サポートされているフェイルオーバーと障害のシナリオ
フェールオーバーマネージャーは、フェールオーバーが発生する場合と発生しない場合がある障害についてクラスターを監視します。
フェールオーバーマネージャーは、非常に限定された限定的なフェールオーバーシナリオをサポートします。フェイルオーバーが発生する可能性があります。
- Masterデータベースがクラッシュまたはシャットダウンした場合。
- Masterデータベースをホストしているノードがクラッシュするか、到達不能になった場合。
Failover Managerは、これらの条件の正確性を検証するためにあらゆる試みを行います。マスターデータベースまたはノードに障害が発生したことをエージェントが確認できない場合、フェールオーバーマネージャーはクラスターでフェールオーバーアクションを実行しません。
フェールオーバーマネージャーは、フェールオーバーマネージャーでフェールオーバー条件を監視および検出するが、スタンバイへの自動フェールオーバーを実行しない場合に、 no auto- フェールオーバーモードもサポートします。このモードでは、フェールオーバー条件が満たされると管理者に通知が送信されます。自動フェイルオーバーを無効にするには、 auto.failoverパラメーターをfalseに設定して、クラスタープロパティファイルを変更します。
フェールオーバーマネージャーは、管理者の介入を必要とするが、スタンバイデータベースをマスターに昇格することに値しない状況について、管理者に警告します。
マスターデータベースがダウンしています
Masterデータベースノードで実行されているエージェントがMasterデータベースの障害を検出すると、Failover Managerは障害を確認するプロセスを開始します。
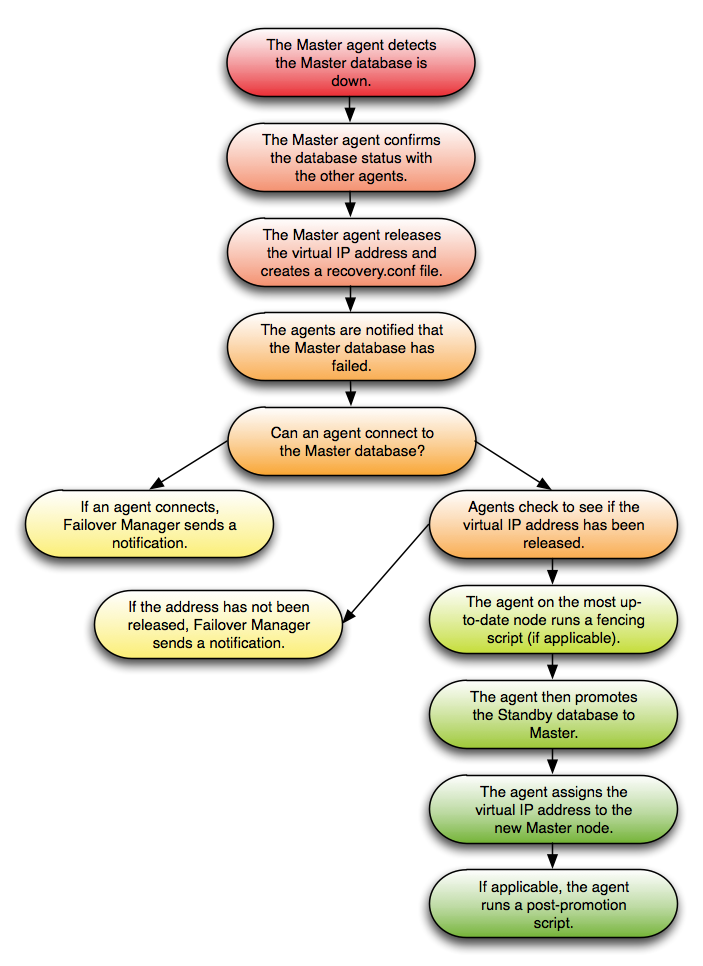
マスターデータベースの障害の確認。
MasterノードのエージェントがMasterデータベースに障害が発生したことを検出すると、すべてのエージェントがMasterデータベースに直接接続しようとします。エージェントがデータベースに接続できる場合、フェールオーバーマネージャーはマスターノードの状態に関する通知を送信します。接続できるエージェントがない場合、マスターエージェントはデータベース障害を宣言し、VIPを解放します(該当する場合)。
エージェントが仮想IPアドレスまたはデータベースサーバーに到達できない場合、フェールオーバーマネージャーはフェールオーバープロセスを開始します。最新のノードのスタンバイエージェントは、フェンシングスクリプト(該当する場合)を実行し、スタンバイデータベースをマスターデータベースに昇格させ、仮想IPアドレスをスタンバイノードに割り当てます。 auto.reconfigureがfalseに設定されていない限り、追加のスタンバイノードは新しいマスターから複製するように構成されます。該当する場合、エージェントはプロモーション後スクリプトを実行します。
ノードをクラスターに戻す
クラスタ全体を再起動せずにこのシナリオから回復するには、次のことを行う必要があります。
- 元のマスターノード上のデータベースをスタンバイデータベースとして再起動します。
- 元のマスターノードでefm resumeコマンドを呼び出します。
ノードをマスターの役割に戻す
ノードをスタンバイとしてクラスターに戻した後、ノードをマスターの役割に簡単に戻すことができます。
- クラスターに複数のスタンバイノードがある場合は、efm allow-nodeコマンドを使用して、ノードのフェールオーバー優先度を1に設定します。
- efm promote -switchoverコマンドを呼び出して、ノードをマスターノードの元の役割に昇格させます。
スタンバイデータベースがダウンしている
スタンバイエージェントがデータベースの障害を検出した場合、エージェントは他のエージェントに通知します。他のエージェントはデータベースの状態を確認します。
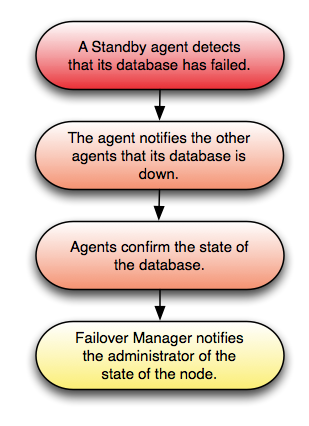
スタンバイデータベースの障害の確認。
スタンバイデータベースを正常な状態に戻した後、efm resumeコマンドを呼び出して、スタンバイをクラスターに戻します。
マスターエージェントの終了またはノードの失敗
フェールオーバーマネージャーマスターエージェントがクラッシュするか、ノードに障害が発生すると、スタンバイエージェントが障害を検出し、(必要に応じて)フェールオーバーを開始します。
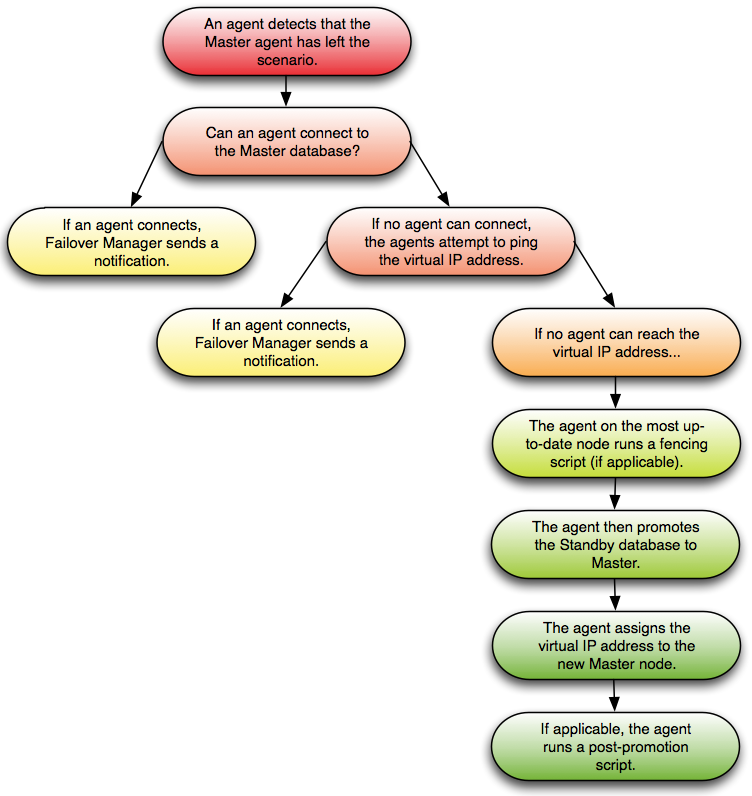
マスターエージェントの障害の確認。
マスターエージェントが去ったことをエージェントが検出した場合、すべてのエージェントはマスターデータベースに直接接続しようとします。データベースに接続できるエージェントがある場合、エージェントはマスターエージェントの障害に関する通知を送信します。接続できるエージェントがない場合、エージェントは仮想IPアドレスにpingを試行して、解放されたかどうかを判断します。
エージェントが仮想IPアドレスまたはデータベースサーバーに到達できない場合、フェールオーバーマネージャーはフェールオーバープロセスを開始します。最新のノード上のスタンバイエージェントは、フェンシングスクリプト(該当する場合)を実行し、スタンバイデータベースをマスターデータベースに昇格させ、仮想IPアドレスをスタンバイノードに割り当てます。該当する場合、エージェントはプロモーション後スクリプトを実行します。 auto.reconfigureがfalseに設定されていない限り、追加のスタンバイノードは新しいマスターから複製するように構成されます。
マスターがネットワークから分離されたためにこのシナリオが発生した場合、マスターエージェントは分離を検出して仮想IPアドレスを解放し、recovery.confファイルを作成します。フェールオーバーマネージャーは、クラスターの残りのノードで前述の手順を実行します。
クラスタ全体を再起動せずにこのシナリオから回復するには、次のことを行う必要があります。
- 元のマスターノードを再起動します。
- 元のマスターデータベースをスタンバイノードとして起動します。
- 元のマスターノードでサービスを開始します。
エージェントを停止しても、エージェントに障害が発生したことはクラスターに通知されません。
スタンバイエージェントの終了またはノードの失敗
スタンバイエージェントが終了するか、スタンバイノードに障害が発生すると、他のエージェントは、クラスタに接続されなくなったことを検出します。
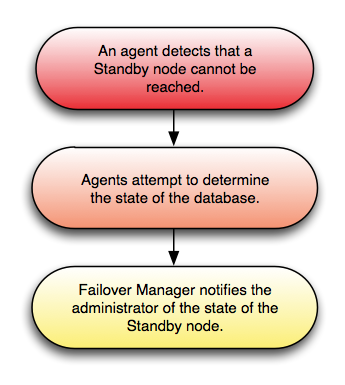
スタンバイエージェントの障害。
障害が検出されると、エージェントはノードにあるデータベースへの接続を試みます。エージェントが問題があることを確認すると、フェールオーバーマネージャーは管理者に適切な通知を送信します。
1つのマスターと1つのスタンバイのみが残っている場合、マスターノードに障害が発生した場合のフェールオーバー保護はありません。マスターデータベースに障害が発生した場合、マスターエージェントとスタンバイエージェントは、データベースに障害が発生したことに同意し、フェールオーバーを続行できます。
専用の監視エージェントの終了/ノードの失敗
次のシナリオでは、専用の証人(データベースをホストしていないノード)に障害が発生した場合に実行されるアクションについて詳しく説明します。
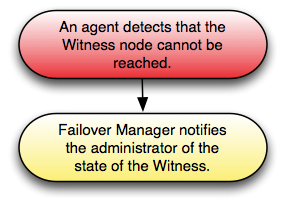
専用の証人の失敗の確認。
Witnessノードに到達できないことをエージェントが検出すると、Failover ManagerはWitnessの状態を管理者に通知します。
注 :マスターが1つだけ、スタンバイが1つだけ残っている場合、マスターノードに障害が発生した場合のフェイルオーバー保護はありません。マスターデータベースに障害が発生した場合、マスターエージェントとスタンバイエージェントは、データベースに障害が発生したことに同意し、フェールオーバーを続行できます。
ノードがクラスターから分離される
次のシナリオでは、1つ以上のノード(クラスターの少数)がクラスターの大部分から分離された場合に実行されるアクションについて詳しく説明します。
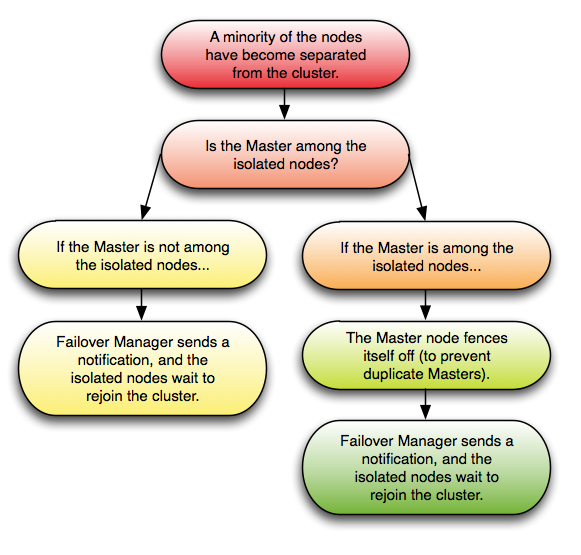
クラスターのメンバーが分離された場合。
1つ以上のノード(ただし、クラスターの半分未満)がクラスターの残りの部分から分離されると、残りのクラスターは、ノードに障害が発生したかのように動作します。エージェントは、マスターノードが 孤立したノード間;つまり、マスターはクラスターから自身をフェンスしますが、スタンバイノード(クラスターの過半数内から)はそれを置き換えるために昇格されます。 auto.reconfigureがfalseに設定されていない限り、他のスタンバイノードは新しいマスターから複製するように構成されます。
フェールオーバーマネージャーは管理者に通知し、分離されたノードは可能な場合はクラスターに再参加します。ノードがクラスターに再参加すると、フェールオーバーの優先順位が変更される場合があります。