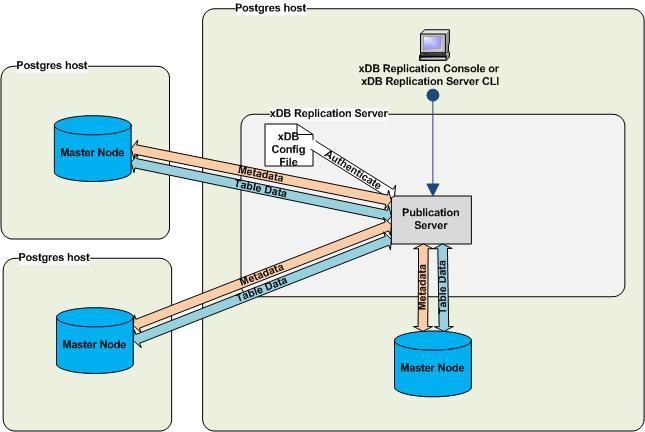
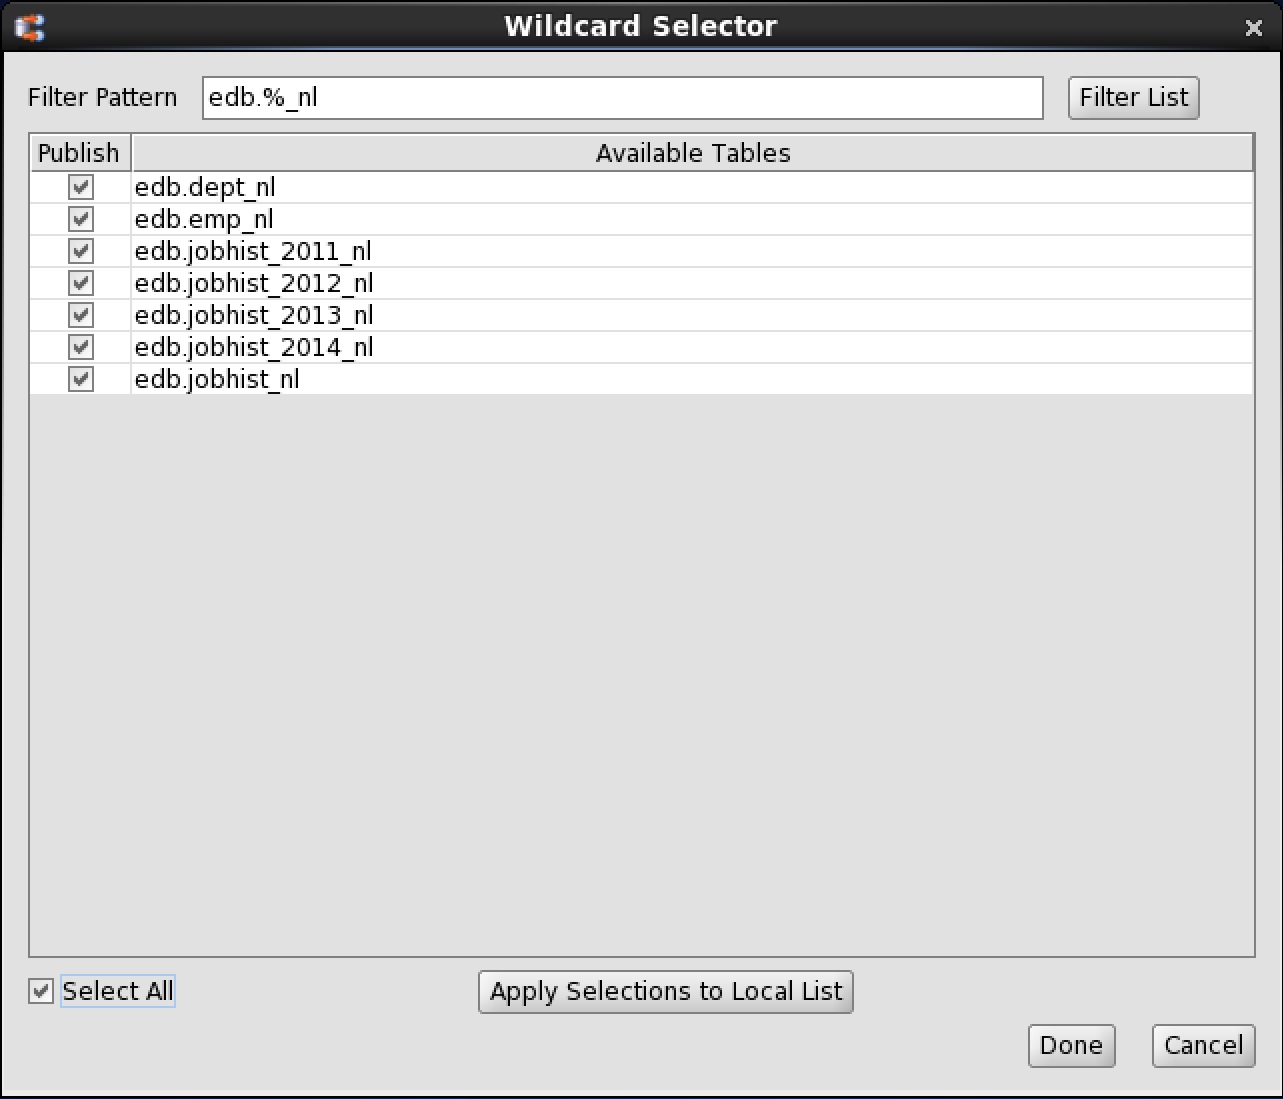
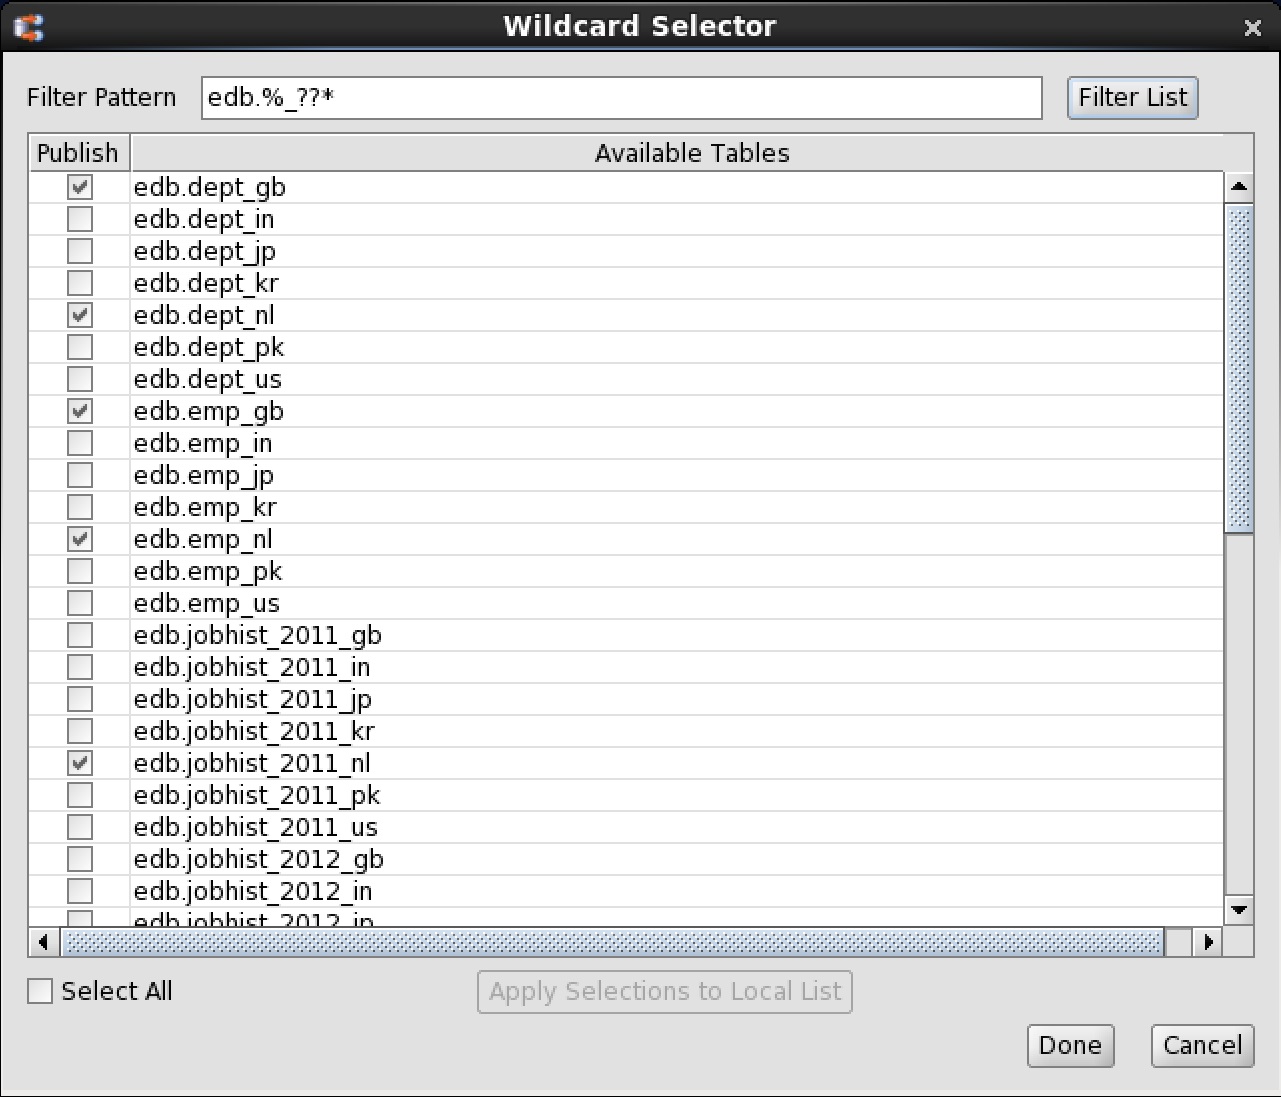
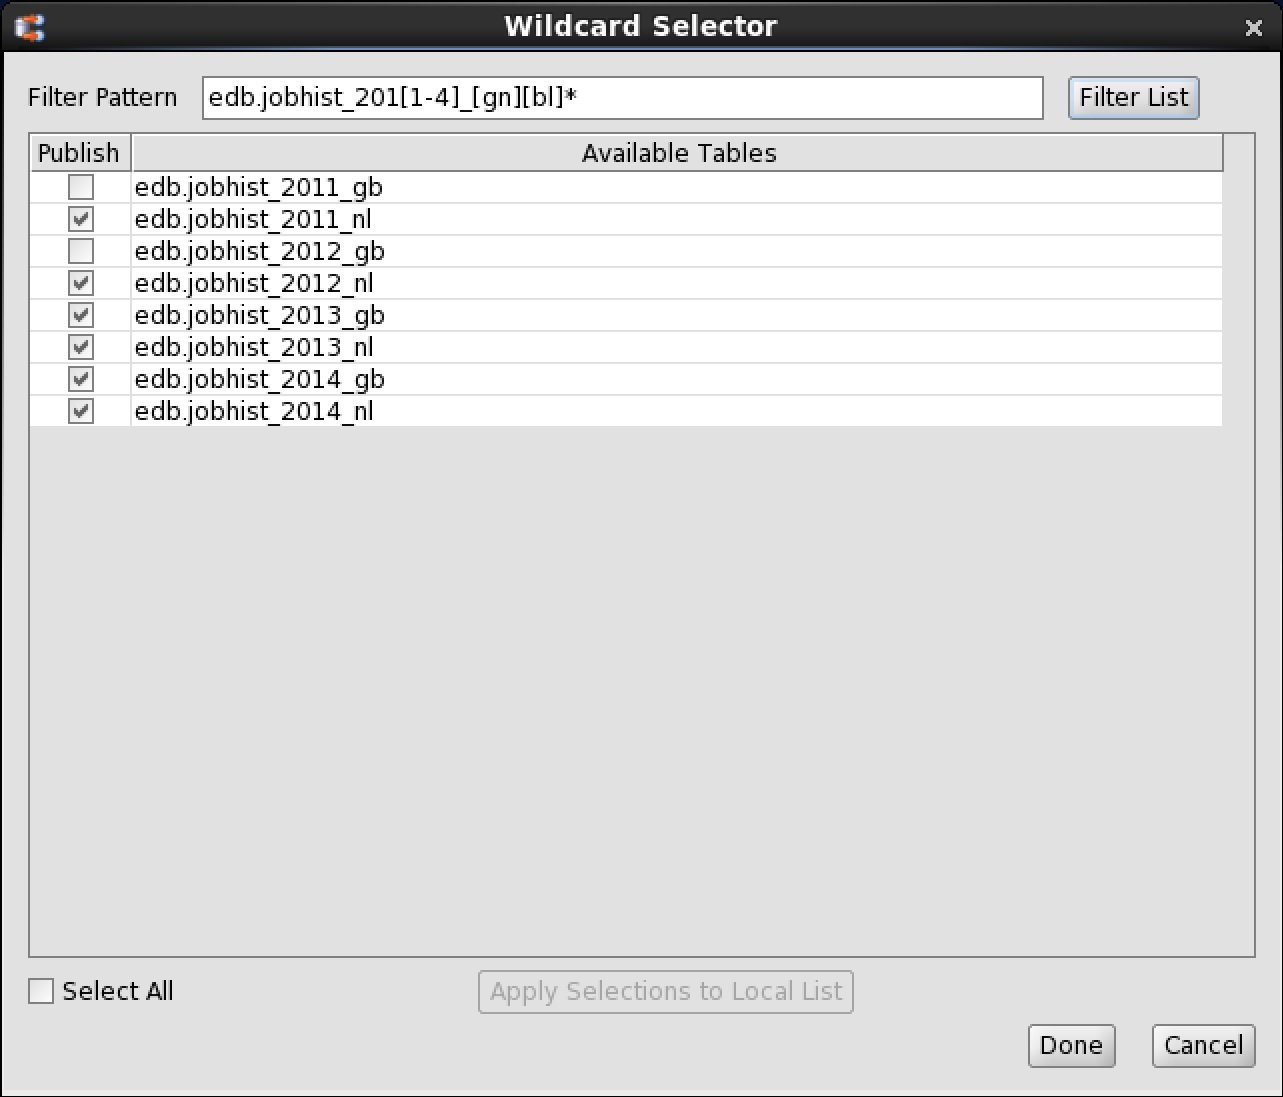
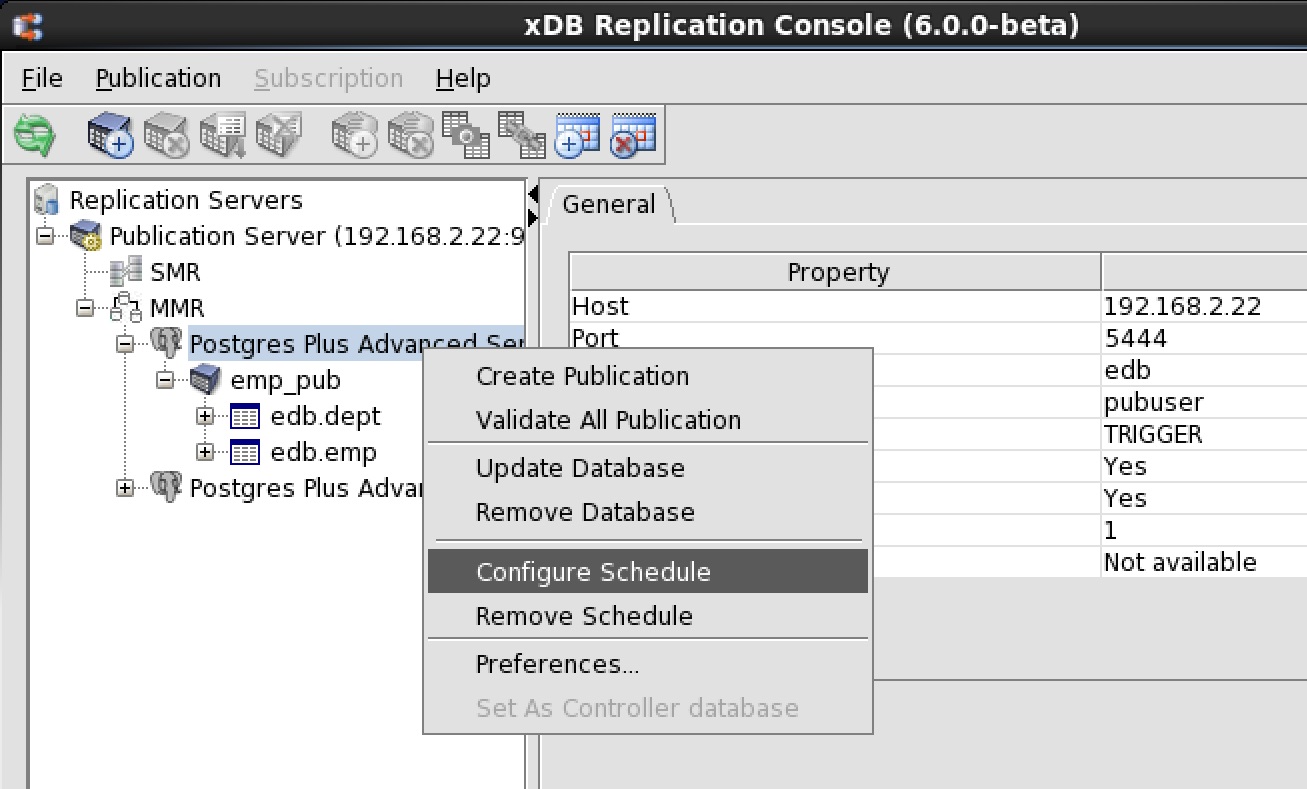
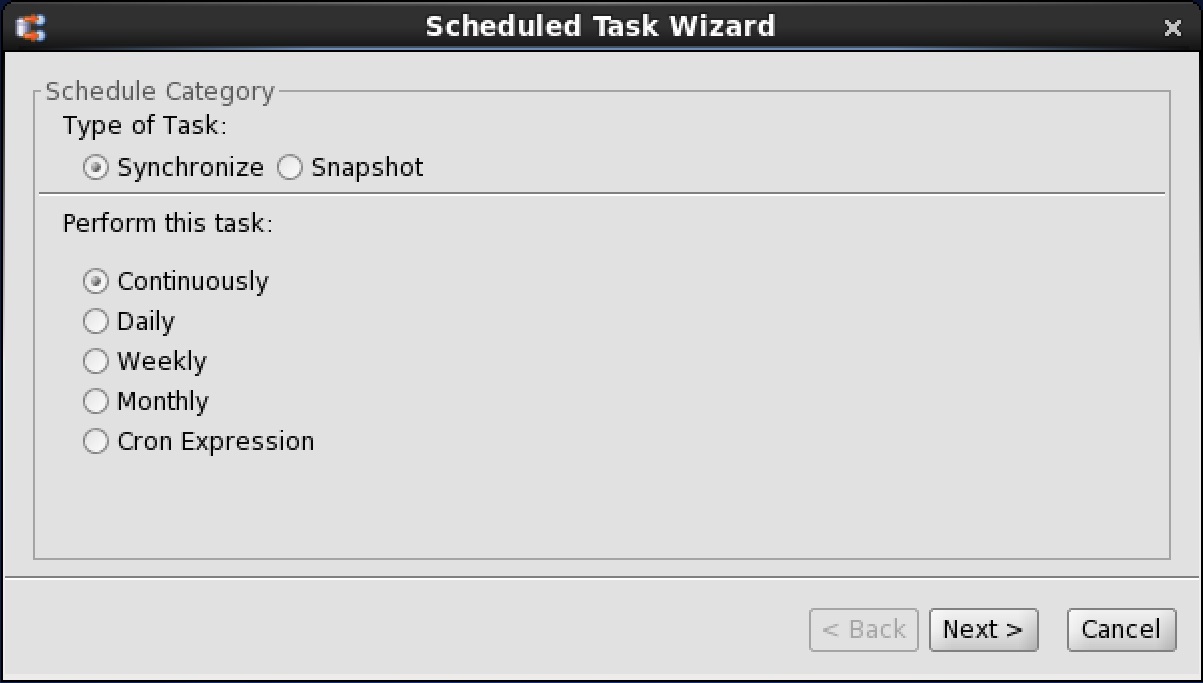
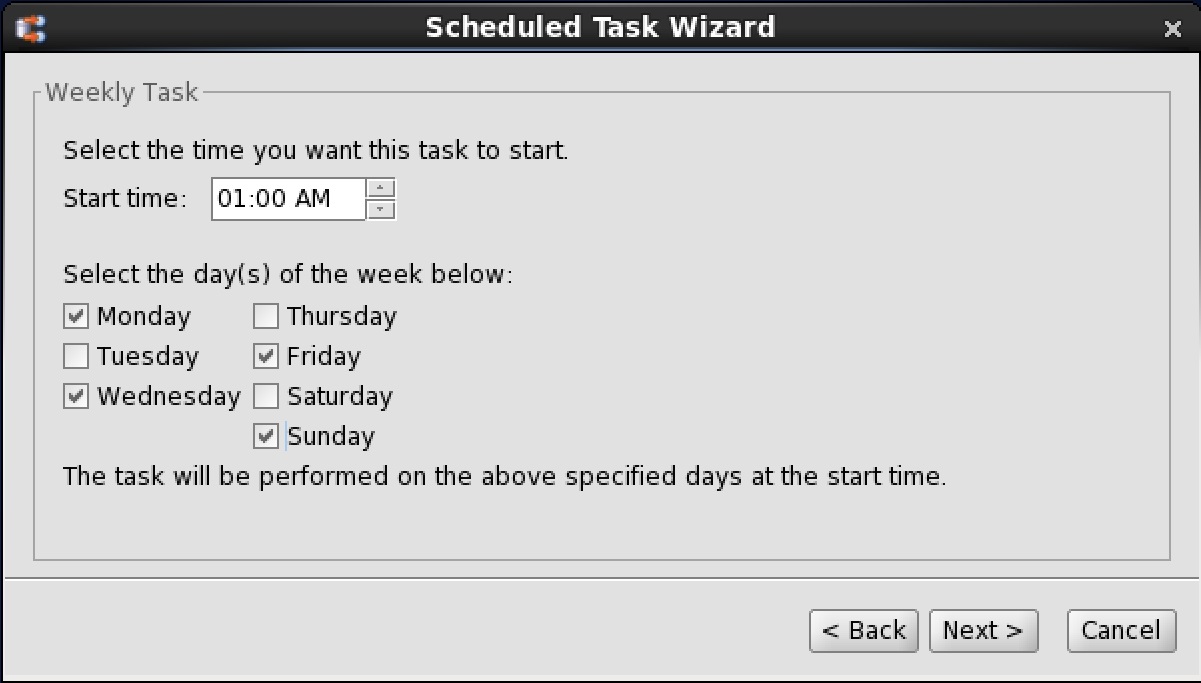
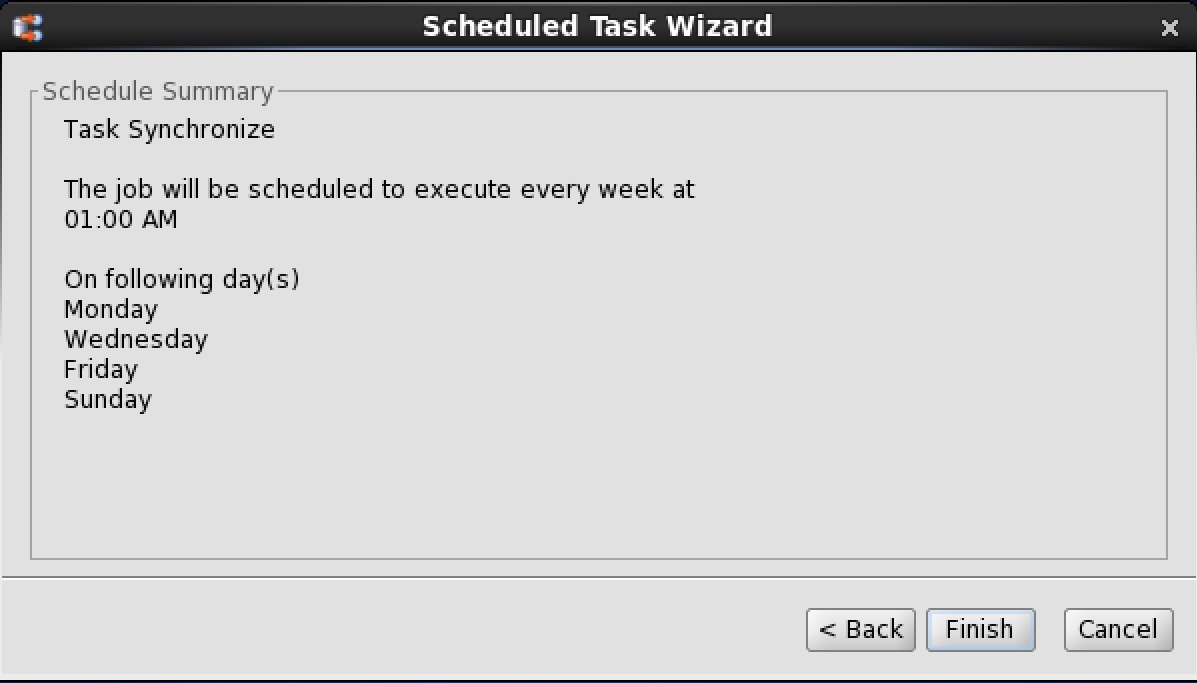
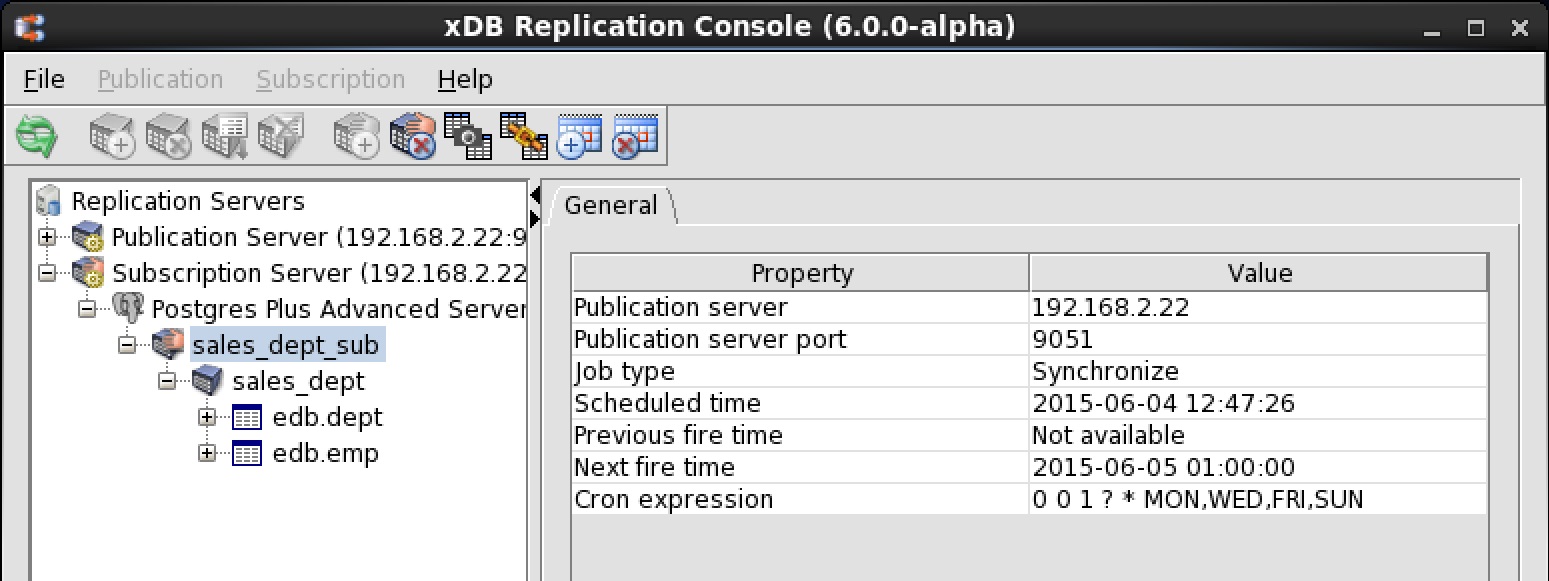
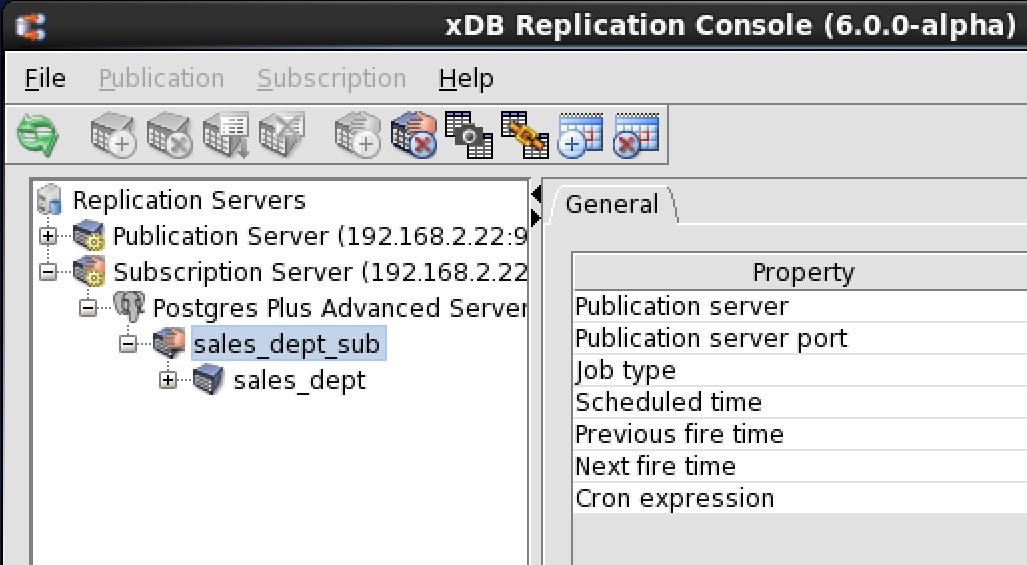
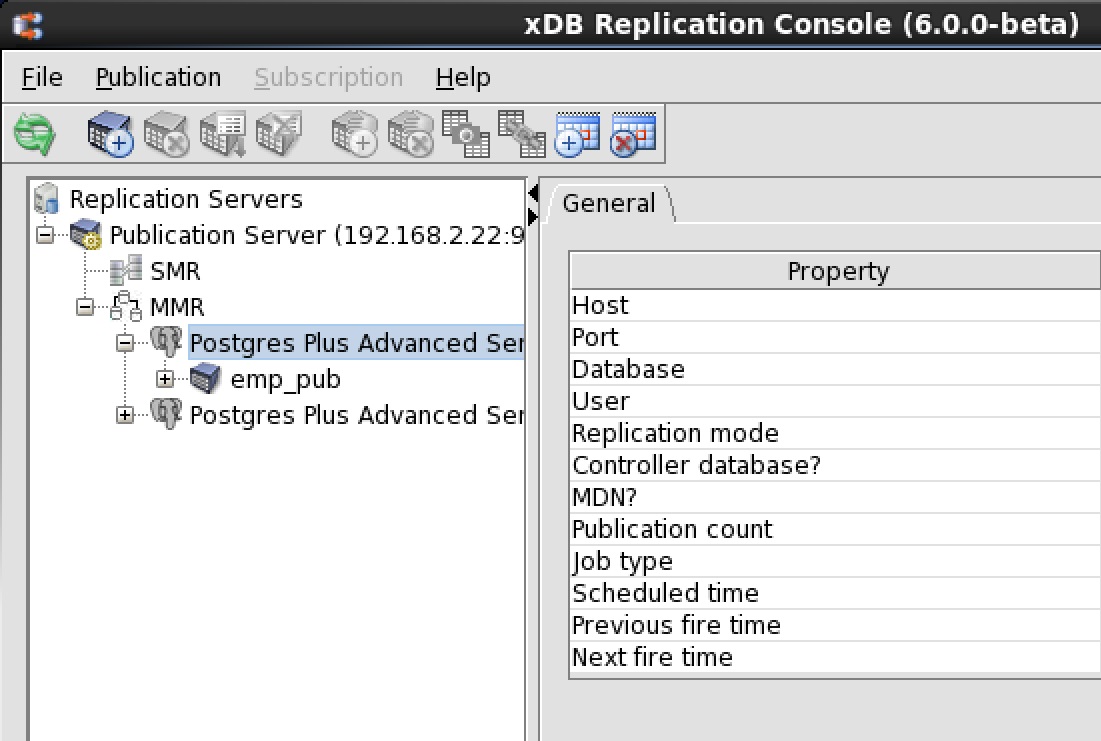
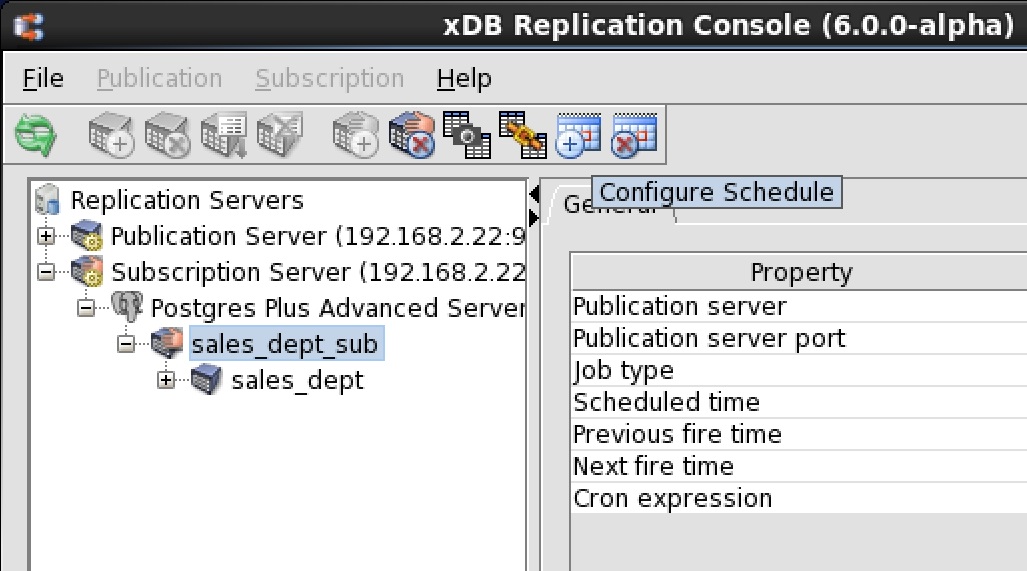
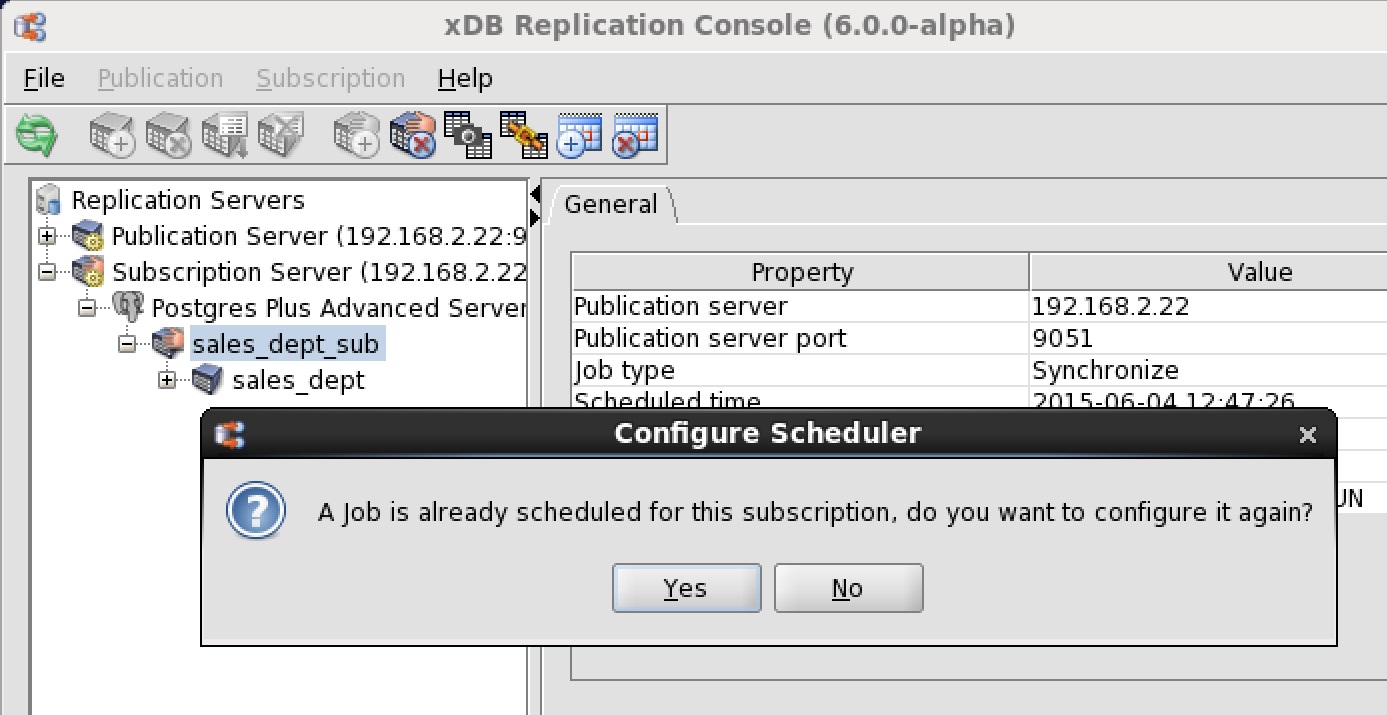
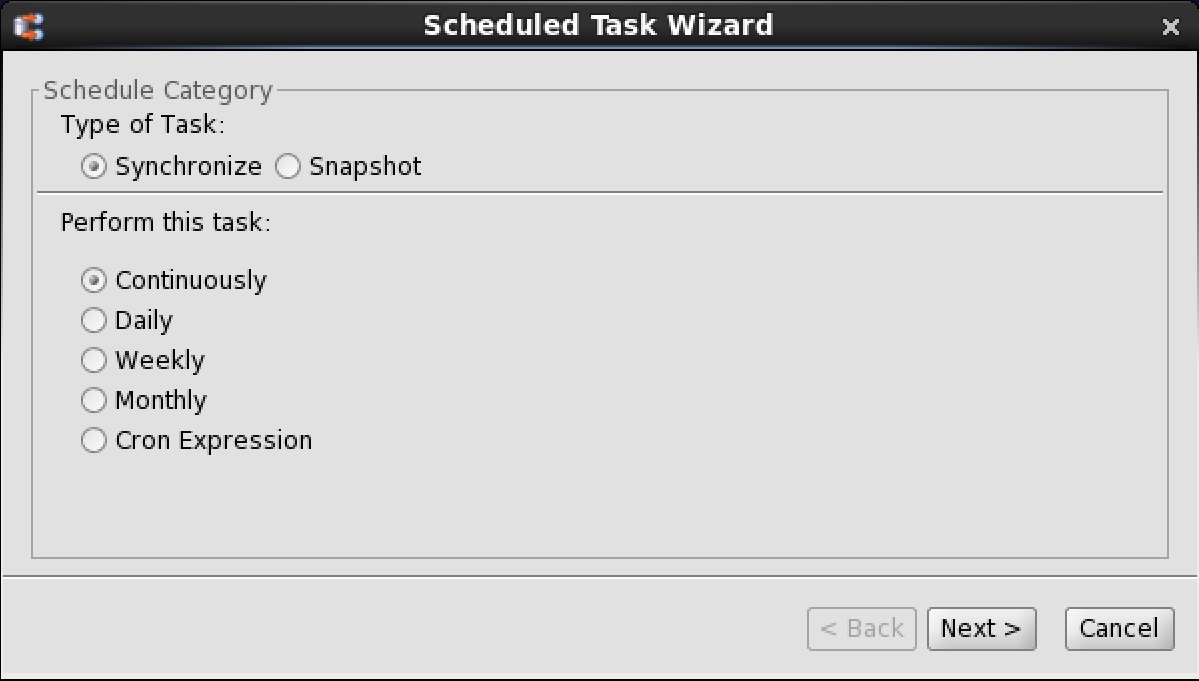
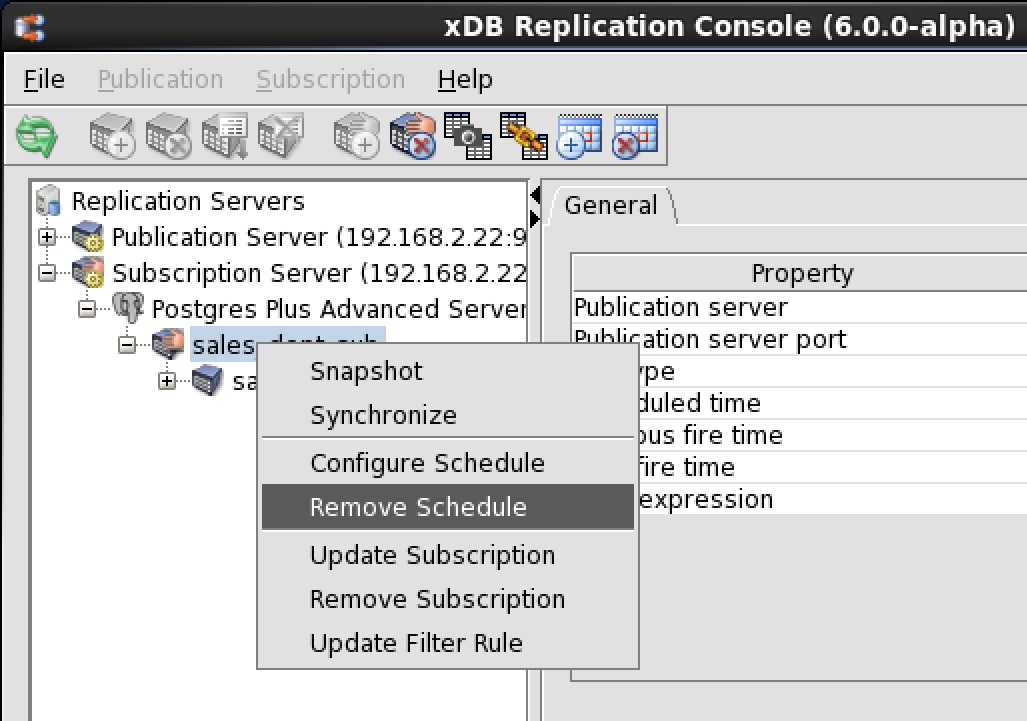
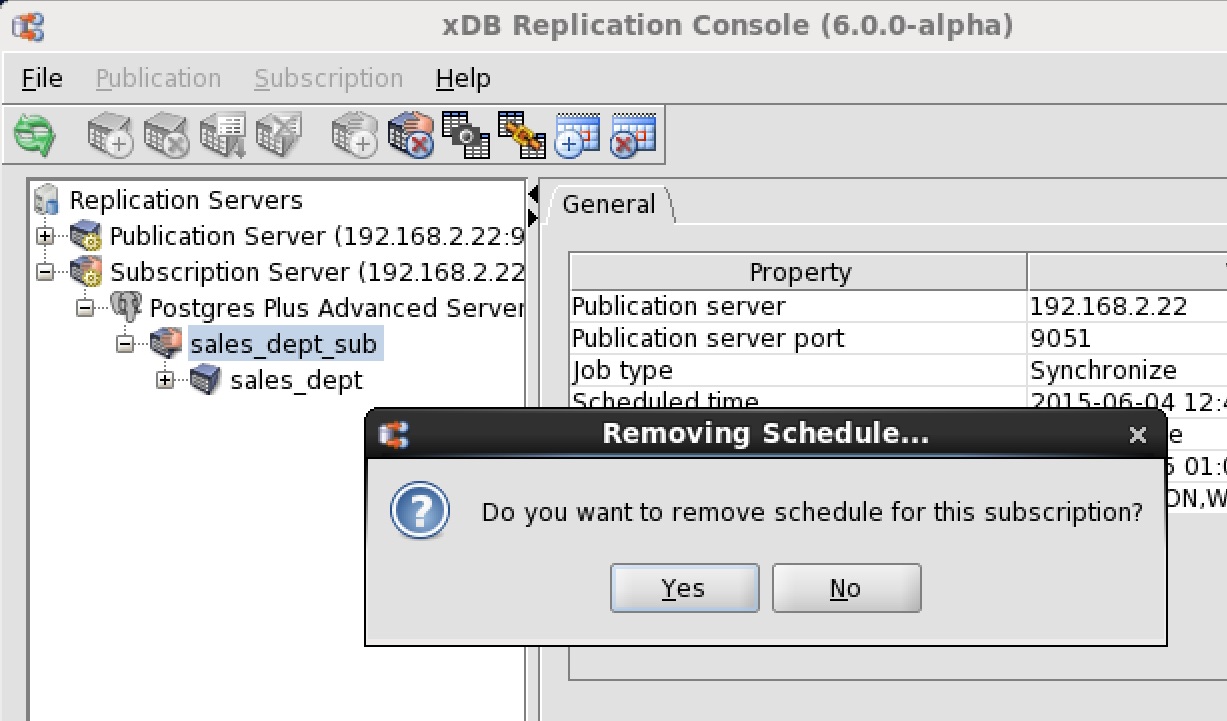
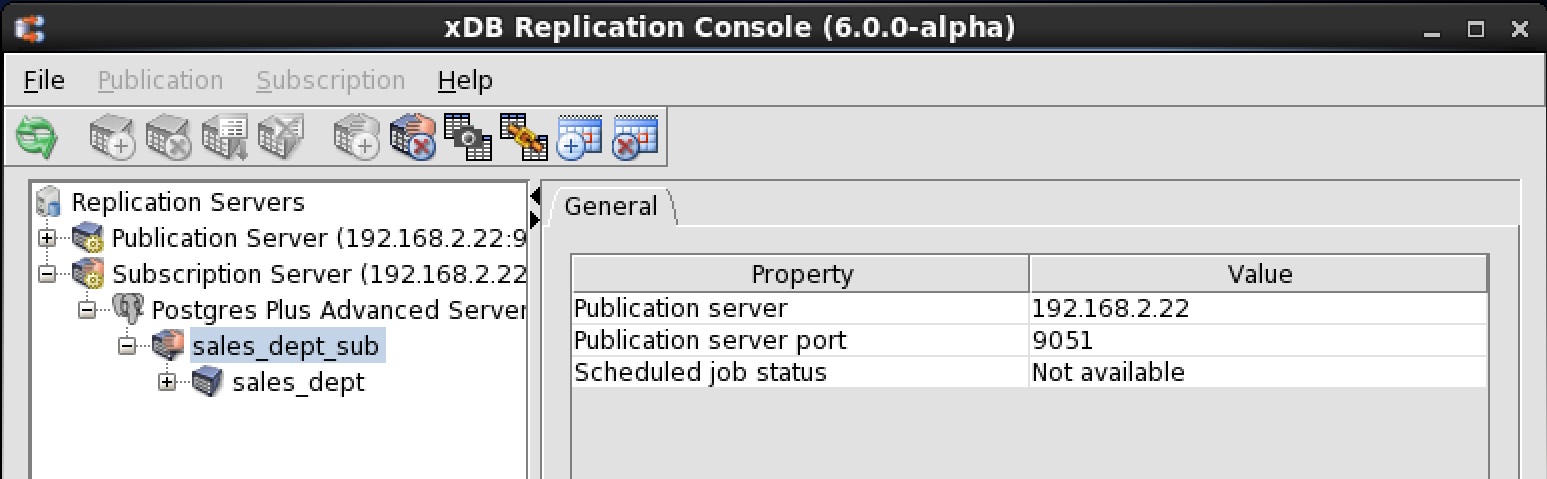
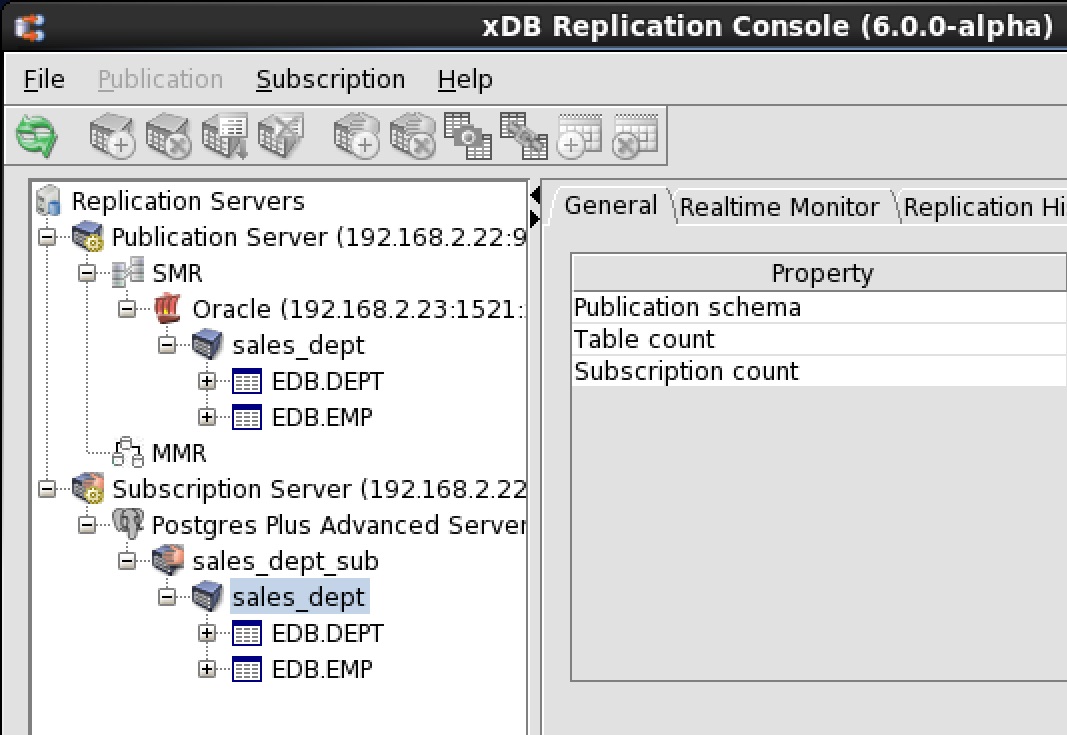
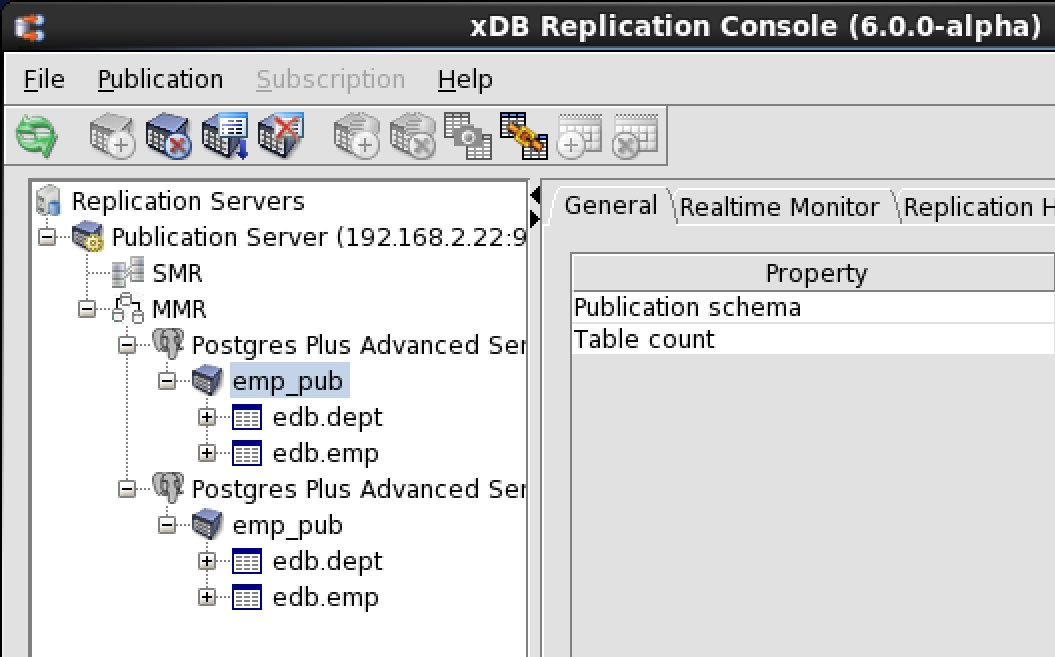
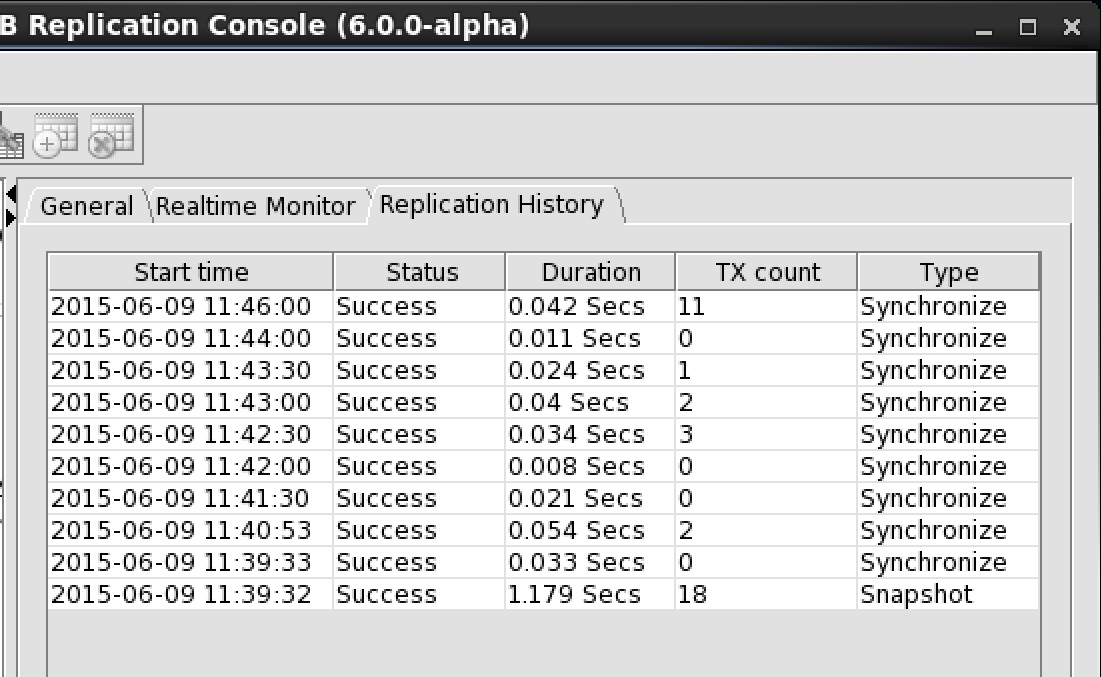
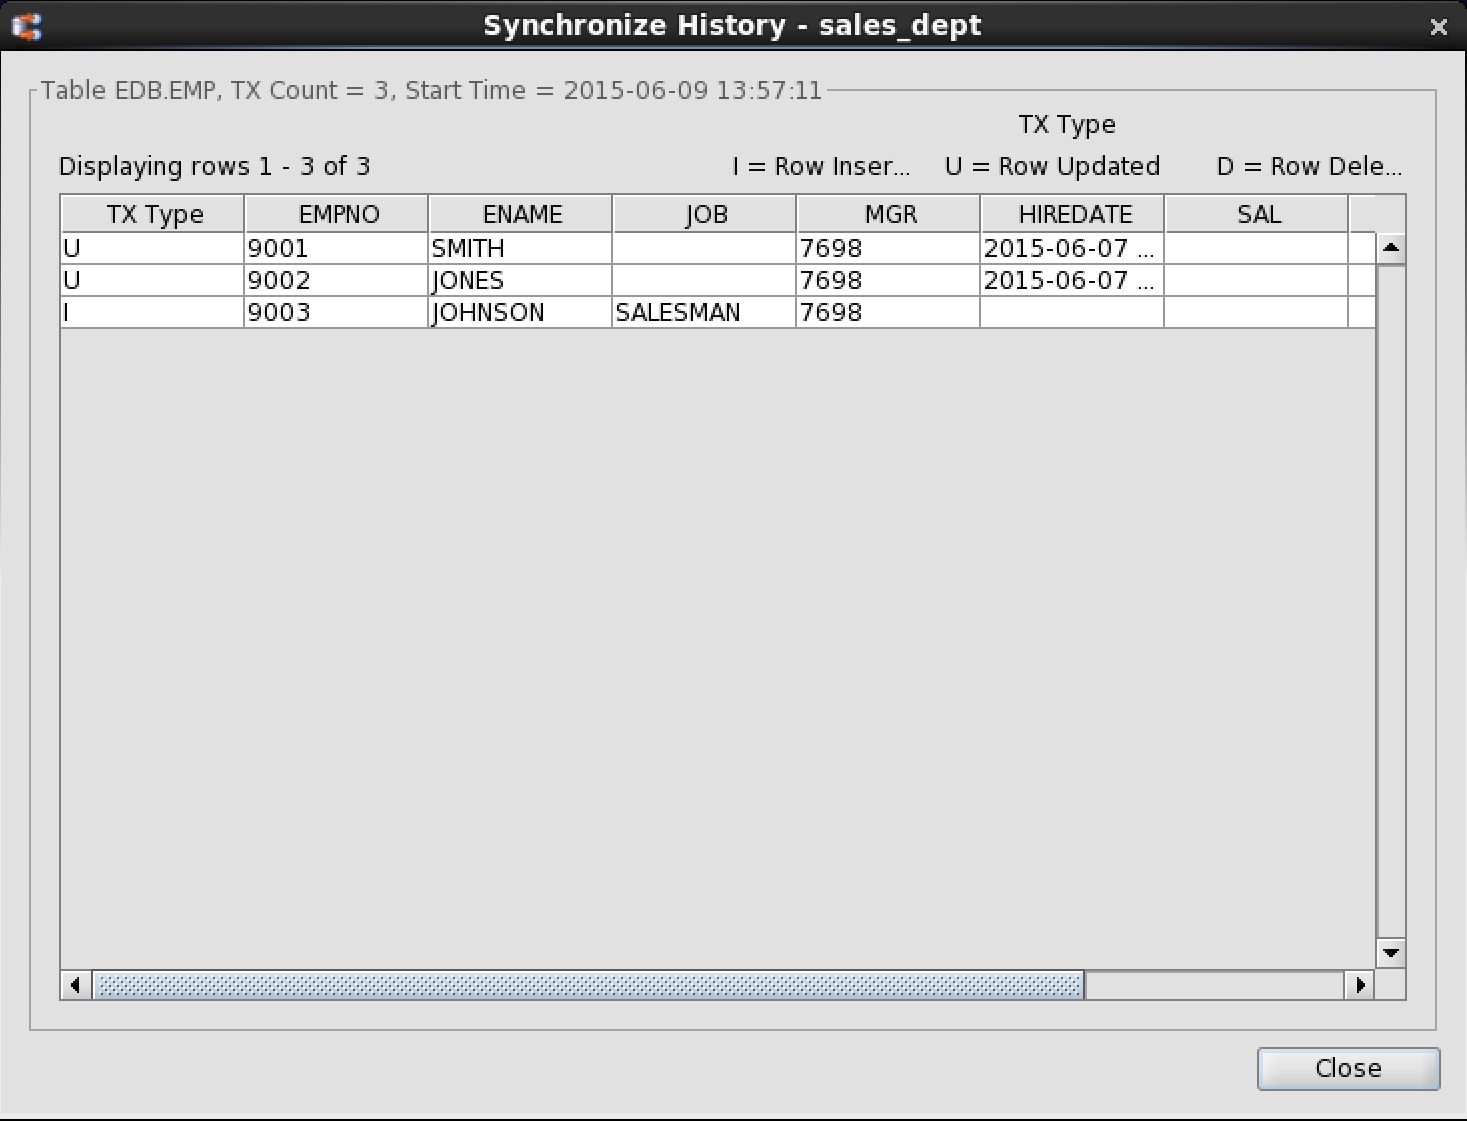
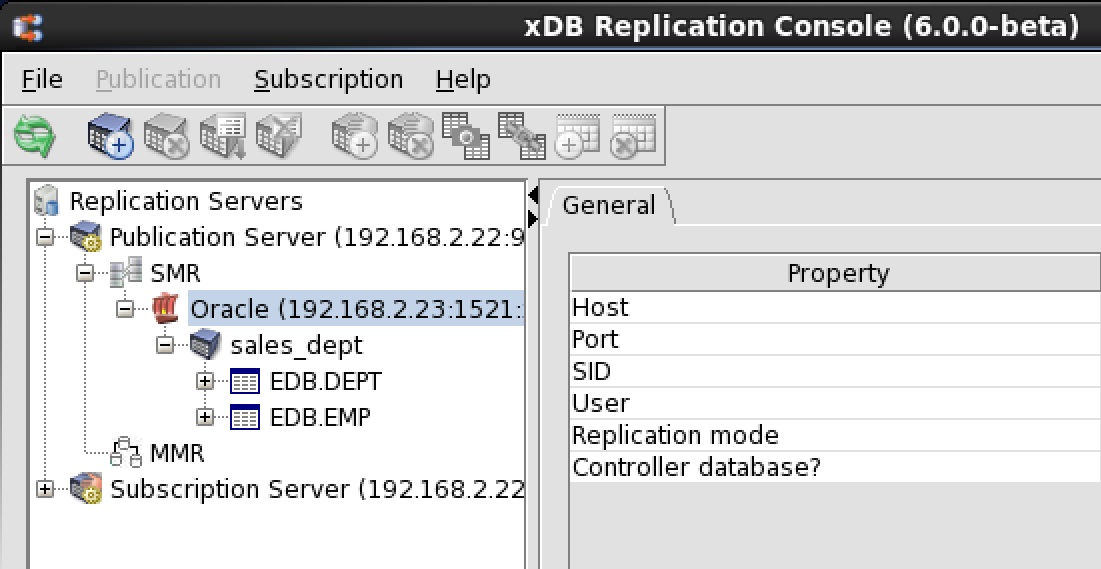
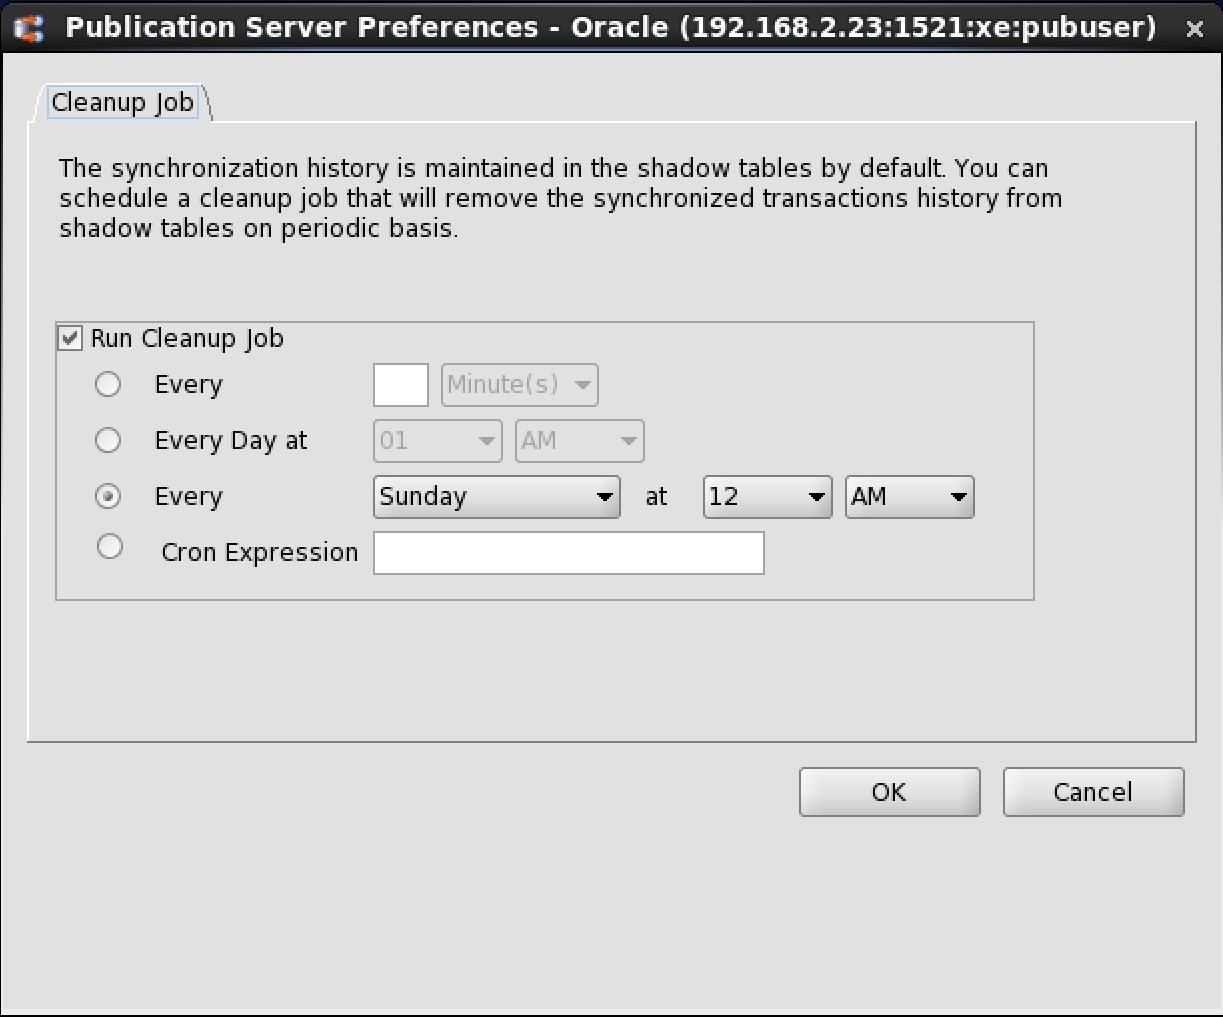
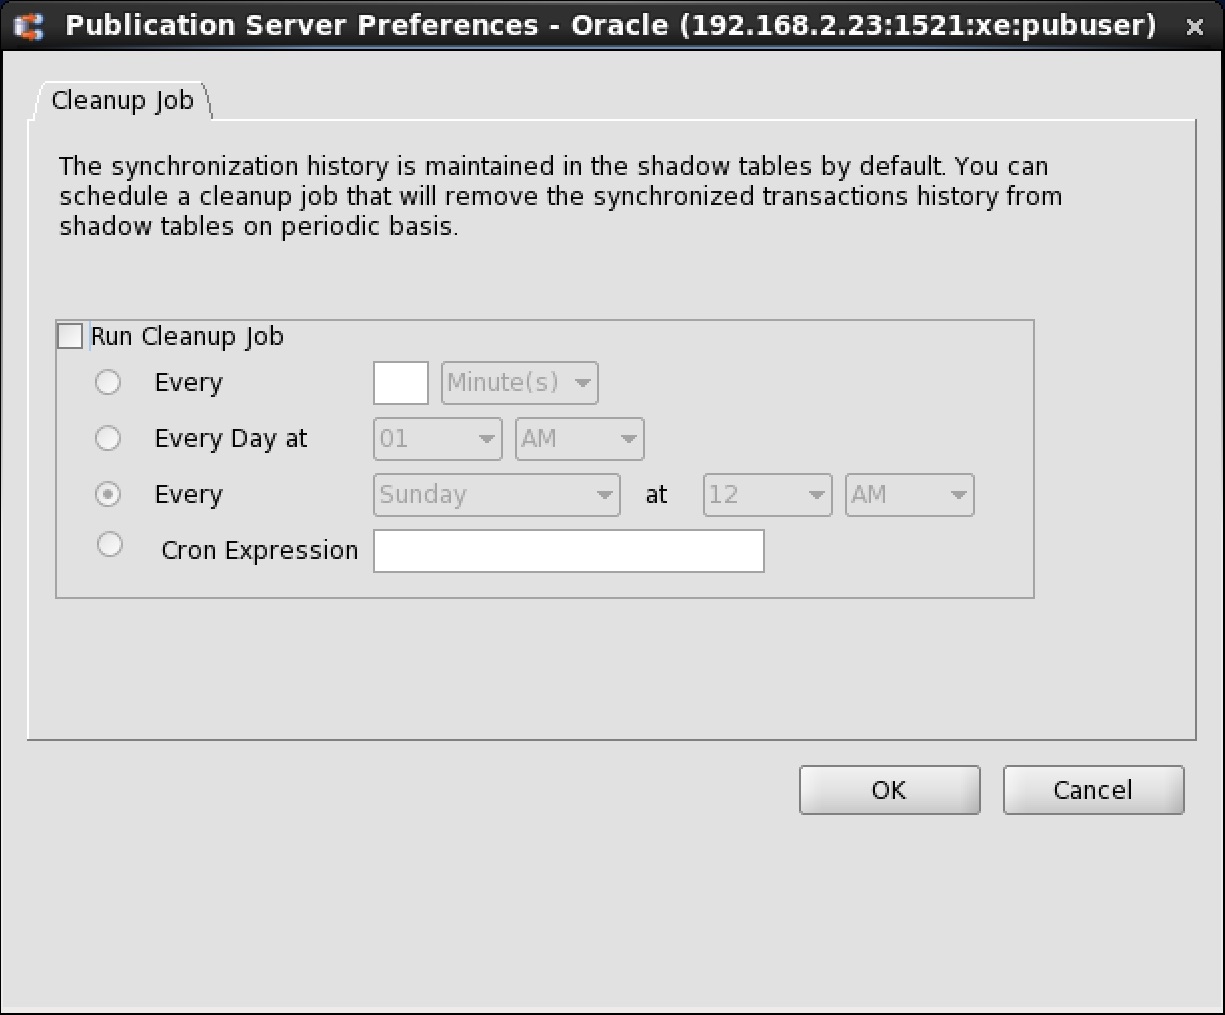
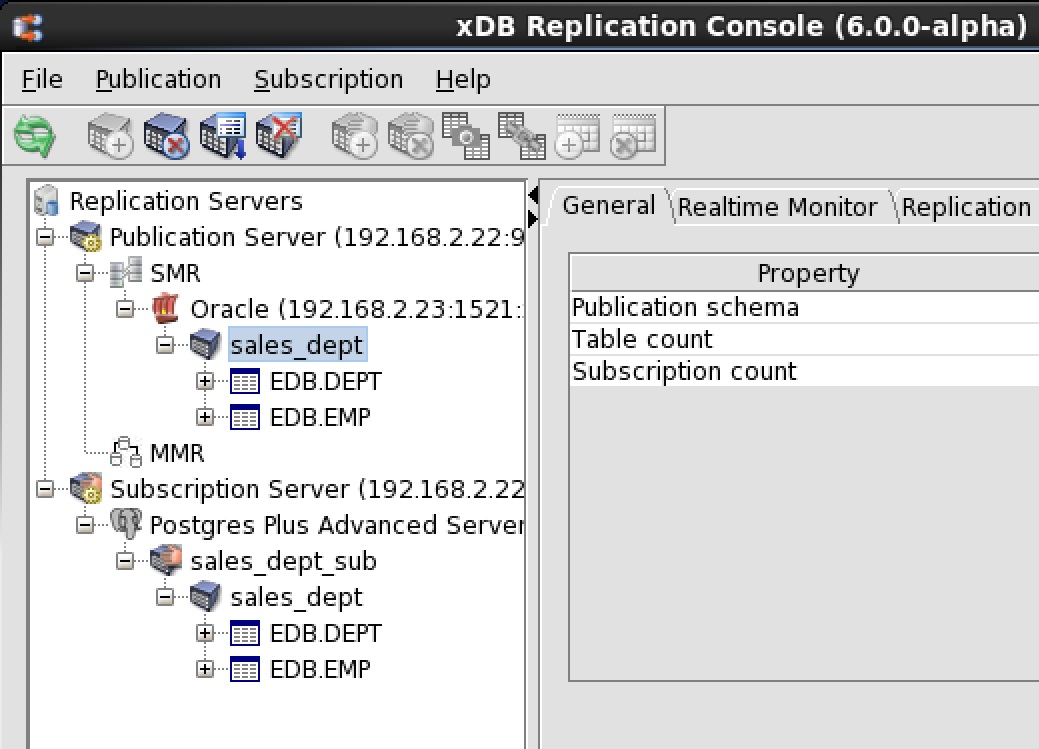
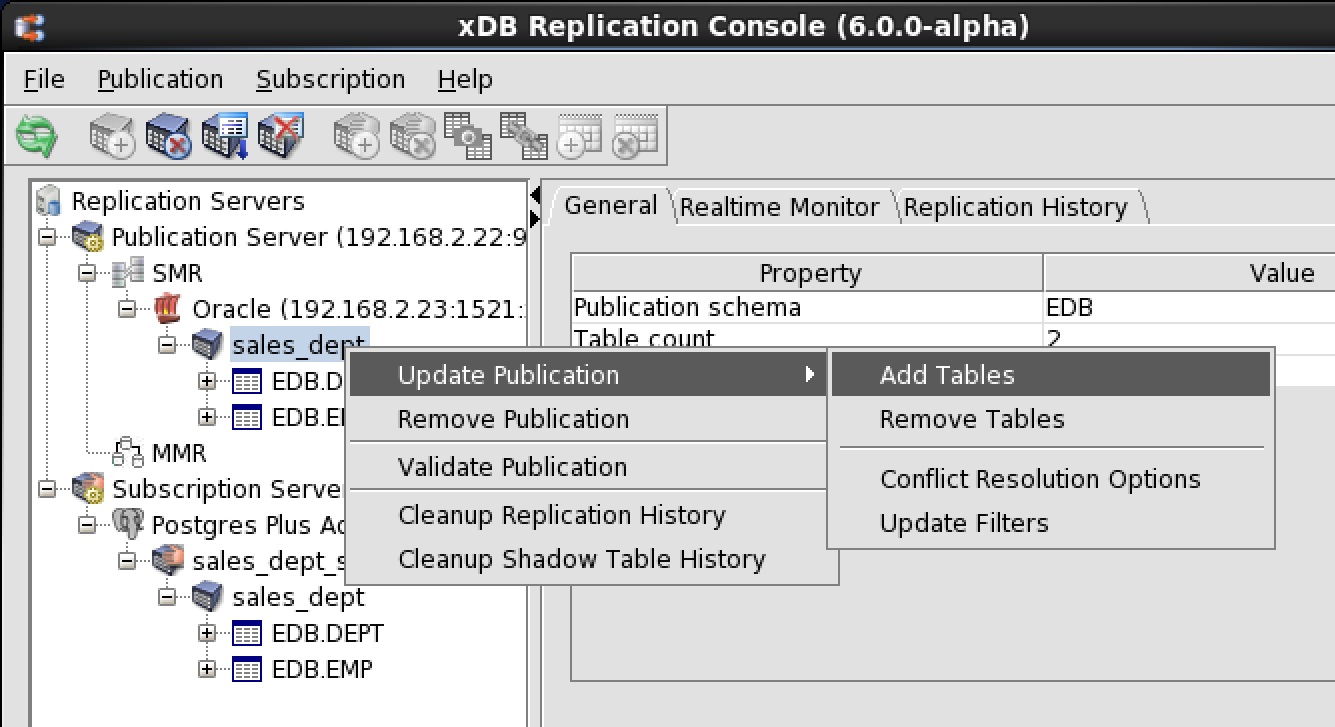
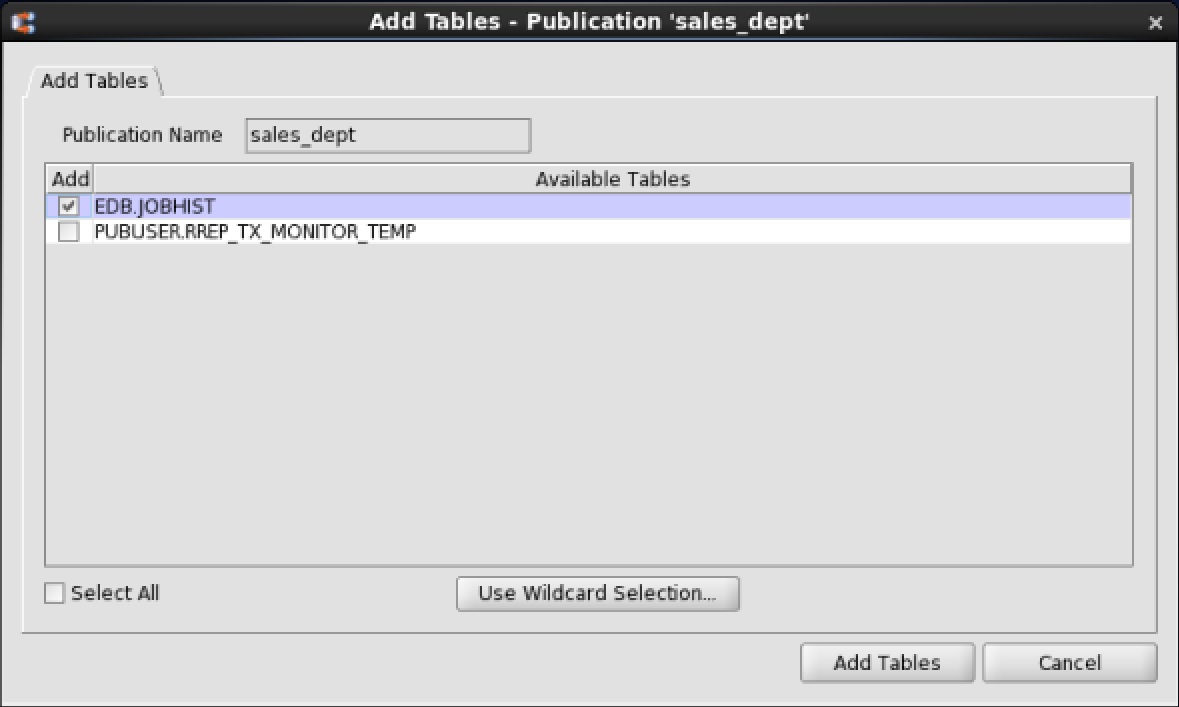
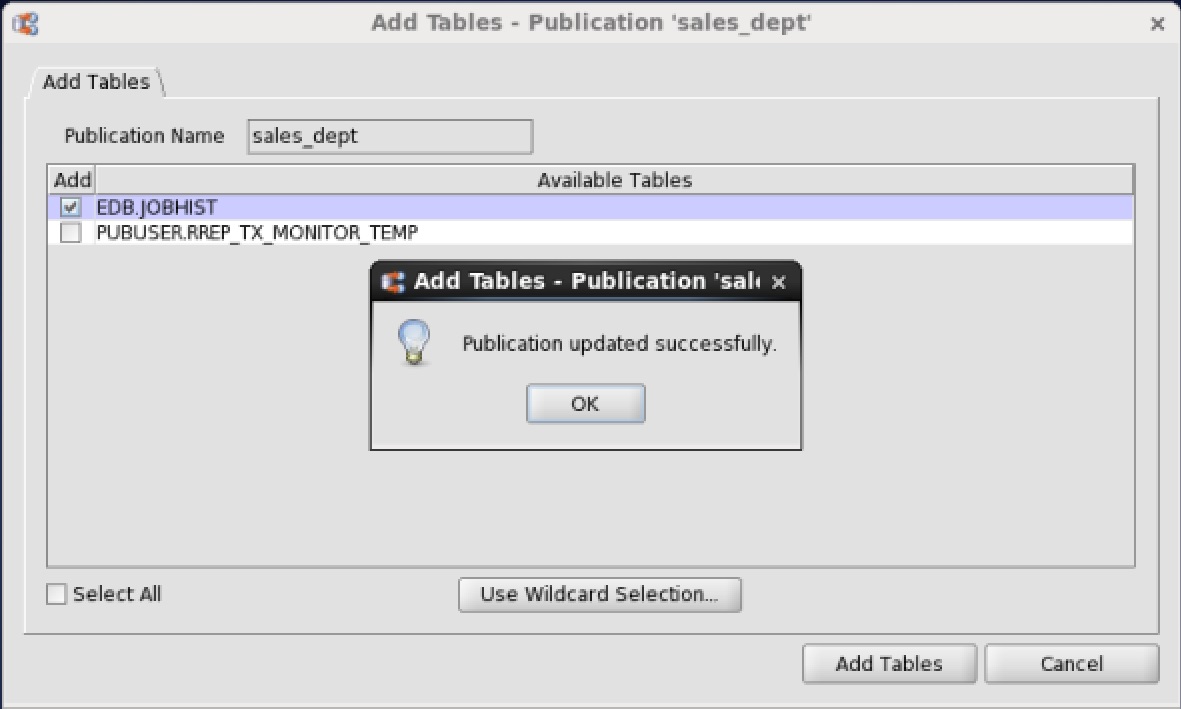
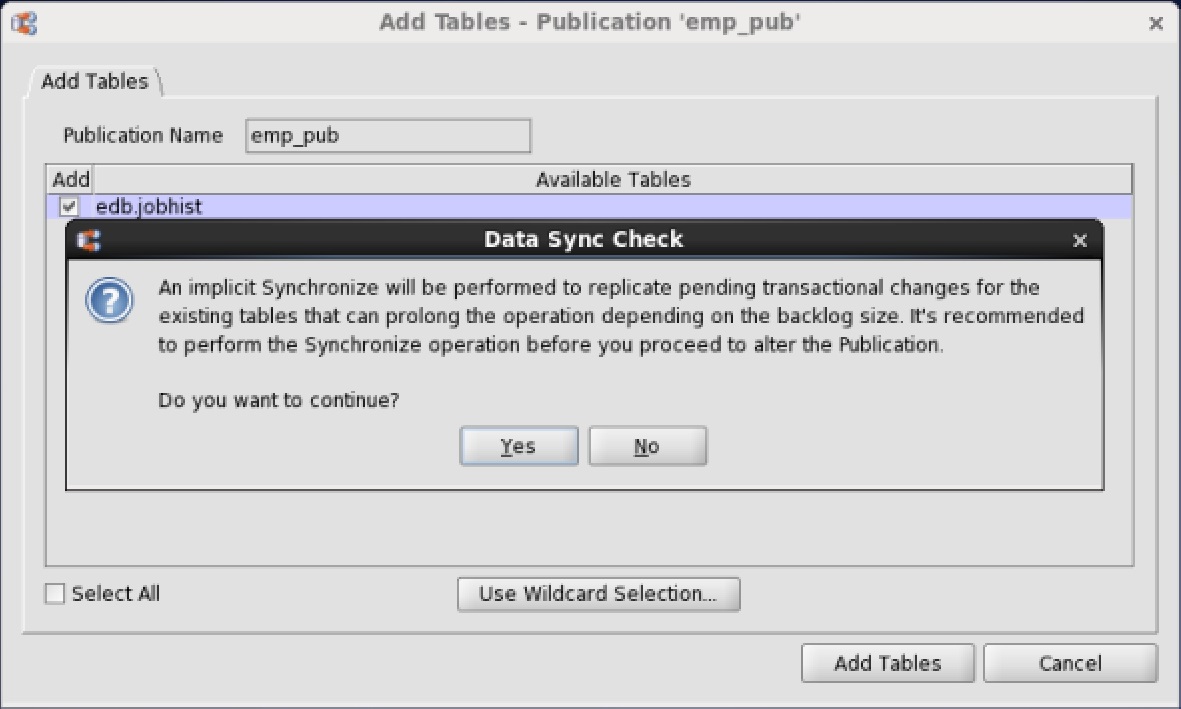
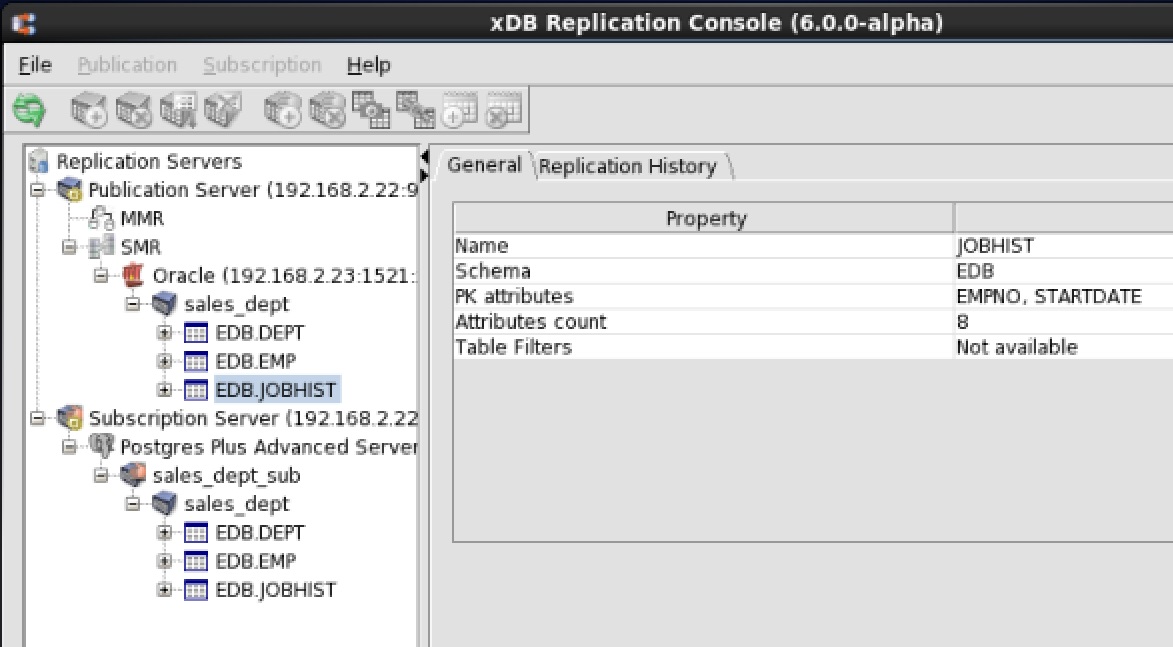
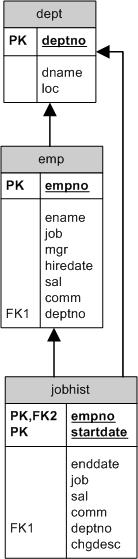
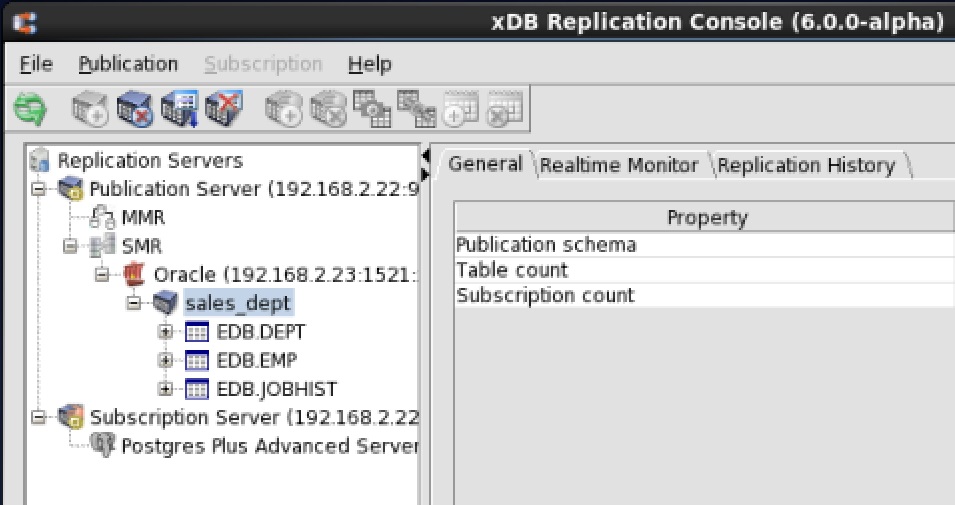
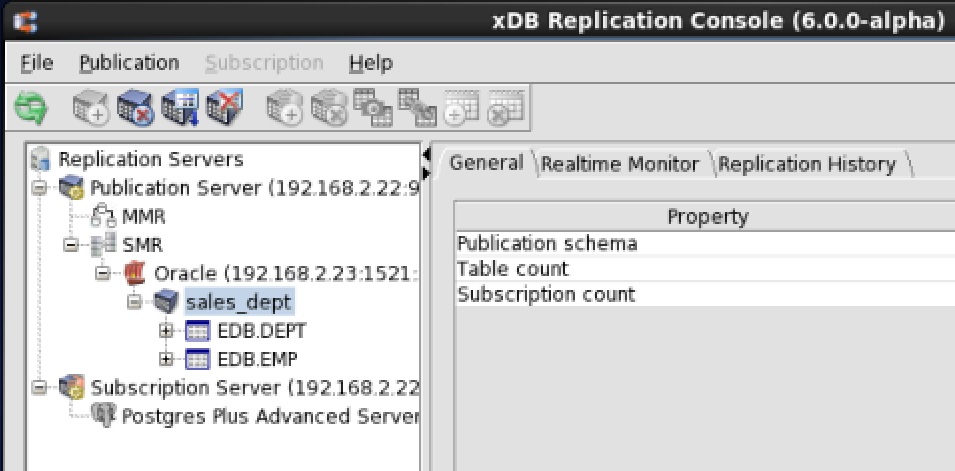
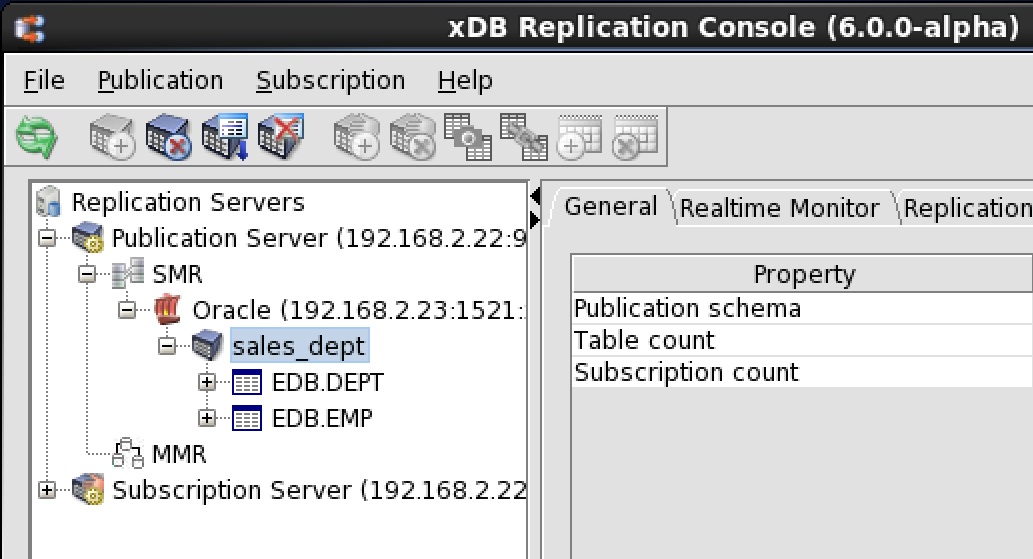
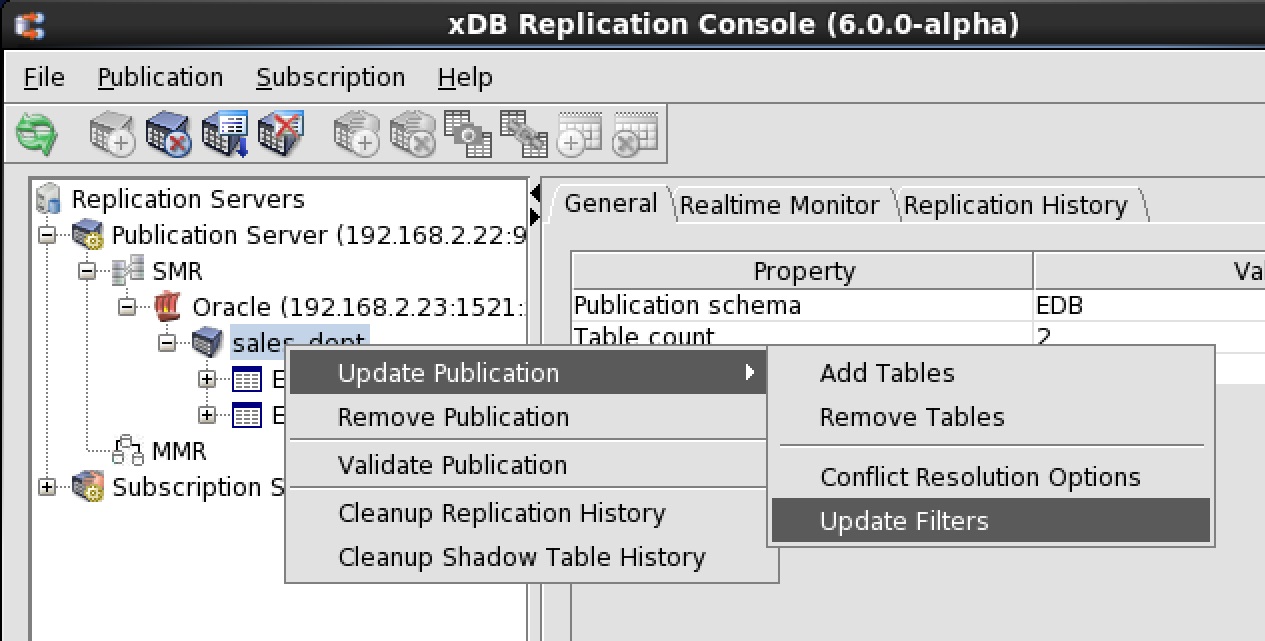
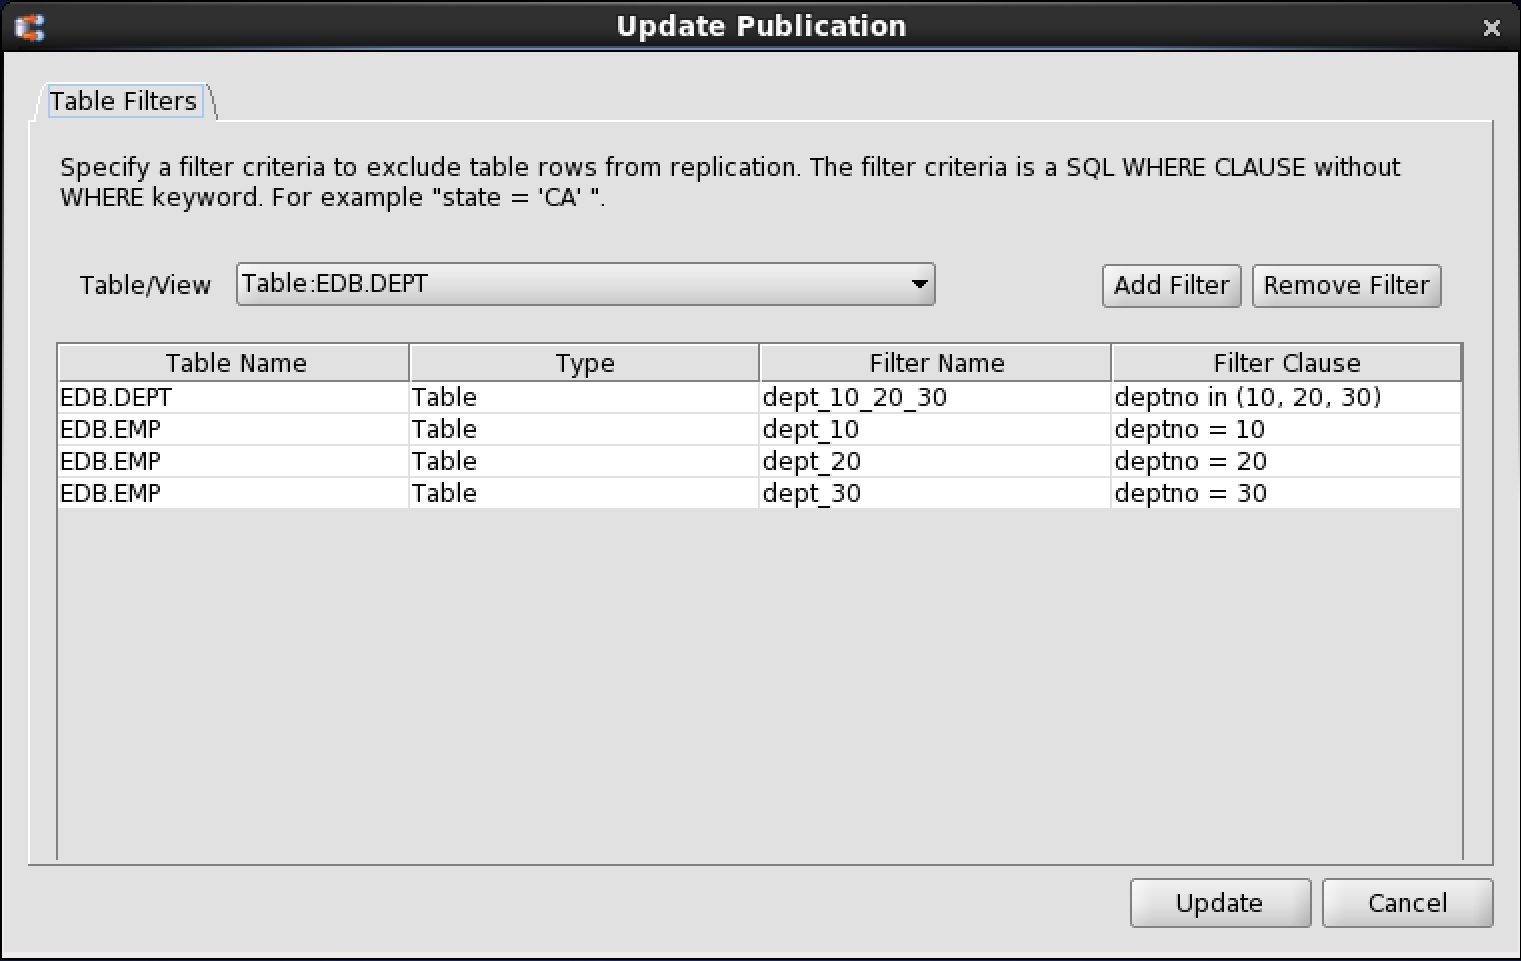
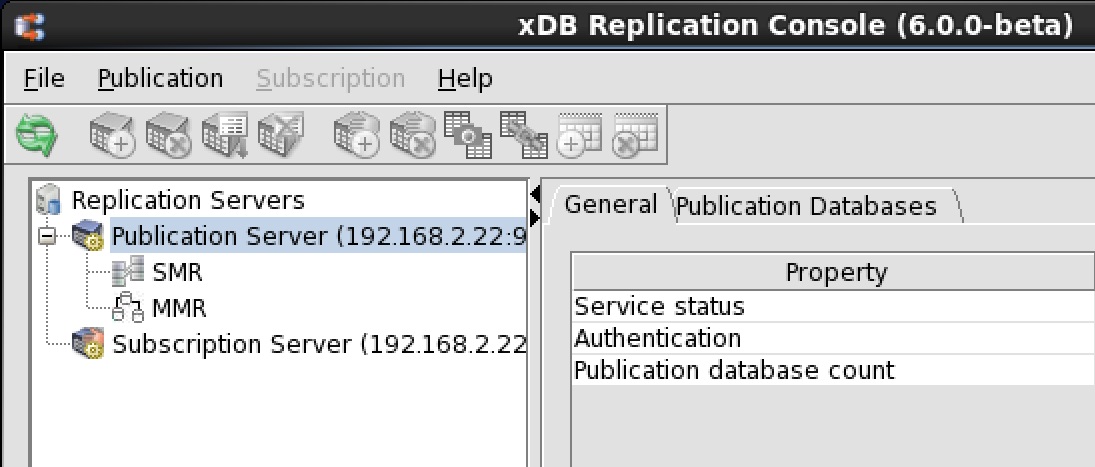
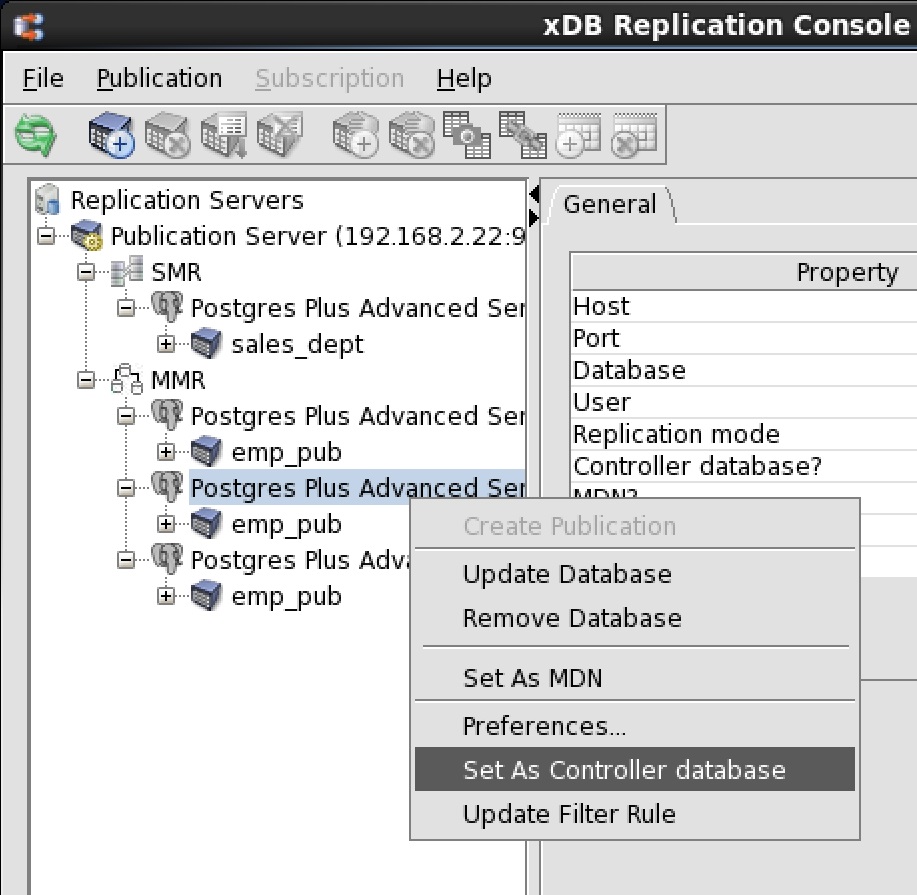
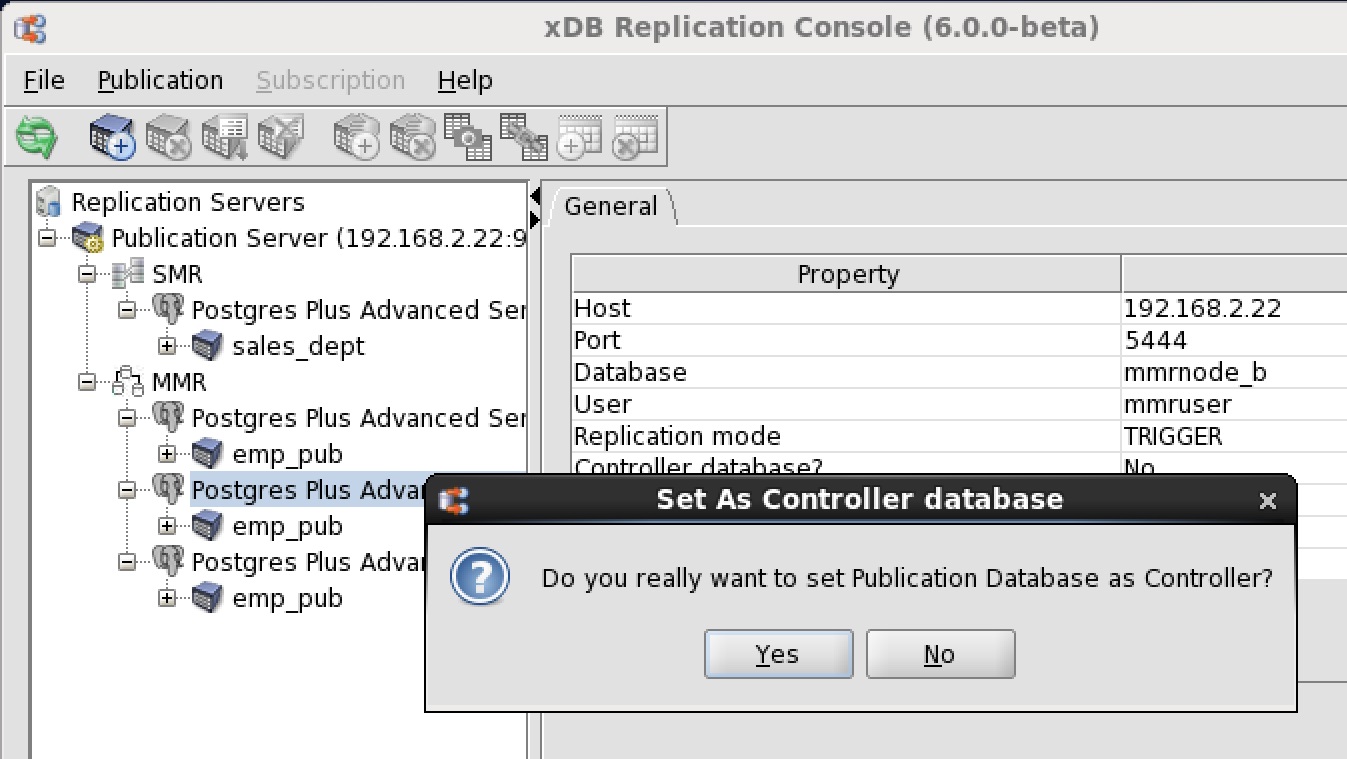
1 はじめにこのドキュメントでは、 EDB xDB Replication Server のインストール、構成、アーキテクチャ、および操作について説明し ます 。 EDB xDB(クロスデータベース)Replication Server(以降xDB Replication Serverと呼びます )は、PostgreSQL®およびEDB Postgres™Advanced Serverで使用可能な非同期レプリケーションシステムです。後者は、単にAdvanced Serverと呼ばれます 。xDB Replication Serverは、 シングルマスター (マスターからスレーブ)レプリケーションまたはマルチマスターレプリケーションの2つの異なるレプリケーションモデルのいずれかに基づいたレプリケーションシステムの実装に使用できます 。
1.1 新機能
• xDB Replication Server製品をEnterpriseDB製品ライセンスキーに登録する必要はなくなりました。したがって、製品の登録に関連するすべてのコンポーネントが削除されました。削除されたコンポーネントは次のとおりです。1)xDB Replication Consoleの[ヘルプ]メニューからアクセスする[製品登録]ダイアログボックス、2) xDB Replication構成ファイルにあるlicense_keyパラメーター、3)xDB Replication Server CLI registerkeyコマンド。
• PostgreSQLおよびAdvanced Serverバージョン10以降の 宣言型パーティション機能を使用して作成されたパーティションテーブルは、ログベースのシングルマスターまたはマルチマスター複製システムで複製できるようになりました。詳細については、セクション7.10を参照してください。
•
1.2 このガイドで使用される表記規則以下の説明では、 用語は、言語キーワード、ユーザー指定の値、リテラルなどの単語または単語のグループを指します。用語の正確な意味は、使用されるコンテキストによって異なります。
• 斜体フォントは、通常、初めて定義する文に新しい用語を導入します。
• Fixed-width (mono-spaced) fontは、SQLコマンド、例で使用される特定のテーブル名と列名、プログラミング言語のキーワードなど、文字通り指定する必要がある用語に使用されます。たとえば、 SELECT * FROM emp;
•
•
•
•
• このドキュメントの情報の多くは、PostgreSQLとEDB Postgres Advanced Serverデータベースシステムに同じように適用されます。 Advanced Server という用語は、EDB Postgres Advanced Serverを指すために使用されます。 Postgresという用語は、PostgreSQLとAdvanced Serverの両方を総称するために使用されます。これら2つのデータベースシステムを区別する必要がある場合は、特定の名前、PostgreSQLまたはAdvanced Serverが使用されます。
• PostgreSQLまたはAdvanced Server製品のインストールディレクトリパスは、 POSTGRES_INSTALL_HOME と呼ばれます。 PostgreSQL Linuxインストールの場合、デフォルトは/opt/PostgreSQL/ x .バージョン10以前のx 。それ以降のバージョンでは、PostgreSQLコミュニティパッケージを使用してください。 PostgreSQL Windowsインストールの場合、デフォルトはC:\Program Files\PostgreSQL\ x . x 。バージョン10以前の対話型インストーラーを使用して行われるAdvanced Server Linuxインストールの場合、これはデフォルトで/opt/PostgresPlus/ x . x ASまたは/opt/edb/as x . x 。 RPMパッケージを使用して行われるAdvanced Server Linuxインストールの場合、デフォルトは/usr/ppas- x . xまたは/usr/edb/as x . x 。 Advanced Server Windowsインストールの場合、デフォルトはC:\Program Files\PostgresPlus\ x . x ASまたはC:\Program Files\edb\as x . x 。製品のバージョン番号はxで表され. xまたはバージョン10以降の場合はxx 。
1.4 このガイドの使用方法
•
•
2 概要
2.1 レプリケーションを使用する理由2.1.4 Migrating Data2.1.5 Write Availability2.1.6 Write Scalability2.1.7 Localized Data Access
2.2 レプリケーションの概念と定義xDB Replication Serverは、レプリケーションシステムの実装を可能にするソフトウェア製品です。 複写システムは、その目的は、ある場所から別の場所へのデータのコピーを作成し、コピーされたデータを確保することである時間をかけてオリジナルと同じであり、ソフトウェアとハードウェアです。
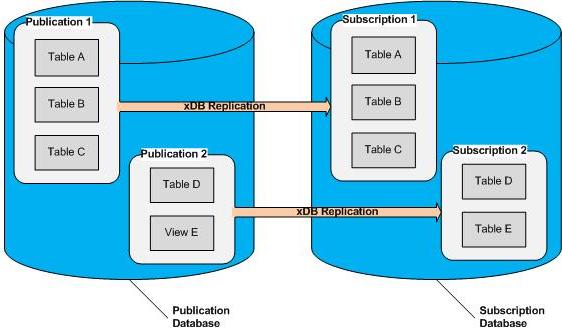
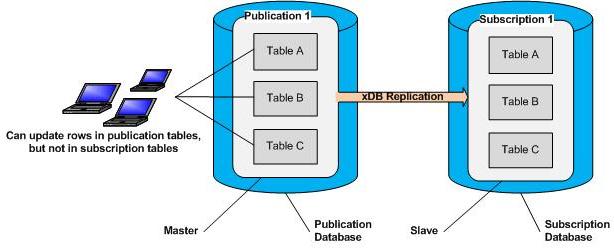
• シングルマスターレプリケーション(SMR)。テーブル行の変更(挿入、更新、および削除)は、指定されたマスターデータベースで発生することが許可されています。これらの変更は、1つ以上のスレーブデータベースのテーブルに複製されます。スレーブデータベースのレプリケートされたテーブルは、指定されたマスターデータベースを除き、変更を受け入れることができません。 (これは、マスターからスレーブへのレプリケーションとも呼ばれます。)
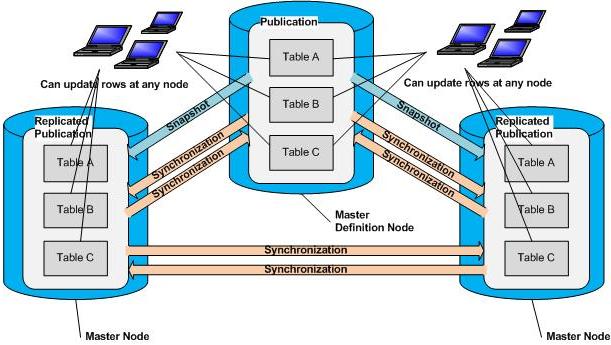
• マルチマスターレプリケーション(MMR)。同じテーブル定義と初期行セットを持つテーブルが作成される2つ以上のデータベースが指定されます。テーブル行の変更(挿入、更新、削除)は、どのデータベースでも発生することが許可されています。特定のデータベースのテーブル行に対する変更は、他のすべてのデータベースの対応するテーブルに複製されます。
•
• OracleとAdvanced Serverの間のいずれかの方向の レプリケーション
• SQL ServerとPostgreSQLの間のいずれかの方向の レプリケーション
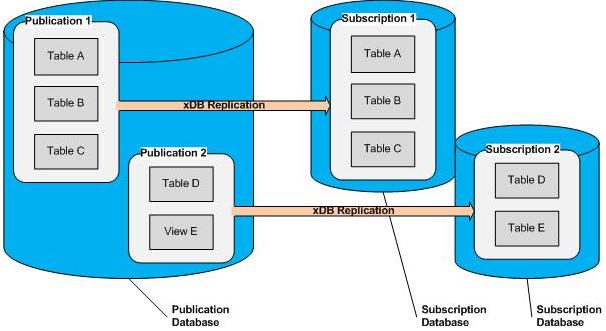
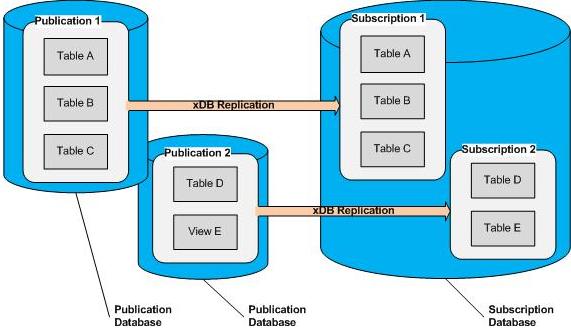
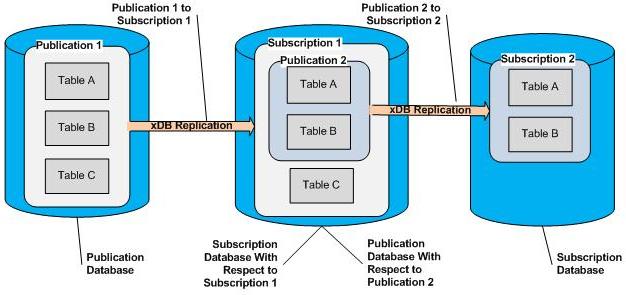
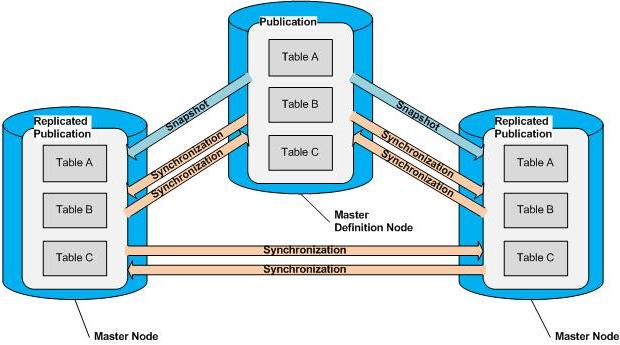
• SQL ServerとAdvanced Server間のいずれかの方向の レプリケーション注:特定のデータベースは、シングルマスター複製システムとマルチマスター複製システムの両方に同時に参加できません。xDB Replication Serverは、 publishおよびsubscribe と呼ばれるアーキテクチャを使用 します 。複製システムによるコピーに使用可能にするデータは、パブリケーションとして定義されます。そのデータのコピーを取得するには、そのパブリケーションを「サブスクライブ」する必要があります。サブスクライブの方法は、シングルマスター複製システムとマルチマスター複製システムではわずかに異なります。xDB Replication Serverでは、 パブリケーションは、データベース内の名前付きのテーブルとビューのセットとして定義されます。パブリケーションを含むデータベースは、そのパブリケーションのパブリケーションデータベースと呼ばれます 。シングルマスターレプリケーションシステムでは、xDB Replication Serverパブリケーションのコピーを取得するには、サブスクリプションを作成する必要があります。 xDB Replication Server サブスクリプションは、パブリケーションのコピー先であるデータベースへのパブリケーションの名前付き関連付けです。このデータベースは、 サブスクリプションデータベースと呼ばれます 。シングルマスターレプリケーションシステムでは、xDB Replication Serverが次のプロセスのいずれかを開始および完了すると、 レプリケーションが発生すると言われます。1)最後のレプリケーションが発生してからパブリケーションの行に加えられた変更を、サブスクリプションデータベース(同期と呼ばれる)。または2)パブリケーションの行をサブスクリプションデータベースの空のテーブルにコピーします(スナップショットと呼ばれます)。スナップショットと同期の詳細については、セクション2.2.6を参照してください。サブスクリプション・テーブルは、パブリケーション内のテーブルまたはビューに対応するから作成サブスクリプションデータベース内のテーブルです。注:シングルマスターレプリケーションシステムでは、xDB Replication Serverはパブリケーションに含まれる各ビューのサブスクリプションデータベースにテーブルを作成します。マルチマスタ複製システムでは、概念と定義データベースの任意の対の間に起こり得る1)同期(マスタノードとも呼ばれる)の複製に関与する: 複製は、以下の変更を加えたシングルマスタ複製システムとほぼ同じですシステム; 2)スナップショットは、マスター定義ノードとして指定されたパブリケーションデータベースから、他のマスターノードのいずれかに発生します。xDB Replication Serverは 、シングルマスタレプリケーションシステムが実装されている場合に、 マスタからスレーブへのレプリケーションを実行します。パブリケーションがマスターであり、サブスクリプションがスレーブです。マスターとスレーブの関係では、変更はマスターからスレーブへの一方向にのみ伝播されます。通常、パブリケーションテーブルまたはサブスクリプションテーブルの定義は変更しないでください。パブリケーションテーブルにそのような変更が行われた場合、DDL変更レプリケーション機能がセクション7.8で説明されているように使用されない限り、それらはサブスクリプションに反映されません。 DDL変更レプリケーション機能を使用せずにテーブル定義を変更すると、将来のレプリケーション試行が失敗する可能性があります。サブスクリプションテーブルの行を変更しないでください。そのような変更が行われた場合、それらはパブリケーションに反映されません。サブスクリプションテーブルの行に変更が加えられた場合、行がパブリケーションの対応する行と一致しなくなる可能性がかなり高くなります。また、将来のレプリケーションの試行が失敗するリスクもあります。2.2.4 Multi-Master Replicationマスターノードは 、マルチマスタ複製システムに参加しているデータベースです。パブリケーションが最初に定義されるデータベース(マスターノード)は、 マスター定義ノード (MDN) として特別に指定され ます 。マスター定義ノードは常に1つしか存在できませんが、どのマスターノードがマスター定義ノードであるかを変更することは可能です。マスター定義ノードと、マスター定義ノードではない他のすべてのマスターノードを区別することが重要な場合、後者は非MDNノードと呼ばれます。通常、マスター定義ノードを含むどのマスターノードのテーブル定義も変更しないでください。このような変更が行われた場合、セクション7.8で説明されているDDL変更複製機能を使用して行われない限り、それらはマルチマスター複製システム内の他のノードに伝搬されません。 DDL変更レプリケーション機能を使用せずにテーブルを変更すると、将来のレプリケーションの試行が失敗するリスクがあります。2.2.5 AsynchronousxDB Replication Serverは、レプリケーションを 非同期的に 実行し ます 。レプリケーションを正常に実行するために、データベースをホストするシステムが常に継続的に実行されている必要はありません。 1つのシステムがオフラインになった場合、複製する保留中のデータがまだあると、オンラインに戻ったときに複製が再開されます。さらに、複製システムのスケジュールを作成できます。 xDB Replication Serverは、割り当てられたスケジュールに従って定期的にレプリケーションを開始および実行します。これにより、レプリケーションシステムを無人で実行できます。スケジュールの作成方法については、セクション 7.2を参照してください 。いずれの方法でも、 ソーステーブルは、レプリケーションデータの 発信元のテーブル(シングルマスターレプリケーションシステムのパブリケーション、または変更がマルチマスターレプリケーションシステムの別のマスターノードにレプリケートされるマスターノード)を参照します。 。ターゲット表は、ソース表から複製データを受信しているテーブル(シングルマスタ複製システム、またはマルチマスタ複製システム内の他のマスタノードから変更を受信したマスターノードでサブスクリプション・テーブル)です。では スナップショットレプリケーション 、ターゲット表内のすべての既存の行は、データベース・システムの使用して削除されたTRUNCATEコマンドを。その後、テーブルはパブリケーションのソーステーブルから完全に再ロードされます。同期複製 、最後の複製以降にソース・テーブル内の行にのみ変更(挿入、更新、および削除)は、ターゲット表に適用されます。注: SQL TRUNCATEコマンドによって実行されたソーステーブルのすべての行を削除すると、同期レプリケーションのログベースの方法が使用されている場合にのみ、ターゲットテーブルへのレプリケーションが行われます。同期レプリケーションのトリガーベースの方法が使用されている場合、ソーステーブルでTRUNCATEコマンドを実行しても、ターゲットテーブルに効果が複製されません。トリガーベースの方法を使用する場合は、ソース表からターゲット表へのスナップショットを実行する必要があります。 (トリガーベースの方法とログベースの方法の違いは次のとおりです。)で トリガーベースの方法ソーステーブル内の行への変更は、行ベースのトリガの発火につながります。これらのトリガーは、シャドウテーブルの変更を記録します。その後、シャドウテーブルに記録された変更は、シャドウテーブルから定期的に抽出され、メモリ内データ構造に変換され、JDBCを使用して実行されるSQLステートメントによってターゲットテーブルに適用されます。トリガーベースの方法については、セクション2.2.9を参照してください。では 、ログベースの方法 、ソース表の行への変更は、Postgresデータベース・サーバで使用可能な論理デコード機能により実現した非同期ストリーミングレプリケーションを使用して、先行書き込みログ・セグメント(WALファイル)から抽出されています。抽出された変更はメモリ内のデータ構造に変換され、JDBCを使用して実行されるSQLステートメントによってターゲットテーブルに適用されます。ログベースの方法については、セクション2.2.10を参照してください。マルチマスター複製システムでは、すべてのマスターノードに蓄積された変更が他のすべてのマスターノードに複製される方法は、複製される変更を含むソースマスターノードによって識別されるグループで概念的に行われます。このプロセスと並列レプリケーションを使用したログベースの方法の改善については、 セクション 2.2.11を参照してください 。シングルマスター複製システムでは、新しく作成されたサブスクリプションへの最初の複製は、常にスナップショットによって行われる必要があります。セクション 2.2.7で 説明されているように、パブリケーションがスナップショットのみのパブリケーションとして定義されていない場合、その後のレプリケーションはスナップショットまたは同期によって実行できます 。パブリケーションがシングルマスターレプリケーションシステムで作成される場合、そのパブリケーションは スナップショットのみのパブリケーション として定義できます 。スナップショットのみのパブリケーションからのレプリケーションは、スナップショットレプリケーションメソッドを使用してのみ実行できます。スナップショットのみのパブリケーションでは、同期レプリケーションは許可されていません。2.2.8 Snapshot Replicationスナップショットレプリケーションでは、ソーステーブルからターゲットテーブルが完全に再ロードされます。データベースシステムの切り捨て操作は、ターゲットテーブルからすべての行を削除するために使用されます。OracleおよびSQL Serverのみ: OracleおよびSQL Serverのターゲットテーブルは、 INSERTステートメントのJDBCバッチを使用してロードされます。Postgresのみ:一般に、切り捨てとCOPYを使用すると、テーブル全体に対してSQL DELETEステートメントを実行してから、 INSERTステートメントのJDBCバッチを使用して行を追加する場合よりも一般に高速であるため、PostgresターゲットテーブルはJDBC COPYコマンドを使用してロードされます。 COPYコマンドが失敗すると、パブリケーションサーバーはINSERTステートメントのJDBCバッチを使用してスナップショットを再試行します。(データベースの種類に関係なく)ターゲットテーブルに BYTEA 、 BLOB 、 CLOB などのラージオブジェクトデータ型が含まれている場合、 INSERTステートメントを使用してバッチごとに1行ずつロードされます。これは、潜在的に大きな行に起因するヒープスペースエラーを回避するためです。ロード時間は、バッチごとに複数の挿入を許可することで短縮できます。これは、セクション5.8.1で説明されている構成オプションlobBatchSize調整することで実行できます。注: Advanced Serverは、データ型の多くのエイリアスをサポートしています。 BYTEA変換されるこのようなエイリアスは、ラージオブジェクトデータ型として扱われます。 Advanced Serverデータ型のリストについては、 『Oracle Developers Reference Databaseのデータベース互換性 』を参照してください。 (Advanced Serverバージョン9.5以前のバージョンのOracle開発者ガイドのデータベース互換性を参照してください。)特定の状況では、特定のタイプのOracleパーティションテーブル用に作成された対応するPostgresターゲットテーブルは、継承されたテーブルのセットです。これらの場合、切り捨てられるのではなく、継承された子テーブルでSQL DELETEステートメントが使用されます。 Oracleパーティションテーブルの複製に関する追加情報については、セクション10.4.1.4を参照してください。サーバー構成オプションを使用すると、スナップショットレプリケーションプロセスで、JDBC COPY 代わりにOracleデータベースリンクユーティリティを使用して 、OracleパブリケーションからPostgresターゲットテーブルにデータを取り込むことができます。 Oracleデータベースリンクにより、JDBC COPYよりもパフォーマンスが向上します。 Oracleデータベースリンクオプションの使用については、セクション5.8.1を参照してください。パブリケーションサーバーは、トリガーが作成されたソーステーブルごとにシャドウテーブルも作成します。 シャドウ・テーブルは、所与のソース・テーブルに加えられた変更(挿入、更新、および削除)を記録するXDBのReplication Serverで使用されるテーブルです。シャドウテーブルは、3種類の記録画像を記録します。ソーステーブルに挿入された各行について、シャドウテーブルは挿入された行の画像を記録します。ソーステーブルで更新される既存の各行について、シャドウテーブルは更新された行の変更後イメージを記録します。ソース表から削除された各行について、シャドー表は削除された行の主キー値を記録します。注:マルチマスターレプリケーションシステムでは、更新の競合検出を実行するために、更新された行の変更前イメージもシャドウテーブルに格納されます。マルチマスターレプリケーションシステムでの競合検出については、セクション6.6を参照してください。最後のレプリケーションが発生してからソーステーブルに加えられた変更は、SQL INSERT 、 UPDATE 、およびDELETEステートメントを使用してターゲットテーブルに適用されますが、ターゲットテーブルに対して実行される実際のSQLステートメントは、ソーステーブルに対して実行されたSQLステートメントとは異なります。同期レプリケーションが発生すると、パブリケーションサーバーは 、ターゲットテーブルに対してSQLステートメントのJDBCバッチ( トランザクションセット とも呼ばれます)を実行します 。バッチには、挿入操作を記録する各シャドウテーブル行のINSERTステートメント、更新操作を記録する各シャドウテーブル行のUPDATEステートメント、および削除操作を記録する各シャドウテーブル行のDELETEステートメントが含まれます。各バッチは1つのトランザクションで実行されます。注:ソース表に対して実行された単一のSQLステートメントは、シャドウ表に多くの行を記録する可能性があり、したがって、ターゲット表に対して実行された多くのSQLステートメントになります。たとえば、単一のUPDATEステートメントがソーステーブルの10行に影響する場合、10行がシャドウテーブルに挿入されます(更新されたソーステーブルの各行に1行)。パブリケーションサーバーがターゲットテーブルに変更を適用すると、10個のUPDATEステートメントが実行されます。注:効率を高めるために、ソーステーブルへの変更がそれぞれ多数の行に影響するSQLステートメントで構成されている場合、パブリケーションサーバーは準備されたSQLステートメントの使用を使用できます。準備されたSQL文の使用を制御する方法の指示、および同期レプリケーションを最適化するための他の様々な構成オプションの情報については、セクション5.8.2を参照してください。PostgreSQL 9.4では、 論理デコード ( 論理複製または変更セット抽出とも呼ばれます)と呼ばれる機能が導入されました 。この機能は、先読みログセグメント(WALファイル)から読み取り可能な形式でデータ操作言語(DML)の変更を抽出する機能を提供します。2.2.10.1 Requirements and Restrictions
• トリガーベースの方法またはログベースの方法の選択は、パブリケーションデータベースのみに適用される特性です。シングルマスター複製システムのマスターデータベース(セクション 5.2.2を 参照 )またはマルチマスター複製システムのマスター定義ノード(セクション6.2.2を参照)を定義するときに選択します 。
• シングルマスターレプリケーションシステムでは、マスターデータベースがトリガーベースの方法を使用するか、ログベースの方法を使用するかは、セクション 10.1で 説明されているサブスクリプションデータベースの選択ルールに追加の影響を与えません 。たとえば、masterデータベースにログベースの方法が選択されている場合でも、サブスクリプションデータベースは、Postgresバージョン9.4、およびサポートされている以前のバージョンのPostgres、および10.1項で説明したOracleまたはSQL Serverで実行されている可能性があります。Postgresデータベースサーバーで実行されているパブリケーションデータベースでログベースの方法を使用する場合、そのPostgresデータベースサーバーの構成ファイル postgresql.confで次の構成パラメーター設定が必要です 。
•
• max_wal_senders。同時接続の最大数(つまり、同時に実行されているWAL送信プロセスの最大数)を指定します。ログベースの方法を使用するこのデータベースサーバー上のシングルマスターレプリケーションシステムのマスターデータベースとマルチマスターレプリケーションシステムのマスターノードの合計数に、少なくとも設定します。
• max_replication_slots。複製スロットの最大数を指定します。データベースサーバーがシングルマスターレプリケーションシステムとマルチマスターレプリケーションシステムの両方をサポートする場合、 max_replication_slotsは両方のレプリケーションシステムの要件の合計に少なくとも設定する必要があります。 SMRシステムをサポートするための最小要件は、ログベースの方法を使用するシングルマスターレプリケーションシステムのマスターデータベースの総数です。 MMRシステムをサポートするための最小要件は、マルチマスターレプリケーションシステム内のマスターノードの総数に、このデータベースサーバーにあるマスターノードの数を掛けたものです。詳細については、セクション2.2.10.4を参照してください。
• track_commit_timestamp。 on設定onます。この構成パラメーターは、バージョン9.5のPostgresデータベースサーバーにのみ適用されます。詳細については、セクション6.6.1を参照してください。さらに 、Postgresデータベースサーバーの pg_hba.conf構成ファイルには、データベースサーバーで実行されているログベースの方法を使用して各データベースのREPLICATIONアクセスを許可するエントリが含まれている必要があります。 xDBレプリケーションコンソールを使用してパブリケーションデータベース定義を作成するときに指定したパブリケーションデータベースユーザー(シングルマスターレプリケーションシステムについてはセクション5.2.2 、マルチマスターレプリケーションシステムについてはセクション6.2.2を参照)にアクセスを許可する必要があります。 xDB Replication Serverコマンドラインインターフェイス(CLI)(セクション8.3.6を参照)。シングルマスター複製システムのREPLICATIONアクセスの設定については、セクション 5.1.6.3を参照してください 。マルチマスター複製システムについては、セクション6.1.5を参照してください。2.2.10.2 Logical Replication Slots論理複製スロットチェンジストリームを表し、単一のデータベースに適用されます。 xDB Replication Serverは、 xdb_ dboid _ pubid形式で作成する各論理レプリケーションスロットにスロット名と呼ばれる一意の識別子を割り当てますdboidはパブリケーションデータベースオブジェクト識別子(OID)で、 pubidはxDB Replicationによって割り当てられたパブリケーションIDです。サーバ。すべてのスロット名は、Postgresデータベースクラスター内で一意です。データベースサーバーに許可されるレプリケーションスロットの最大数は 、 postgresql.confファイルのmax_replication_slots構成パラメーターによって制御されます。したがって、この構成パラメーターは、データベースサーバー上で実行されるシングルマスターレプリケーションシステムのログベースの方法で定義されたすべてのパブリケーションデータベースと、定義されたマルチマスターレプリケーションシステムのすべてのマスターノードを説明するのに十分な値に設定する必要がありますデータベースサーバーで実行されているログベースの方法で。複製元の使用をサポートするには、追加の複製スロットが必要です(セクションを参照 2.2.10.4 )。シングルマスター複製システムの構成パラメーターに関する追加情報については、セクション5.1.2を参照してください。マルチマスター複製システムについては、セクション6.1.2を参照してください。
1。
2。
4。 次のスケジュールされた間隔で 、トリガーベースのセクション2.2.9で説明したのと同じ方法で、 メモリ内のキャッシュされたデータの変更がSQLステートメントのJDBCバッチ( トランザクションセット と呼ばれ ます )の各ターゲットデータベースに適用されます方法。 1つ以上のターゲットデータベースサーバーにアクセスできない場合、データの変更は、パブリケーションサーバーを実行しているホスト上のローカルファイルに保存されます。インメモリキャッシュとデータ永続性については、セクション2.2.10.5を参照してください。注:ソーステーブルに対して実行された単一のSQLステートメントは、変更セットストリームで多くの行が変更されて返される可能性があるため、ターゲットテーブルに対して実行された多くのSQLステートメントがあります。たとえば、単一のUPDATEステートメントがソーステーブルの10行に影響する場合、 UPDATEれたソーステーブルの行ごとに1行、変更セットストリームに10行が返されます。パブリケーションサーバーがターゲットテーブルに変更を適用すると、10個のUPDATEステートメントが実行されます。2.2.10.4 Replication OriginPostgresバージョン9.5から、 複製オリジン と呼ばれる機能が論理デコードフレームワークに導入されました。複製元により、アプリケーションは論理デコードセッションの特定の側面を識別、ラベル付け、およびマークできます。前述のように、ログベースの方法では、WALファイルを使用してパブリケーションテーブルに適用された変更を取得します。 walsenderインターフェースを介して変更を取得した後、パブリケーションサーバーは、SQLステートメントのJDBCバッチで構成されるトランザクションセットを使用して、他のマスターノードに変更セットを適用します。これらの変更が他のターゲットマスターノードのテーブルに適用されると、同じ変更がターゲットマスターノードをホストする各データベースサーバーのWALファイルにも記録されます。
• max_replication_slots構成パラメータは、パブリケーションサーバは、複製起点のための追加のレプリケーション・スロットを作成できることを保証するために一定の最低レベルに設定しなければなりません。マスターノードの総数は6です。各データベースクラスターのマスターノードデータベースの数に6を max_replication_slots 、そのデータベースクラスターのmax_replication_slots 必要な最小設定を与えます。
場合 max_replication_slotsパラメータが十分に高い値に設定されていない、同期レプリケーションはまだ成功しますが、複製起点のパフォーマンスの利点なし。複製起点名形式で割り当てられ xdb_ srcdbname _ pubname _ remotedbid srcdbnameソースデータベースの名前であり、 pubnameパブリケーション名、 remotedbidリモート・データベースのパブリケーションデータベースのIDです。2.2.10.5 In-Memory Caching and PersistencexDB Replication Serverアーキテクチャは、Java オブジェクトのシリアル化を利用して 、データのメモリ内状態を保持します。オブジェクトのシリアル化とは、オブジェクトデータやその他の関連情報を一連のバイトに変換し、ファイルに保存できるようにすることです。キャッシュサイズは、xDBスタートアップ構成ファイルのJAVA_HEAP_SIZEパラメーターの-Xmx nnn m設定によってパブリケーションサーバーに構成されたヒープサイズに対応します。 xDBスタートアップコンフィギュレーションファイルの詳細については、セクション2.3.1.4を参照してください。ヒープサイズの値を増やし、数秒ごとなどのより頻繁な同期間隔を定義することにより、永続性のI / Oオーバーヘッドを最小限に抑えることができます。レプリケーションスケジュールの設定については、セクション 7.2を参照してください 。これは、一連の複数のレプリケーションセットで構成され、それぞれがソースマスターノードとして機能するマスターノードによって識別され、ターゲットマスターノードとして機能する他のすべてのマスターノードにレプリケーションする必要があるトランザクションが含まれます。したがって、 n個のマスターノードで構成されるマルチマスターレプリケーションシステムの n 、 nそのようなレプリケーションセットがあり、それぞれがソースとして機能する異なるマスターノードを持ちます。待ち時間 全体と呼ばれる複製イベント全体を完了する時間は、基本的に各マスターノードがソースとして機能する複製時間の合計です(つまり、ステップ1、2、および3の時間の合計) 。ログベースの方法では、ソースとして機能する特定のマスターノードからの各レプリケーションセットが、他のマスターノードが機能する他のすべてのレプリケーションセットと同時に実行および実行される 並列レプリケーション の実装により、この待ち時間が短縮されました。ソース。注:並列レプリケーションに加えて、特定のマスターノードから他のすべてのマスターノードへの(つまり、単一のレプリケーションセットのコンテキスト内での)レプリケーションの最適化は、複数のスレッドを使用して実装されています。これは、 並列同期と呼ばれます。並列同期は、トリガーベースの方法とログベースの方法の両方に適用されます。パラレル同期の詳細は、 5.8.2.2項を参照してください。2.2.12 Table Filtersテーブルフィルターは、シングルマスターレプリケーションシステムのパブリケーションデータベースからのサブスクリプションへのレプリケーション中、またはマルチマスターレプリケーションシステムのマスターノード間に含まれるパブリケーションテーブルまたはビューの行の選択基準を指定します。選択基準を満たさない行は、これらのテーブルフィルターが有効になっているサブスクリプションまたはマスターノードへのレプリケーションから除外されます。2.2.12.1 Implementing Table Filtersテーブルフィルタの実装は2つの部分から成るプロセスです。まず、使用可能なテーブルフィルターのセットを定義する必要があります。これは、SQL WHERE句の形式で表される選択されたパブリケーションテーブルまたはビューに適用可能な特定の名前付きルールを定義することにより、パブリケーションの作成プロセス中に実行できます 。注(MMRのみ):マルチマスター複製システムでテーブルフィルターを使用する場合、スナップショットのテーブルコンテンツのソースを提供するマスター定義ノードには、他のマスターノードに含まれるすべてのデータのスーパーセットが含まれている必要がありますマルチマスター複製システムの。これにより、スナップショットのターゲットは、他のマスターノードで有効になっているフィルタリング基準を満たすすべてのデータを確実に受信します。2.2.12.2 Effects of Table Filtering場合 INSERTステートメントは、同期複製に続いて、ソーステーブルに実行され、行は、行満たすフィルタリング基準場合、同期の対象テーブルに挿入されます。それ以外の場合、行はターゲット表への挿入から除外されます。したがって、ソーステーブルのトランザクションが INSERT 、 UPDATE 、またはDELETEステートメントであるかどうかに関係なく 、テーブルフィルターの目的は、ターゲットテーブル内のすべての行がフィルタールールを満たすことです。同期レプリケーションのログベースの方法を使用するレプリケーションシステムの場合、フィルタを定義するパブリケーションテーブルの REPLICA IDENTITYオプションをFULL設定する必要があります。注意:このREPLICA IDENTITY FULL設定は、シングルマスターのスナップショットのみのパブリケーションの表には必要ありません。スナップショットのみのパブリケーションの詳細は、 2.2.7項を参照してください。REPLICA IDENTITY設定は、使用してPSQLユーティリティで表示することができます\d+コマンドを:REPLICA IDENTITY FULL設定は、ログ・ベースのレプリケーション・システムの以下のデータベース内のテーブルの上に必要です。
• シングルマスターレプリケーションシステムでは、テーブルフィルターはmasterデータベースで定義されます。したがって、フィルター定義を必要とするmasterデータベースのパブリケーションテーブルは 、パブリケーションがスナップショットのみのパブリケーションでない場合にのみ、 REPLICA IDENTITY FULL設定に変更する必要があります 。スナップショットのみのパブリケーションについては、セクション2.2.7を参照してください。
• マルチマスターレプリケーションシステムでは、テーブルフィルターはマスター定義ノードで定義されます。したがって、フィルター定義を必要とするマスター定義ノードのパブリケーションテーブルは、 REPLICA IDENTITY FULL設定に変更する必要があります 。
• マルチマスターレプリケーションシステムでは、トランザクションがそれらの非MDNノードを対象とすることが予想される場合を除き、非MDNノードのテーブルの REPLICA IDENTITYオプションをFULL設定しないでください。他のマスターノード。ソーステーブルの REPLICA IDENTITY FULL設定により、ソーステーブルの特定のタイプのトランザクションが、フィルターが有効になっているターゲットテーブルに適切に更新されます。注:テーブルのフィルタリング要件に加えて、xDB Replication Serverの他の理由により、パブリケーションテーブルでREPLICA IDENTITY FULL設定が必要になる場合があります。追加の要件については、セクション6.6.1を参照してください。テーブルフィルターは、バイナリデータ型の列ではサポートされていません。バイナリデータ型は、Postgresデータ型 BYTEAです。さらに、テーブルフィルタは、データ型がBINARY 、 VARBINARY 、 BLOB 、 LONG RAW 、およびRAW Advanced Server列ではサポートされていません。これらはBYTEAデータ型のエイリアス名であるためです。2.2.12.4 Roadmap for Further Instructions
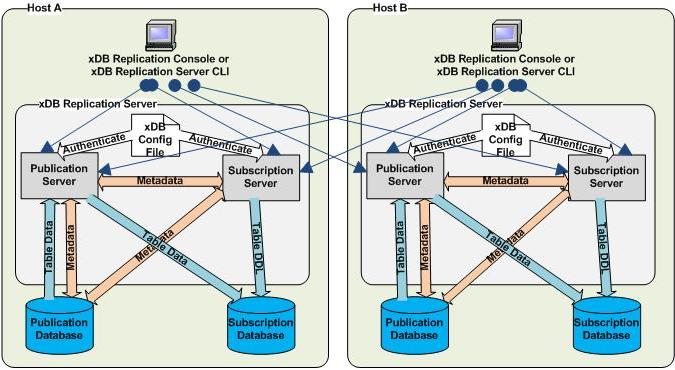
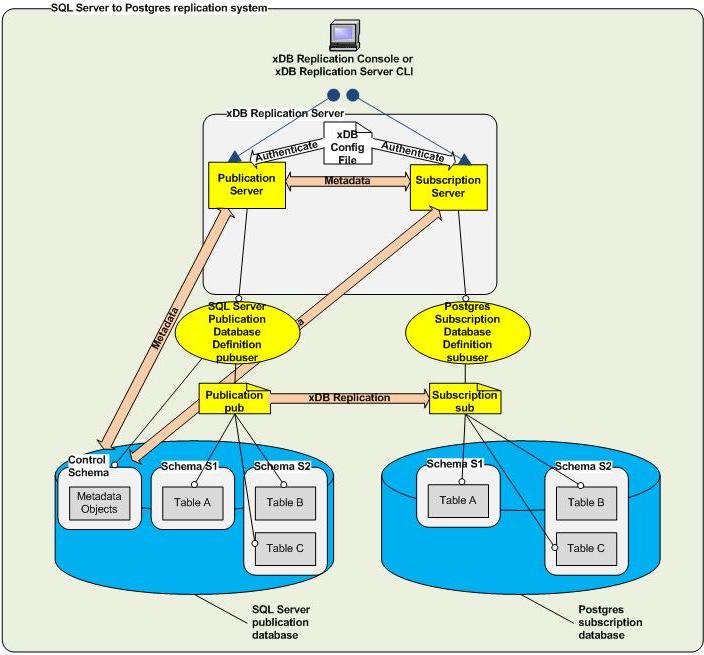
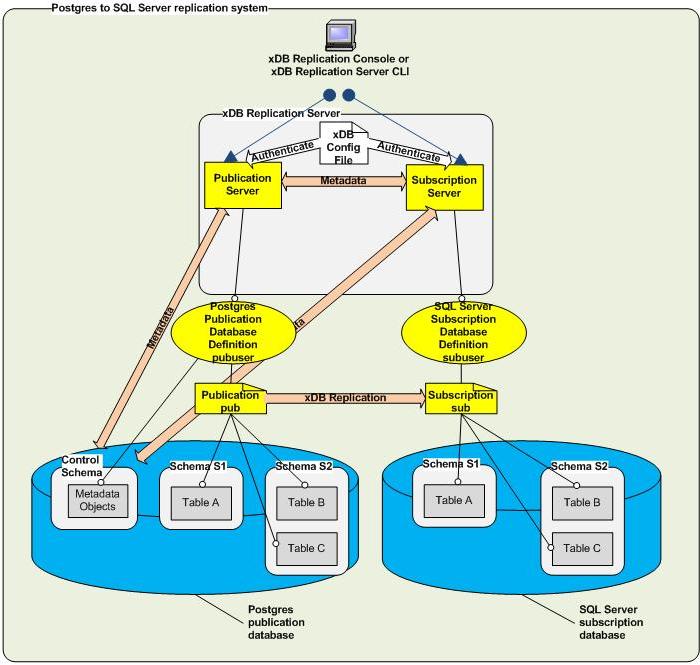
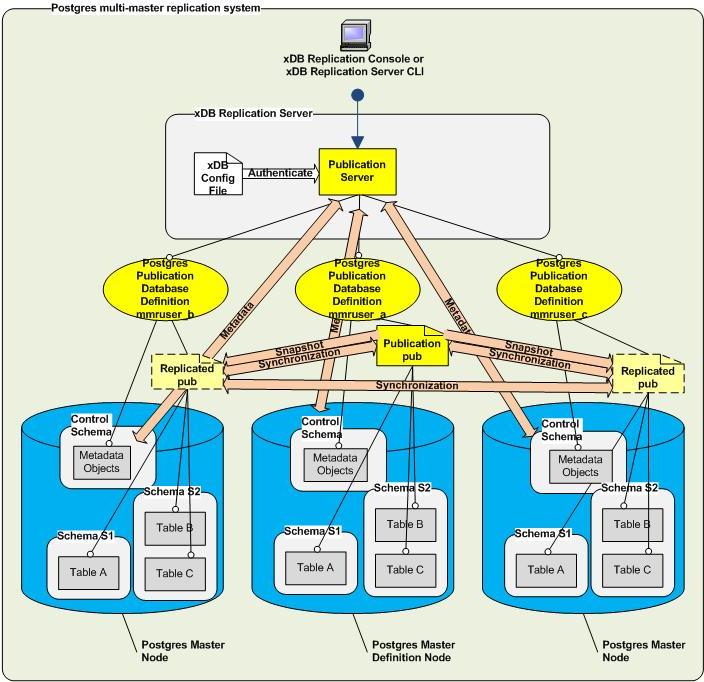
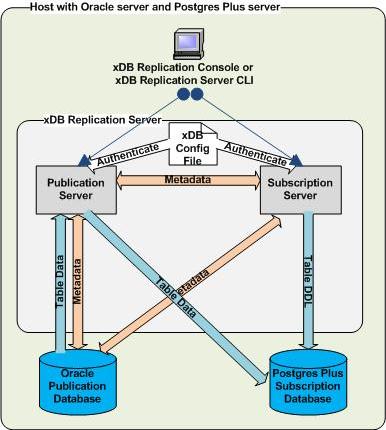
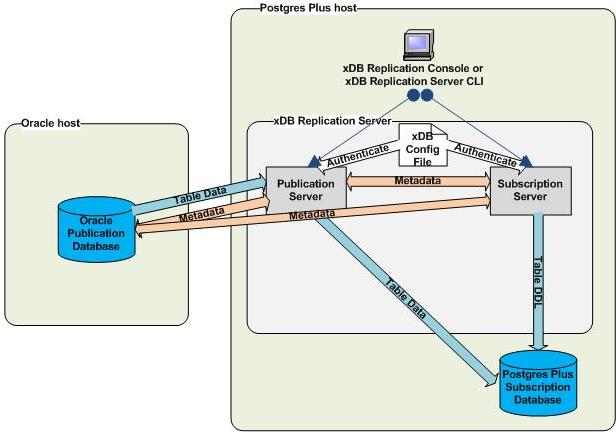
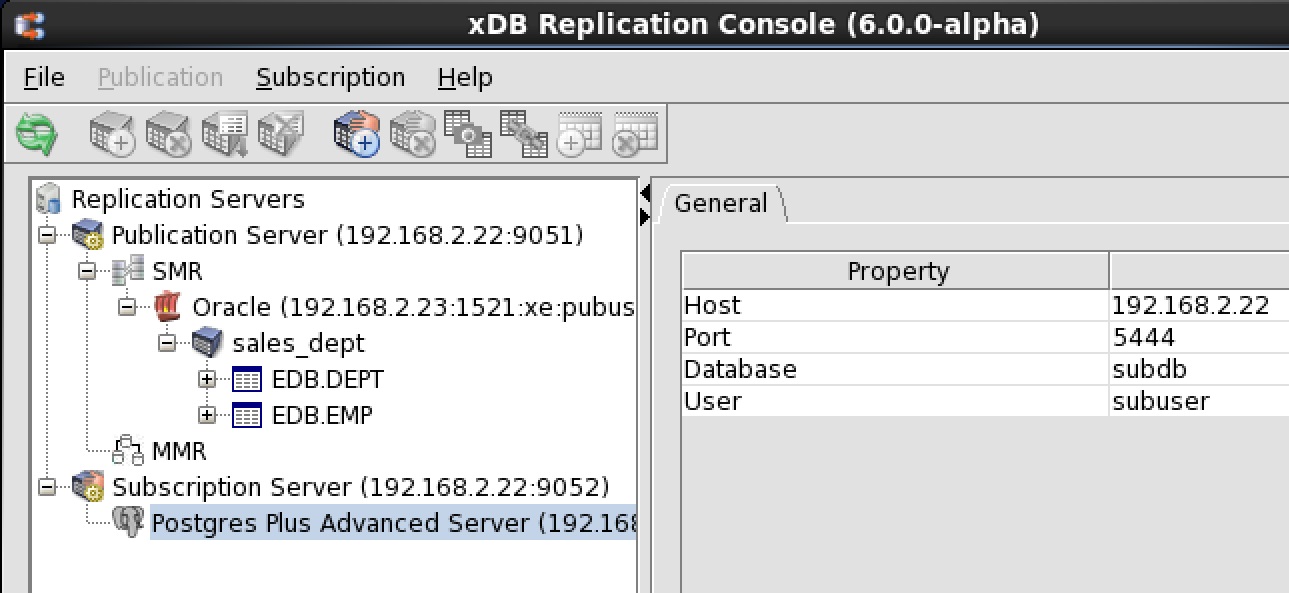
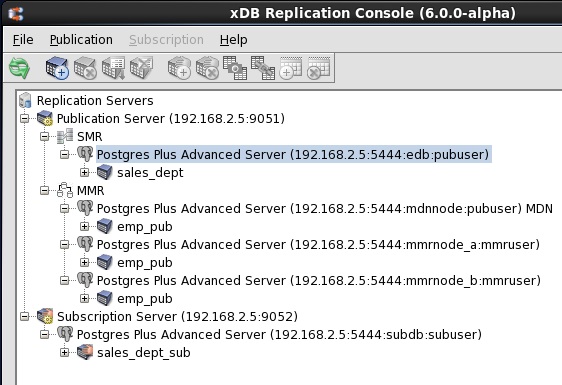
このセクションでは、xDB Replication Serverのコンポーネントとアーキテクチャについて説明します。セクション 2.3.1では、xDB Replication Serverを構成する実行可能プログラム、ファイル、およびデータベースについて説明します。セクション2.3.2では、複製システムの論理コンポーネントと、それらがプログラムおよびデータベースにどのように対応するかを定義します。セクション2.3.3は、複製システムの例を示しています。2.3.1 Physical Components
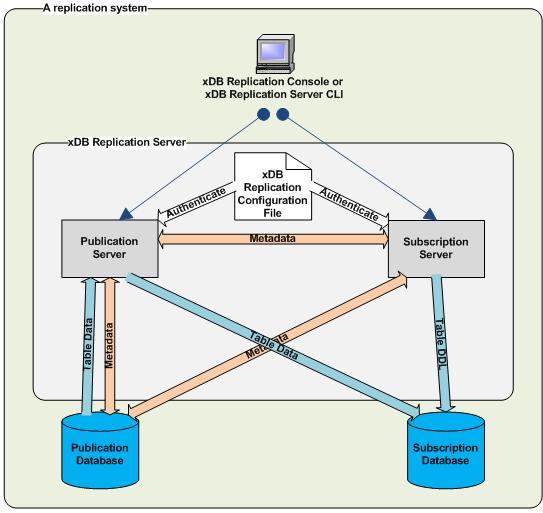
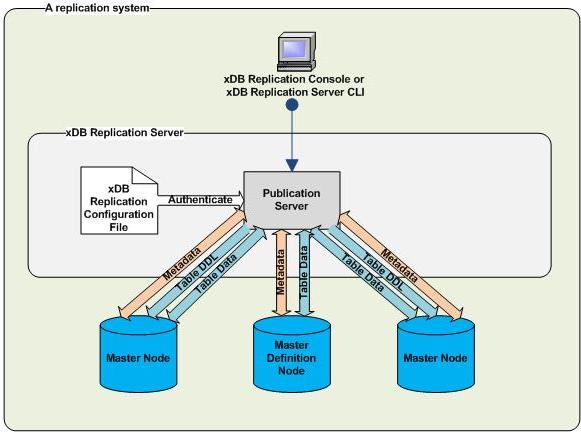
• 出版サーバー。パブリケーションデータベースとマスターノードをレプリケーション用に構成し、レプリケーションを実行するプログラム。
• サブスクリプションサーバー。レプリケーション用にサブスクリプションデータベースを構成し、レプリケーションを開始するプログラム。サブスクリプションサーバーは、シングルマスターレプリケーションシステムでのみ使用されます。
• xDBレプリケーション構成ファイル。コントローラーデータベースとして指定されたパブリケーションデータベースに接続するために、起動時にパブリケーションサーバーおよびサブスクリプションサーバーによって使用される接続および認証情報を含むテキストファイル。レプリケーションシステムを作成するときに、ユーザーインターフェイスからパブリケーションサーバーとサブスクリプションサーバーの登録を認証するためにも使用されます。
• xDBスタートアップコンフィギュレーションファイル。パブリケーションサーバーおよびサブスクリプションサーバーの起動時にJavaランタイム環境に使用されるインストールおよび構成情報を含むテキストファイル。2.3.1.1 Publication Server2.3.1.2 Subscription Server注:サブスクリプションサーバーは、シングルマスターレプリケーションシステムにのみ必要です。サブスクリプションサーバーを実行する必要はありません。また、マルチマスターレプリケーションシステムのみが使用されている場合はインストールする必要もありません。
•
• パラメータ database 、 user 、 password 、 port 、 host 、およびtypeは、xDB Replication ConsoleまたはxDB Replication Server CLIで作成した最初のパブリケーションデータベース定義の接続および認証情報で設定されます。このデータベースは、コントローラーデータベースとして指定されています。コントローラデータベースの詳細については、セクション2.3.1.12を参照してください。シングルマスターレプリケーションシステムのパブリケーションデータベース定義の作成については、セクション5.2.2を参照してください。マルチマスターレプリケーションシステムのパブリケーションデータベース定義の作成については、セクション6.2.2を参照してください。注:管理者ユーザー名とコントローラーデータベースユーザー名のパスワードは暗号化されています。これらのパスワードのいずれかを変更した場合、xDBレプリケーション構成ファイル内の対応するパスワードパラメーターを変更して、新しいパスワードの暗号化された形式を含める必要があります。パスワードの暗号化形式を生成する方法については、セクション10.4.2を参照してください。2.3.1.4 xDB Startup Configuration File
In -Xms NNN m nnn specifies the minimum Java heap size in megabytes. In -Xmx NNN m nnn specifies the maximum Java heap size in megabytes JAVA_EXECUTABLE_PATHパラメータは、インストールプロセス中にXDB Replication Serverのインストーラによって識別されるJavaランタイムプログラムの場所を指定します。このパラメーターの設定は、必要に応じて別のJREインストールに後で変更できます。JAVA_MINIMUM_VERSIONパラメータは、XDB Replication Serverのに使用することができますJavaランタイム環境の最も古いバージョンを指定します。この設定は変更しないでください。JAVA_BITNESS_REQUIREDパラメータは変更しないでください。インストールされた値が変更された場合、またはJAVA_EXECUTABLE_PATHで識別されるJava仮想マシンのJAVA_EXECUTABLE_PATH数と一致しない場合、パブリケーションおよびサブスクリプションサーバーの起動の失敗やxDBレプリケーションの登録の失敗など、多くのエラーが発生する可能性がありますサーバー製品。2.3.1.5 xDB Replication Console2.3.1.7 Publication Database各パブリケーションデータベースには、コントロールスキーマも含まれます。これは、このパブリケーションデータベースに接続されているパブリケーションサーバーによって制御される、シングルマスターとマルチマスターの両方のすべてのレプリケーションシステムのメタデータを含むデータベースオブジェクトのコレクションです。制御スキーマの詳細は、 2.3.1.11 項を参照してください 。2.3.1.8 Subscription Database注:サブスクリプションデータベースは、シングルマスターレプリケーションシステムにのみ適用されます。2.3.1.9 Master Node各マスターノードには、コントロールスキーマも含まれます。これは、このマスターノードに接続されたパブリケーションサーバーによって制御される、シングルマスターとマルチマスターの両方のすべてのレプリケーションシステムのメタデータを含むデータベースオブジェクトのコレクションです。制御スキーマの詳細は、 2.3.1.11 項を参照してください 。2.3.1.10 Master Definition Nodeすべてのマスターノードと同様に、マスター定義ノードにはコントロールスキーマが含まれます。これは、このマスターノードに接続されたパブリケーションサーバーによって制御される、シングルマスターとマルチマスターの両方のすべてのレプリケーションシステムのメタデータを含むデータベースオブジェクトのコレクションです制御スキーマの詳細は、 2.3.1.11 項を参照してください 。制御スキーマは、論理的および物理的な構造を定義するメタデータ・データベース・オブジェクトのコレクションを指す概念的な用語であり、そしてXDB Replication Serverのシングルマスタおよびマルチマスタ複製システムの運用・保守を可能にします。注:ログベースのシングルマスターおよびマルチマスターレプリケーションシステムの場合、変更はコントロールスキーマオブジェクトに保存されるのではなく、データベースサーバーのWALファイルから抽出されます。ログベースの方法については、セクション2.2.10を参照してください。
•
• シングルマスターレプリケーションシステムのスレーブ(サブスクリプション)データベースには、メタデータデータベースオブジェクトとして1つの単一のテーブルが含まれています。 サブスクリプションメタデータオブジェクト という用語は、 サブスクリプションデータベース内のこのデータベースオブジェクトを指すために特に使用されます。一般的な用語、コントロールスキーマ、およびコントロールスキーマオブジェクトは、パブリケーションデータベース内のデータベースオブジェクトを指します。2.3.1.12 Controller Database現在のコントローラーデータベースのパブリケーションデータベース定義を削除する場合は、xDBレプリケーションコンソールを使用して、最初に同じパブリケーションサーバーで定義された別のパブリケーションデータベースをコントローラーとして指定する必要があります。コントローラを別のパブリケーションデータベースに切り替える方法については、セクション 7.7を参照してください 。
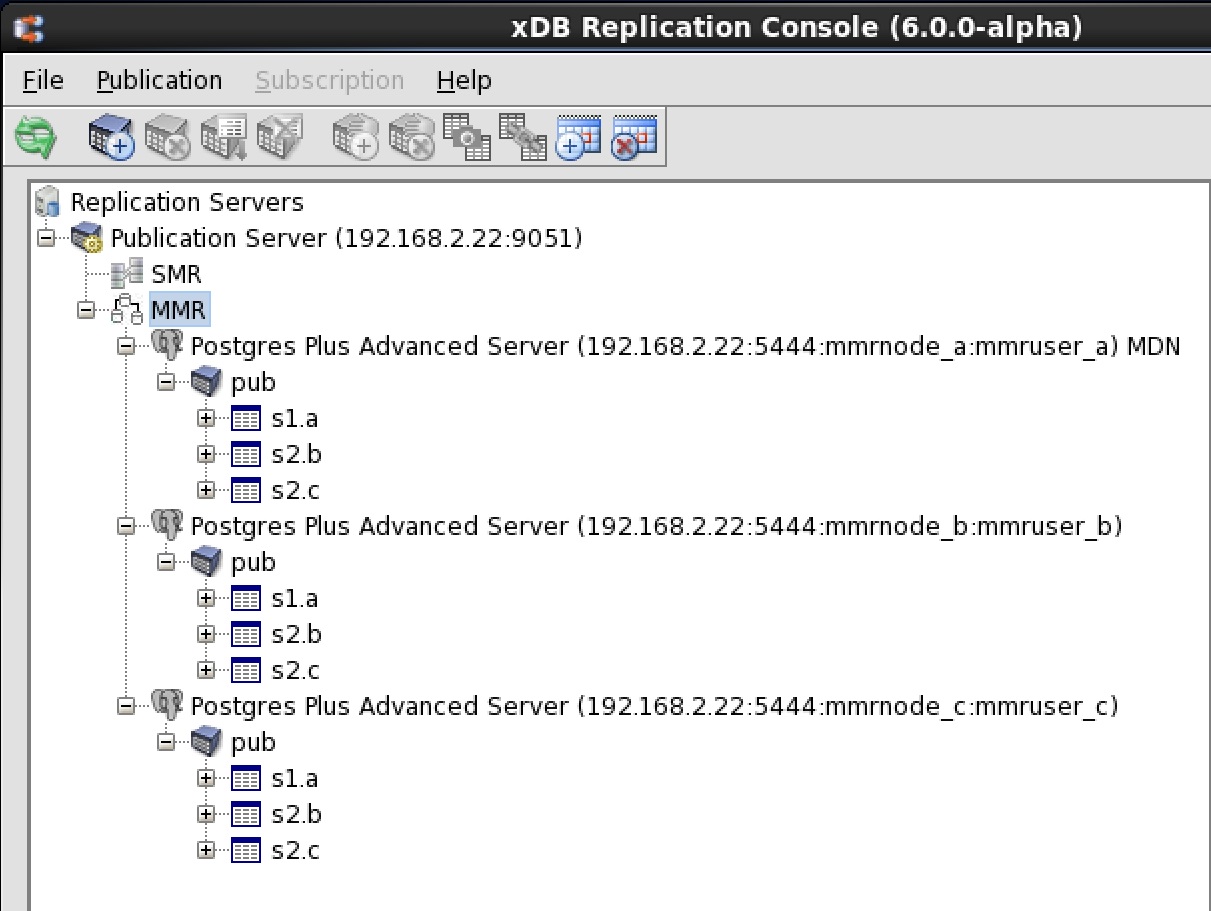
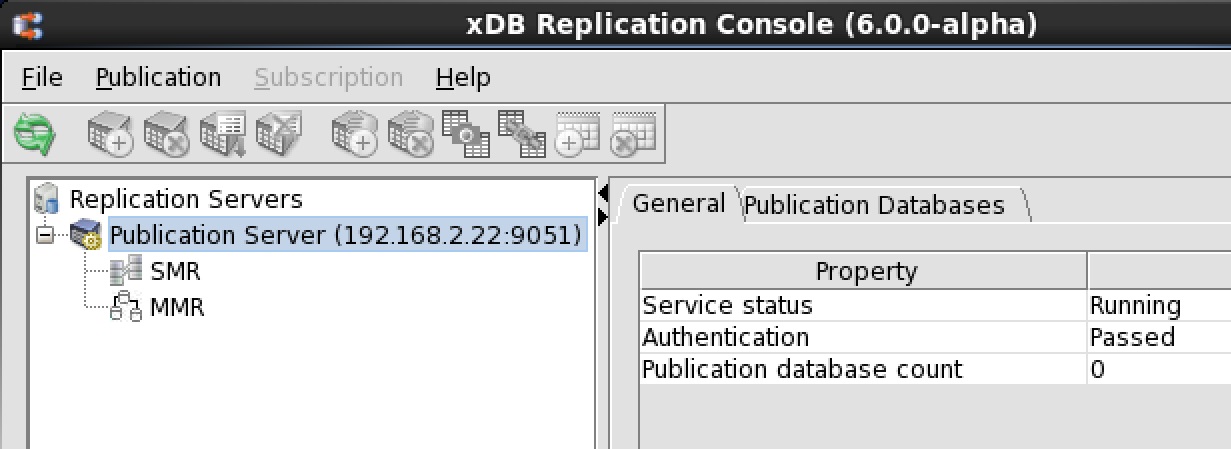
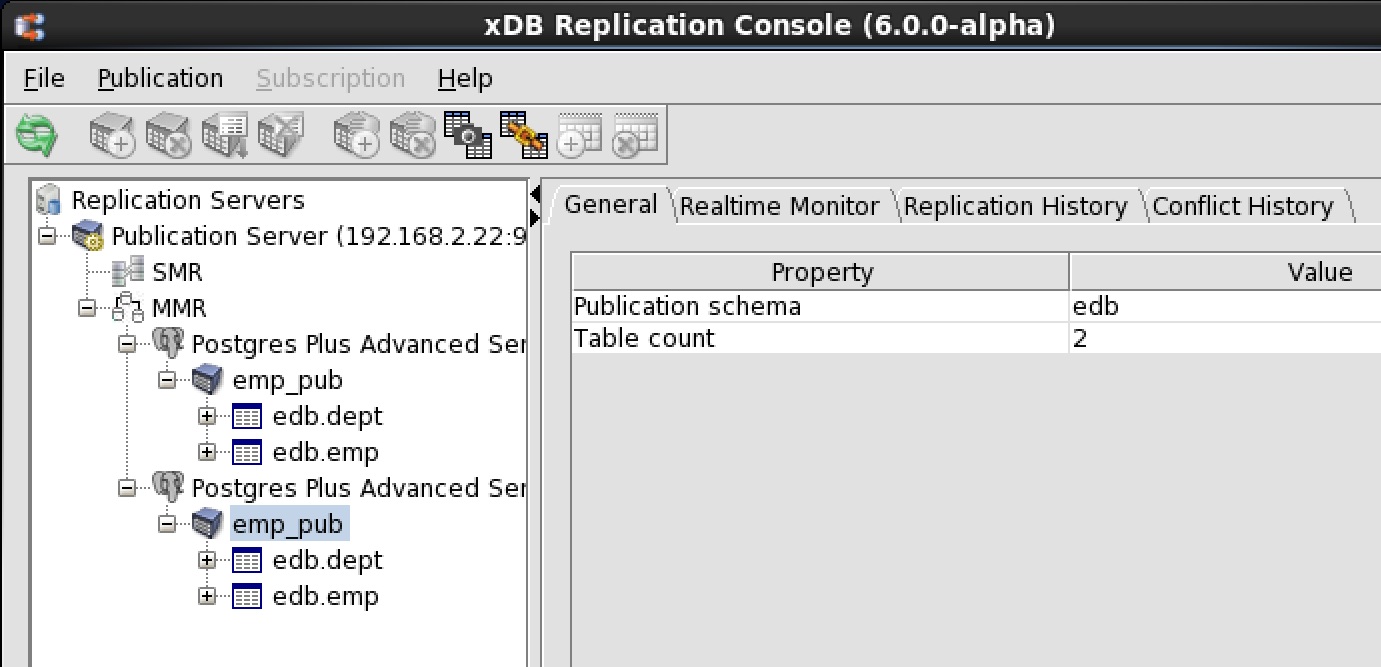
• 注:コントローラーデータベースがOracleまたはSQL Serverパブリケーションデータベースの場合、2番目のOracleまたはSQL Serverパブリケーションデータベースを追加して、2番目のシングルマスターレプリケーションシステムを作成することはできません。 xDB Replication ServerがOracleまたはSQL Serverパブリケーションデータベースで構成される複数のシングルマスタレプリケーションシステムを実行するには、Postgresパブリケーションデータベースをコントローラーデータベースとして指定する必要があります。2.3.2 Logical Componentsこれらの各手順は、xDBレプリケーションコンソールのレプリケーションツリーのノードで表される論理コンポーネントを作成します。 xDB Replication Consoleの説明については、 第 4 章を参照してください 。これらのコンポーネントの簡単な説明は、次のセクションで説明します。2.3.2.1 Publication Server登録されたパブリケーションサーバーの下位に、レプリケーションシステムタイプを表す2つのノードが表示されます。 1つはシングルマスター複製のラベル SMRで識別され、もう1つはマルチマスター複製のラベルMMRで識別されます。2.3.2.3 Publication Database Definition注:現在、パブリケーションサーバーごとに1つのマルチマスターレプリケーションシステムしか存在できません。セクション 5.2.2では、シングルマスターレプリケーションシステムのパブリケーションデータベース定義の作成について説明します。マルチマスター複製システムについては、セクション6.2.2および6.3を参照してください。2.3.2.4 Publicationシングルマスターレプリケーションシステムでは、レプリケーションツリーで表示されるパブリケーションの親のパブリケーションデータベース定義で指定されたデータベースユーザー名には、パブリケーションに含まれるテーブルまたはビューに対するSELECTオブジェクト権限が必要です。2.3.2.5 Subscription Server注:サブスクリプションサーバーは、シングルマスターレプリケーションシステムにのみ適用されます。マルチマスターレプリケーションシステムを作成するとき、サブスクリプションサーバーを登録しません。2.3.2.6 Subscription Database Definition注:サブスクリプションデータベースの定義は、シングルマスターレプリケーションシステムにのみ適用されます。マルチマスターレプリケーションシステムを作成する場合、サブスクリプションデータベース定義は作成しません。2.3.2.7 Subscription注:サブスクリプションは、シングルマスター複製システムにのみ適用されます。マルチマスター複製システムを作成するとき、サブスクリプションを作成しません。
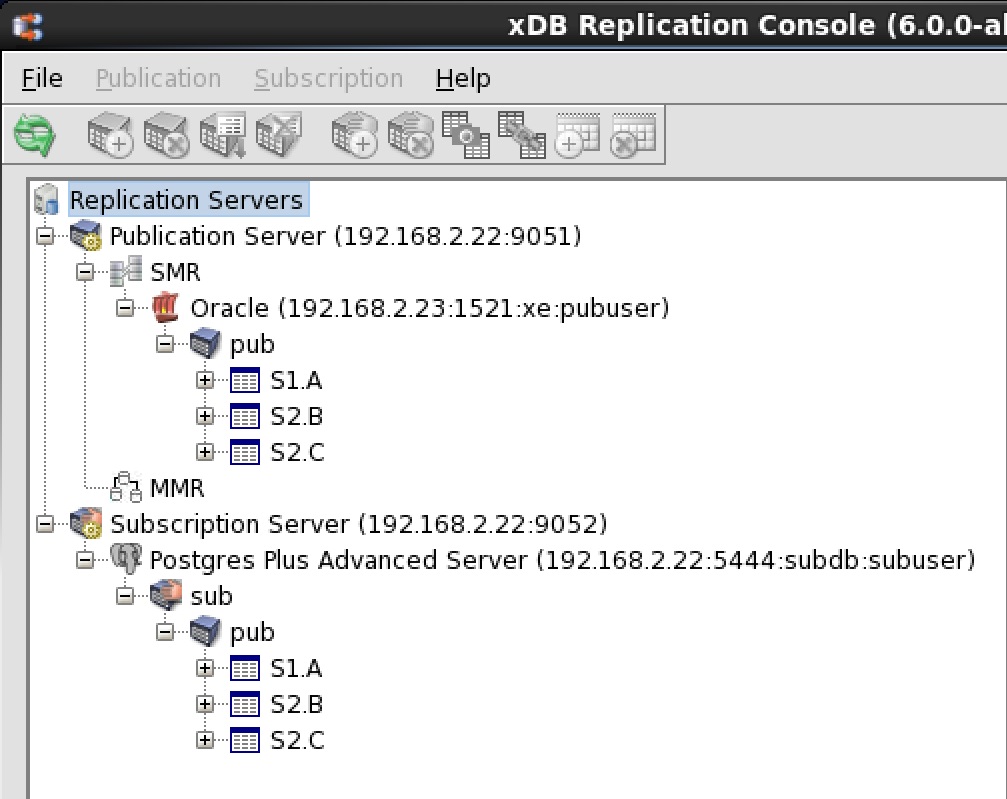
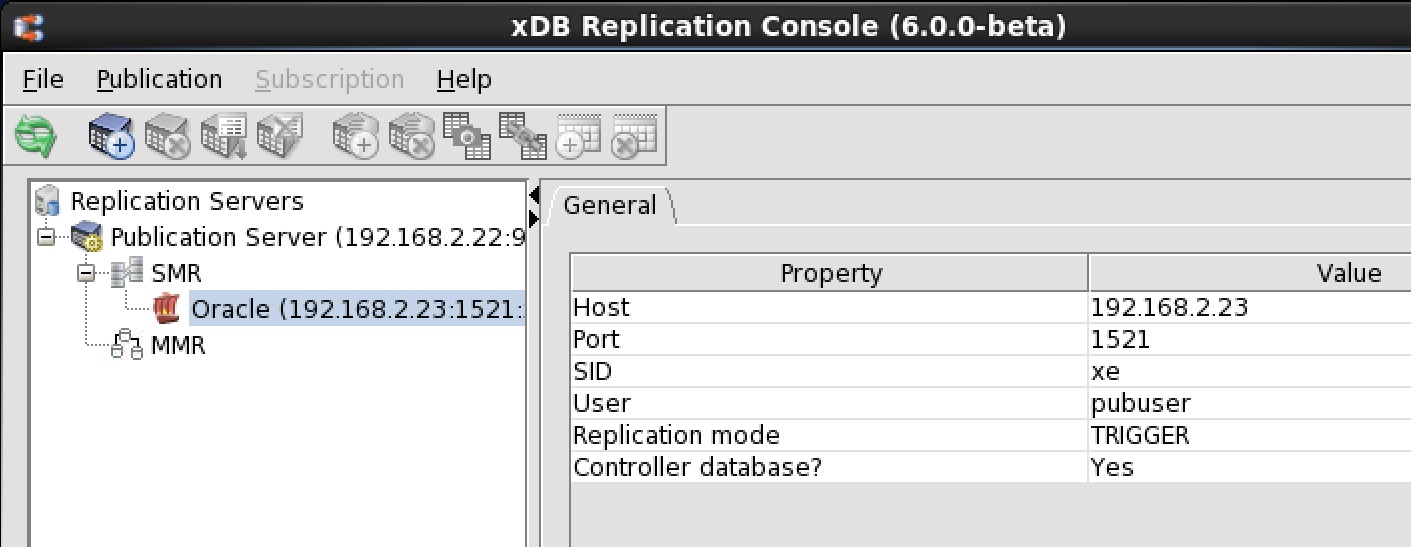
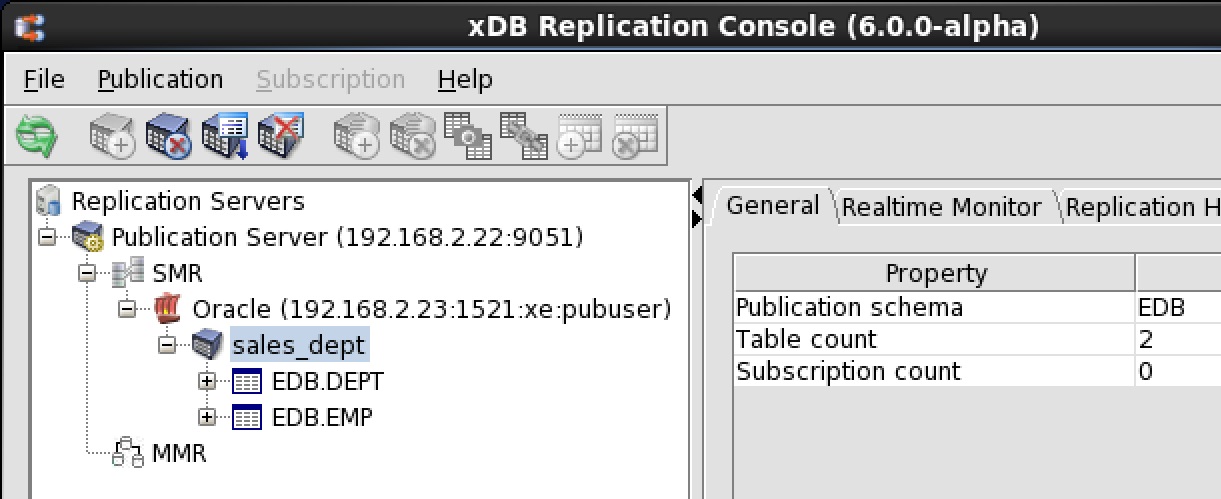
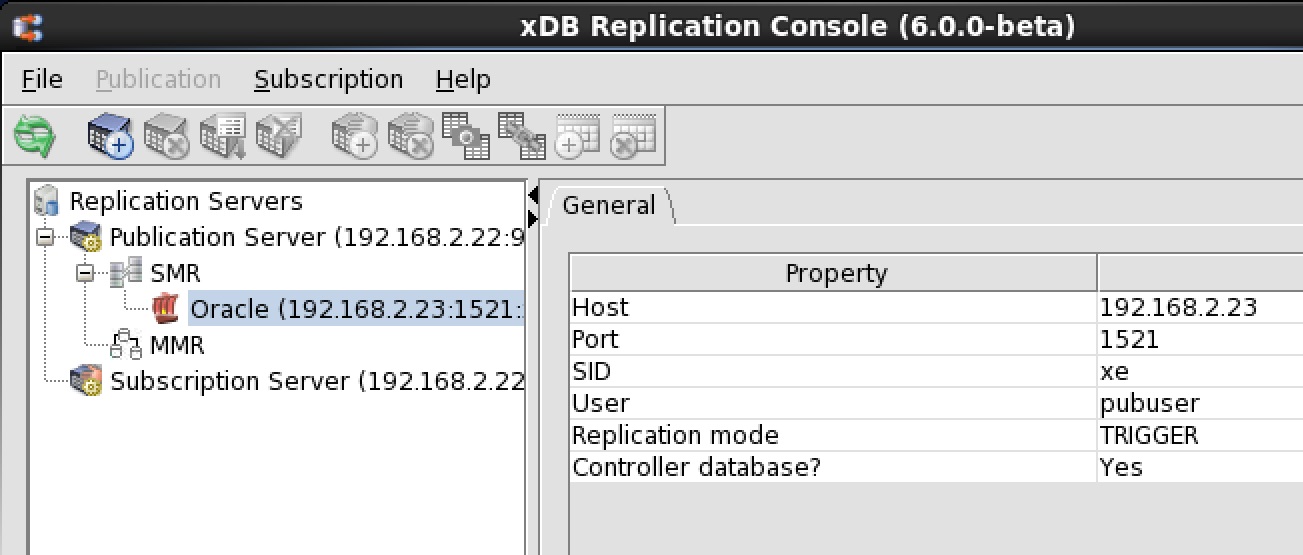
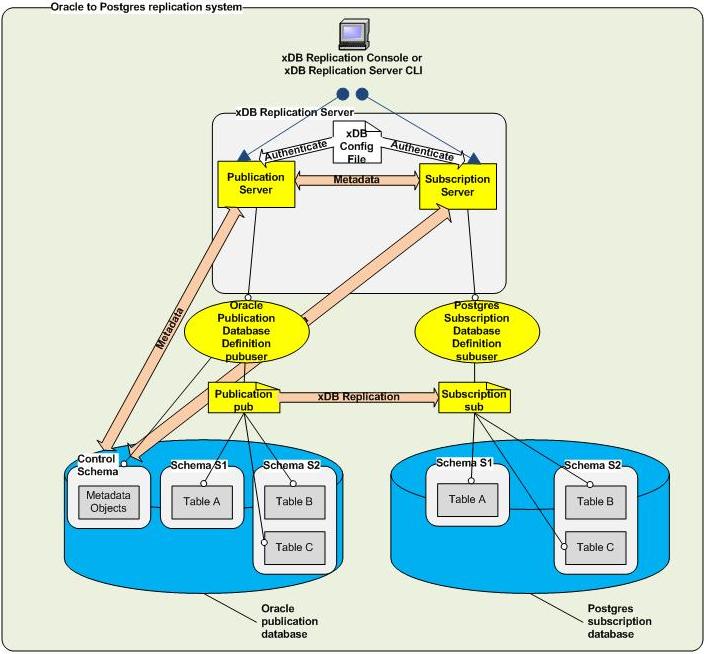
• パブリケーションデータベース定義は、パブリケーションサーバーの下のSMRタイプノードに従属して作成されます。 Oracleデータベースのユーザー名 pubuserは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。あなたが名前のユーザーを作成するときpubuserオラクルでは、名前のスキーマpubuser同時に自動的に、Oracleによって作成されます。パブリケーションデータベースの定義を作成すると、パブリケーションサーバーは、レプリケーションシステムのメタデータのpubuserコントロールスキーマにコントロールスキーマオブジェクトを作成します。
•
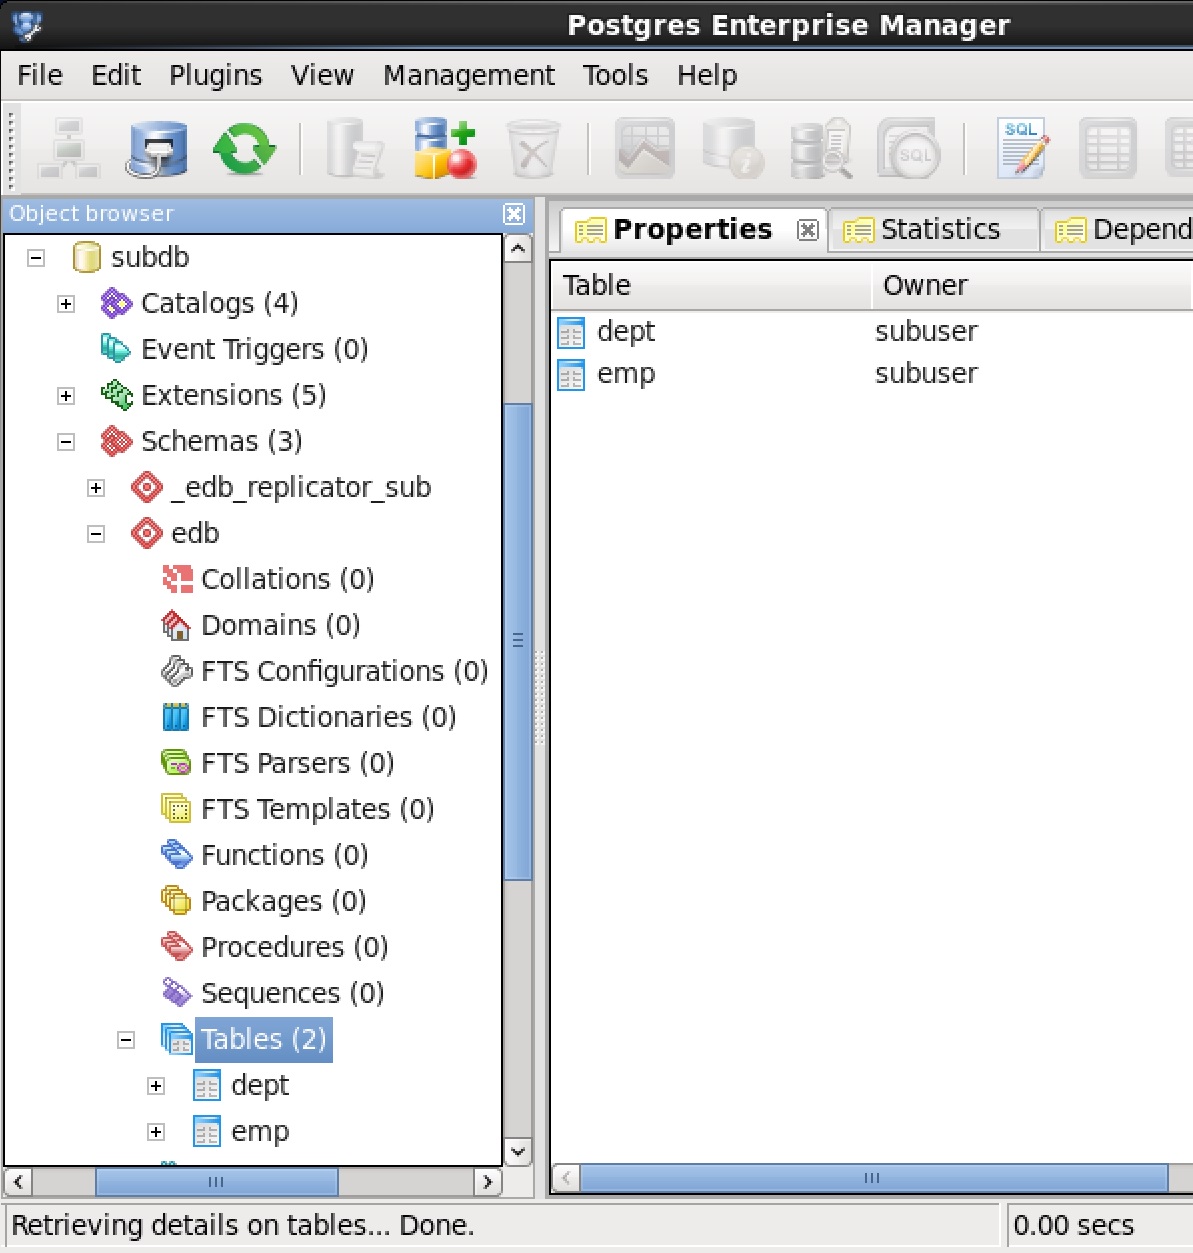
• サブスクリプションデータベース定義は、サブスクリプションサーバーに従属して作成されます。 Postgresデータベースのユーザー名 subuser ユーザーは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。
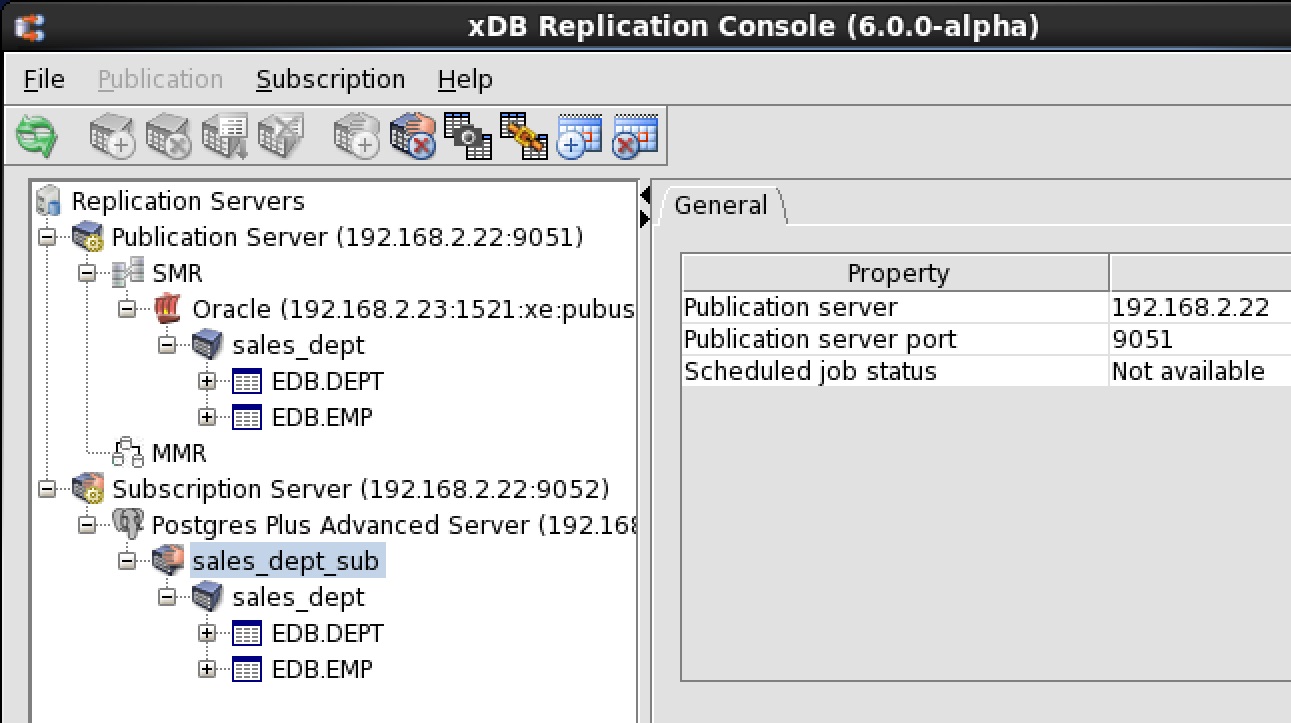
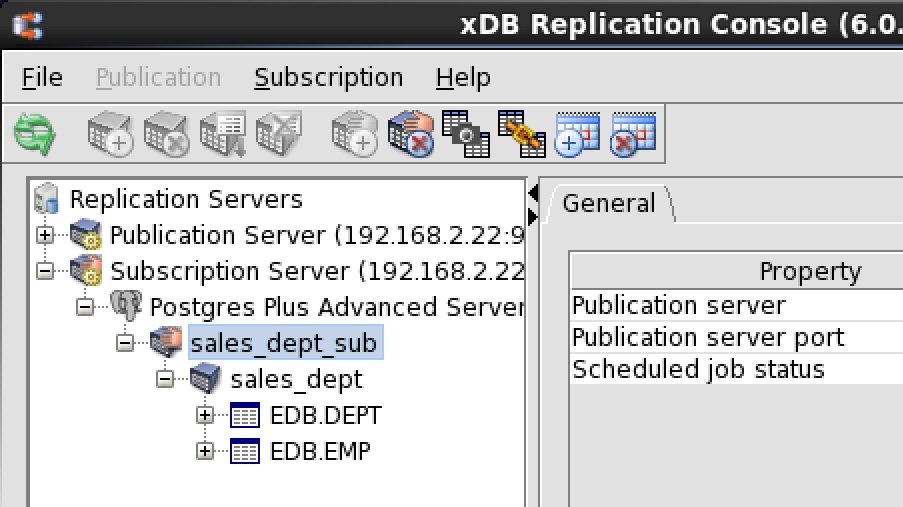
• sub という名前のサブスクリプションは、サブスクリプションデータベース定義に従属して作成されます。サブスクリプションが作成されると、サブスクリプションサーバーは、サブスクリプションデータベースにS1およびS2という名前のスキーマを作成します。この時点で、テーブルA 、 B 、およびCのテーブル定義も作成されます。レプリケーションが発生すると、パブリケーションサーバーはこれらのテーブルにパブリケーションの行を取り込みます。
• パブリケーションデータベース定義は、パブリケーションサーバーの下のSMRタイプノードに従属して作成されます。 SQL Serverログイン pubuserは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。スキーマpubuserは、セクション5.1.4.2で説明されているパブリケーションデータベースの準備ステップで作成されました。 pubuser 3つの物理スキーマからなる制御スキーマと一緒にスキーマ_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerパブリケーションデータベースの定義を作成するときに、レプリケーションシステムのメタデータ用のコントロール・スキーマ・オブジェクトが移入されています。
•
• サブスクリプションデータベース定義は、サブスクリプションサーバーに従属して作成されます。 Postgresデータベースのユーザー名 subuser ユーザーは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。
• sub という名前のサブスクリプションは、サブスクリプションデータベース定義に従属して作成されます。サブスクリプションが作成されると、サブスクリプションサーバーは、サブスクリプションデータベースにS1およびS2という名前のスキーマを作成します。この時点で、テーブルA 、 B 、およびCのテーブル定義も作成されます。レプリケーションが発生すると、パブリケーションサーバーはこれらのテーブルにパブリケーションの行を取り込みます。
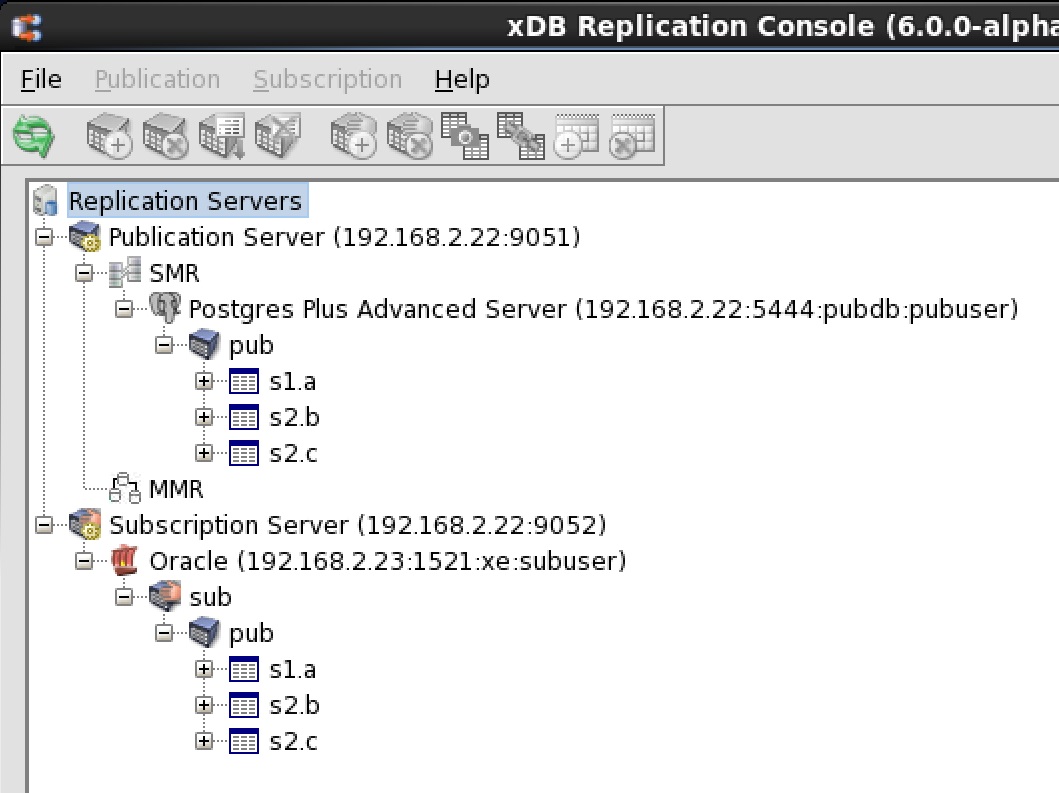
• パブリケーションデータベース定義は、パブリケーションサーバーの下のSMRタイプノードに従属して作成されます。 Postgresデータベースのユーザー名 pubuserは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。パブリケーションサーバーは、3つの物理スキーマ_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerコントロールスキーマを作成し、パブリケーションデータベース定義の作成時にレプリケーションシステムのメタデータのコントロールスキーマオブジェクトを設定します。
•
• サブスクリプションデータベース定義は、サブスクリプションサーバーに従属して作成されます。 Oracleデータベースのユーザー名 subuser ユーザーは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。
• sub という名前のサブスクリプションは、サブスクリプションデータベース定義に従属して作成されます。あなたが名前のユーザーを作成するときsubuserオラクルでは、名前のスキーマsubuser同時に自動的に、Oracleによって作成されます。サブスクリプションsubを作成すると、テーブルA 、 B 、およびCのテーブル定義がスキーマsub subuserに作成されます。レプリケーションが発生すると、パブリケーションサーバーはこれらのテーブルにパブリケーションの行を取り込みます。
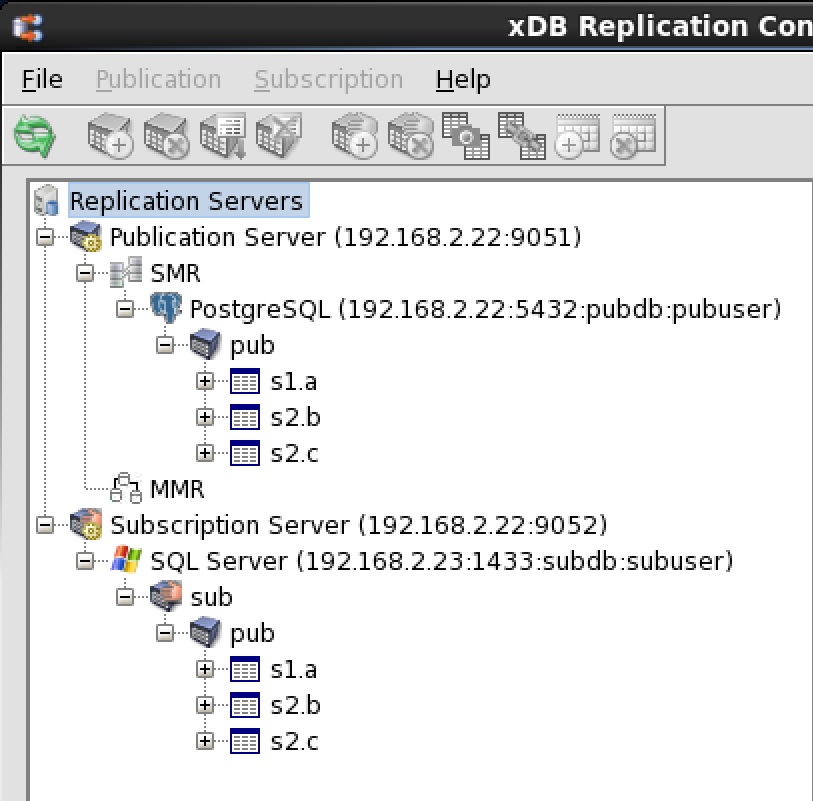
• パブリケーションデータベース定義は、パブリケーションサーバーの下のSMRタイプノードに従属して作成されます。 Postgresデータベースのユーザー名 pubuserは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。パブリケーションサーバーは、3つの物理スキーマ_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerコントロールスキーマを作成し、パブリケーションデータベース定義の作成時にレプリケーションシステムのメタデータのコントロールスキーマオブジェクトを設定します。
•
• サブスクリプションデータベース定義は、サブスクリプションサーバーに従属して作成されます。 SQL Serverログイン subuserは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。
• sub という名前のサブスクリプションは、サブスクリプションデータベース定義に従属して作成されます。サブスクリプションが作成されると、サブスクリプションサーバーは、サブスクリプションデータベースにS1およびS2という名前のスキーマを作成します。この時点で、テーブルA 、 B 、およびCのテーブル定義も作成されます。レプリケーションが発生すると、パブリケーションサーバーはこれらのテーブルにパブリケーションの行を取り込みます。
• パブリケーションデータベース定義は、パブリケーションサーバーの下のMMRタイプノードに従属して作成されます。この最初のパブリケーションデータベース定義は、マスター定義ノードを識別します。 Postgresデータベースのユーザー名 mmruser_aは、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。パブリケーションサーバーは、3つの物理スキーマ_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerコントロールスキーマを作成し、パブリケーションデータベース定義の作成時にレプリケーションシステムのメタデータのコントロールスキーマオブジェクトを設定します。
•
• マスター定義ノードが存在するパブリケーションサーバーのMMRタイプノードに従属する別のパブリケーションデータベース定義を作成することにより、2番目のマスターノードが追加されます。 Postgresデータベースのユーザー名 mmruser_bは、2番目のマスターノードを作成するために、データベースネットワークの場所とデータベース識別子とともに定義で指定されます。
• 2番目のマスターノードを追加するときに、パブリケーションサーバーにスキーマ S1およびS2とA 、 B 、およびCテーブル定義を作成させるか、事前にスキーマおよびテーブル定義を手動で作成するかを選択できます。パブリケーションサーバーは、マスターノードのメタデータを格納するコントロールスキーマオブジェクトを作成する3つの物理スキーマ_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerで_edb_schedulerコントロールスキーマを作成します。マスターノードを定義するときに、パブリケーションサーバーにこれらのテーブルにパブリケーションの行をこの時点で追加するか、テーブルのロードを後の時点に延期するかを選択できます。
•
2.4 レプリケーションシステムの設計2.4.1 General Steps手順1: xDB Replication Serverが要件に適したソリューションであり、特定のニーズに最適なソリューションを選択したかどうかを判断します。 xDB Replication Serverを使用して、シングルマスターまたはマルチマスターのレプリケーションシステムを実装できます。シングルマスターレプリケーションシステムの場合、xDB Replication Serverの際立った特徴は、OracleデータベースからPostgreSQLまたはAdvanced Serverデータベースへ、SQL ServerデータベースからPostgreSQLまたはAdvanced Serverデータベースへ、Advanced Serverデータベースからレプリケートする能力です。 Oracleデータベース、またはPostgreSQLまたはAdvanced ServerデータベースからSQL Serverデータベースへ。ステップ2: xDB Replication Serverの使用方法に関する一般的な戦略を計画します。シングルマスターモデルまたはマルチマスターモデルは、ニーズに最適ですか? (シングルマスターおよびマルチマスター複製システムの使用例については、セクション2.1を参照してください。)OracleからPostgres、SQL ServerからPostgres、Advanced ServerからOracle、またはPostgresからSQL Serverに複製しますか? PostgreSQLデータベースまたはAdvanced Serverデータベース、あるいはその両方の間で複製しますか?どのくらいの頻度でデータを複製する必要がありますか?レプリケーションはアドホックベースで実行されますか、それともスケジュールに従って定期的に実行する必要がありますか?ステップ3:複製システムのロジスティクスを計画します。レプリケートするテーブルの数と、合計バイト数と行数のサイズはどのくらいですか?各レプリケーションの間、各テーブルで行の何パーセントが変更されると予想されますか?データベースサーバーは専用マシンで実行する必要がありますか?ステップ4:複製システムを設計します。レプリケーションシステムを分散するか、単一のホストで実行するかを決定します。必要なパブリケーションとサブスクリプション、およびそれらのテーブルとビューを決定します。パブリケーションテーブルがxDB Replication Serverパブリケーションの要件を満たしていることを確認してください。詳細については、セクション2.4.2および2.4.3を参照してください。手順5:テスト環境でレプリケーションシステムを実装してテストします。パブリケーションデータのサブセットでレプリケーションシステムを試して、レプリケーションプロセスが期待どおりに機能することを確認します。結果の複製されたテーブルがアプリケーションで期待どおりに使用できることを確認してください。完全な実稼働環境でレプリケーションプロセスにかかると予想される時間に関する予備的なメトリックを確立します。手順6:運用環境でレプリケーションシステムを実装およびテストします。2.4.2 Design Considerations
• パブリケーションを作成する前に、テーブル定義が確立されていることを確認してください。セクション 7.8で説明されているようにDDL変更レプリケーション機能が使用されない限り、テーブル定義が変更された場合、関連するサブスクリプションとともにテーブルを含むパブリケーションを削除して再作成する必要があります。同じことが、マスター定義ノードとそれに関連するマスターノードのテーブル定義にも当てはまります。レプリケーションの失敗は、レプリケーション履歴で確認できます。
•
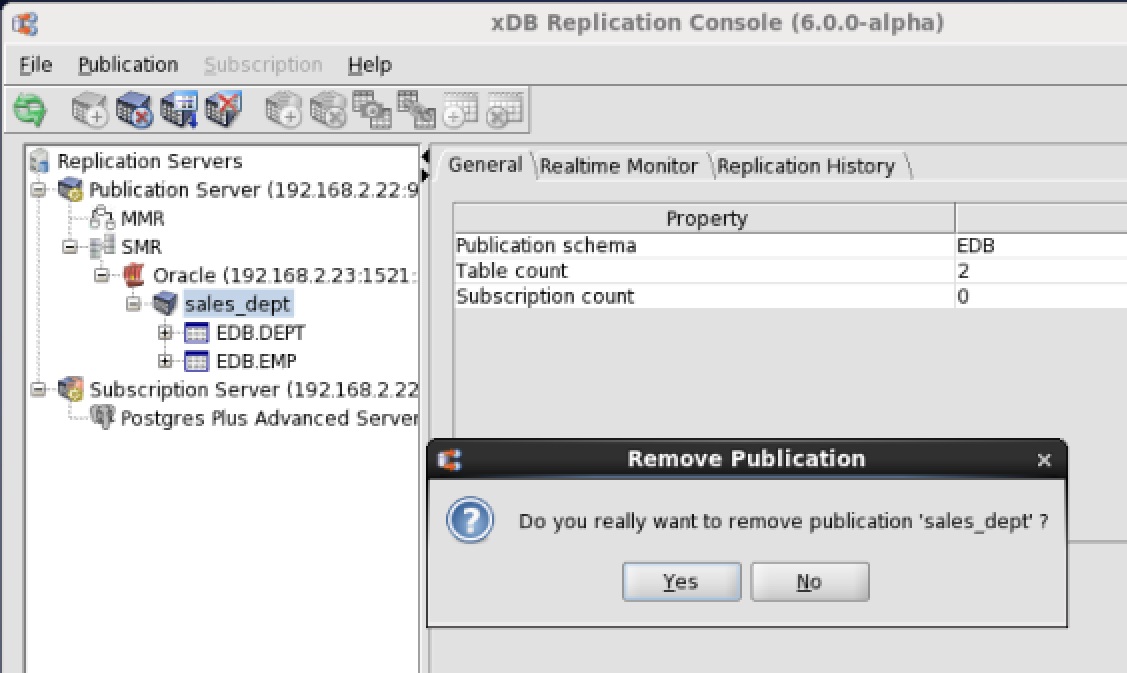
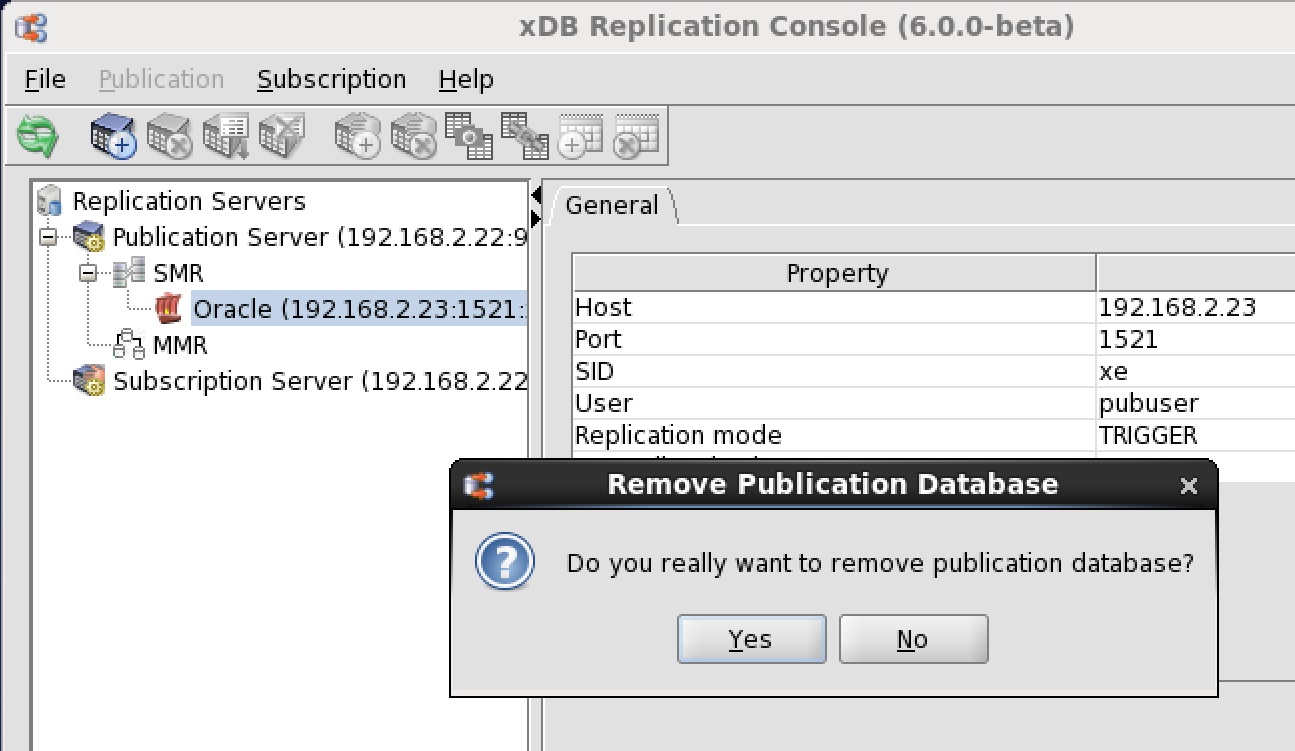
• 一般に、シングルマスターレプリケーションシステムの削除順序は次のとおりです。1)xDB Replication ConsoleまたはxDB Replication Server CLIを使用して、サブスクリプション(サブスクリプションノード)から始めて、その親コンポーネント(サブスクリプションデータベースノード)。 2)サブスクリプションサーバーが不要になった場合は、登録を解除します。 3)パブリケーションに対して同じプロセスを繰り返します。 4)すべてのレプリケーションシステムの論理コンポーネントを削除した後(パブリケーションサーバーとサブスクリプションサーバーを除く)、Oracle、SQL Server、またはPostgresの物理データベースオブジェクトを削除できます。 SQLコマンドラインユーティリティなどを使用して、コントロールスキーマオブジェクトを手動で削除しないでください。これを行うと、xDB Replication ConsoleおよびxDB Replication Server CLIが動作不能になる場合があります。 (この問題が発生した場合は、セクション10.3.4.3を参照してください。)xDB Replication ConsoleまたはxDB Replication Server CLIを使用してレプリケーションシステムの論理コンポーネントを削除すると、物理データベースからコントロールスキーマオブジェクトが自動的に削除されます。
• マルチマスターレプリケーションシステムの削除順序は次のとおりです。1)非MDNノードのパブリケーションデータベース定義で始まるxDB Replication ConsoleまたはxDB Replication Server CLIを使用して、レプリケーションシステムの論理コンポーネントを削除します。 2)マスター定義ノードの下からパブリケーションを削除します。 3)マスター定義ノードのパブリケーションデータベース定義を削除します。 4)すべてのレプリケーションシステムの論理コンポーネントを削除した後(おそらくパブリケーションサーバーを除く)、Postgresの物理データベースオブジェクトを削除できます。 SQLコマンドラインユーティリティなどを使用して、コントロールスキーマオブジェクトを手動で削除しないでください。これを行うと、xDB Replication ConsoleおよびxDB Replication Server CLIが動作不能になる場合があります。
•
•
•
•
•
• 注:外部キー制約は、シングルマスター複製システムのパブリケーションまたはサブスクリプションサーバーによって複製されません。ただし、マルチマスター複製システムでは、外部キー制約はマスター定義ノードから他のマスターノードに複製されます。注:シーケンス( CREATE SEQUENCEステートメントによって作成されたデータベースオブジェクト)は、シングルマスターレプリケーションシステムのパブリケーションデータベースからサブスクリプションデータベースにレプリケートされません。また、シーケンスは、マルチマスター複製システム内のマスター定義ノードから他のマスターノードに複製されません。
•
•
•
•
•
•
•
•
•
•
•
•
•
•
•
•
• OIDベースのラージオブジェクトを含むPostgresテーブルは複製できません。 OIDベースのラージオブジェクトについては、 pg_largeobjectにあるPostgreSQLコアドキュメントの pg_largeobjectを参照してください 。
•
•
•
•
•
•
•
•
•
• 範囲 型と呼ばれるPostgresデータ型は、PostgreSQLバージョン9.2およびAdvanced Serverバージョン9.2で最初にサポートされました。 組み込み範囲タイプは、次の組み込みデータタイプを参照します: int4range 、 int8range 、 numrange 、 tsrange 、 tstzrange 、およびdaterange 。CREATE TYPE AS RANGEコマンドで構築されたカスタム範囲タイプは、xDB Replication Serverではサポートされていません。xDB Replication ConsoleとxDB Replication Server CLIはどちらも、レプリケーションをすぐに開始する機能を提供します。これは、 オンデマンド複製と呼ばれます。レプリケーションシステムの運用準備が整ったら、通常はスケジュールを使用して、レプリケーションを定期的に無人で実行できるようにします。スケジュールの作成方法については、セクション 7.2を参照してください 。注:マルチマスター複製システムでは、オンデマンドのスナップショットは、マスター定義ノードから別のマスターノードにのみ作成できます。2.4.5 Distributed Replication2.4.5.1 Single Host
•
• PostgreSQLの場合。 PostgreSQLをインストールした後、Stack Builderを使用してxDB Replication Serverをインストールします。
• Advanced Serverの場合。 Advanced Serverをインストールした後、StackBuilder Plusを使用してxDB Replication Serverをインストールします。グラフィカルユーザーインターフェイスを使用したくない場合は、xDB Replication ServerインストーラープログラムをEnterpriseDB Webサイトからダウンロードし、テキストモードまたは無人モードおよびグラフィカルユーザーインターフェイスモードで呼び出すことができます。コマンドラインからxDB Replication Serverをインストールする手順については、セクション 3.2を参照してください 。xDB Replication Server製品はRPMパッケージとしても利用できます。この場合、インストールにはYumパッケージマネージャーが使用されます。 RPMパッケージからxDB Replication Serverをインストールする手順については、セクション 3.3を参照してください 。セクション 3.1では 、Stack BuilderまたはStackBuilder Plusのグラフィカルユーザーインターフェイスを使用したxDB Replication Serverのインストールについて説明します。注:古いバージョンのxDB Replication Serverと既存のレプリケーションシステムがある場合は、xDB Replication Serverをインストールする前にセクション10.2を確認してください。後でシステムからxDB Replication Serverを削除する場合は、グラフィカルユーザーインターフェイスを使用して最初にインストールした場合、またはコマンドラインからインストーラープログラムを起動してxDB Replication Serverをアンインストールする方法についてセクション 3.6を参照してください 。 RPMパッケージからインストールされたxDB Replication Serverをアンインストールする方法については、セクション3.7を参照してください。
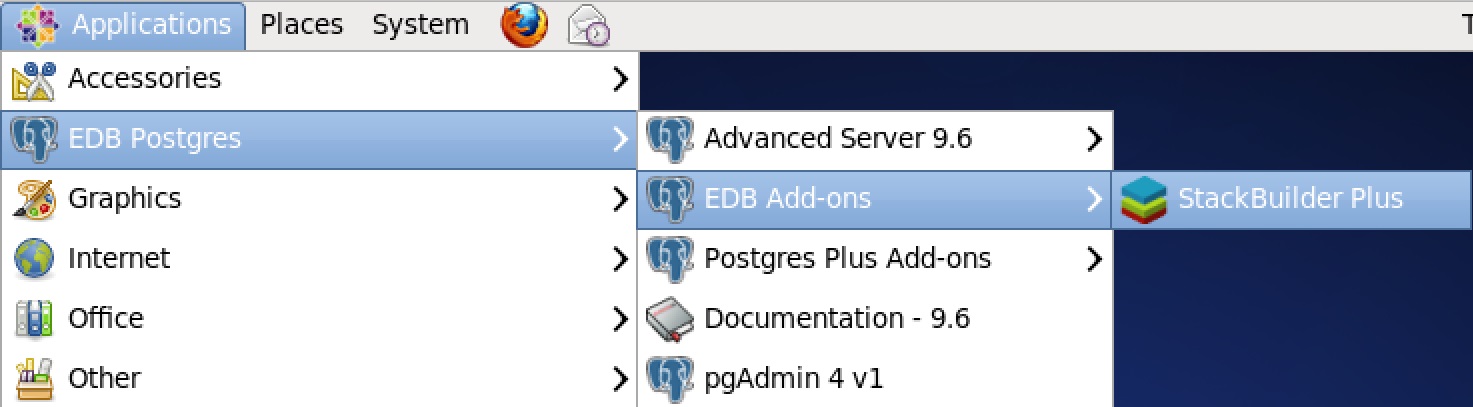
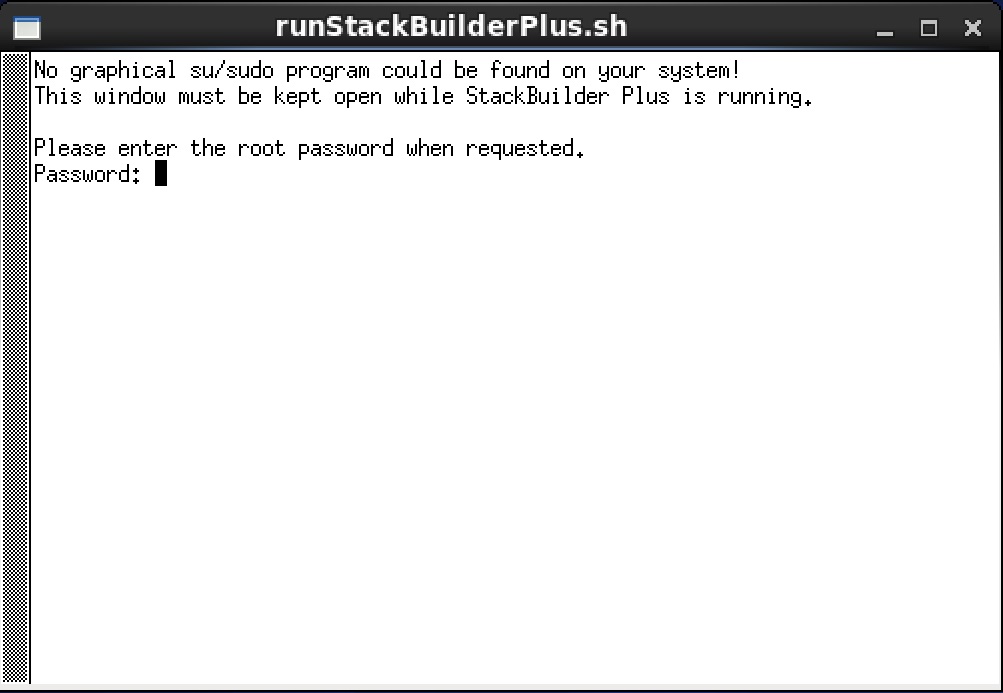
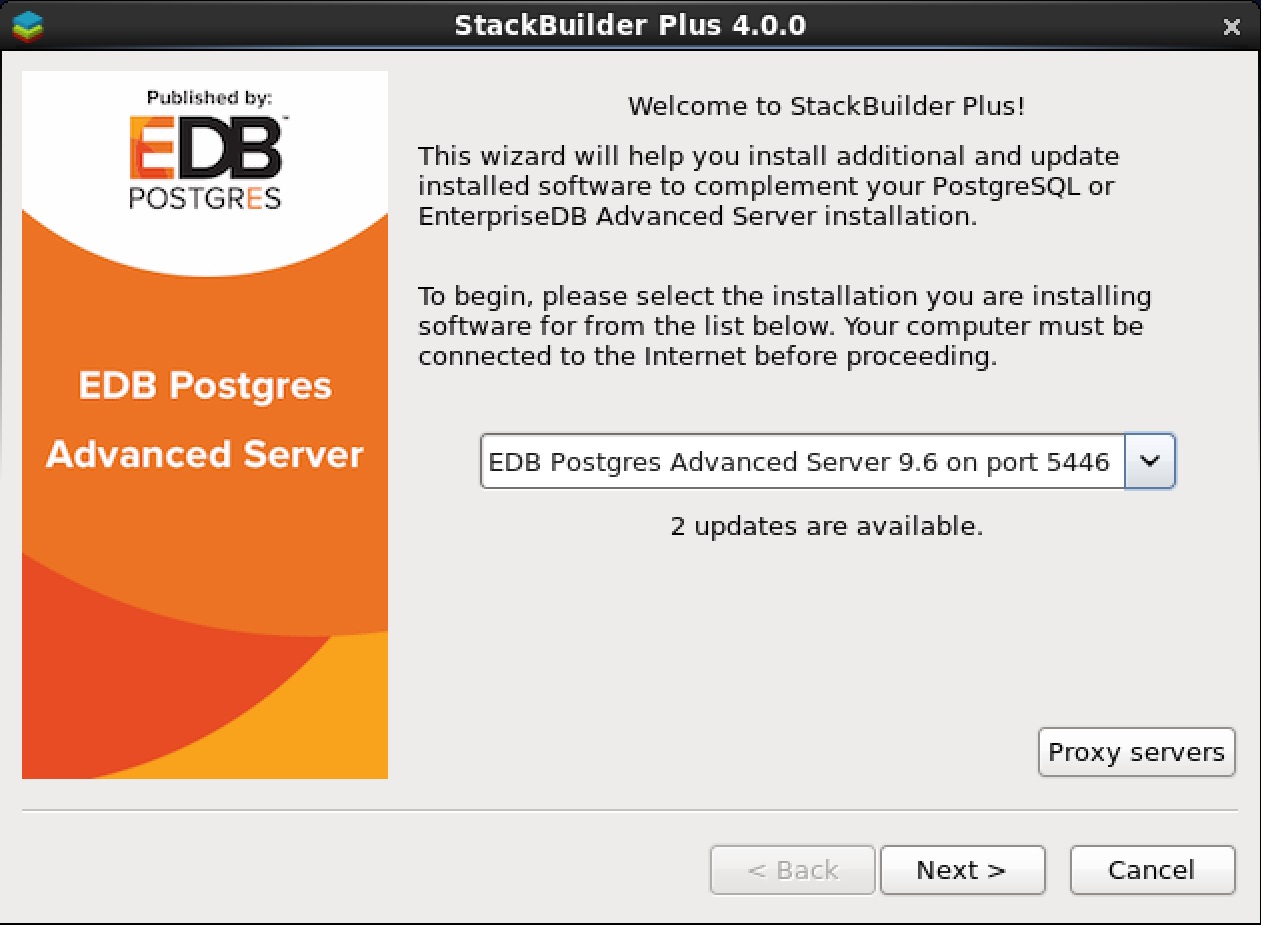
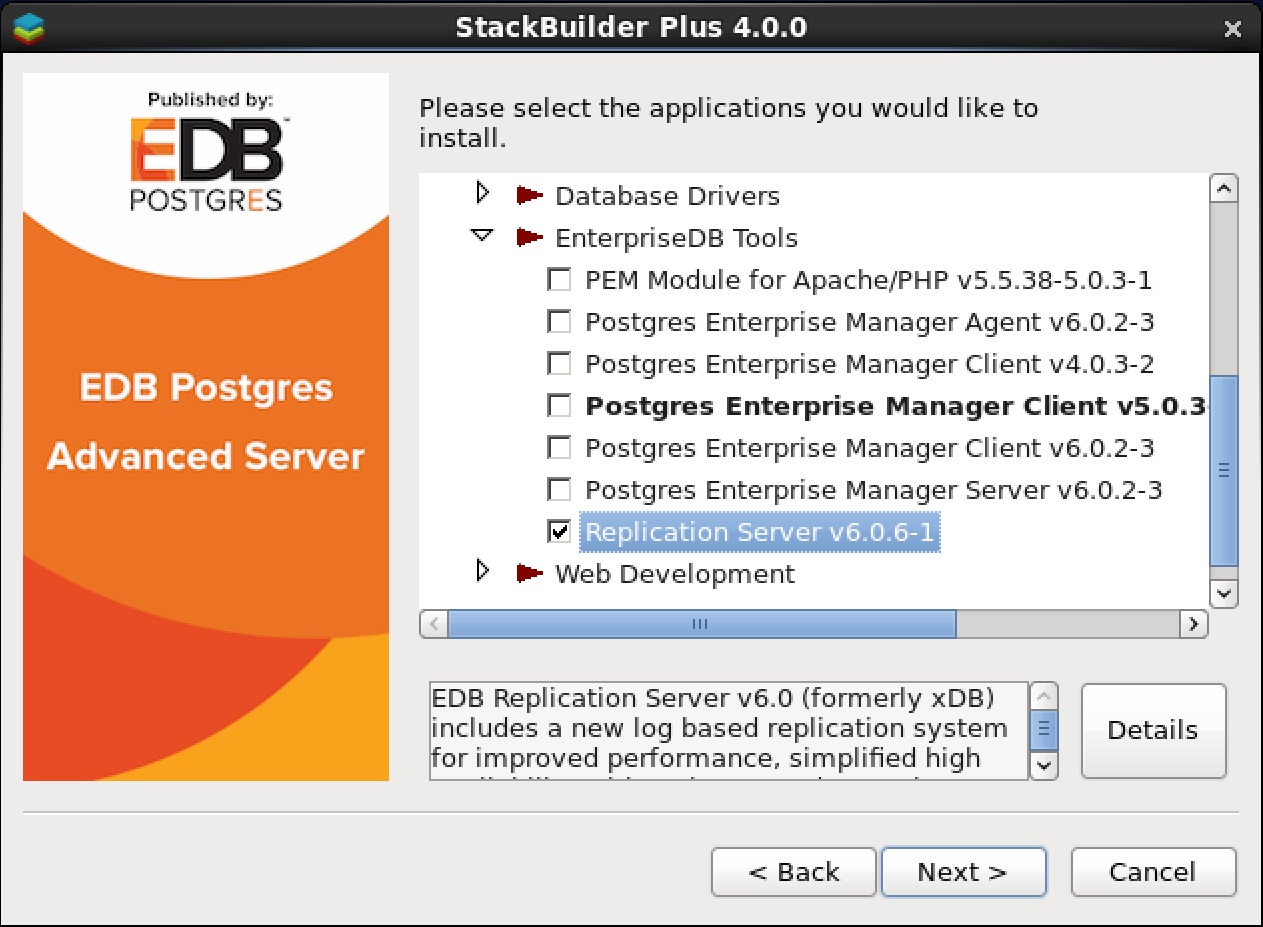
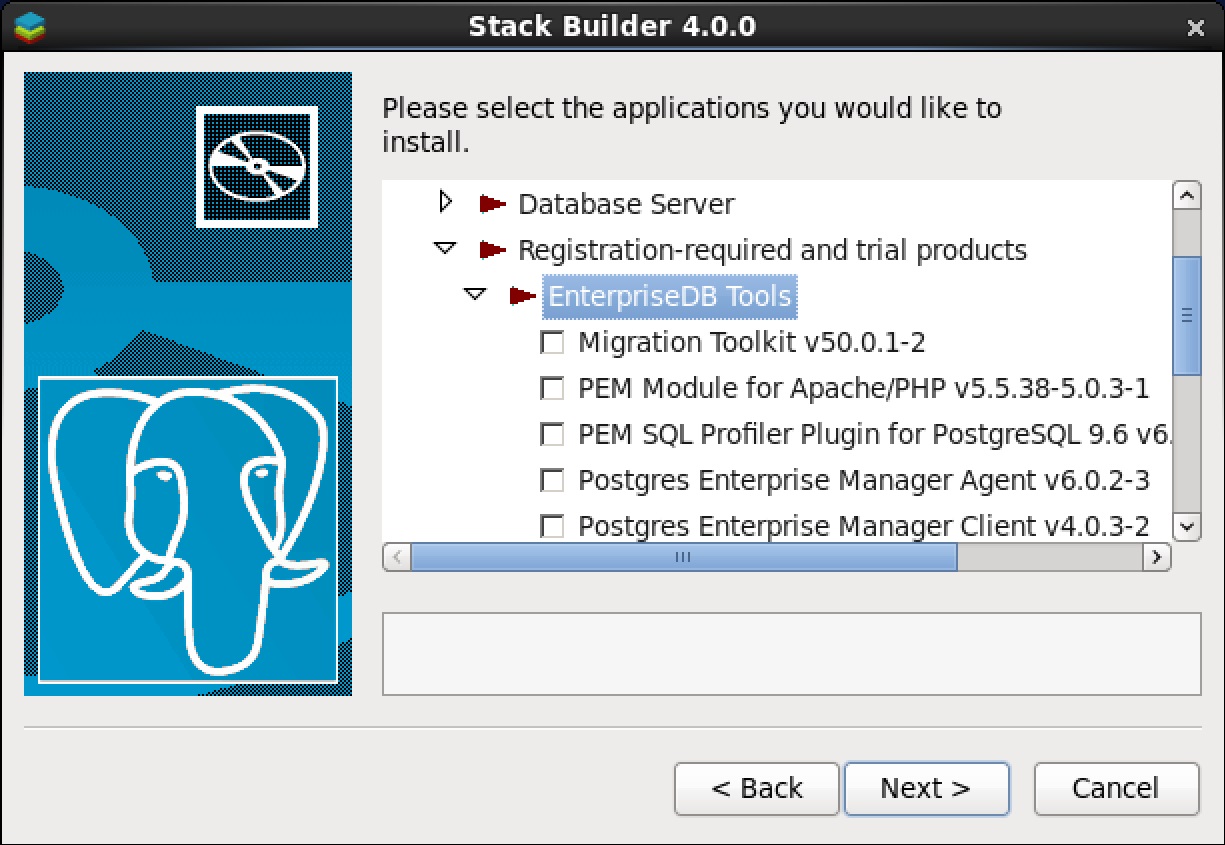
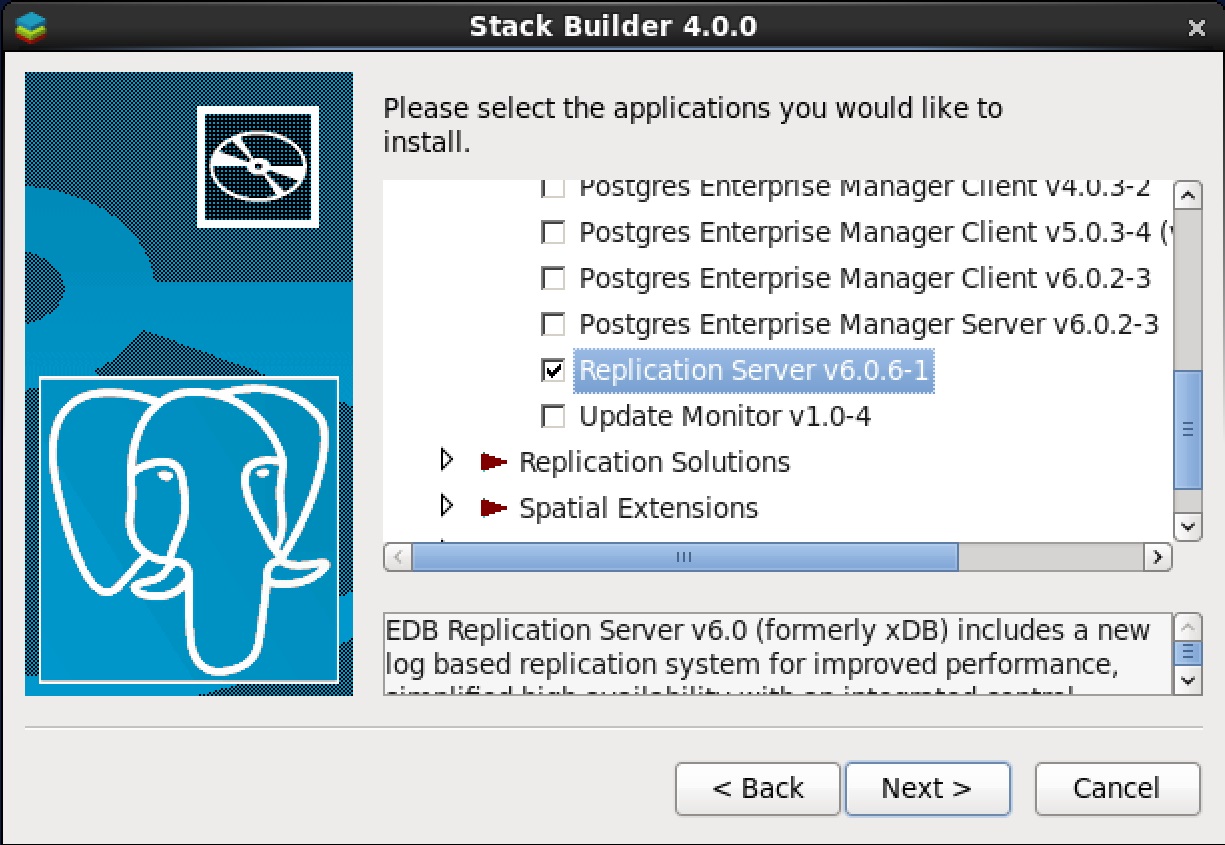
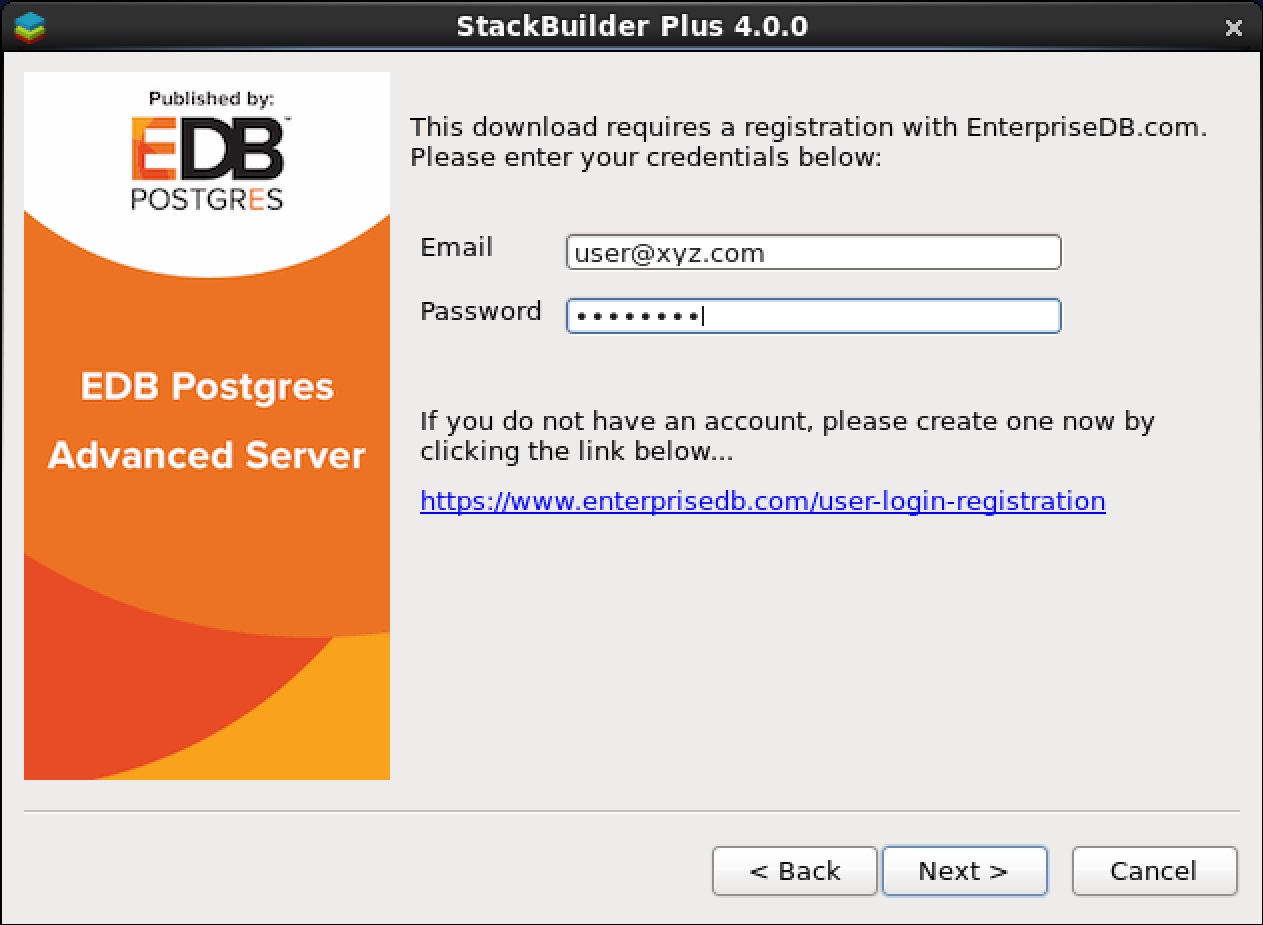
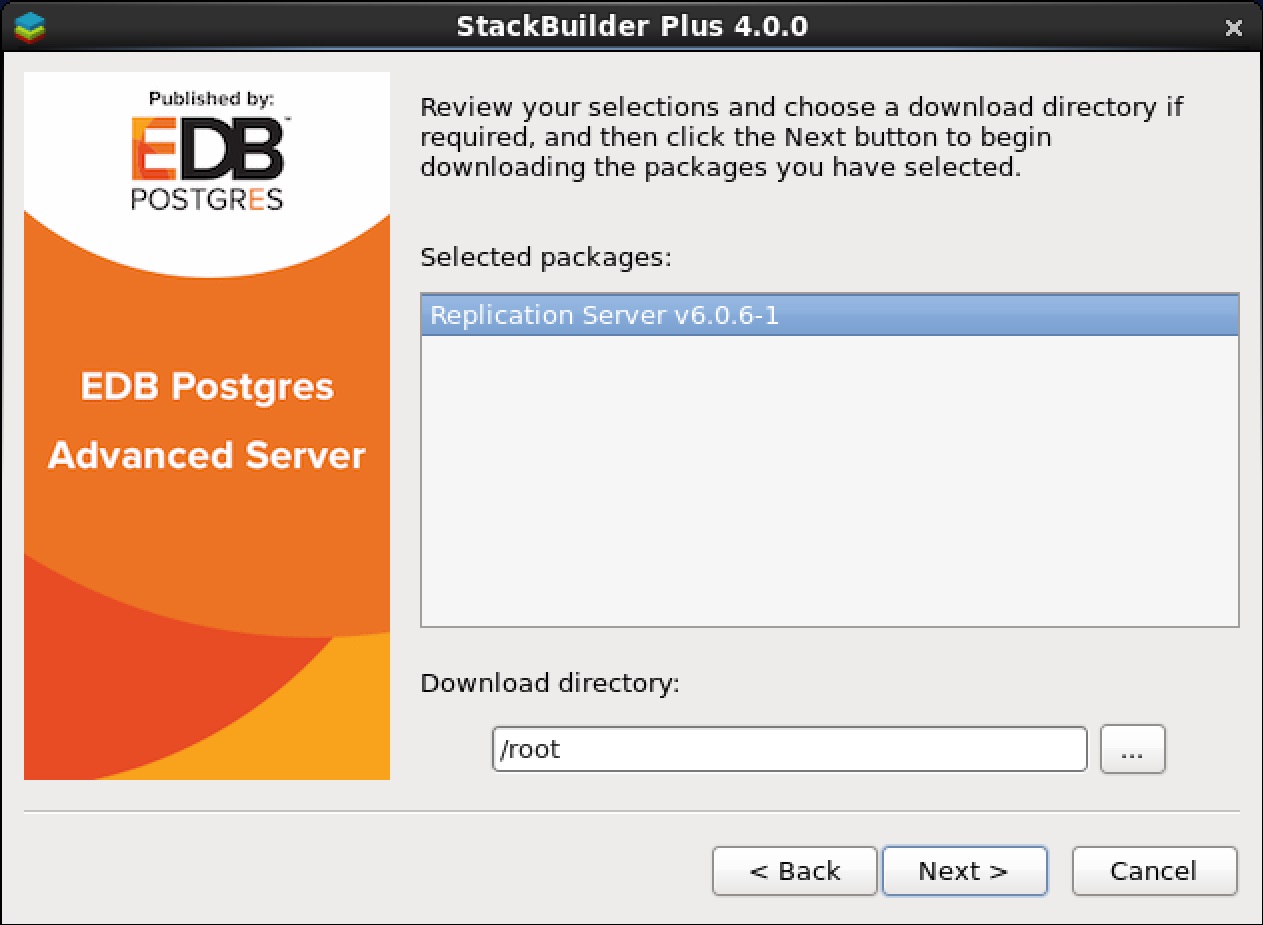
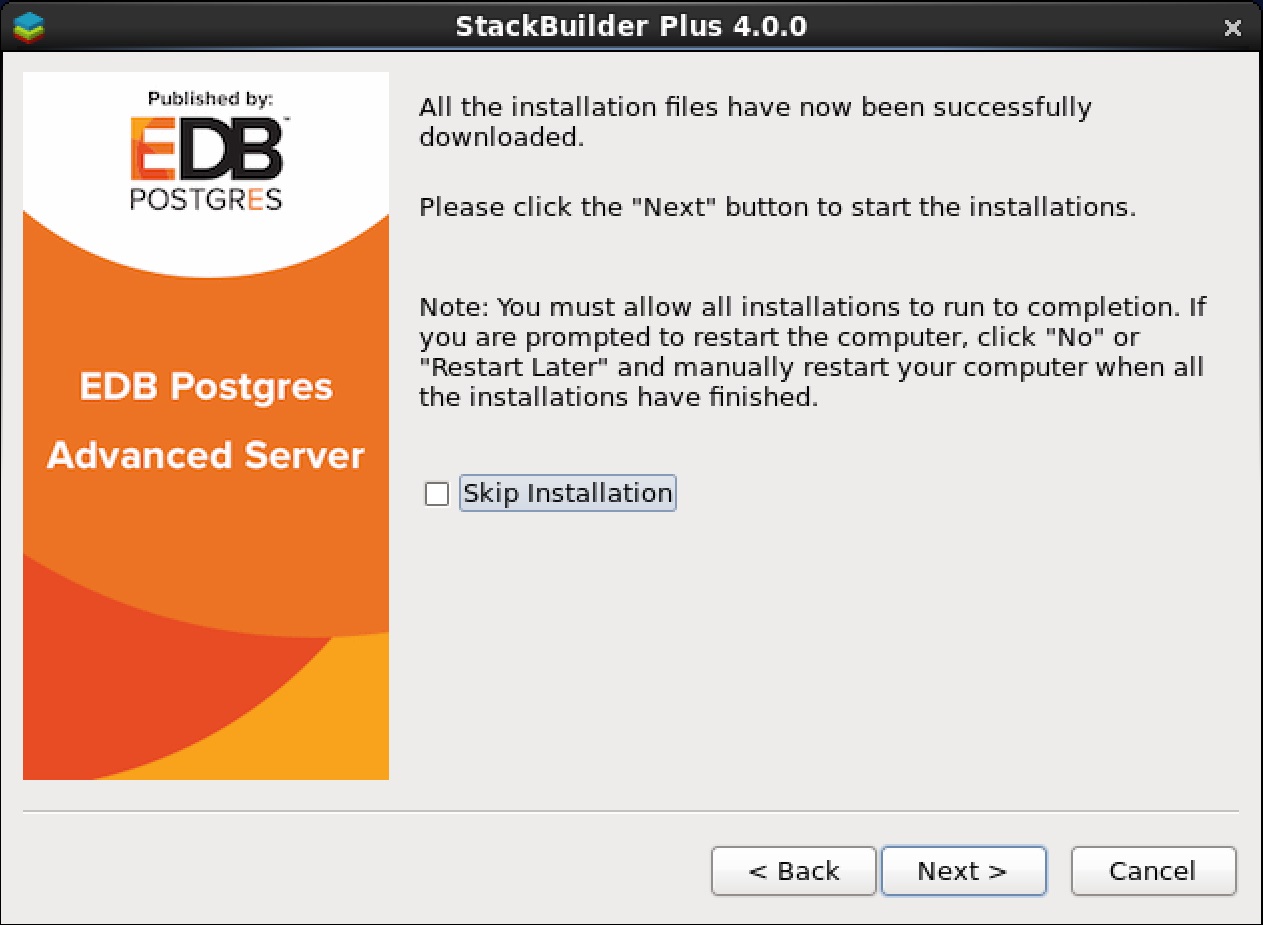
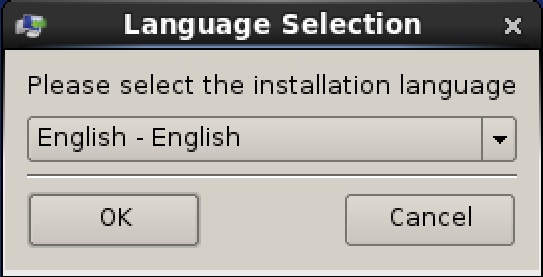
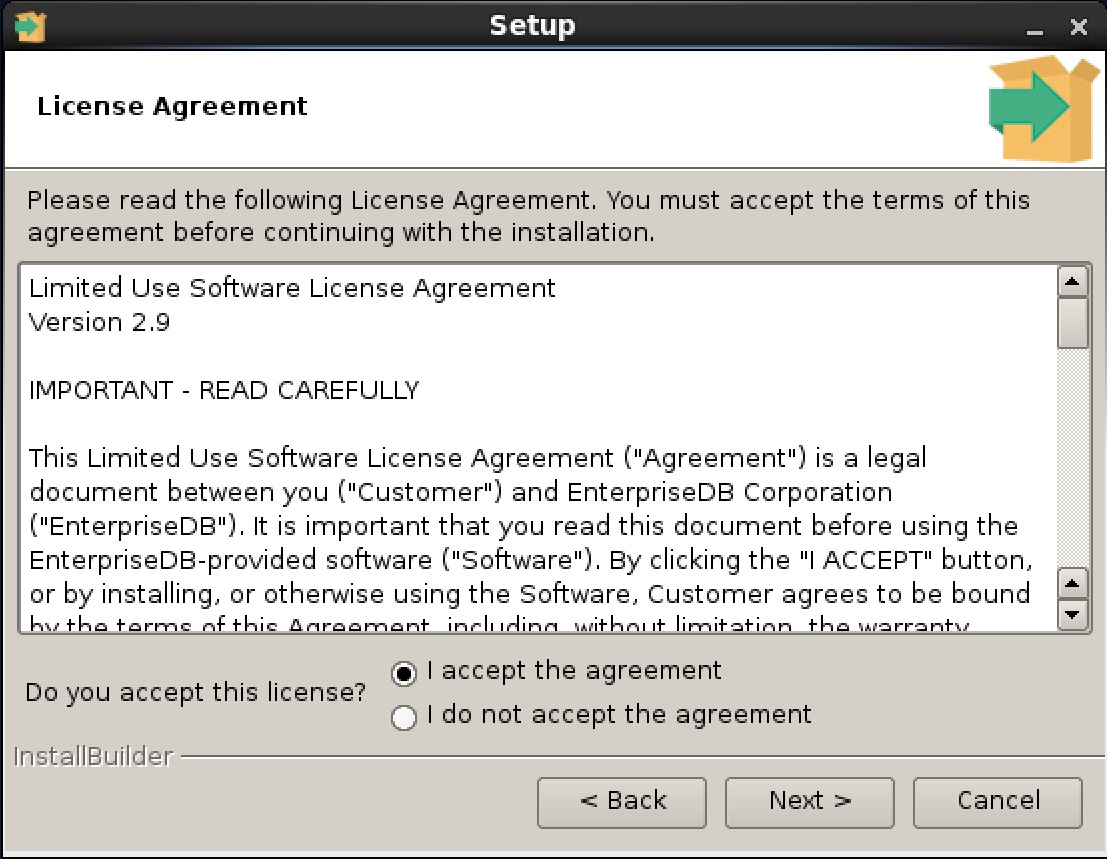
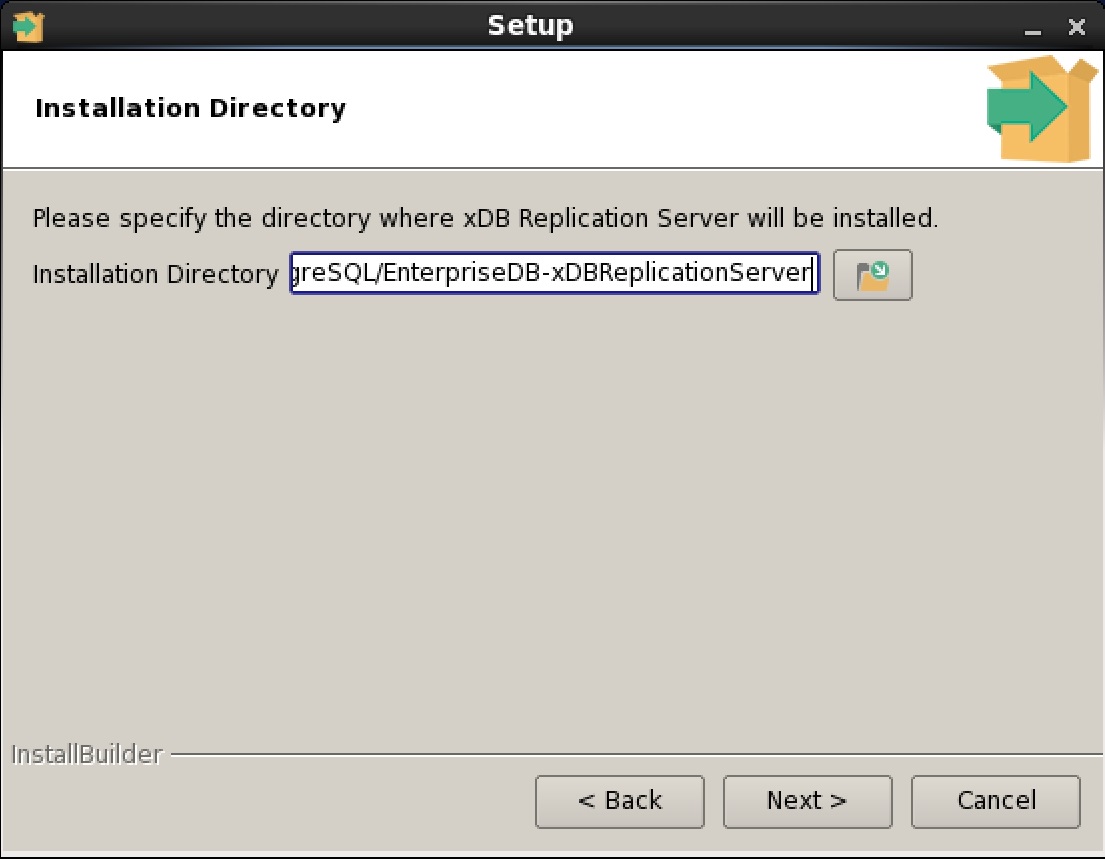
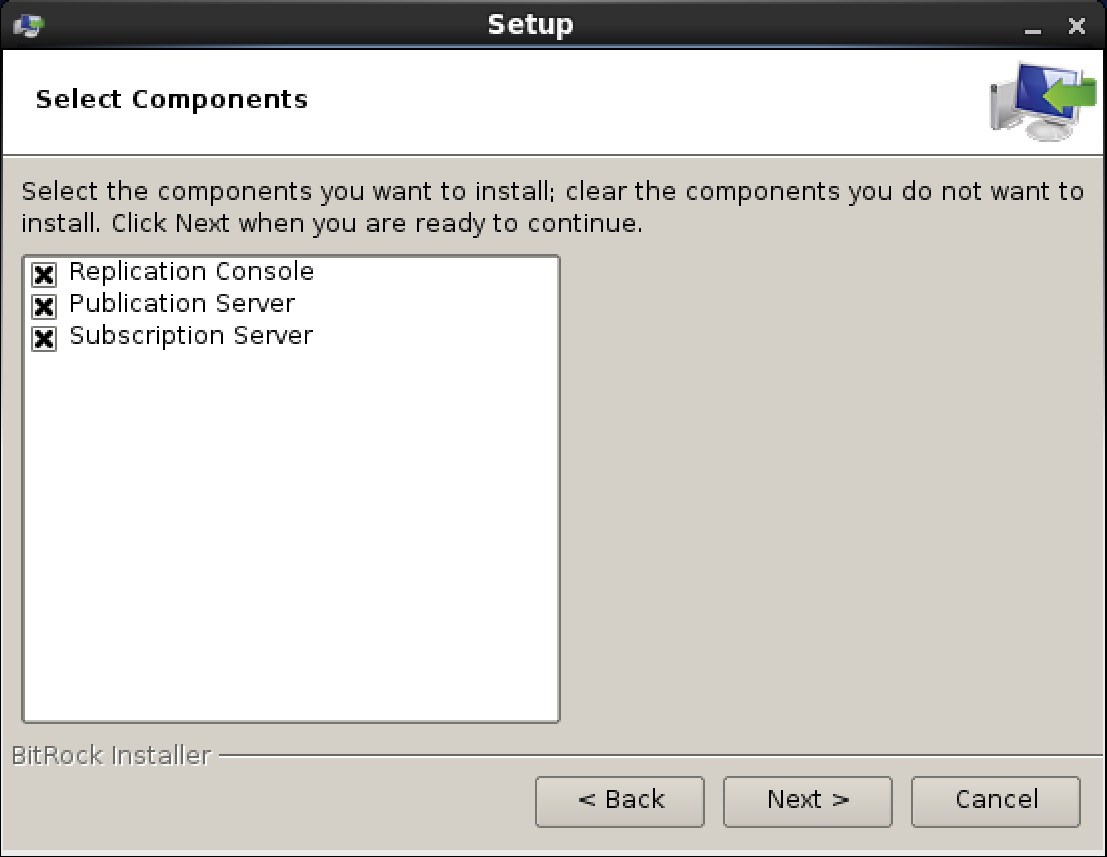
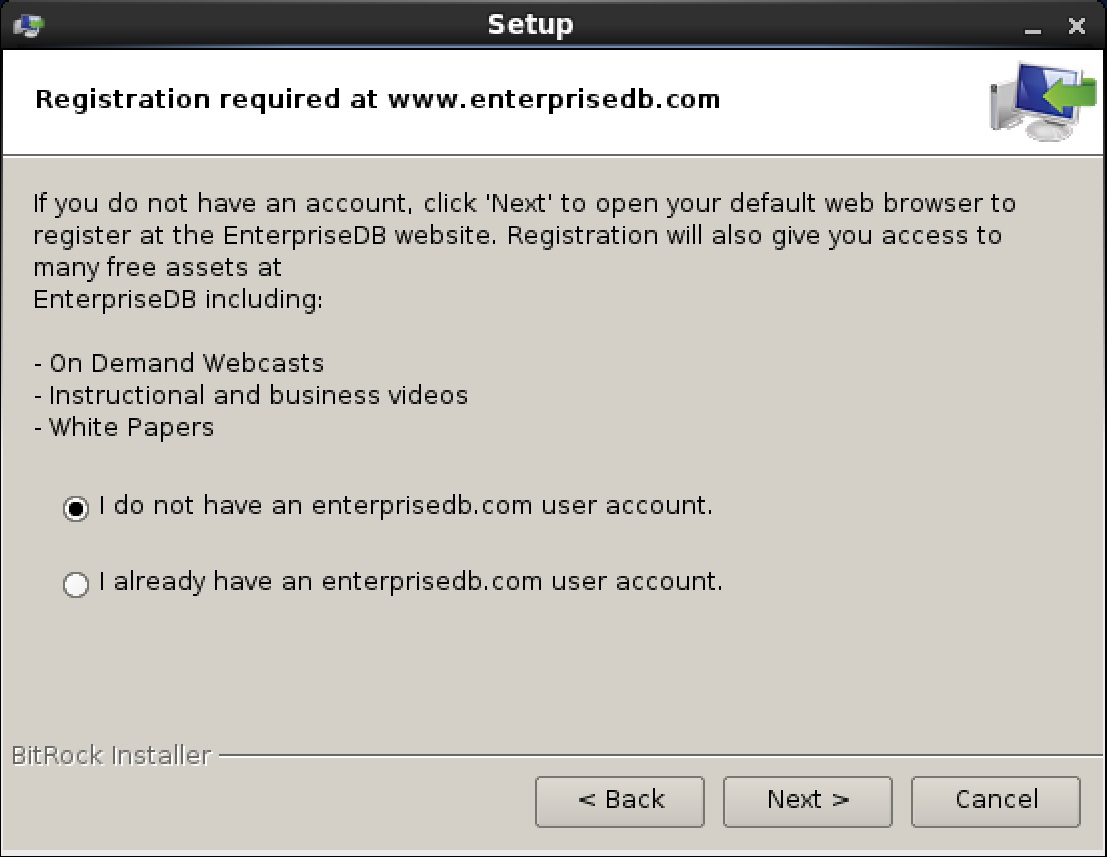
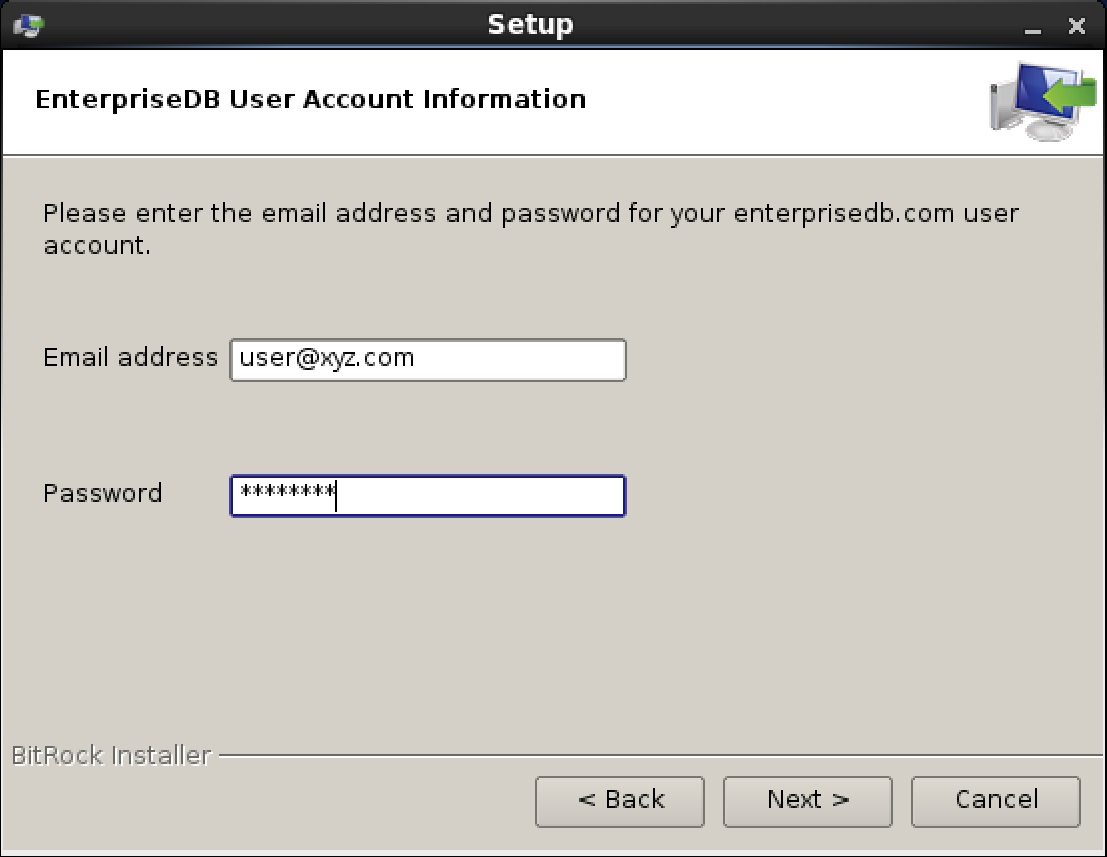
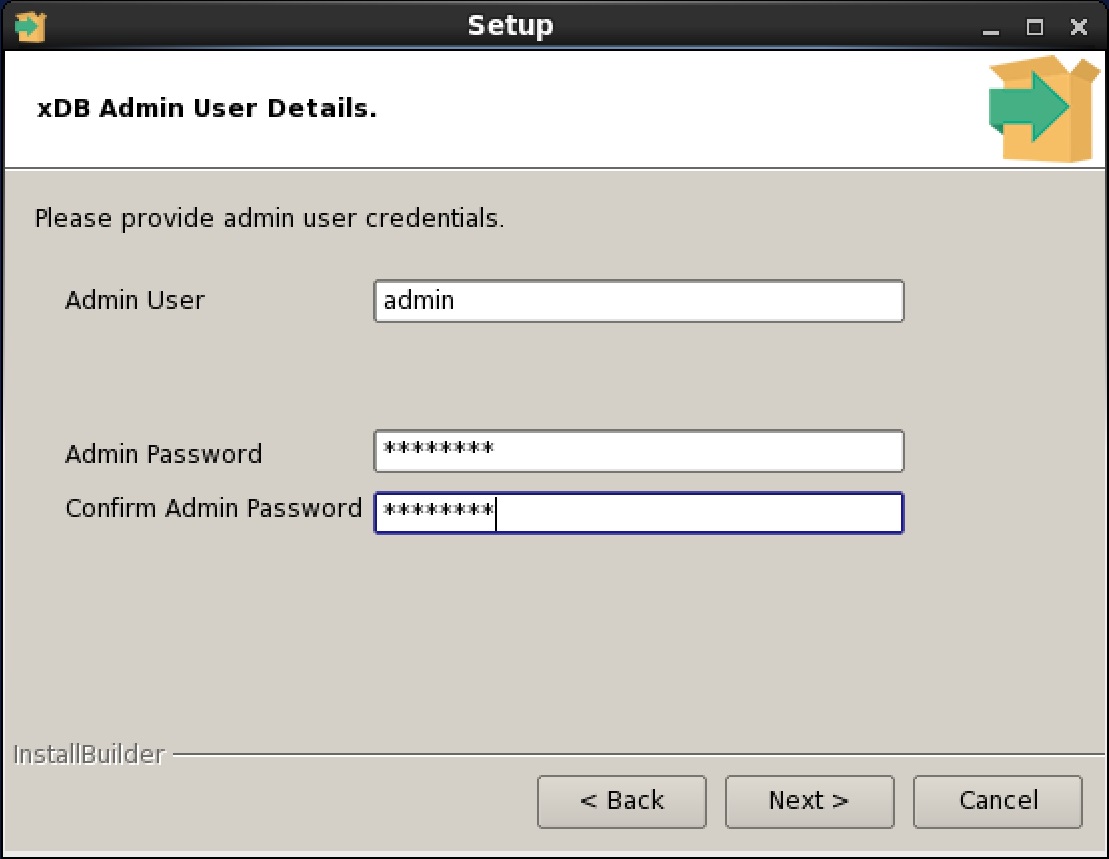
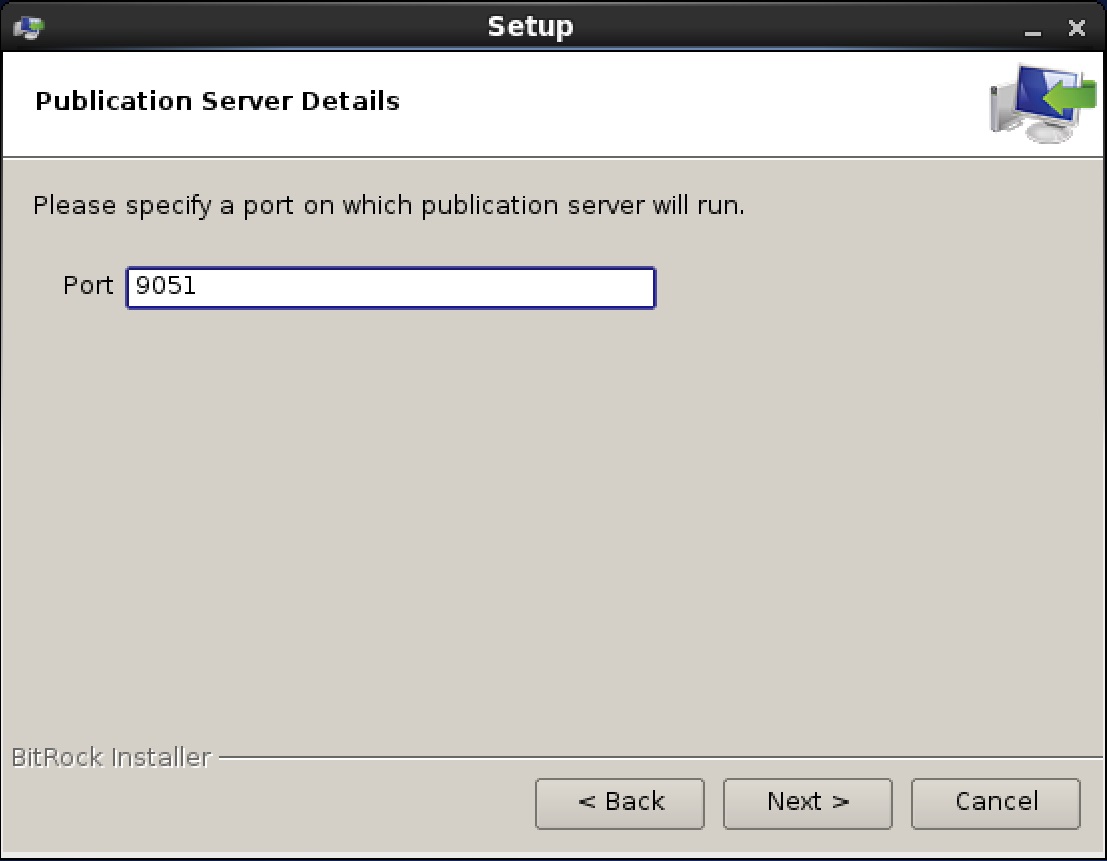
Stack BuilderとStackBuilder Plusは、アドオン製品とPostgreSQLおよびAdvanced Serverのアップデートのダウンロードとインストールに使用されるプログラムです。 Stack BuilderはPostgreSQLに使用されます。 StackBuilder PlusはAdvanced Serverに使用されます。手順1: xDB Replication Serverコンポーネント(xDB Replication Console、パブリケーションサーバー、またはサブスクリプションサーバー)をインストールするホストにJava Runtime Environment(JRE)バージョン1.7以降をインストールする必要があります。 Oracle JavaやOpenJDKなどのJava製品を使用できます。Windowsの場合のみ:システム環境変数JAVA_HOMEが、xDB Replication Serverで使用するJREバージョンとビット数(32ビットまたは64ビット)のJREインストールディレクトリに設定されていることを確認してください。 Windowsプラットフォーム用のxDB Replication Serverインストーラーには、32ビット版と64ビット版の両方が含まれています。 JAVA_HOME設定は、xDB Replication Serverの32ビットバージョンと64ビットバージョンのどちらをインストールするかを決定しJAVA_HOME 。 ( JAVA_HOMEが設定されていない場合、 Pathシステム環境変数で最初に検出されたJREバージョンによって、インストールするxDB Replication Serverのバージョンが決まります。)注: 9.3より前のAdvanced Serverバージョンの場合、JavaランタイムがAdvanced Serverインストールプロセスの一部として提供およびインストールされますが、ホストに別個のJavaランタイムシステムを事前にインストールしておく必要があります。 xDB Replication Serverのインストールプロセスでは、Advanced Serverに付属のJavaランタイムは使用されません。注: xDB Replication Serverのインストールが完了すると、Javaランタイムプログラムへのパスは、xDB Replication Serverが使用するxDBスタートアップコンフィギュレーションファイルに保存されます。 xDBスタートアップ構成ファイルに設定されているJavaランタイムプログラムへのパスが正しいことを確認します。このファイルの場所については、セクション3.5を参照してください。ステップ2:ホストのアプリケーションメニューから、Postgresメニューを開き、Stack BuilderまたはStackBuilder Plusを選択します。ステップ3(Linuxのみ): Linuxホストに応じて、 rootアカウントのパスワードを要求するダイアログボックスまたはプロンプトが表示されます。 rootパスワードを入力し、[OK]ボタンをクリックします。ステップ4: StackBuilder Plusのようこそ画面が表示されます。ドロップダウンリストからPostgresインストールを選択し、[次へ]ボタンをクリックします。ステップ5(Advanced Serverの場合): EnterpriseDB Toolsノードを展開し、Replication Serverのチェックボックスをオンにします。 [次へ]ボタンをクリックします。注:次の図はReplication Server v6.0を示していますが、Replication Server v6.2でも同じプロセスを使用してください。手順5(PostgreSQLの場合): [登録が必要な試用版]ノードを展開し、[EnterpriseDBツール]ノードを展開します。 EnterpriseDB Toolsリストの下にあるReplication Serverのボックスをチェックし、Nextボタンをクリックします。ステップ6(Advanced Serverのみ):アカウント登録画面で、EnterpriseDBユーザーアカウントの電子メールアドレスとパスワードを入力するか、リンクをクリックします。この場合、EnterpriseDBの登録ページに移動します。アカウントを作成できるウェブサイト。 [次へ]ボタンをクリックします。注(PostgreSQLのみ):手順7に進みます 。PostgreSQLを使用している場合、プロセスの後半でアカウント登録が行われます。ステップ7:選択したパッケージのリストにReplication Serverが表示されることを確認します。 [次へ]ボタンをクリックします。手順8: Replication Serverパッケージのダウンロードが完了すると、xDB Replication Serverのインストールを開始する次の画面が表示されます。 [次へ]ボタンをクリックします。注: xDB Replication Serverをもう一度インストールする場合は、[インストールをスキップ]ボックスをチェックできます。ステップ9:インストール言語を選択し、[OK]ボタンをクリックします。ステップ10: [xDB Replication Serverのセットアップ]画面で、[次へ]ボタンをクリックします。ステップ11:ライセンス契約を読みます。契約に同意する場合は、「同意する」ラジオボタンを選択し、「次へ」ボタンをクリックします。手順12: xDB Replication Serverコンポーネントをインストールするディレクトリを参照するか、表示されているデフォルトの場所にコンポーネントをインストールできるようにします。 [次へ]ボタンをクリックします。ステップ13:特定のxDB Replication Serverコンポーネントをこの特定のホストにインストールしたくない場合は、コンポーネント名の隣のボックスをオフにします。 [次へ]ボタンをクリックします。ステップ14:アカウント登録画面で、該当するラジオボタンを選択します。 [次へ]ボタンをクリックします。ステップ15: xDB管理者の情報を入力します。
• 管理者ユーザー。このホストで実行されているパブリケーションサーバーまたはサブスクリプションサーバーの登録など、xDB Replication Serverの特定の使用を認証するためのxDB管理者ユーザー名。管理ユーザー名には、任意の英数字文字列を入力できます。デフォルトの管理ユーザー名はadminです。
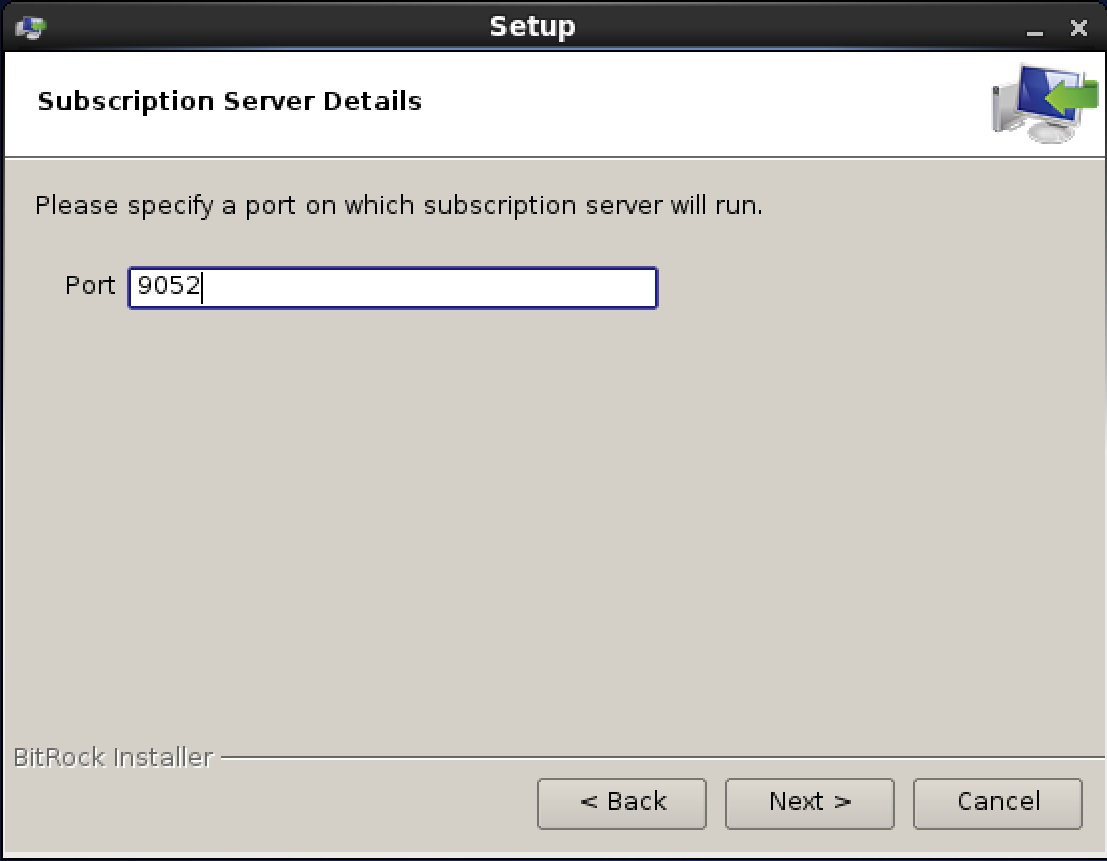
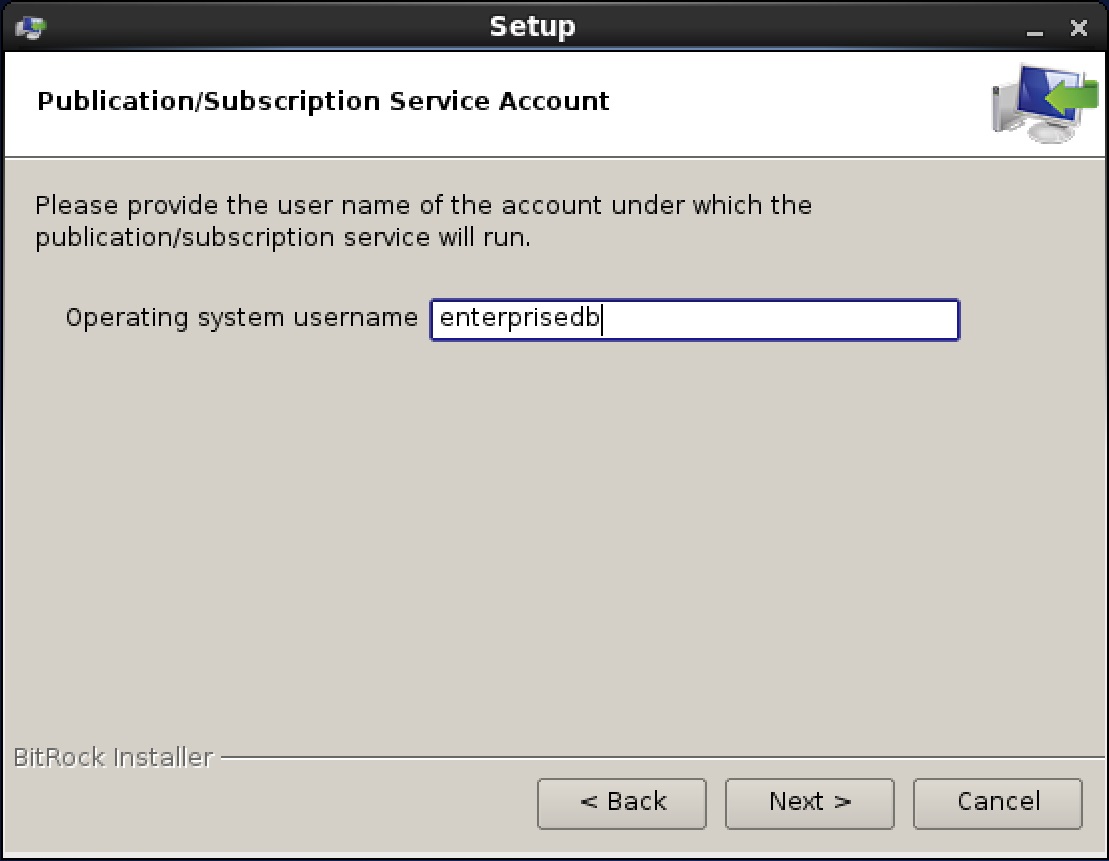
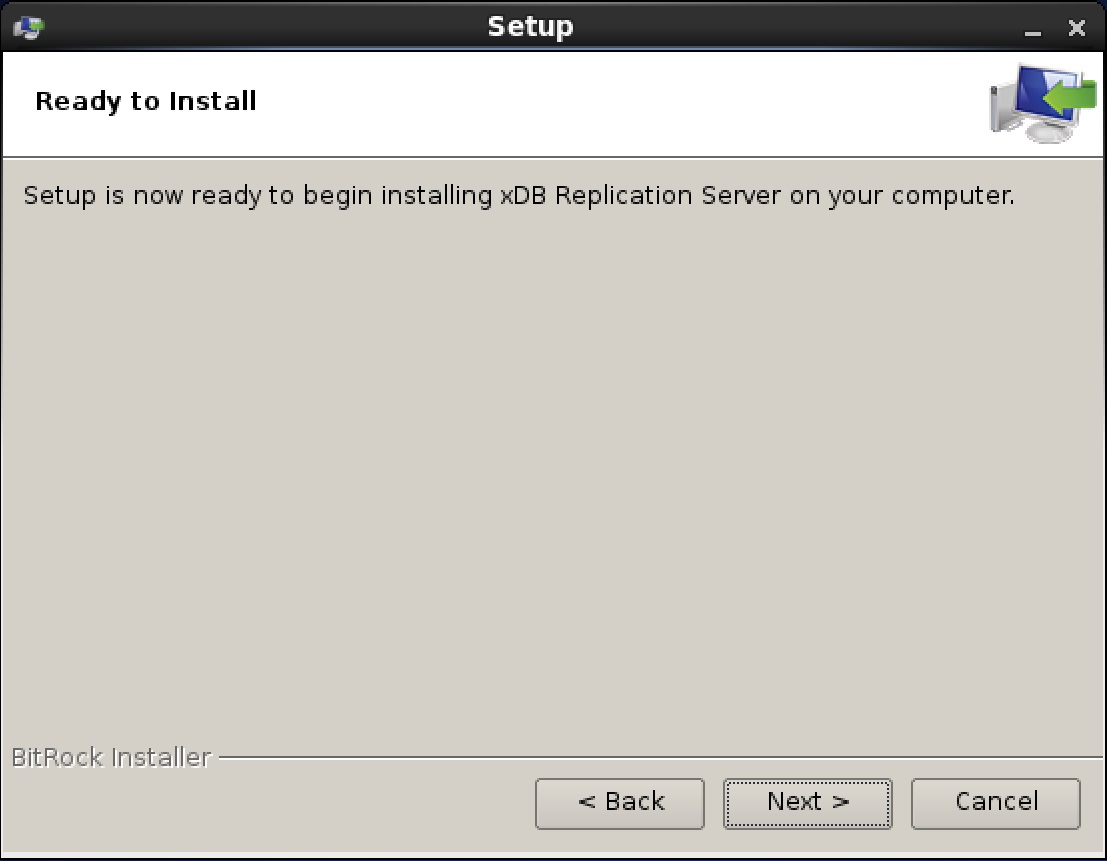
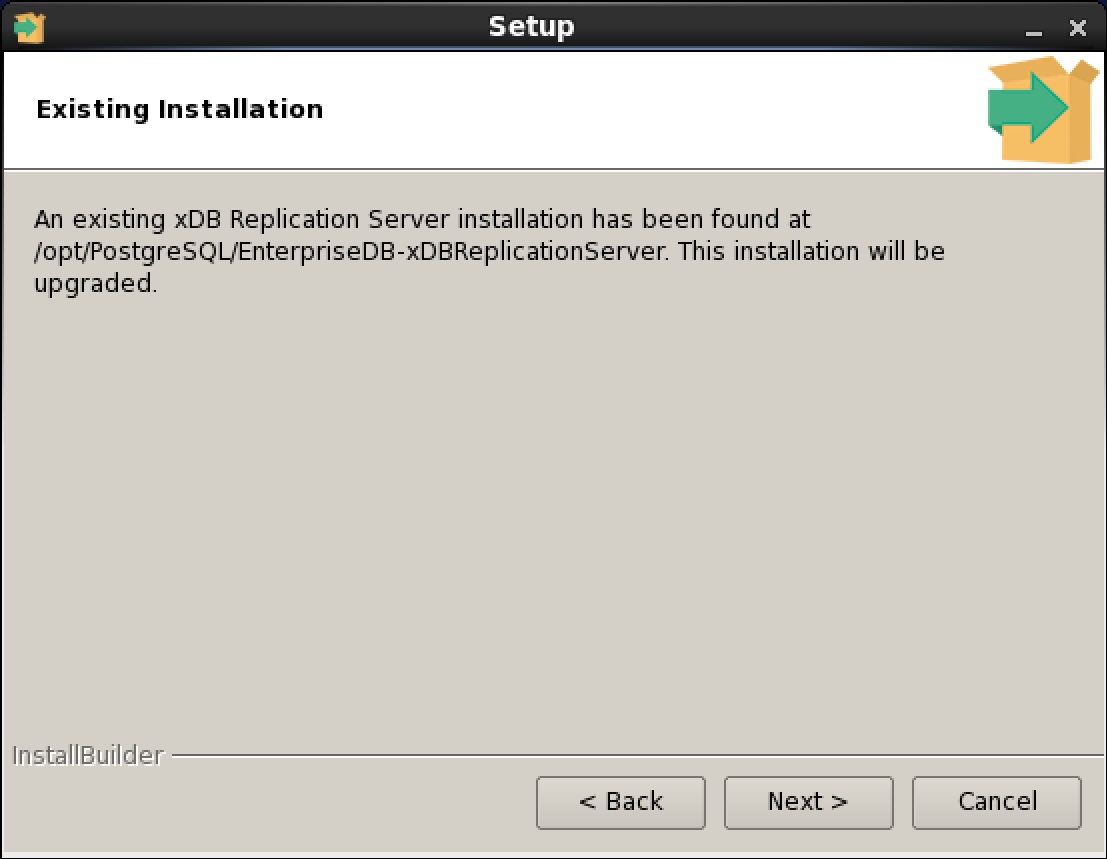
• 管理者のパスワード。 [管理者ユーザー]フィールドで指定されたxDB管理者用に選択したパスワード。管理ユーザーと管理パスワード(暗号化された形式)は、 \etc\edb-repl.conf (WindowsホストのXDB_HOME \etc\edb-repl.conf ) という名前の /etc/edb-repl.conf レプリケーション構成ファイルに保存されます。 [次へ]ボタンをクリックします。ステップ16(公開サーバーが選択されたコンポーネントである場合のみ):公開サーバーが実行される利用可能なポートを入力します。デフォルトのポート番号は9051です。 [次へ]ボタンをクリックします。ステップ17(サブスクリプションサーバーが選択されたコンポーネントの場合のみ):サブスクリプションサーバーが実行される使用可能なポートを入力します。デフォルトのポート番号は9052です。 [次へ]ボタンをクリックします。ステップ18:パブリケーションサーバーまたはサブスクリプションサーバーを実行するオペレーティングシステムアカウントの場合、 postgres (Oracle互換構成モードでインストールされたAdvanced Serverを使用している場合はenterprisedb )を入力します。ステップ19: [インストールの準備完了]画面で、[次へ]ボタンをクリックします。ステップ20:インストールが完了すると、次の画面が表示されます。 [完了]ボタンをクリックします。ステップ21: StackBuilder Plus Installation Complete画面で、Finishボタンをクリックします。
3.2 コマンドラインからのインストール
• テキスト。インストーラーを呼び出してコマンドラインからインストールを実行するときに--mode textパラメーターを含め、その間にユーザー入力のプロンプトが表示されます。
• 無人。インストーラーを呼び出してユーザー入力なしでインストールを実行する場合は、 --mode unattendedパラメーターを含めます。この場合、インストーラーを呼び出すときにコマンドラインで--optionfileパラメーターを指定するか、パラメーター設定を含むファイルを指定するために--optionfileパラメーターを使用する必要があります。
• 注:コマンドラインからEnterpriseDB製品をインストールする方法の詳細については、次の場所にある 『 EDB Postgres Advanced Serverインストールガイド』を参照してください。注: xDB Replication Serverコンポーネント(xDB Replication Console、パブリケーションサーバー、またはサブスクリプションサーバー)をインストールするホストにJava Runtime Environment(JRE)バージョン1.7以降をインストールする必要があります。 Oracle JavaやOpenJDKなどのJava製品を使用できます。注: 9.3より前のAdvanced Serverバージョンの場合、JavaランタイムがAdvanced Serverインストールプロセスの一部として提供およびインストールされますが、ホストに別個のJavaランタイムシステムを事前にインストールしておく必要があります。 xDB Replication Serverのインストールプロセスでは、Advanced Serverに付属のJavaランタイムは使用されません。yesまたは1を指定して、インストールを実行せずにxDB Replication Serverコンポーネントとファイルを抽出します。 noまたは0を指定して、xDB Replication Serverのインストールも実行します。デフォルトはnoまたは0です。無人インストール中にユーザーインターフェイスを表示する範囲を指定します。進行状況バーを表示しnone場合は、 none 指定します。プログレスバーを表示する場合はminimal指定します。エラーが発生した場合にダイアログボックスで進行状況バーを表示する場合は、 minimalWithDialogs指定します。デフォルトはminimalです。--optionfile filenameインストールモードを指定します。 qtを指定して、Qtグラフィカルツールキットを使用します。 Gtkグラフィカルツールキットを使用するにはgtkを指定します(Linuxのみ)。指定xwindow (Linuxのみ)X Windowsのグラフィカルツールキットを使用します。コマンドラインコンソールでインストールするtextを指定しtext (Linuxのみ)。ユーザー入力を要求せずにインストールを実行するには、 unattendedを指定します。デフォルトはqtです。--debugtrace debug_logfile--existing-user edb_user_account--existing-password edb_user_passwordインストール言語を指定します。英語の場合はenを指定します。簡体字中国語にはzh_CNを指定します。繁体字中国語にはzh_TWを指定します。日本語にjaを指定します。韓国語にはkoを指定します。デフォルトはenです。--prefix installation_directoryxDB Replication Serverコンポーネントがインストールされるディレクトリ。 Linuxシステムのデフォルトは /opt/PostgreSQL/EnterpriseDB-xDBReplicationServerです。 Windowsシステムの場合、デフォルトはC:\Program Files\PostgreSQL\EnterpriseDB-xDBReplicationServerです。インストールするxDB Replication Serverコンポーネントを指定します。 xDB Replication ConsoleおよびxDB Replication Serverコマンドラインインターフェースにrepconsoleを指定します。 xDB出版サーバーのpubserverを指定します。指定subserver XDBのサブスクリプションサーバーのために。このコンマ区切りリストには、少なくとも1つのコンポーネントを含める必要があります。デフォルトはrepconsole,pubserver,subserverです。--admin_user admin_user--admin_password admin_password--pubport portパブリケーションサーバーのポート番号。デフォルトは 9051です。--subport portサブスクリプションサーバーのポート番号。デフォルトは 9052です。--serviceaccount account_name--servicepassword account_password
EDB Yumリポジトリの使用については、次の場所にあるEnterpriseDB Webサイトから入手可能なEDB Postgres Advanced Serverインストールガイドの 第3章を参照してください 。注:以下では主にxDB Replication Serverバージョン6.2のインストールについて説明しますが、これらの異なるバージョンのインストールを区別するために、以前のxDB Replication ServerバージョンのRPMパッケージへのアクセスについても説明します。各xDB Replication Serverコンポーネントは、個別のRPMパッケージとして利用できます。したがって、1つの yum installコマンドですべてのxDB Replication Serverコンポーネントを yum installできます。または、特定のRPMパッケージのみをインストールすることにより、選択した個々のコンポーネントをインストールすることもできます。
Advanced Serverサーバーのlibsパッケージは、xDB RPMパッケージコンポーネントをインストールするときにYumからアクセスできる必要があります。 edb-as xx -server-libsパッケージには、バージョン9.6以降のための高度なサーバーのリポジトリのパッケージのコンポーネントです。 ppas xx -server-libsパッケージは、バージョン9.5以前のAdvanced Serverリポジトリパッケージのコンポーネントです。ステップ3は、YumがサーバーlibsパッケージにアクセスできるようにAdvanced Serverリポジトリへのアクセスを有効にする方法を示しています。yum install package_namepackage_nameは、前述の表の「パッケージ名」列にリストされているパッケージのいずれかです。注:すべてのxDBコンポーネントは依存しているため、サーバーライブラリパッケージのインストールが必要ですが、Yumを使用すると、xDBコンポーネントのインストール時にサーバーライブラリへの依存関係が認識されます。 Yumは、選択したxDB RPMパッケージとともに、有効なAdvanced Serverリポジトリからサーバーlibsパッケージを自動的にインストールします。手順1: xDB Replication Serverコンポーネント(xDB Replication Console、パブリケーションサーバー、またはサブスクリプションサーバー)をインストールするホストにJava Runtime Environment(JRE)バージョン1.7以降をインストールする必要があります。 Oracle JavaやOpenJDKなどのJava製品を使用できます。注: 9.3より前のAdvanced Serverバージョンの場合、JavaランタイムがAdvanced Serverインストールプロセスの一部として提供およびインストールされますが、ホストに別個のJavaランタイムシステムを事前にインストールしておく必要があります。 xDB Replication Serverのインストールプロセスでは、Advanced Serverに付属のJavaランタイムは使用されません。rootアカウントとして、次のコマンドを実行して、このリポジトリ構成パッケージをインストールします。ステップ3:ディレクトリ/etc/yum.repos.dに、リポジトリ構成ファイルedb.repoが作成されます。このファイルには、テキスト[ repository_name ]始まるエントリで示されるEnterpriseDBリポジトリのリストが含まれています。
•
•
•
• ステップ4: xDB Replication Server RPMパッケージをインストールします。yum install ppas-xdbxDB Replication Serverは、ディレクトリの場所 /usr/ppas-xdb- x インストールされます . xここでx . xは、以下に示すxDB Replication Serverのバージョン番号です。注:パブリケーションサーバーもサブスクリプションサーバーも、インストール後すぐには実行されていません。残りの手順を確認した後、パブリケーションサーバーを起動する場合は、セクション5.2.1を参照してください。サブスクリプションサーバーの起動については、セクション5.3.1を参照してください。ステップ5(xDB Replication Server 6.2または6.1の場合): xDBレプリケーション構成ファイル/etc/edb-repl.confでは、デフォルトのパスワード( edb )を管理ユーザーパスワードとして使用するか、または次のパスワードに置き換えることができます。あなたの選択。独自のパスワードを使用する場合は、パスワードの暗号化された形式を生成する方法についてセクション10.4.2を参照してください。 xDBレプリケーション構成ファイルのadmin_passwordパラメーターに暗号化されたパスワードを配置します。デフォルトの管理ユーザー名はadmin設定されており、同様に変更できます。 xDBレプリケーション構成ファイルの詳細は、 2.3.1.3項を参照してください。ステップ5(xDB Replication Server 5.1の場合): xDBレプリケーション構成ファイル/etc/edb-repl.conf 、希望するPostgresデータベースへのアクセスを許可するようにパラメーターhost 、 port 、 database 、 user 、およびpasswordが設定されていることを確認しますxDB Controlデータベースとして使用します。現在のデフォルト設定で識別されるデータベース以外を使用する場合は、目的のデータベースを作成し、パラメータを変更して、このデータベースへの接続と認証をxDB制御データベースとして使用できるようにします。手順6:パブリケーションサーバーとサブスクリプションサーバーの起動時にJavaランタイムプログラムにアクセスできるように、xDBスタートアップ構成ファイルのJAVA_EXECUTABLE_PATHパラメーターを設定する必要があります。 Javaプログラムにアクセスできないためにパブリケーションサーバーまたはサブスクリプションサーバーの起動に失敗した場合は、xDB起動構成ファイルでJavaランタイムプログラムへのパスを設定してください。 xDBスタートアップコンフィギュレーションファイルの詳細については、セクション2.3.1.4を参照してください。このファイルの場所については、セクション3.5を参照してください。既存のxDB RPMインストールがある場合は、 yum を 使用 してリポジトリ構成ファイルをアップグレードし、より新しい製品バージョンに更新できます。 edb を更新するには 。 リポジトリ ファイル、スーパーユーザー権限を想定して入力します。yum は edb を更新し ます 。 edbで 指定された資格情報で接続するように構成された現在のEDBリポジトリへのアクセスを可能にする レポ ファイル 。 リポジトリ ファイル。次に、yumを使用して、インストールされているパッケージをアップグレードできます。yum upgrade ppas-xdb
zypper addrepo " http://download.opensuse.org/repositories/Java:/Factory/SLE_12_SP2/Java:Factory.repo "
zypper addrepo "http://download.opensuse.org/repositories/server:/Kolab:/3.3/SLE_12/server:Kolab:3.3.repo"注:パブリケーションサーバーとサブスクリプションサーバーを起動する前に、 /etc/hostsファイルには、次の例に示すように、ホスト名のエントリがホストIPアドレスに関連付けられている必要がありますlinux-dm8sはIPアドレスで、 linux-dm8sはホスト名です。
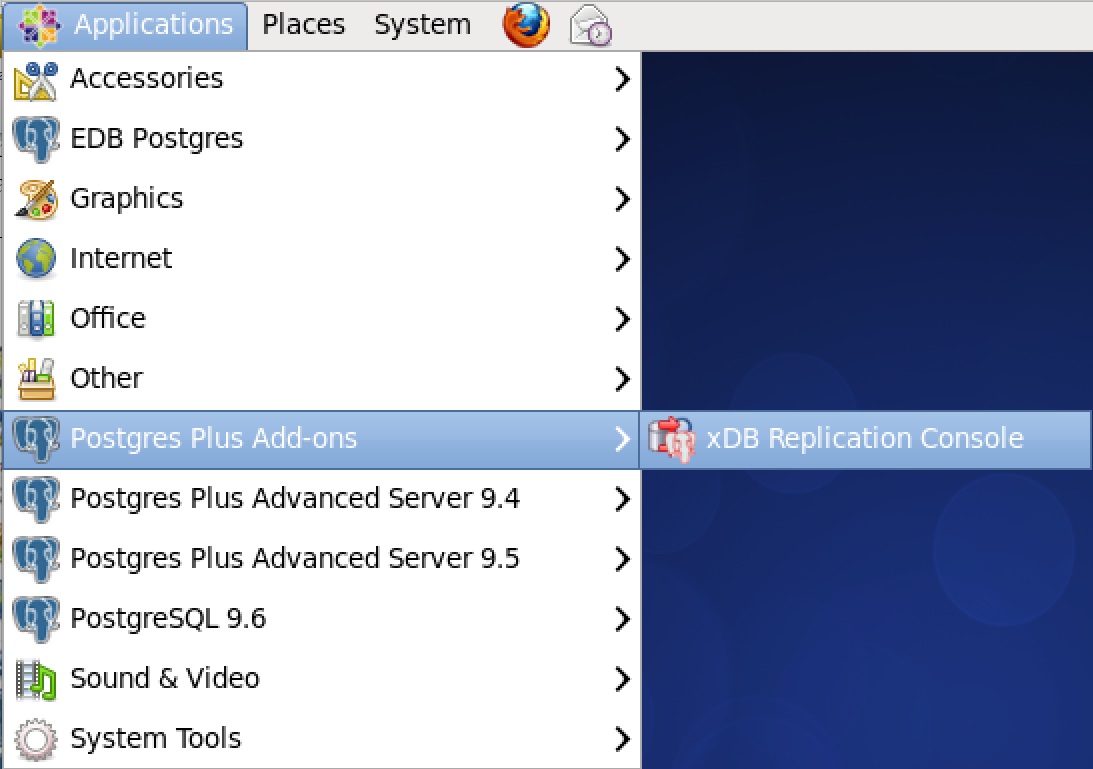
3.5 インストール後のホスト環境グラフィカルユーザーインターフェイスまたはコマンドラインを使用してxDB Replication ServerをインストールしたLinuxホストでは、パブリケーションサーバーおよびサブスクリプションサーバーコンポーネントをインストールすることを選択した場合、コンピューターでパブリケーションサーバーデーモンとサブスクリプションサーバーデーモンを実行する必要があります。 xDB RPMパッケージをインストールした場合、パブリケーションサーバーについてはセクション 5.2.1 、サブスクリプションサーバーについてはセクション5.3.1 の指示に基づいて、パブリケーションサーバーとサブスクリプションサーバーを起動する必要があります。 Windowsシステムでは、パブリケーションサーバーとサブスクリプションサーバーは、 Publication ServiceおよびSubscription Serviceという名前のPublication Serviceとして実行されます。注:一部のLinuxシステムでは、アプリケーションメニューにxDB Replication Consoleの選択肢が表示される前にサーバーを再起動する必要がある場合があります。アプリケーションメニューでxDBレプリケーションコンソールの選択がまだ利用できない場合は、スクリプトXDB_HOME /bin/runRepConsole.shを呼び出して開始できます。注: xDB RPMパッケージからインストールされたxDB Replication Serverの場合、xDB Replication Consoleは、スクリプトXDB_HOME /bin/runRepConsole.shを呼び出すことにより開始されます。
edb-repl.conf (Linux) edb-repl.conf (Windows) XDB_HOME \etc edb-xdbpubserver (Linux) edb-xdbpubserver.service (Linux) edb-xdbsubserver (Linux) edb-xdbsubserver.service (Linux) XDB_HOME /etc XDB_HOME /etc XDB_HOME /etc/sysconfig pubserver.log (Linux) pubserver.log (Windows) subserver.log (Linux) subserver.log (Windows) edb-xdbpubserver.log (Linux) edb-xdbsubserver.log (Linux) 注: XDB_HOMEは、xDB Replication Serverがインストールされているディレクトリーです。注: POSTGRES_HOMEは、 postgresオペレーティングシステムアカウント(Oracle互換構成モードでインストールされたAdvanced Serverのenterprisedb )のホームディレクトリです。注:パブリケーションおよびサブスクリプションサービスのスタートアップログファイル( edb-xdbpubserver.logおよびedb-xdbsubserver.log )は、WindowsおよびMac OS Xオペレーティングシステムでは生成されません。注: USER_HOMEは、使用中のオペレーティングシステムアカウントのホームディレクトリです。
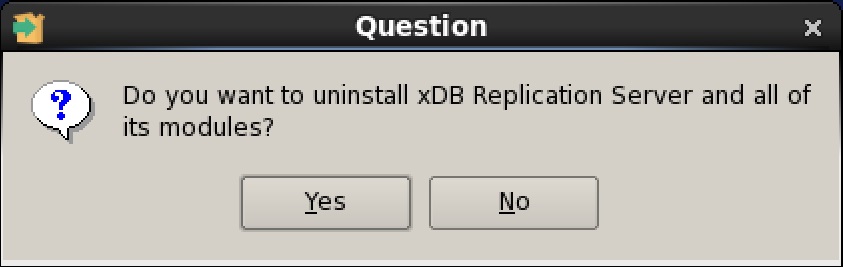
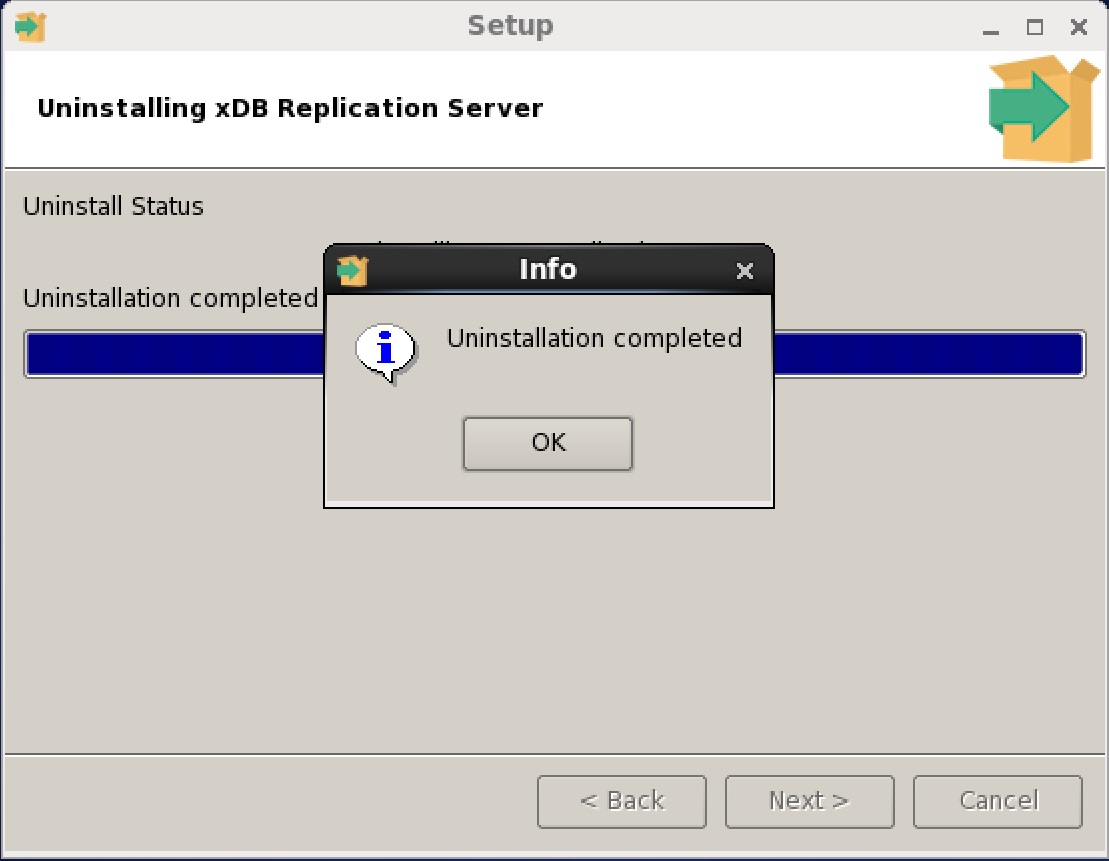
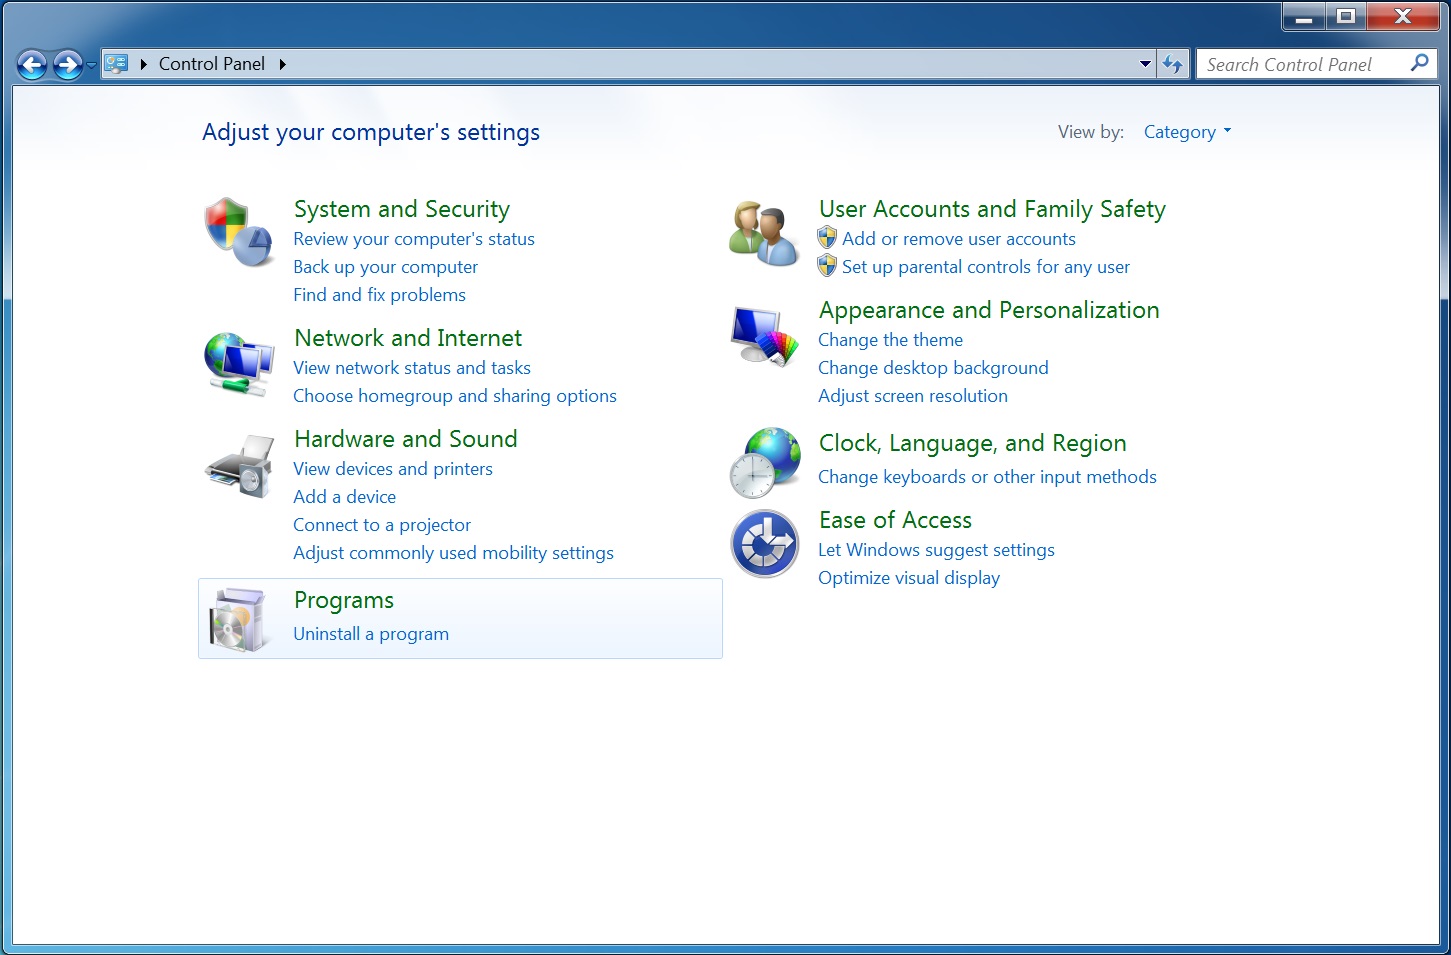
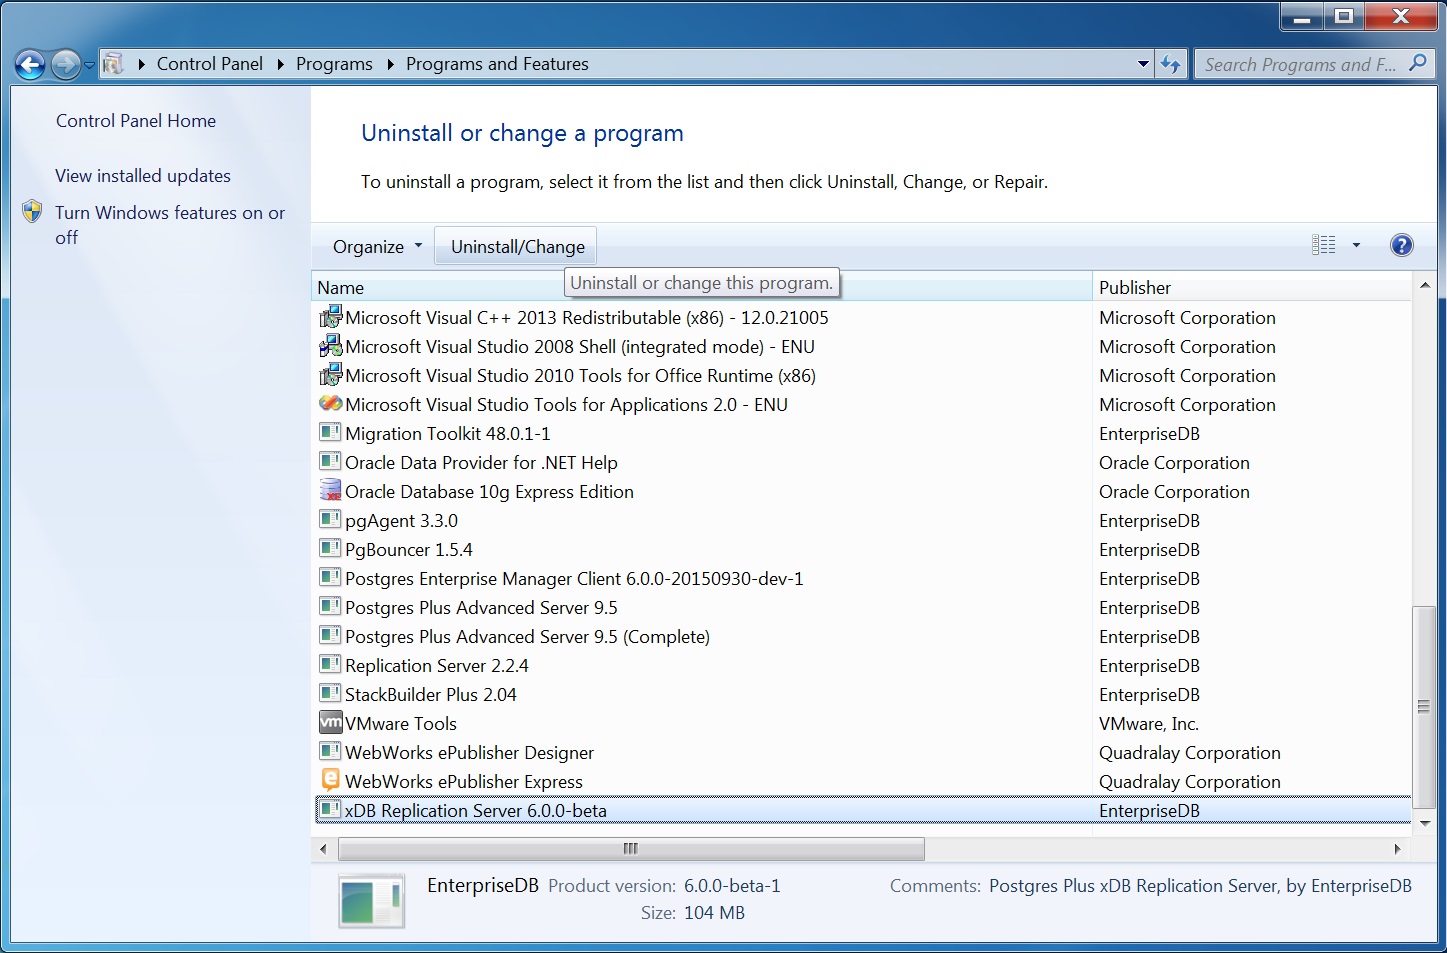
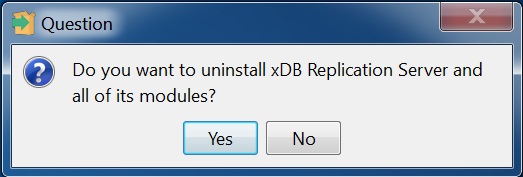
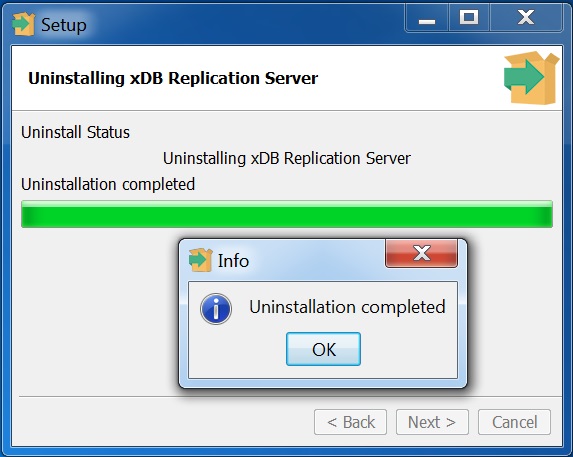
セクション 3.1で 説明したようにStack BuilderまたはStackBuilder Plusから呼び出されたxDB Replication Serverインストーラープログラムを使用してxDB Replication Serverをインストールした場合、またはセクション3.2で説明したようにコマンドラインからxDB Replication Serverインストーラープログラムを呼び出した場合、xDB Replication Serverをアンインストールしてアンインストールしますこのセクションで説明されているuninstall-xdbreplicationserverスクリプト。RPMパッケージからxDB Replication Serverをインストールした場合は、Yumパッケージマネージャーを使用してアンインストールします。詳細については、セクション 3.7を参照してください。Linuxの場合のみ:以下の手順は、LinuxホストからxDB Replication Serverをアンインストールするためのものです。手順1: rootアカウントとして、xDB Replication ServerをインストールしたディレクトリからXDB_HOME /uninstall-xdbreplicationserverスクリプトを実行します。ステップ2: [はい]ボタンをクリックして、xDB Replication Serverのアンインストールを確認します。手順3:プロセスが完了すると、[アンインストールの完了]ダイアログボックスが表示されます。 OKボタンをクリックします。Windowsの場合のみ:次の手順は、WindowsホストからxDB Replication Serverをアンインストールするためのものです。ステップ1: Windowsのコントロールパネルから、[プログラムのアンインストール]を選択します。ステップ2:アンインストールまたは変更するプログラムのリストでxDB Replication Server製品を選択します。 [アンインストール/変更]ボタンをクリックします。ステップ3: [はい]ボタンをクリックして、xDB Replication Serverのアンインストールを確認します。手順4:プロセスが完了すると、[アンインストールの完了]ダイアログボックスが表示されます。 OKボタンをクリックします。
あなたはRPMパッケージからXDB Replication Serverのをインストールした場合は、起動することにより、任意のXDBコンポーネントをアンインストールすることができます yum remove package_nameようなコマンドをrootアカウントpackage_name 、セクションの表に記載されている任意のXDB Replication ServerのコンポーネントのRPMパッケージである3.3 。
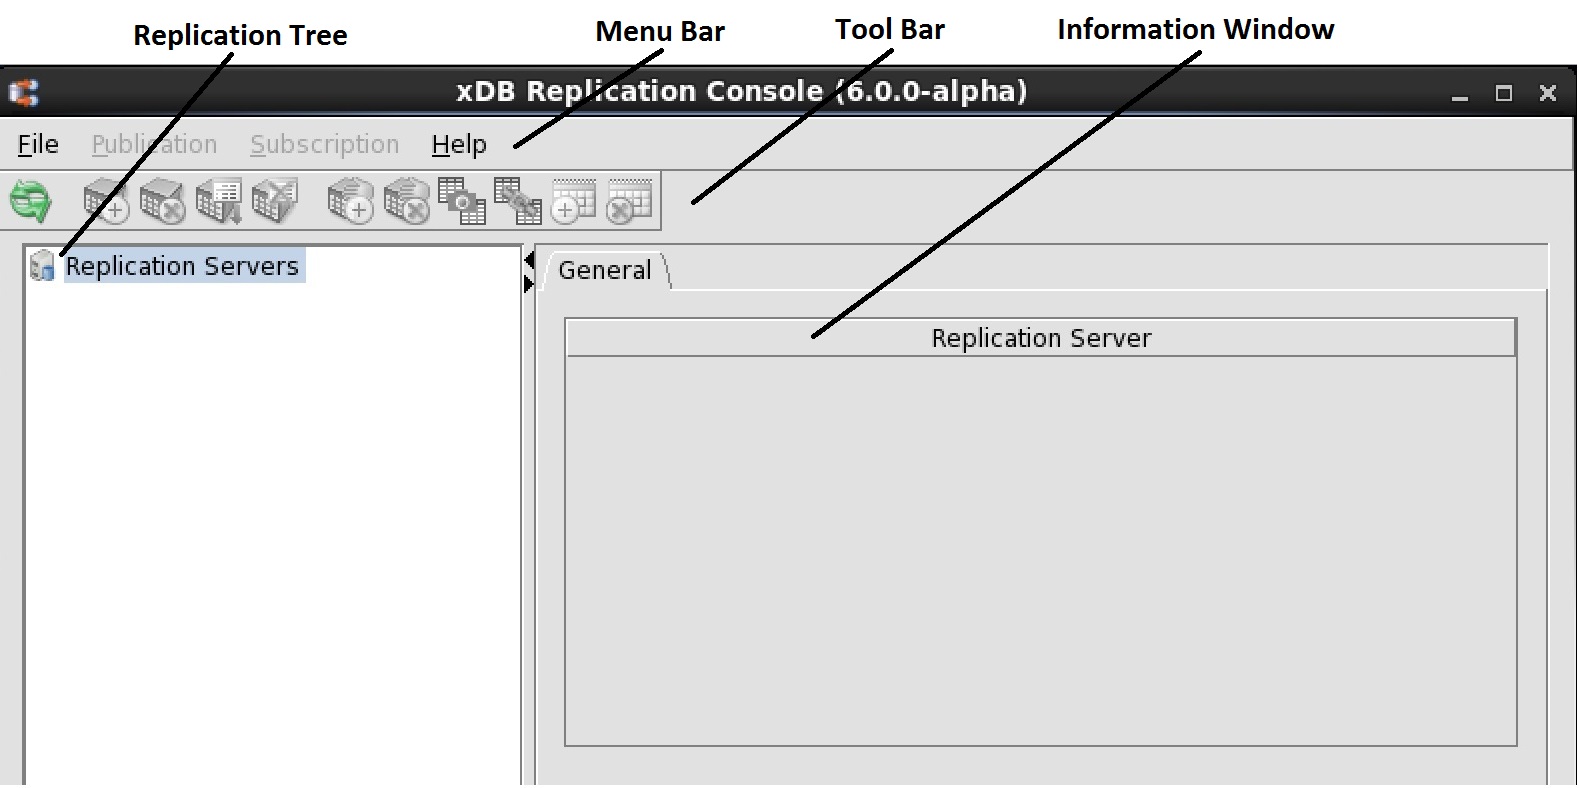
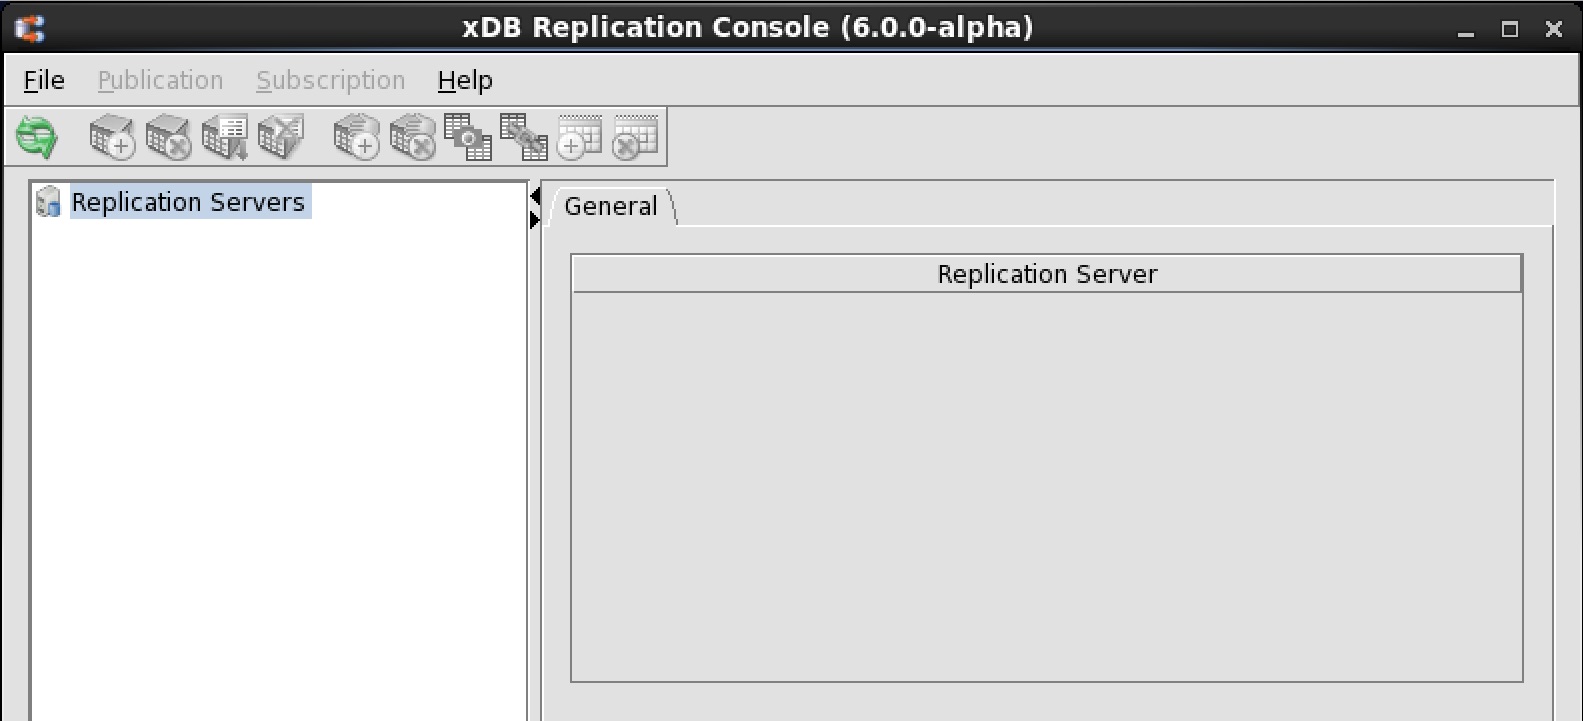
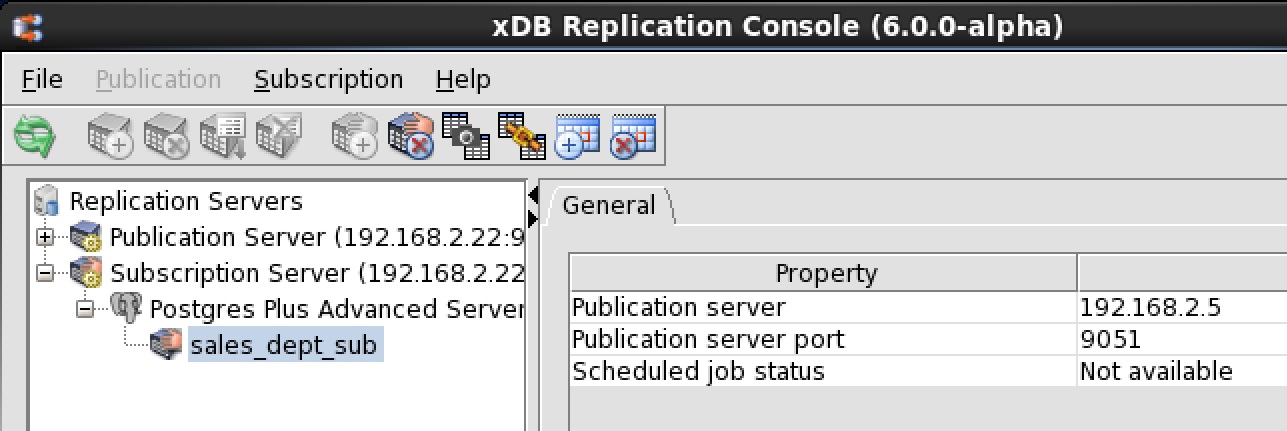
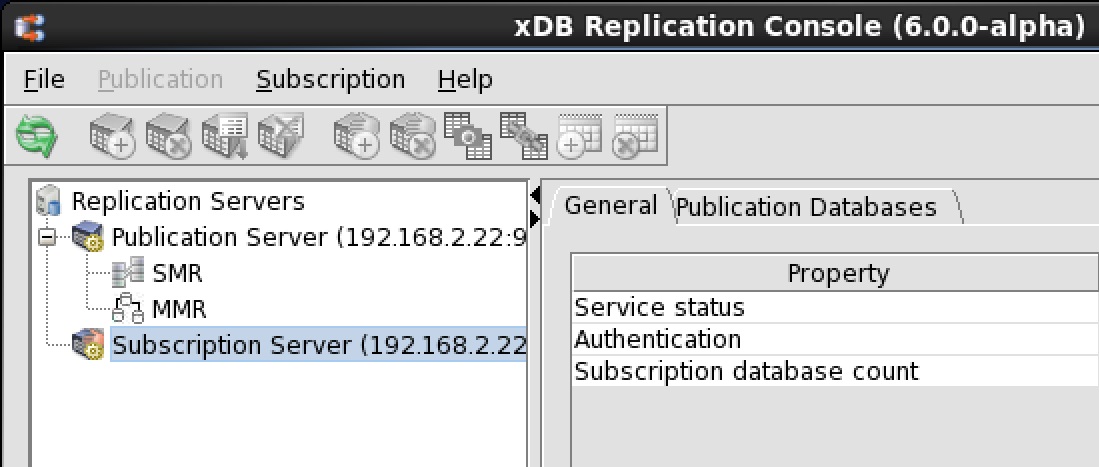
xDBレプリケーションコンソールは、レプリケーションシステムの構成と管理に使用するグラフィカルユーザーインターフェイスです。 xDB Replication Server CLIユーティリティを使用して、同等の機能を実行することもできます。 xDB Replication Server CLIについては、 第 8 章を参照してください 。
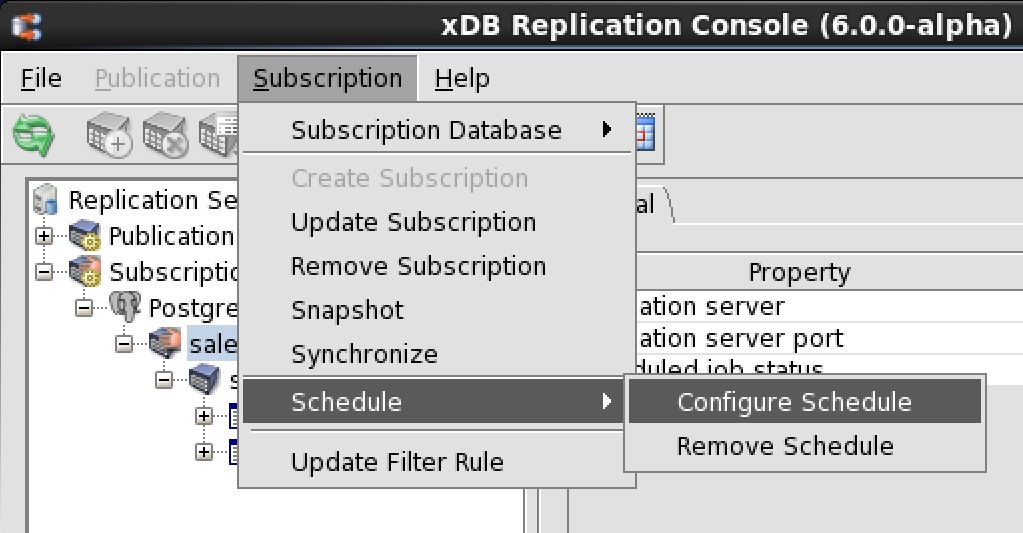
• メニューバー。複製システムコンポーネントのメニュー
• ツールバー。ダイアログボックスにすばやくアクセスするためのアイコン
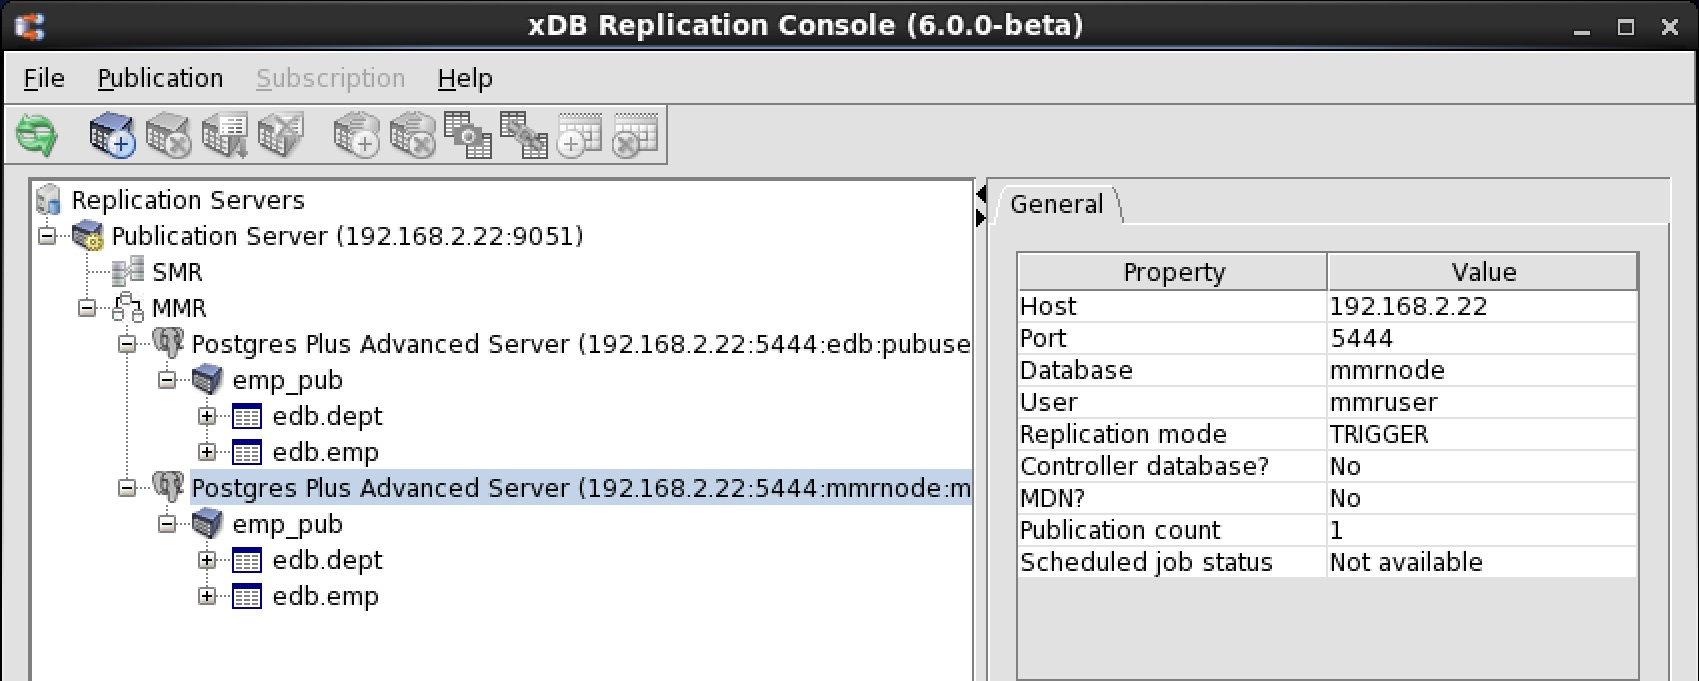
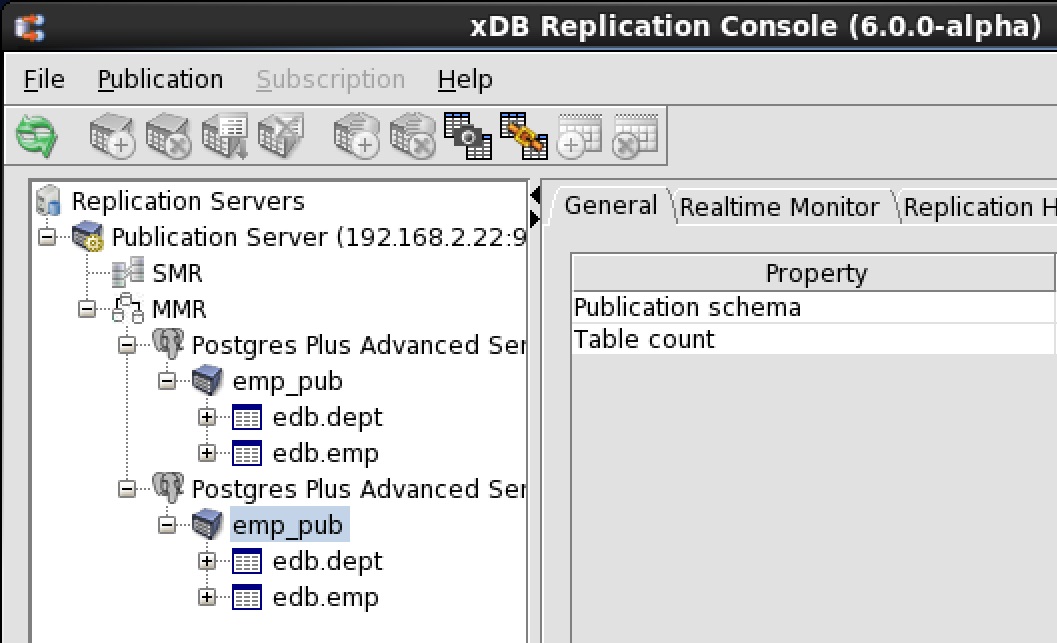
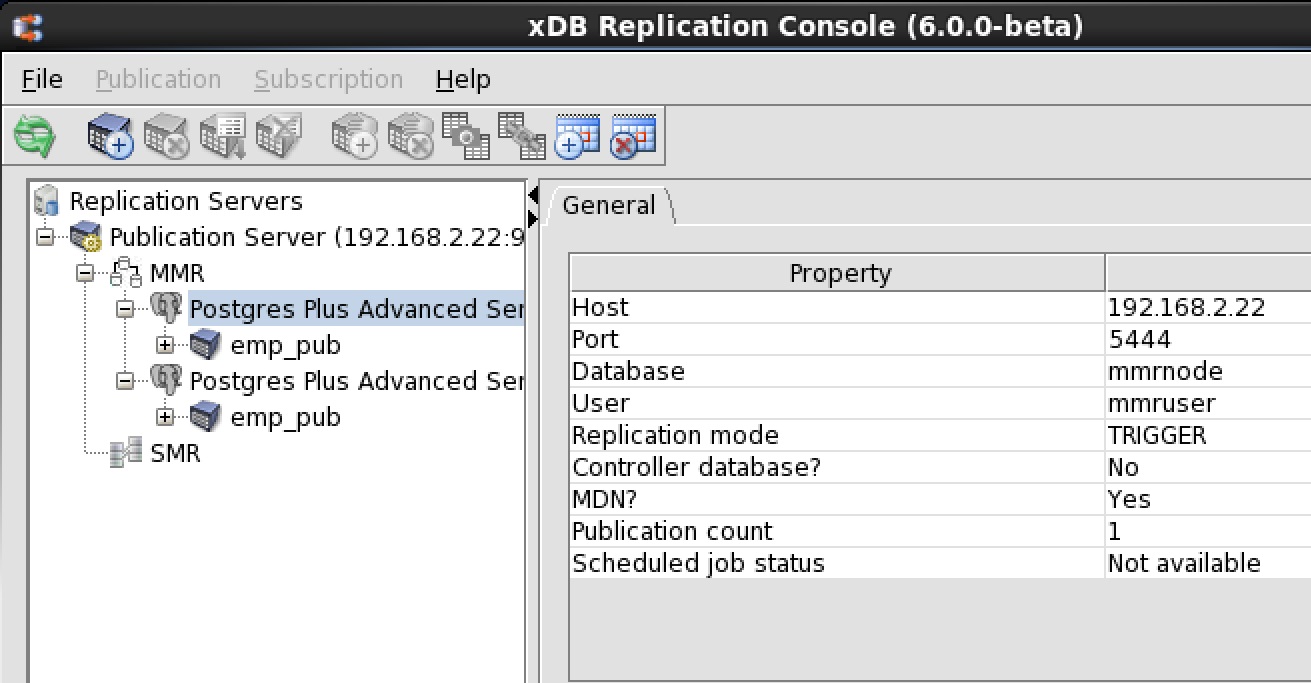
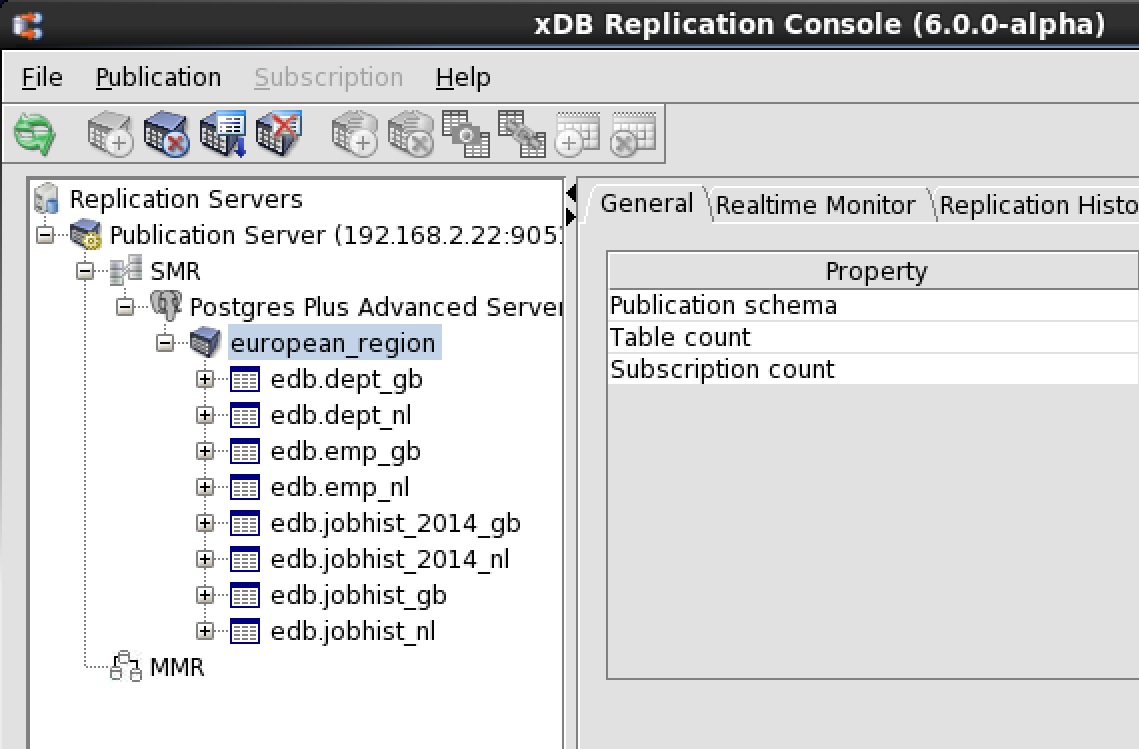
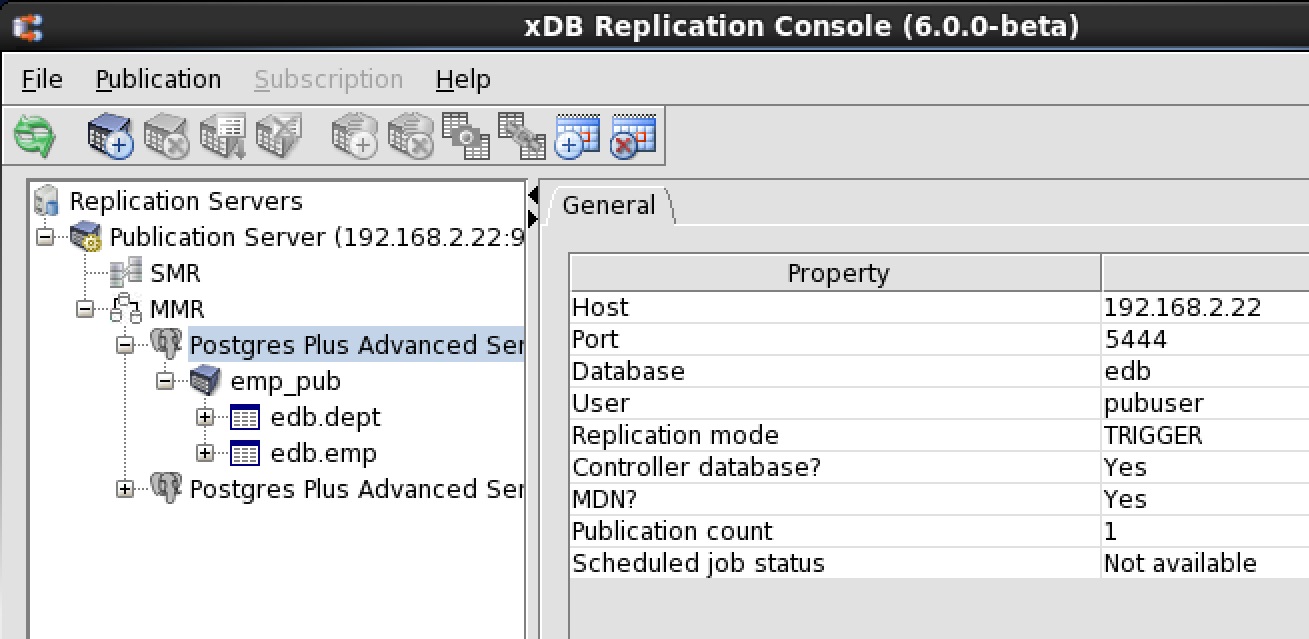
• レプリケーションツリー。逆ツリーのノードとして表される複製システムコンポーネント
• 情報ウィンドウ。レプリケーションツリーで強調表示されたノードに関する情報を含むタブ付きウィンドウ
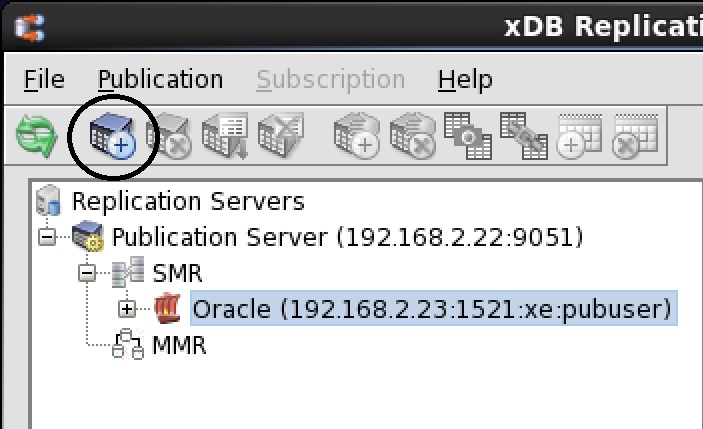
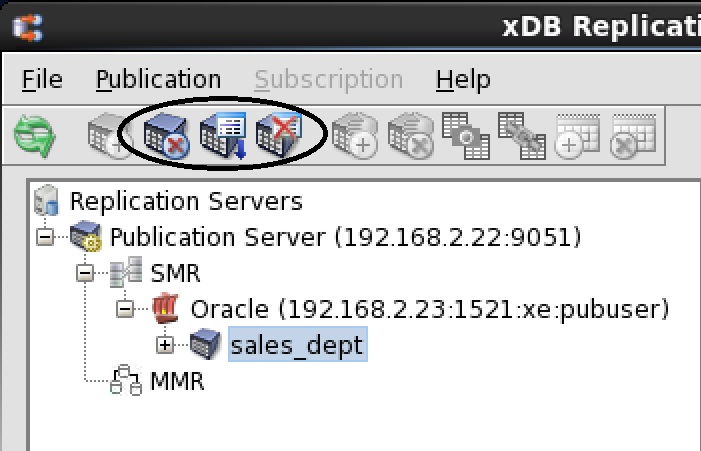
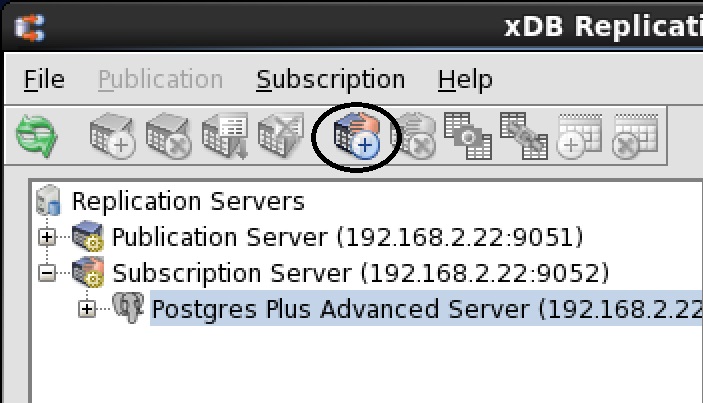
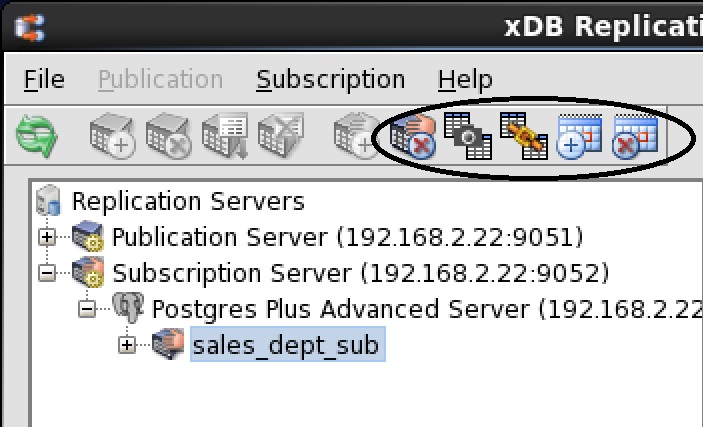
このセクションでは、さまざまなツールバーアイコンがアクティブになるタイミングについて説明します。ツールバーに関連する操作については 、シングルマスターレプリケーションのセクション 5.2および5.3で説明しています 。マルチマスターレプリケーションについては、セクション6.2を参照してください。注:パブリケーションに関連するツールを使用するには、パブリケーションサーバーが実行されている必要があります。同様に、サブスクリプションに関連するツールを使用するには、サブスクリプションサーバーが実行されている必要があります。4.1.1 Refresh4.1.2 Create Publication4.1.3 Publication Management4.1.4 Create Subscription4.1.5 Subscription Management
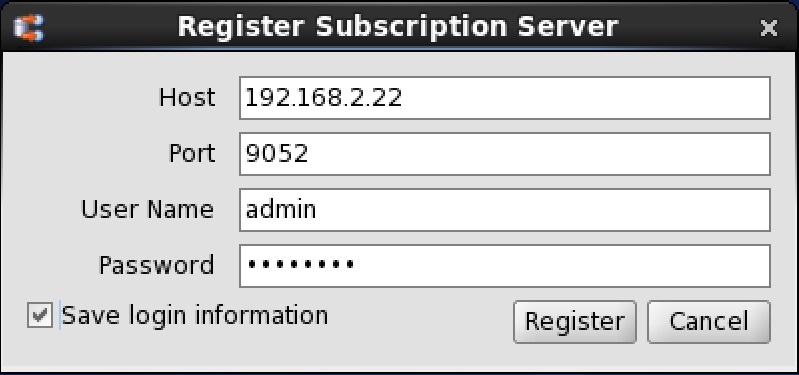
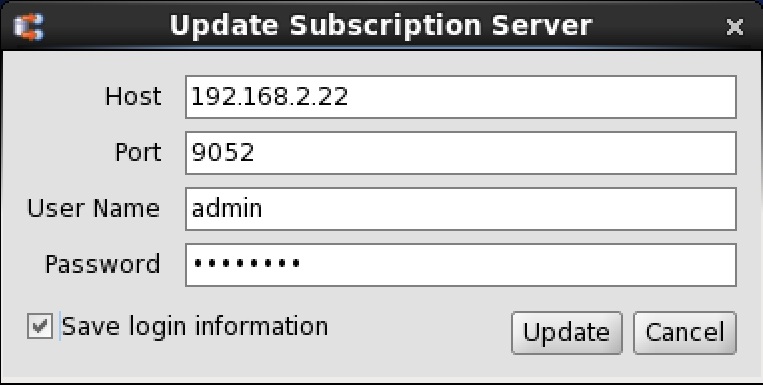
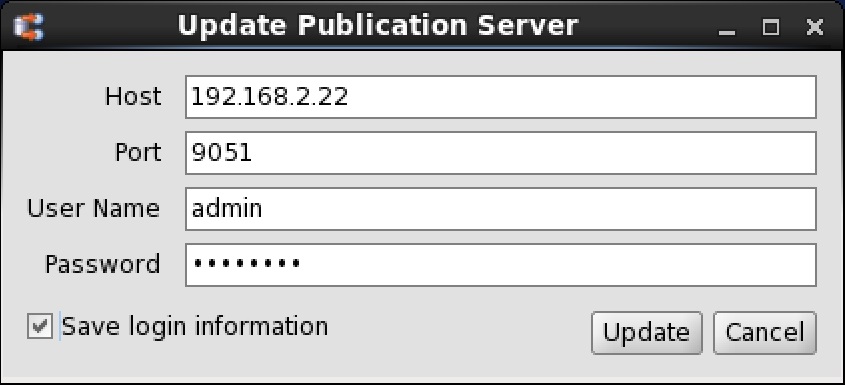
4.2 サーバーログイン情報の保存4.2.1 Server Login Fileログイン情報を保存することを選択した場合、サーバーのネットワークの場所(IPアドレスとポート番号)、管理者ユーザー名、およびパスワードは、ユーザーが使用するオペレーティングシステムアカウントのホームディレクトリの下にある隠し場所のサーバーログインファイルに保存されますxDBレプリケーションコンソールを開きました。このファイルの場所については、セクション3.5を参照してください。ログイン情報を保存するオプションがチェックボックスとして表示される[パブリケーションサーバーの登録]ダイアログボックスを次に示します。この例では、ホストフィールドに入力された192.168.2.22 、ポートフィールドに入力された9051 、ユーザー名フィールドに入力されたadmin 、およびパスワードフィールドに入力されたパスワードの暗号化された形式は、このパブリケーションサーバーのサーバーログインファイルに保存されます管理ユーザー名とパスワードの検証が成功した場合。入力したユーザー名とパスワードの値は 、この場合、 ホスト 192.168.2.22 にあるxDBレプリケーション構成ファイルの管理ユーザー名とパスワードに対して検証されます 。パブリケーションサーバーの登録およびサーバーログインファイルへのパブリケーションサーバーのログイン情報の保存が行われる前に、管理ユーザー名とパスワードが正常に認証される必要があります。 xDBレプリケーション構成ファイルの詳細は、 2.3.1.3項を参照してください。以下に、[サブスクリプションサーバーの登録]ダイアログボックスを示します。この例では、ホストフィールドに入力された192.168.2.22 、ポートフィールドに入力された9052 、ユーザー名フィールドに入力されたadmin 、およびパスワードフィールドに入力されたパスワードの暗号化された形式がこのサブスクリプションサーバーのサーバーログインファイルに保存されます管理ユーザー名とパスワードの検証が成功した場合。注:特定のホスト上の各オペレーティングシステムアカウントには、独自のサーバーログインファイルがあります。したがって、保存され、開いたときにxDBレプリケーションコンソールに表示されるサーバーは、オペレーティングシステムアカウントごとに個別に決定されます。注:パブリケーションデータベースとサブスクリプションデータベースを削除することはできませんが、不正な複製が発生する可能性があります。
5.1 前提条件の手順パブリケーションサーバーとサブスクリプションサーバーは、ヒープサイズパラメーターの既定のセットで実行するように構成されています。 32ビットプラットフォームのデフォルト設定または64ビットプラットフォームのデフォルト設定は 、xDB Replication Serverのインストール時にパラメーター JAVA_HEAP_SIZE によって設定されます 。32ビットシステムでは、初期ヒープサイズは128メガバイト( -Xms128m )に設定され、最大制限は512メガバイト( -Xmx512m )に設定されます。 64ビットシステムでは、初期ヒープサイズは256メガバイト( -Xms256m )で、最大制限は1536メガバイト( -Xmx1536m )です。デフォルト値は 、xDBスタートアップ構成ファイルのJAVA_HEAP_SIZEパラメーター設定を変更することにより変更できます。このような変更を行った後は、必ずパブリケーションサーバーとサブスクリプションサーバーを再起動してください(セクション5.2.1および5.3.1を参照)。
• 最小RAMサイズ。 32ビットシステムの場合、4ギガバイトを使用します。 64ビットシステムでは8ギガバイトを使用します。
• 推奨RAMサイズ。 32ビットシステムの場合、8ギガバイトを使用します。 64ビットシステムの場合、16ギガバイトを使用します。Postgresデータベースサーバーで実行されているパブリケーションデータベースとログベースの同期レプリケーションを使用する場合、Postgresデータベースサーバーの構成ファイル postgresql.confで次の構成パラメーター設定が必要です 。
•
• max_wal_senders。同時接続の最大数(つまり、同時に実行されているWAL送信プロセスの最大数)を指定します。少なくとも、ログベースの方法を使用するこのデータベースサーバー上のSMRパブリケーションデータベースの数に設定します。さらに、このデータベースサーバーでMMRマスターノードを実行する場合は、ログベースの方法を使用するMMRマスターノードの数も追加します。
• max_replication_slots。複製スロットの最大数を指定します。少なくとも、ログベースの方法を使用するこのデータベースサーバー上のSMRパブリケーションデータベースの数に設定します。さらに、MMRマスターノードがログベースの方法でこのデータベースサーバーで実行される場合、必要な追加のレプリケーションスロットの数については、セクション2.2.10.4を参照してください。さらに、 pg_hba.confファイルには、ログベースの方法を使用するパブリケーションデータベースの各パブリケーションデータベースユーザーのエントリが必要です。このようなデータベースユーザーは、 pg_hba.confファイルにレプリケーションデータベースユーザーとして含める必要があります。追加情報については、セクション5.1.6.3を参照してください。5.1.3.1 Enabling Access to Oracle注:このセクションの指示は、Oracleがパブリケーションデータベースまたはサブスクリプションデータベースとして使用される場合にのみ適用されます。ojdbc5.jar などのOracle JDBCドライバーjarファイルは、パブリケーションサーバーとサブスクリプションサーバーを実行しているホスト上のJava仮想マシン(JVM)にアクセスできる必要があります。パブリケーションサーバーとサブスクリプションサーバーが別々のホストで実行されている場合、Oracle JDBCドライバーは各ホストのJVMにアクセスできる必要があります。 Oracle JDBCドライバーバージョンojdbc5以降を使用する必要があります。ステップ1: Oracle JDBCドライバー( ojdbc5.jarなど)をOracleダウンロードサイトからパブリケーションサーバーを実行するホストにダウンロードします。手順3:サブスクリプションサーバーがパブリケーションサーバーとは異なるホストで実行されている場合は、サブスクリプションサーバーのホストに対して手順1と2を繰り返します。5.1.3.2 Enabling Access to SQL Server注:このセクションの指示は、SQL Serverをパブリケーションデータベースまたはサブスクリプションデータベースとして使用する場合にのみ適用されます。jTDS JDBCドライバーjarファイル jtds-1.3.1.jarは、パブリケーションサーバーとサブスクリプションサーバーを実行しているホスト上のJava仮想マシン(JVM)にアクセスできる必要があります。パブリケーションサーバーとサブスクリプションサーバーが別々のホストで実行されている場合、jTDS JDBCドライバーは各ホストのJVMにアクセスできる必要があります。xDB Replication Serverをインストールすると、 jtds-1.3.1.jarファイルがディレクトリXDB_HOME /lib/jdbc配置されるため、この要件のために手動で構成する必要はありません。手順1: SQL ServerデータベースエンジンでSQL Server認証モードが有効になっていることを確認します。 SQL Server認証モードでは、組み込みのシステム管理者ログインsaなどのSQL Serverログインを使用できます。SQL Server認証モードを許可するには、認証モードを Mixed Mode Authenticationに変更する必要があります。これは、Windows認証とSQL Server認証の両方を許可します。これは、 SQL Server Management Studio を使用して実行できます 。 SQL Server Management Studioの使用については、適切なSQL Serverのドキュメントを参照してください。手順2: SQL ServerがTCP / IP接続を受け入れていることを確認します。 SQL Server構成マネージャーの[ SQL Serverネットワーク構成]で、SQL ServerインスタンスのTCP / IPプロトコルが[ Enabled設定されていることを確認します。一般的なデフォルトのSQL Serverインスタンス名はMSSQLSERVERまたはSQLEXPRESSです。ステップ3(SQL Serverパブリケーションデータベースにのみ必要): SQL Serverエージェントが有効で実行されていることを確認します 。 SQL Serverエージェントは、SQL Serverでジョブのスケジューリングと実行を制御するWindowsサービスです。xDB Replication Serverは、スケジュールされたシャドウテーブル履歴のクリーンアップなどの特定の操作にSQL Serverエージェントを使用します(セクション 7.5.1を 参照 )。SQL Server Configuration Manager を使用して、SQL Serverエージェントを起動できます 。 SQL Server Configuration Managerの使用については、適切なSQL Serverのドキュメントを参照してください。特定のパブリケーションに使用されるテーブルとビューは、すべて同じデータベースに存在する必要があります。このデータベースは、そのパブリケーションのパブリケーションデータベースになります。 パブリケーションデータベースのユーザー名は、作成したか、すでに次の特性を持つ存在している必要があります。
• パブリケーションデータベースのユーザー名は pubuserです。
•
•
• パブリケーションデータベースのOracleシステム識別子(SID)は xeです。 SQL Serverパブリケーションデータベース名はedbです。 Postgresパブリケーションデータベース名はedbです。 (パブリケーションデータベースとしてのOracle、パブリケーションデータベースとしてのSQL Server、およびパブリケーションデータベースとしてのPostgresの例については、このセクションの例を参照してください。)Oracleパブリケーションデータベースの準備については、次のセクションを参照してください。 SQL Serverパブリケーションデータベースの準備については、セクション 5.1.4.2を 参照してください 。 Postgresパブリケーションデータベースの準備については、セクション5.1.4.3を参照してください。5.1.4.1 Oracle Publication Database注(Oracle 12cの場合): Oracle 12c マルチテナントアーキテクチャは、複数のプラガブルデータベース (PDB)を含むことができるコンテナーデータベース (CDB)の概念を導入します 。プラグ可能なデータベースは、シングルマスターレプリケーションシステムのパブリケーションデータベースまたはサブスクリプションデータベースとして使用できます。Oracle 12cパブリケーションデータベースまたはサブスクリプションデータベースを使用するためのセットアップ手順は、以前のOracleバージョンと同じです。特別な区別は、指示内の注記で示されます。手順1:パブリケーションデータベースユーザーのデータベースユーザー名を作成します。パブリケーションデータベースのユーザー名にはパスワードが必要であり、データベースセッションを作成できる必要があります。パブリケーションデータベースユーザーは、レプリケーションプロセスと履歴を追跡、制御、および記録するためにパブリケーションデータベースに作成されるコントロールスキーマオブジェクトの所有者になります。注(Oracle 12c Pluggable Databaseの場合):パブリケーションデータベースユーザーは、Oracle ローカルユーザーまたは共通ユーザーにすることができます 。ローカルユーザーは、パブリケーションデータベースとして使用される単一のユーザー作成プラガブルデータベース (PDB)内にのみ存在し、アクセスできます。一般的なユーザー名は通常C##またはc##始まり、複数のプラグ可能なデータベースにアクセスできます。注(Oracle 12cプラグ可能データベースの場合):パブリケーションデータベースとして使用するプラグ可能データベースに接続している間に、ローカルユーザーの特権の作成と付与を行う必要があります。共通ユーザーの作成は、Oracle 12cルートコンテナーCDB$ROOT内で行う必要があります。共通ユーザーへの特権の付与は、パブリケーションデータベースとして使用するプラガブルデータベースに接続している間に行う必要があります。注(Oracle 12c Non-Container Databaseの場合):パブリケーションデータベースユーザーへの特権の作成と付与は、12cより前のOracleバージョンの場合と同じ方法で実行されます。パブリケーションデータベース定義を作成するとき、パブリケーションデータベースのユーザー名は、[パブリケーションサービス-データベースの追加]ダイアログボックスに入力されます(セクション 5.2.2を 参照 )。手順2:コントロールスキーマオブジェクトの作成に必要な特権を付与します。ステップ3:パブリケーションテーブルでトリガーを作成するために必要な特権を付与します。パブリケーションデータベースユーザーにCREATE ANY TRIGGER特権を付与する必要があります。ステップ4:トリガーの作成時にパブリケーションテーブルをロックするために必要な特権を付与します。パブリケーションデータベースユーザーにLOCK ANY TABLE権限を付与する必要があります。ステップ5(Oracle 12cのみ):表領域にアクセスするために必要な特権を付与します。 GRANT UNLIMITED TABLESPACE特権は、パブリケーションデータベースユーザーに付与する必要があります。この要件は、プラガブルデータベースと非コンテナデータベースの両方に適用されます。ステップ6:パブリケーションデータベースユーザーは、パブリケーションに含まれるテーブルとビューを読み取ることができる必要があります。ステップ7(オプション):アプリケーションユーザーが必要とするパブリケーションのテーブルとビューにアクセスするために必要な特権を含む1つ以上の「グループ」ロールを作成します。5.1.4.2 SQL Server Publication Databaseアプリケーションが特定のデータベースに接続すると、アプリケーションはそのデータベースで定義された データベースユーザーの IDと特権を引き継ぎます。任意のデータベースのデータベースユーザーは、ロールメンバシップや特権などのプロパティに関して、他のデータベースのデータベースユーザーとは無関係です。実際、同じデータベースユーザー名を複数のデータベースで定義でき、それぞれに独自のプロパティがあります。各データベースでは、データベースユーザーを SQL Serverログインにマップ できます。データベースユーザーがマップされているSQL Serverログインを使用してアプリケーションがデータベースに接続すると、アプリケーションはそのデータベースユーザーのIDと特権を引き継ぎます。
• 特定の制御スキーマオブジェクトを含むスキーマが存在する必要があります。前述の箇条書きで説明したデータベースユーザーは、このスキーマを所有するか、このスキーマに対する特定の権限を持っている必要があります。これにより、データベースユーザーはこのスキーマでコントロールスキーマオブジェクトを作成および更新できます。このスキーマは、制御スキーマ全体の1つの物理スキーマコンポーネントであり、そのデータベースユーザーのデフォルトスキーマ としても定義する必要があります。制御スキーマ全体を構成する他の物理スキーマは、パブリケーションサーバーによって常に_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerとして作成されます。
• データベースユーザーは 、パブリケーションサーバーが使用するSQL Serverログインにマップされるmsdbデータベースに存在する必要があります。このデータベースユーザーには、 msdbデータベースのdboスキーマでジョブを実行するための特定の特権が必要です。 ( msdbデータベースは、 SQL Serverエージェントがアラートとジョブをスケジュールするために使用されます msdbエージェントはWindowsサービスとして実行されます。)
• パブリケーションテーブルはデータベース edbます。
•
•
• パブリケーションサーバーによって作成された特定のコントロールスキーマオブジェクトを含めるために使用されるコントロールスキーマは pubuserです。他の制御スキーマオブジェクトは、常に_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_scheduler作成されます。
• 注:これらの例のSQLステートメントを実行するには、 sqlcmdユーティリティプログラムを使用します。 USEコマンドは、後続のステートメントが適用されるデータベースを確立します。 GOコマンドは、前述のSQLステートメントをバッチとして実行します。 SQLステートメントのストリーム内でのGOコマンドの配置は、特定のSQLステートメントによっては重要な場合があります。手順1: xDB Replication ServerパブリケーションデータベースユーザーのSQL Serverログインを作成します。ログインにはパスワードが必要です。手順2:データベースmsdbデータベースユーザーとジョブスケジューリングに必要な権限を作成します。手順3:コントロールスキーマオブジェクトの作成と所有権用のデータベースユーザーを作成します。レプリケーションプロセスと履歴を追跡、制御、および記録するために、コントロールスキーマオブジェクトがパブリケーションデータベースに作成されます。この例では、コントロールスキーマオブジェクトの一部がpubuserという名前のスキーマに作成されることを想定しています。注: WITH DEFAULT_SCHEMA句で指定するスキーマ名は、ステップ5で選択したスキーマである必要があります。このスキーマは、 CREATE USER FOR LOGIN WITH DEFAULT_SCHEMAステートメントで使用する前に存在する必要はありません。注:残りの手順は、コマンドがパブリケーションデータベースで指定されていることを前提としています(つまり、 USE edbデータベースは、パブリケーションデータベースedbを現在のデータベースとして確立するために以前に指定されています)。手順4:パブリケーションデータベースユーザーがコントロールスキーマオブジェクトを作成するために必要なデータベースレベルの権限を付与します。ステップ5:いくつかの制御スキーマオブジェクトが存在する制御スキーマを選択します。ステップ6:パブリケーションテーブルでトリガーを作成するために必要な権限を付与します。パブリケーションデータベースユーザーには、パブリケーションテーブルに対するALTER権限が必要です。ステップ7:パブリケーションデータベースユーザーは、パブリケーションに含まれるテーブルとビューを読み取ることができる必要があります。ステップ8(オプション):アプリケーションユーザーが必要とするパブリケーションのテーブルとビューにアクセスするために必要な特権を含む1つ以上の「グループ」ロールを作成します。注:これらのロールの作成は、xDB Replication ConsoleまたはxDB Replication Server CLIを使用してSQL Serverパブリケーションデータベース定義を作成した後にのみ実行できます。 (たとえば、xDB Replication Consoleの使用法については、セクション5.2.2を参照してください。)次の例は、ロール appgroup 作成と、ロールへのパブリケーションテーブルに対する特権の付与を示しています。この例では、ステップ5で、スキーマpubuserがいくつかのコントロールスキーマオブジェクトを格納するコントロールスキーマとして選択されていることを前提としています。注(個々のユーザーへの特権の付与):前述のように、パブリケーションテーブルのデータを変更する各アプリケーションデータベースユーザーには、パブリケーションテーブルおよびコントロールスキーマオブジェクトに対する特定の特権を付与する必要があります。このステップで前述したように、この目的でグループロールを使用すると、このプロセスを簡素化できます。注:スキーマレベルで特権を付与する上記のステートメントを使用する代わりに、次のステートメントを使用して、データベースオブジェクトレベルでより詳細なレベルの特権を発行できます。SQL Server 2008の場合:次の特権を付与します。SQL Server 2012、2014の場合:次の権限を付与します。5.1.4.3 Postgres Publication Database
• データベースユーザーにはスーパーユーザー権限があります。データベース構成パラメーター session_replication_roleが、ある公開データベースから別の公開データベースへの制御スキーマの複製を伴うスナップショット操作のreplicaデータベースユーザーによって変更されるため、スーパーユーザー特権が必要です 。
• 手順1:パブリケーションデータベースユーザーのデータベーススーパーユーザーを作成します。パブリケーションデータベースのユーザー名にはパスワードが必要であり、データベースセッションを作成できる必要があります。パブリケーションデータベースユーザーは、レプリケーションプロセスと履歴を追跡、制御、および記録するためにパブリケーションデータベースに作成されるコントロールスキーマオブジェクトの所有者になります。パブリケーションデータベース定義を作成するとき、パブリケーションデータベースのユーザー名は、[パブリケーションサービス-データベースの追加]ダイアログボックスに入力されます(セクション 5.2.2を 参照 )。ステップ2(オプション):アプリケーションユーザーが必要とするパブリケーションのテーブルとビューにアクセスするために必要な特権を含む1つ以上の「グループ」ロールを作成します。注:この手順で説明するプロセスは、シングルマスターとマルチマスターの両方のレプリケーションシステムのPostgresパブリケーションに適用できます。パブリケーションテーブルの挿入、更新、または削除操作を実行するユーザーには、パブリケーションテーブルとそのスキーマ、およびパブリケーションの特定のコントロールスキーマオブジェクトに対する権限が必要です。これらの制御スキーマオブジェクトは、スキーマ _edb_replicator_pub 下にあります 。また、同期レプリケーションのログベースの方法では、パブリケーションテーブルでTRUNCATEコマンドを許可する場合、次の追加の権限を付与します。また、 TRUNCATEコマンドを使用するための同期レプリケーションのログベースの方法では、パブリケーションデータベース定義の作成後に次の特権を付与します。 (シングルマスターレプリケーションシステムのパブリケーションデータベース定義の作成については、セクション5.2.2を参照してください。マルチマスターレプリケーションシステムについては、セクション6.2.2を参照してください。)注(パブリケーションの作成後にロールに特権を付与する):パブリケーションを作成する前に、パブリケーションテーブルの特権を含むロールを作成する必要があります。 (シングルマスター複製システム用のパブリケーションの作成については、セクション5.2.3を参照してください。マルチマスター複製システムについては、セクション6.2.3を参照してください。)パブリケーションを作成すると、その時点で存在するロールにパブリケーションテーブルで付与された特権が、それらのロールのコントロールスキーマオブジェクトに適用されます。したがって、前述の例では、 edb.dept 、 edb.emp 、 edb.jobhist 、またはedb.salesemp を使用して作成されたパブリケーションのコントロールスキーマオブジェクトに必要な特権は、そのパブリケーションの作成時にロールappgroupに付与されます。
• スキーマ_edb_replicator_pub USAGE特権。
• シーケンスrrep_tx_seq USAGE特権。
• ロールが行を挿入、更新、または削除するパブリケーションテーブルに対応するシャドウテーブルに対するINSERT特権。シャドウテーブルは、命名規則rrst_ schema _ table rrst_ schema 。シャドウテーブルは、トリガーベースの同期方法を使用する場合にのみ存在することに注意してください。同期レプリケーションのログベースの方法を使用する場合 、パブリケーションテーブルでTRUNCATEコマンドを使用することをロールに許可する場合は、ロールにコントロールスキーマオブジェクトに対する次の権限を付与する必要があります 。
• スキーマ_edb_replicator_pub USAGE特権。
• テーブル_edb_replicator_pub.rrep_wal_events_queue INSERT特権。特定のパブリケーションのテーブルとビューはすべて同じデータベースに複製する必要があります。このデータベースは、サブスクリプションデータベースと呼ばれます。 サブスクリプションデータベースのユーザー名は、次の特性を使用して作成する必要があります。
• Postgresサブスクリプションデータベースの準備については、 セクション 5.1.5.1を参照してください 。 Oracleサブスクリプションデータベースの準備については、セクション5.1.5.2を参照してください。 SQL Serverサブスクリプションデータベースの準備については、セクション5.1.5.3を参照してください。5.1.5.1 Postgres Subscription Databaseサブスクリプションデータベース定義を作成するとき、サブスクリプションデータベースのユーザー名が[サブスクリプションサービス-データベースの追加]ダイアログボックスに入力されます(セクション 5.3.2を 参照 )。
•
• サブスクリプションデータベースのユーザー名には、PostgreSQLのインストール時に作成されたPostgresユーザー名 postgres (Oracle互換構成モードでインストールされたAdvanced Serverのenterprisedb )を使用します。このオプションを選択した場合は、手順1をスキップして手順2に進みます。手順1:サブスクリプションデータベースユーザーとしてスーパーユーザーを作成します。ステップ2:サブスクリプションデータベースを作成または選択します。SQL Serverパブリケーションデータベースの場合:SQL Serverのパブリケーションテーブルとビューを含むスキーマの名前がdbo場合、サブスクリプションサーバーは、サブスクリプションテーブルのPostgresサブスクリプションデータベースにdbo_sqlという名前のスキーマを作成します。 (スキーマdboは、Postgresで特別に予約されたスキーマです。)5.1.5.2 Oracle Subscription Databaseステップ1(オプション):サブスクリプションデータベースとして使用する既存のデータベースがない場合は、新しいデータベースを作成します。このステップはかなり複雑になる可能性があります。このタスクを実行するには、適切なOracleのドキュメントを参照してください。手順2:サブスクリプションデータベースユーザーのデータベースユーザー名を作成します。サブスクリプションデータベースのユーザー名にはパスワードが必要であり、データベースセッションを作成できる必要があります。サブスクリプションデータベースユーザーは、レプリケートされたデータベースオブジェクトの所有者になります。注(Oracle 12c Pluggable Databaseの場合):サブスクリプションデータベースユーザーは、Oracle ローカルユーザーまたは共通ユーザーにすることができます 。ローカルユーザーは、サブスクリプションデータベースとして使用される単一のユーザー作成のプラガブルデータベース (PDB)内にのみ存在し、アクセスできます。一般的なユーザー名は通常C##またはc##始まり、複数のプラグ可能なデータベースにアクセスできます。注(Oracle 12cプラグ可能データベースの場合):サブスクリプションデータベースとして使用するプラグ可能データベースに接続している間に、ローカルユーザーの特権の作成と付与を行う必要があります。共通ユーザーの作成は、Oracle 12cルートコンテナーCDB$ROOT内で行う必要があります。共通ユーザーへの特権の付与は、サブスクリプションデータベースとして使用するプラガブルデータベースに接続している間に行う必要があります。注(Oracle 12c非コンテナーデータベースの場合):サブスクリプションデータベースユーザーへの特権の作成と付与は、12cより前のOracleバージョンと同じ方法で実行されます。サブスクリプションデータベース定義を作成するとき、サブスクリプションデータベースのユーザー名が[サブスクリプションサービス-データベースの追加]ダイアログボックスに入力されます(セクション 5.3.2を 参照 )。手順3:複製されたデータベースオブジェクトの作成に必要な特権を付与します。ステップ4(Oracle 12cのみ):テーブルスペースにアクセスするために必要な特権を付与します。 GRANT UNLIMITED TABLESPACE特権をサブスクリプションデータベースユーザーに付与する必要があります。この要件は、プラガブルデータベースと非コンテナデータベースの両方に適用されます。5.1.5.3 SQL Server Subscription Databaseステップ1:サブスクリプションデータベースを作成または選択します。注:パブリケーションテーブルとビューを含むスキーマの名前がpublic場合、サブスクリプションサーバーは、サブスクリプションテーブルのSQL Serverサブスクリプションデータベースにpublic_sqlという名前のスキーマを作成します。手順2:サブスクリプションデータベースユーザーのSQL Serverログインを作成します。ログインにはパスワードが必要です。サブスクリプションデータベース定義を作成するとき、SQL Serverログインが[サブスクリプションサービス-データベースの追加]ダイアログボックスに入力されます(セクション 5.3.2を 参照 )。ステップ3:サブスクリプションデータベースには、サブスクリプションテーブルの作成者および所有者となるデータベースユーザーが存在する必要があります。このデータベースユーザーは、手順2で作成したSQL Serverログインにマップする必要があります。手順4:サブスクリプションのスキーマとテーブルを作成するために、サブスクリプションデータベースユーザーが必要とするデータベースレベルの権限を付与します。5.1.6.1 Firewalls and Access to Portsパブリケーションサーバーは、セクション 3.1の 手順16の[パブリケーションサーバーの詳細]画面で指定したポート番号と、この指定したポート番号より2大きい値のポートオフセットを使用します。したがって、デフォルトのパブリケーションサーバーのインストールでは、ポート番号9051および9053にアクセスする必要があります。サブスクリプションサーバーは、セクション 3.1の ステップ17の[サブスクリプションサーバーの詳細]画面で指定したポート番号と、この指定したポート番号より2大きい値のポートオフセットを使用します。そのため、デフォルトのサブスクリプションサーバーのインストールでは、ポート番号9052および9054にアクセスする必要があります。xDB Replication Serverをインストールすると、パブリケーションサーバーとサブスクリプションサーバーに指定したポート番号は、次の例に示すようにxDBスタートアップ構成ファイルに保存されます。 xDBスタートアップコンフィギュレーションファイルの詳細については、セクション 2.3.1.4を参照してください 。注:既存のレプリケーションシステムがあるパブリケーションサーバーまたはサブスクリプションサーバーのポート番号を変更する場合、これらの既存のレプリケーションシステムで実行する必要がある追加の更新があります。サブスクリプションサーバーで使用されるポート番号が変更された場合、コントロールスキーマ内のパブリケーションサーバーメタデータに対して行う必要がある変更については、セクション7.6.1.2を参照してください。パブリケーションサーバーが使用するポート番号が変更された場合に、コントロールスキーマ内のサブスクリプションメタデータに対して行う必要がある変更については、セクション5.5.3を参照してください。5.1.6.2 Network IP AddressesLinuxのみ: /sbin/ifconfigコマンドを使用します。Windowsのみ:コマンドプロンプトウィンドウを開き、 ipconfigコマンドを使用します。Linuxのみ:ホストのネットワークIPアドレスがホスト名に関連付けられるように、 /etc/hostsファイルを変更する必要がある場合があります。ループバックアドレスが 127. x 場合 . x .上記の例のようにxが返されます。代わりにネットワークIPアドレスがホスト名に関連付けられるように/etc/hostsファイルを編集/etc/hostsます。次の例は、ホスト名localhostがループバックアドレス127.0.0.1ではなくネットワークIPアドレス192.168.2.22に関連付けられるように変更された /etc/hostsファイルを示して /etc/hostsます。一部のLinuxシステムでは、 /etc/hostsファイルを変更した後にネットワークサービスを再起動する必要がある場合があります。これは、次のバリエーションに示すように、使用しているLinuxシステムに応じてさまざまな方法で実行できます。hostname -iコマンドはホストのネットワークIPアドレスを返します。5.1.6.3 Postgres Server AuthenticationPostgresデータベースサーバーは、ホストベースの認証ファイル pg_hba.conf使用して、データベースサーバー内のデータベースへのアクセスを制御します。前述の各ケースでpg_hba.confファイルに必要な変更については、次のセクションで説明します。pub_dbname 代わりに pub_dbname 値は、使用するPostgresパブリケーションデータベースの名前です。 pub_dbuser代わりにpub_dbuser値は、セクション5.1.4.3の手順1で作成したパブリケーションデータベースのユーザー名です。注:上記の例では、パブリケーションサーバーとサブスクリプションサーバーが同じホスト上で実行されているため、データベースedb単一エントリがedbれています。パブリケーションサーバーとサブスクリプションサーバーが別々のホストで実行されている場合、パブリケーションデータベースサーバー上のpg_hba.confファイルは次のようになります。さらに、前述の例では、パブリケーションデータベース edbがトリガーベースの同期レプリケーションの方法を使用していることを前提としています 。ログベースの方法を使用する場合、 pg_hba.confファイルには、DATABASEフィールドがpub_dbname 、 pub_dbuser 、およびpub_ipaddr replicationに設定された追加のエントリが含まれている必要があります。Postgresアプリケーションメニューから[構成の再読み込み](エキスパート構成、[Advanced Server上の構成の再読み込み])を選択します。これにより、変更された pg_hba.confファイルが有効になります。sub_dbuserおよびsub_dbname 代わりに sub_dbuser 値は、セクション5.1.5.1の手順1および2で作成したサブスクリプションデータベースユーザー名とサブスクリプションデータベース名です。注:前の例では、パブリケーションサーバーとサブスクリプションサーバーが同じホスト上で実行されているため、データベースsubdb必要なエントリは1つだけsubdb 。パブリケーションサーバーとサブスクリプションサーバーが別々のホストで実行されている場合、サブスクリプションデータベースサーバー上のpg_hba.confファイルは次のようになります。Postgresアプリケーションメニューから[構成の再読み込み](エキスパート構成、[Advanced Server上の構成の再読み込み])を選択します。これにより、変更された pg_hba.confファイルが有効になります。
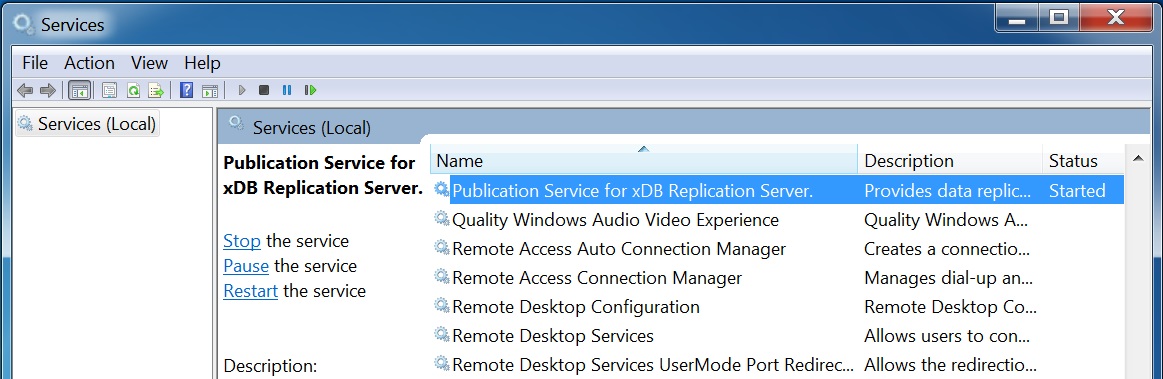
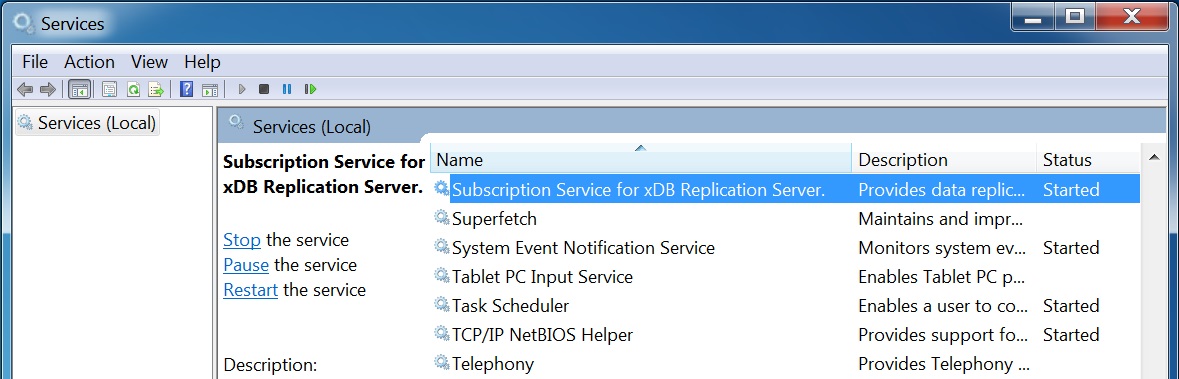
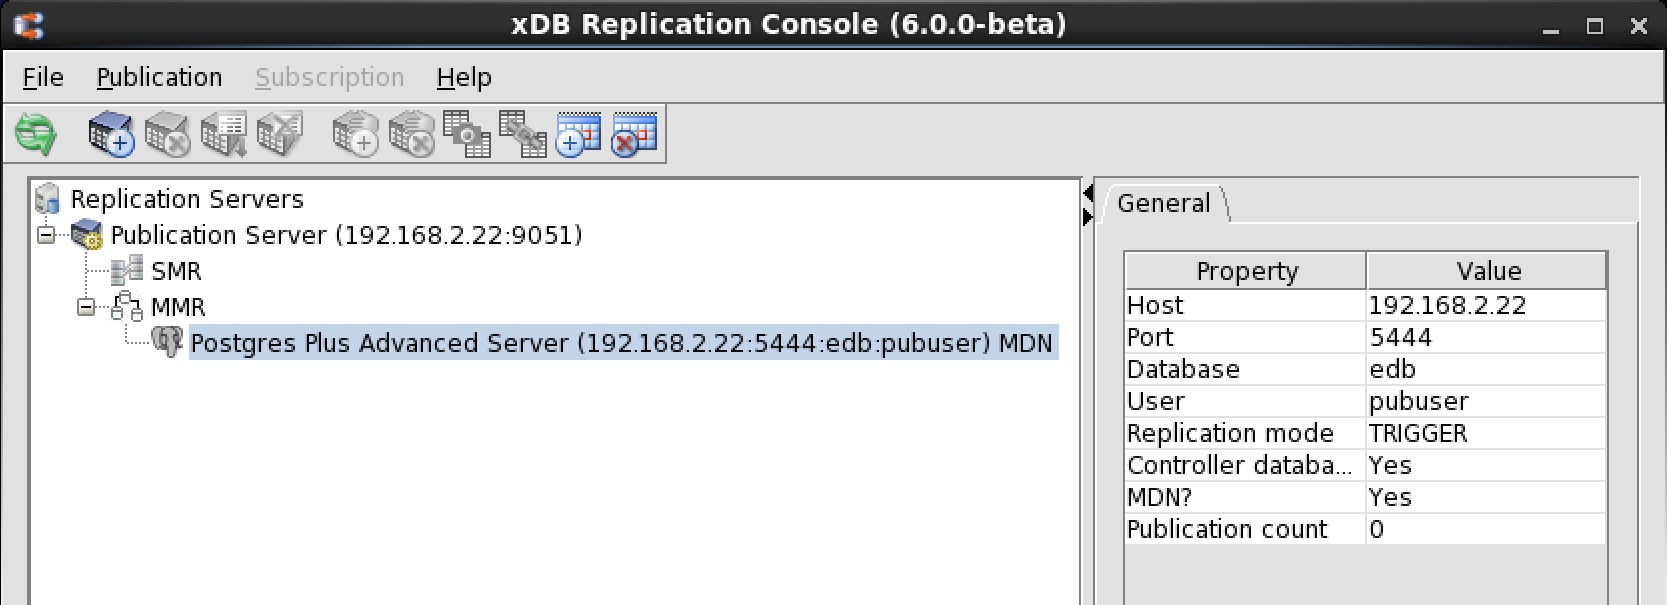
5.2 パブリケーションの作成パブリケーションデータベースを追加すると、パブリケーションデータベースユーザーが読み取り可能で、セクション 2.4.2および2.4.3で 概説されている基準を満たす利用可能なテーブルおよびビューがある限り、多くのパブリケーションを作成できます 。手順1:公開サーバーがまだ実行されていない場合は起動します。注: Oracleパブリケーションまたはサブスクリプションデータベースを使用していて、Oracle JDBCドライバーをxDB Replication Serverインストールのlib/jdbcサブディレクトリにコピーしてからパブリケーションサーバーを再起動していない場合、パブリケーションサーバーを再起動する必要があります。Linuxのみ: CentOS 7またはRHEL 7のsystemctlコマンド、および以前のLinuxバージョンのserviceコマンドを使用して、パブリケーションサーバーが実行されていることを確認できます。Windowsのみ:コントロールパネル、システムとセキュリティ、管理ツール、サービスの順に開きます。パブリケーションサーバーはPublication Service for xDB Replication Serverという名前のサービスとして実行されPublication Service for xDB Replication Server 。ステップ2:パブリケーションサーバーを登録します。システムのアプリケーションメニューからxDBレプリケーションコンソールを開きます。 xDB RPMパッケージからインストールされたxDB Replication Serverの場合、xDB Replication Consoleは、スクリプトXDB_HOME /bin/runRepConsole.shを呼び出すことにより開始されます。ステップ3:最上位のReplication Serverノードを選択します。 [ファイル]メニューの[パブリケーションサーバー]を選択し、[サーバーの登録]を選択します。または、Replication Serversノードで2番目のマウスボタンをクリックし、Register Publication Serverを選択します。 [パブリケーションサーバーの登録]ダイアログボックスが表示されます。
•
• パスワード。 [ユーザー名]フィールドで指定された管理ユーザーのパスワード。
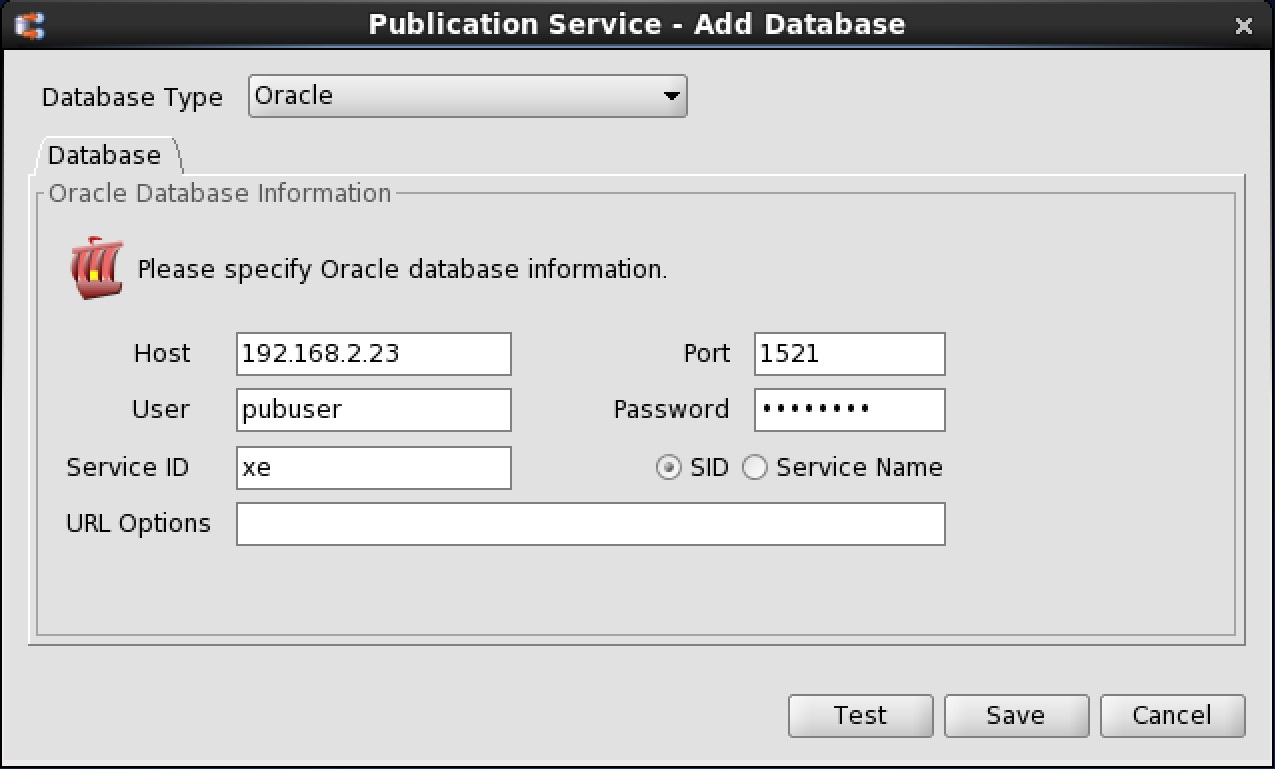
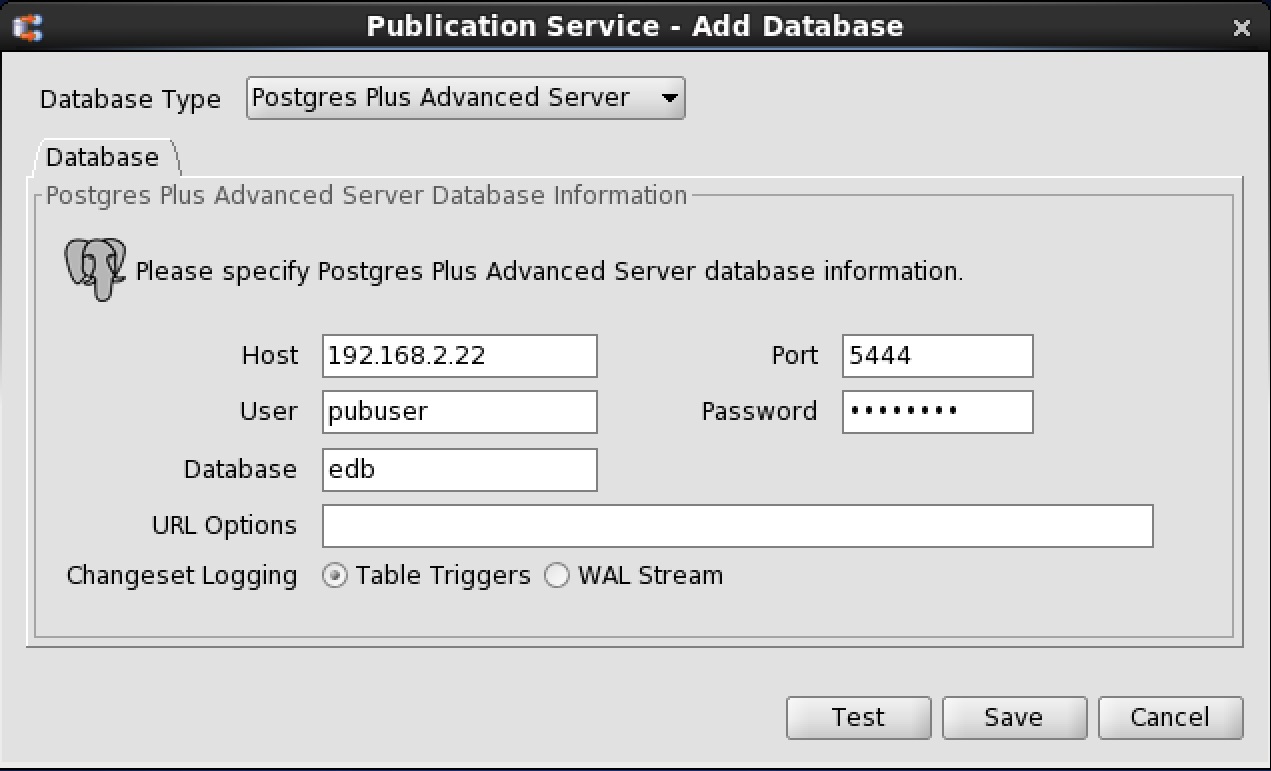
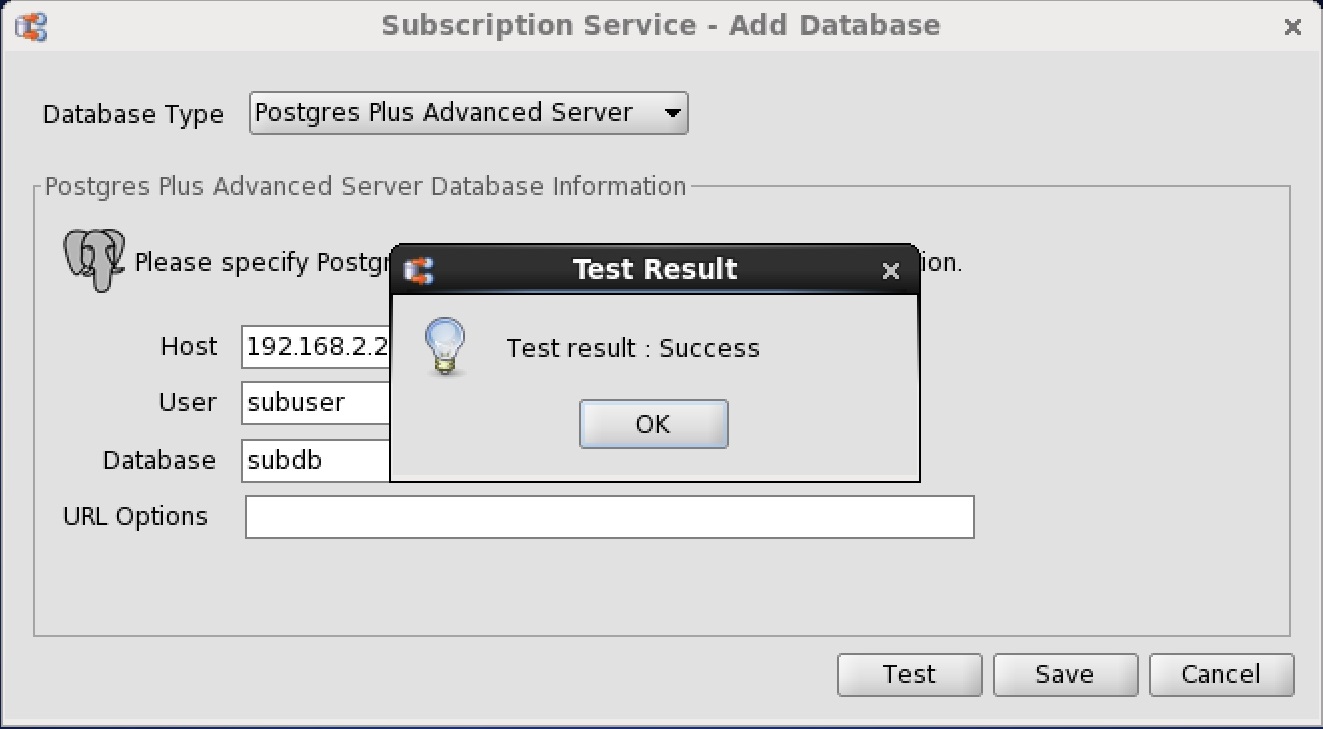
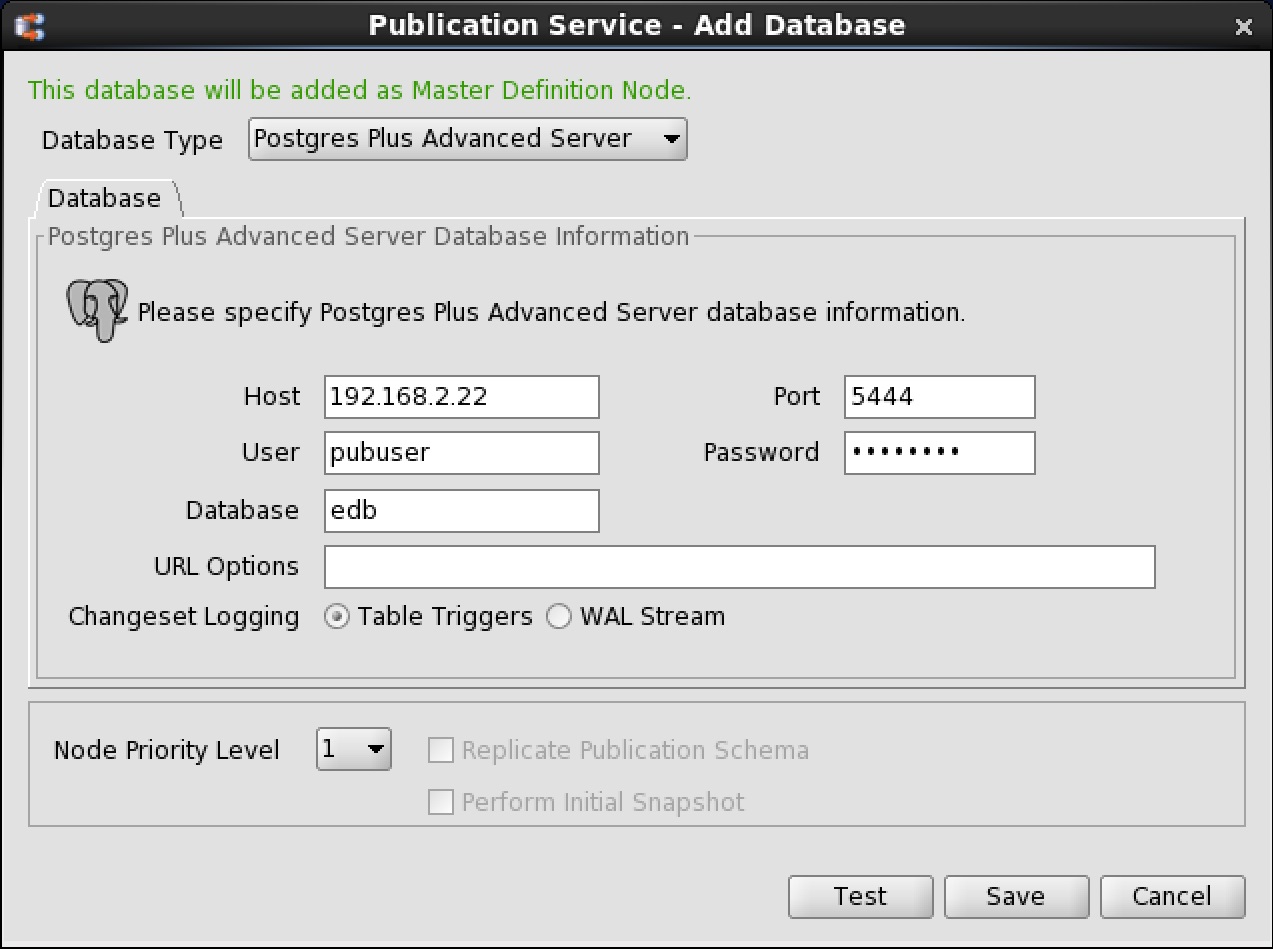
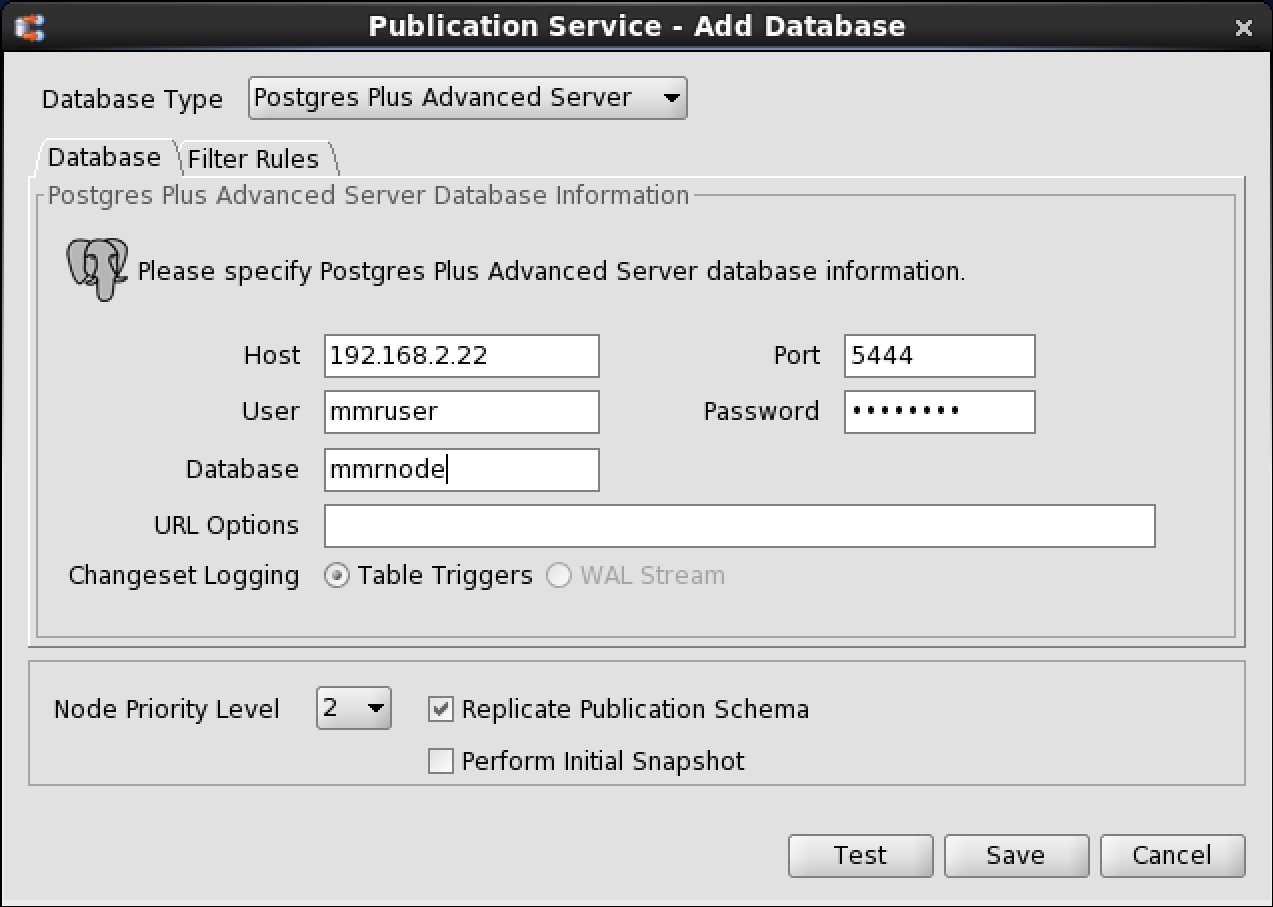
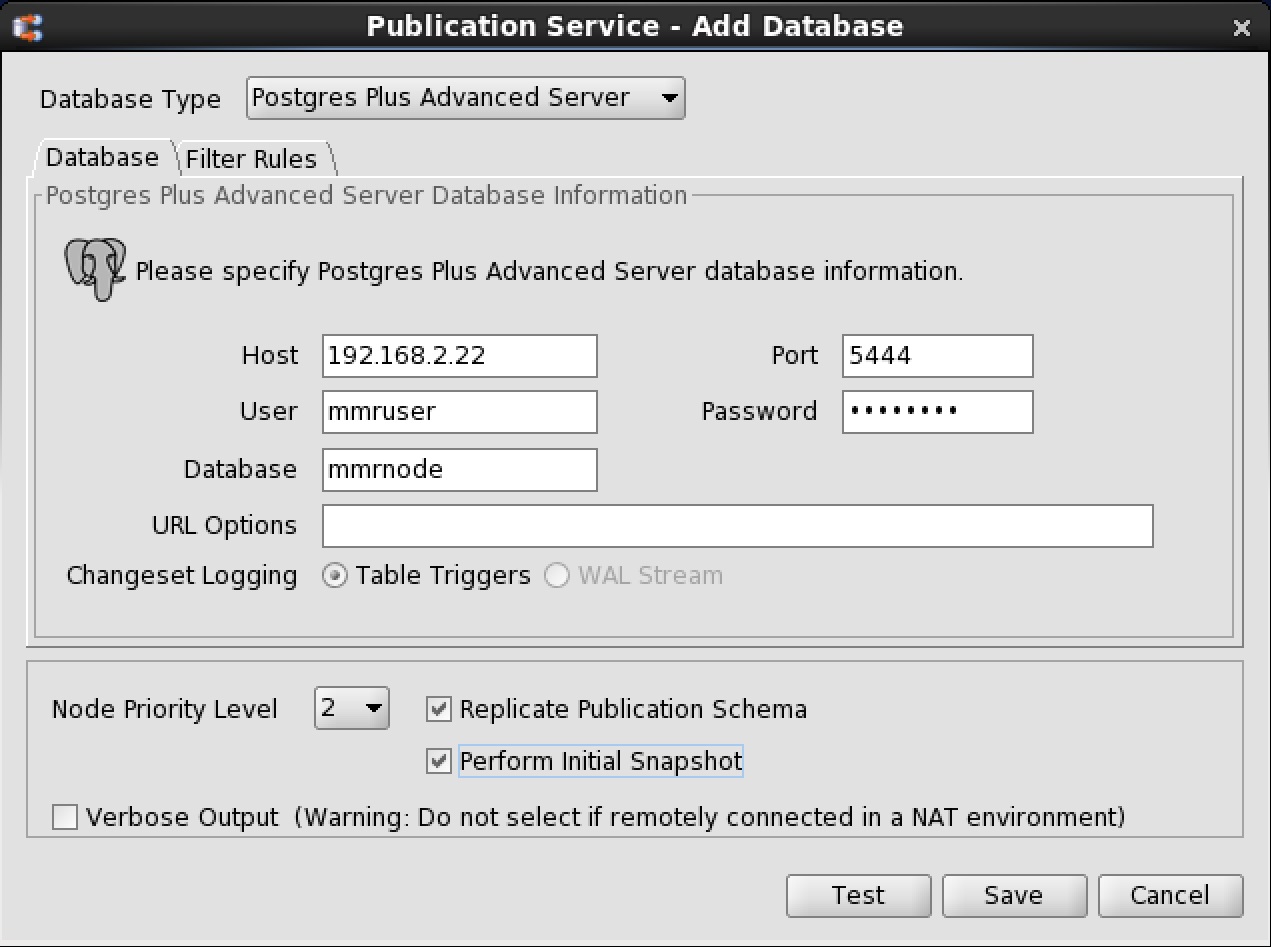
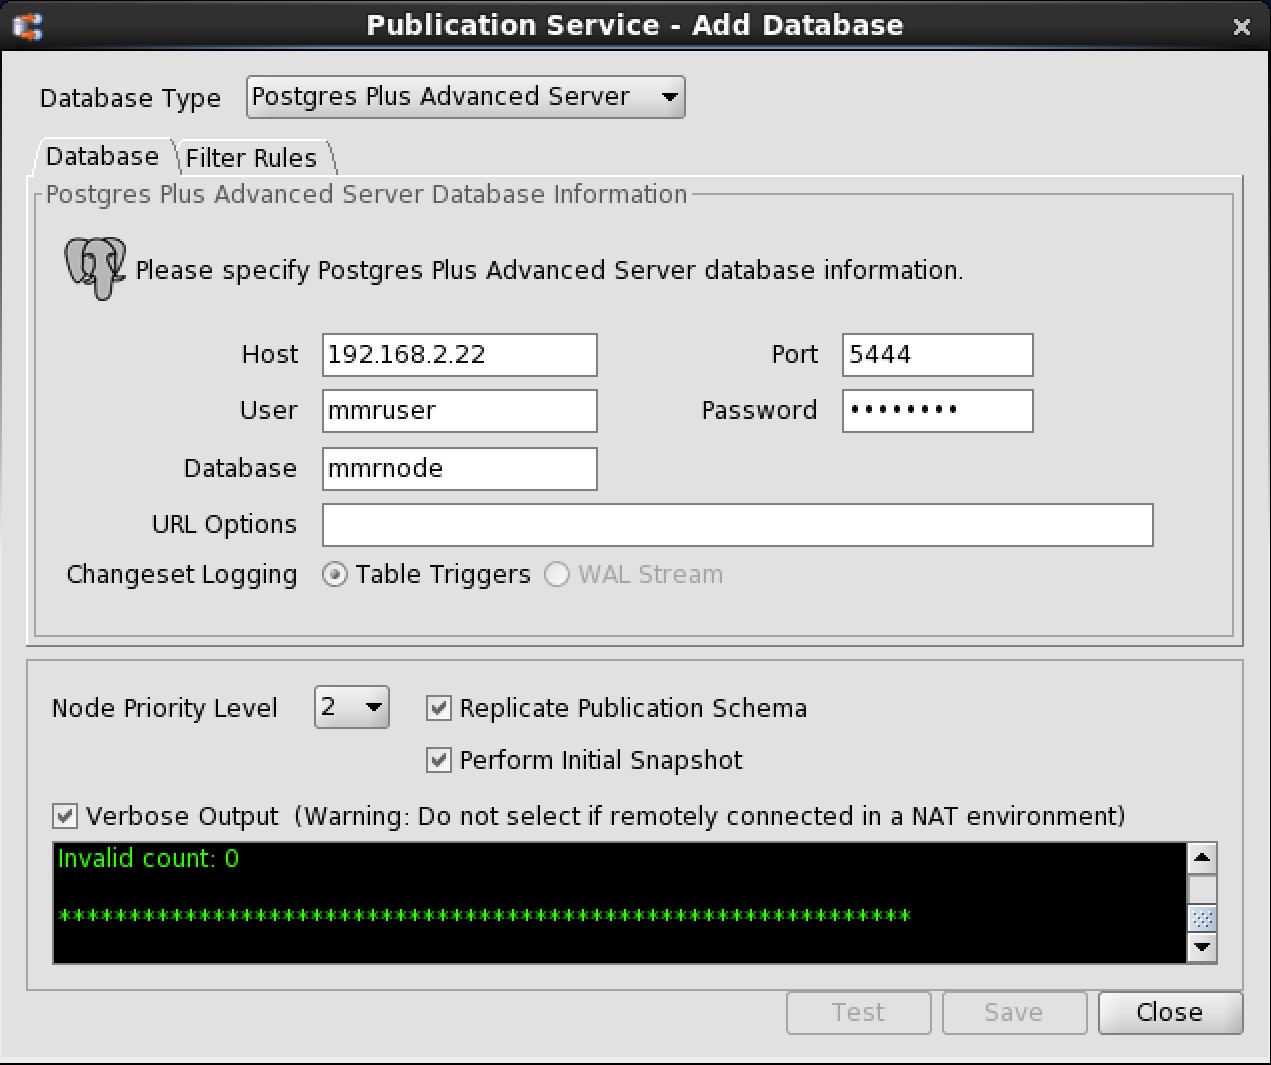
• ログイン情報を保存します。 xDBレプリケーションコンソールを開くたびにパブリケーションサーバーを再登録しない場合は、このボックスをオンにします。サーバーのログイン情報を保存する利点と欠点の詳細については、セクション4.2を参照してください。注:入力したユーザー名とパスワードの組み合わせは、ホストフィールドに入力したIPアドレスを持つホストにあるxDBレプリケーション構成ファイルの管理ユーザー名とパスワードに対して認証されます。手順1:パブリケーションデータベースが存在するデータベースサーバーが実行され、クライアント接続を受け入れていることを確認します。ステップ2: Publication Serverノードの下のSMRタイプノードを選択します。 [出版物]メニューの[出版物データベース]を選択し、[データベースの追加]を選択します。または、SMRタイプノードで二次マウスボタンをクリックし、データベースの追加を選択します。パブリケーションサービス-データベースの追加ダイアログボックスが表示されます。ステップ3:次のフィールドに入力します。
• データベースの種類。パブリケーションデータベースのタイプとして、Oracle、SQL Server、PostgreSQL、またはPostgres Plus Advanced Serverを選択します。 Advanced Server Oracle互換インストールの場合、Postgres Plus Advanced Serverオプションを選択します。 PostgreSQLまたはAdvanced Server PostgreSQL互換インストールの場合、PostgreSQLオプションを選択します。
• ホスト。パブリケーションデータベースサーバーが実行されているホストのIPアドレス。
• 港。パブリケーションデータベースサーバーが接続をリッスンするポート。
• パスワード。データベースユーザーのパスワード。
• サービスID(Oracleの場合)。 [SID]ラジオボタンが選択されている場合、パブリケーションデータベースを実行しているOracleインスタンスのOracleシステム識別子(SID)を入力します。 「サービス名」ラジオボタンが選択されている場合、 TNSNAMES.ORAファイルで定義されている接続記述子のネットサービス名を入力します。 注(Oracle 12cプラグ可能データベースの場合):サービス名を使用します。
• データベース(PostgresまたはSQL Server用)。 PostgresまたはSQL Serverデータベース名を入力します。
• URLオプション(SSL接続用)。 URLオプションを入力して、パブリケーションデータベースへのSSL接続を確立します。 SSL接続の使用については、セクション7.11を参照してください。
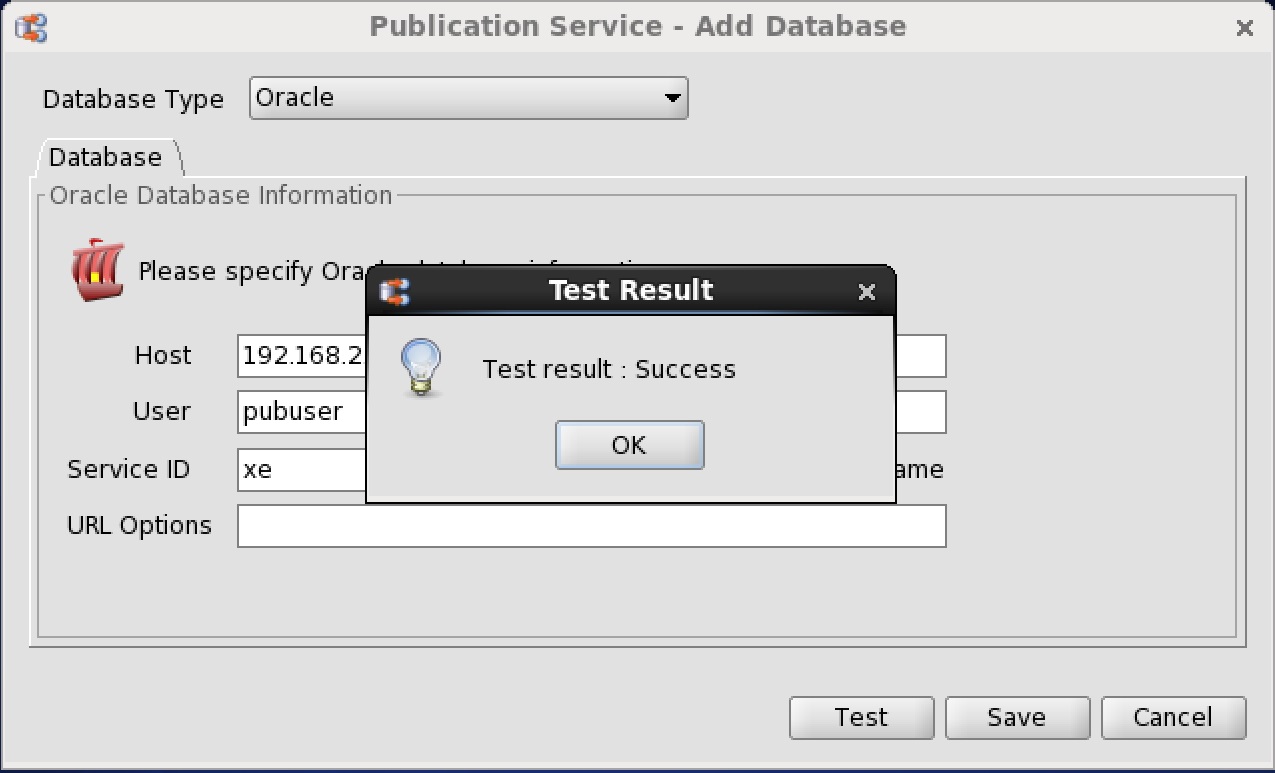
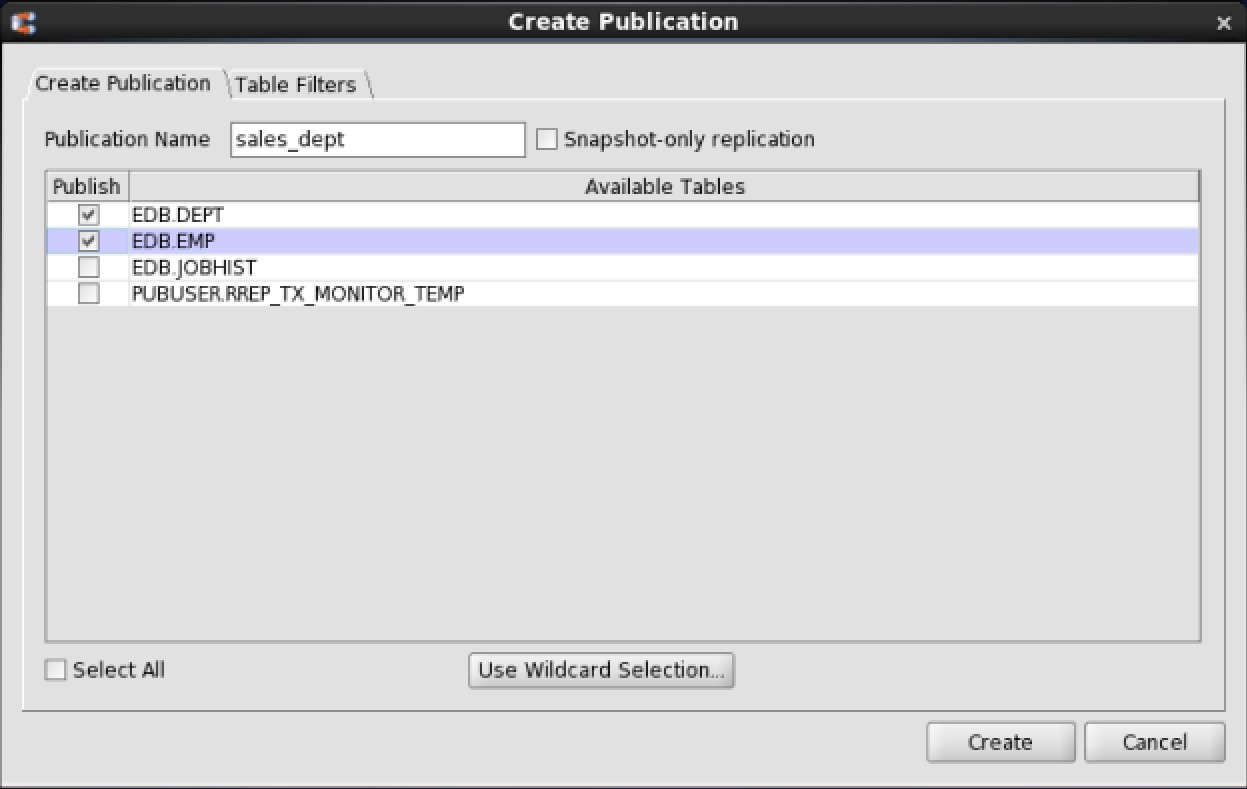
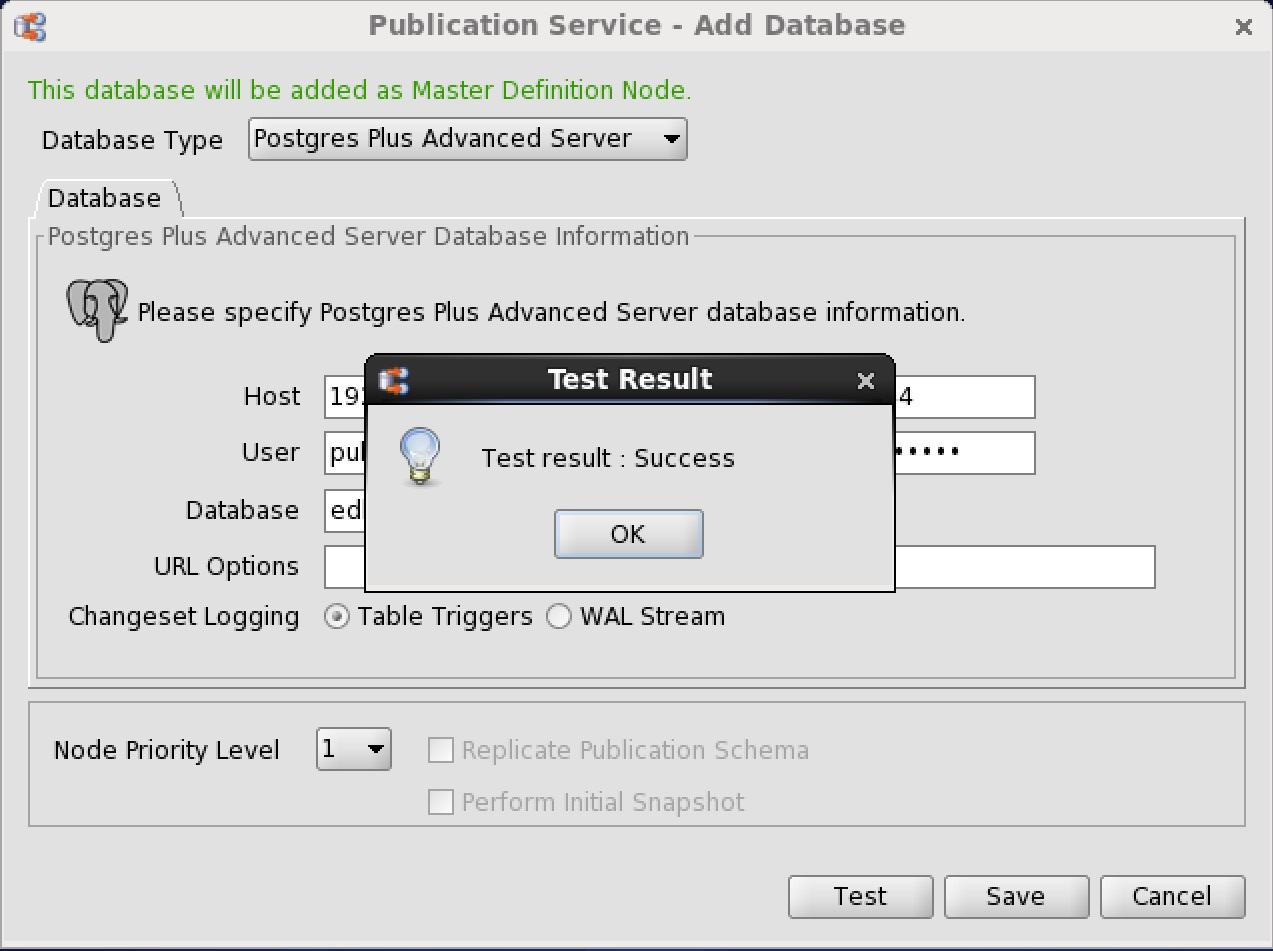
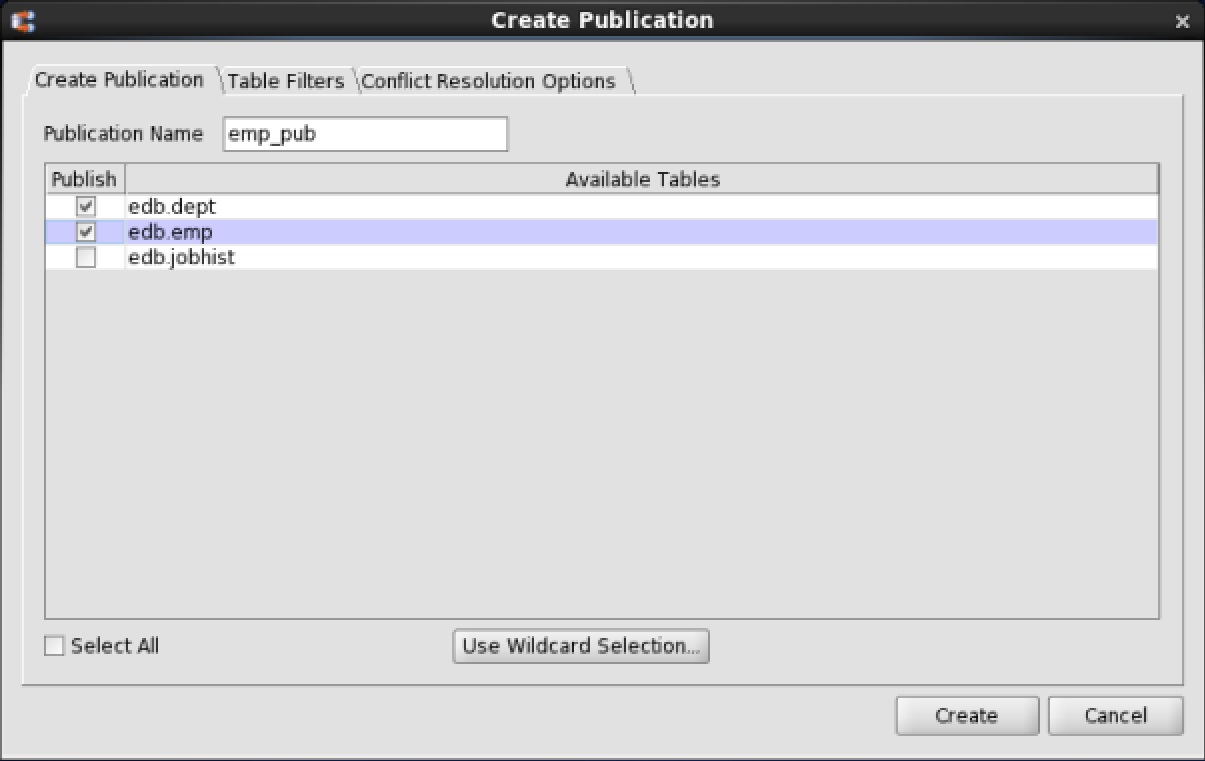
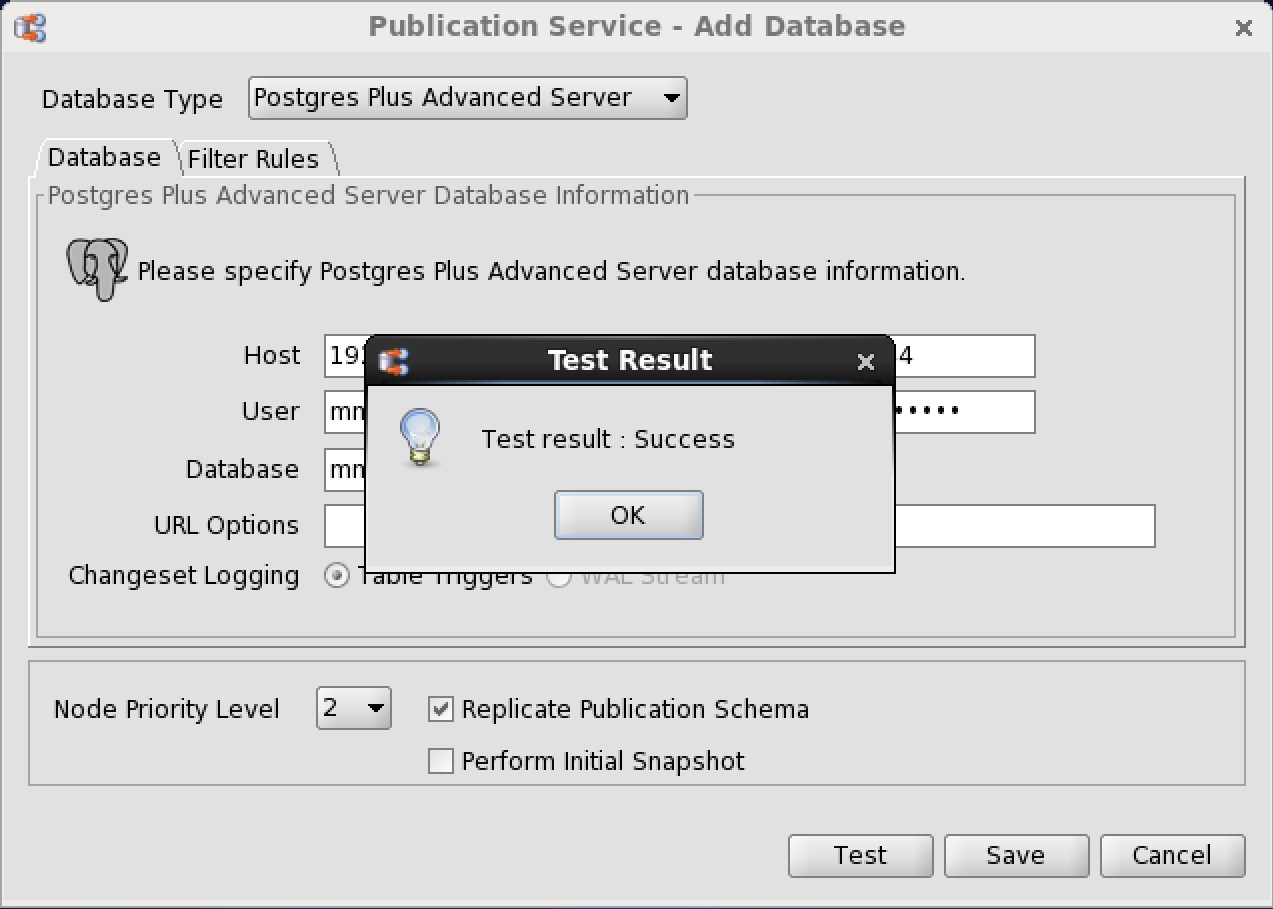
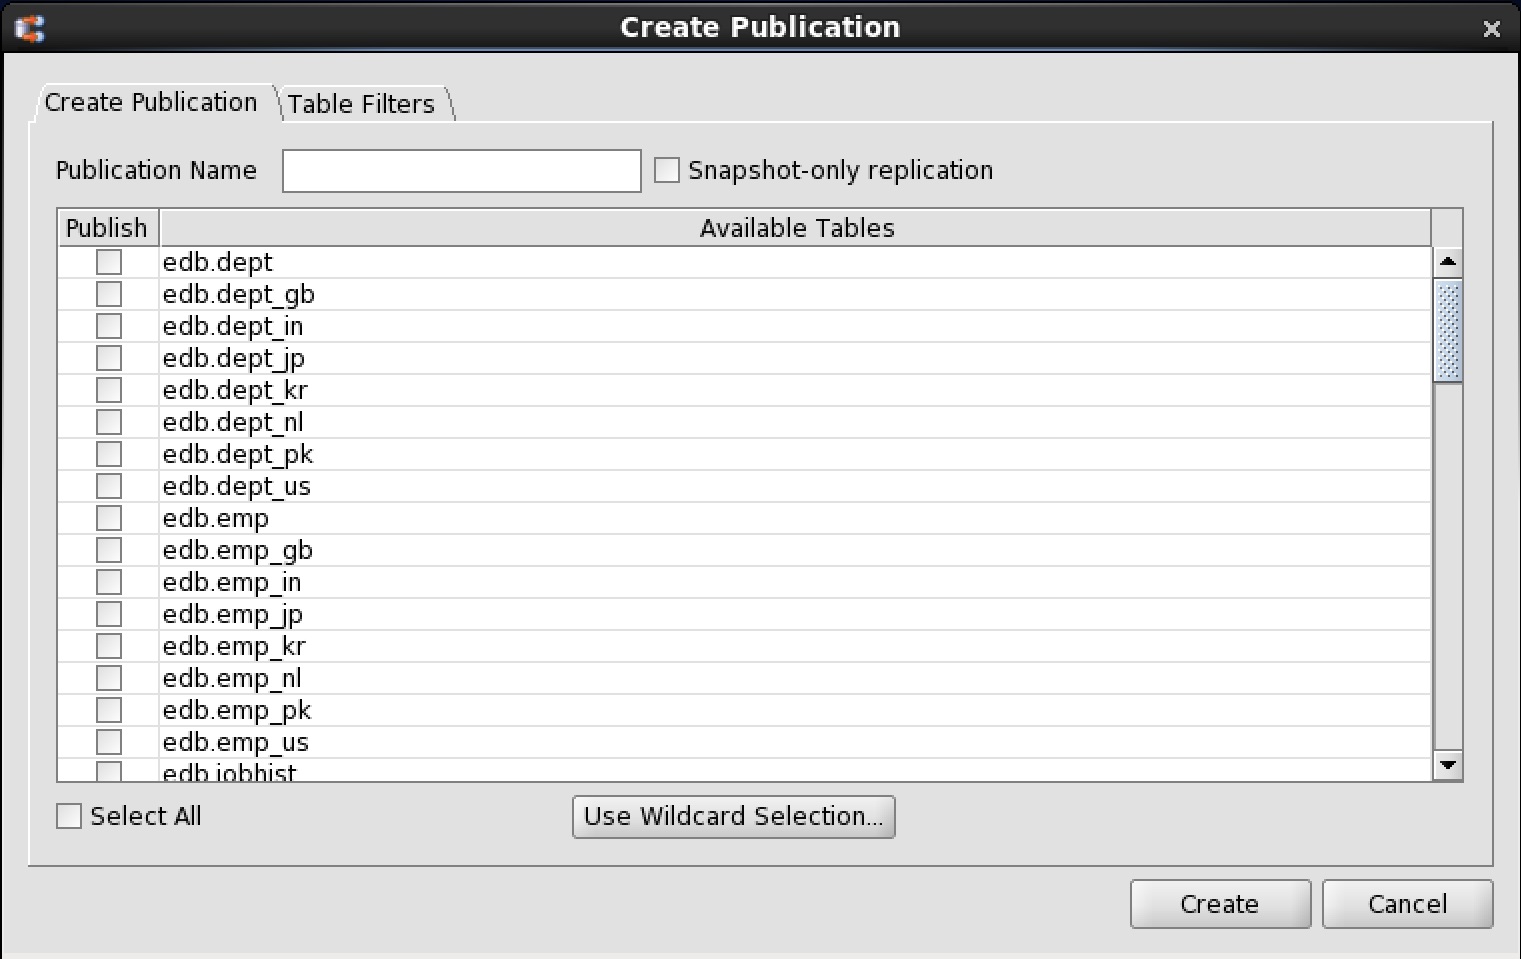
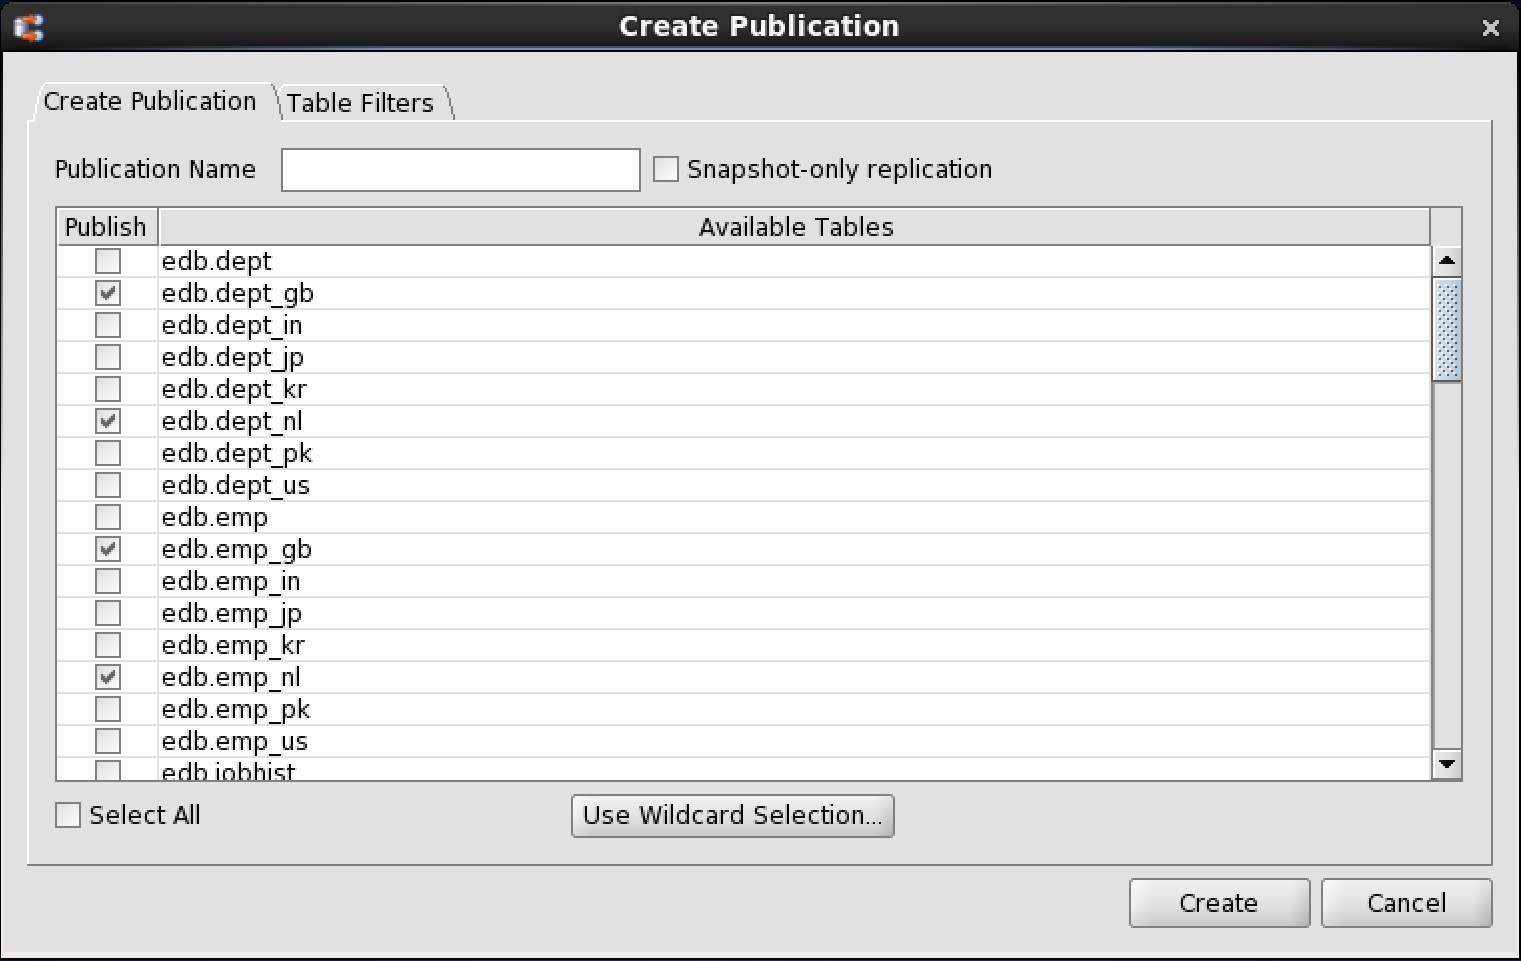
• 変更セットのロギング(Postgresの場合)。 [テーブルトリガー]を選択して、同期レプリケーションのトリガーベースの方法を使用します。同期レプリケーションのログベースの方法を使用するには、WAL Streamを選択します。トリガーベースの方法については、セクション2.2.9を参照してください。ログベースの方法については、セクション2.2.10を参照してください。注:コントローラーデータベースがOracleまたはSQL Serverパブリケーションデータベースの場合、2番目のOracleまたはSQL Serverパブリケーションデータベースを追加して、2番目のシングルマスターレプリケーションシステムを作成することはできません。 xDB Replication ServerがOracleまたはSQL Serverパブリケーションデータベースで構成される複数のシングルマスタレプリケーションシステムを実行するには、Postgresパブリケーションデータベースをコントローラーデータベースとして指定する必要があります。コントローラデータベースの詳細については、セクション2.3.1.12を参照してください。ステップ4: [テスト]ボタンをクリックします。テスト結果:成功が表示されたら、[OK]ボタンをクリックしてから、[保存]ボタンをクリックします。Oracleのみ:各データベースの[データベースの追加]ダイアログボックスに入力することにより、複数のOracleデータベースをパブリケーションデータベースとして追加できます。パブリケーションデータベース定義ごとに異なるパブリケーションデータベースユーザー名を使用する場合、同じOracleデータベースを2つ以上の個別のパブリケーションデータベース定義として追加することもできます。PostgresまたはSQL Serverの場合:各データベースの[データベースの追加]ダイアログボックスに入力することにより、複数のPostgresまたはSQL Serverデータベースをパブリケーションデータベースとして追加できます。ただし、Oracleとは異なり、特定のPostgresまたはSQL Serverデータベースは、パブリケーションデータベース定義として1回のみ追加できます。5.2.3 Adding a Publicationステップ1:パブリケーションデータベースノードを選択します。 [出版物]メニューから[出版物の作成]を選択します。または、[パブリケーションデータベース]ノードで2番目のマウスボタンをクリックし、[パブリケーションの作成]を選択します。 [パブリケーションの作成]ダイアログボックスが表示されます。ステップ2: [パブリケーションの作成]タブの下の次のフィールドに入力します。
• 出版物名。すべての出版物の中で一意の名前を入力してください。
• スナップショットのみのレプリケーション。スナップショットのみで複製を行う場合は、チェックボックスをオンにします。スナップショットのみのパブリケーションに含まれるテーブルには、主キーは必要ありません。同期レプリケーションを使用するパブリケーションに含まれるテーブルには、主キーが必要です。
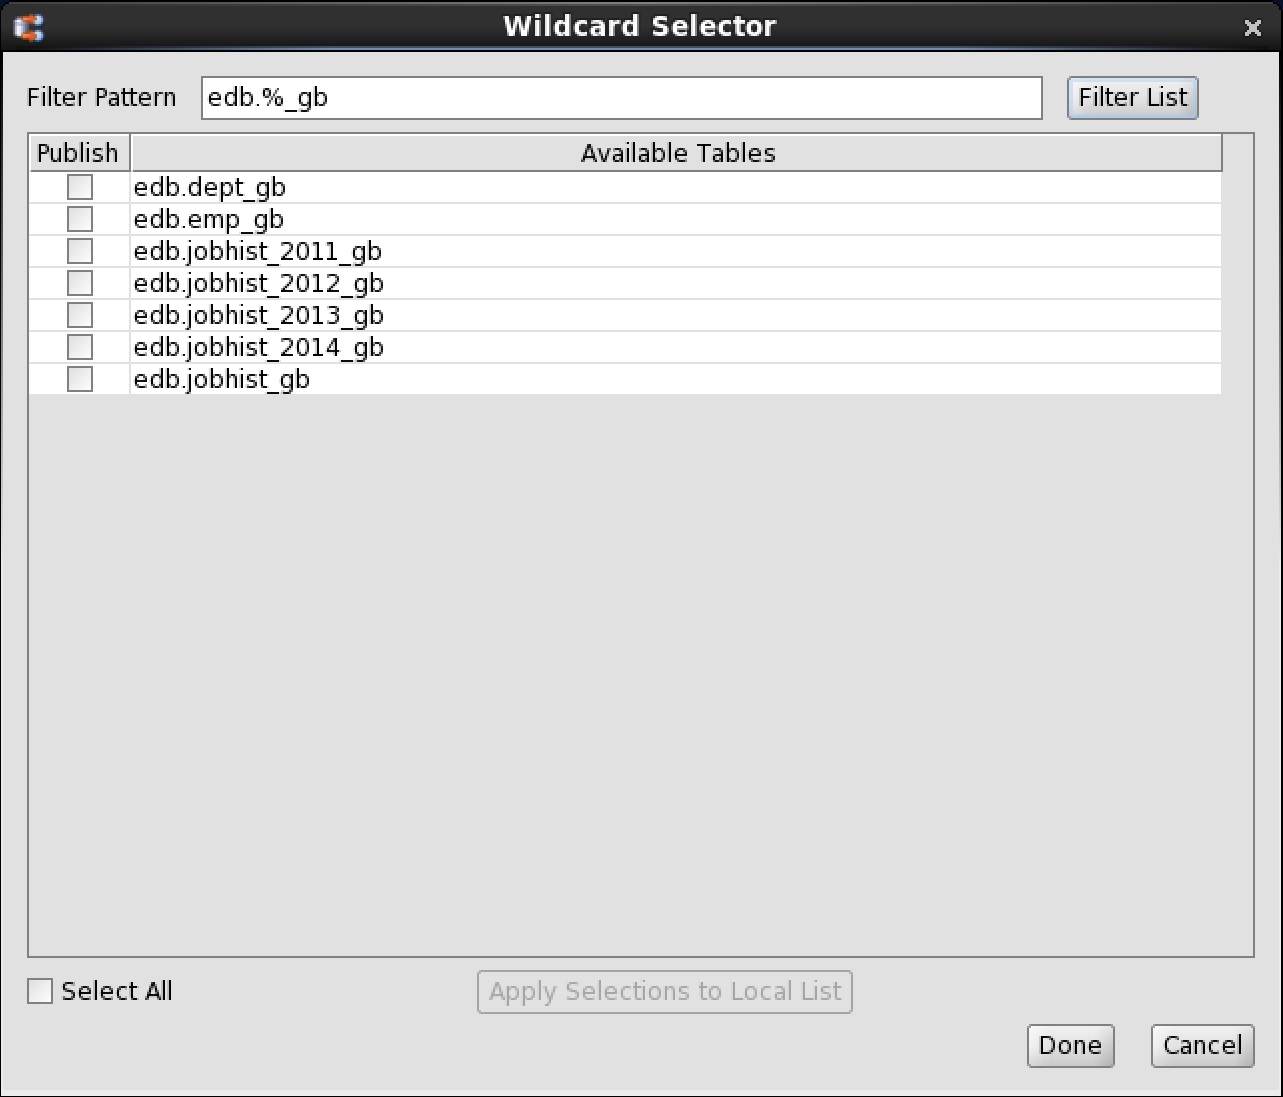
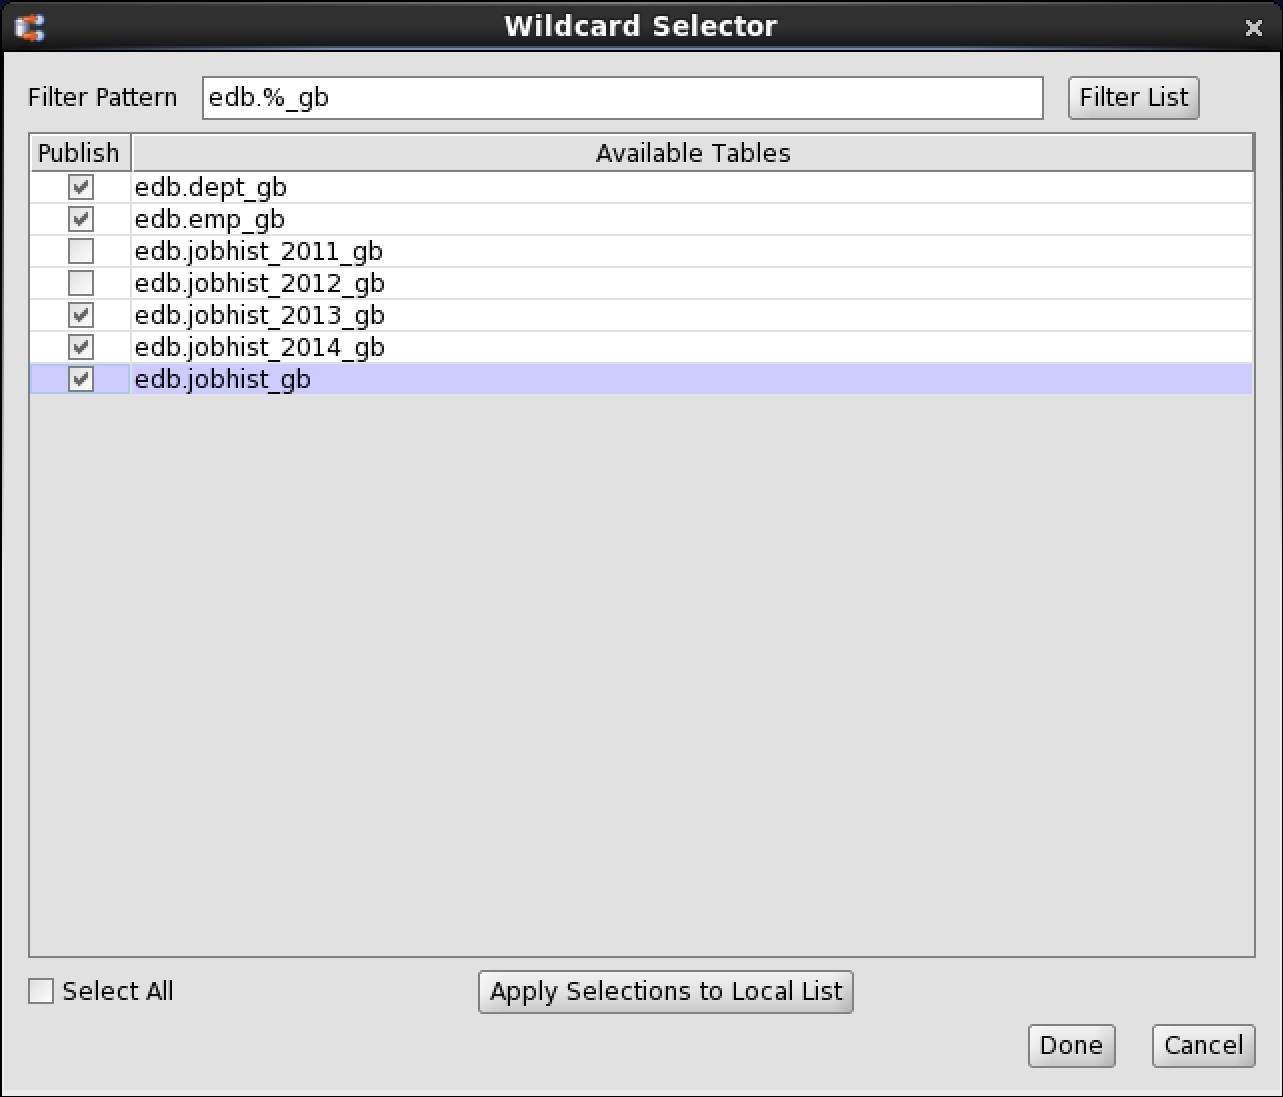
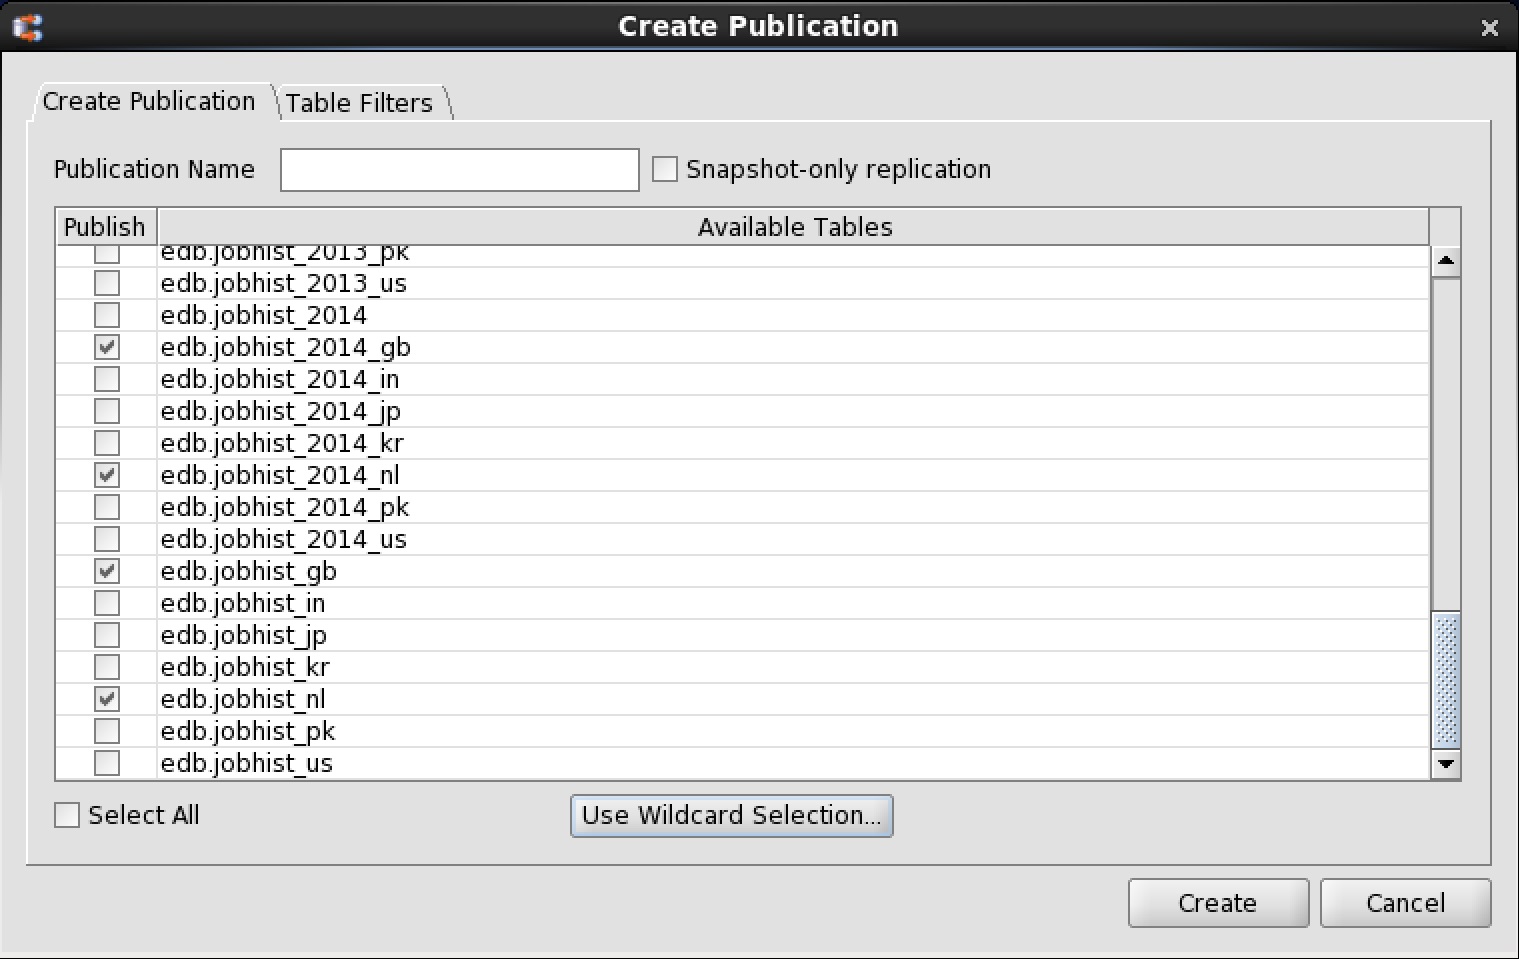
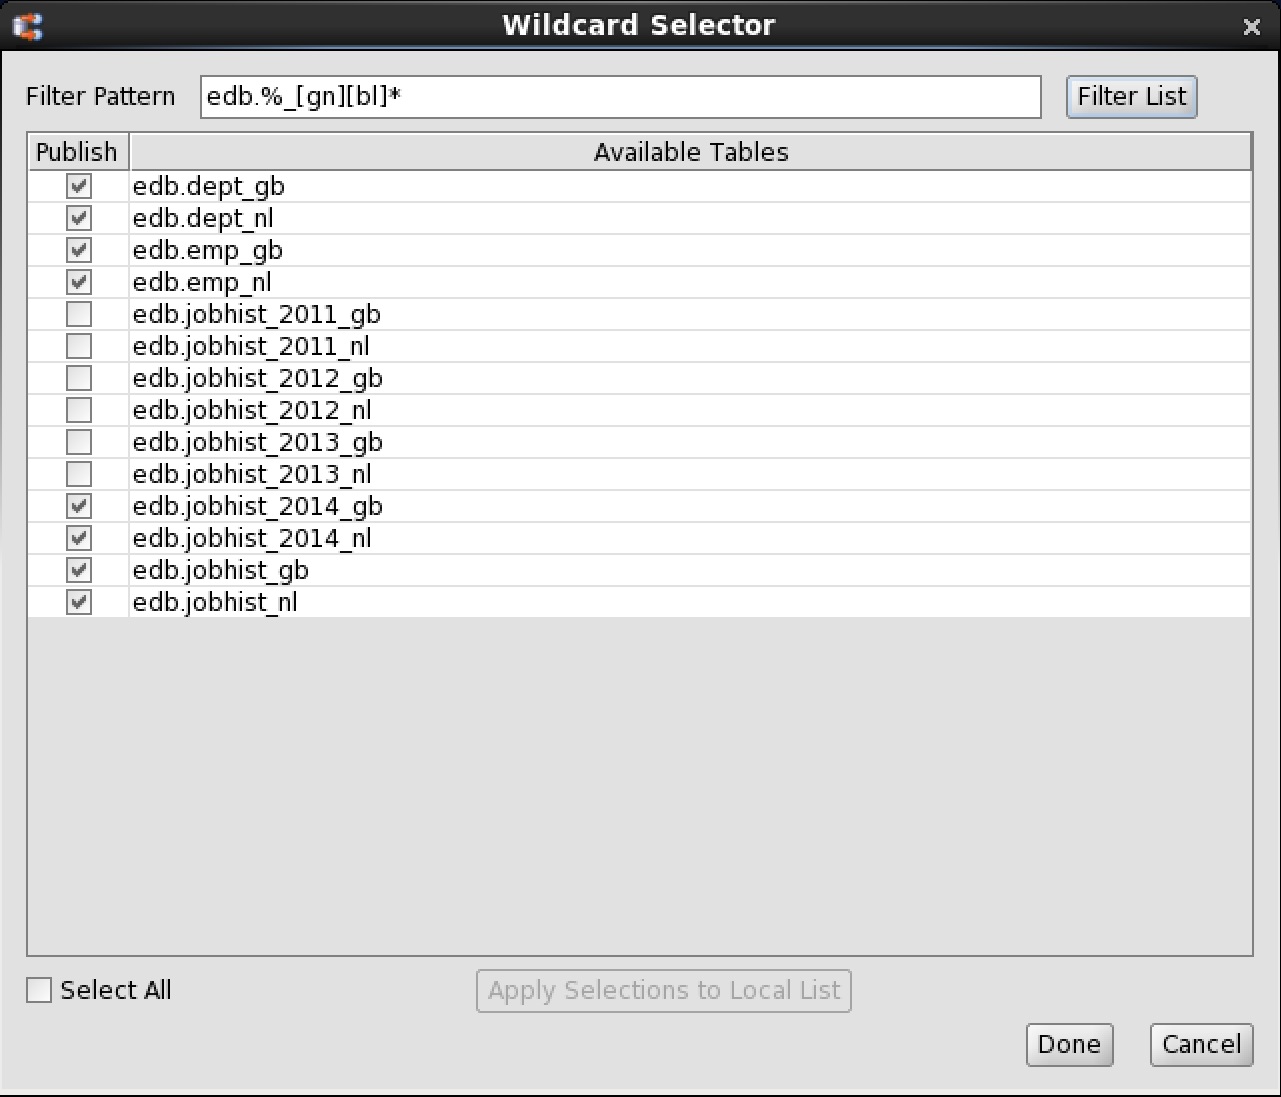
• パブリッシュ。パブリケーションに含めるテーブルの横にあるチェックボックスをオンにします。 [スナップショットのみのレプリケーション]ボックスがチェックされている場合、ビューは[公開]リストにも表示されます。または、さらに、[ワイルドカード選択の使用]ボタンをクリックして、パブリケーションテーブルの選択にワイルドカードパターンマッチングを使用します。
• すべて選択。パブリケーションの[使用可能なテーブル]リストにすべてのテーブルとビューを含める場合は、このボックスをオンにします。
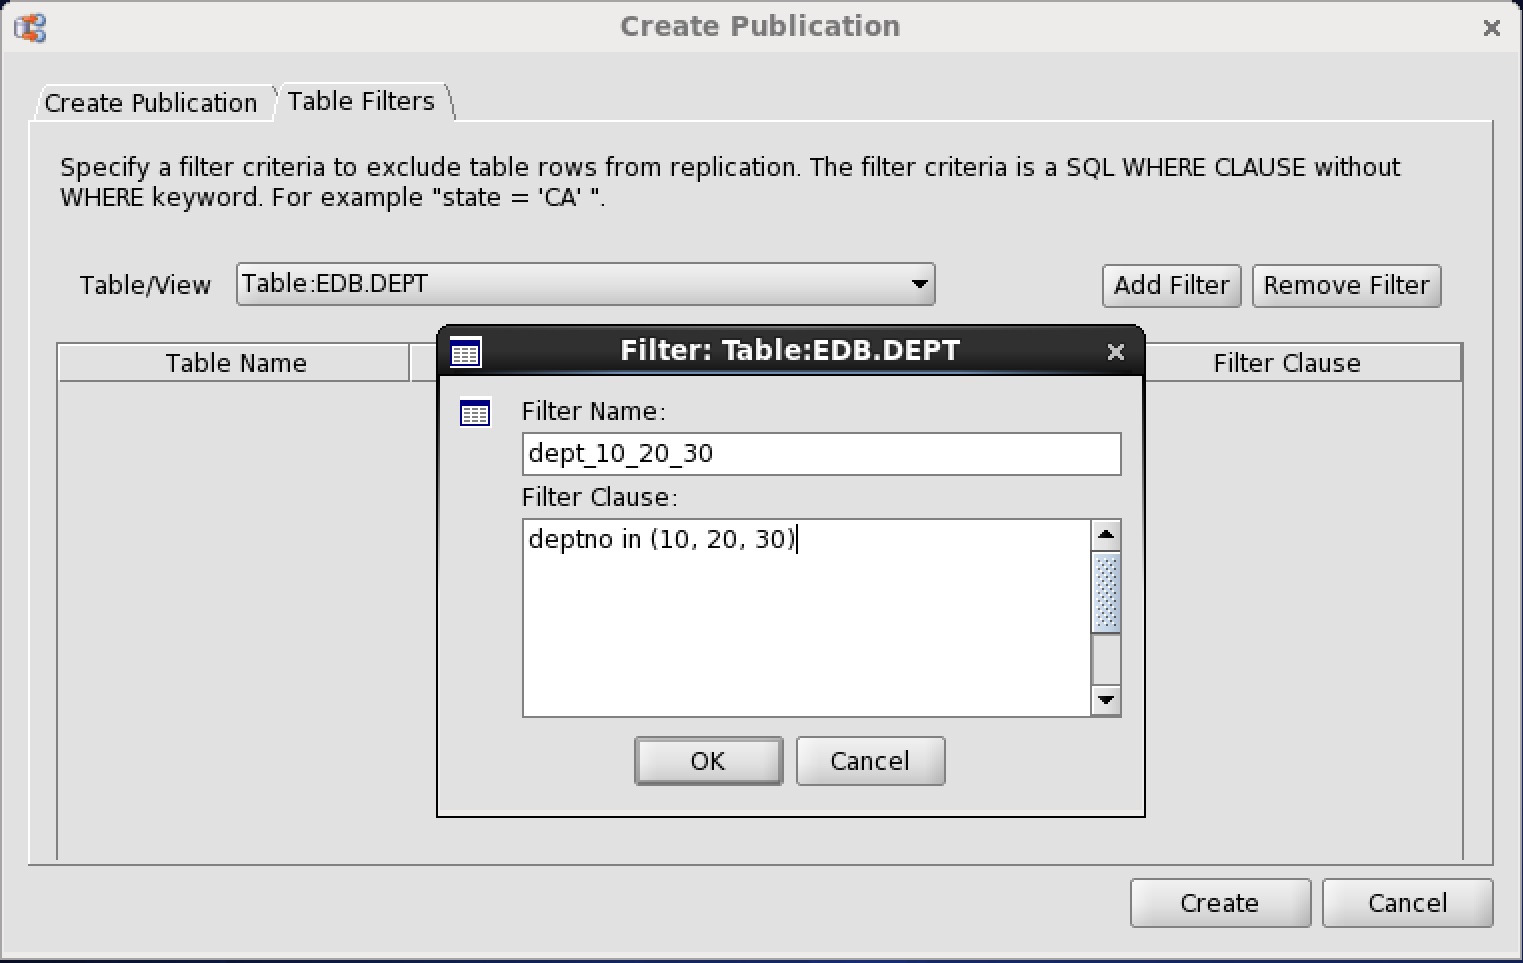
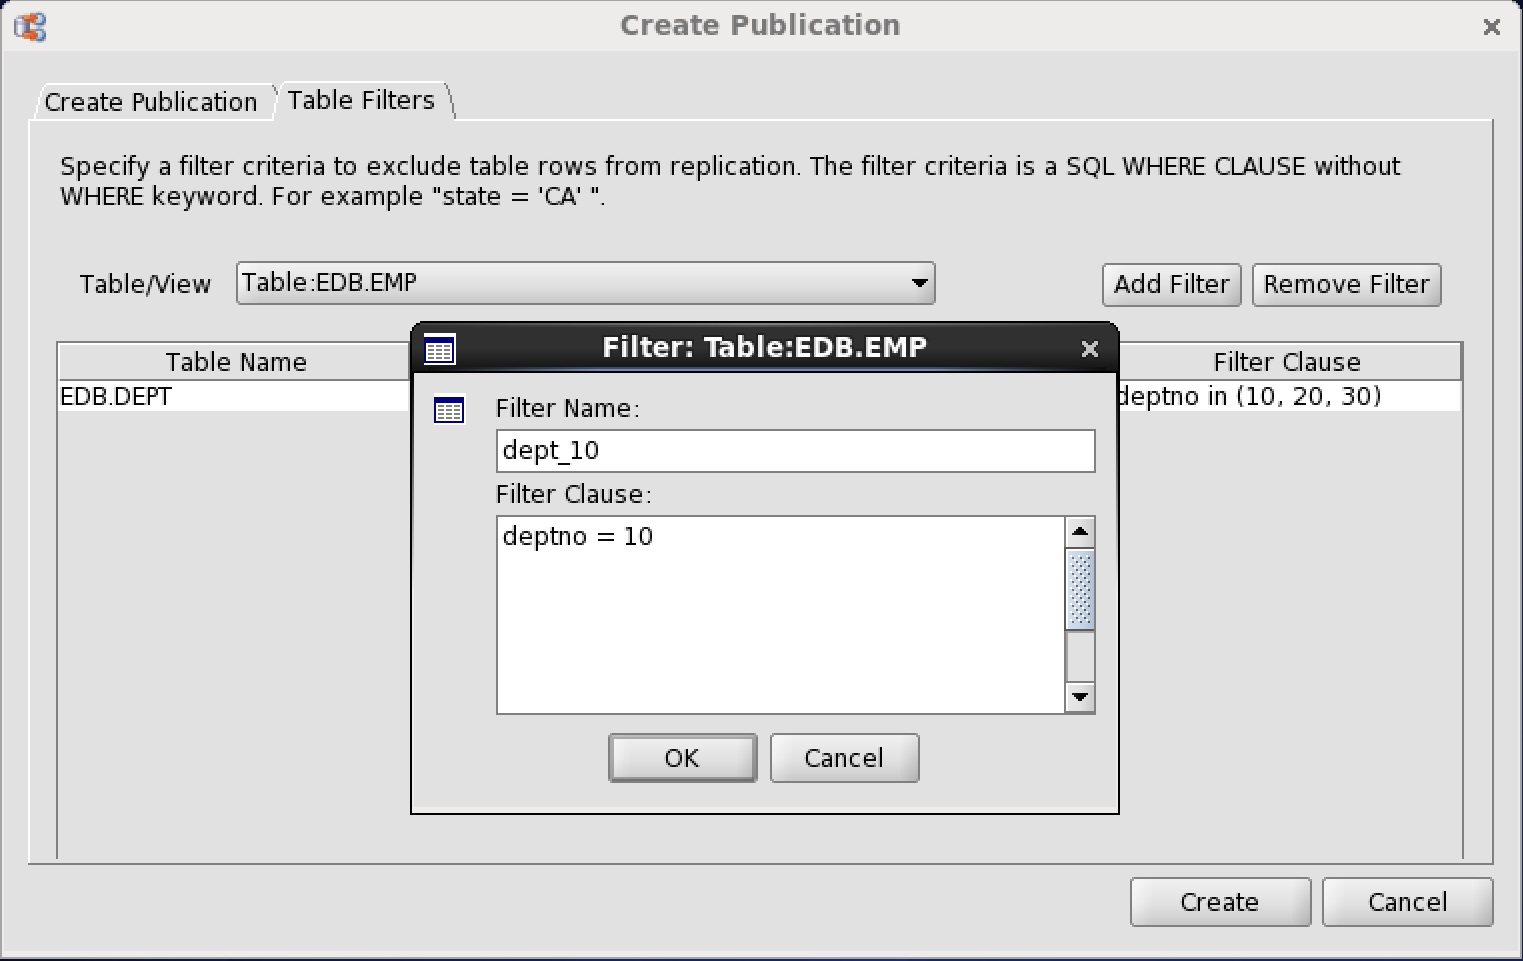
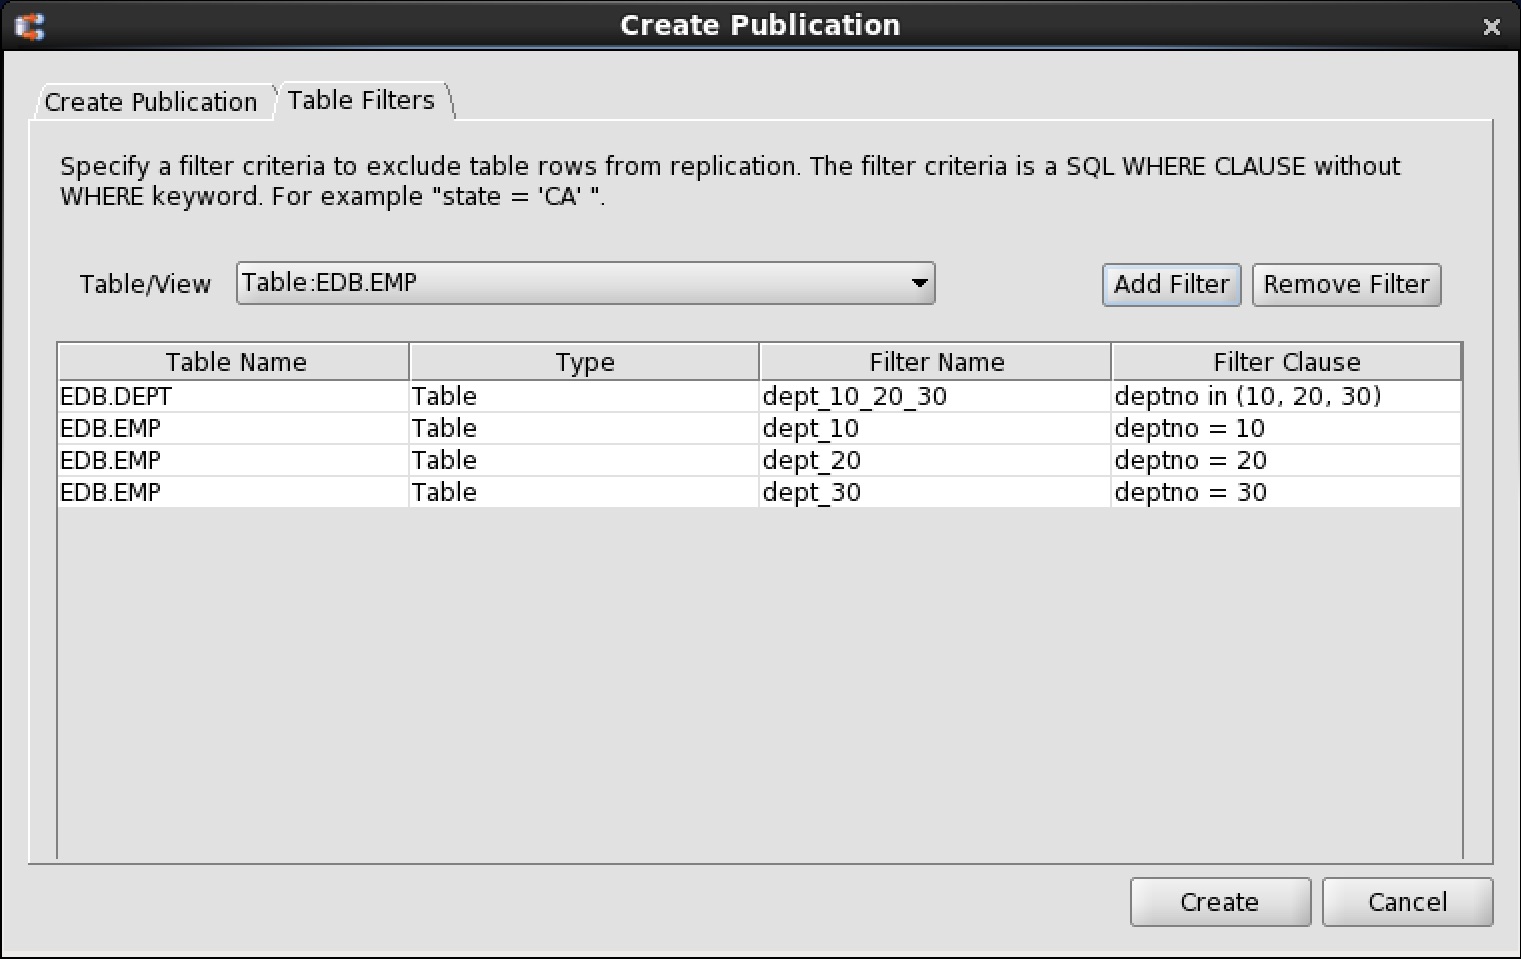
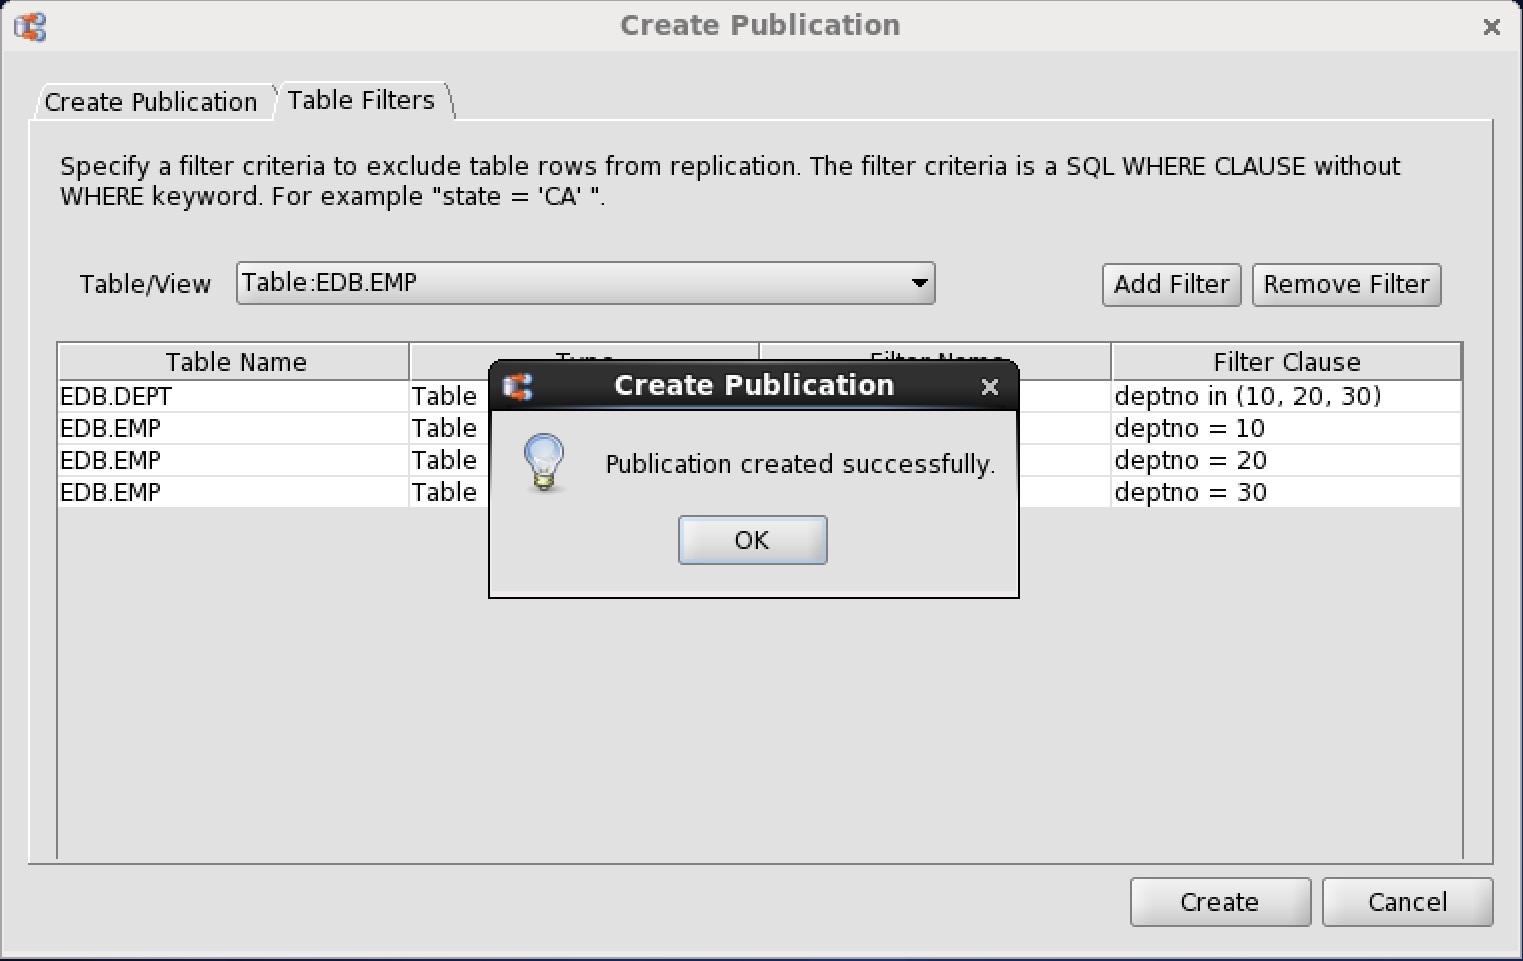
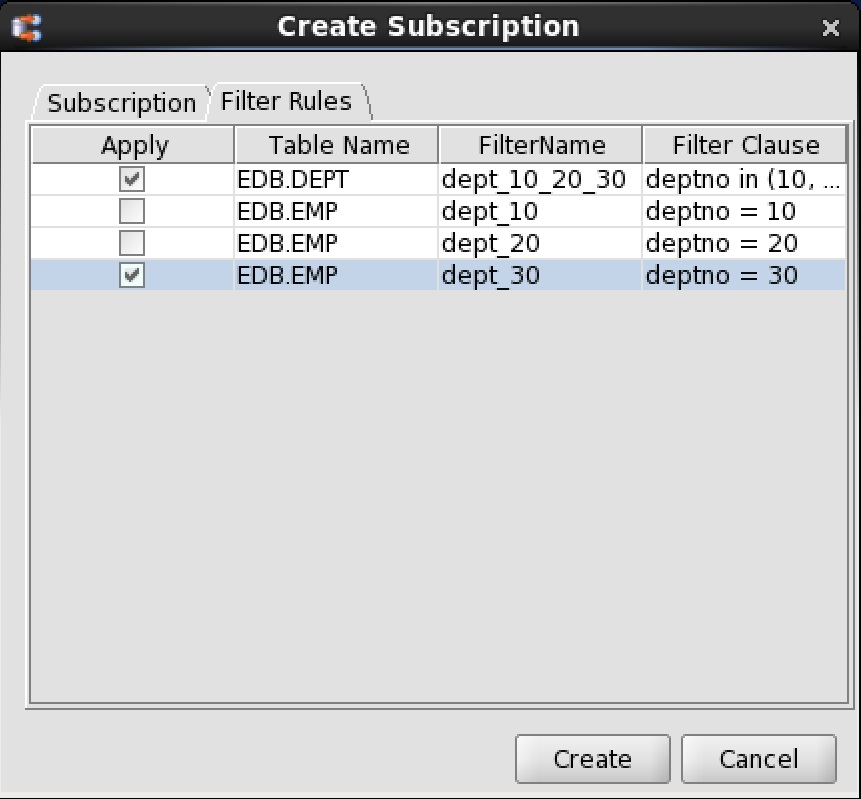
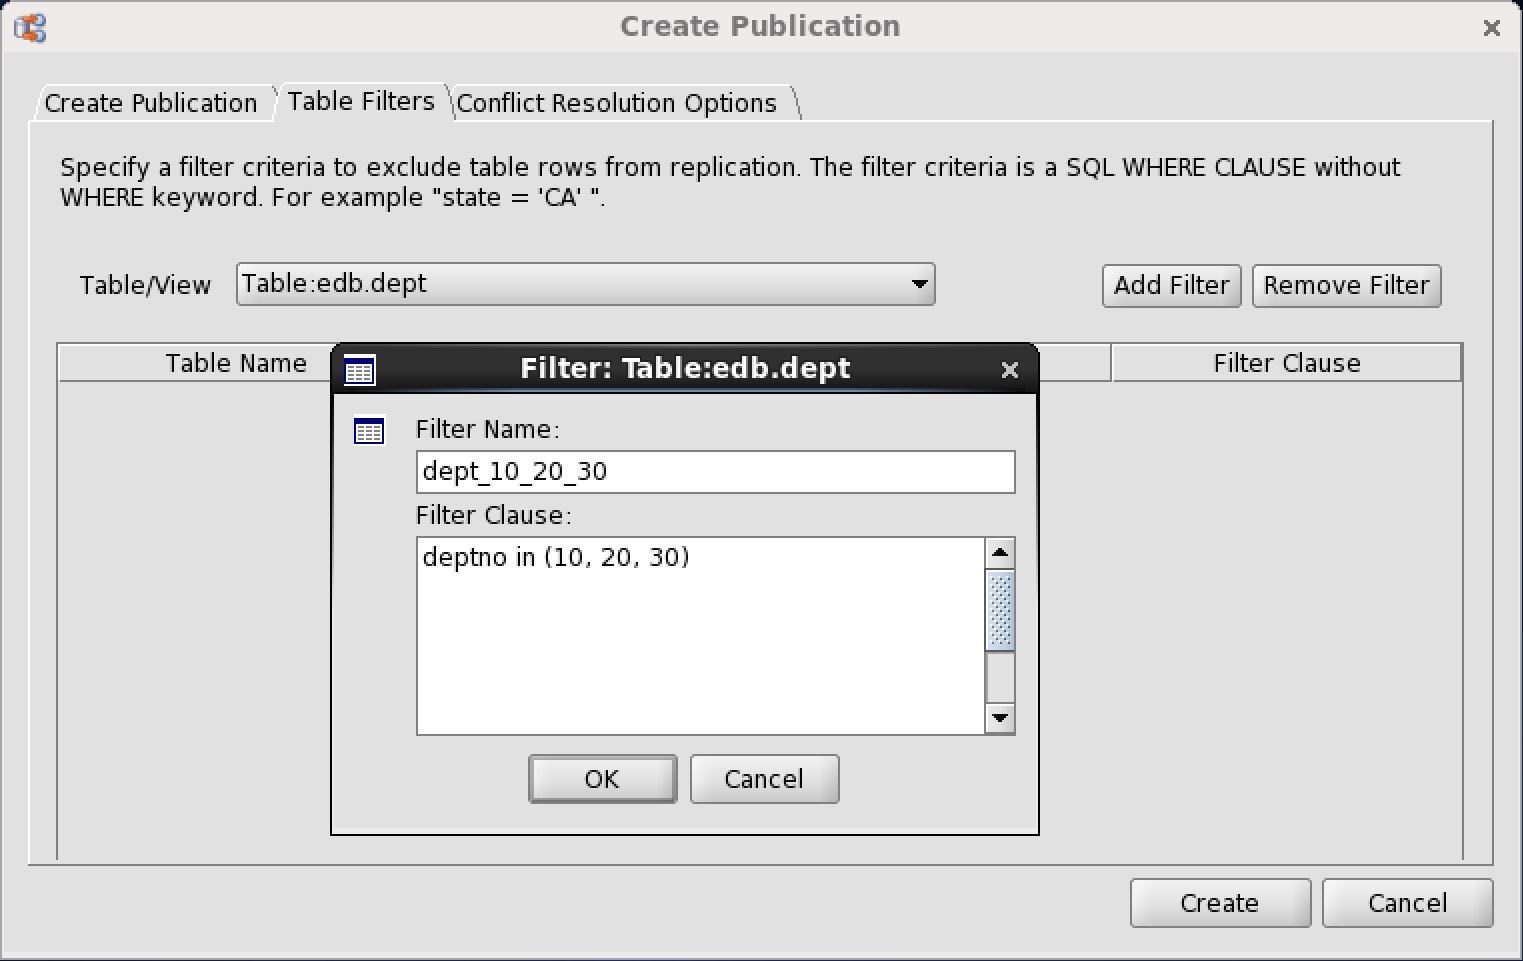
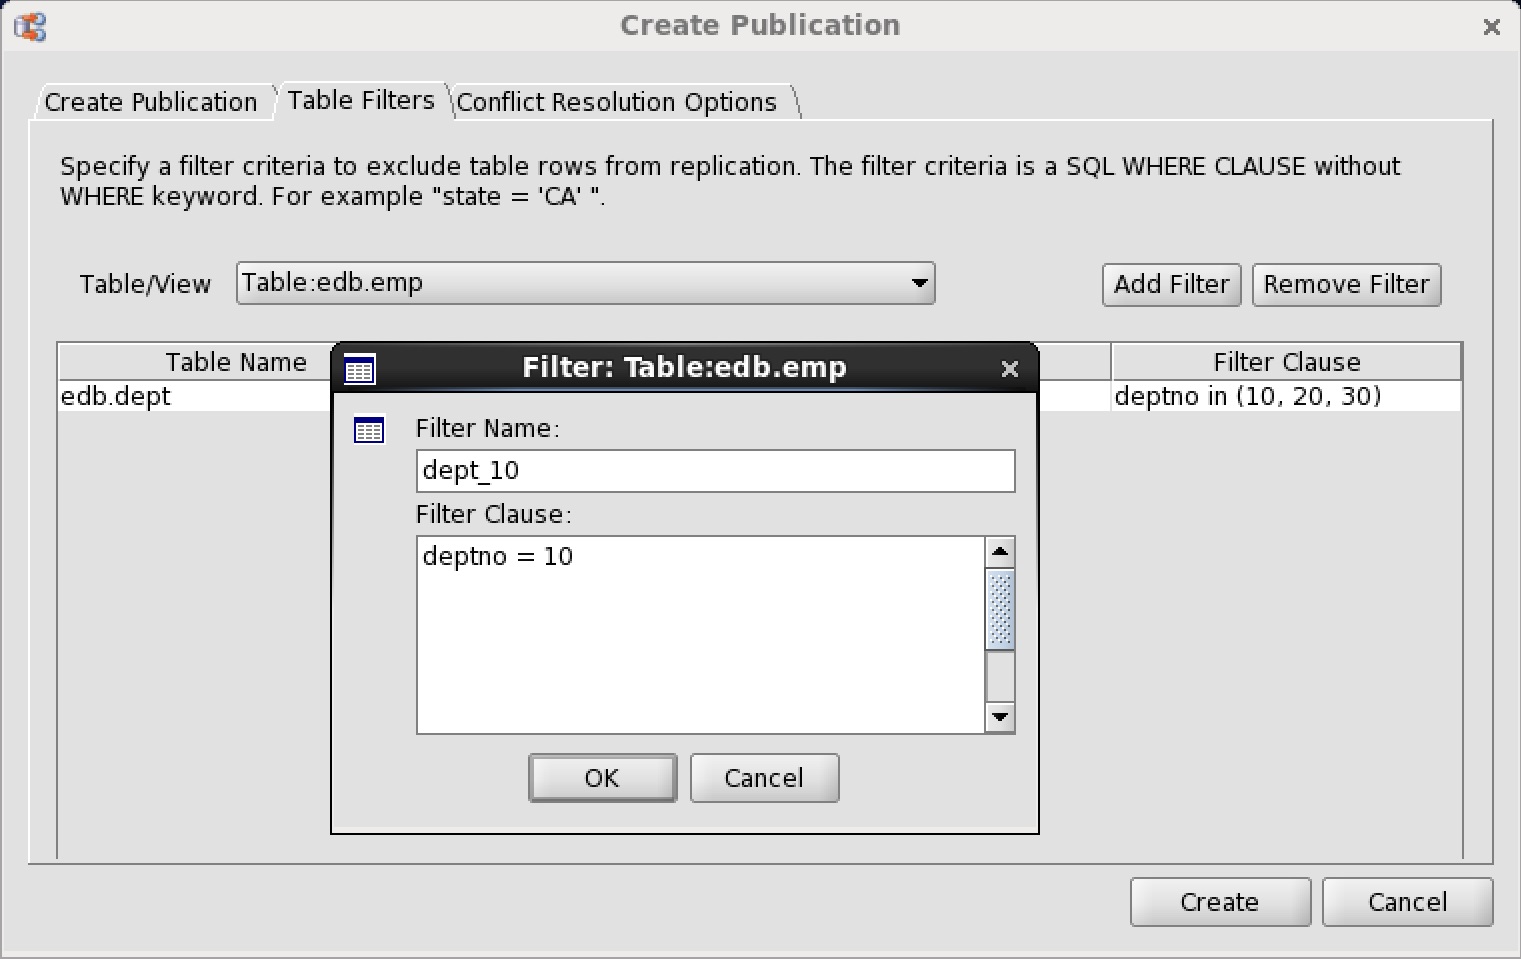
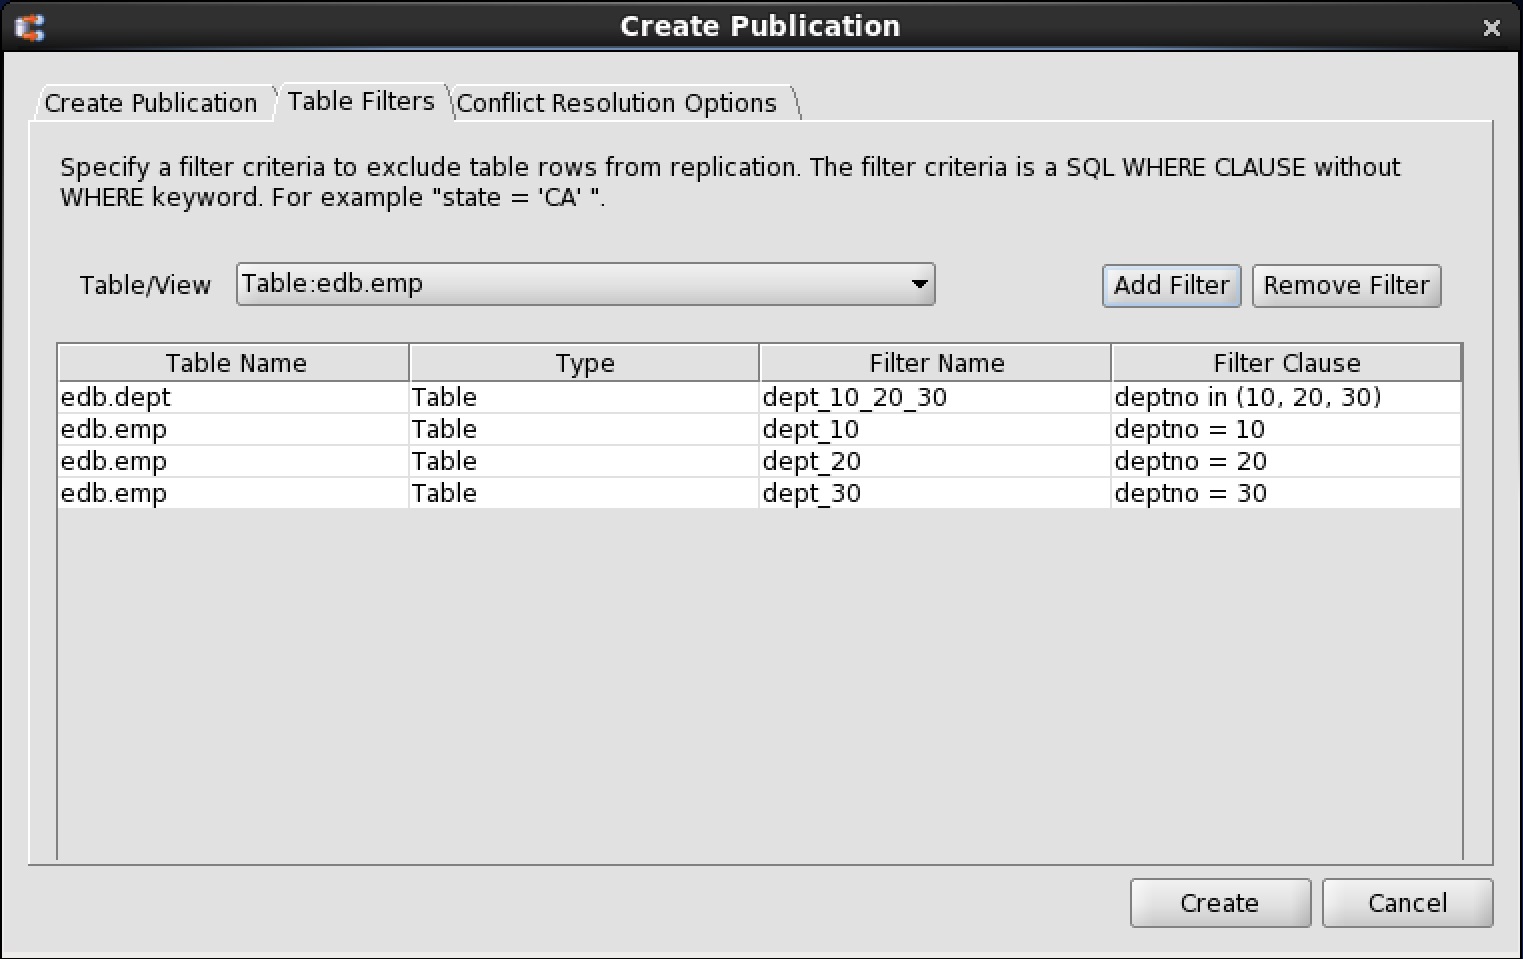
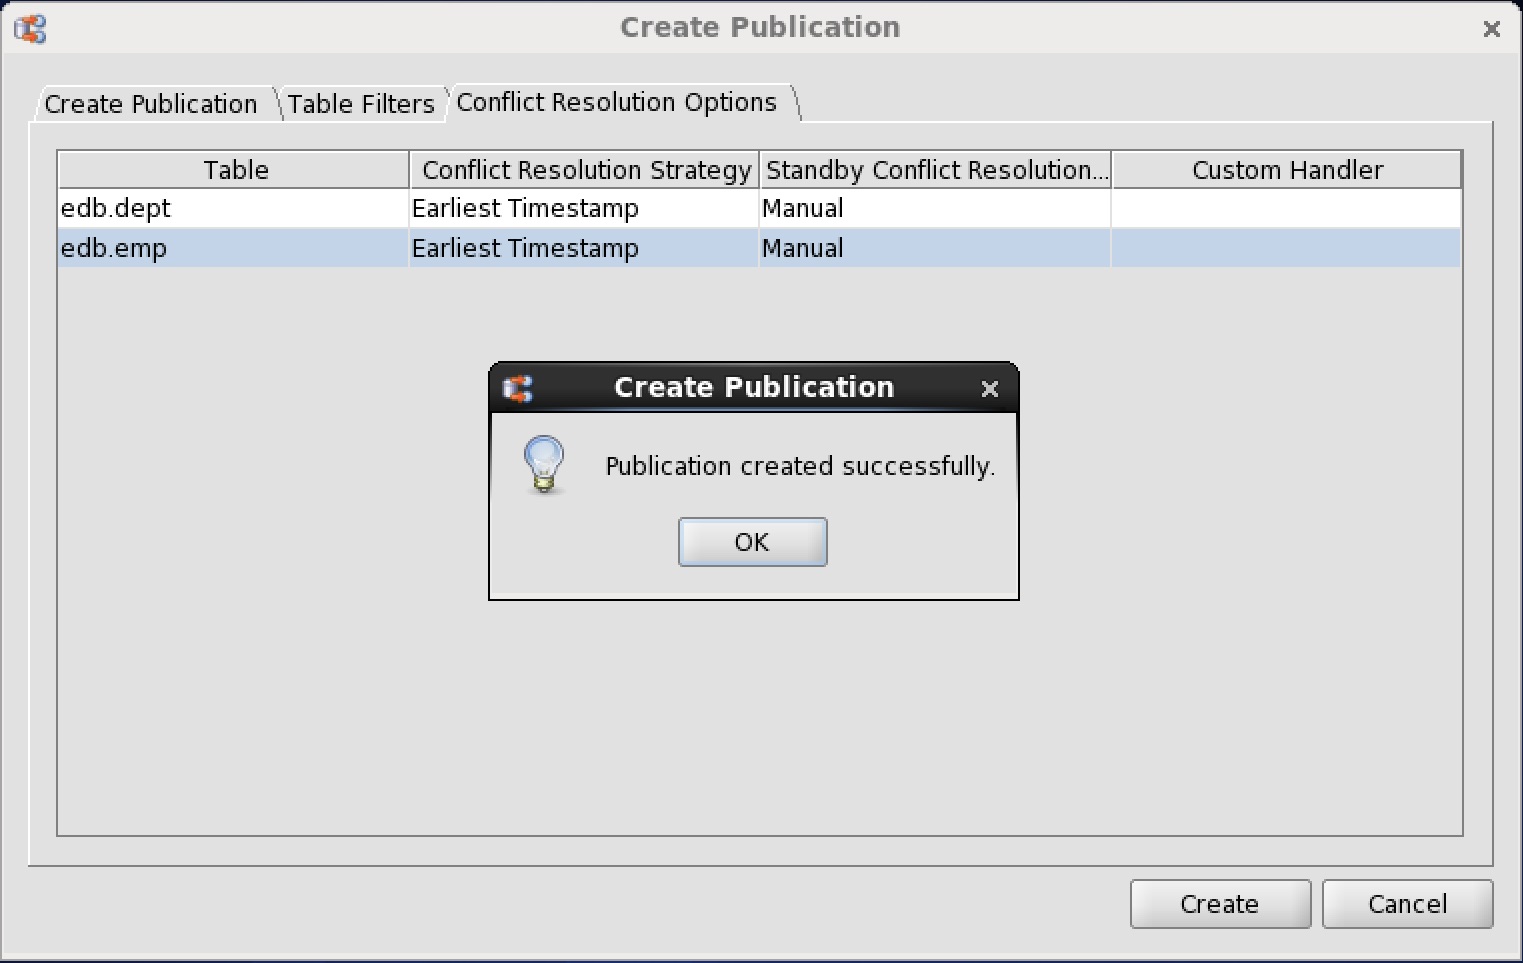
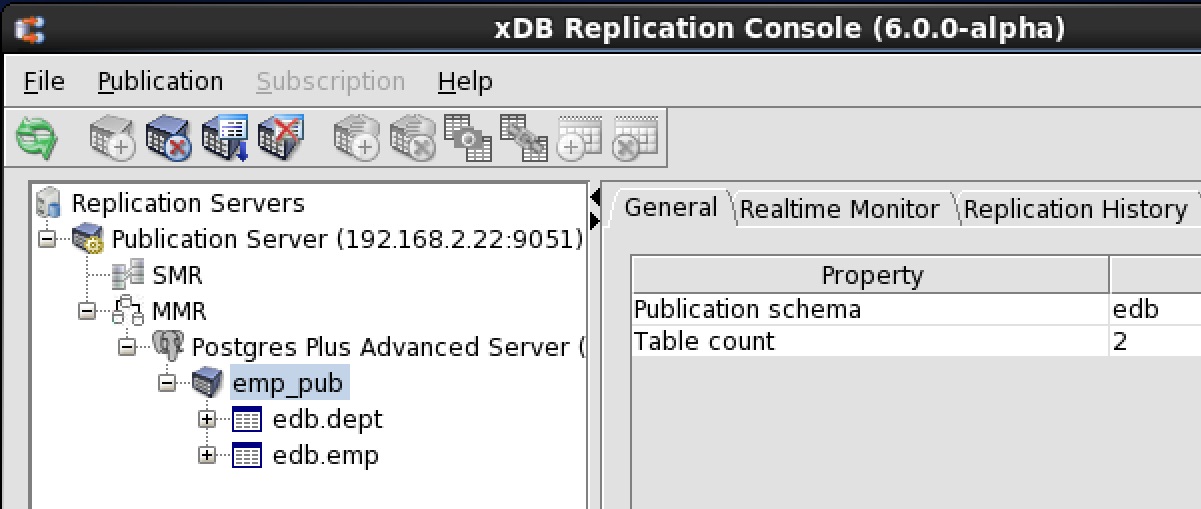
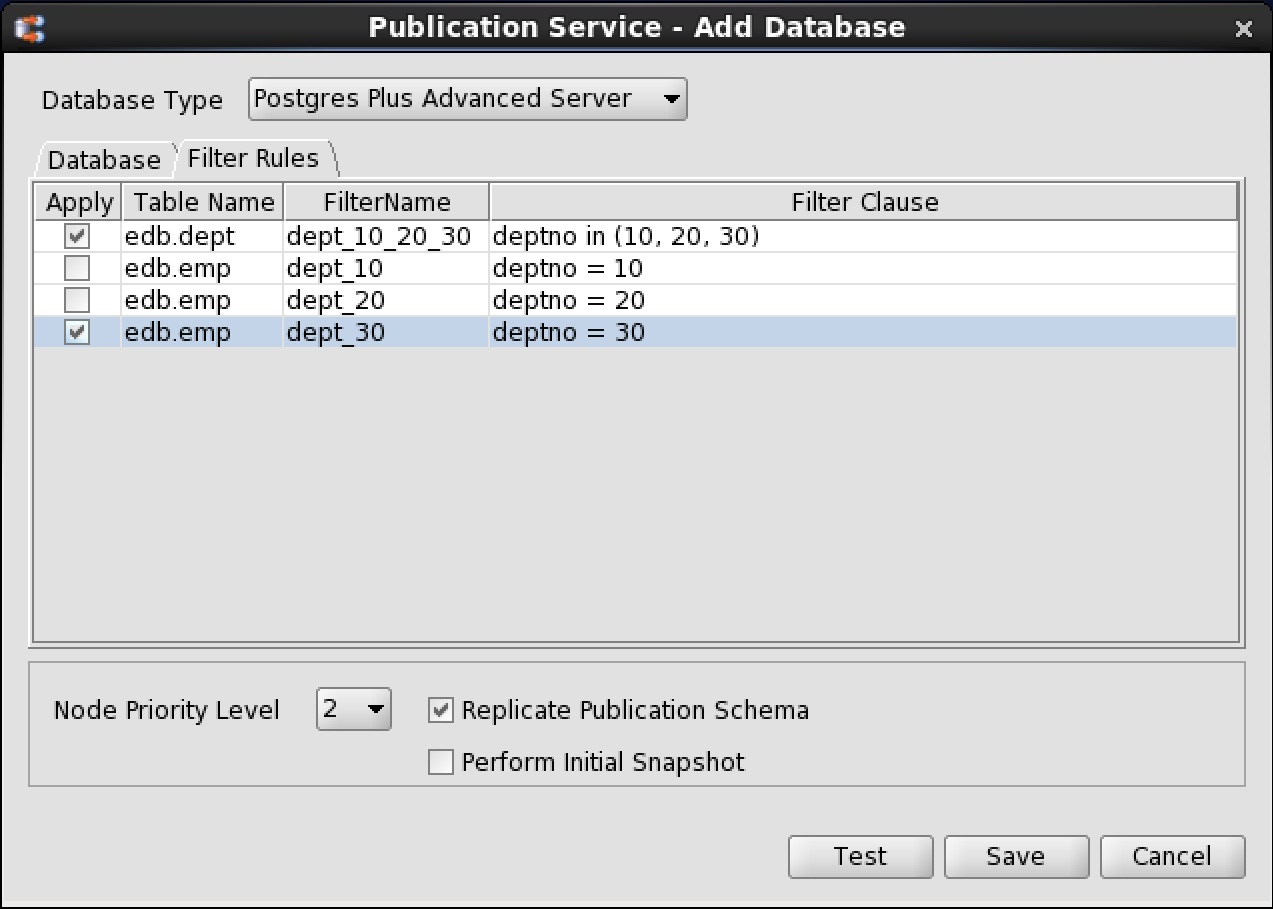
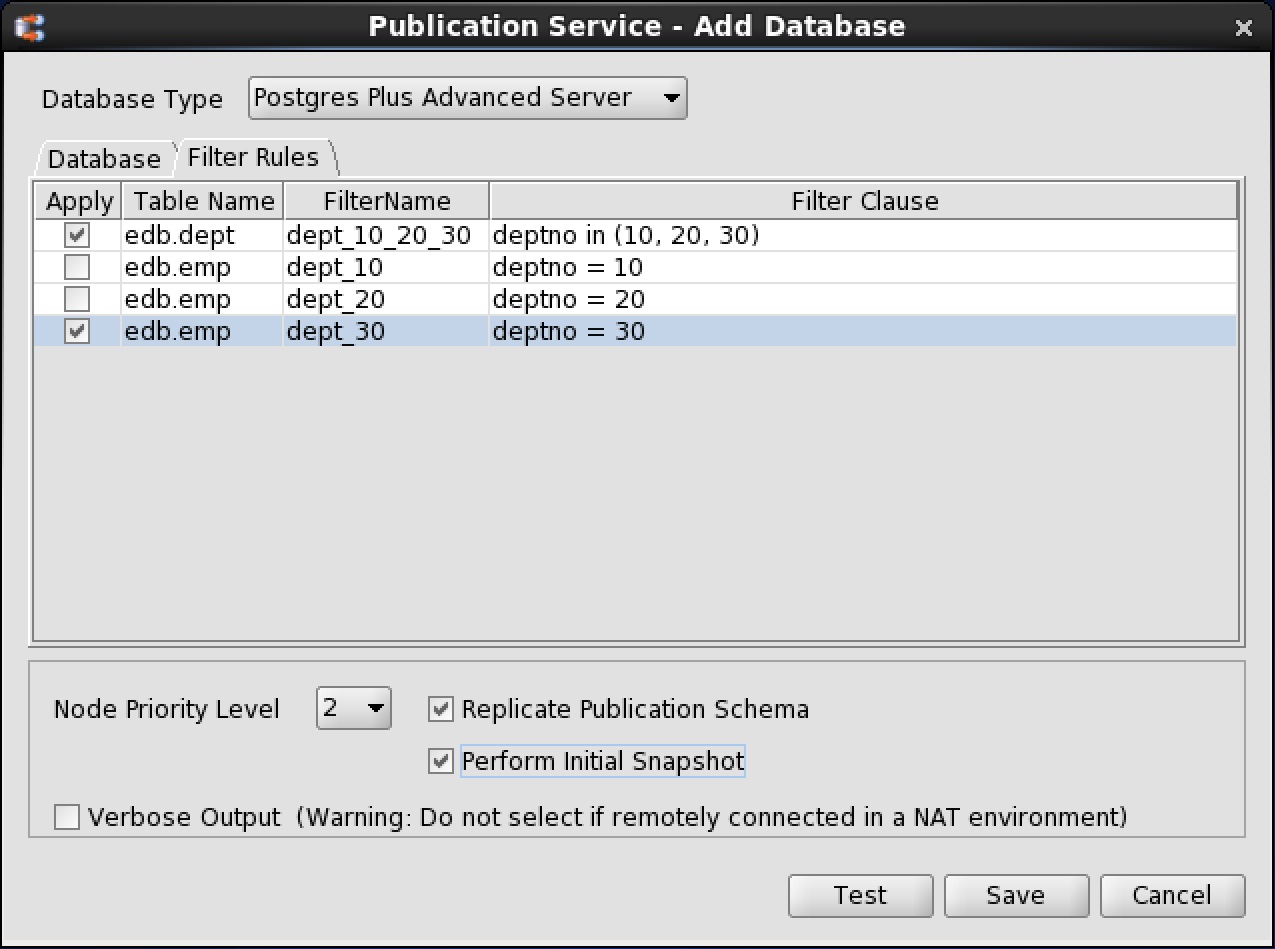
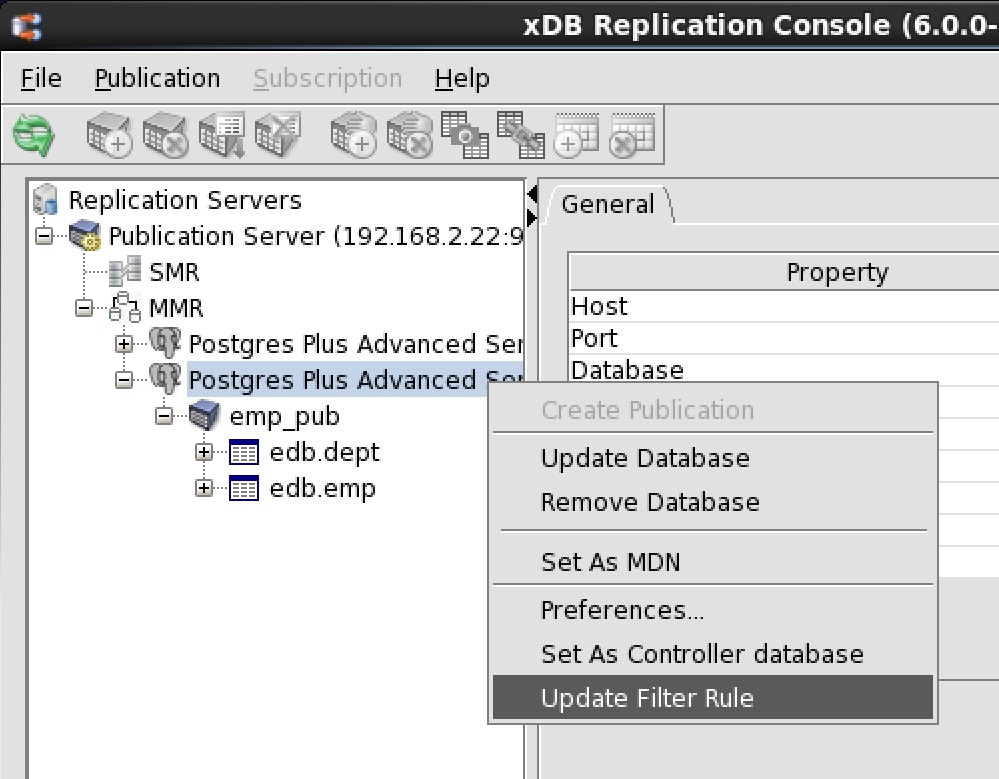
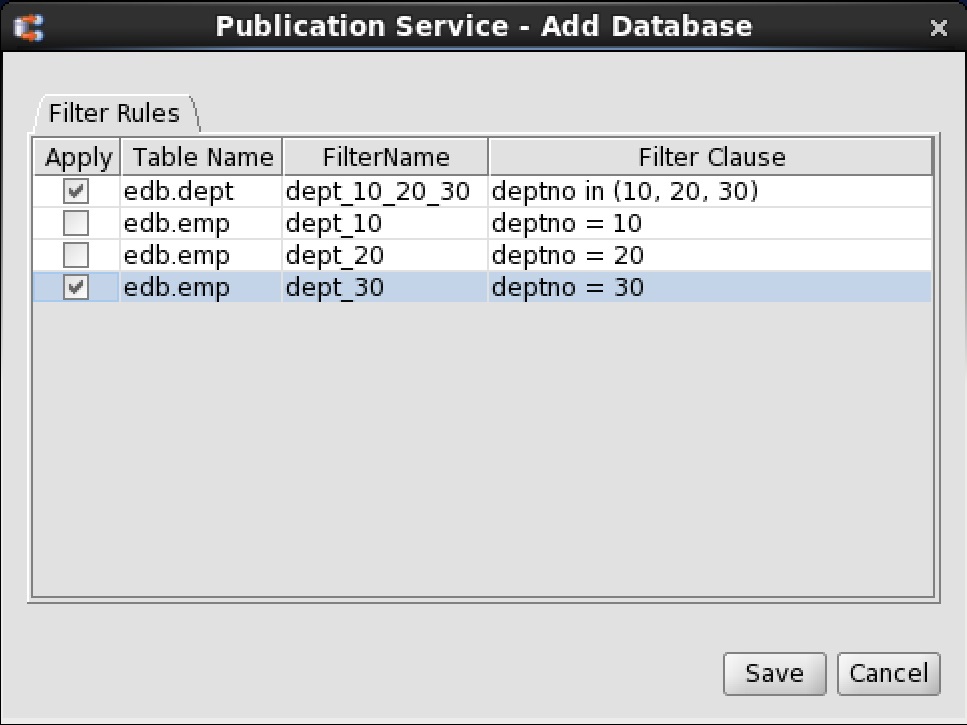
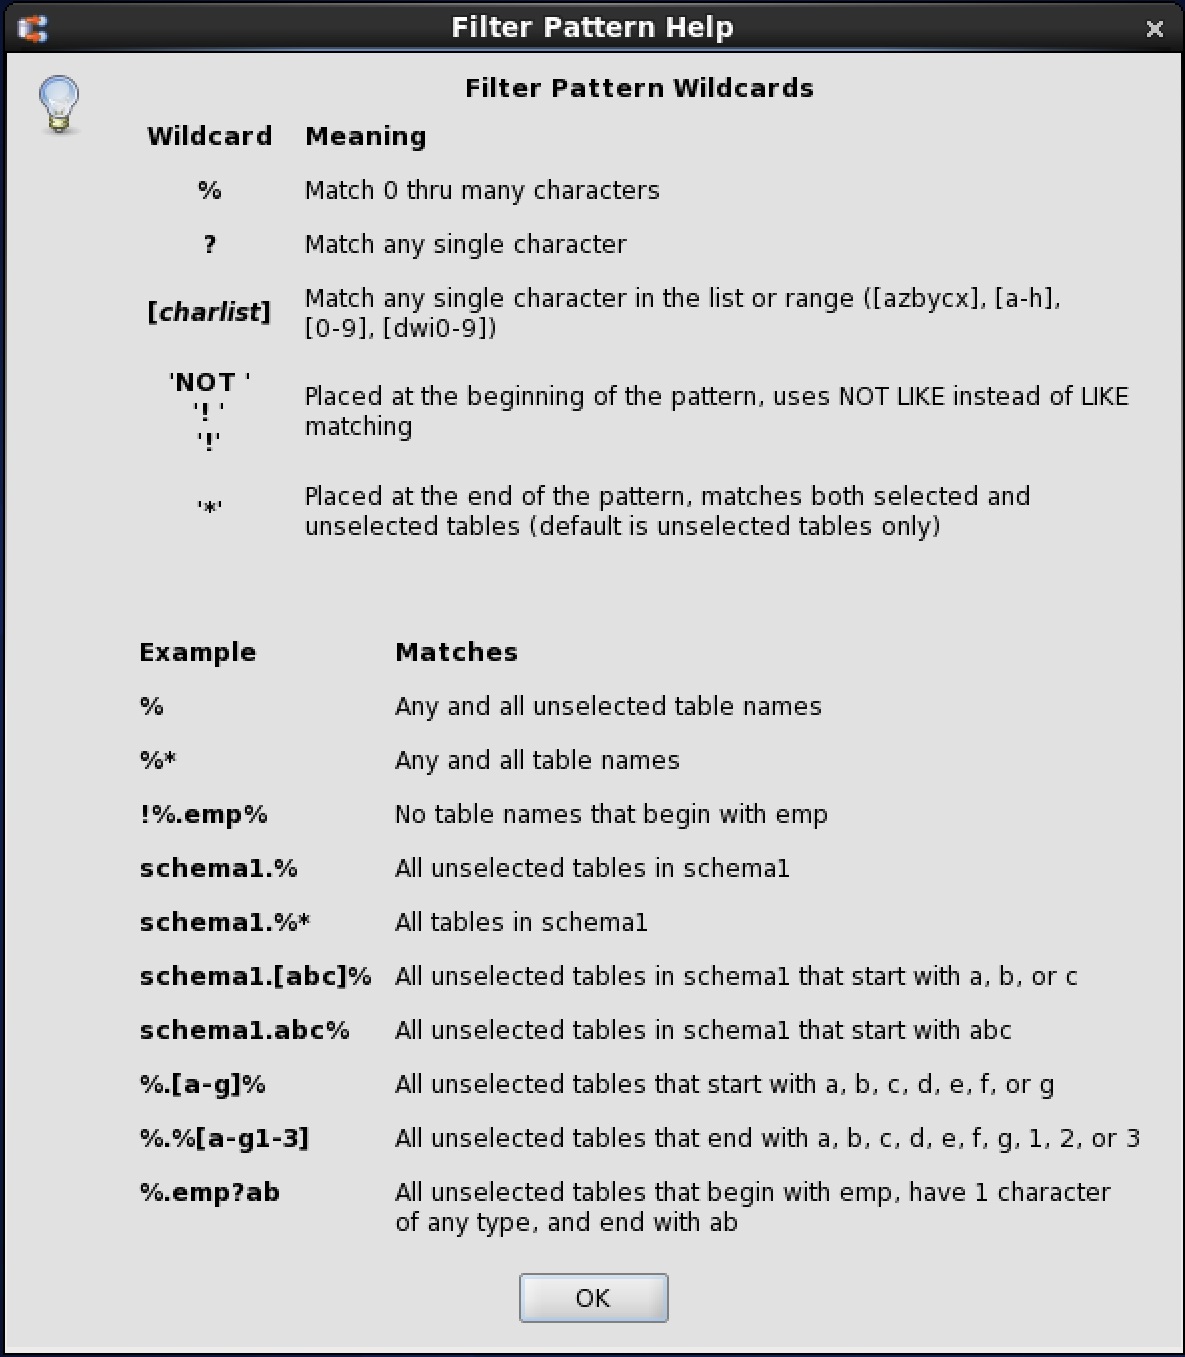
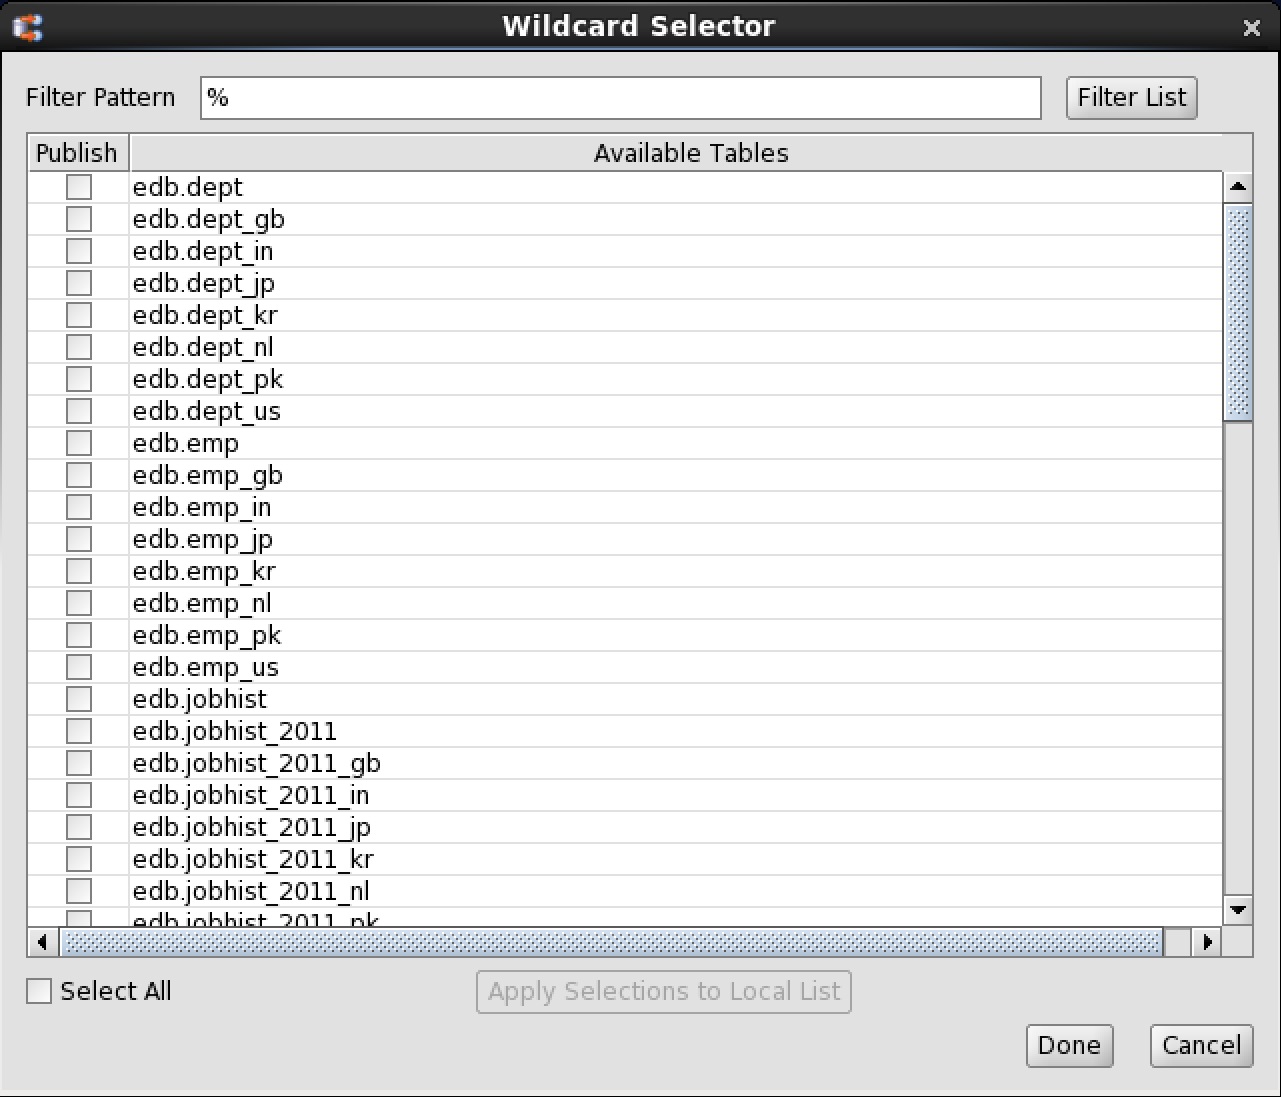
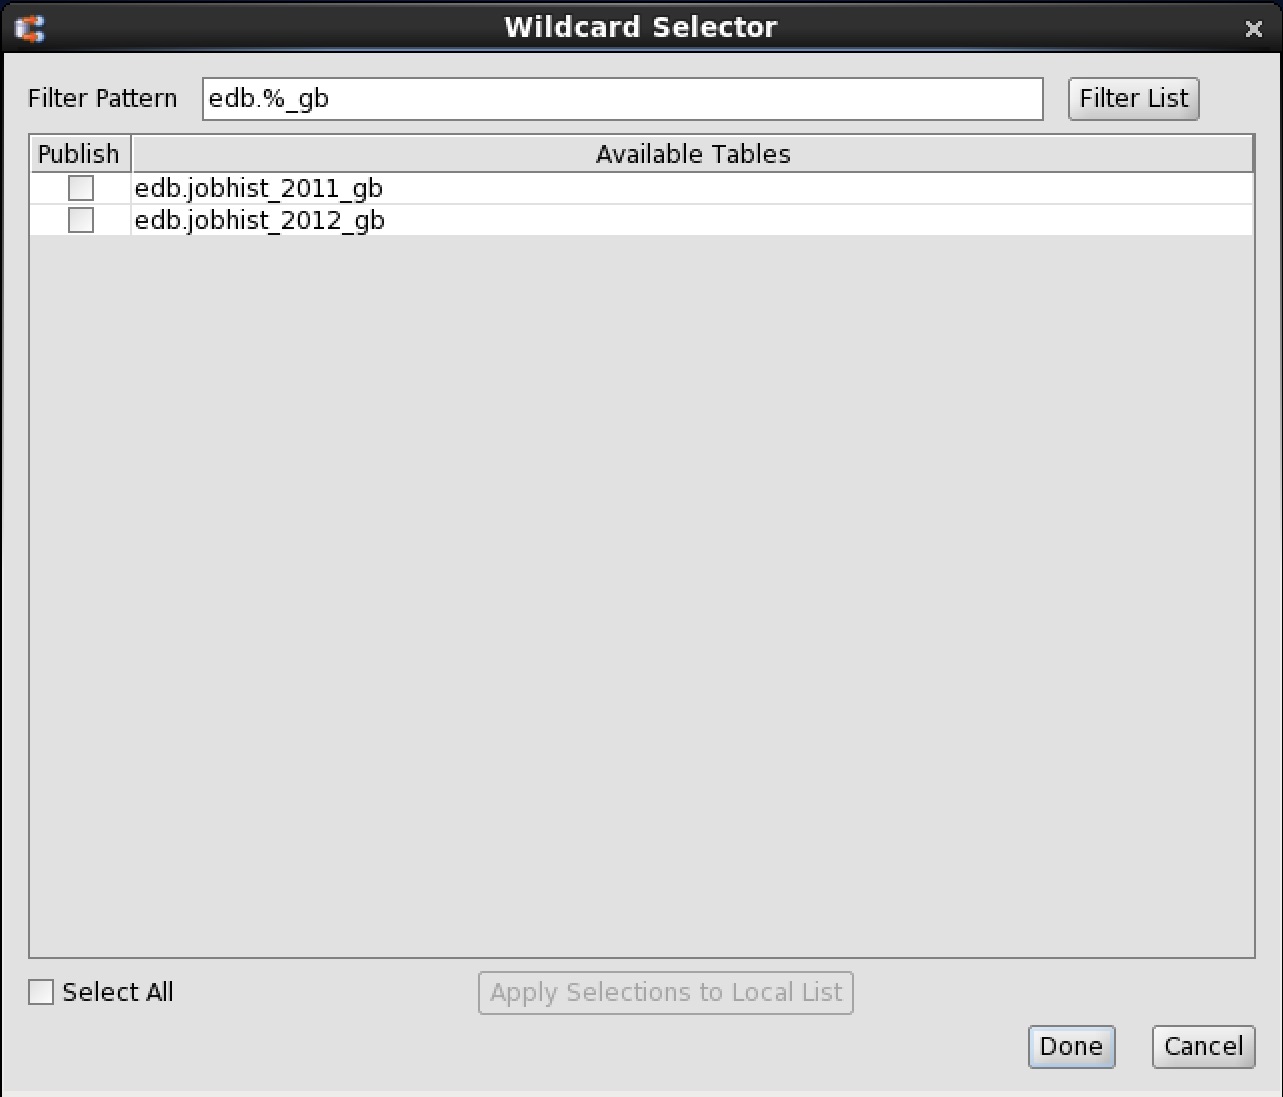
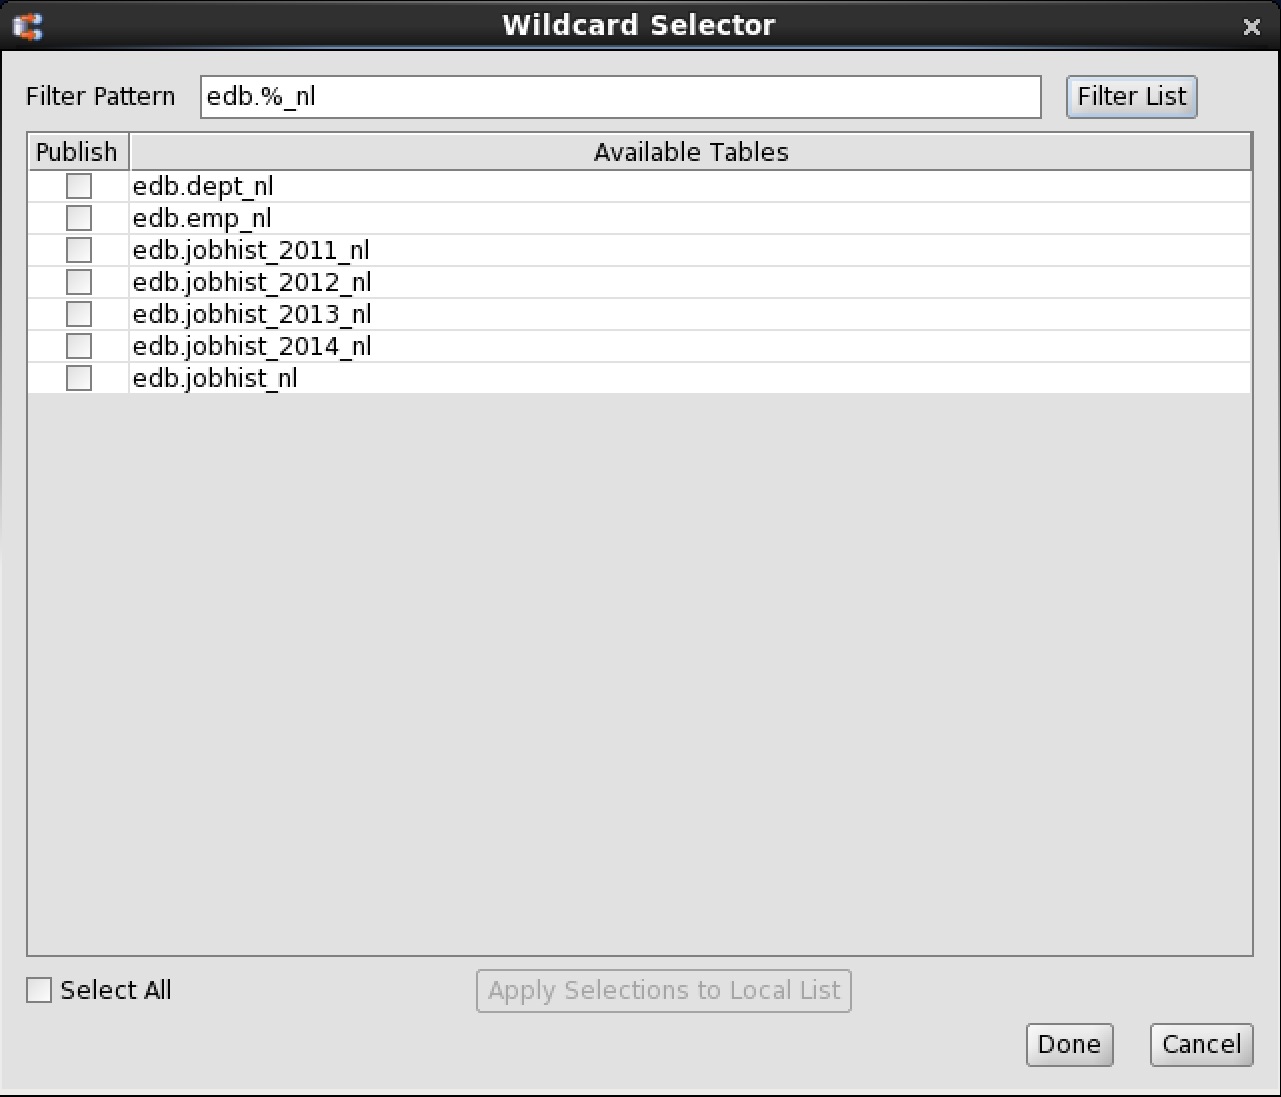
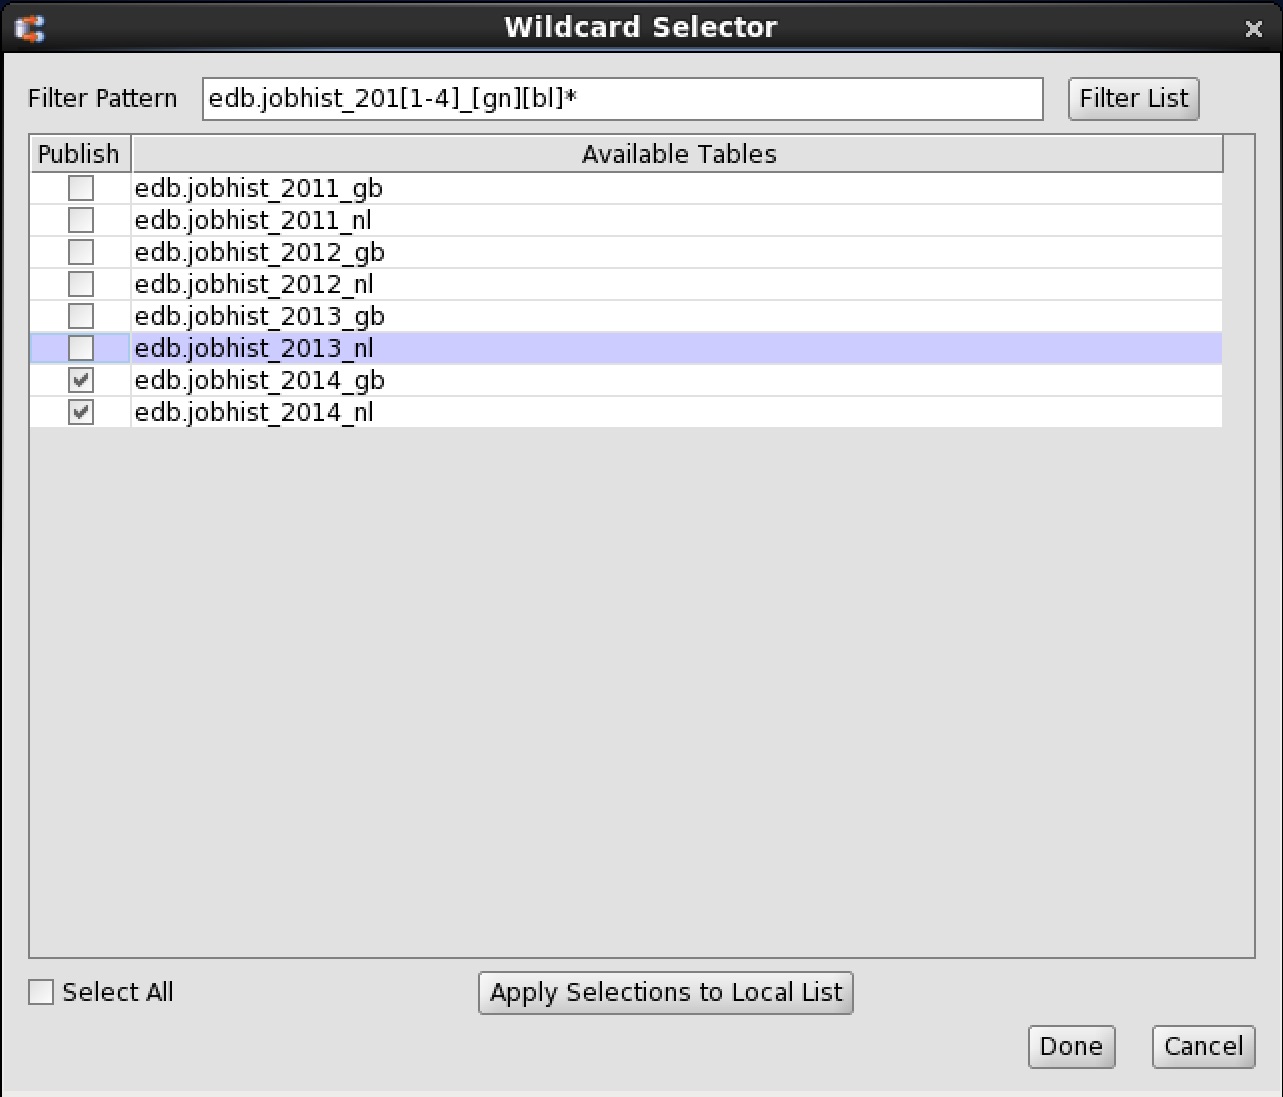
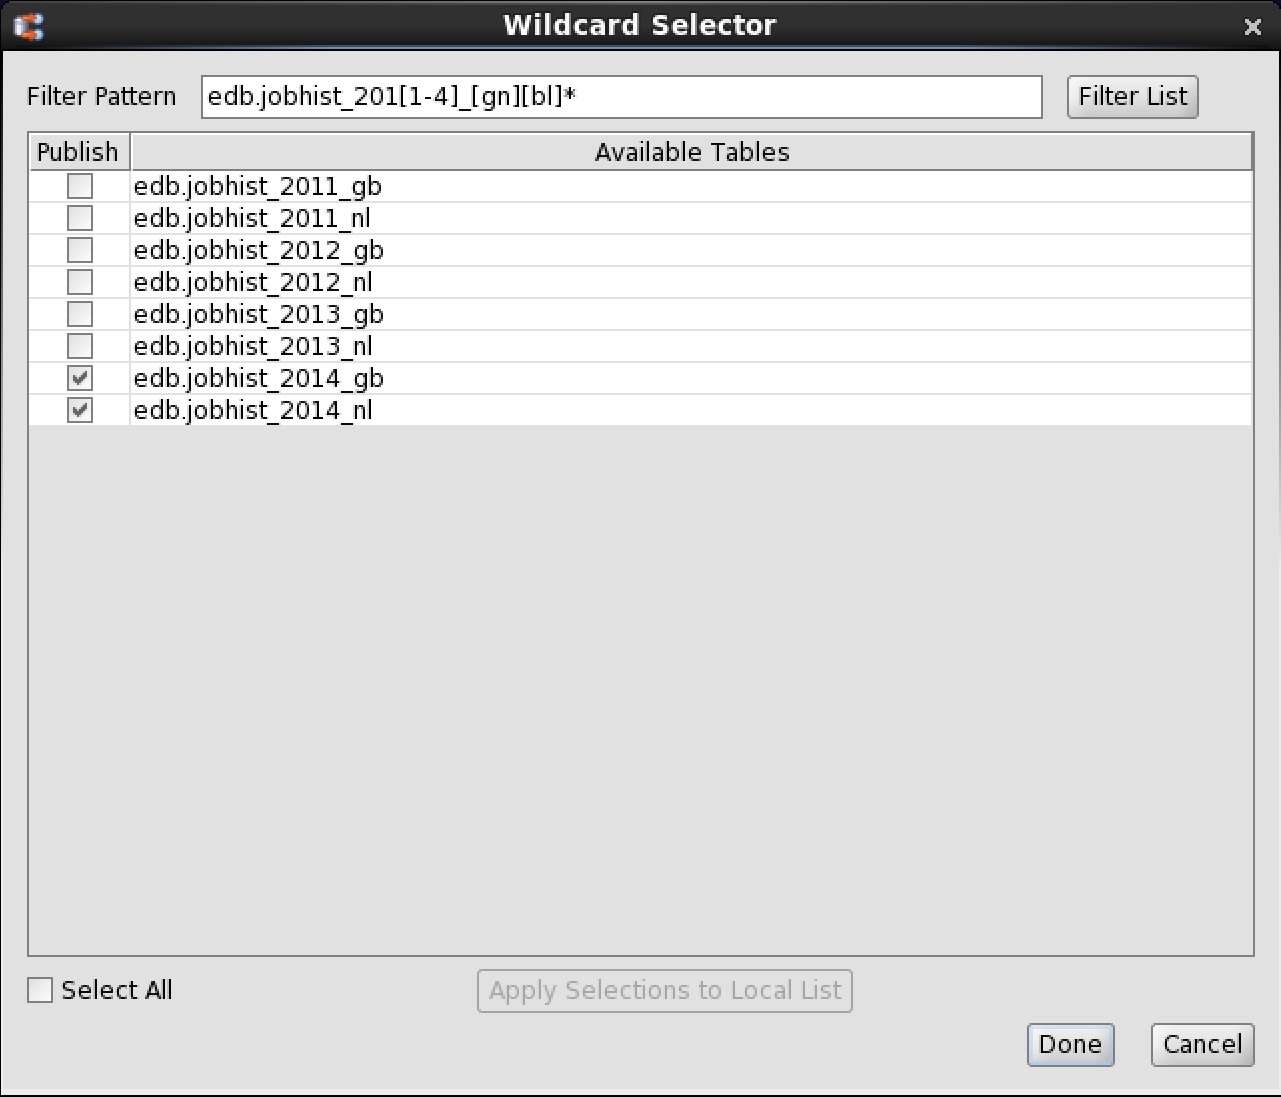
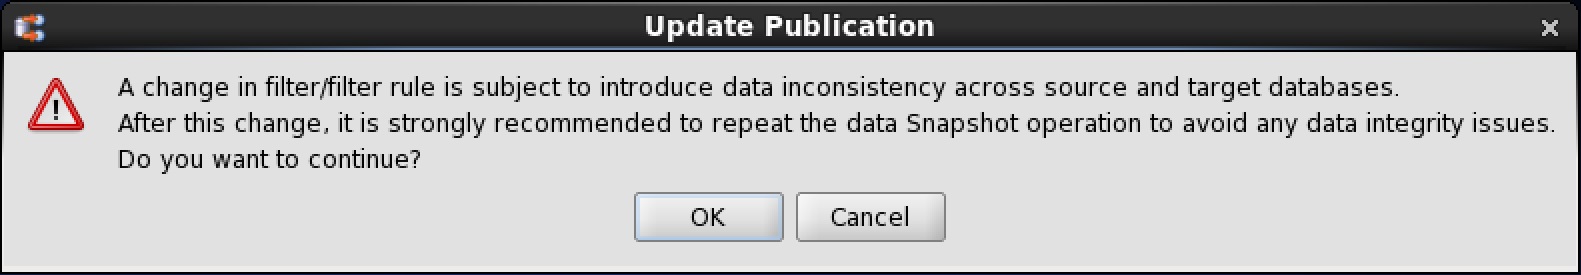
• ワイルドカード選択を使用します。このボタンをクリックして、ワイルドカードセレクターを使用してパブリケーションのテーブルを選択します。ワイルドカードセレクタの詳細については、セクション7.1を参照してください。ステップ3(オプション): テーブルフィルターは、スナップショットまたは同期レプリケーション中にサブスクリプションテーブルにレプリケートされる行の選択基準を制御するフィルタールールのセットで構成されます。フィルタルールは、 フィルタ名とSQLで構成されて句(省略さWHERE WHEREキーワード)を使用すると、レプリケーション中に含まれている行の選択基準を定義するテーブルまたはビューに指定するフィルタ句を 、と呼ばれます。以下は、 [テーブル/ビュー]ドロップダウンリストから[ EDB.EMP ]を選択し、[フィルター]ダイアログボックスに10を含むdeptno行のみの選択基準を入力して、 EMPテーブルに追加されたルールを示しています。サブスクリプションを作成するときに、対応するサブスクリプションテーブルでこれらのテーブルフィルターを選択的に有効にすることができます。サブスクリプションの作成については、セクション 5.3.3を参照してください 。ステップ4: [作成]ボタンをクリックします。 Publication Created Successfullyが表示されたら、[OK]ボタンをクリックします。それ以外の場合は、エラーを調査し、必要な修正を行います。5.2.4.1 Oracle Control Schema Objects
• コンベンションに従って命名テーブル RRST_ schema _ tableからSELECTの声明user_tables唯一の同期パブリケーションのために発見されました。この例では、これらのテーブルはRRST_EDB_DEPTおよびRRST_EDB_EMPです。
• コンベンションに従って命名トリガ RRPD_ schema _ table 、 RRPI_ schema _ table 、およびRRPU_ schema _ tableからSELECTの声明user_triggers唯一の同期パブリケーションのために発見されました。この例では、これらのトリガーはRRPU_EDB_DEPT 、 RRPI_EDB_DEPT 、 RRPD_EDB_DEPT 、 RRPI_EDB_EMP 、 RRPU_EDB_EMP 、およびRRPD_EDB_EMPです。注: RREP_SYNCID_ARRAYコレクションタイプは、Oracleパブリケーションデータベースでのみ見つかります。ほとんどの制御スキーマオブジェクトは、スキーマ _edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerで作成されます 。セクション5.1.4.2の手順5で選択したスキーマに、追加の制御スキーマオブジェクトが作成されます。次の例では、選択したスキーマがpubuserであると想定しています。パブリケーションテーブルは、 edbスキーマにあるdeptおよびempです。注(SQL Server 2012、2014の場合):パブリケーションデータベースがSQL Server 2012または2014の場合、前述のリストの次のデータベースオブジェクトは、コントロールスキーマの一部として作成されなくなりました。5.2.4.3 Postgres Control Schema Objects_edb_replicator_pub 含まれるコントロールスキーマオブジェクトは、次のように表示されます。_edb_replicator_sub 含まれる制御スキーマオブジェクトは、次のように表示されます。_edb_scheduler 含まれる制御スキーマオブジェクトは、次のように表示されます。
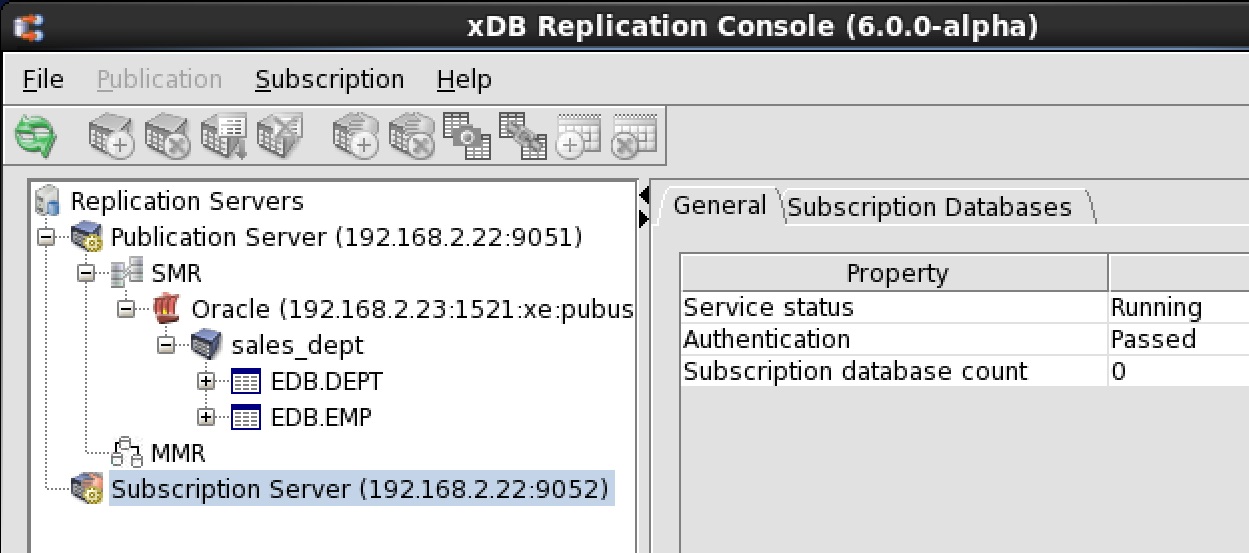
5.3 サブスクリプションの作成注: Oracleパブリケーションまたはサブスクリプションデータベースを使用していて、Oracle JDBCドライバーをxDB Replication Serverインストールのlib/jdbcサブディレクトリにコピーしてからサブスクリプションサーバーが再起動されていない場合、サブスクリプションサーバーを再起動する必要があります。Linuxのみ: CentOS 7またはRHEL 7のsystemctlコマンド、および以前のLinuxバージョンのserviceコマンドをedb-xdbsubserverして、サブスクリプションサーバーのedb-xdbsubserverを起動、停止、または再起動します。これらのコマンドの使用方法については、セクション5.2.1を参照してください。Windowsのみ:コントロールパネル、システムとセキュリティ、管理ツール、サービスの順に開きます。 Subscription Service for xDB Replication Serverという名前のサービスの[開始]または[再起動]リンクを使用しSubscription Service for xDB Replication Server 。ステップ2:サブスクリプションサーバーを登録します。システムのアプリケーションメニューからxDBレプリケーションコンソールを開きます。 xDB RPMパッケージからインストールされたxDB Replication Serverの場合、xDB Replication Consoleは、スクリプトXDB_HOME /bin/runRepConsole.shを呼び出すことにより開始されます。ステップ3:最上位のReplication Serverノードを選択します。 [ファイル]メニューの[サブスクリプションサーバー]を選択し、[サーバーの登録]を選択します。または、Replication Serversノードでセカンダリマウスボタンをクリックし、Register Subscription Serverを選択します。 [サブスクリプションサーバーの登録]ダイアログボックスが表示されます。
•
•
• パスワード。 [ユーザー名]フィールドで指定された管理ユーザーのパスワード。
• ログイン情報を保存します。 xDB Replication Consoleを開くたびにサブスクリプションサーバーを再登録しない場合は、このボックスをオンにします。サーバーのログイン情報を保存する利点と欠点の詳細については、セクション4.2を参照してください。注:入力したユーザー名とパスワードの組み合わせは、ホストフィールドに入力したIPアドレスを持つホストにあるxDBレプリケーション構成ファイルの管理ユーザー名とパスワードに対して認証されます。
• Oracleのみ。このデータベースにレプリケートされるパブリケーションのテーブルまたはビューと同じ名前を持つ、Oracleサブスクリプションデータベースユーザーが所有する既存のテーブルまたはビューが存在していてはなりません。たとえば、Oracleサブスクリプションデータベースのユーザー名がsubuserで、Postgresパブリケーションに名前deptテーブルが含まれている場合、Oracleサブスクリプションデータベースには、スキーマ修飾名subuser.dept既存のテーブルまたはビューがあってはなりません。サブスクリプションを作成するとき。
• Postgresのみ。このデータベースにレプリケートされるパブリケーション内のテーブルまたはビューと同じスキーマ修飾名を持つ既存のテーブルまたはビューが存在してはなりません。たとえば、パブリケーションにスキーマ修飾名edb.deptテーブルが含まれている場合、Postgresサブスクリプションデータベースには、サブスクリプションの作成時にスキーマ修飾名edb.dept既存のテーブルまたはビューがあってはなりません。 注: SQL Serverパブリケーションのスキーマ名がdbo場合、サブスクリプションテーブルはPostgresのdbo_sqlというスキーマの下に作成されます。
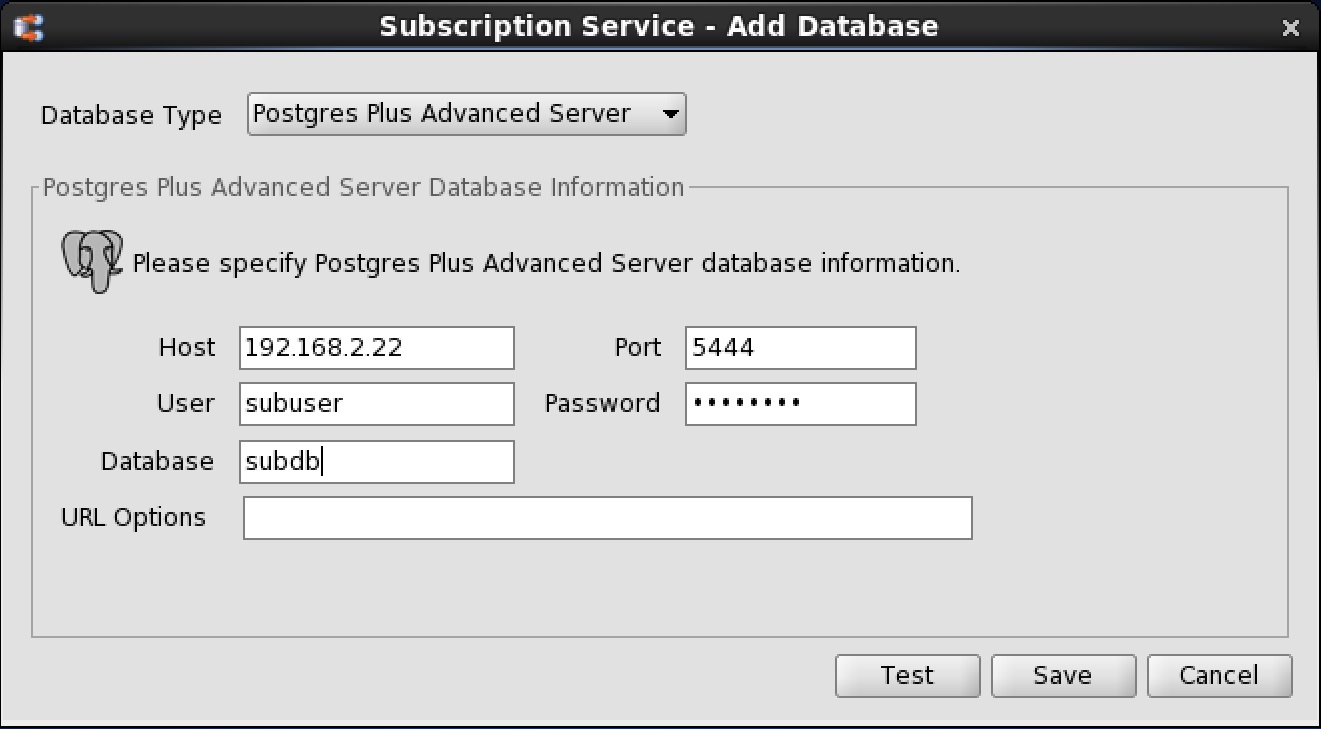
• SQL Serverのみ。このデータベースにレプリケートされるパブリケーション内のテーブルまたはビューと同じスキーマ修飾名を持つ既存のテーブルまたはビューが存在してはなりません。たとえば、パブリケーションにスキーマ修飾名edb.deptテーブルが含まれている場合、SQL Serverサブスクリプションデータベースには、サブスクリプションの作成時にスキーマ修飾名edb.dept既存のテーブルまたはビューがあってはなりません。 注: Postgresの公開スキーマ名がpublic場合、サブスクリプションテーブルはSQL Serverのpublic_sqlという名前のスキーマの下に作成されます。注:パブリケーションデータベースとして追加されたデータベースは、サブスクリプションデータベースとしても使用できます。手順1:サブスクリプションデータベースが存在するデータベースサーバーが実行され、クライアント接続を受け入れていることを確認します。ステップ2: Subscription Serverノードを選択します。 [サブスクリプション]メニューから[サブスクリプションデータベース]を選択し、[データベースの追加]を選択します。または、Subscription Serverノードで二次マウスボタンをクリックし、データベースの追加を選択します。 [サブスクリプションサービス-データベースの追加]ダイアログボックスが表示されます。ステップ3:次のフィールドに入力します。
• データベースの種類。サブスクリプションデータベースのタイプとして、Oracle、SQL Server、PostgreSQL、またはPostgres Plus Advanced Serverを選択します。 Advanced Server Oracle互換インストールの場合、Postgres Plus Advanced Serverオプションを選択します。 PostgreSQLまたはAdvanced Server PostgreSQL互換インストールの場合、PostgreSQLオプションを選択します。
• ホスト。サブスクリプションデータベースサーバーが実行されているホストのIPアドレス。
• 港。サブスクリプションデータベースサーバーが接続をリッスンするポート。
•
• パスワード。データベースユーザーのパスワード。
• サービスID(Oracleの場合)。 [SID]ラジオボタンが選択されている場合、サブスクリプションデータベースを実行しているOracleインスタンスのOracleシステム識別子(SID)を入力します。 「サービス名」ラジオボタンが選択されている場合、 TNSNAMES.ORAファイルで定義されている接続記述子のネットサービス名を入力します。 注(Oracle 12cプラグ可能データベースの場合):サービス名を使用します。
• データベース(PostgresまたはSQL Server用)。 PostgresまたはSQL Serverデータベース名を入力します。
• URLオプション(SSL接続用)。 URLオプションを入力して、サブスクリプションデータベースへのSSL接続を確立します。 SSL接続の使用については、セクション7.11を参照してください。ステップ4: [テスト]ボタンをクリックします。テスト結果:成功が表示されたら、[OK]ボタンをクリックしてから、[保存]ボタンをクリックします。5.3.3 Adding a Subscriptionステップ1:サブスクリプションデータベースノードを選択します。 [サブスクリプション]メニューから、[サブスクリプションの作成]を選択します。または、サブスクリプションデータベースノードで二次マウスボタンをクリックし、サブスクリプションの作成を選択します。 [サブスクリプションの作成]ダイアログボックスが表示されます。ステップ2:次のフィールドに入力します。
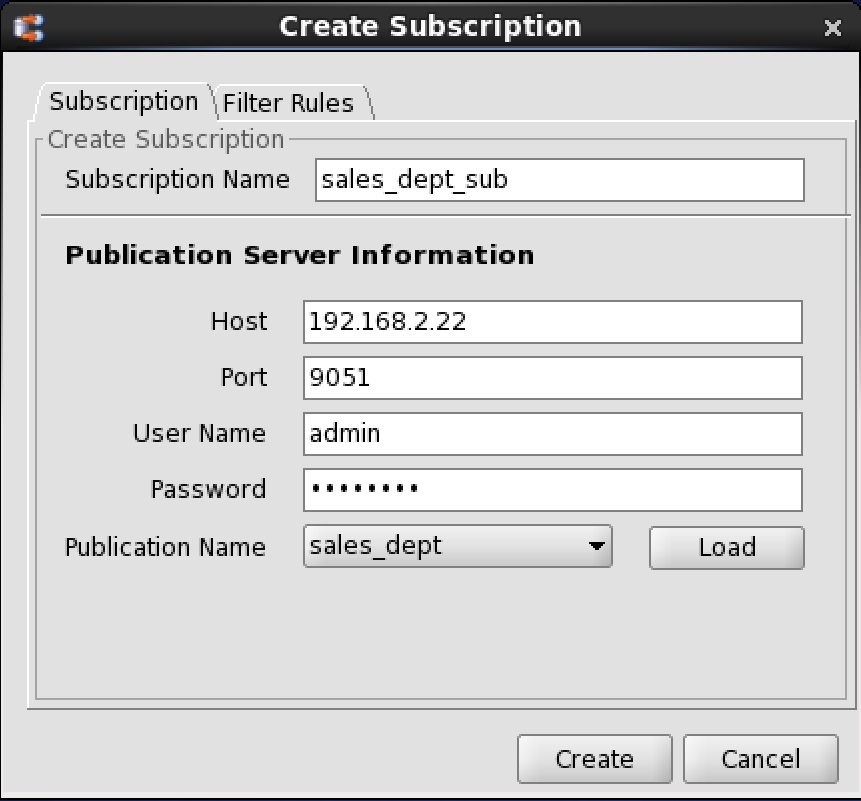
• サブスクリプション名。すべてのサブスクリプション名の中で一意のサブスクリプションの名前を入力します。
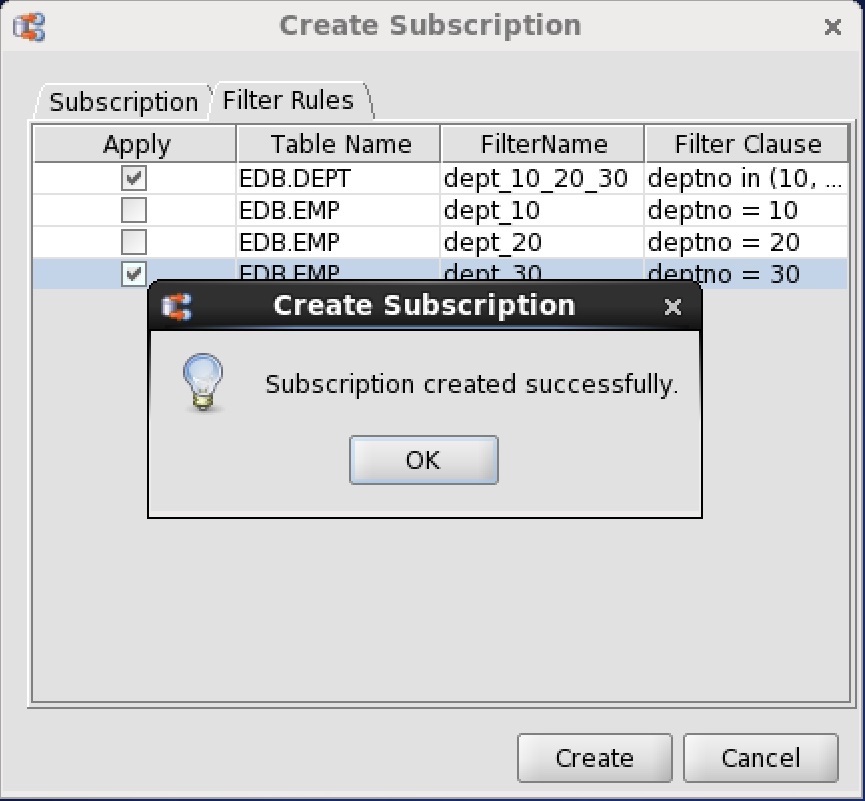
• 出版物名。 [ロード]ボタンをクリックして、利用可能なパブリケーションのリストを取得します。サブスクライブするパブリケーションを選択します。ステップ3(オプション):パブリケーションで使用可能なテーブルフィルターのセットを定義した場合、このサブスクリプションでこれらのフィルターを有効にするオプションがあります。テーブルフィルターの定義手順については、セクション5.2.3を参照してください。このサブスクリプションに複製される行をフィルタリングしたくない場合は、ステップ4に進みます。ステップ4: [作成]ボタンをクリックします。 [サブスクリプションが正常に作成されました]と表示されたら、[OK]ボタンをクリックします。それ以外の場合は、エラーを調査して必要な修正を行います。Oracleのみ: RREP_TXSET_HEALTHテーブルは、次の出力に示すように、サブスクリプションデータベースユーザーのスキーマに作成されます。
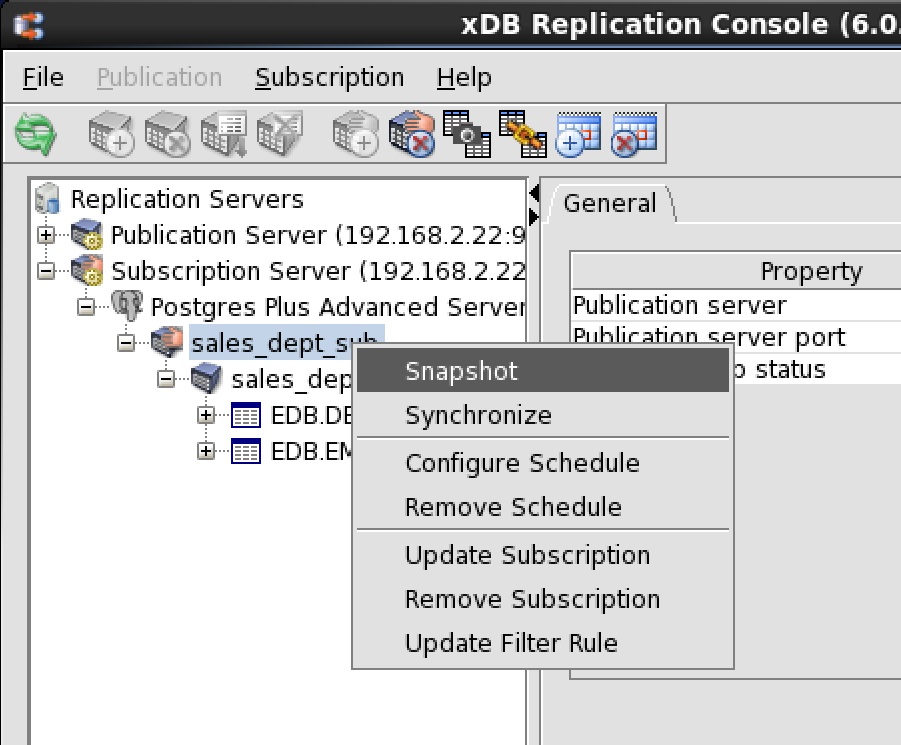
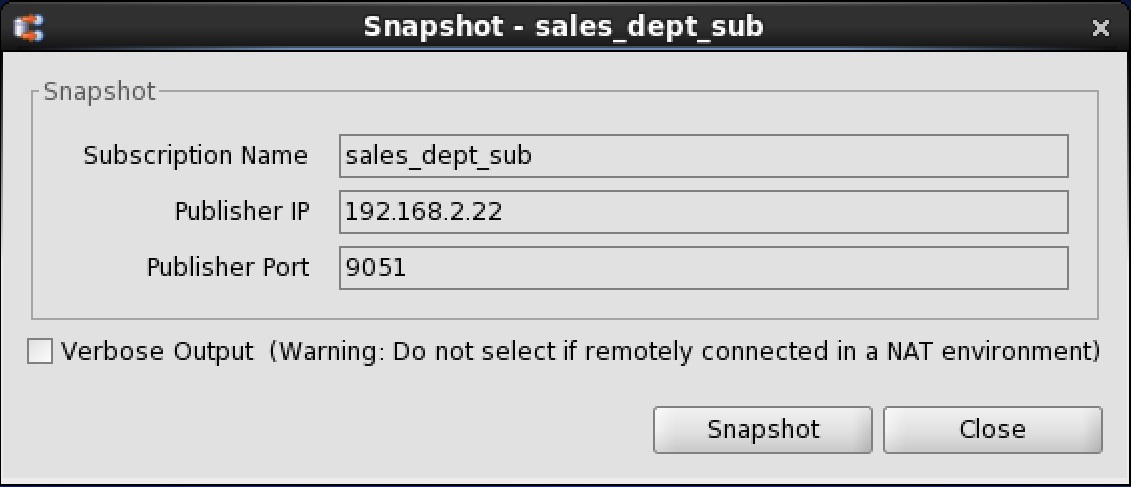
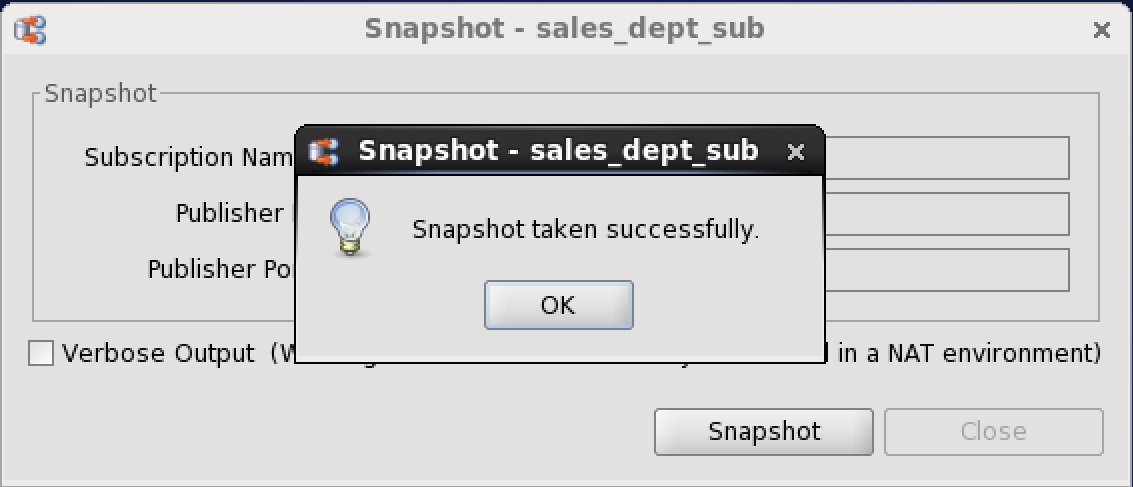
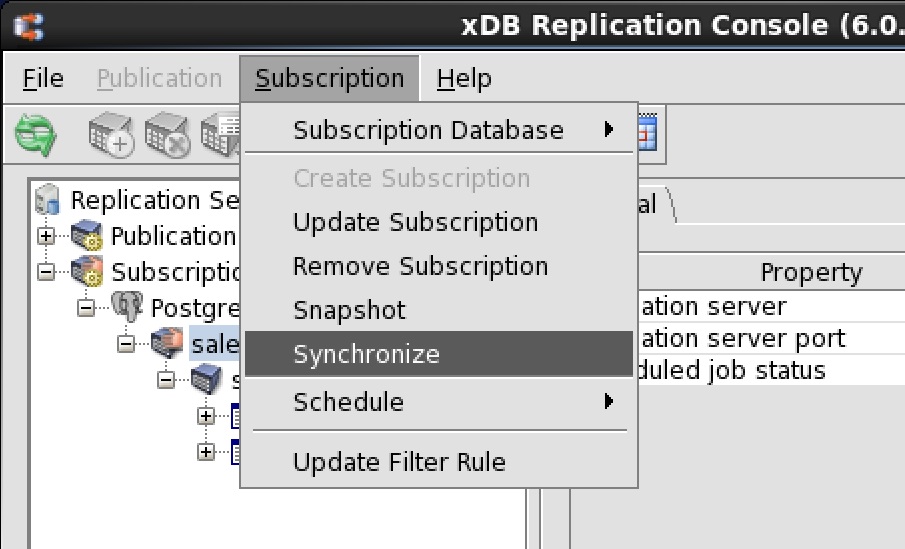
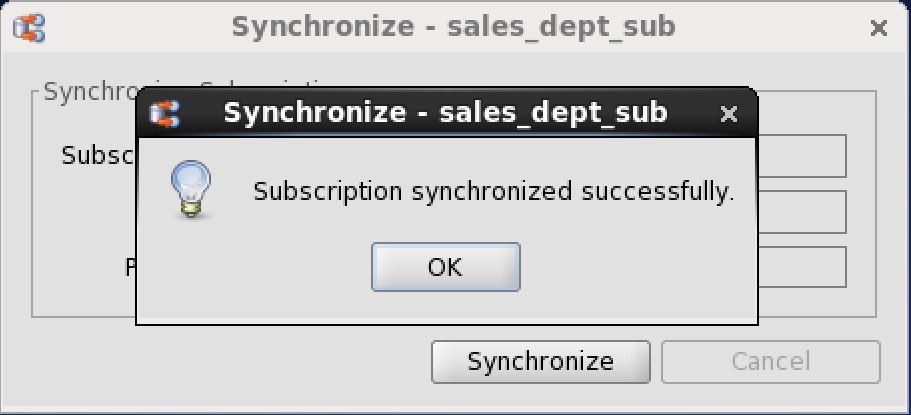
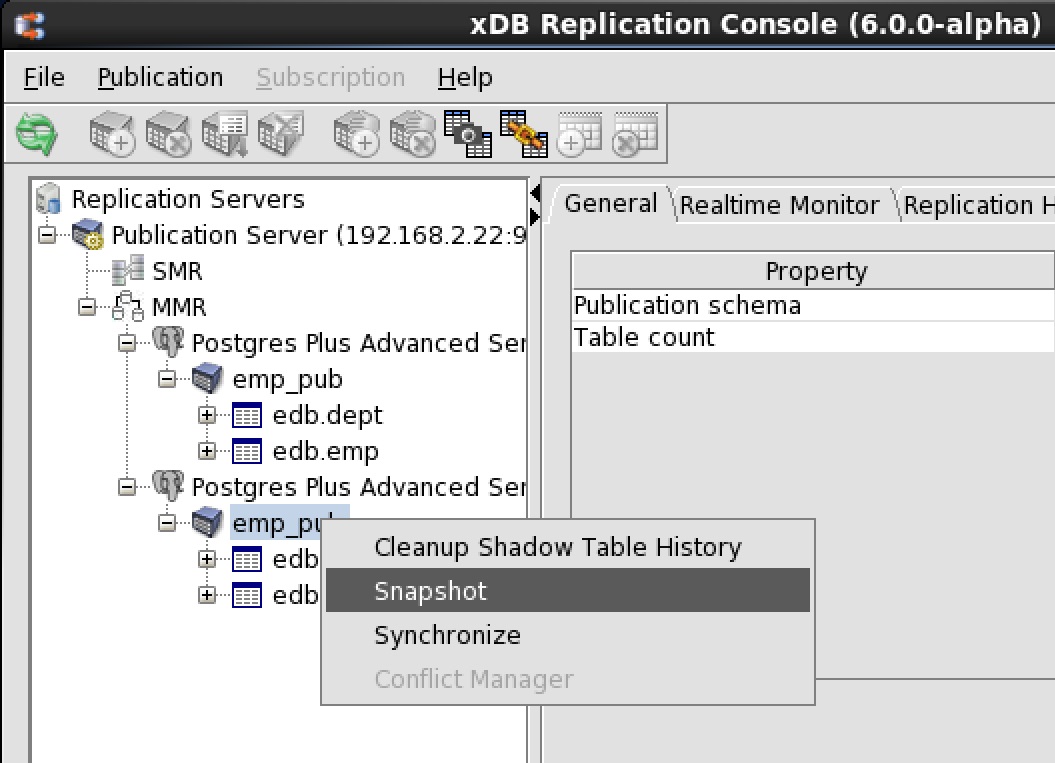
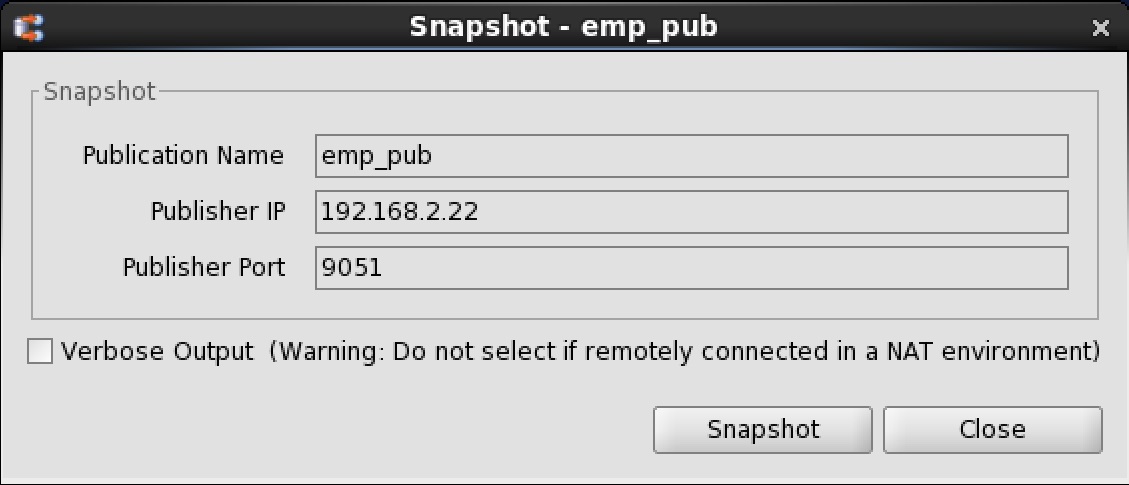
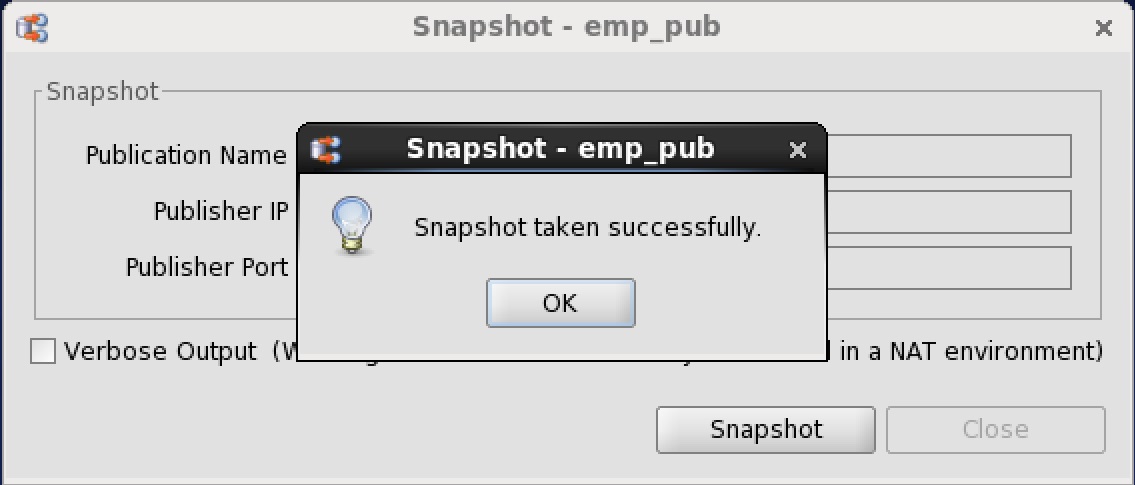
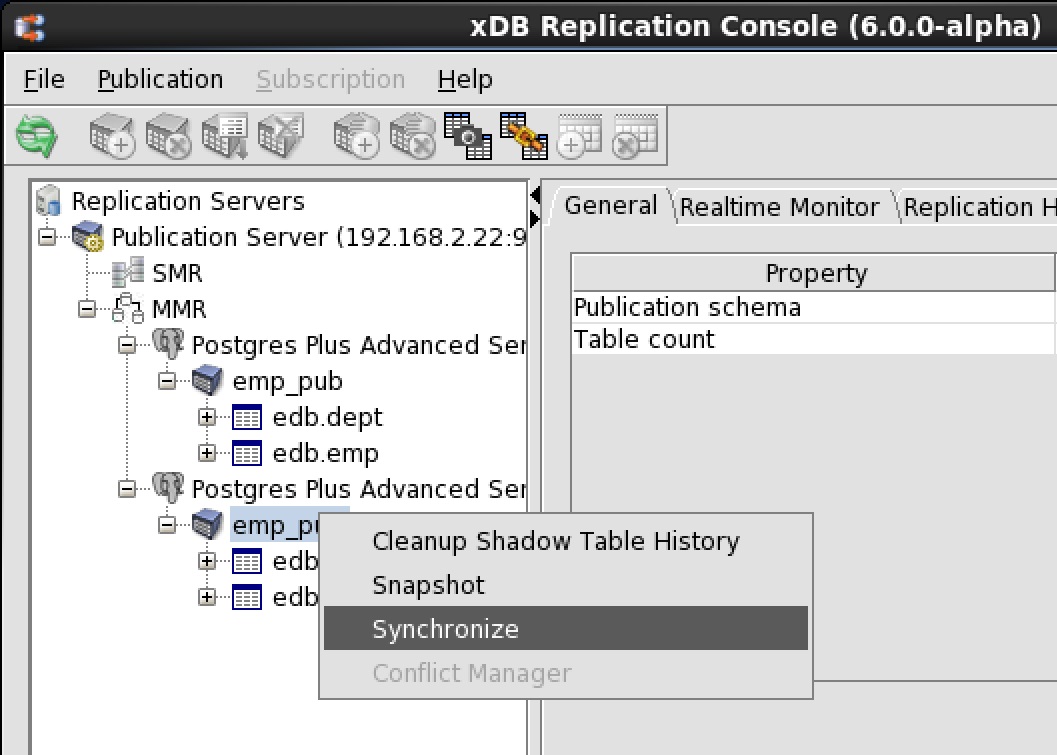
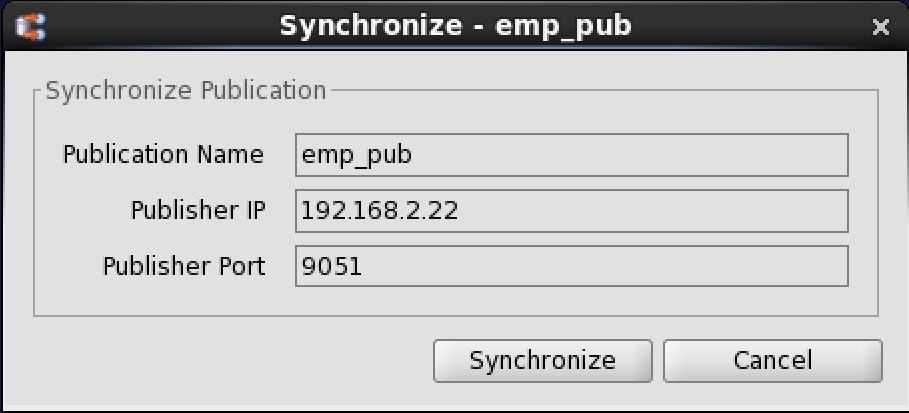
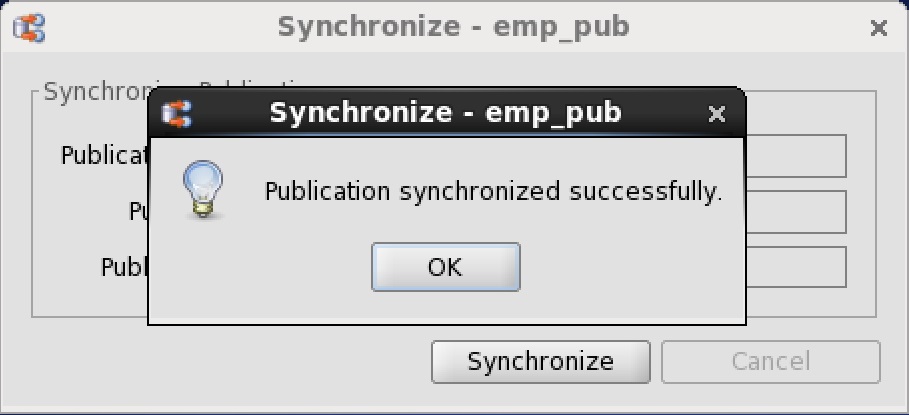
5.4 オンデマンドレプリケーションこのセクションでは、オンデマンドでレプリケーションを開始する手順について説明します。セクション 7.2では、スケジュールの作成方法について説明します。手順1:スナップショットレプリケーションを実行するサブスクリプションのサブスクリプションノードを選択します。手順2:次のいずれかの方法で[スナップショット]ダイアログボックスを開きます。ステップ3:スナップショットの出力をダイアログボックスに表示する場合にのみ、[詳細出力]チェックボックスをオンにします。スナップショットからの大量の出力が[スナップショット]ダイアログボックスからの応答を遅延させる可能性があるため、ネットワークアドレス変換(NAT)環境ではこのオプションをオフのままにしておく必要があります。 [スナップショット]ボタンをクリックして、スナップショットの複製を開始します。ステップ4:スナップショットが成功した場合、「スナップショットの取得に成功しました」と表示されます。 OKボタンをクリックします。スナップショットが成功しなかった場合、[詳細出力]が選択されている場合は[スナップショット]ダイアログボックスウィンドウのメッセージをスクロールするか、ログファイルを確認します。各スナップショットのステータスメッセージは、 mtk.log[.という名前のMigration Toolkitログファイルに保存されますmtk.log[.次のディレクトリのn ] (ログファイルのローテーションが有効な場合、 [. n ]はオプションの履歴ファイル数です):POSTGRES_HOMEは、Windows postgresアカウント(Oracle互換構成モードでインストールされたAdvanced Serverのenterprisedbアカウント)のホームディレクトリです。 POSTGRES_HOMEの特定の場所は、Windowsのバージョンによって異なります。 xDB Replication Serverのバージョン番号はxで表され. x 。これで、パブリケーションがサブスクリプションデータベースに複製されました。スナップショットの記録は、レプリケーション履歴に保持されます。レプリケーション履歴を表示する方法については、セクション 7.4を参照してください 。ステップ1:同期レプリケーションのトリガーベースの方法が使用されている場合、同期レプリケーションを実行するサブスクリプションのサブスクリプションノードを選択します。手順2:次のいずれかの方法で[同期]ダイアログボックスを開きます。手順3: [同期]ボタンをクリックして、同期レプリケーションを開始します。ステップ4:同期が成功した場合、Subscription Synchronized Successfullyが表示されます。 OKボタンをクリックします。同期が成功しなかった場合、[同期]ダイアログボックスウィンドウでメッセージをスクロールします。
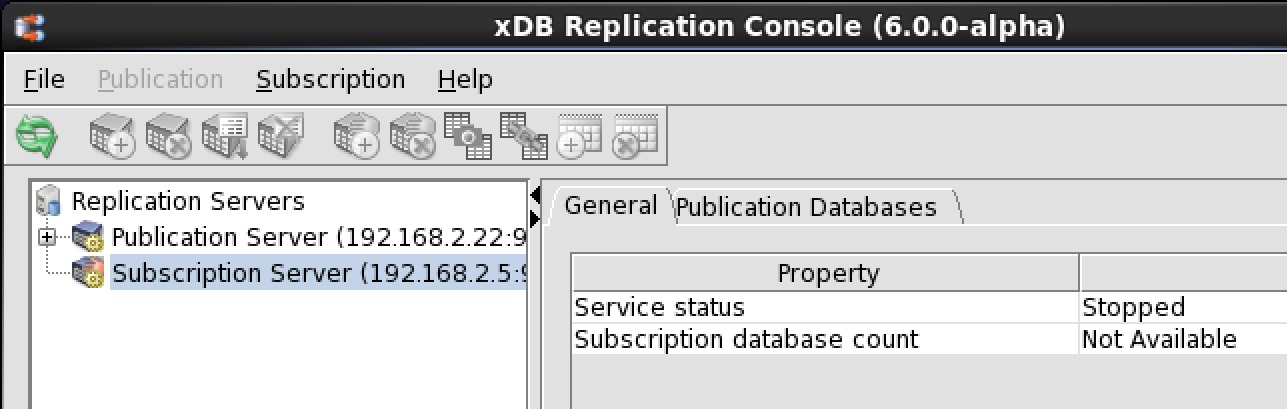
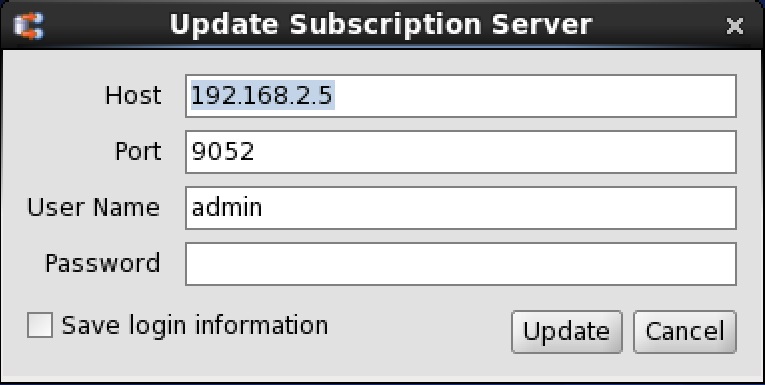
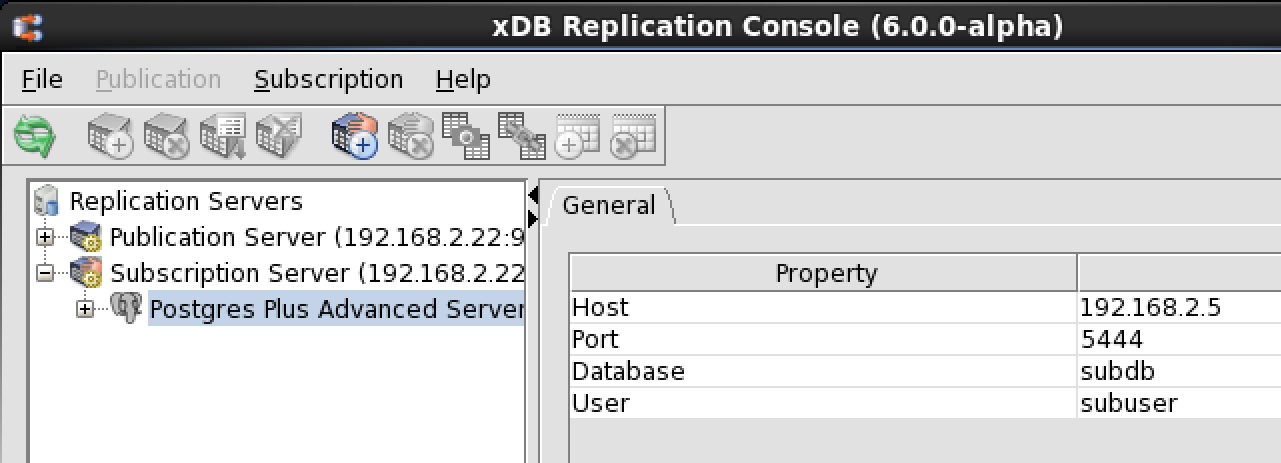
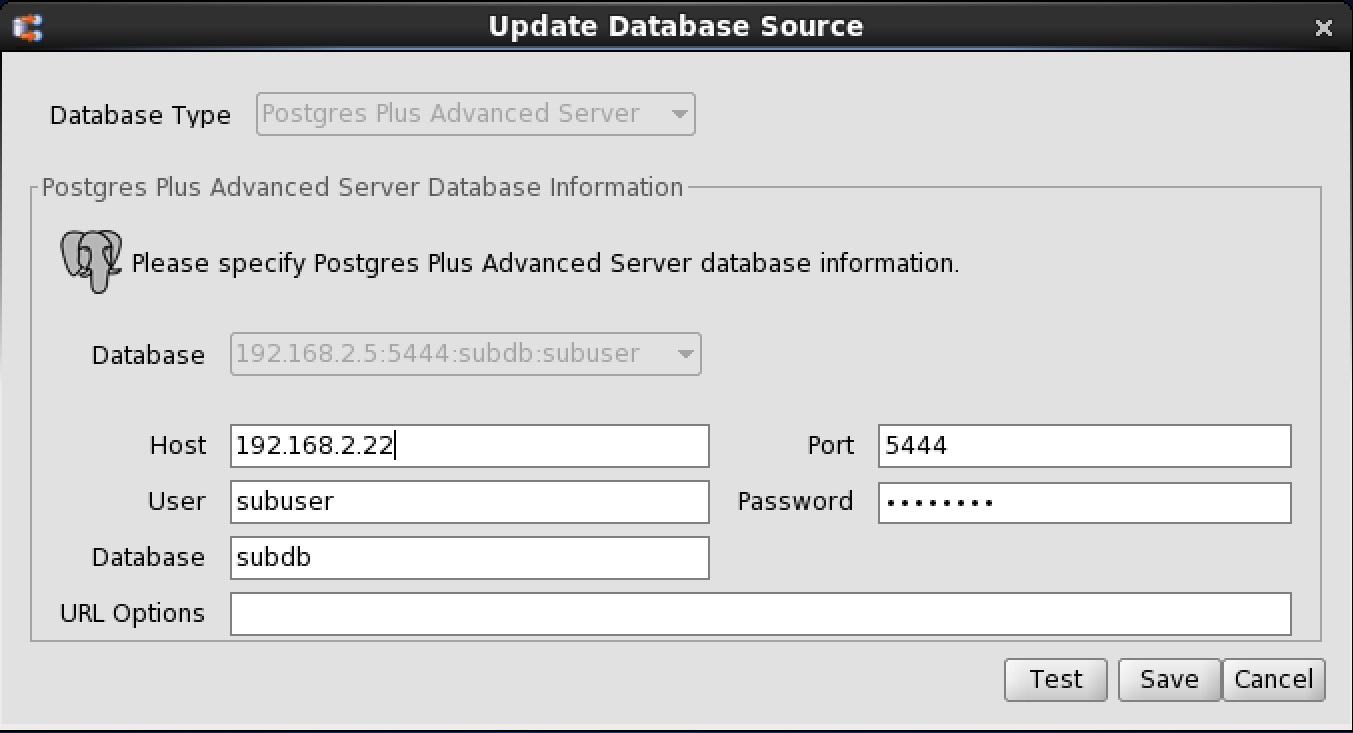
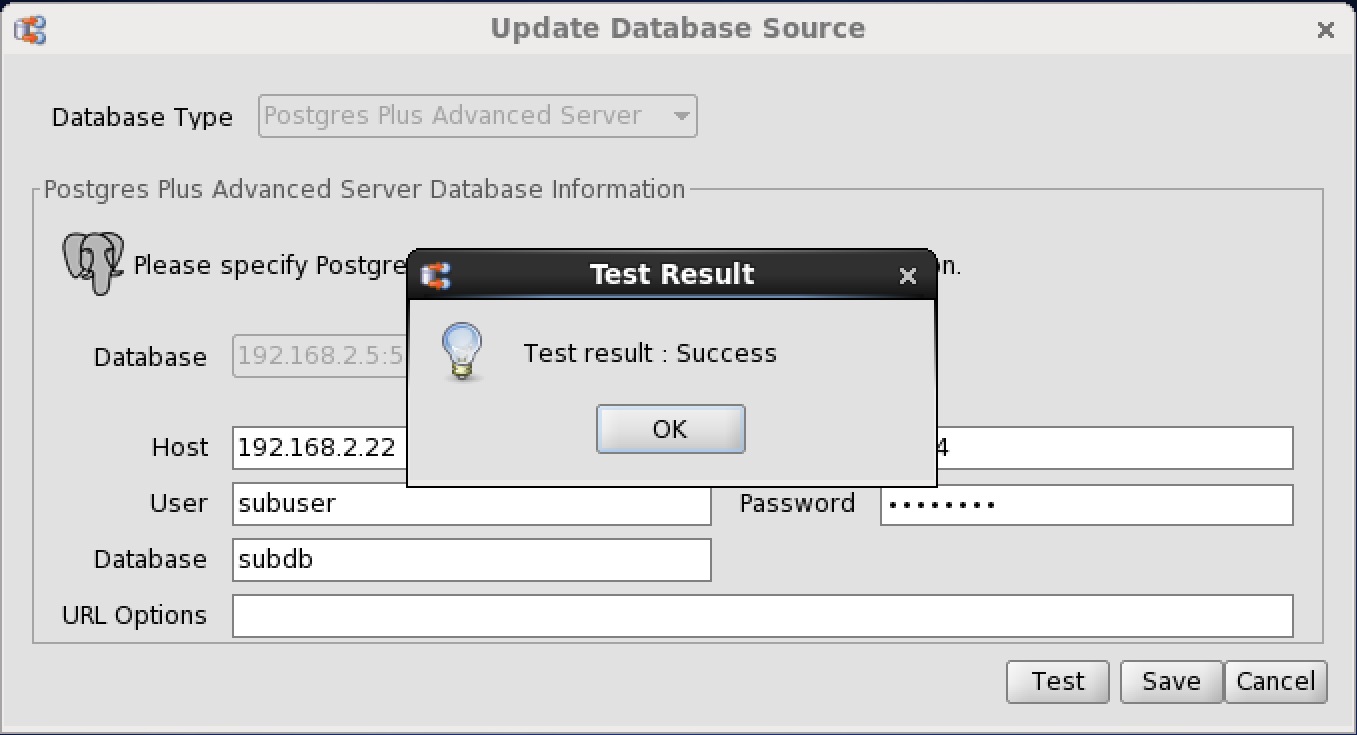
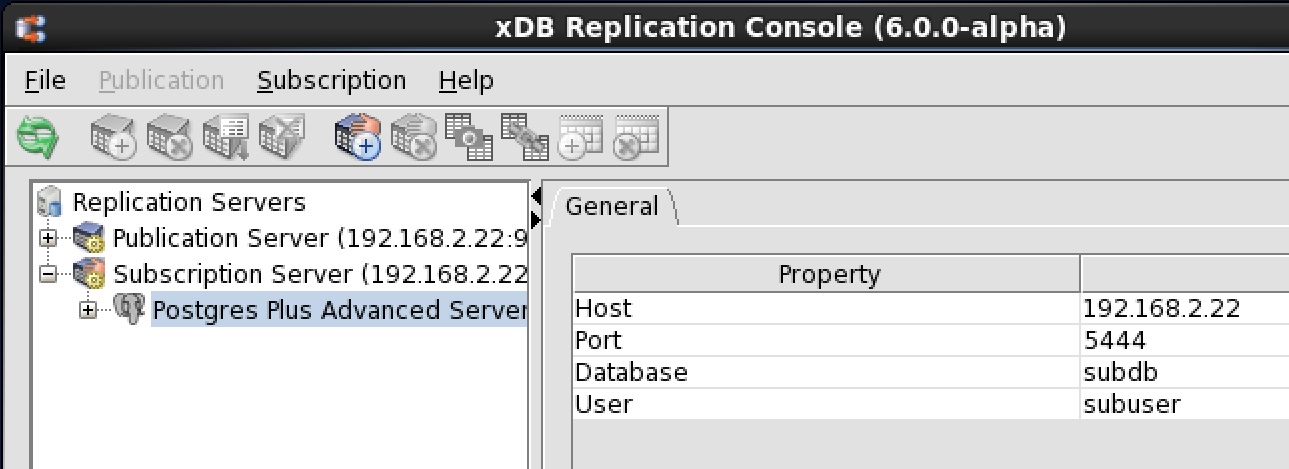
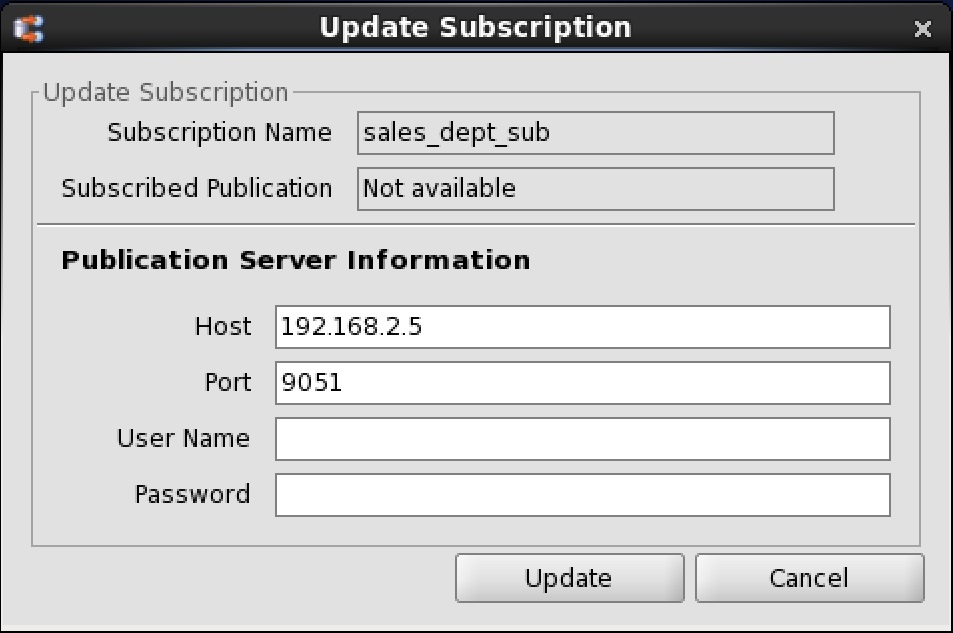
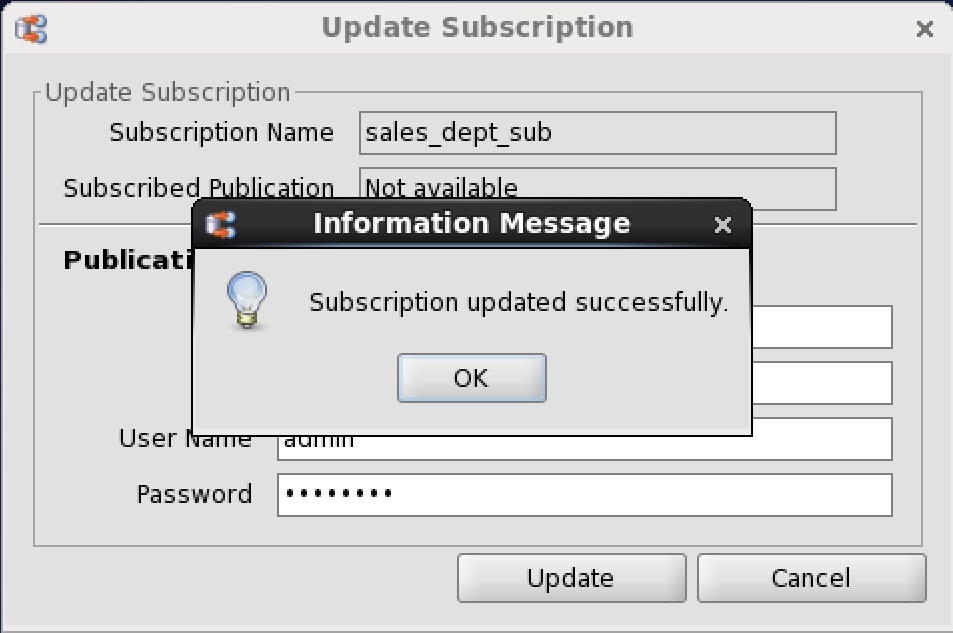
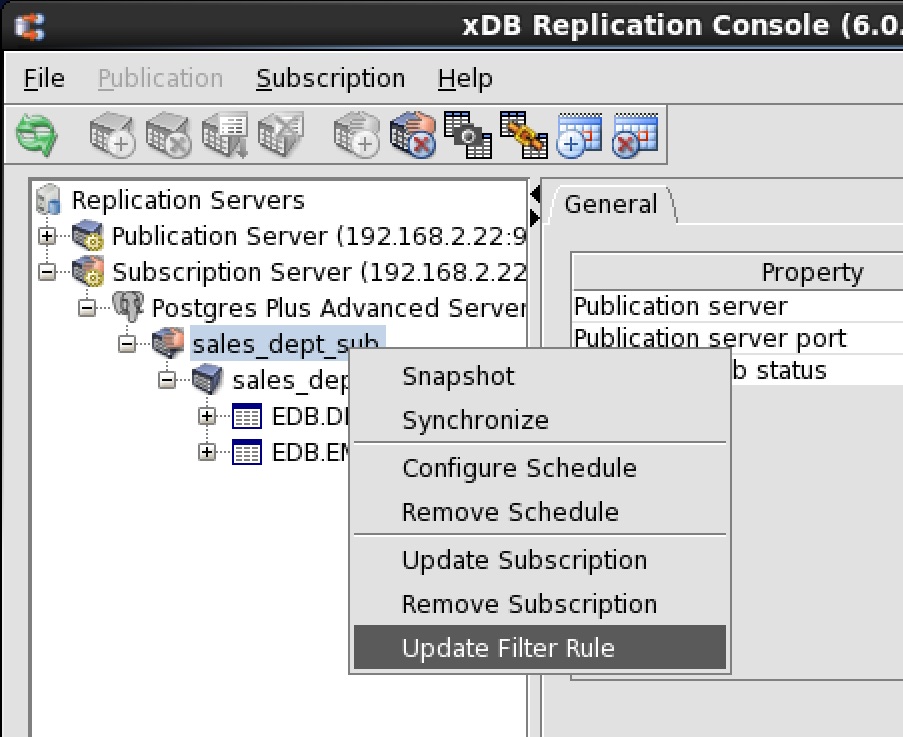
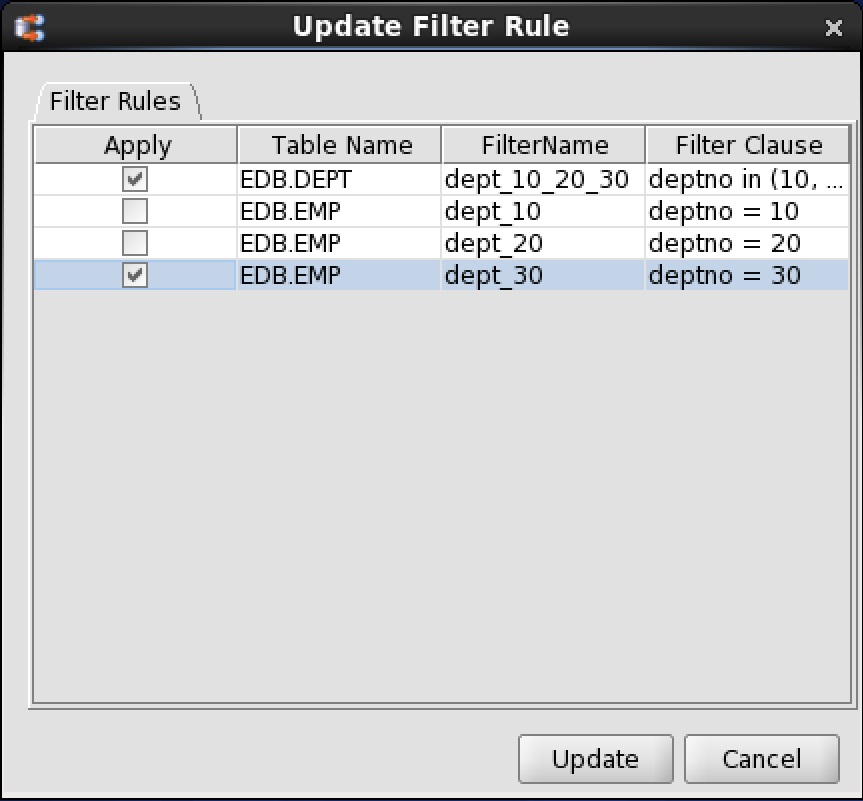
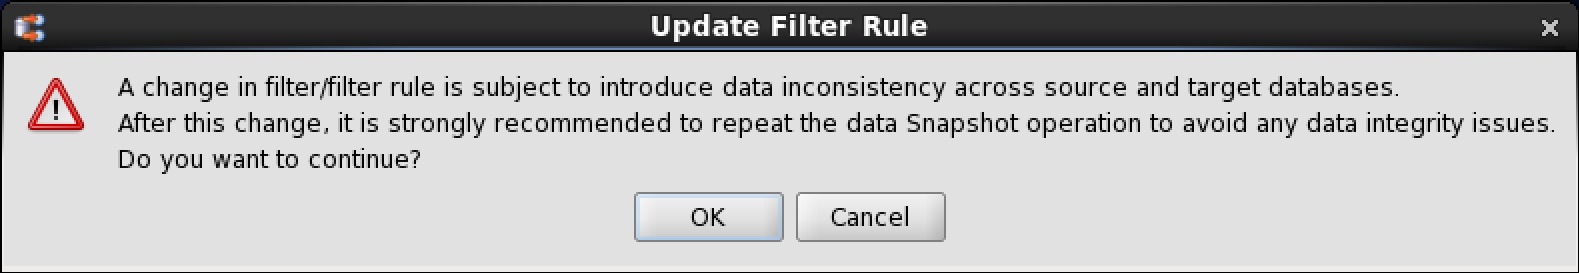
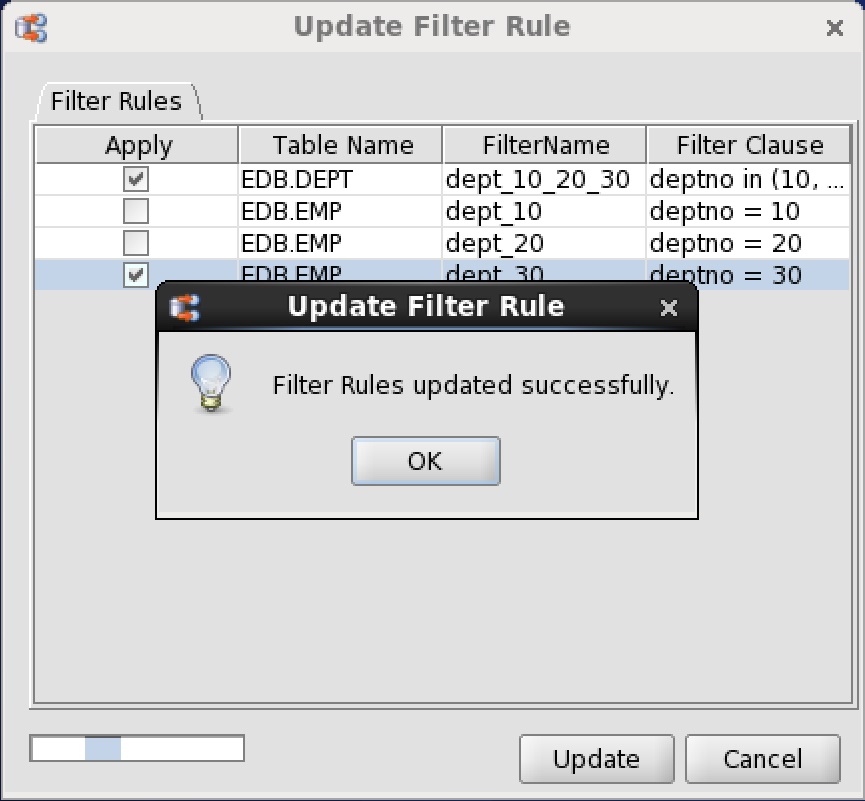
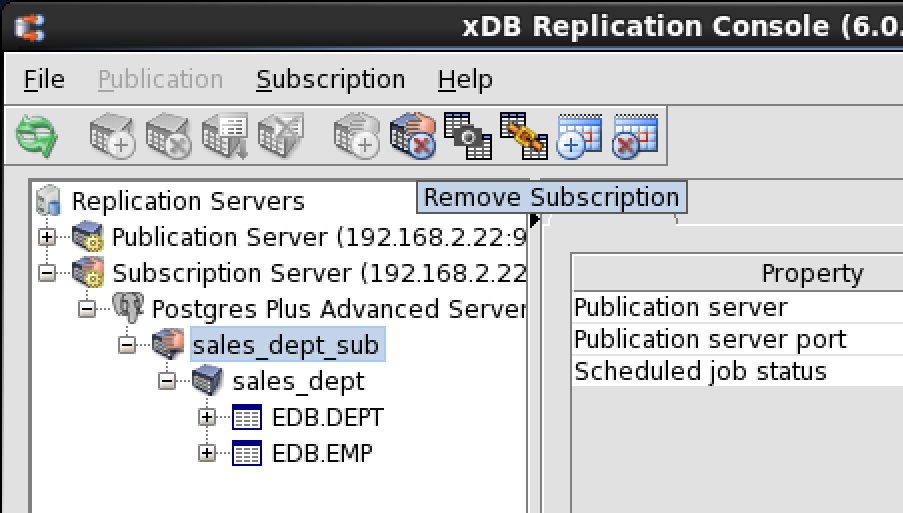
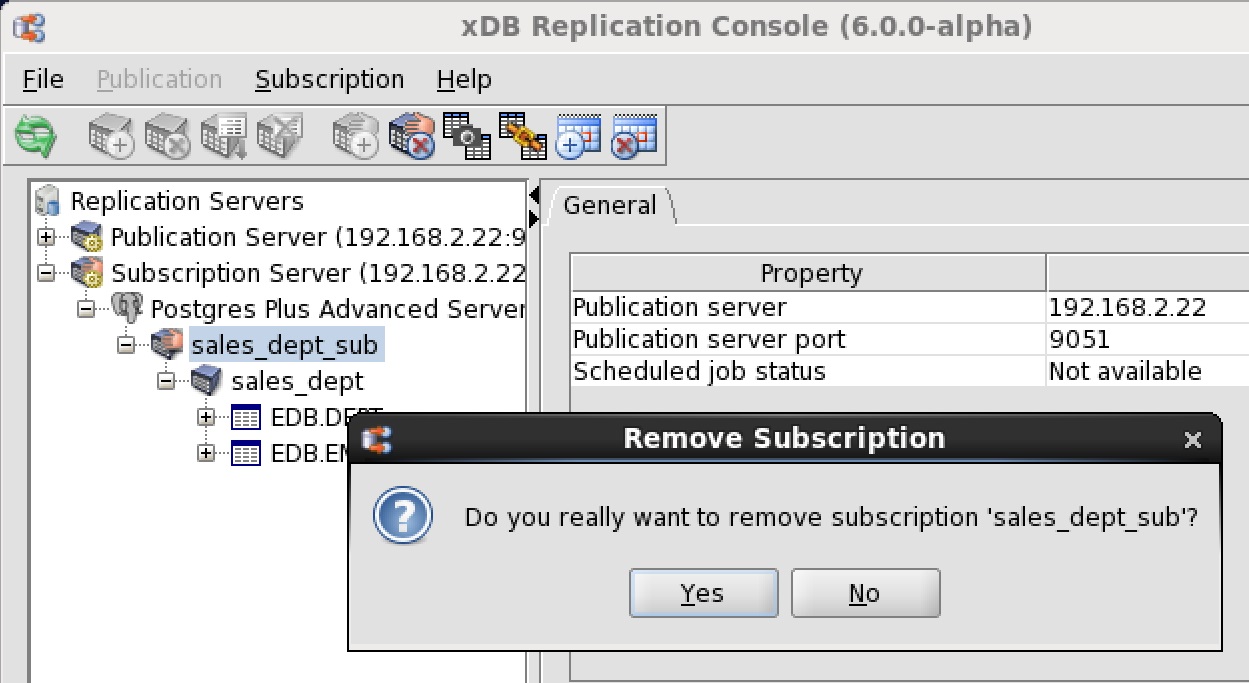
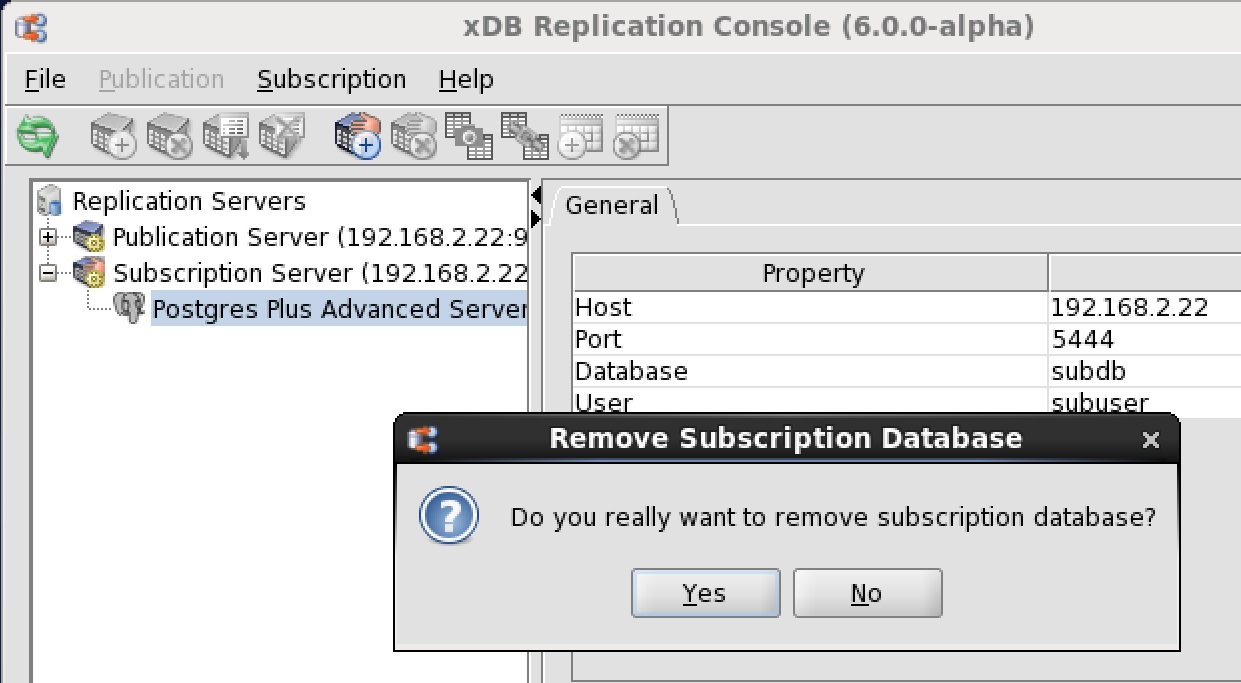
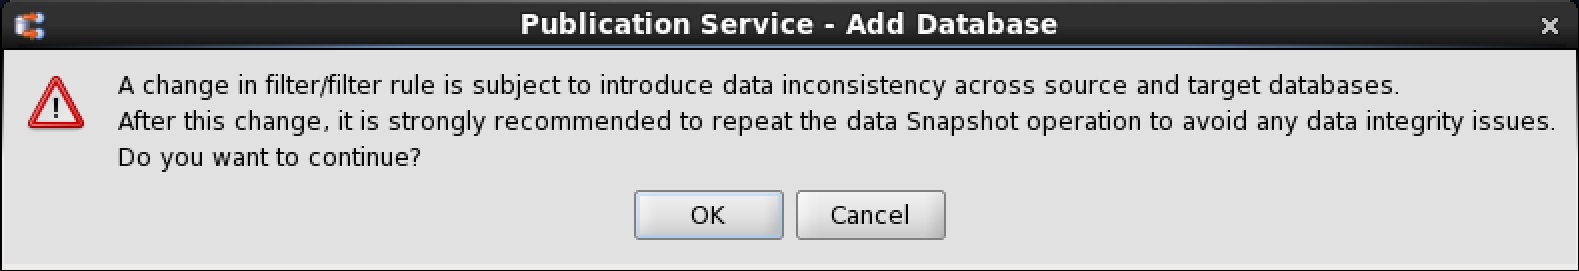
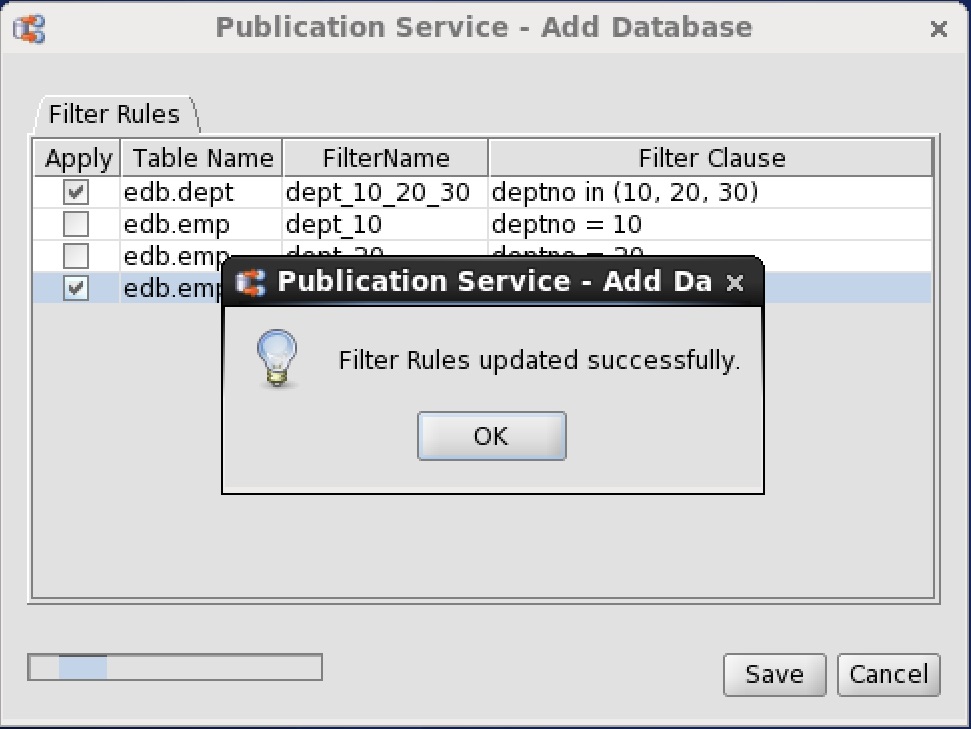
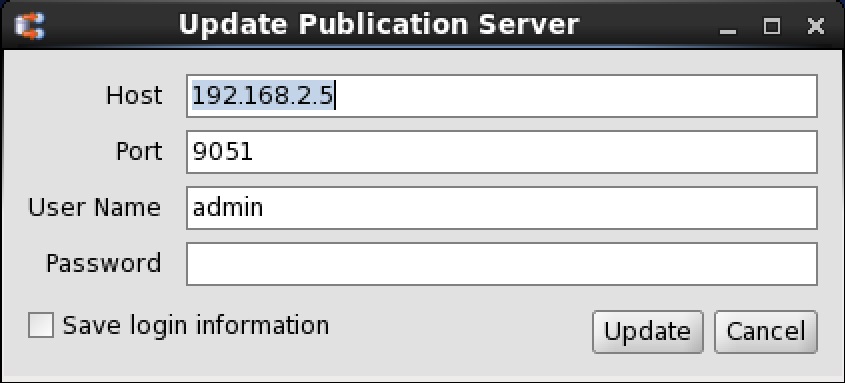
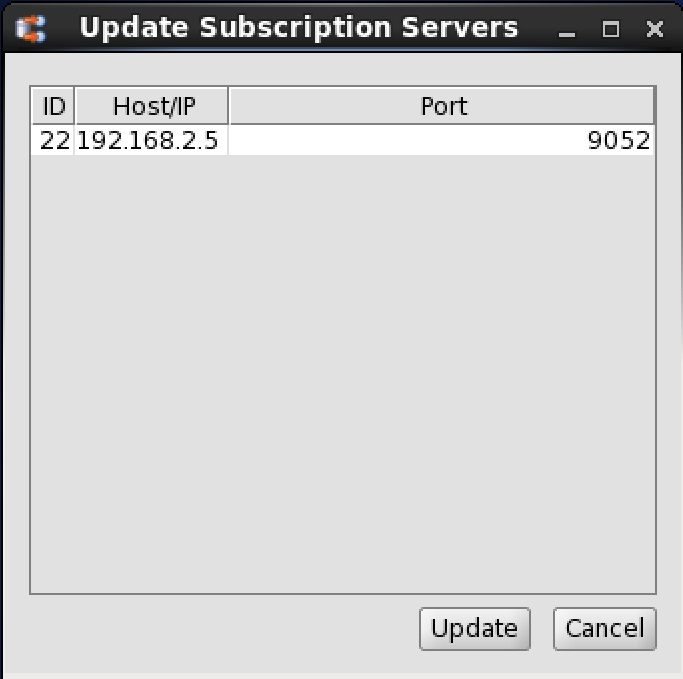
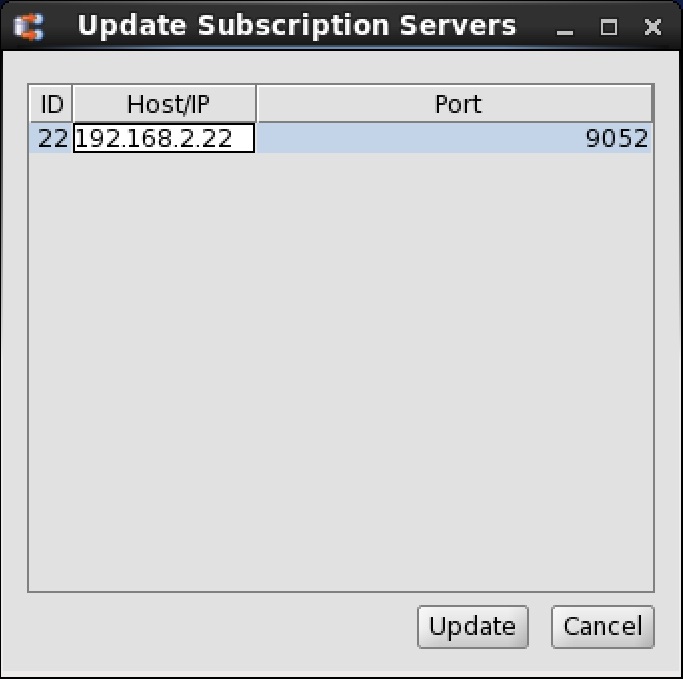
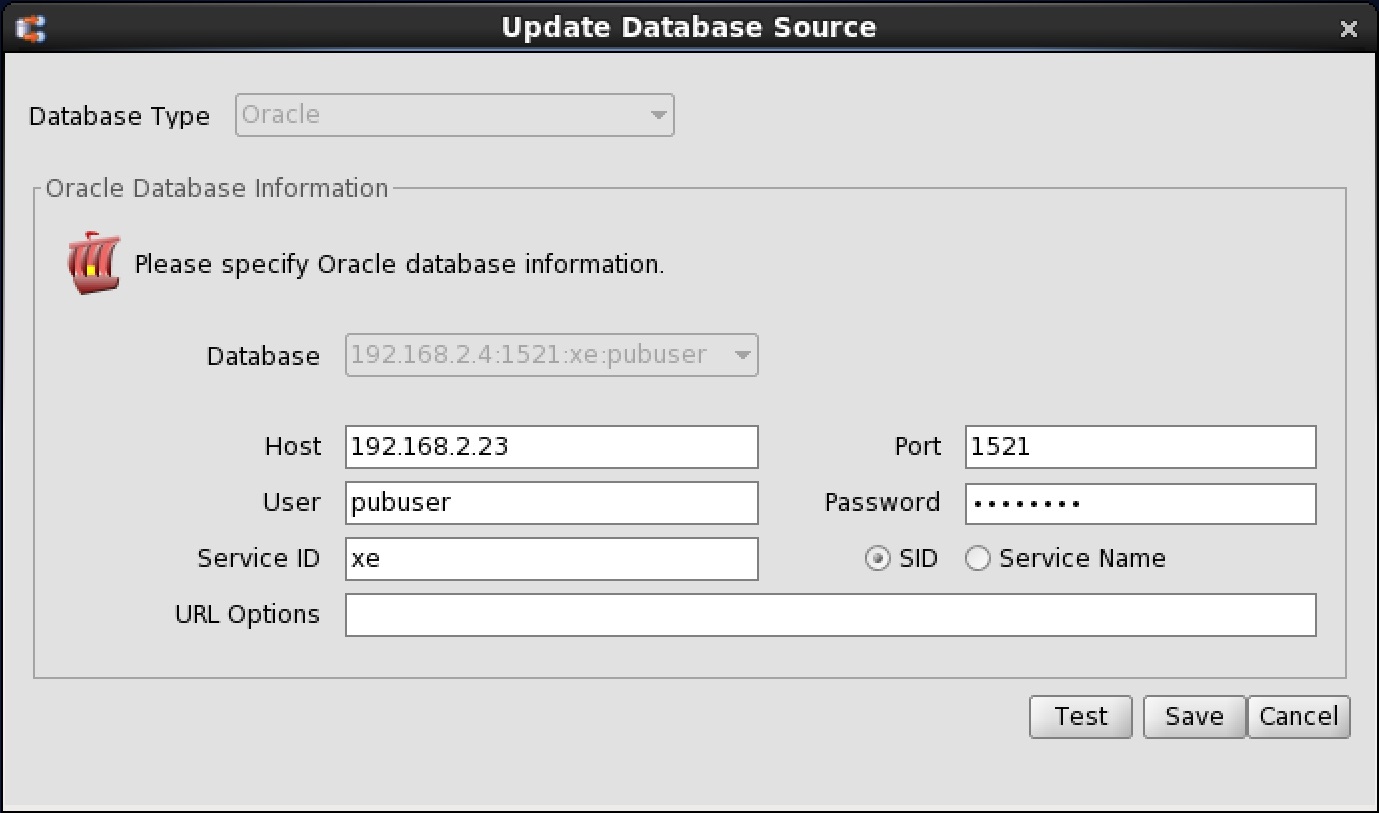
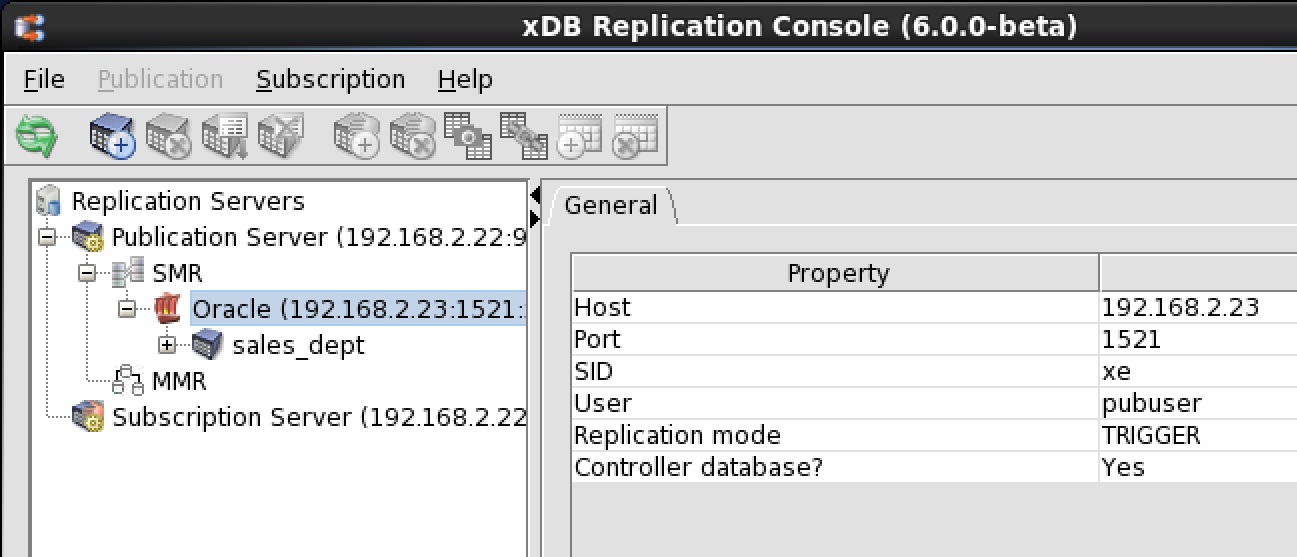
5.5 サブスクリプションの管理注:このセクションでは、レプリケーションシステムのサブスクリプションを管理するさまざまな側面について説明します。レプリケーションシステムのパブリケーションの管理に関する同様の説明については、セクション7.6を参照してください。xDBレプリケーションコンソールでサブスクリプションサーバーを登録するとき、実行しているコンピューターのサーバーログインファイルにサブスクリプションサーバーのネットワークの場所(IPアドレスとポート番号)、管理ユーザー名、および暗号化されたパスワードを保存することを選択できますxDBレプリケーションコンソール。ログイン情報の保存については、セクション 4.2を参照してください 。手順1:ファイルに変更を加える前に、サーバーログインファイルでログイン情報を保存、変更、または削除するサブスクリプションサーバーが実行されている必要があります。サブスクリプションサーバーの起動方法については、セクション5.3.1のステップ1を参照してください。ステップ2: Subscription Serverノードで2番目のマウスボタンをクリックし、Updateを選択します。 [サブスクリプションサーバーの更新]ダイアログボックスが表示されます。ステップ3:サーバーログインファイルを更新する目的に応じて、ダイアログボックスのフィールドに入力します。ステップ4: [更新]ボタンをクリックします。ダイアログボックスが閉じた場合、サーバーログインファイルの更新は成功しています。 xDB Replication Consoleツールバーの[更新]アイコンをクリックして、更新されたサブスクリプションサーバーノードを表示します。サブスクリプションデータベース定義を作成する場合、サブスクリプションサーバーによってアクセスされるコントロールスキーマに、サブスクリプションデータベースサーバーのネットワークの場所(IPアドレスとポート番号)、データベース識別子、データベースログインユーザー名、およびユーザーのパスワードを保存します。このログイン情報は、サブスクリプションデータベースとのセッションを確立する必要がある場合に使用されます。サブスクリプションデータベース定義の作成については、セクション 5.3.2を参照してください 。注:データベースのタイプ(Oracle、SQL Server、またはPostgres)に応じて、特定の属性を変更しないでください。すでにサブスクリプションを追加している場合、サブスクリプションテーブルが作成されたスキーマへのアクセスを変更する属性を変更しないでください。手順1:サブスクリプションデータベース定義として最終的に保存するデータベースサーバーが実行中であり、クライアント接続を受け入れていることを確認します。ステップ2:変更するサブスクリプションデータベース定義の親であるノードを持つサブスクリプションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。サブスクリプションサーバーの起動と登録の手順については、セクション5.3.1を参照してください。手順3:更新するサブスクリプションデータベース定義に対応するサブスクリプションデータベースノードを選択します。ステップ4: [サブスクリプション]メニューから[サブスクリプションデータベース]を選択し、[データベースの更新]を選択します。または、サブスクリプションデータベースノードで二次マウスボタンをクリックし、データベースの更新を選択します。 [データベースソースの更新]ダイアログボックスが表示されます。ステップ6: [テスト]ボタンをクリックします。テスト結果:成功が表示されたら、[OK]ボタンをクリックしてから、[保存]ボタンをクリックします。手順7: xDB Replication Consoleツールバーの[更新]アイコンをクリックして、更新されたサブスクリプションデータベースノードとそのサブスクリプションを表示します。5.5.3 Updating a Subscription手順1:変更するサブスクリプションの親であるノードを持つサブスクリプションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。サブスクリプションサーバーの起動と登録の手順については、セクション5.3.1を参照してください。手順2:属性を更新するサブスクリプションノードを選択します。ステップ3: [サブスクリプション]メニューから、[サブスクリプションの更新]を選択します。または、サブスクリプションノードでセカンダリマウスボタンをクリックし、サブスクリプションの更新を選択します。 [サブスクリプションの更新]ダイアログボックスが表示されます。ステップ4:現在、パブリケーションサーバーが、ダイアログボックスに表示されているものとは異なるIPアドレスまたはポート番号を持つホストで実行されている場合は、正しい情報を入力します。また、パブリケーションサーバーが実行されているホストにあるxDBレプリケーション構成ファイルに保存されている管理ユーザー名とパスワードを入力する必要があります。 [更新]ボタンをクリックします。手順5: [サブスクリプションが正常に更新されました]が表示されたら、[OK]ボタンをクリックします。それ以外の場合は、エラーを調査して必要な修正を行います。ステップ6:新しいネットワークロケーションを備えたパブリケーションサーバーが他のサブスクリプションによってサブスクライブされたパブリケーションを管理する場合、これらの他のサブスクリプションに対してステップ1〜5を繰り返します。テーブルフィルターは、サブスクリプションで有効にする前に、パブリケーションで使用可能なテーブルフィルターのセットで最初に定義する必要があります。シングルマスターレプリケーションシステムでのテーブルフィルターの定義については、セクション 5.2.3を参照してください 。手順1:変更するサブスクリプションに関連付けられたパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。変更するサブスクリプションの親であるノードを持つサブスクリプションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認してください。サブスクリプションサーバーの起動と登録の手順については、セクション5.3.1を参照してください。ステップ2:個々のフィルタールールを有効または無効にするサブスクリプションのサブスクリプションノードを選択します。手順3:次のいずれかの方法で[フィルタールール]タブを開きます。ステップ4: [フィルタールール]タブで、チェックボックスをオンまたはオフにして、サブスクリプションで有効または無効にするフィルタールールを指定します。任意のサブスクリプションテーブルで、最大1つのフィルタールールを有効にできます。 [更新]ボタンをクリックします。ステップ5:確認ボックスが表示され、フィルタリング基準を変更したサブスクリプションに対してスナップショットレプリケーションを実行するための警告メッセージと推奨事項が表示されます。手順6:前の手順で[OK]ボタンをクリックした場合、更新が成功した場合、フィルタールールが正常に更新されたことを示す確認メッセージが表示されます。手順7:フィルター条件が変更されたテーブルを含むサブスクリプションに対してスナップショットレプリケーションを実行することを強くお勧めします。スナップショットにより、サブスクリプションテーブルのコンテンツが更新されたフィルタリング基準と一致することが保証されます。スナップショットレプリケーションの実行については、セクション 5.4.1を参照してください 。5.5.5 Removing a Subscriptionサブスクリプションを削除しても、サブスクリプションデータベースのサブスクリプションテーブルは削除されません。これらのテーブルのIDとxDB Replication Serverへの関連付けが削除されるため、DBAが DROP TABLE SQLステートメントでDROP TABLE 削除するまで、テーブルはデータベースに残ります。手順1:削除するサブスクリプションの親ノードをノードとするサブスクリプションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。サブスクリプションサーバーの起動と登録の手順については、セクション5.3.1を参照してください。ステップ2:削除するサブスクリプションのサブスクリプションノードを選択します。ステップ3:次のいずれかの方法でサブスクリプションを削除します。ステップ4: [サブスクリプションの削除]確認ボックスで、[はい]ボタンをクリックします。xDB Replication Serverからサブスクリプションデータベース定義を削除することは、そのサブスクリプションデータベースノードを削除することと同等です。サブスクリプションデータベースノードを削除するには、そのサブスクリプションデータベースノードの下にあるすべてのサブスクリプションを削除する必要があります。サブスクリプションの削除については、セクション 5.5.5を参照してください 。手順1:削除するサブスクリプションデータベース定義の親であるノードを持つサブスクリプションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。サブスクリプションサーバーの起動と登録の手順については、セクション5.3.1を参照してください。手順2:削除するサブスクリプションデータベースノードを選択します。ステップ3: [サブスクリプション]メニューから、[サブスクリプションデータベース]、[データベースの削除]の順に選択します。または、[サブスクリプションデータベース]ノードでセカンダリマウスボタンをクリックし、[サブスクリプションの削除]を選択します。 [サブスクリプションデータベースの削除]確認ボックスが表示されます。ステップ4: [サブスクリプションデータベースの削除]確認ボックスで、[はい]ボタンをクリックします。
5.6 制御されたスイッチオーバーの実行制御されたスイッチオーバーとは、パブリケーションデータベースとサブスクリプションデータベースの間でロールを交換することです。つまり、以前はパブリケーションであったテーブルがサブスクリプションテーブルになります。以前のサブスクリプションテーブルがパブリケーションになりました。注:この説明では、同期レプリケーションのトリガーベースの方法がパブリケーションデータベースで使用されることを前提としています。パブリケーションデータベースがログベースの方法を採用している場合、パブリケーションデータベースの役割に切り替えたときに必要な場合、現在のサブスクリプションデータベースがログベースの方法を使用する基準を満たしているかどうかを判断する必要があります。サブスクリプションデータベースが基準を満たしていない場合は、トリガーベースの方法を実装して使用する必要があります。ログベースの方法と、ログベースの方法を使用する場合に実行する必要がある必要な構成手順については、セクション2.2.10を参照してください。また、xDB Replication Serverがレプリケーションの更新をキャプチャして保存するために使用する以前のサブスクリプションデータベースにデータベースオブジェクトを作成する必要があります。
• 特定のコントロールスキーマテーブルを更新して、パブリケーションデータベースとサブスクリプションデータベースの接続情報を交換します。 これらの更新は、すべてのパブリケーションデータベース間で制御スキーマの一貫性を確保するために、すべてのパブリケーションデータベースの制御スキーマで行う必要があります。
• 「ノード1」は、パブリケーションデータベースが最初に存在するサーバーです。そのネットワークIPアドレスは 192.168.2.19です。
• 「ノード2」は、サブスクリプションデータベースが最初に存在するサーバーです。そのネットワークIPアドレスは 192.168.2.20です。ステップ1:パブリケーションデータベースに対するすべてのトランザクション処理を停止します。手順2:オンデマンド同期レプリケーションまたはスナップショットレプリケーション(スナップショットのみのパブリケーションの場合)を実行して、パブリケーションデータベースシャドウテーブルの保留中の更新をサブスクリプションデータベースにレプリケートします。ステップ3:パブリケーションサーバーとサブスクリプションサーバーを停止します。ステップ4:セクション5.1の前提条件を確認して、サブスクリプションデータベースとそのホストがパブリケーションデータベースの役割で使用でき、パブリケーションデータベースとそのホストがサブスクリプションデータベースの役割で使用できることを確認します。
• pg_hba.confファイルに追加のエントリが必要になる場合があります。手順5:ノード1のパブリケーションデータベースからスキーマ_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerバックアップを作成します。手順6:ノード1のパブリケーションテーブルにレプリケーショントリガーとそれに対応するトリガー関数のバックアップを作成します。トリガーベースの方法では、これらのトリガーにはrrpd_ 、 rrpi_ 、およびrrpu_プレフィックスが付けられます。トリガー関数には同じプレフィックスが付けられます。ログベースの方法の場合、各テーブルのトリガーにはrrpt_プレフィックスが付きrrpt_ 。この関数の名前はcapturetruncateeventです。手順7:ノード2のサブスクリプションデータベースからスキーマ_edb_replicator_subバックアップを作成します。手順8:手順5で作成したスキーマ_edb_replicator_pub 、 _edb_replicator_sub 、および_edb_schedulerのバックアップをノード2のサブスクリプションデータベースに復元します。また、手順6で作成したレプリケーショントリガーとトリガー関数のバックアップをノード2のサブスクリプションデータベースに復元します。手順9:手順7で作成したスキーマ_edb_replicator_subのバックアップをノード1のパブリケーションデータベースに復元します。ステップ10:コントロールスキーマオブジェクトを更新して、パブリケーションデータベース定義がノード2の新しいパブリケーションデータベース(つまり、以前のサブスクリプションデータベース)を参照し、サブスクリプションデータベース定義が新しいサブスクリプションデータベース(つまり、以前のパブリケーションデータベース)を参照するようにしますノード1。
•
•
• たとえば、次の例では、パブリケーションデータベースの定義を更新して、ネットワークIPアドレスがノード2( 192.168.2.20 )になるようにします。ステップ11:新しいホストでパブリケーションサーバーまたはサブスクリプションサーバーを使用する場合は、次の手順を実行します。それ以外の場合は、手順12に進みます。手順12:ノード2で現在実行されている新しいパブリケーションデータベースのコントローラーデータベース接続と認証情報が含まれるように、パブリケーションサーバーとサブスクリプションサーバーホストのxDBレプリケーション構成ファイルを編集します。ステップ13:データベースサーバーのpg_hba.confファイルを更新して、セクション5.1.6.3に従ってノード1のサブスクリプションデータベースとノード2のパブリケーションデータベースにアクセスできるようにします。手順14:ログベースの方法を使用する場合、パブリケーションデータベースが含まれているデータベースサーバーにレプリケーションスロットを作成します。pg_drop_replication_slot関数が成功しない場合のレプリケーションスロットの削除に関する追加情報については、 10.3.4.4 項を参照してください 。データベースを元の役割に戻す場合、この手順で前述したように、パブリケーションデータベースサーバーにレプリケーションスロットを再作成するだけです。ステップ15:制御されたスイッチオーバーが完了しました。パブリケーションサーバーとサブスクリプションサーバーを起動します。ステップ16:パブリケーションテーブルがサブスクリプションテーブルと一致していることを確認した後、最初のレプリケーション操作はスナップショットである必要があります。スナップショットの実行後、同期レプリケーションが実行される場合があります。
5.7 フェイルオーバーの実行フェールオーバーとは、パブリケーションデータベースまたはそのホストで障害が発生した場合に、サブスクリプションデータベースによってパブリケーションデータベースを置き換えることです。フェールオーバーは元に戻せないアクションと見なされるため、サブスクリプションデータベースはパブリケーションデータベースの役割を永続的に引き継ぎます。
• パブリケーションデータベース上のコントロールスキーマオブジェクト(つまり、スキーマ _edb_replicator_pub 、 _edb_replicator_sub 、 _edb_scheduler 、およびそれらのオブジェクト)をバックアップから復旧または復元できない場合、フェイルオーバーの実行はEnterpriseDBテクニカルサポートサービスの支援が必要な場合にのみ可能です。
5.8 パフォーマンスの最適化パブリケーションサーバーとサブスクリプションサーバーの構成オプションは、それぞれパブリケーションサーバーとサブスクリプションサーバーの構成ファイルで設定されます。これらのファイルで構成オプションを設定する方法の詳細な説明については、 10.4.1 項を参照してください 。注:これらの構成オプションのほとんどは、マルチマスター複製システムにも適用できます。マルチマスターレプリケーションシステムに適用可能なオプションは、パブリケーションサーバーに適用されるオプションであり、Postgres以外のデータベース製品(Oracle機能など)に固有のものではありません。注:このセクションで説明するオプションは、パブリケーションサーバーにのみ適用され、特に指定がない限り、パブリケーションサーバーの構成ファイルで設定されます。copyViaDBLinkOraオプションがに設定されているtrue 、OracleデータベースのリンクAPI、 dblink_ora 、代わりにJDBCを使用したCOPYスナップショットレプリケーション中のOracleパブリケーションからAdvanced Serverのサブスクリプションテーブルを移入します。注: OracleデータベースリンクAPI機能はPostgreSQLでは使用できないため、 copyViaDBLinkOraオプションはPostgreSQLサブスクリプションテーブルには適用されません。注: dblink_oraをxDB Replication Serverで使用する前に、Advanced Serverで実行する必要のあるいくつかの構成手順があります。 Advanced Serverバージョン9.3以前の場合、 README-dblink_ora_setup.txtについてはPOSTGRES_INSTALL_HOME /doc/contribディレクトリにあるREADME-dblink_ora_setup.txt readmeテキストファイルを参照してください。 Advanced Serverバージョン9.4以降の場合、指示については、 『 Oracle開発者用データベース互換性ガイド』の dblink_oraの章を参照してください。デフォルト値は falseです。useFastCopyオプションを使用するには、ターゲットPostgresデータベースサーバーのpostgresql.confファイルの archive_mode構成パラメーターをオフにする必要があります(したがって、WALデータのアーカイブを無効にします)。デフォルト値は falseです。使用 cpBatchSize JDBCで使用されている(メガバイト)バッチサイズを設定するオプションCOPYスナップショット時の動作を。大きなパブリケーションテーブルの場合、このオプションの値を増やします。OracleまたはSQL Serverがサブスクリプションデータベースの場合、このオプションは効果がありません。 OracleまたはSQL Serverテーブルのロードを調整するには、 batchSizeオプションを変更します。batchSizeオプションコントロールの数INSERT JDBCバッチ内の文。OracleまたはSQL Serverがサブスクリプションデータベースである場合、これらのデータベースタイプのテーブルは INSERTステートメントのJDBCバッチを使用してロードされるため、このオプションは特に重要です。Postgresサブスクリプションデータベースの場合、テーブルはJDBC COPY を使用してロードされますが、何らかの理由でCOPY操作が失敗した場合、OracleおよびSQL Serverの場合のようにINSERTステートメントのJDBCバッチを使用してテーブルロードが再試行されます。Postgresサブスクリプションテーブルのロード後にANALYZEコマンドの実行をスキップする場合は、 skipAnalyzeオプションをtrue 設定します。 ANALYZEコマンドは、テーブルの内容に関する統計情報を収集します。これらの統計は、クエリプランナーによって使用されます。デフォルト値は falseです。注:このオプションをシングルマスターレプリケーションシステムに適用するには、サブスクリプションサーバー設定ファイル内でサブスクリプションサーバーに設定する必要があります。このオプションをマルチマスターレプリケーションシステムに適用するには、パブリケーションサーバー設定ファイル内でパブリケーションサーバーに設定する必要があります。snapshotParallelLoadCountオプションコントロールは、スレッドの数は、並列モードでスナップショットデータの複製を実行するために使用されます。デフォルトの動作では、単一のスレッドを使用します。ただし、ターゲットシステムアーキテクチャにマルチCPU /コアが含まれる場合、通常はCPU /コアカウントに等しい1より大きい値を指定して、システムリソースを完全に利用できます。デフォルト値は 1です。BYTEA 、 BLOB 、 CLOB などの大きなオブジェクトに通常使用されるデータ型の列がテーブルに含まれている場合、大量のデータ(数百メガバイト)が持ち込まれるためにヒープスペースエラーが発生する可能性が高くなります。メモリに。このエラーの可能性を最小限に抑えるために、スナップショットレプリケーションは、バッチごとに1つのINSERTステートメントを使用して、一度に1行ずつ、ラージオブジェクトデータ型を含むテーブルをロードします。ただし、ラージオブジェクトデータ型の列に比較的少量のデータが含まれていることがわかっている場合は、 lobBatchSizeオプションの値を増やして各行でより多くの行( n指定)を許可することで、スナップショットレプリケーションの速度を上げることができますバッチ。デフォルト値は 1です。注:このセクションで説明するオプションは、パブリケーションサーバーにのみ適用され、パブリケーションサーバーの構成ファイルで設定されます。5.8.2.1 Using Prepared SQL Statements同期レプリケーションが発生すると、シャドウテーブルに記録された変更がJDBCバッチ更新のサブスクリプションテーブルに適用されます。各バッチ内では、変更ごとに個別のSQLステートメントを使用して変更を適用できます。または、単一の準備されたSQLステートメントを使用して一連の変更を適用できます。 準備されたSQL文は解析され、一度だけコンパイルされ、それは各実行におけるSQL文の特定の構成要素に対して異なる値を使用して複数回実行することができるされています。準備されていないSQLステートメントは、一度だけ解析、コンパイル、および実行されます。準備されたステートメントは、同じタイプのSQLステートメント( INSERT 、 UPDATEまたはDELETE )が同じターゲットテーブルで異なる値で繰り返し連続して実行される場合にのみ役立ちます。同じテーブルに行のセットを挿入して同じ列にデータを挿入するなど、同じ操作を使用して同じテーブルに一連の連続した変更がある場合、パブリケーションサーバーは準備済みステートメントを使用してこれらの変更を適用できます。それ以外の場合、各変更は独自の個別のSQLステートメントで適用されます。defaultBatchUpdateModeデフォルトモードは、JDBCのバッチ更新(この動作モードは、BUSと呼ばれている)で、個々のSQL文を使用するか、JDBCのバッチ更新(この動作モードは以下のように呼ばれている中で準備されたSQLステートメントを使用するかどうかのオプションを制御しBUP )。デフォルト値は BUSです。switchBatchUpdateMode出版サーバは動的にトリガベースの方法または対数用チェンジストリームのシャドウテーブルに遭遇した更新の種類及び配列に応じ複製プロセス中にバスモードとBUPモードを切り替えるか否かのオプションコントロールベースの方法。デフォルト値は trueです。これは、 defaultBatchUpdateMode=BUSおよびswitchBatchUpdateMode=true のデフォルト設定を使用することを意味します。パブリケーションサーバーは、個々のSQLステートメントで更新を適用することから開始します。単一の準備済みステートメントですべて処理できる連続した変更のストリームに遭遇すると、準備済みSQLステートメントの使用に切り替わります。注:更新モードを切り替えずに、特定のパブリケーションサーバーによって適用されるすべての同期レプリケーション全体で特定のバッチ更新モードを使用する場合は、 switchBatchUpdateMode=falseと組み合わせてdefaultBatchUpdateModeオプションを目的のモードに設定しdefaultBatchUpdateMode 。たとえば、準備済みステートメントのみを使用する場合は、次のオプションを設定します。注: Oracleがサブスクリプションデータベースの場合、上記の2つのオプションが常に設定されているかのように、同期レプリケーションは常にBUPモードで発生します。これは、PostgresパブリケーションのTEXTデータ型の大きな列がOracle CLOB列に正常に複製できるためです。 BUSモードでは、個々のOracle SQLステートメントの文字列リテラルの最大長は4000文字です。この制限は、BUPモードで使用される準備済みSQLステートメントには発生しません。busBatchThresholdCountオプションは、パブリケーションサーバは、動的場合BUPモードへのバス・モードから切り替える前に、トリガーベースの方法またはログベースの方法のためのチェンジストリームのためのシャドーテーブルに遭遇しなければならない同じタイプの連続更新数を設定します切り替えが許可されます(つまりswitchBatchUpdateMode=true )。各ステートメントが複数の行に影響する多くのSQLステートメントを使用してパブリケーションへの変更が行われた場合、 busBatchThresholdCountを低くすると、パブリケーションの個々の変更の結果として生じる複数のシャドウテーブル行で準備されたステートメントの使用を促進することが有益な場合があります 。bupBatchThresholdCoun tオプションは、と組み合わせて使用されるbupBatchThresholdRepeatLimitモードの周波数を制御するためのオプションは、パブリケーションに予想される更新タイプの揮発性に基づいて切り替えます。同じ準備済みSQLステートメントが連続して実行されるたびに、内部「バッチ」カウンターが増分されます。このバッチカウントが 、指定された準備済みステートメントの実行回数に対してbupBatchThresholdCountを下回ると 、2番目の内部「繰り返し」カウンターが1つ増加します。繰り返しカウンターが最終的にbupBatchThresholdRepeatLimitに達すると、更新モードはBUPからBUSに切り替えられます。したがって、準備されたSQLステートメント( bupBatchThresholdRepeatLimit に対して測定される ) が頻繁に連続して変更され 、それぞれが少数回( bupBatchThresholdCountに対して測定される)実行される場合、実行モードは変更されずに個々のSQLステートメントに戻ります準備されたステートメント。次の例は、 bupBatchThresholdCountが3に設定され、 bupBatchThresholdRepeatLimitが4に設定されている場合の更新の処理を示しています 。この例で参照される「クエリドメイン」の変更は、異なるステートメントタイプ( INSERT 、 UPDATE 、またはDELETE )または異なるターゲットテーブルは次の更新で検出されるため、別の準備されたSQLステートメントを使用する必要があります。
1。
2。 この時点で、最初の2つの更新(テーブル empからdeptへの変更)後にクエリドメインが変更され、前の準備済みステートメント(2)の実行回数がbupBatchThresholdCount未満なので、繰り返しカウンターは1に設定されます。
7。 クエリドメインは再び変更されます(テーブル deptからemp 変更されます )が、今回は同じクエリドメイン(更新3から6)の実行回数(4)がbupBatchThresholdCountを超えるため、繰り返しカウンターが0にリセットされます。
8。
9。 クエリドメインが再び変更され( INSERTステートメントからUPDATEステートメント)、実行回数(2)がbupBatchThresholdCountよりbupBatchThresholdCountため、繰り返しカウンターが1にインクリメントされます。
10。
11。
12。
13。 クエリドメインは、更新10と11の間、更新11と12の間、および更新12と13の間で変更されます。この時点で、繰り返しカウンターは値4にさらに3回増加しました。これ bupBatchThresholdRepeatLimit 、 bupBatchThresholdRepeatLimit BUPモードからBUSモードに変更されます。5.8.2.2 Parallel Synchronization並列同期では、複数のスレッドを使用してトランザクションセットを並列に適用することにより、システムアーキテクチャのマルチCPUまたはコアを利用します。syncLoadThreadLimitオプションコントロールパラレル同期中にソース公開テーブルからの荷重データに使用されるスレッドの最大数。デフォルトのカウントは4です。ただし、ターゲットシステムアーキテクチャ(具体的には、マルチCPU /コア)に応じて、通常CPU /コアカウントに等しいカスタムカウントを指定して、システムリソースを最大限に活用することができます。デフォルト値は 4です。dataSyncThreadCountオプションコントロールは、スレッドの最大数は、パラレルモード(マルチマスタ複製システム用)(シングルマスタ複製システムのための)標的スレーブデータベースまたはターゲットマスターノードに同期複製中に増分変更を適用するために使用されます。デフォルトの動作( dataSyncThreadCountが0に設定されている場合)は、ターゲットノードと同じ数のスレッドを使用します。デフォルト値は 0です。targetDBQueryTimeoutターゲット・データベースのトランザクションのセットを適用するには、公開サーバによる試みは、ターゲットの一つ以上に別のアプリケーションによって取得したロックのために、データベースサーバ(通常によって中止される前に、オプションは、タイムアウト(ミリ秒)間隔を制御しますテーブル)。targetDBQueryTimeoutオプションは、10分にデフォルトのロック・タイムアウト値を設定します。トランザクションが中止されるまでの待ち時間を長くしたい場合は、10分のデフォルト値をより高い値に変更します。 targetDBQueryTimeoutオプションの使用をオフにする場合は、値を0に変更します。この場合、タイムアウト間隔はPostgresデータベースサーバーのstatement_timeout構成パラメーターの設定によって制御されます。targetDBQueryTimeout 値が targetDBQueryTimeout 、他のターゲットデータベース上の後続のトランザクションセットの処理が遅れます。トランザクションセットがブロックされると、次のトランザクションセットをロードできないためです。1)ロックが解除され、ブロックされたトランザクションセットを完了に適用できるまたは2) targetDBQueryTimeout間隔を超えています。したがって、たとえば、保留中のトランザクションセットが10個ある3ノードクラスターで、トランザクションセット1がロードされ、ノード2およびノード3への複製を開始すると仮定します。待機状態のこれらのテーブルの更新。トランザクションセット1のレプリケーションはノード3で完了するまで実行できますが、待機時間が targetDBQueryTimeout間隔を超えると、データベースサーバーはノード2のトランザクションセット1をキャンセルします。このトランザクションセットのノード2へのレプリケーションは、xDBレプリケーションで中止としてマークされますサーバーのメタデータ。デフォルト値は 600000です。syncBatchSizeオプションは、同期レプリケーションJDBCバッチ内のステートメントの数を制御します。syncFetchSizeオプションコントロールがどのように多くの行1つのネットワーク往復で、パブリケーションデータベースからフェッチされます。たとえば、保留中の行の変更が1000件ある場合、デフォルトのフェッチサイズには5回のデータベースラウンドトリップが必要です。 500のフェッチサイズを使用すると、2回の往復ですべての変更が取得されます。txSetMaxSizeオプションでは、単一のトランザクションのセットにグループ化することができるトランザクションの行の最大数を定義します。パブリケーションサーバーは、単一のトランザクションセットにグループ化された数のメモリ内の行をフェッチすることにより、変更をロードして処理します。パフォーマンステストを実行し、レプリケーション統計を分析する必要がある場合にのみ、 enablePerformanceStatsオプションをtrue 設定します。有効にすると、パブリケーションサーバーは、各マスターノードのパブリケーションテーブルに追加のトリガーを作成します。トリガーは、制御スキーマのmmr_transaction_historyテーブルに記録されるトランザクション統計を生成します。 パフォーマンスのオーバーヘッドを回避するために、本番環境ではこのオプションを無効にする必要があります。デフォルト値は falseです。
6.1 前提条件の手順レプリケーションの速度と効率は、パブリケーションサーバーに設定されたヒープメモリサイズの影響を受ける可能性があります。 xDBスタートアップ構成ファイルは、パブリケーションサーバーに割り当てられる最小および最大ヒープサイズを制御するパラメーターを設定します。このパラメーターの設定に関するガイドラインと情報については、セクション 5.1.1を参照してください 。特定のPostgresデータベースサーバーで実行されているマスターノードとログベースの同期レプリケーションの方法を使用する場合、そのような各Postgresデータベースサーバーの構成ファイル postgresql.confで次の構成パラメーター設定が必要です 。
•
• max_wal_senders。同時接続の最大数(つまり、同時に実行されているWAL送信プロセスの最大数)を指定します。少なくとも、ログベースの方法を使用するこのデータベースサーバー上のMMRマスターノードの数に設定します。さらに、SMRパブリケーションデータベースをこのデータベースサーバーで実行する場合は、ログベースの方法を使用するSMRパブリケーションデータベースの数も追加します。
• max_replication_slots。複製スロットの最大数を指定します。 MMRシステムをサポートするための最小値は、マルチマスターレプリケーションシステムのマスターノードの合計数に、このデータベースサーバーにあるマスターノードの数を掛けた値です。詳細については、セクション2.2.10.4を参照してください。さらに、SMRパブリケーションデータベースをこのデータベースサーバーで実行する場合は、ログベースの方法を使用するSMRパブリケーションデータベースの数も追加します。
• track_commit_timestamp。 on設定onます。この構成パラメーターは、バージョン9.5のPostgresデータベースサーバーにのみ適用されます。詳細については、セクション6.6.1を参照してください。さらに、 pg_hba.confファイルには、ログベースの方法を使用するマスターノードの各パブリケーションデータベースユーザーのエントリが必要です。このようなデータベースユーザーは、 pg_hba.confファイルにレプリケーションデータベースユーザーとして含める必要があります。追加情報については、セクション6.1.5を参照してください。
• データベースユーザーにはスーパーユーザー権限があります。マスター定義ノードが同期レプリケーション中に他のマスターノードから更新を受信すると、データベース構成パラメーター session_replication_roleがデータベースユーザーによって変更されるため、スーパーユーザー権限が必要です 。データベースユーザーは、 session_replication_roleを一時的にreplicaに変更して、パブリケーションテーブルのトリガーが起動しないようにします。このセッションの変更は、あるパブリケーションデータベースから別のパブリケーションデータベースへの制御スキーマの複製を伴うスナップショット操作でも発生します。
•
• マスター定義ノードのデータベースユーザー名は pubuserです。
•
•
• マスター定義ノードのデータベース名は edbです。ステップ1:マスター定義ノードのログインおよびスーパーユーザー特権を持つユーザー名を作成します。このユーザーは、レプリケーションプロセスと履歴を追跡、制御、および記録するためにマスター定義ノードで作成されるxDB Replication Serverメタデータデータベースオブジェクトの所有者になります。 xDB Replication Serverメタデータデータベースオブジェクトは、 _edb_replicator_pubというスキーマに作成されます。ステップ2(オプション):ユーザーがこのマスターノードにあるパブリケーションテーブルのデータにアクセスする場合、これらのテーブルにアクセスするために必要な特権を含む1つ以上の「グループ」ロールがあると便利です。パブリケーションテーブルに対して挿入、更新、または削除を実行するユーザーには、コントロールスキーマオブジェクトに対する特権も付与する必要があります。
• データベースユーザーにはスーパーユーザー権限があります。マスターノードが同期レプリケーション中に他のマスターノードから更新を受信すると、データベース構成パラメーター session_replication_roleがデータベースユーザーによって変更されるため、スーパーユーザー特権が必要です 。データベースユーザーは、 session_replication_roleを一時的にreplicaに変更して、パブリケーションテーブルのトリガーが起動しないようにします。このセッションの変更は、あるパブリケーションデータベースから別のパブリケーションデータベースへの制御スキーマの複製を伴うスナップショット操作でも発生します。
•
• 追加のマスターノードをマスター定義ノードとは異なるデータベースサーバーインスタンス(つまり、異なるホストまたはポート番号)に配置する場合、この追加のマスターノードには、同じデータベースユーザー名を使用する必要があります。パブリケーションサーバー構成オプション skipTablePrivilegesがデフォルト値のfalseからtrue変更されない限り、マスター定義ノード 。 skipTablePrivileges詳細は、 10.4.1.13項を参照してください。
• 2番目のマスターノードのデータベースユーザー名は mmruserです。
• 2番目のマスターノードのデータベース名は mmrnodeです。手順1:マスターノードのデータベースユーザー名を作成します。このユーザーは、レプリケーションプロセスと履歴を追跡、制御、記録するためにマスターノードで作成されるxDB Replication Serverメタデータデータベースオブジェクトの所有者になります。 xDB Replication Serverメタデータデータベースオブジェクトは、 _edb_replicator_pubというスキーマに作成されます。ステップ2:そのようなデータベースがまだ存在しない場合、マスターノードとして使用されるデータベースを作成します。Postgresデータベースサーバーは、ホストベースの認証ファイル pg_hba.conf使用して、データベースサーバー内のデータベースへのアクセスを制御します。マスターノードを含む各Postgresデータベースサーバーでpg_hba.confファイルを変更する必要があります。pg_hba.confファイルに必要な変更については、次のセクションで説明します。masternode_db 代わりに使用する値は、マスターノードとして使用するデータベースの名前です。 masternode_user代わりにmasternode_user値は、セクション6.1.3のステップ1またはセクション6.1.4のステップ1で作成したデータベースユーザー名です。データベースの使用して、マスターノードた場合 mmrnodeデータベースのユーザー名とmmruser 、データベースの場所とは別のホスト上で実行されているedb実行されている、 pg_hba.confデータベースとデータベース・サーバ上のファイルmmrnode次のようになります。前述の例では、データベース edbおよびmmrnodeがトリガーベースの同期レプリケーションの方法を使用していることを前提としています 。ログベースの方法を使用する場合、 pg_hba.confファイルには、 masternode_userおよびpub_ipaddr replicationに設定されたDATABASEフィールドを持つ追加エントリが含まれており、実行中のホスト上のパブリケーションサーバーからのレプリケーション接続が許可されます。Postgresアプリケーションメニューから[構成の再読み込み](エキスパート構成、[Advanced Server上の構成の再読み込み])を選択します。これにより、変更された pg_hba.confファイルが有効になります。
6.2 パブリケーションの作成手順1:マスター定義ノードのデータベースサーバーが実行され、クライアント接続を受け入れていることを確認します。ステップ2: Publication Serverノードの下のMMRタイプノードを選択します。 [出版物]メニューの[出版物データベース]を選択し、[データベースの追加]を選択します。または、MMRタイプノードで2番目のマウスボタンをクリックし、データベースの追加を選択します。パブリケーションサービス-データベースの追加ダイアログボックスが表示されます。ステップ3:次のフィールドに入力します。
• データベースの種類。マスター定義ノードにPostgreSQLまたはPostgres Plus Advanced Serverを選択します。 Advanced Server Oracle互換インストールの場合、Postgres Plus Advanced Serverオプションを選択します。 PostgreSQLまたはAdvanced Server PostgreSQL互換インストールの場合、PostgreSQLオプションを選択します。
• ホスト。マスター定義ノードが実行されているホストのIPアドレス。
• 港。マスター定義ノードが接続を待機しているポート。
• パスワード。データベースユーザーのパスワード。
• データベース。マスター定義ノードのデータベース名を入力します。
• URLオプション(SSL接続用)。 URLオプションを入力して、マスター定義ノードへのSSL接続を確立します。 SSL接続の使用については、セクション7.11を参照してください。
• 変更セットのロギング(Postgresの場合)。 [テーブルトリガー]を選択して、同期レプリケーションのトリガーベースの方法を使用します。同期レプリケーションのログベースの方法を使用するには、WAL Streamを選択します。トリガーベースの方法については、セクション2.2.9を参照してください。ログベースの方法については、セクション2.2.10を参照してください。
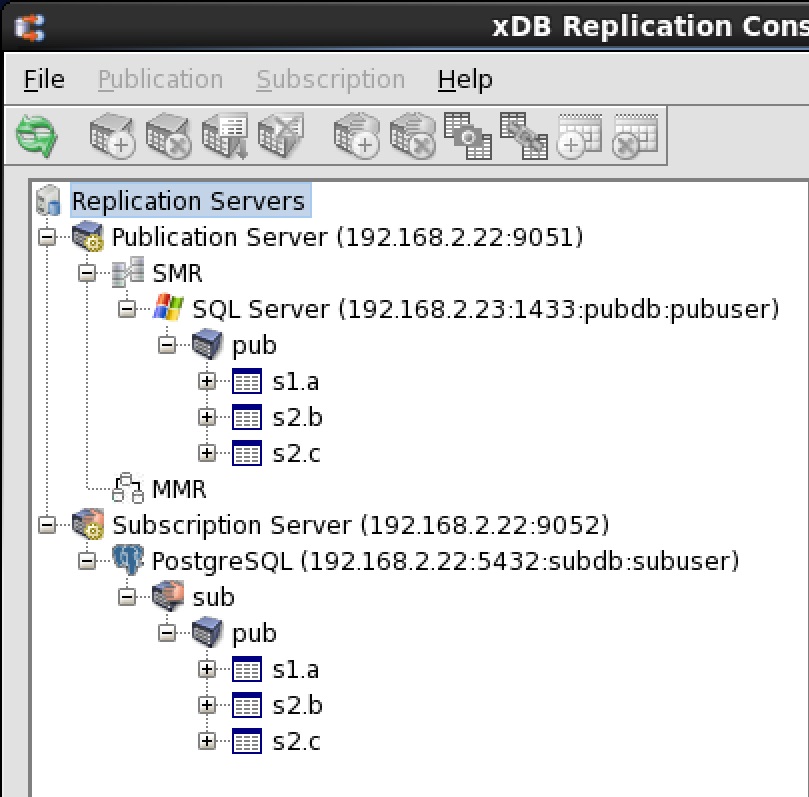
• ステップ4: [テスト]ボタンをクリックします。テスト結果:成功が表示されたら、[OK]ボタンをクリックしてから、[保存]ボタンをクリックします。6.2.3 Adding a Publicationステップ1:パブリケーションデータベースノードを選択します。 [出版物]メニューから[出版物の作成]を選択します。または、[パブリケーションデータベース]ノードで2番目のマウスボタンをクリックし、[パブリケーションの作成]を選択します。 [パブリケーションの作成]ダイアログボックスが表示されます。ステップ2: [パブリケーションの作成]タブの下の次のフィールドに入力します。
• 出版物名。すべての出版物の中で一意の名前を入力してください。
• パブリッシュ。パブリケーションに含めるテーブルの横にあるチェックボックスをオンにします。または、さらに、[ワイルドカード選択の使用]ボタンをクリックして、パブリケーションテーブルの選択にワイルドカードパターンマッチングを使用します。
• すべて選択。パブリケーションの[使用可能なテーブル]リストにすべてのテーブルを含める場合は、このボックスをオンにします。
• ワイルドカード選択を使用します。このボタンをクリックして、ワイルドカードセレクターを使用してパブリケーションのテーブルを選択します。ワイルドカードセレクタの詳細については、セクション7.1を参照してください。ステップ3(オプション): テーブルフィルターは、スナップショットまたは同期レプリケーション中にマスターノード間でレプリケートされる行の選択基準を制御するフィルタールールのセットで構成されます。フィルタルールは、 フィルタ名とSQLで構成されて句(省略さWHERE WHEREキーワード)を使用すると、レプリケーション中に含まれている行の選択基準を定義するテーブルに指定のフィルタ句を 、と呼ばれます。次の例では、フィルタルールは上で定義されている dept表これだけ行deptnoカラムが含まれている10 、 20 、または30の複製に含まれています。他のすべての行はレプリケーションから除外されます。以下は、 [テーブル/ビュー]ドロップダウンリストからedb.empを選択し、[フィルター]ダイアログボックスに10を含むdeptno行のみの選択基準を入力することにより、 empテーブルに追加されたルールを示しています。追加のマスターノードを作成する場合、追加のマスターノードの対応するテーブルでこれらのテーブルフィルターを選択的に有効にすることができます。追加のマスターノードの作成については、セクション 6.3を参照してください 。注:現在パブリケーションを作成しているマスター定義ノードでテーブルフィルターを有効にするには、まずマスター定義ノードの役割を別のマスターノードに切り替え(セクション6.10を参照)、次にセクション6.9の指示に従う必要があります。テーブルフィルターを有効にします。ステップ4(オプション):現在の競合解決オプションを変更または表示する場合は、[競合解決オプション]タブをクリックします。各テーブルについて、適切なボックスの上でマウスの主ボタンをクリックして、選択肢のドロップダウンリストを表示することにより、主な競合解決戦略とスタンバイ戦略を選択できます。[競合解消戦略]列からの選択で競合が解決されない場合、[スタンバイ競合解消戦略]列からの選択が適用されます。どちらの戦略も競合を解決しない場合、イベントは [競合履歴]タブで[ Pending ] としてマークされます。競合履歴の表示については、 6.7項を参照してください。
• 最も早いタイムスタンプ。最も早いタイムスタンプと競合する変更は受け入れられ、他のすべてのマスターノードに複製されます。その他の競合する変更はすべて破棄されます。
• 最新のタイムスタンプ。最新のタイムスタンプとの競合する変更は受け入れられ、他のすべてのマスターノードに複製されます。その他の競合する変更はすべて破棄されます。
• ノードの優先順位。最も優先度の高いマスターノードで発生する競合する変更は受け入れられ、他のすべてのマスターノードに複製されます。その他の競合する変更はすべて破棄されます。
• カスタム。更新/更新の競合は、PL / pgSQLカスタム競合処理プログラムで解決されます。
• マニュアル。競合は未解決のままです。競合する変更は、元の各マスターノードに適用されたままですが、他のマスターノードには複製されません。適切な調整は、各マスターノードに手動で適用する必要があります。手順5:更新/更新の競合が予想される場合は、競合が発生すると予想されるテーブルでREPLICA IDENTITYオプションをFULLに設定します。詳細については、セクション6.6.1を参照してください。ステップ6: [作成]ボタンをクリックします。 Publication Created Successfullyが表示されたら、[OK]ボタンをクリックします。それ以外の場合は、エラーを調査し、必要な修正を行います。
6.3 追加のマスターノードの作成手順1:マスター定義ノードのデータベースサーバーが実行され、クライアント接続を受け入れていることを確認します。ステップ2:マスター定義ノードを含む同じPublication Serverノードの下でMMRタイプのノードを選択します。 [出版物]メニューの[出版物データベース]を選択し、[データベースの追加]を選択します。または、MMRタイプノードで2番目のマウスボタンをクリックし、データベースの追加を選択します。パブリケーションサービス-データベースの追加ダイアログボックスが表示されます。ステップ3:次のフィールドに入力します。
• データベースの種類。マスターノードにPostgreSQLまたはPostgres Plus Advanced Serverを選択します。 Advanced Server Oracle互換インストールの場合、Postgres Plus Advanced Serverオプションを選択します。 PostgreSQLまたはAdvanced Server PostgreSQL互換インストールの場合、PostgreSQLオプションを選択します。
• ホスト。マスターノードが実行されているホストのIPアドレス。
• 港。マスターノードが接続を待機しているポート。
• パスワード。データベースユーザーのパスワード。
• データベース。マスターノードのデータベース名を入力します。
• URLオプション(SSL接続用)。 URLオプションを入力して、マスターノードへのSSL接続を確立します。 SSL接続の使用については、セクション7.11を参照してください。
• 変更セットのロギング(Postgresの場合)。この設定は、マスター定義ノードでの選択によって事前に決定されます(セクション6.2.2を参照)。テーブルトリガーは、同期レプリケーションのトリガーベースの方法用です。 WAL Streamは、同期レプリケーションのログベースの方法用です。トリガーベースの方法については、セクション2.2.9を参照してください。ログベースの方法については、セクション2.2.10を参照してください。
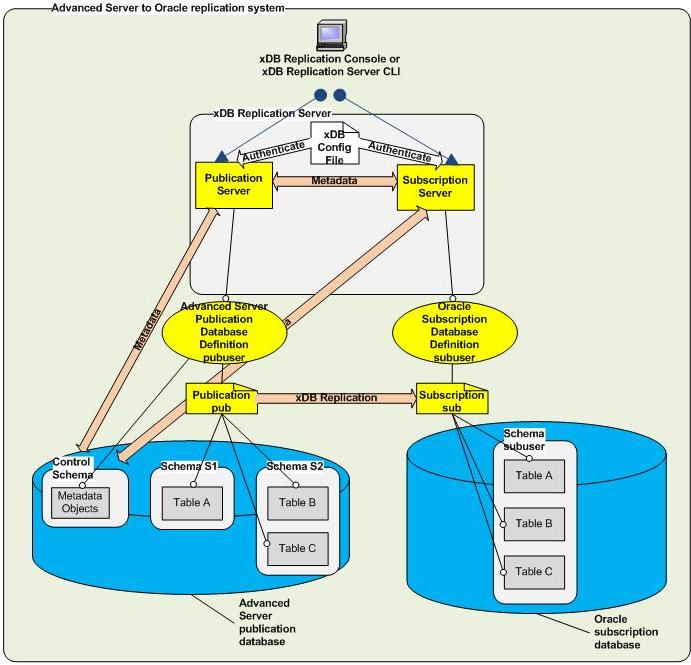
•
• パブリケーションスキーマを複製します。マスター定義ノードから定義をコピーして、パブリケーションサーバーで新しいマスターノードにパブリケーションテーブル定義を作成する場合は、このボックスをオンにします。このチェックボックスをオンにしない場合、マスターノードにテーブル定義がすでに作成されていると想定されます。オフラインスナップショット手法を使用してこのマスターノードを作成している場合は、このボックスをオンにしないでください。オフラインスナップショットの使用については、セクション7.9を参照してください。
• 初期スナップショットを実行します。 [保存]ボタンをクリックしたときに、パブリケーションサーバーでマスター定義ノードからこのマスターノードへのスナップショットを実行する場合は、このボックスをオンにします。このボックスをチェックしない場合、マスターノード上のテーブルは、後でレプリケーションを実行するまでロードされません。オフラインスナップショット手法を使用してこのマスターノードを作成している場合は、テーブル行を既にロードしている必要があります。したがって、データをリロードする場合を除き、このボックスをオンにしないでください。オフラインスナップショットの使用については、セクション7.9を参照してください。注:オフラインスナップショット手法(セクション7.9を参照)を使用する場合を除き、[初期スナップショットの実行]ボックスをオンにすることをお勧めします。最初のスナップショットレプリケーションは、オンデマンド(セクション6.5.2を参照)またはスケジュール(セクション7.2を参照)で同期レプリケーションを実行する前に、マスター定義ノードから他のすべてのマスターノードに実行する必要があります。新しく追加されたマスターノードで初期スナップショットが行われなかった場合、その後の同期レプリケーションでは、そのマスターノードへのトランザクションの適用に失敗する可能性があります。初期スナップショットは、オンデマンドスナップショットを実行して取得することもできます(セクション6.5.1を参照)。ステップ4: [テスト]ボタンをクリックします。テスト結果:成功が表示されたら、[OK]ボタンをクリックします。ステップ5(オプション):パブリケーションで使用可能なテーブルフィルターのセットを定義した場合、このマスターノードでこれらのフィルターを有効にするオプションがあります。テーブルフィルターの定義手順については、セクション6.2.3をご覧ください。このマスターノードに複製される行をフィルタリングしたくない場合は、手順6に進みます。ステップ6: [保存]ボタンをクリックしたときに、パブリケーションサーバーでマスター定義ノードからこのマスターノードへのスナップショットを実行する場合は、[初期スナップショットの実行]ボックスをオンにします。このボックスをチェックしない場合、マスターノード上のテーブルは、後でレプリケーションを実行するまでロードされません。オフラインスナップショット手法を使用してこのマスターノードを作成している場合は、テーブル行を既にロードしている必要があります。したがって、データをリロードする場合を除き、このボックスをオンにしないでください。オフラインスナップショットの使用については、セクション 7.9を参照してください 。マスター定義ノードとは異なり、ラベル MDNはレプリケーションツリーのノードの最後に表示されません。 [プロパティ]ウィンドウで[MDN]フィールドが[ Noに設定され、これがマスター定義ノードではないことを示します。手順7:更新/更新の競合が予想される場合、競合が発生すると予想されるテーブルでREPLICA IDENTITYオプションをFULLに設定します。詳細については、セクション6.6.1を参照してください。ステップ8(オプション):ユーザーがこのマスターノードにあるパブリケーションテーブルのデータにアクセスする場合、これらのテーブルにアクセスするために必要な特権を含む1つ以上の「グループ」ロールがあると便利です。トリガーベースの方法の場合、パブリケーションテーブルで挿入、更新、または削除を実行するユーザーに、コントロールスキーマオブジェクトに対する特権も付与する必要があります。ログベースの方法を使用する場合、ユーザーは特定の状況下でパブリケーションテーブルと特定のコントロールスキーマオブジェクトにアクセスする必要があります。
6.5 オンデマンドレプリケーションこのセクションでは、オンデマンドでレプリケーションを開始する手順について説明します。セクション 7.2では、スケジュールの作成方法について説明します。手順1:スナップショットレプリケーションを実行するマスターノードの下のパブリケーションノードを選択します。手順2:次のいずれかの方法で[スナップショット]ダイアログボックスを開きます。ステップ3:スナップショットの出力をダイアログボックスに表示する場合にのみ、[詳細出力]チェックボックスをオンにします。スナップショットからの大量の出力が[スナップショット]ダイアログボックスからの応答を遅延させる可能性があるため、ネットワークアドレス変換(NAT)環境ではこのオプションをオフのままにしておく必要があります。 [スナップショット]ボタンをクリックして、スナップショットの複製を開始します。ステップ4:スナップショットが成功した場合、「スナップショットの取得に成功しました」と表示されます。 OKボタンをクリックします。スナップショットが成功しなかった場合、[詳細出力]が選択されている場合は[スナップショット]ダイアログボックスウィンドウのメッセージをスクロールするか、ログファイルを確認します。各スナップショットのステータスメッセージは、 mtk.log[.という名前のMigration Toolkitログファイルに保存されますmtk.log[.次のディレクトリのn ] (ログファイルのローテーションが有効な場合、 [. n ]はオプションの履歴ファイル数です):POSTGRES_HOMEは、Windows postgresアカウント(Oracle互換構成モードでインストールされたAdvanced Serverのenterprisedbアカウント)のホームディレクトリです。 POSTGRES_HOMEの特定の場所は、Windowsのバージョンによって異なります。 xDB Replication Serverのバージョン番号はxで表され. x 。これで、パブリケーションがマスター定義ノードから選択したマスターノードに複製されました。スナップショットの記録は、レプリケーション履歴に保持されます。レプリケーション履歴を表示する方法については、セクション 7.4を参照してください 。注:マスター定義ノードからマルチマスター複製システム内の他のすべてのマスターノードへの初期スナップショット複製が実行されていることを確認してください。新しく追加されたマスターノードで初期スナップショットが行われなかった場合、その後の同期レプリケーションでは、そのマスターノードへのトランザクションの適用に失敗する可能性があります。最初のスナップショットは、マスターノードが最初に追加されたときに(セクション6.3を参照)、またはオンデマンドスナップショットを実行して(セクション6.5.1を参照)取得できます。異なるノードでの変更により競合が発生する場合があります。セクション 6.6では、発生する可能性のある競合の種類と、その解決方法について説明します。ステップ1:マスターノードの下のパブリケーションノードを選択します。選択されたマスターノードに関係なく、同期は複製システム内のすべてのマスターノードペアに適用されます。手順2:次のいずれかの方法で[同期]ダイアログボックスを開きます。手順3: [同期]ボタンをクリックして、同期レプリケーションを開始します。ステップ4:同期が成功した場合、パブリケーションが正常に同期されたことが表示されます。 OKボタンをクリックします。同期が成功しなかった場合は、エラーメッセージが表示されます。
6.6 紛争解決競合の解決では、発生する可能性のある競合の種類、競合に対処するための戦略、およびそのような競合を自動的に解決するために利用可能なオプションを扱います。
• track_commit_timestamp。マスターノードを含むPostgres 9.5データベースサーバーでは、 track_commit_timestamp構成パラメーターを有効にする必要があります。 track_commit_timestampパラメーターはpostgresql.confファイルにあります。 track_commit_timestampが有効になっていない場合、競合するトランザクションの最も早いタイムスタンプを使用するなどして、更新/更新の競合は自動的に解決されません。その結果、これらの競合するトランザクションは保留状態のままになります。更新/更新の競合が自動的に解決される方法の例については、セクション6.6.7を参照してください。
• REPLICA IDENTITY FULL。特定のパブリケーションテーブルで更新/更新の競合が発生することが予想される場合、すべてのマスターノードでテーブルのREPLICA IDENTITY設定をFULLに設定する必要があります。更新トランザクションが別々のマスターノードで発生するが、同じ行の異なる列を更新する場合は、更新/更新の競合とは見なされません。ただし、 REPLICA IDENTITYがFULLに設定されていない場合、このケースは更新/更新の競合として記録されます。REPLICA IDENTITYオプションがに設定されているFULL使用してALTER TABLE以下で示すようにコマンドを:REPLICA IDENTITY設定は、使用してPSQLユーティリティで表示することができます\d+コマンドを:注:競合解決の要件に加えて、xDB Replication Serverの他の理由により、パブリケーションテーブルでREPLICA IDENTITY FULL設定が必要になる場合があります。追加の要件については、セクション2.2.12.3を参照してください。6.6.2 Conflict Types
• 一意性の競合。 2つ以上のマスターノードで挿入トランザクションのプライマリキーまたは一意の列に同じ値が使用されると、一意性の競合が発生します。これは、 挿入/挿入の競合とも呼ばれます。
• 更新の競合。更新トランザクションは、2つ以上のマスターノードの同じ行の列値を変更します。たとえば、従業員の住所列はマスターノードAで更新され、別のユーザーはマスターノードBで同じ従業員の住所列を更新します。各ノードでトランザクションが発生するタイムスタンプは異なる場合がありますが、両方のトランザクションは同期がまだ行われていない時間間隔。したがって、同期が行われると、競合する両方のトランザクションが適用されます。これは、 更新/更新の競合とも呼ばれます。
• 競合を削除します。行はターゲットノードで既に削除されているため、ソースノードの更新トランザクションに対応する行はターゲットノードで見つかりません。これは、 更新/削除の競合と呼ばれます。逆に、ソースノードに削除トランザクションがあり、ターゲットノードの同じ行に更新トランザクションがある場合、このケースは削除/更新の競合と呼ばれます。最後に、ソースノードの削除トランザクションに対応する行がターゲットノードで見つからない場合、その行はターゲットノードで既に削除されているため、 削除/削除の競合と呼ばれます。
id = 2, address = 'ADDR B1' id = 2, address = 'ADDR B2'
id = 2, address = 'ADDR B1' 6.6.3 Conflict Detection
• 競合するトランザクションの場合、レプリケーションサーバーは、特定のテーブルに対して競合解決戦略が選択されているかどうかを確認します。戦略が見つかった場合、それに応じて戦略が適用され、競合状態は 解決済み としてマークさ れます。戦略を適用できない場合、競合ステータスは未解決としてマークされます ( 保留中とも呼ばれます )。
• 競合が検出されない場合、トランザクションの変更はターゲットマスターノードに複製され、そのターゲットノードのトランザクションステータスは、ソースマスターノードコントロールスキーマで完了 としてマークされます。各ターゲットマスターノードのトランザクションステータスマッピングは、すべてのマスターノードで維持されます。たとえば、ノードAにはステータスの2つのマッピングが含まれています。1つはノードB、もう1つはノードCです。
• 最も早いタイムスタンプ。最も早いタイムスタンプオプションを選択すると、ソースおよびターゲットマスターノードからの更新の競合に関連する関連行が、特定のノードで更新が発生したときのタイムスタンプに基づいて比較されます。最も早く発生した行の変更が適用されます。後のタイムスタンプを持つ行の変更は破棄されます。
• 最新のタイムスタンプ。最新のタイムスタンプによる行の変更が受け入れられることを除いて、最も早いタイムスタンプと同じアプローチ。以前のタイムスタンプを持つ行の変更は破棄されます。
• ノードの優先順位。ノードの優先度が最も高いマスターノードの行の変更が適用され、優先度の低いマスターノードの変更は破棄されます。ノードの優先度レベルは、1〜10の範囲の整数です。1が最高の優先度レベルで、10が最低の優先度レベルです。
•
• ノード固有のシーケンス範囲。シーケンス範囲は、各マスターノード用に予約されています。たとえば、マスターノードAにはMINVALUE = 1およびMAXVALUE = 1000 、マスターノードBにはMINVALUE = 1001およびMAXVALUE = 2000などがあり、他のノードについても同様です。これにより、すべてのマスターノードにわたって一意のIDが常に生成されます。
•
• 共通のシーケンス。すべてのノードは共通のシーケンスオブジェクトを共有しますが、これには各ID生成に関連するネットワークラウンドトリップのためにトランザクション処理が遅くなるという大きな欠点があります。
• MMR対応シーケンス。これは、シーケンスの使用を強化する手法であり、マルチマスターレプリケーションシステムに固有の分散マルチデータベースアーキテクチャにより柔軟で信頼性の高いアプローチを提供します。このアプローチは、前述のシーケンス手法よりも推奨されます。 MMR対応シーケンスについては、セクション6.6.6を参照してください。
マルチマスターレプリケーションシステムで一意性の競合を防ぐために、 MMR対応シーケンスを使用して、固有の一意の識別子を持たないパブリケーションテーブルの各行に一意の識別子を生成できます。MMR対応シーケンスには、 BIGINTデータ型、整数値を返す関数とシーケンスが組み込まれています。これらの値は、各マスターノードにユーザーが割り当てた一意のデータベース識別子と、そのマスターノード内で生成されたシーケンスを組み合わせます。
• 一意性。一意のデータベース識別子とシーケンスの組み合わせにより、特定のテーブルの各行がすべてのマスターノードで一意の値を持つようになります。
• クラスター化インデックスのサポート。 MMR対応シーケンスは、検索効率を提供するクラスター化インデックスの使用を損なわない。 MMR対応のシーケンス値は、Universally Unique Identifier(UUID)が使用された場合などのランダムな値としてではなく、典型的な順序付けられたシーケンスで返されます。
• 効果的な移行サポート。シーケンスをすでに利用しているテーブルは、既存の主キーと外部キーへの影響を最小限に抑えながら、MMR対応のシーケンスを使用するように変更できます。
• 信頼性と保守性。要約すると、MMR対応シーケンスは、一意性の競合を回避するための信頼性が高く保守可能な方法を提供します。6.6.6.1 Creating an MMR-Ready Sequence手順1:一意のデータベース識別子を1〜1024の整数として割り当てます。したがって、MMR対応シーケンスを備えたマルチマスター複製システムでは、最大1024個のデータベースを一意に識別できます。cluster.unique_db_idを db_idます。手順2:データベース内の各テーブル行を一意に識別するシーケンスを作成します。MMR対応シーケンスを使用するパブリケーションテーブル列には 、関数呼び出しでシーケンス名を参照する DEFAULT句が含まれます。パブリケーションテーブル定義は、関数呼び出しで同じシーケンス名を参照することにより、すべてのマスターノードで一貫している必要があります。手順3:行がテーブルに挿入されたときに次のMMR対応シーケンス値を返す次の関数を作成します。この関数は、パブリケーションテーブル列のDEFAULT句によって参照されます。この関数は 、データベース識別子( cluster.unique_db_id )に対してビット単位の左シフト操作( << 52 )を実行するため、数値が大幅に増加します。次に、次のシーケンス値がこの番号に追加されます。したがって、特定のデータベースのテーブルに挿入されたすべての行は、シフトされたデータベース識別子の値によって決定される数値範囲内に収まります。ステップ4(オプション):次の関数を作成して、現在のMMR対応シーケンス値を取得します。mmr_sequence_nextval機能を呼び出す前に、現在のセッションで起動する必要がありますmmr_sequence_currval機能を。ステップ5: MMR対応シーケンスを使用するパブリケーションテーブル列を追加または変更します。列のデータ型はBIGINT必要があります。 mmr_sequence_nextval関数は、列id次の例に示すように、 DEFAULT句で指定されます。CREATE TABLE table_name (デフォルトmmr_sequence_nextval( ' seq_name ')、手順6:マスターノードとして追加する他のデータベースに対して手順1〜4を繰り返します。パブリケーションテーブルの定義はセクション 6.3で 説明されているように作成されるときに、マスター定義ノードから追加のマスターノードに複製されるため、追加のマスターノードのステップ5は省略されます 。6.6.6.2 MMR-Ready Sequence Example以下は、MMR対応シーケンスを使用した3マスターノードシステムの例です。マスターノードとして使用されるデータベースは、 mmrnode_a 、 mmrnode_b 、およびmmrnode_cです。 mmr_seq_tblという名前のパブリケーションテーブルは、MMR対応シーケンスを使用します。上 mmrnode_bとmmrnode_c 、設定パラメータごとに異なる設定を作成するためのコマンドcluster.unique_db_idシーケンスと関数を作成するためのコマンドと同様に実行されています。マルチマスター複製システムは、追加のマスターノード mmrnode_bおよびmmrnode_c 作成するときに、パブリケーションスキーマの複製オプションと初期スナップショットの実行オプションを選択して作成されます 。結果のマスターノードは、xDBレプリケーションコンソールに表示されます。 id列のDefault Valueプロパティは mmr_sequence_nextval関数を使用することに注意してください 。mmrnode_b 同じクエリを実行すると、同じ行セットが表示されます。SERIALデータ型などの標準シーケンスを使用するテーブルを持つ既存のアプリケーションがある場合 、これらのテーブルを変更して、MMR対応シーケンスを使用してマルチマスター複製システムに組み込むことができます。
• 関数の入力引数と戻り引数はデータ型 BIGINTため、関数を使用する前に既存のシーケンス列を適宜変更する必要があります。最後に、今後の挿入のためにMMR対応シーケンス値を提供するために、シーケンス列に BIGINT NOT NULL DEFAULT mmr_sequence_nextval(' seq_name ') 句を含める必要があります 。変換を実行する前に、MMR対応シーケンスに変換されるシーケンスの現在の最大シーケンス値を取得します。この例では、値はテーブルmmr_seq_child_tbl id列に見られるように6 mmr_seq_child_tbl 。列 mmr_seq_tbl.id 、 mmr_seq_child_tbl.id 、およびmmr_seq_child_tbl.parent_idの既存のシーケンス値を変換するには 、次の手順を実行します。主キー id値には古いシーケンス値が組み込まれていますが、52ビットシフトされたデータベース識別子値の追加により増加しています。変換されたテーブルを含むデータベース mmrnode_a場合、既存の行との主キーの一意性の競合を回避するために、開始値7で新しいシーケンスが作成されます。元のテーブルでは、最大使用シーケンス値は6でした。mmrnode_c に対してプロセスを繰り返します 。マルチマスターレプリケーションシステムは 、セクション6.6.6.2で説明されているのと同様の方法で、 データベース mmrnode_a 、 mmrnode_b 、およびmmrnode_c を使用して作成されます 。
id = 2, address = 'ADDR A' id = 2, address = 'ADDR C' id = 2, address = 'ADDR A' Synchronization pushes Node A changes to Node C. Current address on Node C <> old value on Node A ( 'ADDR C' <> 'ADDR' ) hence conflict detected. Latest change on Node C accepted and Node A change discarded. id = 2, address = 'ADDR C' id = 2, address = 'ADDR C' id = 2, address = 'ADDR C' ただし、 2番目のマスターノードの列 dname の値は LOGISTICS設定されたままです。競合する列で通常予想されるように、マスター定義ノードから値OPERATIONSに戻されませんでした。予想どおり、 loc列の値はCAMBRIDGEからBEDFORDマスター定義ノード値に戻されることに注意してください。6.6.8 Custom Conflict Handling同じ同期で複数のマスターノードで更新された列は、 競合 する列と見なされます。競合する更新トランザクションで列の新しい更新された値が同一であっても、同じ列が複数のマスターノードで更新されたという事実により、競合する列になります。
• 列はソースノードに設定されます。関数のresolution_codeパラメーターが1値に設定されている場合、競合する両方のノードのすべての列の結果の設定は、レプリケーションのソースノードから取得されます。
• 列はターゲットノードに設定されます。関数のresolution_codeパラメータの値が2設定されている場合、競合する両方のノードのすべての列の結果の設定は、レプリケーションのターゲットノードから取得されます。
• 関数ロジックは列を設定します。関数のresolution_codeパラメーターが値3設定されている場合、最初の競合する列の結果の設定は、関数ロジック内でコーディングされたsourceパラメーターで返された値から取得されます。他のすべての列値の結果の設定は、レプリケーションのソースノードから取得されます。マルチマスター複製システムが同期複製のログベースの方法で構成されている場合、 INOUT sourceおよびIN targetパラメータのシャドウテーブルは 、次のように実際のパブリケーションテーブルに置き換えられます:この例では、最初の競合する列(テーブル内の列の順序に基づく)のみが、関数でコーディングされた値に設定されます。 sourceパラメーターへの他のすべての割り当ては無視されます。これらの他の列は、ソースノードに設定されます。競合を解決するマスター定義ノードのスキーマ_edb_replicator_pub内のシャドウテーブルのレコードタイプのINOUTパラメーター。同期レプリケーションのログベースの方法を使用する場合は、シャドウテーブルではなく実際のパブリケーションテーブルを指定します。入力値は、ソースノードからの列値です。 resolution_codeの値が3に設定されている場合、このパラメーターの列を最終結果に使用される値に設定します。競合を解決するマスター定義ノードのスキーマ_edb_replicator_pub内のシャドウテーブルのレコードタイプのINパラメーター。同期レプリケーションのログベースの方法を使用する場合は、シャドウテーブルではなく実際のパブリケーションテーブルを指定します。入力値は、ターゲットノードからの列値です。更新/更新の競合が発生した列の名前を含む、タイプVARCHAR(255) INパラメーター。複数の列が競合に関係している場合、最初の競合する列の名前が返されます。パブリケーションサーバーのログファイルに書き込まれる情報メッセージを含む、タイプVARCHAR(255) OUTパラメーター。メッセージをパブリケーションサーバーのログファイルに表示するには、パブリケーションサーバーの構成オプションlogging.levelを少なくともINFOレベルに設定する必要があります。パブリケーションサーバーのログファイルの場所については、セクション3.5を参照してください。競合の解決方法を決定するために次の値のいずれかに設定する、タイプINTEGER OUTパラメーター: 1は最終結果にレプリケーションのソースノードの列値を使用し、 2はターゲットノードの列値を使用します最終結果のレプリケーションの3 、または最初の競合する列のsource INOUTパラメーターに設定された値をその列の最終結果として使用する場合は3ステップ2:関数をマスター定義ノードに追加します。次の例は、PSQLを使用した関数の追加を示しています。手順3:次のいずれかの方法で[競合解決オプション]タブを開きます。ステップ4:カスタム競合処理を使用するテーブルで、適切なドロップダウンリストから[カスタム]を選択します。 [カスタムハンドラー]テキストボックスに、 CREATE FUNCTIONステートメントで使用されるスキーマと関数名を入力します。手順5: [更新]ボタンをクリックし、[競合解決オプションが正常に更新されました]確認メッセージへの応答として[OK]をクリックします。注:マルチマスター複製システムがカスタム競合処理を使用し、その後マスター定義ノードの役割を別のマスターノードに切り替える場合、新しいマスター定義ノードに機能を再追加する必要があります。つまり、新しいマスター定義ノードで手順2を繰り返す必要があります。注:マルチマスターレプリケーションシステムを削除する場合は、パブリケーションを削除する前に、マスター定義ノードからすべてのカスタム競合処理機能を削除する必要があります。次の例は、セクション6.6.8.1に示すcustom_conflict_dept という名前のカスタム競合処理関数を使用したカスタム競合処理の効果を示しています 。この関数は、 deptテーブルでの更新/更新の競合の勝者としてターゲットノードを設定します。次の例は、セクション6.6.8.1に示すcustom_conflict_emp という名前のカスタム競合処理関数を使用したカスタム競合処理の効果を示しています 。この関数は、関数でコード化された値を、 empテーブルでの更新/更新の競合の勝者として設定します。同期複製後、マスターノード edbには、競合する行について次の値が含まれます。同期複製後、マスターノード mmrnodeには、競合する行について次の値が含まれます。注:このカスタム競合処理関数は、実際のパブリケーションテーブルではなくシャドウテーブルの列である列(この例ではrrep_old_quantity )を使用するため、この特定のソリューションは、ログベースの同期方法を使用したパブリケーションには使用できませんレプリケーション。更新トランザクションの場合、シャドー表には、更新がパブリケーション表で行われる前の列値( rrep_old_ column_name という名前の列 )および更新が適用された後の値(パブリケーション表の列名と同じ名前の列)が含まれます。注:このセクションの手動の競合解決の説明は、同期レプリケーションのトリガーベースの方法で構成されたマルチマスターレプリケーションシステムにのみ適用されます。ログベースの同期レプリケーション方式で構成されたマルチマスターレプリケーションシステムの手動の競合解決については、セクション6.6.10を参照してください。セクション 6.6.5で説明したように 、一意性(挿入/挿入)の競合に対する組み込みの自動競合解決戦略はありません。一意性の競合が発生した場合は、競合を含むパブリケーションテーブルの行を変更し、マスターノードのコントロールスキーマテーブルの行を変更して競合を解決する必要があります。同様に、更新/削除および削除/更新の競合には、手動修正を使用する必要があります。さらに、競合解決オプションが手動に設定され(セクション 6.8を 参照 )、競合が発生した場合、この競合も手動で解決する必要があります。
• 競合を見つける。未解決の競合を見つける
• 紛争解決の準備。手動の競合解決プロセスを支援する便利なセットアップ手順
• 修正戦略の概要。修正を実行するために使用できる方法の概要
• マニュアル公開表の修正。出版物テーブルの手動修正
• 新しいトランザクションを使用した修正。新しいトランザクションを使用して、すべてのマスターノードを一貫した状態にする
• シャドウテーブルトランザクションを使用した修正。既存のシャドウテーブルトランザクションを使用して、すべてのマスターノードを一貫した状態にする6.6.9.1 Finding Conflicts6.6.9.2 Conflict Resolution Preparationパブリケーションテーブルの行を変更するセッション中に、パブリケーションテーブルのトリガーが起動しないようにするには、データベースサーバー構成パラメーター session_replication_roleの値をreplica設定する必要があります。 ( session_replication_roleのデフォルト設定はoriginです。この場合、トリガーが起動します。)replica設定を確実に有効にするための推奨方法は、このパラメーターのreplicaデフォルトセッション設定でデータベースユーザーを作成することです。このデータベースユーザーを使用してデータベースに接続すると、このセッション中にreplica設定が有効になります。したがって、競合が発生したことを発見したら、パブリケーションサーバーを停止することを強くお勧めします。セクション5.2.1のステップ1で説明されているLinuxスクリプトまたはWindowsサービスのstopオプションを使用します。
• シャドウテーブル内のどの保留中のトランザクションが、すべてのマスターノードのパブリケーションテーブルに適用されていないか。保留中のトランザクションは 、シャドウテーブルのrrep_tx_conflict_status列の値 Pで示されます。
• パブリケーションテーブルでどのトランザクションが発生し、最初の競合の後にシャドウテーブルに記録されるか、およびこれらのトランザクションがすべてのマスターノードのパブリケーションテーブルに完全かつ正しく適用されたかどうか。これらのトランザクションは、保留中としてマークされない場合があります。代わりに、 rrep_tx_conflict_status列をnullに設定できます。これは、レプリケーション中に特定の競合が検出されなかったこと、またはトランザクションがまだレプリケートされていないことを意味します。これらのトランザクションは、初期競合の原因となっているトランザクションよりもrrep_tx_timestamp値が遅いため、識別できます。手順1:すべてのマスターノードのパブリケーションテーブルの行に必要な手動修正を加えて、各パブリケーションテーブルがマスターノード全体で同じ行の同じセットを持つように、それらを初期の一貫した状態にします。これは、競合を完全に解決するための最も簡単な措置と判断した内容によっては、競合するトランザクションが発生する前の状態になる場合があります。ステップ2:トランザクションを(アプリケーションまたはシャドウテーブルから)適用または再適用して、シャドウテーブルに記録されたものの期待される期待される結果に従って、すべてのマスターノードのすべてのパブリケーションテーブルが一貫して更新されるようにします。手順3:シャドウテーブルで、競合するエントリの特定のインジケータを更新して、手順2で解決されたことを示します。手順4:コントロールスキーマで、競合するエントリの特定のインジケーターを更新して、これらの競合が解決されたことを示します。この更新により、[競合履歴]タブでこれらのエントリの解決ステータスが[ Resolved ]に変更されます。これらのエントリは、 6.6.9.1項で説明されているSQL問合せには表示されなくなります。コントローラデータベースの制御スキーマに手順4の更新を実行します。現在指定されているコントローラーデータベースは、xDBレプリケーション構成ファイルの内容から決定できます(セクション 2.3.1.3を 参照 )。パブリケーションサーバーは、コントローラーデータベースで行われたコントロールスキーマの変更がすべてのパブリケーションデータベースのコントロールスキーマに確実に複製され、すべてのパブリケーションデータベース間でメタデータの一貫性を維持します。ステップ5:複製システムの操作を再開します。パブリケーションサーバーを起動し、レプリケーションスケジュールを使用している場合は再作成します。
• マニュアル公開表の修正。 PSQLやpgAdmin(Advanced ServerのPostgres Enterprise Manager Client)などのユーティリティを使用して、これらの変更を複製せずに、すべてのマスターノードのパブリケーションテーブルの行を手動で修正します。この目的のために、 session_replication_roleをreplicaに設定したデータベースユーザーを使用します。
• 新しいトランザクションを使用した修正。 1つのマスターノードでアプリケーションを再実行して、他のすべてのマスターノードに複製できる新しいトランザクションを作成します。すべてのパブリケーションテーブルがすべてのマスターノードで一貫した状態にあることを確認してから、このメソッドを使用します。
• シャドウテーブルトランザクションを使用した修正。シャドウテーブルに既に記録されているトランザクションの同期を強制します。適用する必要があるシャドウテーブルトランザクションが多数あり、アプリケーションからトランザクションを再発行するよりも、これらのトランザクションの同期を強制する方が簡単な場合は、この方法を使用します。
• 3ノードのマルチマスター複製システムが確立されました。マスターノード名は mmrnode_a (マスター定義ノードおよびコントローラーデータベース)、 mmrnode_b 、およびmmrnode_cです。
•
• で mmrnode_a 、次のステートメントが実行されます。で mmrnode_b 、次のステートメントが実行されます。
•
•
• mmrnode_aおよびmmrnode_c deptテーブルを手動で修正します。つまり、 mmrnode_aの行を更新して正しい値にし、欠落している行をmmrnode_c挿入しmmrnode_c 。すべてのノードのdeptテーブルは、一貫性があり最新の状態になりました。
•
• mmrnode_aの表から、 主キー値 50 の誤った行を手動で削除しmmrnode_a 。 mmrnode_bのテーブルに正しい行を残します。これは、 mmrnode_bで正しいトランザクションが実行された状態をシミュレートしますが、シャドウテーブルに記録されますが、まだ複製されておらず、誤ったトランザクションがmmrnode_a実行されたことはありません。 mmrnode_aシャドウテーブルエントリを更新して、破棄されることを示し、今後の同期に含まれないようにします。 mmrnode_bシャドウテーブルエントリのメタデータを更新して、次の同期に含めるようにします。 mmrnode_b受け入れられたシャドウテーブルエントリがmmrnode_aおよびmmrnode_c複製されるように、同期レプリケーションを実行します。パブリケーションテーブルの行を修正したら、現在コントローラーデータベースとして指定されているパブリケーションデータベースの適切なコントロールスキーマテーブルを更新して、競合が解決されたことを示します。上 mmrnode_a 、誤った行を修正:で mmrnode_c 、欠落している行を挿入します。手順2:マスターノード内の競合するトランザクションのシャドウテーブルエントリを更新して、競合が解決されたことを示します。シャドウテーブルは、スキーマ _edb_replicator_pub 各マスターノードにあります 。シャドウテーブルは、命名規則に従うrrst_ schema _ table schema出版テーブルと含むスキーマの名前でtable掲載テーブルの名前です。
• シャドウテーブルの行は 、他のマスターノードの対応するパブリケーションテーブルに適用されるINSERT 、 UPDATE 、またはDELETEステートメントに対応します。シャドウテーブルの行は、ユーザーアプリケーションによって発行されたSQLステートメントに必ずしも対応していません。たとえば、より大きいまたはより小さいなどの範囲を使用するWHERE句を含むユーザーアプリケーションによって発行されたSQLステートメントは、アプリケーションのSQLステートメントの結果セットの各行のシャドウテーブルに複数の個別のエントリをもたらします。 。
• シャドー表の主キーは、列 rrep_sync_id 正の整数が生成されたプログラム rrep_sync_id 。 rrep_sync_id値は、特定のマスターノード内のすべてのシャドウテーブル間で一意です。したがって、競合するトランザクションのrrep_sync_id値は、各マスターノードのシャドウテーブルに記録された以前のトランザクションの数に依存するため、マスターノード間で同じ値を持つ場合と持たない場合があります。
• まだ解決されていない競合に関係するトランザクションのシャドウテーブルエントリには 、列rrep_tx_conflict_status に P (保留)の値が含まれています 。トランザクションが競合に関与していない場合、この列はnullに設定されます。 (シャドウテーブルエントリの大部分のこの列にはnullが必要です。)パブリケーションサーバーによって自動的に解決される競合にトランザクションが関与し、このトランザクションが正しいものとして受け入れられた場合、この列にはC (complete / accepted )。トランザクションが自動的に解決された競合に関与しており、このトランザクションが正しくないと見なされた場合、この列にはD (破棄)が含まれます。次のクエリは 、前の出力のRECORD 1フィールドsrc_rrep_sync_idから取得したrrep_sync_id値2でmmrnode_a の deptテーブルのシャドウテーブルで実行されます。同様のクエリは 、 RECORD 2フィールドsrc_rep_sync_id :から取得したキー値をクエリすることにより、 mmrnode_b 保留中のシャドウテーブルエントリを見つけることができます 。注:保留中のトランザクションが見落とされないようにするには、競合に関係している可能性のあるすべてのマスターノードのシャドウテーブルを調べ、 rrep_tx_conflict_statusがP設定されているエントリを検索する必要があります。以下は、 Postgres Enterprise ManagerクライアントでP (保留中)とマークされた rrep_tx_conflict_status列を示して rrep_tx_conflict_statusます。値をD (破棄)に変更して列 rrep_tx_conflict_statusを変更し、保留中の競合が解決されたことを示します。 Dの値は、シャドウテーブルエントリが将来の同期レプリケーション中にレプリケートされないことも保証します。mmrnode_cにはシャドーテーブルエントリがありません。これは 、アプリケーションによってマスターノードで挿入トランザクションが実行されなかったためです。手順3:現在コントローラーデータベースとして指定されているパブリケーションデータベースのコントロールスキーマで、 xdb_conflictsテーブルのエントリを変更して、競合が解決されたことを示します。テーブルxdb_conflictsは、スキーマ_edb_replicator_pubにあります。注意:テーブルxdb_conflictsのエントリは、セクション6.6.9.1で説明されている[競合履歴]タブとSQLクエリに表示されるデータにのみ影響します。 xdb_conflictsエントリを変更しても、将来のレプリケーション操作には影響しませんが、過去の競合がどのように解決されたかを記録する方法を提供します。xdb_conflictsテーブルに関する次の点に注意してください。
• xdb_conflictsテーブルの行は、 [競合履歴]タブのエントリとして表示されます。
• xdb_conflictsテーブルの主キーは、列src_db_id 、 target_db_id 、 src_rrep_sync_id 、およびtarget_rrep_sync_idます。列src_db_idは、 target_db_id識別されるマスターノードに複製されたときに競合が発生するトランザクションが発生したマスターノードの一意の識別子が含まれます。 src_rrep_sync_idは、競合に関係するソースマスターノード上のトランザクションのシャドウテーブル識別子ですtarget_rrep_sync_idは、競合に関係するターゲットマスターノード上のトランザクションのシャドウテーブル識別子です。 注:一意性(挿入/挿入)の競合の場合、 target_rrep_sync_id値は常に0設定され0 。特定の一意性の競合について、 xdb_conflictsテーブルには2つのエントリがあります。 2つのエントリのそれぞれのsrc_rrep_sync_id値は、シャドウテーブル識別子に対応します。1つはソースマスターノードに関連付けられたシャドウテーブル識別子、もう1つはターゲットマスターノードに関連付けられたシャドウテーブル識別子です。
• コントロールスキーマのテーブル xdb_pub_databaseは、データベース識別子src_db_idおよびtarget_db_idを、データベース名、IPアドレス、ポートなどのマスターノード属性に関連付けます。
• 列 table_idは、競合が発生したパブリケーションテーブルの識別子です。 table_id値とその名前、スキーマ、シャドウテーブルなどのパブリケーションテーブル属性との関連付けは、 _edb_replicator_pub.rrep_tables各マスターノードに_edb_replicator_pub.rrep_tablesます。
• 一意性(挿入/挿入)競合のみの場合、列 pk_valueは、競合の原因となった主キー値を示すテキストが含まれます。テキストはcolumn_name = valueとしてフォーマットされvalue 。主キーが2つ以上の列で構成されている場合、各列と値のペアは、 column_1 = value_1 AND column_2 = value_2などのキーワードAND区切られvalue_2 。これにより、 table_idで指定されたパブリケーションテーブルの行の主キーが提供され、競合が発生しました。 注:一意性(挿入/挿入)の競合のみが、 pk_value列にcolumn_name = valueテキストをpk_valueます。他のすべての競合タイプ(つまり、更新/更新、削除/更新、更新/削除、および削除/削除の競合)の場合、 pk_value列はヌルです。
• 列 resolution_statusは、競合のステータスを示します。可能な値は、 P (保留)またはC (完了-競合が解決されました)です。このステータスは、[競合履歴]タブの[解決ステータス]列に表示されます。
• 列 win_db_idを使用して、「勝った」(受け入れられた)トランザクションを含むマスターノードのデータベース識別子を記録できます。この情報は、「競合履歴」タブの「DBの獲得」列に表示されます。
• 列 win_rrep_sync_idを使用して、勝ち取ったトランザクションのシャドウテーブル識別子を記録できます。列 resolution_status の値を P (保留)からC (完了)に変更して、この競合が解決されたことを示します。 winning_db_idの値は4に変更され、マスターノードmmrnode_bに勝ったトランザクションが含まれていることを示します。値winning_rrep_sync_idの値に変更さrrep_sync_idにおけるトランザクションのシャドウ・テーブル・エントリのmmrnode_bこれは一方が正しいと見なされるからです。[競合履歴]タブで表示すると、エントリの[解決ステータス]列にPending ]ではなくPending Resolved ]が表示され、[勝利DB]列にマスターノードmmrnode_bアドレスが表示されます。セクションで説明されているように、誤った行を修正し、行が欠落しているマスターノードに行を挿入する代わりに、 deptテーブルの一意性の競合を参照します 6.6.9.4 、すべてのマスターノードから競合する行を削除してから、1つのマスターノードに正しい行を挿入し、マルチマスター複製システムに正しい行をすべてのマスターノードと同期させることができます。で mmrnode_a 、誤った行を削除します。で mmrnode_b 、トランザクションが正しい結果を作成していても、行を削除します。で mmrnode_c 、変更は、このノード上のテーブルに新しい行を挿入しませんでした矛盾のトランザクションとして必要ありません。オン mmrnode_a :手順3:同期レプリケーションを実行します。オン mmrnode_a ;オン mmrnode_b :オン mmrnode_c :mmrnode_a 上のシャドウテーブルの変更は次のとおりです。rrep_tx_conflict_statusがnullに設定され、競合がなかったことを示すステップ2で実行した受け入れられたトランザクションの2番目のエントリに注意してください 。mmrnode_b のシャドウテーブルの変更は次のとおりです。mmrnode_cにはシャドーテーブルエントリがありません。これは 、アプリケーションによってマスターノードで挿入トランザクションが実行されなかったためです。ステップ5:現在コントローラーデータベースとして指定されているパブリケーションデータベースのコントロールスキーマで、 xdb_conflictsテーブルのエントリを変更し、セクション6.6.9.4のステップ3のように競合が解決されたことを示します。
•
• mmrnode_b 、次の行が挿入されています。mmrnode_c 、次の行が同じ主キー値が挿入されている9001でempnoカラム:mmrnode_c 、これは、新たに挿入された行に対する一連の更新が続いています。上 mmrnode_a競合行が複製されていません。上 mmrnode_c競合する行がこのノード上で実行された更新に伴って、このノードが残っている上に挿入します:ステップ1:挿入された行を、正しい行を持つmmrnode_cを除くすべてのマスターノードのパブリケーションテーブルから手動で削除します。 session_replication_roleがreplica設定されていることを確認してください。で mmrnode_a 、この行は存在しません。で mmrnode_b 、誤った行を削除します。上 mmrnode_c 、正しい、受け入れ行はそのまま残されます。手順2:破棄される競合する行を含むマスターノードで、その行のシャドウテーブルエントリを破棄としてマークします。これは、この行の競合が解決されたことを示し、このシャドウテーブルエントリが将来的に複製されないようにします。これらの4つのエントリの rrep_tx_conflict_status列がnullであることを確認してください 。この場合、挿入トランザクションの場合、 P (保留)値をnullに変更する必要があります。ステップ4:次の同期中にこれら四つのシャドーテーブルエントリを複製するために、1つ以上のエントリが制御スキーマテーブルに追加されなければならない_edb_replicator_pub.rrep_mmr_txsetにmmrnode_cターゲット・マスター・ノード(に同期のための保留状態を示すためmmrnode_aとmmrnode_b )同定された4つのシャドー・テーブル・エントリのrrep_sync_idの値は1 、 2 、 3 、及び4ステップ3で述べ。最初に、保留中のトランザクションに関連付けるpub_id値とターゲットdb_id値を識別する必要があります 。そうするために、代わりに次のクエリ呼び出しrrep_sync_idの値sync_idクエリで:WHERE start_rrep_sync_id <= sync_idAND end_rrep_sync_id> = sync_id ;結果は、以前に実行によって識別シャドウテーブルトランザクション適用しようと同期することを示す rrep_sync_id値1 、 2 、 3 、及び4によって識別パブリケーションのすべてたpub_idの3 。ターゲット・マスター・ノードは、によって同定したdb_idの1 (用mmrnode_a )とdb_idの4 (用mmrnode_b )。したがって、少なくとも2つのエントリは、制御スキーマテーブルに挿入されなければならない _edb_replicator_pub.rrep_mmr_txsetにmmrnode_c 。少なくとも一つのエントリは、ターゲットに必要とされるdb_idの1とターゲットのための少なくとも1つのエントリdb_idの4 。各エントリため _edb_replicator_pub.rrep_mmr_txsetの範囲から成りrrep_sync_id値(列によって識別start_rrep_sync_idとend_rrep_sync_id )と所望のシャドウ・テーブルはrrep_sync_id値が(連続して起こる1スルー4 )、単一のエントリは、4つの包含することができるrrep_sync_id Aの値を単一のターゲットデータベース。注:複数の非連続があった場合rrep_sync_id (例えば、同期化のために必要な値は、 1 、 2 、 5 、及び6 )は、複数のエントリは、各ターゲット・データベースのために必要とされるであろう。エントリはrrep_sync_id範囲を指定して、連続していないすべての値をまとめてカバーしますが、同期に含まれないrrep_sync_id値を省略します(たとえば、 1から2 1つのエントリと5から6 2番目のエントリ)。手順5:前の手順で特定した_edb_replicator_pub.rrep_mmr_txsetコントロールスキーマテーブルにエントリを挿入します。_edb_replicator_pub.rrep_mmr_txsetメタデータテーブルのクエリは 、次を表示します。現在、保留ステータス( P )の2つの新しいエントリがあります 。1つはターゲットdb_id 1で、もう1つはターゲットdb_id 4用db_id 。両方のエントリは、カバーrrep_sync_idの範囲1介して4 。ステップ6:同期レプリケーションを実行します。オン mmrnode_a :オン mmrnode_b :ステップ7:現在コントローラーデータベースとして指定されているパブリケーションデータベースのコントロールスキーマで、 xdb_conflictsテーブルのエントリを変更して、セクション6.6.9.4のステップ3のように競合が解決されたことを示します。次のSQLステートメントは、列 resolution_status の値を P (保留)からC (完了)に変更して、この競合が解決されたことを示します。 winning_db_idの値は56に変更され、マスターノードmmrnode_cに勝ったトランザクションが含まれていることを示します。値winning_rrep_sync_idの値に変更するrrep_sync_idのシャドウ・テーブル・エントリのINSERTトランザクションmmrnode_cこれは一方が正しいと見なされるからです。注:このセクションの手動の競合解決の説明は、同期レプリケーションのログベースの方法で構成されたマルチマスターレプリケーションシステムにのみ適用されます。同期レプリケーションのトリガーベースの方法で構成されたマルチマスターレプリケーションシステムの手動競合解決については、セクション6.6.9を参照してください。セクション 6.6.5で説明したように 、一意性(挿入/挿入)の競合に対する組み込みの自動競合解決戦略はありません。一意性の競合が発生した場合は、競合を含むパブリケーションテーブルの行を変更し、マスターノードのコントロールスキーマテーブルの行を変更して競合を解決する必要があります。同様に、更新/削除および削除/更新の競合には、手動修正を使用する必要があります。さらに、競合解決オプションが手動に設定され(セクション 6.8を 参照 )、競合が発生した場合、この競合も手動で解決する必要があります。
• 競合を見つける。未解決の競合を見つける
• ログベースの方法の競合解決の概念。トランザクションを実行して修正を適用する方法に関する基本的な概念
• 修正戦略の概要。修正を実行するために使用できる方法の概要
• マニュアル公開表の修正。出版物テーブルの手動修正
• 新しいトランザクションを使用した修正。新しいトランザクションを使用して、すべてのマスターノードを一貫した状態にする6.6.10.1 Finding Conflicts注:トリガーベースの同期レプリケーション方式で構成されたマルチマスターレプリケーションシステムで表示される「データリンクの表示」および「競合の詳細」ウィンドウは、ログベースの同期レプリケーション方式で構成されたマルチマスターレプリケーションシステムでは使用できません。注:すべてのxDBコントロールスキーマテーブルが、トランザクションブロックのこの複製を妨げるわけではありません。以下に示すように、SQL UPDATEステートメントを使用します。次のトランザクションブロックに示すSQL UPDATEステートメントは、同じトランザクションブロック内に現れる他のパブリケーションテーブルの変更の複製を防ぐために含まれています。6.6.10.3 Overview of Correction Strategiesしたがって、競合が発生したことを発見したら、パブリケーションサーバーを停止することを強くお勧めします。セクション5.2.1のステップ1で説明されているLinuxスクリプトまたはWindowsサービスのstopオプションを使用します。手順1:すべてのマスターノードのパブリケーションテーブルの行に必要な手動修正を加えて、各パブリケーションテーブルがマスターノード全体で同じ行の同じセットを持つように、それらを初期の一貫した状態にします。これは、競合を完全に解決するための最も簡単な措置と判断した内容によっては、競合するトランザクションが発生する前の状態になる場合があります。ステップ2:トランザクション(アプリケーションまたはセクション6.6.10.2で定義されているトランザクションブロックのいずれか)を適用して、すべてのマスターノードにわたるすべてのパブリケーションテーブルが、期待される期待される結果に従って一貫して更新されるようにします。手順3:コントロールスキーマで、競合するエントリの特定のインジケーターを更新して、これらの競合が解決されたことを示します。この更新により、[競合履歴]タブでこれらのエントリの解決ステータスが[ Resolved ]に変更されます。これらのエントリは、セクション6.6.10.1で説明されているSQLクエリには表示されなくなります。コントローラーデータベースの制御スキーマに手順3の更新を実行します。現在指定されているコントローラーデータベースは、xDBレプリケーション構成ファイルの内容から決定できます(セクション 2.3.1.3を 参照 )。パブリケーションサーバーは、コントローラーデータベースで行われたコントロールスキーマの変更がすべてのパブリケーションデータベースのコントロールスキーマに確実に複製され、すべてのパブリケーションデータベース間でメタデータの一貫性を維持します。ステップ4:複製システムの操作を再開します。パブリケーションサーバーを起動し、レプリケーションスケジュールを使用している場合は再作成します。
• マニュアル公開表の修正。 PSQLやpgAdmin(Advanced ServerのPostgres Enterprise Manager Client)などのユーティリティを使用して、これらの変更を複製せずに、すべてのマスターノードのパブリケーションテーブルの行を手動で修正します。セクション6.6.10.2で説明したトランザクションブロック内でこれらの手動修正を適用します。
• 新しいトランザクションを使用した修正。 1つのマスターノードでアプリケーションを再実行して、他のすべてのマスターノードに複製できる新しいトランザクションを作成します。すべてのパブリケーションテーブルがすべてのマスターノードで一貫した状態にあることを確認してから、このメソッドを使用します。
• 3ノードのマルチマスター複製システムが確立されました。マスターノード名は mmrnode_a (マスター定義ノードおよびコントローラーデータベース)、 mmrnode_b 、およびmmrnode_cです。
•
• で mmrnode_a 、次のステートメントが実行されます。で mmrnode_b 、次のステートメントが実行されます。6.6.10.4 Manual Publication Table Correction
•
•
• mmrnode_aおよびmmrnode_c deptテーブルを手動で修正します。つまり、 mmrnode_aの行を更新して正しい値にし、欠落している行をmmrnode_c挿入しmmrnode_c 。すべてのノードのdeptテーブルは、一貫性があり最新の状態になりました。
• パブリケーションテーブルの行を修正したら、現在コントローラーデータベースとして指定されているパブリケーションデータベースの適切なコントロールスキーマテーブルを更新して、競合が解決されたことを示します。上 mmrnode_a 、次のトランザクションブロックを実行して、誤った行を修正:で mmrnode_c 、以下のトランザクションブロックに欠落している行を挿入します。手順2:現在コントローラーデータベースとして指定されているパブリケーションデータベースのコントロールスキーマで、 xdb_conflictsテーブルのエントリを変更して、競合が解決されたことを示します。テーブルxdb_conflictsは、スキーマ_edb_replicator_pubにあります。注:テーブルxdb_conflictsのエントリは、セクション6.6.10.1で説明されている[競合履歴]タブとSQLクエリに表示されるデータにのみ影響します。 xdb_conflictsエントリを変更しても、将来のレプリケーション操作には影響しませんが、過去の競合がどのように解決されたかを記録する方法を提供します。xdb_conflictsテーブルに関する次の点に注意してください。
• xdb_conflictsテーブルの行は、 [競合履歴]タブのエントリとして表示されます。
• xdb_conflictsテーブルの主キーは、列src_db_id 、 target_db_id 、 src_rrep_sync_id 、およびtarget_rrep_sync_idます。列src_db_idは、 target_db_id識別されるマスターノードに複製されたときに競合が発生するトランザクションが発生したマスターノードの一意の識別子が含まれます。 src_rrep_sync_idは、競合に関与するソースマスターノード上のトランザクションの識別子であり、 target_rrep_sync_idは、競合に関与するターゲットマスターノード上のトランザクションの識別子です。 注: src_rrep_sync_idおよびtarget_rrep_sync_id値は、xDB Replication Serverによって内部的に使用され、手動の競合解決プロセスには必要ありません。
• コントロールスキーマのテーブル xdb_pub_databaseは、データベース識別子src_db_idおよびtarget_db_idを、データベース名、IPアドレス、ポートなどのマスターノード属性に関連付けます。
• 列 table_idは、競合が発生したパブリケーションテーブルの識別子です。 table_id値とその名前やスキーマなどのパブリケーションテーブル属性との関連付けは、 _edb_replicator_pub.rrep_tables各マスターノードに_edb_replicator_pub.rrep_tablesます。
• 列 pk_valueは、競合の原因となった主キー値を示すテキストが含まれます。テキストはcolumn_name = valueとしてフォーマットされvalue 。主キーが2つ以上の列で構成されている場合、各列と値のペアは、 column_1 = value_1 AND column_2 = value_2などのキーワードAND区切られvalue_2 。これにより、 table_idで指定されたパブリケーションテーブルの行の主キーが提供され、競合が発生しました。
• 列 resolution_statusは、競合のステータスを示します。可能な値は、 P (保留)またはC (完了-競合が解決されました)です。このステータスは、[競合履歴]タブの[解決ステータス]列に表示されます。
• 列 win_db_idを使用して、「勝った」(受け入れられた)トランザクションを含むマスターノードのデータベース識別子を記録できます。この情報は、「競合履歴」タブの「DBの獲得」列に表示されます。列 resolution_status の値を P (保留)からC (完了)に変更して、この競合が解決されたことを示します。 winning_db_idの値は22に変更され、マスターノードmmrnode_bに勝者のトランザクションが含まれることを示します。[競合履歴]タブで表示すると、エントリの[解決ステータス]列にPending ]ではなくPending Resolved ]が表示され、[勝利DB]列にマスターノードmmrnode_bアドレスが表示されます。6.6.10.5 Correction Using New Transactionsセクション6.6.10.4で説明されているように、誤った行を修正し、行が欠落しているマスターノードに行を挿入する代わりに、 deptテーブルの一意性の競合を参照すると、競合する行をすべてのマスターノードから削除してから挿入できます1つのマスターノードで正しい行を作成し、マルチマスターレプリケーションシステムに正しい行をすべてのマスターノードと同期させます。で mmrnode_a 、以下のトランザクションブロックで誤った行を削除します。で mmrnode_b 、トランザクションが正しい結果を作成していても、行を削除します。で mmrnode_c 、変更は、このノード上のテーブルに新しい行を挿入しませんでした矛盾のトランザクションとして必要ありません。手順2:マルチマスター複製システムを実行した状態で、1つのマスターノードで正しいトランザクションを再実行します。目的はすべてのマスターノードと同期することであるため、セクション6.6.10.2で説明されているトランザクションブロック内でこれを実行しないでください。オン mmrnode_a :手順3:同期レプリケーションを実行します。オン mmrnode_a ;オン mmrnode_b ;オン mmrnode_c ;
6.7 競合履歴の表示注:競合履歴は、マルチマスターレプリケーションシステムの任意のマスターノードの下にあるパブリケーションノードから表示できます。履歴には、同期中に発生したすべてのマスターノードのすべてのパブリケーションテーブルでの競合が表示されるため、表示されるマスターノードに関係なく、履歴は同じように表示されます。注:一意性(挿入/挿入)の競合については、ログベースの方法と比較してトリガーベースの同期レプリケーションの方法を使用する場合、[競合履歴]タブに表示されるエントリの数が異なります。トリガーベースの方法を使用すると、単一の挿入/挿入の競合が競合履歴に2つのエントリとして表示されます。各エントリは、2つの競合するマスターノードのソースデータベースフィールドとターゲットデータベースフィールドが交換される点で異なります。ログベースの方法を使用したときに同じ競合が発生した場合、競合履歴には1つのエントリのみが表示されます。手順1:マスターノードを表すデータベースノードの下の任意のパブリケーションノードを選択します。 [全般]、[リアルタイムモニター]、[複製履歴]、および[競合履歴]というラベルのタブが表示されます。手順2: [競合履歴]タブをクリックして、競合履歴を表示します。 [更新]ボタンをクリックして、すべての競合がリストされていることを確認します。ステップ3: [競合表示基準]ドロップダウンリストを使用して、選択したステータスの競合のみを表示します。ステップ4: [データの表示]リンクをクリックして、特定の競合の詳細を表示します。注: 「データの表示」リンクと「競合の詳細」ウィンドウは、同期レプリケーションのトリガーベースの方法で構成されたマルチマスターレプリケーションシステムでのみ使用できます。ログベースの同期レプリケーション方式で構成されたマルチマスターレプリケーションシステムには、データの表示リンクまたは競合の詳細ウィンドウはありません。
6.8 競合解決オプションの更新手順1:変更するパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2:マスター定義ノードを表すPublication Databaseノードの下のPublicationノードを選択します。手順3:次のいずれかの方法で[競合解決オプション]ダイアログボックスを開きます。ステップ4:各テーブルで、適切なボックスの上でマウスの主ボタンをクリックしてドロップダウンリストを表示することにより、主な競合解決戦略とスタンバイ戦略を選択できます。手順5: [更新]ボタンをクリックし、[競合解決オプションが正常に更新されました]に対して[OK]をクリックします。
マスターノードで有効にするには、最初にパブリケーションで使用可能なテーブルフィルターのセットでテーブルフィルターを定義する必要があります。マルチマスターレプリケーションシステムでのテーブルフィルターの定義については、セクション 6.2.3を参照してください 。手順1:ノードがレプリケーションシステムのマスターノードの親であるパブリケーションサーバーが実行されており、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2:個々のフィルタールールを有効または無効にするマスターノードに対応するパブリケーションデータベースノードを選択します。ステップ3: [パブリケーションデータベース]ノードで二次マウスボタンをクリックし、[フィルタールールの更新]を選択します。注:現在のマスター定義ノードでフィルタールールを有効または無効にする場合、マスターノードのコンテキストメニューで[フィルタールールの更新]オプションを公開するには、まずマスター定義ノードの役割を別のマスターノードに切り替える必要があります。マスター定義ノードの切り替えに関する指示については、セクション6.10を参照してください。手順4: [フィルタールール]タブで、チェックボックスをオンまたはオフにして、マスターノードで有効または無効にするフィルタールールを指定します。任意のテーブルで最大1つのフィルタールールを有効にできます。 [保存]ボタンをクリックします。手順5:確認ボックスが表示され、警告メッセージと、フィルター条件を変更したすべてのマスターノードへのスナップショットレプリケーションの実行に関する推奨事項が表示されます。手順6:前の手順で[OK]ボタンをクリックした場合、更新が成功した場合、フィルタールールが正常に更新されたことを示す確認メッセージが表示されます。手順7:フィルター条件が変更されたテーブルを含むマスターノードに対してスナップショットレプリケーションを実行することを強くお勧めします。スナップショットにより、マスターノードテーブルの内容が更新されたフィルタリング基準と一致することが保証されます。スナップショットレプリケーションの実行については、セクション 6.5.1を参照してください 。注:スナップショットのテーブルコンテンツのソースを提供するマスター定義ノードには、マルチマスターレプリケーションシステムの他のマスターノードに含まれるすべてのデータのスーパーセットが含まれている必要があります。これにより、スナップショットのターゲットは、更新されたフィルタリング基準を満たすすべてのデータを確実に受信します。
6.10 マスター定義ノードの切り替え手順1:ノードがレプリケーションシステムのマスターノードの親であるパブリケーションサーバーが実行されており、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。手順2:マスター定義ノードとして設定するマスターノードに対応するパブリケーションデータベースノードを選択します。ステップ3: [パブリケーションデータベース]ノードで二次マウスボタンをクリックし、[MDNとして設定]を選択します。ステップ4: [MDNとして設定]確認ボックスで、[はい]ボタンをクリックします。ステップ5:選択したマスターノードがマスター定義ノードになりました。注:新しいマスター定義ノードは、xDBレプリケーションコンソールのレプリケーションツリーの最上部に移動します。
6.11 高可用性の確保
• xDBレプリケーションコンソールで、マスターノードが選択されると、このマスターノードが現在のコントローラーデータベースである場合、[プロパティ]ウィンドウの[コントローラーデータベース]フィールドは[ Yes 設定されます。
• 注:レプリケーション履歴は、コントローラーデータベースから他のパブリケーションデータベースにレプリケートするのに時間がかかる場合があるため、コントローラーデータベースへのアクセスが失敗し、別のパブリケーションへの切り替えが行われると、一部のレプリケーション履歴が失われる可能性がありますコントローラーデータベースとして機能するデータベース。レプリケーション履歴については、セクション7.4を参照してください。コントローラのデータベース認証および接続情報は、xDBレプリケーション構成ファイルで適宜変更されます(セクション 2.3.1.3を 参照 )。したがって、パブリケーションサーバーとサブスクリプションサーバーの以降の起動では、この新しく指定されたコントローラーデータベースが使用されます。パブリケーションサーバーが現在実行されている場合、この切り替えはxDB Replication Console(セクション 7.7を 参照 )またはxDB Replication Server CLI(セクション8.3.26を参照) を使用して行うことができます。パブリケーションサーバーが実行されていない場合でも、パブリケーションサーバーの起動時にパブリケーションサーバーが新しく指定されたコントローラーデータベースに接続するように、コントローラーデータベースを変更できます。この方法の詳細は、 6.11.4 項を参照してください 。コントローラーデータベースにアクセスできないと判断された場合、xDBレプリケーション構成ファイルを編集して、レプリケーションシステム内の別のマスターノードの接続情報を含めることにより、コントローラーデータベースロールを別のパブリケーションデータベースに切り替えることができます。 xDBレプリケーション構成ファイルの詳細は、 2.3.1.3 項を参照してください 。xDBレプリケーション構成ファイルを変更した後、サブスクリプションサーバーも使用している場合は、サブスクリプションサーバーと共にパブリケーションサーバーを再起動します。パブリケーションサーバーの起動手順については、セクション 5.2.1を参照してください 。サブスクリプションサーバーの起動手順については、セクション5.3.1を参照してください。
6.12 パフォーマンスの最適化シングルマスターレプリケーションシステムのパブリケーションサーバーパフォーマンスに関連するほとんどすべての構成オプションは、マルチマスターレプリケーションシステムに等しく適用できます(Oracleなどのデータベース固有の場合を除く)。これらのオプションの説明については、 セクション 5.8を参照してください 。パブリケーションサーバーの構成オプションは、パブリケーションサーバーの構成ファイルで設定されます。このファイルで構成オプションを設定する方法の詳細な説明については、 10.4.1 項を参照してください 。uniquenessConflictDetection一意性競合は、データロード時に検出されるか、データがターゲット・マスター・ノードに対して適用されたときに延期されなければならない必要がある場合、オプションが決定します。可能な値はEAGERとLAZYです。マスターノード間で重複した挿入の可能性が高い場合は、 EAGER設定します。マスターノードの数が2より大きい場合、競合検出は常に EAGERモードで実行されます。 ( LAZYモードの設定は無視されます。)これは、ターゲットノードから既に複製された競合する変更を削除しないようにするために主に必要です。skipConflictDetection同期レプリケーション中に競合検出をスキップするかどうかを制御します。デフォルトはfalseあり、マスターノード間でデータ競合の可能性がゼロの場合にのみ変更する必要があります。たとえば、各マスターノードが独立したデータセットで動作する場合、このオプションをオンにするとレプリケーション時間が改善されます。デフォルト値は falseです。マルチマスターレプリケーションシステムでは、ターゲットマスターノードでデッドロックが検出された場合、 deadlockRetryCountオプションは、指定されたミリ秒数待機した後、パブリケーションサーバーが現在のレプリケーションサイクルで変更の適用を再試行する回数を制御しますdeadlockWaitTimeによって。 deadlockRetryCountを0に設定してこのオプションをオフにします。この場合、失敗した変更は次のレプリケーションサイクルで試行されます。deadlockWaitTimeオプションは一緒に使用されdeadlockRetryCountターゲット・マスター・ノード上の変更の再試行アプリケーションにパブリケーションサーバーの試行の前にミリ秒単位での待機時間を設定するオプション。
7 一般的な操作レプリケーションシステムの構成と管理には、xDBレプリケーションコンソールのグラフィカルユーザーインターフェイスを使用して、この章の手順と例を示します。 xDB Replication Serverコマンドラインインターフェイス(CLI)を使用して、オペレーティングシステムのコマンドラインから同じ手順を実行できます。 xDB Replication Server CLIユーティリティのコマンドについては、第 8 章で説明します 。注:この章で説明するほとんどの手順は、シングルマスターとマルチマスターの両方のレプリケーションシステムに適用されますが、シングルマスターレプリケーションシステムにのみ適用される手順はFor SMR onlyで示されています。マルチマスター複製システムにのみ適用される手順は、 For MMRのみで示されています。
シングルマスター複製システム(セクション 5.2.3を 参照 )またはマルチマスター複製システム(セクション6.2.3を参照 )のパブリケーションを作成するためにテーブルを選択する場合、選択可能なテーブルの数がそうなる場合がありますチェックリストからそれらを選択するだけでは、困難で時間のかかるプロセスになります。既存のパブリケーションにテーブルを追加するとき、この困難にも遭遇することができます(項を参照 7.6.3.1を )、または既存のパブリケーションからテーブルを削除(セクションを参照7.6.3.2 )。ワイルドカードセレクターによって実行されるパターンマッチングは、スキーマとテーブル名の組み合わせがパターンと呼ばれる文字列と一致する場合に、操作に適格なテーブルがフィルター処理されたリストで返されるプロセスです。パターンに一致するとは、スキーマとテーブル名がschema_nameとしてフォーマットされた文字列に結合されることを意味します. table_nameは、パターンに現れる文字に指定された規則に従って、文字と文字を一致させます。schema_name 場合 . table_name文字列がパターンと一致すると、スキーマとテーブルがそのパターンのフィルター処理されたリストに表示されます。これは、ワイルドカードセレクターダイアログボックスの[使用可能なテーブル]フィールドです。次に、フィルター処理されたリストから選択してローカルリストに追加するテーブルを選択できます。このリストには、ワイルドカードセレクターを使用している操作の潜在的な候補テーブルが含まれます。ワイルドカード と呼ばれる文字を除き 、パターンに現れる文字は、 schema_name対応する位置にある文字を必要とし. table_name文字列は、大文字と小文字を区別しない方法でパターン文字に一致する必要があります(つまり、文字Aまたはa 、 Aとa両方に一致a )。
•
• % -複数文字のワイルドカードは、任意の文字の不在を含む複数の文字の任意の組み合わせがパターンのその位置に存在することを指定します。
•
•
• [ abcd - f ...] –リストと範囲の組み合わせのワイルドカードは、前の2つの箇条書きで説明したリストまたは範囲のワイルドカードの説明のいずれかに一致する文字がパターンの位置に存在することを指定します。
• パターンに指定されている文字以外の文字は ? 、 % 、 [ 、 ] 、およびリストまたは範囲ワイルドカードの角括弧で囲まれた文字は、パターンの位置に存在する必要があります。このような文字のパターンマッチングは、(例えば、パターンケース鈍感であるedb.dept名前のスキーマと一致するテーブルEDB.Dept )。
• NOT pattern 、 ! pattern 、 ! pattern –排他的パターンは、 pattern示されるpattern文字列に一致するテーブルがフィルターされたリストから除外されることを指定します。 pattern一致しないテーブルは、フィルタリングされたリストに含まれます。キーワードNOTは大文字、小文字、または大文字と小文字を混在させることができますが、 pattern前にスペース文字を1つ続ける必要があります。 ! patternは、スペース文字を挟まずに感嘆符( ! )の直後にpattern続くことを指定しpattern 。 ! patternは、 patternと感嘆符( ! )の間に単一のスペース文字が存在することを指定します。
• pattern * - (アスタリスクを指定します*あなたがマッチすることをフィルタされたリスト内のテーブルを含めたい場合は、すぐに介在しない空白文字のパターンを以下の) pattern持っていることの表と一緒に(ローカルリストテーブルである)と、以前に選択されています選択されていません。フィルタリング済みリストでは、以前に選択された各ローカルリストテーブルが表示され、チェックボックスにチェックマークが付いています。以前に選択されていなかったフィルター処理された各テーブルには、チェックボックスにチェックマークがありません。デフォルトでは、アスタリスクが省略されると、以前に選択されていないテーブルのみがフィルターされたリストに返されます。アスタリスクを使用すると、現在選択されているテーブルをローカルリストから削除するのに役立ちます。
• 呼び出しダイアログボックス。これは、ワイルドカードセレクターダイアログボックスを呼び出す操作のダイアログボックスです。ワイルドカードセレクターからのテーブルの最終セットは、呼び出しダイアログボックスによって管理される操作に適用されます。呼び出し可能なダイアログボックスは、[パブリケーションの作成]ダイアログボックス(シングルマスターレプリケーションシステムの場合はセクション5.2.3 、マルチマスターレプリケーションシステムの場合はセクション6.2.3を参照)、[テーブルの追加]ダイアログボックス(セクション7.6.3.1を参照)です。 [テーブルの削除]ダイアログボックス(セクション7.6.3.2を参照)。
• テーブルリスト。これは、呼び出しダイアログボックスに表示される現在選択されているテーブルのリストです。選択した各テーブルのチェックボックスにはチェックマークが付いています。
• ローカルリスト。これは、ワイルドカードセレクターによって管理されるテーブルリストの一時的な内部コピーです。ワイルドカードセレクタを使用すると、ローカルリストにテーブルを追加したり、ローカルリストからテーブルを削除したりできます。 [ワイルドカードセレクタ]ダイアログボックスの[完了]ボタンをクリックすると、ローカルリストがテーブルリストになります。つまり、ローカルリストテーブルは、呼び出しダイアログボックスの選択されたテーブルとして表示されます。
• 選択されていないテーブル。これらは適格なテーブルですが、ワイルドカードセレクターを使用している操作では選択されていません。 [フィルターリスト]ボタンをクリックすると、フィルターパターンに一致する未選択のテーブルが、[ワイルドカードセレクター]ダイアログボックスの[使用可能なテーブル]フィールドに一覧表示されます。選択されていないすべてのテーブルを一覧表示するには、フィルターパターンにパーセント記号( % )を使用します。
• 選択したテーブル。これらは、ワイルドカードセレクターを使用している操作で選択したテーブルです。つまり、これらはローカルリストを構成するテーブルです。フィルタパターンに一致する選択したテーブルを表示するには、フィルタパターンの直後にアスタリスク文字( * )を追加します。選択した各テーブルのチェックボックスにはチェックマークが付いています。手順1: [ワイルドカードセレクター]ダイアログボックスを開く前に、各テーブルのチェックボックスにチェックマークを追加することにより、呼び出しダイアログボックスの使用可能なテーブルのリストからテーブルの選択を開始できます。ステップ2: [使用可能なテーブル]フィールドには、[フィルターパターン]テキストフィールドで使用されているパターンに一致するフィルター処理されたリストが表示されます。[ワイルドカードセレクター]ダイアログボックスを最初に開いたとき、既定のフィルターパターンはパーセント記号( % )で、選択されていないすべての適格なテーブルを返します。ステップ3:フィルターパターンテキストフィールドにパターンを入力して、目的のテーブル選択を絞り込みます。 [フィルターリスト]ボタンをクリックして、パターンに一致するテーブルを表示します。手順4:ローカルリストに追加する[使用可能なテーブル]リストから、そのような各テーブルのチェックボックスにチェックマークを付けて、テーブルを選択します。 [すべて選択]チェックボックスをクリックしてすべてのテーブルを選択し、チェックマークを外して特定のテーブルを個別に選択解除することもできます。ステップ5: [選択をローカルリストに適用]ボタンをクリックして、選択したテーブルをローカルリストに追加します。注:呼び出しダイアログボックスのテーブルリストにローカルリストの変更を適用せずに、いつでも[キャンセル]ボタンをクリックしてワイルドカードセレクターを終了できます。ステップ6:必要な回数だけ、すべての目的のテーブルをローカルリストに追加するために必要なフィルターパターンを使用して、ステップ3〜5を繰り返します。ステップ7:ローカルリストに目的の選択したテーブルがすべて含まれている場合は、[完了]ボタンをクリックします。 [ワイルドカードセレクタ]ダイアログボックスが閉じ、ローカルリストが、呼び出しダイアログボックスによって表示される選択されたテーブルのリストになります。ステップ8:ワイルドカードセレクターを再度呼び出して、ステップ1から開始して、プロセスを繰り返してテーブルを追加したり、テーブルリストからテーブルを削除したりできます。ステップ9:呼び出しダイアログボックスに目的のテーブルの完全なリストが含まれている場合、呼び出しダイアログボックスの適切なボタンをクリックして、選択したテーブルで操作を完了します。
7.2 スケジュールの作成レプリケーションが発生する場合、スケジュールは、時間的に繰り返し点を確立します。注(MMRのみ):マスター定義ノードからマルチマスター複製システム内の他のすべてのマスターノードへの初期スナップショット複製が実行されていることを確認してください。新しく追加されたマスターノードが最初のスナップショットを受けなかった場合、スケジュールによって開始された以降の同期レプリケーションは、そのマスターノードへのトランザクションの適用に失敗する可能性があります。最初のスナップショットは、マスターノードが最初に追加されたときに(セクション6.3を参照)、またはオンデマンドスナップショットを実行して(セクション6.5.1を参照)取得できます。
• ステップ1(SMRのみ):スケジュールを作成するサブスクリプションのサブスクリプションノードを選択します。ステップ1(MMRのみ):コントローラーデータベースとして指定されたパブリケーションデータベースノードを選択します。 (コントローラデータベースの[プロパティ]ウィンドウの[コントローラデータベース]フィールドは[ Yesに設定されています。)ステップ2(SMRのみ):次のいずれかの方法で[タスクウィザード]ダイアログボックスを開きます。ステップ2(MMRのみ):次のいずれかの方法で[タスクウィザード]ダイアログボックスを開きます。手順3: [スケジュールされたタスクウィザード]ダイアログボックスで、同期レプリケーションまたはスナップショットレプリケーションのいずれかのラジオボタンを選択します。注:このサブスクリプションに関連付けられているパブリケーションがスナップショットのみのパブリケーションである場合、スナップショットのみを選択できます。注:マルチマスター複製システムでは、同期のみを選択できます。ステップ4:スケジュールされた複製頻度のラジオボタンを選択するか、[cron式]を選択して独自のcron式を作成します。周波数の選択には次の意味があります。
• 継続的に。指定した秒単位の間隔で継続的に実行されるように複製をスケジュールします。ソーステーブルが日中頻繁に変更され、ターゲットテーブルを1日を通して最新に保つ必要がある場合は、このオプションを選択します。
• 毎日。選択した時刻に1日1回実行されるように複製をスケジュールします。ターゲット表を毎日更新する必要がある場合は、このオプションを選択します。
• 毎週。選択した時刻に1日1回実行するようにレプリケーションをスケジュールしますが、選択した特定の曜日にのみ実行します。毎日のスケジュールよりも柔軟性が必要で、ターゲットテーブルを毎日更新する必要がない場合は、このオプションを選択します。
• 毎月。選択した特定の月の特定の月にのみ、月に1日実行するように複製をスケジュールします。ソーステーブルへの更新があまり頻繁に行われず、ターゲットテーブルが1か月以上古い場合、このオプションを選択します。 [月単位]オプションを使用すると、月に1回または1年に1回の頻度で複製をスケジュールできます。手順5: [スケジュールされたタスクウィザード]ダイアログボックスの完了後、[次へ]ボタンをクリックします。ステップ6:選択したスケジュールが表示されます。 [完了]ボタンをクリックして、スケジュールを受け入れます。
7.3 スケジュールの管理7.3.1 Updating a Scheduleステップ1(SMRのみ):変更するサブスクリプションの親であるノードを持つサブスクリプションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。サブスクリプションサーバーの起動と登録の手順については、セクション5.3.1を参照してください。ステップ1(MMRのみ):変更するコントローラーデータベースの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2(SMRのみ):スケジュールを更新するサブスクリプションのサブスクリプションノードを選択します。ステップ2(MMRのみ):スケジュールを更新するコントローラーデータベースとして指定されたパブリケーションデータベースノードを選択します。ステップ3(SMRのみ):次のいずれかの方法で[タスクウィザード]ダイアログボックスを開きます。ステップ3(MMRのみ):次のいずれかの方法で[スケジュールされたタスクウィザード]ダイアログボックスを開きます。ステップ4: 「スケジューラーの構成」確認ボックスが表示されます。 [はい]ボタンをクリックします。7.3.2 Removing a Scheduleステップ1(SMRのみ):変更するサブスクリプションの親であるノードを持つサブスクリプションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。サブスクリプションサーバーの起動と登録の手順については、セクション5.3.1を参照してください。ステップ1(MMRのみ):変更するコントローラーデータベースの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2(SMRのみ):スケジュールを削除するサブスクリプションのサブスクリプションノードを選択します。ステップ2(MMRのみ):スケジュールを削除するコントローラーデータベースとして指定されたパブリケーションデータベースノードを選択します。ステップ3(SMRのみ):次のいずれかの方法でスケジュールを削除します。ステップ3(MMRのみ):次のいずれかの方法でスケジュールを削除します。ステップ4: [スケジュールの削除]確認ボックスで、[はい]ボタンをクリックします。
7.4 レプリケーション履歴の表示各サブスクリプションまたはマスターノードで実行されたレプリケーションの概要は、xDBレプリケーションコンソールで表示できます。各ターゲットテーブルに対して行われた各挿入、更新、削除を示す詳細なレプリケーション履歴も表示できます。同期レプリケーションのターゲットベースの方法の変更がターゲット表に適用される方法については、 セクション 2.2.9を参照してください 。同期レプリケーションのログベースの方法については、セクション2.2.10を参照してください。注(SMRのみ):レプリケーション履歴は、パブリケーションノードおよびサブスクリプションノードから表示できます。パブリケーションノードに対して表示される履歴は、実際には、同期中にパブリケーションサーバーがサブスクリプションテーブルに対して行った挿入、更新、および削除のまったく同じセットです。パブリケーションノードに対して表示される履歴には、ユーザーアプリケーションから発生したパブリケーションテーブルで処理された実際のSQLステートメントは表示されません。注(MMRのみ):レプリケーション履歴は、マルチマスターレプリケーションシステムの任意のマスターノードの下のパブリケーションノードから表示できます。表示される履歴には、同期中にパブリケーションサーバーによってすべてのマスターノードのすべてのパブリケーションテーブルで行われた挿入、更新、および削除が含まれるため、履歴が表示されるマスターノードに関係なく、履歴は同じように表示されます。7.4.1 All Replication Historyステップ1(SMRのみ):サブスクリプションノードの下のノードを選択します。 [全般]、[リアルタイムモニター]、および[複製履歴]というラベルのタブが表示されます。ステップ1(MMRのみ):マスターノードを表すデータベースノードの下の任意のパブリケーションノードを選択します。 [全般]、[リアルタイムモニター]、[複製履歴]、および[競合履歴]というラベルのタブが表示されます。手順2: [レプリケーション履歴]タブをクリックして、レプリケーションの履歴を表示します。注:少なくとも1つの更新を含むすべてのスナップショットレプリケーションと各同期レプリケーションは、コントロールスキーマのレプリケーション履歴テーブルに保持される履歴レコードを生成します。時間が経つにつれて、レプリケーション履歴テーブルのサイズが大きくなります。レプリケーション履歴レコードは定期的に削除できます。レプリケーション履歴のクリーンアップについては、セクション7.5.3を参照してください。手順1: [レプリケーション履歴]タブの下部にある[トランザクション数> 0の履歴を表示する]チェックボックスをオンにします。手順2: [レプリケーション履歴]タブが次に更新されると、ゼロ以外のトランザクションカウントのレプリケーションのみがレプリケーション履歴に表示されます。注:ゼロトランザクションカウントのレプリケーションレコードは、パブリケーションサーバーのメモリに保持されます。デフォルトでは、これらは永続的にディスクに保存されるわけではありません。したがって、パブリケーションサーバーがシャットダウンすると、メモリ内のゼロトランザクションカウントのレプリケーションレコードは使用できなくなります。ゼロトランザクションカウントレプリケーションレコードをディスクに永続的に保存する場合は、パブリケーションサーバー構成オプション persistZeroTxRepEventをtrue 設定しtrue 。詳細については、セクション10.4.1.12を参照してください。7.4.3 Shadow Table Historyステップ1:テーブルを選択して、テーブルに関する一般情報とテーブルの複製履歴を含むタブを表示します。テーブルノードを展開して、テーブルの列を表示します。手順2: [レプリケーション履歴]タブをクリックして、このテーブルのレプリケーションの履歴を表示します。手順3: [データの表示]リンクをクリックして、同期レプリケーション中にテーブルに加えられた各変更のリストを表示します。 [履歴の同期]ウィンドウには、 empソーステーブルで実行された次のSQLステートメントのセットに対応するempターゲットテーブルに対する1つの挿入操作が後に続く2つの更新操作が表示されます。
7.5 履歴の管理
• シャドウテーブルの履歴。トリガーベースの方法を使用した同期レプリケーション中に各ターゲットテーブルに適用された各変更(挿入、更新、または削除)のレコード。ログベースの方法を使用した同期レプリケーションのシャドウテーブル履歴はありません。
• レプリケーション履歴。各複製の要約レコード。
• イベント履歴。さまざまなコントロールスキーマテーブルに適用された各変更の記録。注:シャドウテーブル内の特定の処理済み行のクリーンアップは、次にスケジュールされているクリーンアップよりも遅れることがありますが、その後のクリーンアップイベントで最終的に削除されます。Oracleのみ: Oracleパブリケーションデータベースでのシャドウテーブル履歴のクリーンアップのスケジューリングには、Oracleデータベースサーバー上のOracle DBMS_JOBパッケージが使用されます。クリーンアップのスケジュールで指定した時間が渡され、タイムゾーン変換なしでDBMS_JOB保存されます。SQL Serverのみ: SQL Serverパブリケーションデータベースでのシャドウテーブル履歴クリーンアップのスケジュールには、SQL Serverを実行しているホストでSQL Serverエージェントが使用されます。クリーンアップのスケジュールで指定した時間は、タイムゾーン変換なしでSQL Serverエージェントに渡されます。この効果は、前の例でOracleについて説明したものと同じです。Postgresのみ: Postgresパブリケーションデータベースでのシャドウテーブル履歴クリーンアップのスケジューリングでは、コントローラーデータベースの場所に基づいてパブリケーションサーバーを実行しているホストでQuartzスケジューラーが使用されます。Oracleのみ: Oracleパブリケーションデータベースのクリーンアップジョブは、パブリケーションサーバーとは独立して実行されるため、パブリケーションサーバーが実行されているかどうかに関係なく、クリーンアップジョブが実行されます。Postgresのみ:クリーンアップジョブをPostgresパブリケーションデータベースで実行するには、パブリケーションサーバーが実行されている必要があります。注: Postgresがパブリケーションデータベースである場合にQuartzスケジューラーを使用する代わりに、pgAgentジョブスケジューリングを使用することもできます。 pgAgentジョブスケジューリングの使用方法とその利点については、セクション10.4.1.8を参照してください。手順1:クリーンアップスケジュール設定を設定するパブリケーションデータベース定義の親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。手順2:クリーンアップスケジュール設定を設定するパブリケーションデータベースノードを選択します。ステップ3: [出版物]メニューから[設定]を選択します。または、[パブリケーションデータベース]ノードで2番目のマウスボタンをクリックし、[設定]を選択します。 Publication Server Preferencesダイアログボックスが表示されます。ステップ4:スケジュールされたシャドウテーブル履歴のクリーンアップジョブを実行しない場合は、[パブリケーションサーバーの設定]ダイアログボックスで、チェックボックスをオフにします。 [OK]ボタンをクリックして、残りの手順をスキップします。手順5:シャドウテーブルの履歴クリーンアップをスケジュールする場合は、[クリーンアップジョブの実行]チェックボックスがオンになっていることを確認します。クリーンアップ頻度のラジオボタンを選択します。周波数の選択には次の意味があります。
• すべての分/時間。シャドウテーブルの履歴のクリーンアップをスケジュールして、指定した分または時間の間隔で継続的に実行します。 1日のうち毎日、パブリケーションテーブルに大量の更新がある場合は、このオプションを選択します。
• 毎日1時間ごと。シャドウテーブルの履歴のクリーンアップをスケジュールして、選択した時間に1日1回実行します。パブリケーションテーブルの更新が頻繁に行われ、1週間に2回以上のクリーンアップが必要であるが、1日に1回以上は必要ない場合は、このオプションを選択します。
• 選択した曜日ごとの時刻。シャドウテーブルの履歴のクリーンアップをスケジュールして、選択した日と時間に週に1回実行します。パブリケーションテーブルの更新が頻繁ではなく、クリーンアップを手動で実行したくない場合は、このオプションを選択します。ステップ6: [OK]ボタンをクリックして、スケジュールを受け入れます。
• Oracleのみ: Oracleがパブリケーションデータベースである場合、これらのテーブルはパブリケーションデータベースユーザーのスキーマのパブリケーションデータベースにあります。SQL Serverのみ: SQL Serverがパブリケーションデータベースである場合、これらのテーブルはセクション5.1.4.2のステップ5で選択したスキーマのパブリケーションデータベースにあります。Postgresのみ: Postgresがパブリケーションデータベースである場合、これらのテーブルはスキーマ_edb_replicator_pubパブリケーションデータベースにあります。注:シャドウテーブル内の特定の処理済み行のクリーンアップは、オンデマンドクリーンアップ中に発生しないか、スケジュールされた次のクリーンアップより遅れる場合がありますが、その後のクリーンアップイベントで削除されます。手順1:シャドウテーブルの履歴をクリーンアップするパブリケーションの親であるノードを持つパブリケーションサーバーが実行されており、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。手順2:シャドウテーブルの履歴をクリーンアップするパブリケーションのパブリケーションノードを選択します。ステップ3: [パブリケーション]メニューから、[シャドウテーブル履歴のクリーンアップ]を選択します。または、パブリケーションノードで二次マウスボタンをクリックし、シャドウテーブル履歴のクリーンアップを選択します。 [同期履歴のクリーンアップ]確認ボックスが表示されます。ステップ4: [同期履歴のクリーンアップ]確認ボックスで[はい]ボタンをクリックします。ステップ5:シャドウテーブルのトランザクション履歴が正常に削除されたことに応じて、[はい]ボタンをクリックします。ステップ1:レプリケーション履歴をクリーンアップするパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。手順2:レプリケーション履歴をクリーンアップするパブリケーションのパブリケーションノードを選択します。ステップ3: [パブリケーション]メニューから、[レプリケーション履歴のクリーンアップ]を選択します。または、パブリケーションノードで2番目のマウスボタンをクリックし、[レプリケーション履歴のクリーンアップ]を選択します。 Cleanup Replication History確認ボックスが表示されます。ステップ4: [レプリケーション履歴のクリーンアップ]確認ボックスで[はい]ボタンをクリックします。手順5: [レプリケーション履歴が削除されました]への応答として[はい]ボタンをクリックします。コントロールスキーマのイベント履歴とレプリケーション履歴データは、毎日午前12時にスケジュールされて削除されるため、テーブル xdb_events 、 xdb_events_status 、 xdb_pub_replog 、およびxdb_pub_table_replog の行数が削減されます。パブリケーションサーバー構成オプション historyCleanupDaysThresholdは、削除する前に完了したデータに到達する必要があるhistoryCleanupDaysThresholdを指定する機能を提供します。デフォルト設定では、完了したデータは、毎日午前12時のクリーンアッププロセスで削除される前に7日以上経過している必要があります。経過時間に関係なく完了したすべてのイベントとレプリケーション履歴をクリーンアップするには、 historyCleanupDaysThresholdの値を0に設定してから、パブリケーションサーバーを再起動します。クリーンアップは、次に予定されている午前12時のクリーンアッププロセス中に行われます。
7.6 パブリケーションの管理7.6.1.1 Publication Server Login FilexDBレプリケーションコンソールでパブリケーションサーバーを登録するときに、xDBレプリケーションコンソールを実行しているコンピューターのサーバーログインファイルにパブリケーションサーバーのネットワークの場所、管理ユーザー名、暗号化されたパスワードを保存することを選択できます。ログイン情報の保存については、セクション 4.2を参照してください 。手順1:ファイルに変更を加える前に、サーバーログインファイルでログイン情報を保存、変更、または削除するパブリケーションサーバーが実行されている必要があります。パブリケーションサーバーの起動手順については、セクション5.2.1のステップ1を参照してください。ステップ2: Publication Serverノードで2番目のマウスボタンをクリックし、Updateを選択します。 [パブリケーションサーバーの更新]ダイアログボックスが表示されます。ステップ3:サーバーログインファイルを更新する目的に応じて、ダイアログボックスのフィールドに入力します。ステップ4: [更新]ボタンをクリックします。ダイアログボックスが閉じた場合、サーバーログインファイルの更新は成功しています。 xDB Replication Consoleツールバーの「更新」アイコンをクリックして、更新されたPublication Serverノードを表示します。注:このセクションは、シングルマスター複製システムにのみ適用されます。ステップ2: Publication Serverノードで二次マウスボタンをクリックし、Update Subscription Serversを選択します。 [サブスクリプションサーバーの更新]ダイアログボックスが表示されます。注:エラーメッセージボックスが再び表示される場合は、[OK]ボタンをクリックして、手順2を繰り返します。ステップ3:ネットワークロケーションが変更されたリスト内の各サブスクリプションサーバーの新しいネットワークロケーションを入力します。ステップ4: [更新]ボタンをクリックします。ダイアログボックスが閉じた場合、パブリケーションサーバーのメタデータの更新は成功しています。ステップ5:新しいネットワークロケーションのサブスクリプションサーバーが他のパブリケーションサーバーのパブリケーションに関連付けられたサブスクリプションを管理する場合、これらの他のパブリケーションサーバーに対してステップ1〜4を繰り返します。パブリケーションデータベース定義を作成するとき、パブリケーションサーバーがアクセスするコントロールスキーマに、パブリケーションデータベースサーバーのネットワークの場所(IPアドレスとポート番号)、データベース識別子、データベースログインユーザー名、およびユーザーのパスワードを保存します。このログイン情報は、パブリケーションデータベースとのセッションを確立する必要があるたびに使用されます。シングルマスターレプリケーションシステムのパブリケーションデータベース定義の作成については、セクション 5.2.2を参照してください 。マルチマスター複製システムについては、セクション6.2.2および6.3を参照してください。注:データベースのタイプ(Oracle、SQL Server、またはPostgres)に応じて、特定の属性を変更しないでください。このパブリケーションデータベース定義を最初に追加したときにコントロールスキーマオブジェクトが作成されたスキーマへのアクセスを変更する属性を変更しないでください。コントロールスキーマオブジェクトの場所については、セクション5.2.4を参照してください。ステップ1:パブリケーションデータベース定義として最終的に保存するデータベースサーバーが実行中であり、クライアント接続を受け入れていることを確認します。手順2:変更するパブリケーションデータベース定義の親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。手順3:更新するパブリケーションデータベース定義に対応するパブリケーションデータベースノードを選択します。ステップ4: [出版物]メニューから[出版物データベース]を選択し、[データベースの更新]を選択します。または、[パブリケーションデータベース]ノードで2番目のマウスボタンをクリックし、[データベースの更新]を選択します。 [データベースソースの更新]ダイアログボックスが表示されます。ステップ5:目的の変更を入力します。シングルマスター複製システムのフィールドの正確な意味については、セクション5.2.2のステップ3を参照してください。マルチマスター複製システムについては、セクション6.2.2および6.3を参照してください。ステップ6: [テスト]ボタンをクリックします。テスト結果:成功が表示されたら、[OK]ボタンをクリックしてから、[保存]ボタンをクリックします。手順8: xDB Replication Consoleツールバーの[更新]アイコンをクリックして、更新されたパブリケーションデータベースノードとそのパブリケーションを表示します。7.6.3 Updating a Publication7.6.3.1 Adding Tables to a Publication手順1:変更するパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2(SMRのみ):テーブルを追加するパブリケーションのパブリケーションノードを選択します。ステップ2(MMRのみ):マスター定義ノードを表すPublication Databaseノードの下のPublicationノードを選択します。手順3:次のいずれかの方法で[テーブルの追加]ダイアログボックスを開きます。ステップ4: [テーブルの追加]ダイアログボックスの[テーブルの追加]タブで、次のフィールドに入力します。
• 追加します。パブリケーションに追加する[使用可能なテーブル]リストのテーブル名の横にあるチェックボックスをオンにします。パブリケーションがスナップショットのみのパブリケーションである場合、ビューは[使用可能なテーブル]リストにも表示されます。 [使用可能なテーブル]リストには、同じパブリケーションデータベースノードの下の他のパブリケーションのメンバーではないテーブルとビューのみが含まれます。または、さらに、[ワイルドカード選択の使用]ボタンをクリックして、パブリケーションに追加するテーブルの選択にワイルドカードパターンマッチングを使用します。
• すべて選択。パブリケーションの[使用可能なテーブル]リストにすべてのテーブルとビューを含める場合は、このボックスをオンにします。
• ワイルドカード選択を使用します。このボタンをクリックして、ワイルドカードセレクターを使用してパブリケーションのテーブルを選択します。ワイルドカードセレクタの詳細については、セクション7.1を参照してください。ステップ5(オプション):パブリケーションのテーブルまたはビューの行をフィルターする場合は、[テーブルフィルター]タブをクリックします。 [フィルター]ダイアログボックスに一意のわかりやすいフィルター名と適切なSQL WHERE句を入力して、複製する行を選択することにより、フィルタールールを定義します。ステップ6(SMRのみ): [テーブルの追加]ボタンをクリックします。 [パブリケーションが正常に更新された]が表示されたら、[OK]ボタンをクリックします。それ以外の場合は、エラーを調査して必要な修正を行います。ステップ6(MMRのみ): [テーブルの追加]ボタンをクリックします。テーブルが追加される前に同期レプリケーションが実行されることを警告する[データ同期チェック]ダイアログボックスが表示されます。ステップ7:パブリケーションノードの下に新しく追加されたテーブルとともに、レプリケーションツリーが次のように表示されます。 [更新]アイコンをクリックします。新しく追加されたテーブルは、シングルマスター複製システムのサブスクリプションノードまたはマルチマスター複製システムの追加マスターノードの下に表示されます。ステップ8(MMRのみ):新しく追加されたテーブルに割り当てられたデフォルトの競合解決オプションを変更または表示する場合は、セクション6.8の指示に従います。ステップ9(オプション):新しく追加されたテーブルでテーブルフィルターを定義し、サブスクリプションまたはマスターノードでこれらのフィルターを使用する場合、目的のサブスクリプションまたはマスターノード内のテーブルでフィルターを有効にする必要があります。上記のエンティティ関係図では、 empテーブルにはdeptテーブルを参照する外部キー制約があり、 jobhistテーブルには2つの外部キー制約があります。 1つの制約はempテーブルを参照し、もう1つの制約はdeptテーブルを参照します。
• jobhistテーブルのみを削除します。
• 手順1:変更するパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2(SMRのみ):テーブルを削除するパブリケーションのパブリケーションノードを選択します。ステップ2(MMRのみ):マスター定義ノードを表すPublication Databaseノードの下のPublicationノードを選択します。手順3:次のいずれかの方法で[テーブルの削除]ダイアログボックスを開きます。手順4:次のように[テーブルの削除]ダイアログボックスを使用します。
• 削除します。パブリケーションから削除する[使用可能なテーブル]リストのテーブル名の横にあるチェックボックスをオンにします。パブリケーションがスナップショットのみのパブリケーションである場合、ビューは[使用可能なテーブル]リストにも表示されます。または、さらに、[ワイルドカード選択の使用]ボタンをクリックして、パブリケーションから削除するテーブルの選択にワイルドカードパターンマッチングを使用します。
• ワイルドカード選択を使用します。このボタンをクリックして、ワイルドカードセレクターを使用して、パブリケーションから削除するテーブルを選択します。ワイルドカードセレクタの詳細については、セクション7.1を参照してください。ステップ5: [削除]ボタンをクリックし、確認ボックスの[はい]ボタンをクリックします。ステップ6:テーブルが正常に削除されたことに応じて、[OK]ボタンをクリックします。
• パブリケーションに新しいフィルタールールを追加した後、これらのフィルタールールを有効にするサブスクリプションまたはマスターノードでこれらの新しく追加されたフィルタールールを有効にする必要があります。サブスクリプションでフィルタールールを有効にする方法については、セクション 5.5.4を参照してください 。マスターノードでフィルタールールを有効にする方法については、セクション6.9を参照してください。手順1:変更するパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2(SMRのみ):利用可能なテーブルフィルターのセットを更新するパブリケーションのパブリケーションノードを選択します。ステップ2(MMRのみ):マスター定義ノードを表すPublication Databaseノードの下のPublicationノードを選択します。手順3:次のいずれかの方法で[フィルターの更新]ダイアログボックスを開きます。ステップ4:パブリケーションで定義されている使用可能なすべてのフィルタールールのセットが、[テーブルフィルター]タブの下に一覧表示されます。新しいフィルタールールを追加するには、[テーブル/ビュー]ドロップダウンリストから、フィルターを追加するテーブルまたはビューを選択し、[フィルターの追加]ボタンをクリックします。表示されるダイアログボックスに情報を入力します。 (シングルマスター複製システムに個々のフィルター規則を追加する方法の詳細については、 セクション 5.2.3を参照してください。マルチマスター複製システムについては、セクション6.2.3を参照してください。)手順5:警告メッセージと、フィルター条件の変更を有効にする予定のサブスクリプションまたはマスターノードへのスナップショットレプリケーションを実行するための推奨事項を示す確認ボックスが表示されます。ステップ6:関連するサブスクリプションまたはマスターノードの対応するテーブルに対して、新しいフィルタールールを選択的に有効にすることができます。サブスクリプションでテーブルフィルターを有効にする方法については、セクション5.5.4を参照してください。マスターノードでテーブルフィルターを有効にする方法については、 6.9項をご覧ください。7.6.5 Validating a Publicationパブリケーションが作成されたら、パブリケーションに 属するテーブルの定義を直接変更しない で ください 。これを行うと、複製プロセス中に障害が発生する場合があります。変更してはならないテーブル定義の例は次のとおりです。注: xDB Replication Serverによって生成されたトリガーを変更しないでください。トリガーの再生成が必要になった場合、関連するパブリケーションを削除してから、パブリケーションを再作成する必要があります。注:DDL変更レプリケーション機能を使用して、xDB Replication Serverによって特定のテーブル定義の変更を行い、伝播することができます。 DDL変更レプリケーション機能の詳細は、 7.8項を参照してください。
•
•
•
•
•
•
•
•
•
•
• 追加のマスターノードを再追加します。マスターノードを追加する方法については、セクション 6.3を参照してください 。マスターノードを作成するときに、すべてのマスターノードでテーブル定義をすでに作成している場合は、[パブリケーションスキーマの複製]チェックボックスをオフにします。マスター定義ノードから他のすべてのマスターノードにテーブル定義を伝播する場合は、[パブリケーションスキーマの複製]チェックボックスをオンにします。スナップショットは、マスター定義ノードからマスターノードテーブルをリロードします。7.6.5.1 Validating a Single Publication注:この検証機能は、同期レプリケーションのトリガーベースの方法を使用するパブリケーションでのみ使用できます。この検証機能は、同期レプリケーションのログベースの方法を使用するパブリケーションでは使用できません。
• 注:マルチマスターレプリケーションシステムでは、マスター定義ノードのみのパブリケーションテーブルが検証されます。検証操作では、他のマスターノードでテーブル定義が変更されているかどうかはチェックされません。ステップ1:検証するパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2(SMRのみ):検証するパブリケーションのパブリケーションノードを選択します。ステップ2(MMRのみ):マスター定義ノードを表すPublication Databaseノードの下のPublicationノードを選択します。ステップ3: [出版物]メニューから[出版物の検証]を選択します。または、パブリケーションノードで2番目のマウスボタンをクリックし、パブリケーションの検証を選択します。ステップ4:パブリケーション ' publication_name 'のパブリッシュされたテーブルのすべてのスキーマが最新である場合は、[OK]ボタンをクリックします。エラーが表示された場合、どのテーブルが変更されたか、テーブル定義にどのような変更が加えられたかを判断します。このセクションで前述したように、これらの問題はケースバイケースで解決する必要があります。7.6.5.2 Validating All Publications注:この検証機能は、同期レプリケーションのトリガーベースの方法を使用するパブリケーションでのみ使用できます。この検証機能は、同期レプリケーションのログベースの方法を使用するパブリケーションでは使用できません。注:マルチマスターレプリケーションシステムでは、マスター定義ノードのみのパブリケーションテーブルが検証されます。検証操作では、他のマスターノードでテーブル定義が変更されているかどうかはチェックされません。ステップ1:検証するパブリケーションの親であるノードを持つパブリケーションサーバーが実行されており、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2(SMRのみ):すべてのパブリケーションを検証するパブリケーションデータベースノードを選択します。ステップ2(MMRのみ):マスター定義ノードを表すパブリケーションデータベースノードを選択します。ステップ3: [出版物]メニューから[すべての出版物を検証]を選択します。または、パブリケーションデータベースノードで2番目のマウスボタンをクリックし、[すべてのパブリケーションを検証]を選択します。ステップ4:変更されたテーブルがなかった場合、[OK]ボタンをクリックします。7.6.6 Removing a Publicationシングルマスターレプリケーションシステムでは、パブリケーションを削除してから、関連するサブスクリプションを削除できます。サブスクリプションを削除する方法については、セクション 5.5.5を参照してください 。マルチマスターレプリケーションシステムでは、マスター定義ノードを表すパブリケーションデータベースノードの下からパブリケーションが削除されます。パブリケーションを削除する前に、すべての非MDNノードを削除する必要があります。マスターノードのパブリケーションデータベース定義を削除する方法 については、セクション 7.6.7を参照してください 。パブリケーションを削除しても、パブリケーションデータベース内のパブリケーションテーブルは削除されません。これらのテーブルのIDとxDB Replication Serverへの関連付けが削除されるため、DBAが DROP TABLE SQLステートメントでDROP TABLE 削除するまで、テーブルはデータベースに残ります。ステップ1:削除するパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2(SMRのみ):削除するパブリケーションのパブリケーションノードを選択します。ステップ2(MMRのみ):マスター定義ノードを表すPublication Databaseノードの下のPublicationノードを選択します。手順3:次のいずれかの方法でパブリケーションを削除します。ステップ4: [パブリケーションの削除]確認ボックスで、[はい]ボタンをクリックします。削除するパブリケーションデータベースノードが現在コントローラーデータベースとして指定されており、他のシングルマスターまたはマルチマスターレプリケーションシステムに追加のパブリケーションデータベースがある場合、最初にコントローラーデータベースロールを別のパブリケーションデータベースに切り替える必要があります。コントローラーデータベースの切り替えについては、セクション 7.7を参照してください 。シングルマスターレプリケーションシステムでは、パブリケーションデータベースノードを削除する前に、そのパブリケーションデータベースノードの下にあるすべてのパブリケーションを削除する必要があります。パブリケーションを削除する方法については、セクション 7.6.6を参照してください 。
• OracleおよびSQL Serverの場合:パブリケーションデータベースユーザーのスキーマの下にあるすべてのメタデータデータベースオブジェクトが削除されます。Postgresのみ:スキーマ_edb_replicator_pubとそのすべてのデータベースオブジェクトがパブリケーションデータベースから削除されます。手順1:削除するパブリケーションデータベース定義の親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2:削除するパブリケーションデータベースノードを選択します。ステップ3: [出版物]メニューから[出版物データベース]、[データベースの削除]の順に選択します。または、パブリケーションデータベースノードで2番目のマウスボタンをクリックし、データベースの削除を選択します。 [パブリケーションデータベースの削除]確認ボックスが表示されます。ステップ4: [パブリケーションデータベースの削除]確認ボックスで、[はい]ボタンをクリックします。
コントローラーデータベースはxDBレプリケーション構成ファイルで指定され、起動時にパブリケーションサーバーとサブスクリプションサーバーが最初に接続するパブリケーションデータベースを決定します。コントローラデータベースの詳細については、セクション 2.3.1.12を参照してください 。 xDBレプリケーション構成ファイルの詳細は、 2.3.1.3項を参照してください。注:コントローラーデータベースがOracleまたはSQL Serverパブリケーションデータベースの場合、2番目のOracleまたはSQL Serverパブリケーションデータベースを追加して、2番目のシングルマスターレプリケーションシステムを作成することはできません。 xDB Replication ServerがOracleまたはSQL Serverパブリケーションデータベースで構成される複数のシングルマスタレプリケーションシステムを実行するには、Postgresパブリケーションデータベースをコントローラーデータベースとして指定する必要があります。コントローラーデータベースを切り替えると、パブリケーションサーバーはxDBレプリケーション構成ファイルを更新し、パラメーター user 、 password 、 host 、 port 、 database 、およびtypeが、選択したパブリケーションデータベースの接続および認証設定に設定されるようにします。手順1:ノードがパブリケーションデータベースの親であるパブリケーションサーバーが実行されており、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ2:コントローラーデータベースとして設定するパブリケーションデータベースに対応するパブリケーションデータベースノードを選択します。ステップ3: Publication Databaseノードで2番目のマウスボタンをクリックし、Set as Controller databaseを選択します。ステップ4: [コントローラーデータベースとして設定]確認ボックスで、[はい]ボタンをクリックします。ステップ5:選択したパブリケーションデータベースがコントローラーデータベースとして設定されました。ステップ6: [プロパティ]ウィンドウの[コントローラーデータベース]フィールドの[ Yesは、このデータベースがコントローラーデータベースであることを示します。
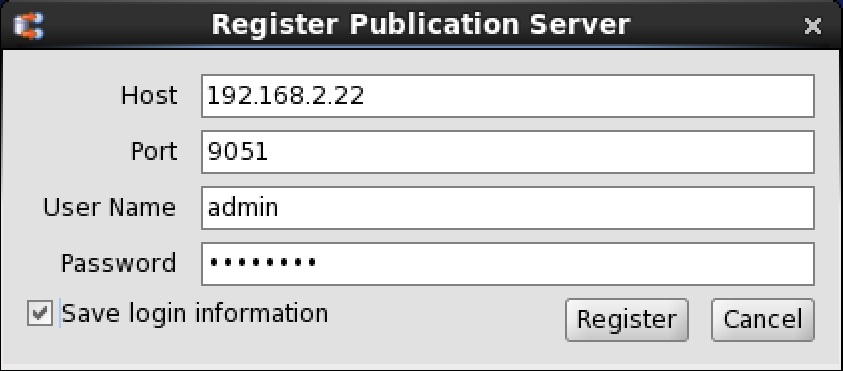
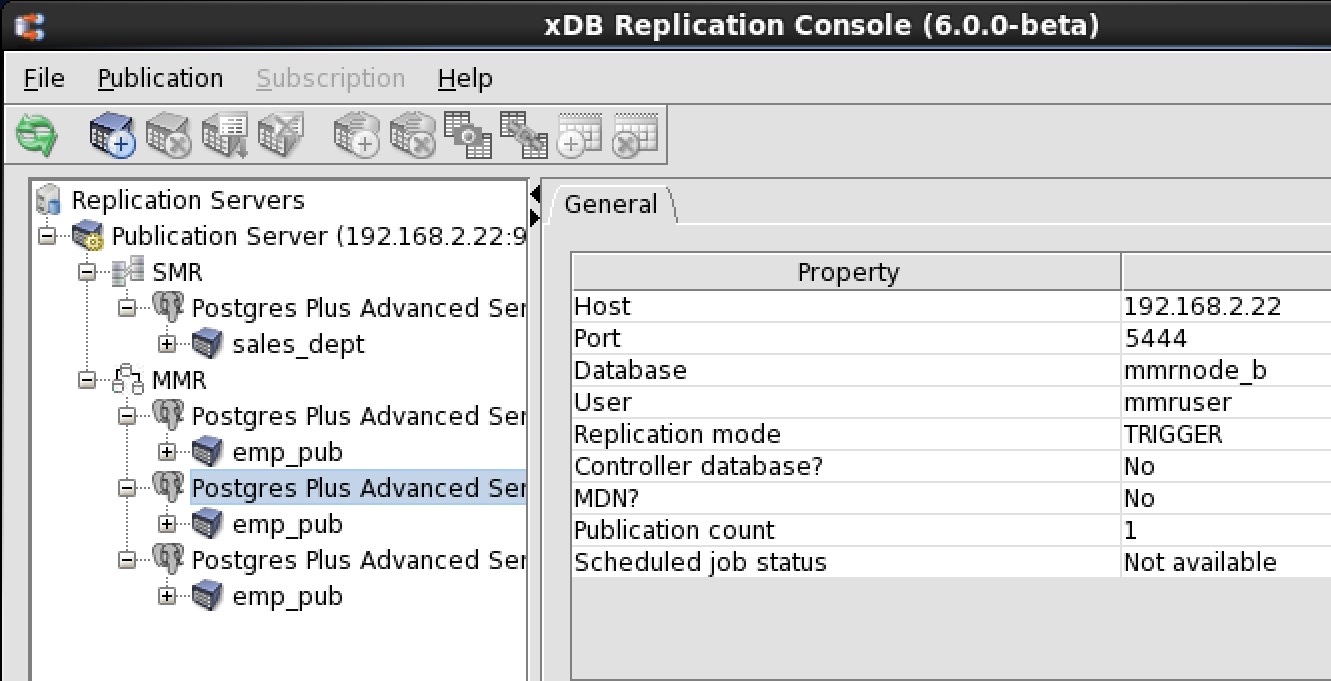
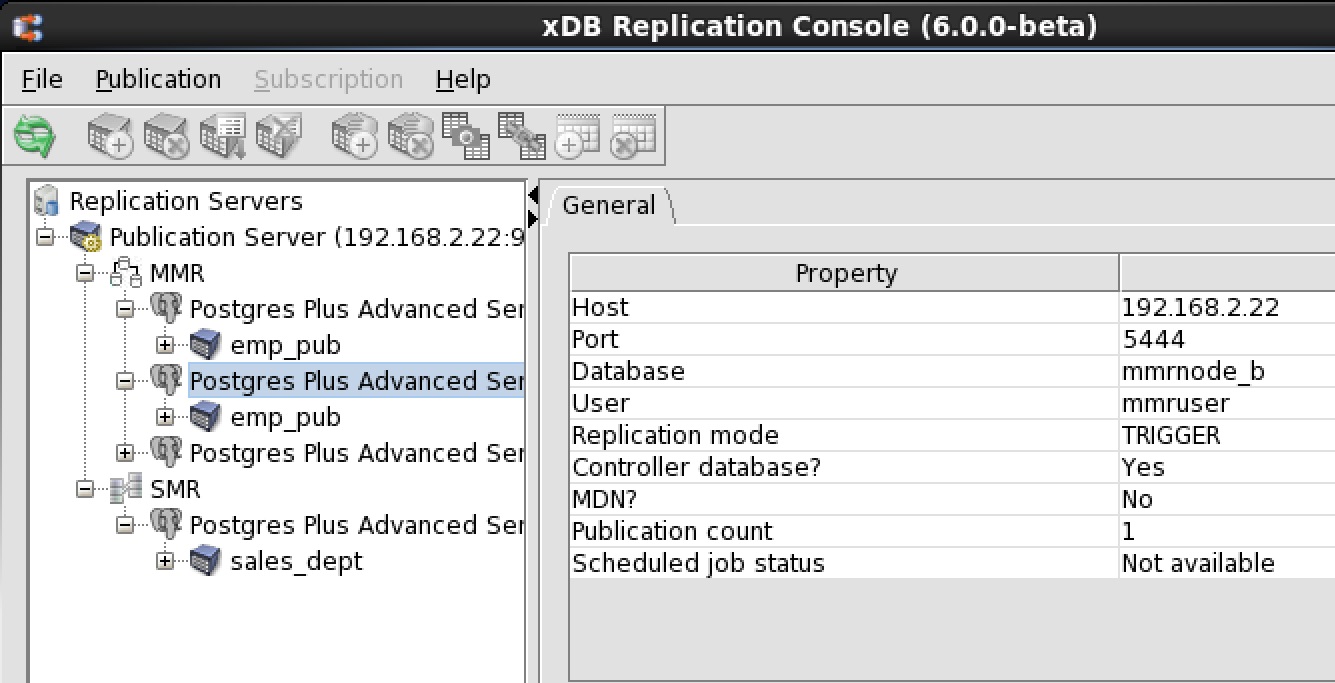
7.8 DDL変更の複製
•
• DDL変更のレプリケーション機能は、一つ以上の受け入れALTER TABLE文を。ステートメントは、テキストファイルを使用するか、[パブリケーションテーブルの変更]ダイアログボックスに直接入力することで提供できます。後者の場合は、ステートメントをコピーしてダイアログボックスに貼り付けるか、ステートメントを直接入力します。その後、DDL変更レプリケーション機能は次のアクションを実行します。
• ALTER TABLEステートメントを、シングルマスターレプリケーションシステムのパブリケーションデータベースとサブスクリプションデータベース、またはマルチマスターレプリケーションシステムのすべてのマスターノード(マスター定義ノードを含む)の適切なターゲットテーブルに適用します。DDL変更レプリケーション機能で受け入れられるALTER TABLEステートメントの構文は次のとおりです。どこ action 、次のいずれかになります。[デフォルト dflt_expr ]DROP [COLUMN] column_name [RESTRICT][COLLATE " collation "][USING data_type_expr ]列のDEFAULT値を設定します。注: OracleまたはSQL Serverがサブスクリプションデータベースの場合、 SET DEFAULT句はサポートされません。ドロップ DEFAULT列の値を:ALTER [COLUMN] column_name DROP DEFAULT注: OracleまたはSQL Serverがサブスクリプションデータベースである場合、 DROP DEFAULT句はサポートされません。ALTER [COLUMN] column_name SET NOT NULLALTER [COLUMN] column_name DROP NOT NULL
• 各 ALTER TABLEステートメントはセミコロンで終了し、別の行で開始する必要があります。
• Postgres ALTER TABLEステートメントはステートメントごとに複数のアクションを許可しますが、xDB DDL変更レプリケーション機能はALTER TABLEステートメントごとに1つのactionのみを許可します。
•
• DROP COLUMNアクションは、テーブルの主キーの一部を構成する列に指定することはできません。table_name を含むスキーマの名前 。この値は大文字と小文字が区別されます。RENAME COLUMN句で指定された列の新しい名前 。UNIQUEまたはCHECK 制約などの列制約 。列制約の詳細については、次の場所にあるPostgreSQLコアドキュメントのCREATE TABLE SQLコマンドを参照してください。
https://www.postgresql.org/docs/current/static/sql-createtable.htmlDROP COLUMNそれに依存するオブジェクトが存在する場合句、列を削除しないでください。これがデフォルトです。 注: CASCADEオプションは、DDL変更複製機能ではサポートされていないため、指定できません。次のクエリは、 DDL変更レプリケーション機能が前述のALTER TABLEステートメントをedb.empテーブルに適用した後にtitle列に割り当てられた値を示しています 。 title列のこの変更と値の割り当ては、シングルマスター複製システムのすべてのサブスクリプションデータベース、またはマルチマスター複製システムのすべてのマスターノードで発生します。DDL変更レプリケーション機能は、xDBレプリケーションコンソール(セクション 7.8.2を 参照 )またはxDBレプリケーションサーバーCLI(セクション8.3.30を参照) から呼び出すことができます 。DDLステートメントは 、操作の過程でターゲットテーブルが排他的にロックされるように制御された方法で実行されます(構成オプション ddlChangeTableLock デフォルト設定により )。これは、DDL変更レプリケーションプロセスによってレプリケーショントリガーとシャドウテーブルが変更されている間、トランザクションの損失を回避するために行われます。 DDL変更レプリケーションがそのテーブル、そのトリガー、およびシャドウテーブルで行われている間、一度に1つのターゲットテーブルのみがロックされます。保留中のトランザクションのバックログがある場合は、DDL変更レプリケーションを長時間実行しないように、DDL変更レプリケーションを実行する前に明示的な同期レプリケーションを実行することをお勧めします。注: ddlChangeTableLockをfalse設定すると、DDL変更レプリケーションプロセス中の各ターゲットテーブルの排他的取得をオフにできfalse 。ただし、これは、ターゲットテーブルに対して実行されている書き込みトランザクションがない場合にのみ行う必要があります。そうでない場合、レプリケーションシステムによってトランザクションが記録されない場合があります。 ddlChangeTableLock構成オプションの追加情報については、セクション10.4.1.11を参照してください。
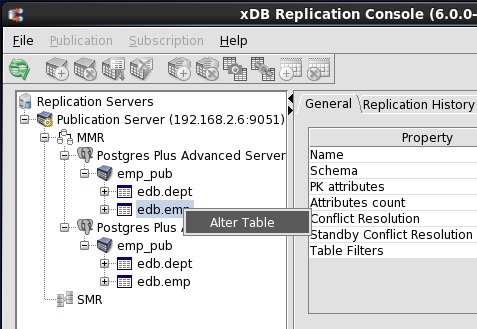
• パブリケーションサーバーの構成オプション ddlChangeTableLockがデフォルト値のtrueに設定されている場合、DDLの変更が適用されるテーブルで排他テーブルロックが要求されます。別のアプリケーションがすでにテーブルにロックを設定している場合、2分前に待機時間があり、その後ロックが解除されない場合、DDL変更レプリケーションプロセスは中止されます。 ddlChangeTableLockがfalseに設定されてfalse場合、排他的なテーブルロックは要求されません。
• DDLステートメントは、ターゲットテーブルに対して実行されます。それに応じて、レプリケーショントリガーとシャドウテーブルが変更されます。エラーが発生した場合、ユーザーに通知され、操作は中止されます。場合 ddlChangeTableLockに設定されているtrue 、排他ロックが解除されます。手順1:ファイルを使用してパブリケーションテーブルにALTER TABLEステートメントを提供する場合は、テキストファイルを準備します。 xDBレプリケーションコンソールを開くオペレーティングシステムアカウントでこのテキストファイルにアクセスできることを確認してください。ステップ2:変更するテーブルを含むパブリケーションの親であるノードを持つパブリケーションサーバーが実行中であり、使用しているxDBレプリケーションコンソールに登録されていることを確認します。パブリケーションサーバーの起動と登録の手順については、セクション5.2.1を参照してください。ステップ3:シングルマスターレプリケーションシステムのパブリケーションデータベースの下、またはマルチマスターレプリケーションシステムのマスター定義ノードの下で、テーブルのテーブルノードのセカンダリマウスボタンをクリックしてパブリケーションテーブルの変更ダイアログボックスを開きます。変更して、テーブルの変更を選択します。ステップ4: [パブリケーションテーブルの変更]ダイアログボックスで、 ALTER TABLEステートメントをテキストファイルに保存した場合、[DDLスクリプトファイル]オプションが選択されていることを確認し、このファイルを参照して[OK]ボタンをクリックします。または、 ALTER TABLEステートメントを直接入力する場合は、DDLスクリプトファイルオプションではなくDDLスクリプトオプションを選択します。ソースからALTER TABLEステートメントを直接入力するか、コピーしてテキストボックスに貼り付けます。 OKボタンをクリックします。ステップ5: DDL replicated successfullyメッセージボックスが表示されたら、DDLの変更はすべてのデータベースで成功しました。 OKボタンをクリックします。
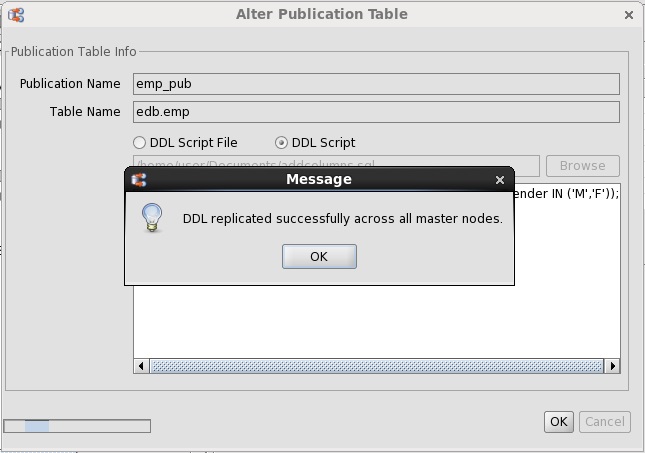
• ALTER TABLEステートメントの変更は、レプリケーションシステムの各データベースのターゲットテーブルに正常に適用されましたか?
•
• トリガーベースの方法の場合 、 ALTER TABLEステートメントを説明するために、レプリケーションシステムの各データベースの_edb_replicator_pubスキーマにあるシャドウテーブル RRST_ schema _ table変更されましたか?
xDB Replication Serverのスナップショットレプリケーション機能以外の方法を使用して、ターゲットテーブル(シングルマスターレプリケーションシステムのサブスクリプションテーブル、またはマルチマスターレプリケーションシステムの非MDNノード)を最初にロードする必要がある場合があります。 。これは、 オフラインスナップショットの 使用と呼ばれます。更新の1つが新しい行の挿入であり、この新しい行がすでにオフラインスナップショットからロードされたターゲットテーブルにある場合、パブリケーションサーバーがこのための INSERTステートメントを含むバッチを適用しようとすると、重複キーエラーが発生します行。重複キーエラーにより、バッチ全体が強制的にロールバックされます。これにより、まだターゲットテーブルに引き継がれていない可能性があるバッチ内の更新が除外されます。ターゲット表に適用されていないソース表に更新があったため、ソース表とターゲット表は一貫性がなくなりました。注:バッチ内のUPDATEおよびDELETEステートメントを、これらの更新によって既に変更されているターゲットテーブルに適用する効果は、 INSERTステートメントの繰り返しの適用と同じ問題を引き起こしません。 UPDATEステートメントは、行を同じ値に2回変更するだけです。 DELETEステートメントが行に影響しない場合、これはデータベースサーバーによってエラーと見なされないため、バッチのロールバックは発生しません。batchInitialSync第1の同期レプリケーションは、バッチまたは非バッチモードで発生するかどうかの設定オプションを制御します。ソーステーブルに更新が発生し、トランザクションがトリガーベースのメソッドのシャドウテーブルに蓄積されるアクティブなレプリケーションシステムでオフラインスナップショットを使用している場合、 batchInitialSyncをfalseに設定して最初の同期レプリケーションを実行することをお勧めしfalse非バッチモード。注:オフラインスナップショットを使用して、ログベースの方法を使用するアクティブなレプリケーションシステムにサブスクリプションまたはマスターノードを追加することはできません。ログベースの方法の場合、オフラインスナップショットは、システムの初期構成にのみ使用でき、パブリケーションデータベースまたはマスターノードがトランザクションをアクティブに受信した後、追加のノードで更新することはできません。オフラインスナップショットを使用して、まだアクティブ化されていないレプリケーションシステム全体を最初に作成し、オフラインスナップショットの内容がすべてソーステーブルとターゲットテーブルで一貫していると想定される場合、 batchInitialSyncはデフォルト設定のままにしてbatchInitialSyncことができます最初の同期レプリケーションは重複した更新を適用しないと想定されるため、 true 。注:これらのオプションは、パブリケーションサーバーにのみ適用されます。offlineSnapshotオプションがに設定されなければならないtrueシングルマスタレプリケーションシステムのサブスクリプションを作成する前に、またはマルチマスター・レプリケーション・システムのマスターノードを追加する前に。デフォルト値は falseです。trueに設定すると、サブスクリプションがシングルマスターレプリケーションシステムで定義されている場合、サブスクリプションテーブル定義を作成して外部ソースからロードすると想定されるため、 offlineSnapshotオプションはサブスクリプションスキーマとテーブル定義の通常の作成を防ぎます出版物以外。マルチマスターレプリケーションシステムにマスターノードを追加する場合、[パブリケーションスキーマのレプリケート]および[初期スナップショットの実行]チェックボックスをオフのままにします(セクション 6.3を 参照 )。場合 offlineSnapshotに設定されているtrue 、これはカラムに設定することにより制御スキーマ内直接影響有するhas_initial_snapshot値をO列で表されるターゲットサブスクリプションまたはマスターノードのために使用されるオフラインスナップショットを示しています。列has_initial_snapshotは、シングルマスター複製システムの場合はテーブルxdb_mmr_pub_groupに、マルチマスター複製システムのhas_initial_snapshotはテーブルxdb_publication_subscriptions設定されます。batchInitialSyncオプションはオフラインスナップショットからターゲット表をロードした後最初の同期は、バッチモード(デフォルト)または非バッチモードで行われているかどうかを制御するために使用されます。offlineSnapshot設定オプションは、最初に設定されていなければならないtrue前にサブスクリプションを作成したり、追加のマスターノードを追加します。非バッチモード同期は、 batchInitialSyncがfalseあり、コントロールスキーマのhas_initial_snapshot列がofflineSnapshotオプションの説明offlineSnapshot O値に設定されている場合にofflineSnapshotます。デフォルト値は trueです。オフラインスナップショットを使用して、シングルマスターレプリケーションシステムのサブスクリプションテーブルを最初にロードできます。複数のサブスクリプションを対象とするパブリケーションの場合、セクション 5.4.1で説明されているデフォルトのxDB Replication Serverスナップショットレプリケーションプロセスを使用してサブスクリプションの一部を作成できますが、他のサブスクリプションはオフラインスナップショットから作成できます。注:サブスクリプションを作成する前に、ステップ3および4を実行する必要があります。オフラインスナップショットから追加のサブスクリプションを作成するたびに、手順3〜9を繰り返すことができます。手順3:これらのオプションが以下で説明するように設定されていない場合、パブリケーションサーバーの構成ファイルを変更します。
• offlineSnapshotオプションをtrue 変更しtrue 。パブリケーションサーバーを再起動すると、 offlineSnapshotをtrue設定すると、1)サブスクリプションを作成しても、既定の設定で行われるようにサブスクリプションデータベースにスキーマとサブスクリプションテーブルの定義が作成されません。オフラインスナップショットを示すコントロールスキーマの列は、このサブスクリプションの読み込みに使用されます。ステップ4:パブリケーションサーバーの構成ファイルがステップ3で変更された場合、パブリケーションサーバーを再起動します。パブリケーションサーバーを再起動する方法については、セクション5.2.1を参照してください。手順5:サブスクリプションデータベースで、スキーマ、サブスクリプションテーブル定義を作成し、オフラインデータソースからサブスクリプションテーブルを読み込みます。セクション5.3.2で使用されるサブスクリプションデータベースのユーザー名には、この手順で作成されたデータベースオブジェクトに対する完全な権限が必要です。また、ターゲット定義を手動で作成するときにこれらの同じ規則に従う必要があるため、xDB Replication Serverが各データベースタイプのパブリケーションからサブスクリプション定義を作成する方法に関する規則に関するセクション5.3.2の冒頭を確認してください。ステップ8:あなたはこの時点では、オフラインのスナップショットを使用して、他のサブスクリプションをロードする予定がない場合は、変更offlineSnapshotにオプションのバックfalseとbatchInitialSyncにオプションtrueパブリケーションサーバーの設定ファイルのを。ステップ9:ステップ8でパブリケーションサーバーの構成ファイルを変更した場合は、パブリケーションサーバーを再起動します。オフラインスナップショットを使用して、マルチマスターレプリケーションシステムのマスターノードを最初にロードできます。セクション 6.3で 説明されているようにマスターノードを定義する場合、またはセクション6.5.1で説明されているオンデマンドスナップショットを使用する場合、xDB Replication Serverスナップショットレプリケーション機能を使用して一部のマスターノードをロードできますが、他のマスターノードはロードできますオフラインスナップショットから。注:アクティブに使用されているマルチマスターレプリケーションシステムでは、オフラインスナップショットはサポートされていません。アクティブなマスターノードでの変更は、別のノードのデータをダンプまたは復元するオフラインスナップショットプロセス中に失われます。注:オフラインスナップショットによってロードされるマスターノードを追加する前に、次の手順を実行する必要があります。オフラインスナップショットから追加のマスターノードを作成するたびに、手順2〜10を繰り返すことができます。手順2:複製システムにスケジュールが定義されていないことを確認します。定義されていない場合は、次の手順の実行中にスケジュールを削除します。スケジュールを削除する方法については、セクション7.3.2を参照してください。手順3:これらのオプションが以下で説明するように設定されていない場合、パブリケーションサーバーの構成ファイルを変更します。
• offlineSnapshotオプションをtrue 変更しtrue 。パブリケーションサーバーを再起動すると、 offlineSnapshotをtrue設定すると、マスターノードを追加すると、コントロールスキーマの列が設定され、このマスターノードの読み込みにオフラインスナップショットが使用されることが示されます。ステップ4:パブリケーションサーバーの構成ファイルがステップ3で変更された場合、パブリケーションサーバーを再起動します。パブリケーションサーバーを再起動する方法については、セクション5.2.1を参照してください。手順5:新しいマスターノードとして使用するデータベースで、スキーマ、テーブル定義を作成し、オフラインデータソースからテーブルを読み込みます。ステップ8:あなたはこの時点では、オフラインのスナップショットを使用して、他のマスター・ノードをロードする予定がない場合は、変更offlineSnapshotにオプションのバックfalseとbatchInitialSyncにオプションtrueパブリケーションサーバーの設定ファイルのを。ステップ9:ステップ8でパブリケーションサーバーの構成ファイルを変更した場合は、パブリケーションサーバーを再起動します。
Advanced Serverを使用している場合、 CREATE TABLE文を使用して、 Oracleデータベースと互換性のあるパーティション構文を使用してパーティション表を作成できます。 Oracleデータベースと互換性のあるパーティションの詳細については、次の場所にあるEnterpriseDB Webサイトから入手可能な 『 EDB Postgres Advanced Server 10.0データベース互換性Oracle開発者ガイド 』の第10章「テーブルパーティション」を参照してください。PostgreSQLまたはAdvanced Serverのバージョン10以降を使用している場合、 宣言的なパーティション分割を使用してパーティションテーブルを作成できます。宣言的なパーティションテーブルを作成するためのCREATE TABLE構文は、Oracleデータベースと互換性のあるパーティションに似ていますが、宣言的なパーティションテーブルの個々のパーティションは、独自のCREATE TABLEステートメントで個別に作成する必要があります。ネイティブのPostgreSQLバージョン9.6以前を使用している場合、最初に親テーブルを作成し、次に親の列を継承する1つ以上の子テーブルを作成するテーブル継承 と呼ばれる手法を使用する必要があります 。各子は、親の列定義を含むことを除いて、それ自体が独立した表です。次に、親テーブルでトリガーを定義して、挿入された行をどの子テーブルに保存するかを指示します。テーブル継承はAdvanced Serverでも使用できます。このドキュメント全体で例として使用されるempテーブルには、3つのパーティション化テクニックがすべて示されています。パーティションテーブルは、次のセクションのマルチマスターレプリケーションシステムのパブリケーションで使用されます。注: xDB Replication Serverを使用して複製される宣言パーティションテーブルを作成する場合、 PRIMARY KEY制約は、パーティション化される親テーブルのCREATE TABLEステートメントではなく、個々のパーティションのCREATE TABLEステートメントに含まれている必要があります。次のクエリは、子テーブル間で行が物理的にどのように分割されるかを示しています。 ONLYキーワードを使用すると、 SELECTステートメントの指定されたテーブルにのみ行が作成され、その子からは作成されません。セクション 7.10.2は、Oracleデータベースと互換性のあるパーティションを使用する場合、またはPostgres 10以降のデータベースサーバーで宣言パーティションを使用する場合のパブリケーションの作成を示しています。6.2 項の指示に従って、パーティション化された表を含むパブリケーションとともにマスター定義ノードを作成します。 (シングルマスターレプリケーションシステムの場合、セクション5.2の指示に従って、パブリケーションとともにパブリケーションデータベースを作成します。)セクション 6.3で 説明されているように、追加のマスターノードを作成します 。 (シングルマスターレプリケーションシステムの場合、セクション5.3の指示に従ってサブスクリプションデータベースとサブスクリプションを作成します。)
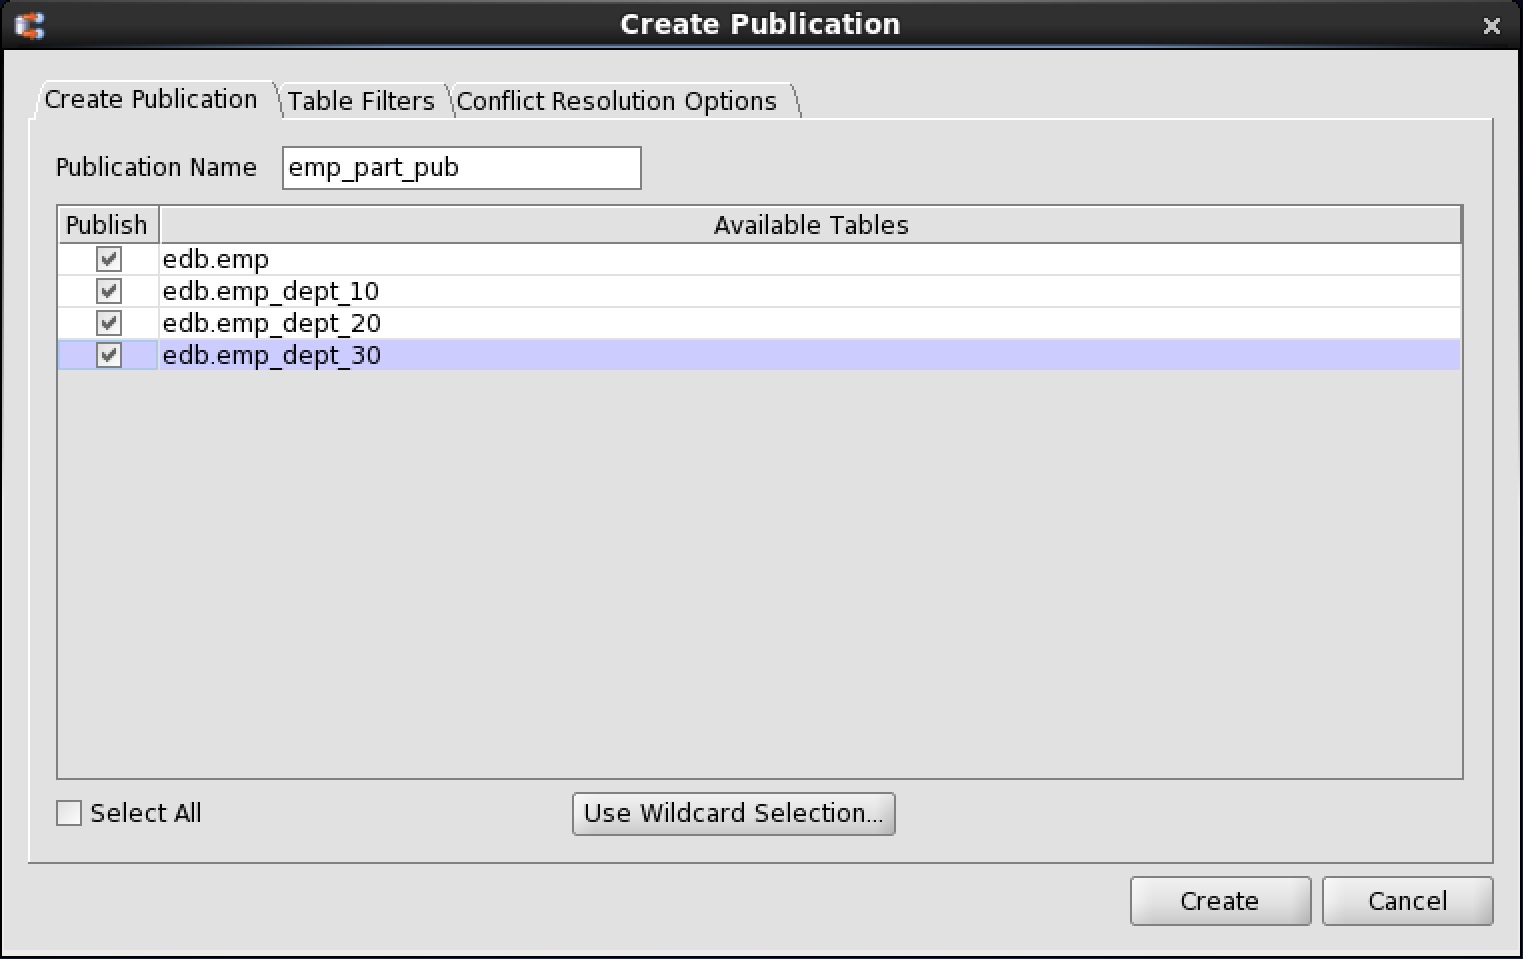
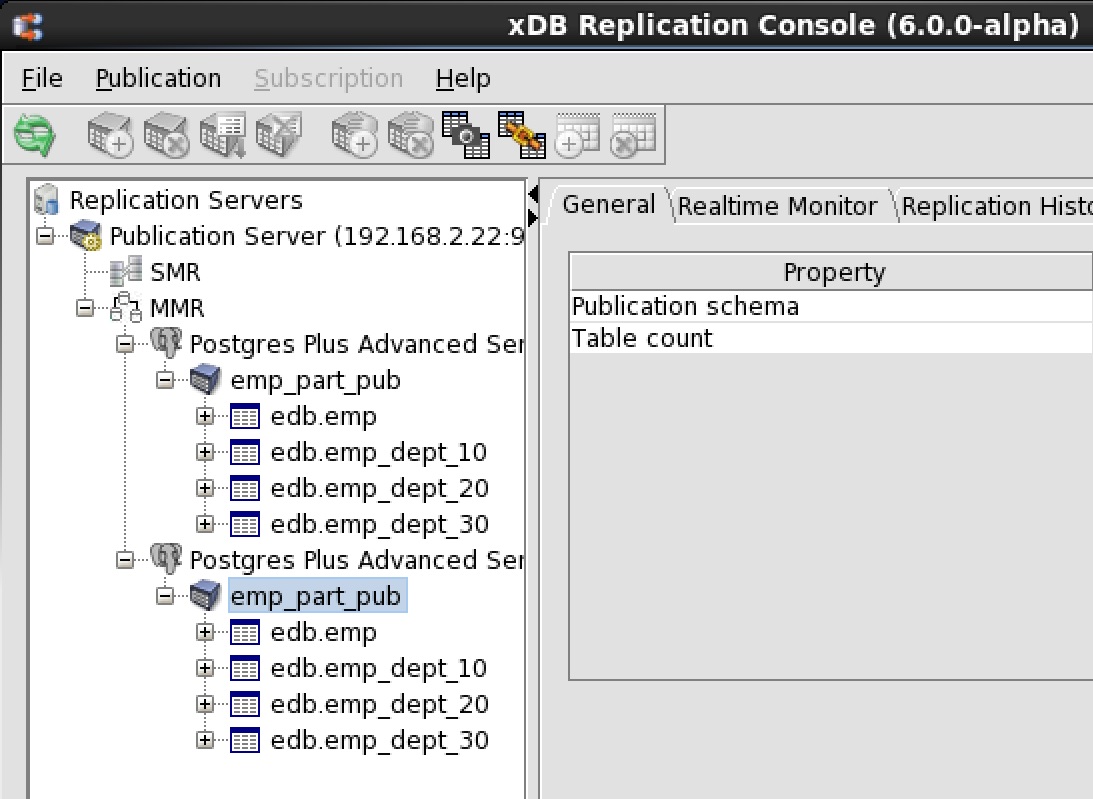
• 6.2 項の指示に従って、パーティション化された表を含むパブリケーションとともにマスター定義ノードを作成します。 (シングルマスターレプリケーションシステムの場合、セクション5.2の指示に従って、パブリケーションとともにパブリケーションデータベースを作成します。)セクション 6.3で 説明されているように、追加のマスターノードを作成します 。 (シングルマスターレプリケーションシステムの場合、セクション5.3の指示に従ってサブスクリプションデータベースとサブスクリプションを作成します。)
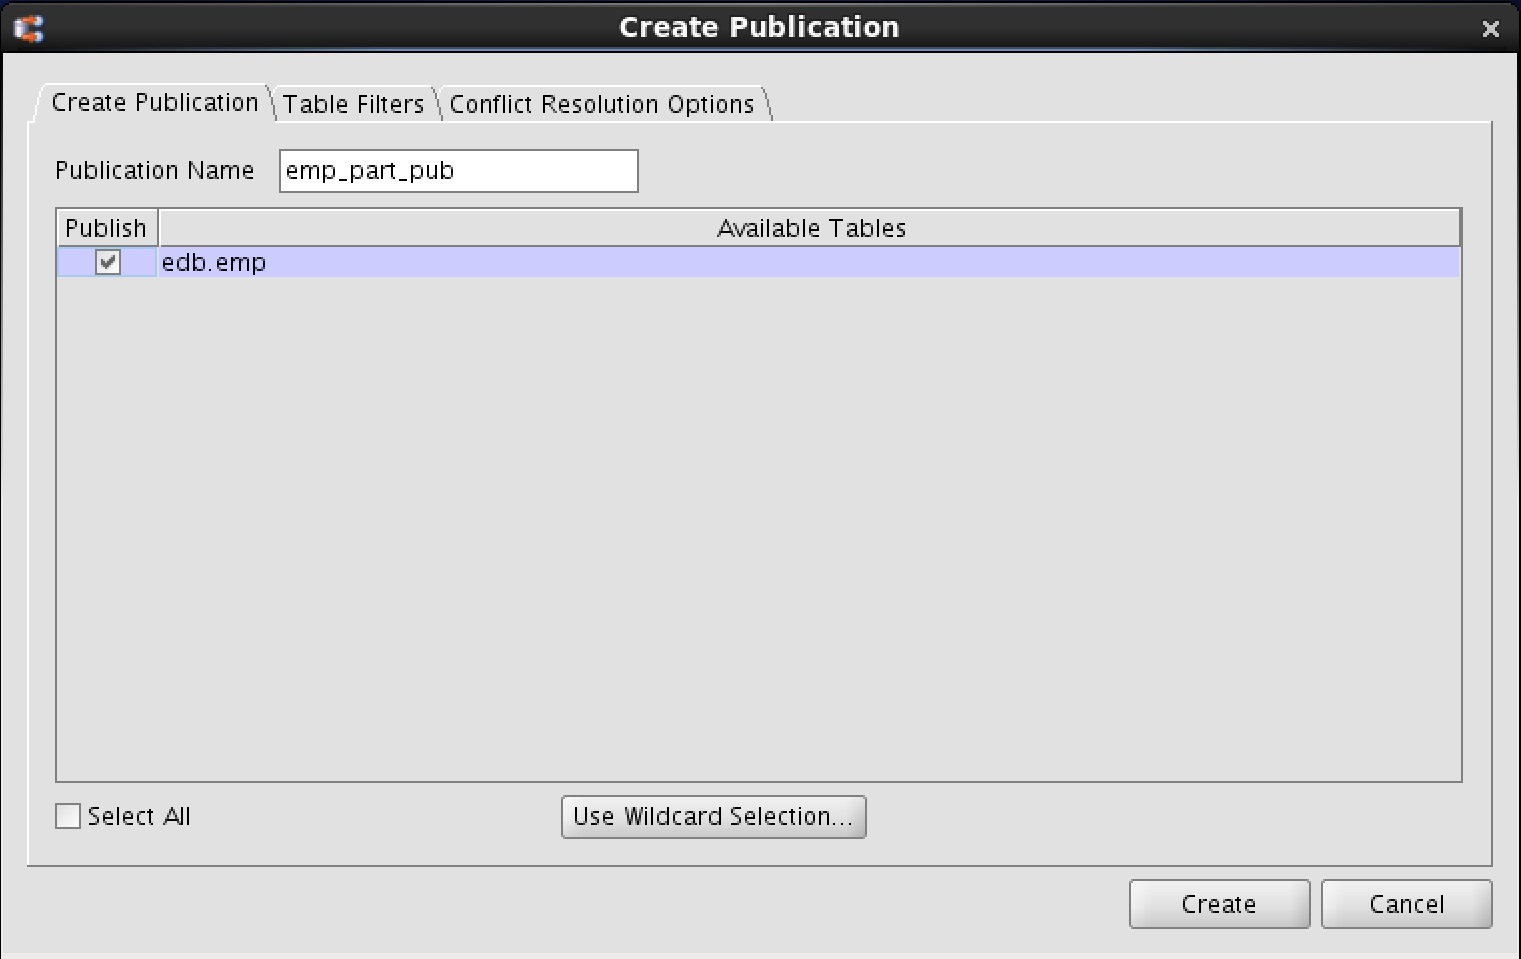
注: SSL接続は、xDB Replication ConsoleまたはxDB Replication Serverコマンドラインインターフェースからは使用されません。 xDBユーザーインターフェイスは、パブリケーションサーバーおよびサブスクリプションサーバーと通信し、パブリケーション/サブスクリプションデータベースまたはマスターノードに接続します。注: SSLを使用したMigration Toolkit接続は、パブリケーションサーバーとサブスクリプションサーバーのSSL接続のコンテキスト内で発生します。したがって、Migration Toolkit SSL接続に対して実行する必要のある個別の手順はありません。Java トラストストアは、Javaクライアント(パブリケーションサーバーおよびサブスクリプションサーバー)がSSL接続を開始するサーバーの信頼性を検証するために使用する認証局(CA)証明書を含むファイルです。Java キーストアは、秘密鍵と公開鍵、およびそれらに対応する証明書を含むファイルです。キーストアは、xDB Replication Server SSL接続に使用されるサーバーへのクライアント認証に必要です。
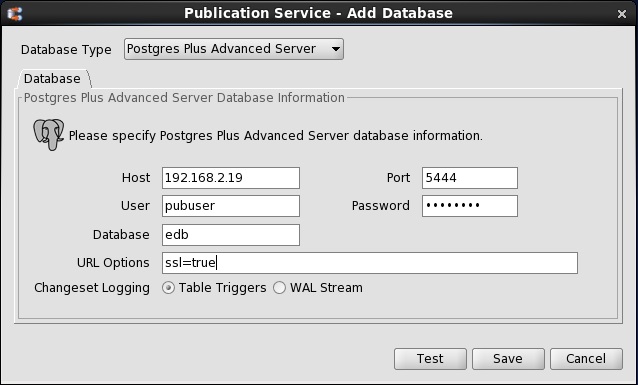
•
• ステップ1:証明書署名要求(CSR)を作成します。注:証明書を作成する場合、共通名フィールド(この例ではCN=enterprisedbとして指定)に指定する値は、定義時に使用する[データベースの追加]または[データベースの更新]ダイアログボックスの[ユーザー]フィールドで指定するデータベースユーザー名である必要がありますパブリケーションデータベース(セクション5.2.2を参照)、サブスクリプションデータベース(セクション5.3.2を参照)、またはマスターノード(セクション6.2.2および6.3を参照)。あるいは、 pg_ident.confファイルで定義されているユーザー名マップを使用して、共通名とデータベースユーザー名の柔軟性を高めることができます。手順8および9では、ユーザー名マップの使用について説明します。ステップ2:自己署名証明書を生成します。ステップ4:現在冗長な証明書署名要求( server.csr )を削除します。ステップ6:証明書ファイルと秘密鍵ファイルにファイルの所有権と許可を設定します。Postgresデータベースサーバーのdataサブディレクトリを所有するオペレーティングシステムアカウントに所有権を設定します。これは、Postgresデータベースサーバーのインストール時に選択したインストールモード(Oracle互換またはPostgreSQL互換)に応じてenterprisedbまたはpostgresいずれかenterprisedb 。ステップ7: postgresql.confファイルで、次の変更を行います。ステップ8: pg_hba.confファイルを変更して、目的のパブリケーション、サブスクリプション、またはマスターノードデータベースでSSLの使用を有効にします。認証方法は 、証明書の共通名(この例ではenterprisedb )を使用して認証が実行されるクライアントからのSSL証明書を要求するために、オプションclientcert=1でcert 設定されます。map=sslusersのオプションは、名前のマッピングというsslusersで定義されているpg_ident.confファイルには、認証のために使用されるべきです。このマッピングにより、証明書の共通名と接続を試行するデータベースユーザー名がpg_ident.confファイルにリストされているSYSTEM-USERNAME/PG-USERNAMEペアと一致する場合、データベースへの接続が許可されます。ステップ9:以下は、 map=sslusersオプションによるpg_hba.confファイルに関連するpg_ident.confファイル内のユーザー名マップを示しています。これらのユーザー名マップを使用すると、xDBレプリケーションコンソールでパブリケーション、サブスクリプション、またはマスターノードデータベースを追加するときに、[データベースの追加]または[データベースの更新]ダイアログボックスの[ユーザー]フィールドでデータベースユーザー名pubuser 、 subuser 、 mmruser 、またはenterprisedbを指定できます。手順10: Postgres構成ファイルに変更を加えた後、Postgresデータベースサーバーを再起動します。PostgresデータベースサーバーでSSLを構成した後、次の手順では、パブリケーションサーバーとサブスクリプションサーバー(JDBCクライアント)の証明書とキーストアファイルを生成する例を示します。手順1: Postgresデータベースサーバーのdataサブディレクトリにあるserver.crtファイルとserver.keyファイルを使用して、これらのファイルのコピーを作成し、パブリケーションサーバーとサブスクリプションサーバーが実行されているホストに移動します。ステップ2: xdb.crtコピーを作成します。ステップ3:ファイルxdb_root.crt Distinguished Encoding Rules(DER)形式を作成します。このファイルの生成されたDER形式はxdb_root.crt.derです。次のステップのkeytoolプログラムでは、ファイルのDER形式が必要です。ステップ4:使用keytoolキーストアファイル(作成するためのプログラムxdb.keystore使用) xdb_root.crt.der入力としてを。このプロセスにより、Postgresデータベースサーバーの証明書がキーストアファイルに追加されます。keytoolプログラムは、下にありますbinのJava Runtime Environmentのインストールのサブディレクトリ。ステップ5:前のステップで指定された新しいパスワードの暗号化された形式を生成します。暗号化されたパスワードは 、パブリケーションサーバーSSL接続用のパブリケーションサーバー構成ファイルと、サブスクリプションサーバーSSL接続用のサブスクリプションサーバー構成ファイルの sslTrustStorePassword構成オプションで指定する必要があります 。 (パブリケーションサーバーとサブスクリプションサーバーの構成ファイルについては、セクション10.4.1を参照してください。)xDB Replication Server CLIの encryptコマンドを使用してパスワードを encrypt ます 。次の例は、ファイルinfile含まれるパスワードを暗号化するこのプロセスを示しています。ステップ7:前のステップで指定した新しいパスワードの暗号化された形式を生成し、暗号化されたパスワードは 、パブリケーションサーバーSSL接続用のパブリケーションサーバー構成ファイルおよびサブスクリプションサーバーSSL接続用のサブスクリプションサーバー構成ファイルの sslKeyStorePassword構成オプションで指定する必要があります 。ステップ9:パブリケーションサーバーとサブスクリプションサーバーの設定ファイルでは、ファイルの場所を設定xdb.keystoreしてsslTrustStoreオプションとファイルの場所xdb_pkcs.p12とsslKeyStoreオプション。ステップ10:パブリケーションサーバーとサブスクリプションサーバーを再起動します。
• シングルマスターレプリケーションシステムでSSL接続を使用するには、パブリケーションデータベースのセクション 5.2.2およびサブスクリプションデータベースのセクション5.3.2に示すように、URLオプションを指定する必要があります。
• マルチマスター複製システムでSSL接続を使用するには、マスター定義ノードについてはセクション 6.2.2に、非MDNノードについてはセクション6.3に示すように、URLオプションを指定する必要があります 。注: xDB Replication ServerデータベースへのSSL接続を使用したくない場合は、[データベースの追加]または[データベースの更新]ダイアログボックスの[URLオプション]フィールドからssl=trueテキストを完全に削除する必要があります。 trueをfalse変更するだけでは、SSLオプションを無効にする効果はありません。sslTrustStoreTypeオプションは、トラストストア・フォーマットを指定します。このオプションをクライアントのJavaトラストストア形式に設定します。sslTrustStoreType= truststore_formatトラストストアの一般的なデフォルトの場所は、 cacertsという名前のファイルのディレクトリ JAVA_HOME /jre/lib/securityまたはJAVA_HOME /lib/securityです。 ( JAVA_HOMEはJavaインストールディレクトリです。)sslTrustStore = truststore_filexDB Replication Server CLIの encryptコマンド(セクション8.3.4を参照) を使用してJavaシステムのトラストストアのパスワードを暗号化し、 sslTrustStorePasswordオプションで暗号化されたパスワードを指定します。sslTrustStorePassword = encrypted_passwordsslKeyStoreTypeオプションは、キーストアのフォーマットを指定します。このオプションをクライアントのJavaキーストア形式に設定します。sslKeyStoreType= keystore_formatsslKeyStore = keystore_filexDB Replication Server CLIの encryptコマンド(セクション8.3.4を参照) を使用してJavaシステムキーストアのパスワードを暗号化し、 sslKeyStorePasswordオプションで暗号化されたパスワードを指定します。sslKeyStorePassword = encrypted_password
この章では、xDB Replication Serverコマンドラインインターフェイス(CLI) の構文と使用方法について説明します 。このユーティリティプログラムは、xDBレプリケーションコンソールに代わるコマンドライン駆動型です。xDB Replication Server CLI を使用してレプリケーションシステムを作成する手順は 、xDB Replication Consoleを使用する場合に必要な手順と同じです。レプリケーションシステムの論理コンポーネントは、xDBレプリケーションコンソールでレプリケーションシステムを作成するときと同じ属性セットで、同じ順序で作成する必要があります。
8.1 前提条件の手順xDB Replication Serverのインストール時にxDB Replication Consoleコンポーネントが選択されている場合、 xDB Replication Server CLIが含まれています 。 xDB Replication Server CLIは、ディレクトリXDB_HOME /binあるJavaアプリケーションです。ステップ3:次の説明に従って、Javaランタイム環境を設定します。xDB Replication Server CLIを実行するホスト上に、Javaランタイム環境( JRE )が存在し、xDBの実行に使用されるオペレーティングシステムユーザー名のパスにJavaランタイムbinディレクトリが含まれている必要があります。 Replication Server CLI 。xDBスタートアップ構成ファイル xdbReplicationServer- xx .configには、xDB Replication Serverのインストール中に検出されたJREランタイムプログラムのパスが含まれています。以下は、xDBスタートアップコンフィギュレーションファイルの例です(このファイルの場所については、セクション3.5を参照してください)。Windowsシステムでは、マイコンピュータの[プロパティ]ダイアログボックスを開き、[システムの詳細設定]を選択して、[環境変数]をクリックします。 Pathシステム環境変数を編集して 、Javaランタイム環境のbinディレクトリを含めます。または、次の例のようにコマンドプロンプトウィンドウを開いたときに、現在のセッションだけのパスを設定できます。
8.2 一般的な使用法xDB Replication Consoleを実行できる任意のホストからxDB Replication Server CLIを実行できます。 xDB Replication Server CLIは、 javaランタイムプログラムを実行し、 javaプログラムに次の引数を指定することにより実行されます。
•
• xDB Replication Server CLIコマンド各xDB Replication Server CLIコマンドの一般的な構文は次のとおりです。上記の構文図では、 commandはxDB Replication Server CLIコマンドの名前です。コマンド名の前には、ハイフン文字(-)を付ける必要があります。コマンドがパブリケーションに作用する場合、 pubnameで表されるpubnameが指定されます。コマンドがサブスクリプションに作用する場合、 subnameで表されるサブスクリプション名が指定されます。特定のコマンドでは、複数のパブリケーション名または複数のサブスクリプション名を指定できます。java -jar XDB_HOME /bin/edb-repcli.jar注: Enterキーを押す前にオペレーティングシステムの継続文字(たとえば、Linuxではバックスラッシュ文字(\)、Windowsではキャレット文字(^))を入力すると、次の物理行にコマンドを継続できます。8.2.2 Getting Helpこのセクションでは、多くのコマンドで必要とされるrepsvrfileという名前のrepsvrfile Replication Server CLIパラメーターの構文と使用法について説明します 。パラメータrepsvrfile使用は、xDB Replication Consoleでパブリケーションサーバーまたはサブスクリプションサーバーを登録するプロセスと同等のxDB Replication Server CLIです。セクション 5.2.1は複製システムを構築する最初のステップが出版サーバーを登録することである方法について議論します 。 xDBレプリケーションコンソールでは、登録されたパブリケーションサーバーがレプリケーションツリーのノードとして表示されます。 Publication Serverノードは、レプリケーションシステムの他の論理コンポーネントを追加できるコンテキストを提供します。xDB Replication Server CLI を使用する場合 、レプリケーションシステムの他の論理コンポーネントを関連付けるために使用できるレプリケーションツリーイメージはありません。代わりに、パブリケーションサーバーまたはサブスクリプションサーバーのコンテキストを必要とするxDB Replication Server CLIコマンドを実行するときは、 repsvrfileパラメーターを使用してパブリケーションサーバーのログイン情報またはサブスクリプションサーバーのログイン情報を指定する必要があります。repsvrfileパラメータは、その値として使用したいというパブリケーションサーバーインスタンスまたはサブスクリプションサーバーインスタンスのいずれかのログイン情報を含むテキストファイルへのパスを取ります。 repsvrfileパラメーターを含む一般的なxDB Replication Server CLIコマンド構文を次の図に示します。[-repsvrfile repsvrfile ]XDB Replication ServerのCLIコマンドが表され実行されるcommand 。必要な場合は、パブリケーション名は、で表さpubnameで表現またはサブスクリプションの名前subname次に指定されています。パブリケーションサーバーまたはサブスクリプションサーバーのログイン情報を含むテキストファイルへのパスは、 repsvrfile で表され repsvrfile 。 command使用されるパラメーターとその値は、 parameterとvalue示されparameter 。-repsvrfile repsvrfile 、および- parameterとその値が指定されるコマンドラインの順序は重要ではありません。たとえば、 -repsvrfile repsvrfileは、コマンドラインの最初のパラメーター、コマンドラインの最後のパラメーター、または他のパラメーターの間に指定できます。
•
•
•
• これは、 xDBレプリケーションコンソールを使用している場合に、 パブリケーションサーバーまたはサブスクリプションサーバー を登録するために必要な情報と同じです 。 出版サーバーの登録に関する追加情報に関してセクション5.2.1を見てください。サブスクリプションサーバーの登録については、セクション5.3.1を参照してください。xDB Replication Server CLIを使用する場合、ユーザー名とパスワードを含む特定の情報を保存するためにテキストファイルが使用されます。例は、 repsvrfileパラメーターで使用されるパブリケーションサーバーとサブスクリプションサーバーのログイン情報を含むファイルです。パラメーター repsvrfileで指定されたファイルでは、 passwordフィールドを暗号化された形式のパスワードに設定する必要があります。暗号化されたパスワードを使用すると、ファイルが何らかの形で侵害された場合に、権限のない人がuserとpassword値を使用してパブリケーションサーバーまたはサブスクリプションサーバーにアクセスすることを防ぎます。 (暗号化されたパスワードを使用して、xDBレプリケーションコンソールのダイアログボックスからパブリケーションサーバーまたはサブスクリプションサーバーにアクセスすることはできません。)paramfileコマンドは、テキストファイルに符号化されたXDB Replication ServerのCLIコマンドとそのパラメータを実行することができます。この手法は、繰り返し実行するためにコマンドとそのパラメーターを保存する場合に役立ちます。paramfile を実行するための構文は次のとおりです。java -jar XDB_HOME /bin/edb-repcli.jar-paramfile cmdparamfileテキストファイルcmdparamfileコード化されたxDB Replication Server CLIコマンドとそのパラメーターの構文は 、次のようにコマンドラインプロンプトで指定した場合と同じです。[-repsvrfile repsvrfile ]paramfileコマンドの使用には、次の制限があります。
• xDB Replication Server CLIコマンドで使用されるパラメーターは、すべてcmdparamfileに含まれている必要があります 。一部のパラメーターをcmdparamfileして、コマンドラインで他のパラメーターを指定することはできません。Windowsの場合のみ: -repsvrfileディレクトリパスは、スラッシュ文字またはバックスラッシュ文字で指定できます。ディレクトリ名にスペース文字が含まれる場合は、ディレクトリパス全体を二重引用符で囲みます。注: xDB Replication Server CLIコマンドとそのパラメーターをコマンドラインプロンプトで直接入力するのとは異なり、テキストファイルにコーディングする場合、次の行に進むために継続文字は必要ありません。終了ステータス 0は、実行が成功したことを示します。ゼロ以外の終了ステータスは、障害が発生したことを示します。
Linuxのみ:環境変数、 $? 、終了ステータスが含まれます。Windowsの場合のみ:環境変数%ERRORLEVEL%には、終了ステータスが含まれます。
注:このセクションで説明するほとんどのコマンドは、シングルマスターとマルチマスターの両方のレプリケーションシステムに適用されますが、シングルマスターレプリケーションシステムにのみ適用されるコマンドには、 For SMRのみが記載されています。マルチマスター複製システムにのみ適用されるコマンドは、 For MMRのみで示されています。同じ表記法は、シングルマスター複製システムまたはマルチマスター複製システムにのみ適用されるコマンドパラメーターにも使用されます。このセクションで使用例については、XDBことが想定され 、あなたが行った後にReplication ServerのCLIコマンドが実行されXDB_HOME /bin 、それによっての完全なパスを指定する必要がなくなり、あなたの現在の作業ディレクトリXDB_HOME /binそれぞれ実行するためにedb-repcli.jarファイル。たとえば、xDB Replication Serverがデフォルトのインストールディレクトリにインストールされていると仮定すると、Linuxで次のコマンドを発行しました。例にrepsvrfileパラメーターが表示されるたびに 、ファイル~/pubsvrfileにはパブリケーションサーバーのログイン情報が含まれ、ユーザーのホームディレクトリにありますが、 ~/subsvrfileにはサブスクリプションサーバーのログイン情報が含まれます。 Windowsの場合、同等の使用法は%HOMEPATH%\pubsvrfileおよび%HOMEPATH%\subsvrfileです。このセクションの例はLinuxで実行されたので、Linux継続文字(バックスラッシュ(\))を使用して、xDB Replication Server CLIコマンドを次の行に継続する方法を示します。端末ウィンドウでテキストをラップします。 Windowsの場合、Windows継続文字を使用します。これはキャレット(^)です。8.3.1 Getting Help (help)helpコマンドは、すべてのXDB Replication ServerのCLIコマンドの構文の要約を提供します。versionコマンドは、XDB Replication ServerのCLIのバージョン番号を提供します。repversionコマンドは、XDB レプリケーションServerのバージョン番号を提供します。-repversion -repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。encryptコマンドは、入力ファイルで提供されたテキストを暗号化し、指定した出力ファイルに暗号化された結果を書き込みます。 encryptコマンドを使用して、ユーザー名とユーザーのパスワードを必要とするxDB Replication Server CLIコマンドによって参照されるテキストファイルにコピーできる暗号化されたパスワードを生成します。infile のテキストはMD5暗号化アルゴリズムを使用して処理され、暗号化されたテキストはファイルpwdfile書き込まれます。 infileは暗号化するテキストのみが含まれ、暗号化するテキストの前またはテキストの後に余分な文字や空行がないことを確認してください。infile のテキストの暗号化された形式を含むファイル 。ファイル infileには「パスワード」という単語が含まれています。uptimeのコマンドは、パブリケーションサーバーが完全に起動してからの時間間隔を出力します。-uptime -repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。addpubdbコマンドは、パブリケーションデータベースの定義を追加します。-repsvrfile pubsvrfile-dbhost host-dbport port-dbuser user-database dbname[-urloptions jdbc_url_parameters ][-nodepriority priority_level ]addpubdbコマンドは、新しいパブリケーションデータベース定義を作成します。 addpubdbコマンドは、新しく作成されたパブリケーションデータベース定義に割り当てられた一意のパブリケーションデータベースIDを表示します。パブリケーションデータベースIDは、他のxDB Replication Server CLIコマンドの実行時に操作するパブリケーションデータベース定義を識別するために使用されます。シングルマスターレプリケーションシステムのパブリケーションデータベース定義を追加するときに提供する必要があるデータベース接続情報の詳細については、 セクション 5.2.2を参照してください。マルチマスター複製システムについては、セクション6.2.2および6.3を参照してください。パブリケーションサーバーのログイン情報を含むファイル 。データベースがOracleデータベースの場合は、 oracle 指定します。データベースがOracle互換構成モードのAdvanced Serverデータベースである場合、 enterprisedb指定します。データベースがPostgreSQLデータベースまたはPostgreSQL互換構成モードのAdvanced Serverデータベースである場合、 postgresql指定します。データベースがMicrosoft SQL Serverデータベースの場合、 sqlserver指定します。データベースサーバーが接続を待機しているポート番号 。databaseパラメータでパブリケーションデータベースを識別するためにOracleシステムID(SID)が使用される場合は、 sid 指定します。 databaseパラメータでパブリケーションデータベースを識別するためにOracleサービス名が使用される場合は、 servicename指定します。 注: Oracle 12cの場合、サービス名を使用します。MMRのみ:非MDNノードに適用されます。新しいマスターノードの対応するテーブルで有効にするために使用可能なテーブルフィルターのセットからフィルタールールを識別するフィルターIDのカンマ区切りリスト。 printpubfilterslistコマンドを使用して、 printpubfilterslist使用可能なフィルタールールのフィルターIDを取得します(セクション8.3.17を参照)。 注:コンマIDとフィルターIDの間に空白があってはなりません。MMRのみ:非MDNノードに適用されます。新しいマスターノードを作成するときに、マスター定義ノードからパブリケーションテーブル定義を複製する場合は、このオプションをtrue設定します。新しいマスターノードにテーブル定義を既に作成している場合は、このオプションをfalse設定します。省略した場合、デフォルトはtrueです。マスター定義ノードを作成するときは、このパラメーターを指定しないでください。MMRのみ:非MDNノードに適用されます。マスターノードの作成時に初期スナップショットレプリケーションを実行する場合は、このオプションを指定します。マスターノードの作成時に初期スナップショットレプリケーションを実行しない場合は、このオプションを省略します。注(MMRのみ):オフラインスナップショット手法を使用する場合を除き(セクション7.9を参照)、このオプションを指定することをお勧めします。最初のスナップショットレプリケーションは、オンデマンド(セクション8.3.42を参照)またはスケジュール(セクション8.3.44を参照)で同期レプリケーションを実行する前に、マスター定義ノードから他のすべてのマスターノードに実行する必要があります。新しく追加されたマスターノードで初期スナップショットが行われなかった場合、その後の同期レプリケーションでは、そのマスターノードへのトランザクションの適用に失敗する可能性があります。初期スナップショットは、オンデマンドスナップショットを実行することでも取得できます(セクション8.3.41を参照)。スナップショットからの出力を表示する true 、 このオプションを true 設定します 。スナップショットの出力を表示したくない場合は、このオプションをfalse設定します。省略した場合、デフォルトはtrueです。注:このオプションは、 -initialsnapshotオプションの指定の直後にのみ指定できます。MMRの場合のみ: 1〜10の整数値で、1が最高の優先順位を持ち、10が最低の優先順位を持つマスターノードに優先順位レベルを割り当てます。Tを指定して、このパブリケーションデータベースの同期レプリケーションのトリガーベースの方法を使用します。このパブリケーションデータベースの同期レプリケーションのログベース(WAL)メソッドを使用するには、 Wを指定します。省略した場合、デフォルトはTです。次の例では、 Oracleデータベースのパブリケーションデータベース定義を追加します。暗号化されたパスワードは、 dbpasswordパラメーターを使用してコマンドラインで指定されます。出版データベースID 1出版サービスがデータベースに割り当てられています。次の例では、 Advanced Serverデータベースのパブリケーションデータベース定義を追加します。暗号化されたパスワードは、名前のファイルから読み込まれるpwdfileでdbpassfileパラメータ。 2パブリケーションデータベースIDは、パブリケーションサービスによってデータベースに割り当てられます。次の例では、初期スナップショットが呼び出されないマルチマスターレプリケーションシステムで、マスターノード(マスター定義ノード以外)のパブリケーションデータベース定義を追加します( initialsnapshotパラメーターは省略されます)。フィルターID 8および16フィルタールールがこのマスターノードに適用されます。マスターノードに3のノードプライオリティレベルが割り当てられます。printpubdbidsコマンドは、パブリケーションデータベース定義のパブリケーションデータベースIDを印刷します。-printpubdbids -repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。printpubdbidsdetailsコマンドは、各パブリケーションデータベース定義の接続情報を印刷します。-printpubbidsの詳細 pubsvrfile注:データベースユーザーのパスワードは表示されません。パブリケーションサーバーのログイン情報を含むファイル 。データベースサーバーが接続を待機しているポート番号 。printcontrollerdbidコマンドは、コントローラのデータベースのパブリケーションデータベースのIDを印刷します。-printcontrollerdbid -repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。MMRの場合のみ: printmdndbidコマンドは、マスター定義ノードのパブリケーションデータベースIDを出力します。-printmdndbid -repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。updatepubdbコマンドは、パブリケーションデータベースIDによって識別される既存のパブリケーションデータベース定義の接続情報を変更する能力を提供します。-repsvrfile pubsvrfile-pubdbid dbid-dbhost host-dbport port-dbuser user-database dbname[-urloptions jdbc_url_parameters ][-nodepriority priority_level ]シングルマスターレプリケーションシステムのパブリケーションデータベース定義に提供する必要があるデータベース接続情報の詳細については、 セクション 5.2.2を参照してください。マルチマスター複製システムについては、セクション6.2.2および6.3を参照してください。パブリケーションサーバーのログイン情報を含むファイル 。データベースサーバーが接続を待機しているポート番号 。databaseパラメータでパブリケーションデータベースを識別するためにOracleシステムID(SID)が使用される場合は、 sid 指定します。 databaseパラメータでパブリケーションデータベースを識別するためにOracleサービス名が使用される場合は、 servicename指定します。 注: Oracle 12cの場合、サービス名を使用します。SSL接続のサポートなどのために、JDBC URLパラメーターの使用を拡張しました。 (パブリケーションデータベースへのSSL接続については、セクション 7.11を参照してください 。) urloptionsパラメーターの指定は、このデータベースで以前に指定された既存のJDBC URLパラメーターを完全に置き換えます。 urloptionsパラメーターを省略すると、このデータベースで以前に指定された可能性のある既存のJDBC URLパラメーターが削除されます。MMRの場合のみ: 1〜10の整数値で、1が最高の優先順位を持ち、10が最低の優先順位を持つマスターノードに優先順位レベルを割り当てます。removepubdbコマンドは、パブリケーションデータベースの定義を削除します。–repsvrfile pubsvrfile–pubdbid dbidパブリケーションサーバーのログイン情報を含むファイル 。gettablesfornewpubコマンドは、指定されたパブリケーションデータベースの定義から新しい出版物に含めることが可能です表やビューを示しています。パブリケーションサーバーのログイン情報を含むファイル 。パブリケーションデータベースID 1で識別されるパブリケーションデータベース定義の場合、パブリケーションに含めることができるテーブルはEDB.DEPT 、 EDB.EMP 、およびEDB.JOBHISTです。パブリケーションに含めることができるビューはEDB.SALESEMPです。createpubコマンドは、新しいパブリケーションを作成します。-createpub pubname-repsvrfile pubsvrfile-pubdbid dbidcreatepubコマンドは、パラメータで指定したパブリケーションデータベースのIDとパブリケーションデータベースの定義に新しいパブリケーションの従属を追加pubdbid 。パラメーターreptypeをs設定してパブリケーションがスナップショットのみとして指定されている場合、 viewsパラメーターの後にリストされているviewsはすべて無視されます。シングルマスターレプリケーションシステム用のパブリケーション作成の詳細については、セクション 5.2.3を参照してください 。マルチマスター複製システムについては、セクション6.2.3を参照してください。注: tablesおよびviewsパラメーターの値として指定するスキーマ名、テーブル名、およびビュー名では、大文字と小文字が区別されます。データベースオブジェクトの作成に引用識別子が使用されていない限り、 Oracle名は大文字で入力する必要があり(たとえばEDB.DEPT )、 Advanced Server名は小文字で入力する必要があります(たとえばedb.dept )。引用符付き識別子とケース変換の詳細については、セクション10.4.5を参照してください。パブリケーションサーバーのログイン情報を含むファイル 。MMRの場合のみ:競合解決オプションでは、指定したE最も古いタイムスタンプによる競合解消のためのL最新のタイムスタンプによる競合解消のため、 Nノード優先紛争解決のために、 Mマニュアル紛争解決のための、またはCカスタム競合処理のため。指定された競合解決は、 tablesパラメータリストの左から右にカウントするordinal_tn指定された位置のテーブルに適用されます。省略した場合、デフォルトはEです。MMRの場合のみ:スタンバイの競合解決オプションでは、指定したE最も古いタイムスタンプによる競合解消のためのL最新のタイムスタンプによる競合解消のため、 Nノード優先紛争解決のために、 Mマニュアル紛争解決のための、またはCカスタム競合処理のため。指定された競合解決は、 tablesパラメータリストの左から右にカウントするordinal_tn指定された位置のテーブルに適用されます。省略した場合、デフォルトはMです。MMRの場合のみ: 、競合解決オプションまたはスタンバイの競合解決オプションで指定customhandler_tnオプションのスキーマの接頭辞を持つ関数名として(としてフォーマットされ、 schema . function_nameで与えられる) CREATE FUNCTION機能を処理するカスタム競合するためのコマンドordinal_tn示される位置にあるtablesパラメータリストのtablesに対して作成されます。カスタム競合処理関数をマスター定義ノードに追加する必要があります。 PSQLを使用してカスタム競合処理関数を追加する例については、セクション6.6.8.2を参照してください。競合解決オプションまたはスタンバイ競合解決オプションがC値を使用したカスタム競合処理に設定されている場合にのみ、カスタムハンドラー名オプションを指定する必要があります。次の例では、名前の公表 analysts_managers含まれているが作成されedb.deptテーブルとから従業員edb.empアナリストや管理されているテーブルを。テーブルはAdvanced Serverデータベースにあります。複製方法はスナップショットのみです。次の例では、マルチマスター複製システムのパブリケーションを作成します。 1つのテーブルフィルタは、テーブルの上に定義され edb.deptと3つのテーブルフィルタは、テーブルの上に定義されていedb.emp 。テーブルedb.deptは、スタンバイ競合解決戦略としてノード優先度競合解決と最新のタイムスタンプが割り当てられます。テーブルedb.empは、スタンバイ戦略として最も早いタイムスタンプ競合解決と手動解決(デフォルト)が割り当てられます。printpublistコマンドは、パブリケーション名のリストを出力します。-printpublist -repsvrfile pubsvrfile[-pubdbid dbid ]パブリケーションサーバーのログイン情報を含むファイル 。pubdbidパラメーターが指定されている場合、 dbid指定されたパブリケーションデータベース定義に従属するパブリケーション名のみが出力されます。 pubdbidパラメーターを省略すると、パブリケーションサーバーに従属するすべてのパブリケーション名が印刷されます。printpublishedtables印刷物に与えられたパブリケーションに属しているテーブルとビューのリストを命じます。パブリケーションサーバーのログイン情報を含むファイル 。printpubfilterslistコマンドは、指定された刊行物で定義されているテーブルのフィルタのリストを印刷します。パブリケーションサーバーのログイン情報を含むファイル 。addtablesintopubコマンドは、既存のパブリケーションにテーブルまたはビューを追加します。-addtablesintopub pubname-repsvrfile pubsvrfileaddtablesintopubコマンドがで識別される既存のパブリケーションを更新pubname 。パブリケーションがスナップショットのみの場合、 viewsパラメーターの後にリストされているviewsはすべて無視されます。注: tablesおよびviewsパラメーターの値として指定するスキーマ名、テーブル名、およびビュー名では、大文字と小文字が区別されます。データベースオブジェクトの作成に引用識別子が使用されていない限り、 Oracle名は大文字で入力する必要があり(たとえばEDB.DEPT )、 Advanced Server名は小文字で入力する必要があります(たとえばedb.dept )。引用符付き識別子とケース変換の詳細については、セクション10.4.5を参照してください。パブリケーションサーバーのログイン情報を含むファイル 。MMRの場合のみ:競合解決オプションでは、指定したE最も古いタイムスタンプによる競合解消のためのL最新のタイムスタンプによる競合解消のため、 Nノード優先紛争解決のために、 Mマニュアル紛争解決のための、またはCカスタム競合処理のため。指定された競合解決は、 tablesパラメータリストの左から右にカウントするordinal_tn指定された位置のテーブルに適用されます。省略した場合、デフォルトはEです。MMRの場合のみ:スタンバイの競合解決オプションでは、指定したE最も古いタイムスタンプによる競合解消のためのL最新のタイムスタンプによる競合解消のため、 Nノード優先紛争解決のために、 Mマニュアル紛争解決のための、またはCカスタム競合処理のため。指定された競合解決は、 tablesパラメータリストの左から右にカウントするordinal_tn指定された位置のテーブルに適用されます。省略した場合、デフォルトはMです。MMRの場合のみ: 、競合解決オプションまたはスタンバイの競合解決オプションで指定customhandler_tnオプションのスキーマの接頭辞を持つ関数名として(としてフォーマットされ、 schema . function_nameで与えられる) CREATE FUNCTION機能を処理するカスタム競合するためのコマンドordinal_tn示される位置にあるtablesパラメータリストのtablesに対して作成されます。カスタム競合処理関数をマスター定義ノードに追加する必要があります。 PSQLを使用してカスタム競合処理関数を追加する例については、セクション6.6.8.2を参照してください。競合解決オプションまたはスタンバイ競合解決オプションがC値を使用したカスタム競合処理に設定されている場合にのみ、カスタムハンドラー名オプションを指定する必要があります。このコマンドがシングルマスター複製システムに適用される場合は、 s 指定します。このコマンドがマルチマスター複製システムに適用される場合は、 m指定します。 注:このパラメーターは必須ではなく、完全に省略できます。以前のxDB Replication Server CLIバージョンでの使用をサポートするために存在します。removetablesfrompubコマンドは、出版からテーブルを削除します。-removetablesfrompub pubname-repsvrfile pubsvrfile注: tablesおよびviewsパラメーターの値として指定するスキーマ名、テーブル名、およびビュー名では、大文字と小文字が区別されます。データベースオブジェクトの作成に引用識別子が使用されていない限り、 Oracle名は大文字で入力する必要があり(たとえばEDB.DEPT )、 Advanced Server名は小文字で入力する必要があります(たとえばedb.dept )。引用符付き識別子とケース変換の詳細については、セクション10.4.5を参照してください。パブリケーションサーバーのログイン情報を含むファイル 。addfilterコマンドは、指定されたパブリケーションにテーブルのフィルタルールの定義を追加します。-addfilter pubname–repsvrfile pubsvrfile注: tablesまたはviewsパラメーターの値として指定するスキーマ名とテーブルまたはビューの名前では、大文字と小文字が区別されます。データベースオブジェクトの作成に引用識別子が使用されていない限り、 Oracle名は大文字で入力する必要があり(たとえばEDB.DEPT )、 Advanced Server名は小文字で入力する必要があります(たとえばedb.dept )。引用符付き識別子とケース変換の詳細については、セクション10.4.5を参照してください。パブリケーションサーバーのログイン情報を含むファイル 。updatefilterコマンドは、指定したテーブルまたはビューのフィルタ句を変更します。-updatefilter pubname–repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。フィルター句を変更するフィルタールールを識別するフィルターID。 printpubfilterslistコマンドを使用して、 printpubfilterslist 使用可能なフィルタールールのフィルターIDを取得します(セクション8.3.17を参照)。removefilterコマンドは、指定されたパブリケーションからテーブルのフィルタを削除します。-removefilter pubname–repsvrfile pubsvrfile-filterid filteridパブリケーションサーバーのログイン情報を含むファイル 。削除するフィルタールールを識別するフィルターID。 printpubfilterslistコマンドを使用して、パブリケーション内のフィルタールールのフィルターIDを取得します(セクション8.3.17を参照)。MMRのみ: printconfresolutionstrategyコマンドは、指定されたテーブルの競合解決戦略とスタンバイ競合解決戦略を出力します。-printconfresolutionstrategy pubname–repsvrfile pubsvrfile注: tableパラメーターの値として指定するスキーマ名とテーブル名またはビュー名では、大文字と小文字が区別されます。データベースオブジェクトの作成に引用識別子が使用されていない限り、 Oracle名は大文字で入力する必要があり(たとえばEDB.DEPT )、 Advanced Server名は小文字で入力する必要があります(たとえばedb.dept )。引用符付き識別子とケース変換の詳細については、セクション10.4.5を参照してください。パブリケーションサーバーのログイン情報を含むファイル 。table_name を含むスキーマの名前 。この値は大文字と小文字が区別されます。MMRのみ: updateconfresolutionstrategyコマンドは、指定されたテーブルの競合解決戦略またはスタンバイ競合解決戦略を変更します。-updateconfresolutionstrategy pubname–repsvrfile pubsvrfile[-customhandlername customhandler ]注: tableパラメーターの値として指定するスキーマ名とテーブル名またはビュー名では、大文字と小文字が区別されます。データベースオブジェクトの作成に引用識別子が使用されていない限り、 Oracle名は大文字で入力する必要があり(たとえばEDB.DEPT )、 Advanced Server名は小文字で入力する必要があります(たとえばedb.dept )。引用符付き識別子とケース変換の詳細については、セクション10.4.5を参照してください。パブリケーションサーバーのログイン情報を含むファイル 。table_name を含むスキーマの名前 。この値は大文字と小文字が区別されます。競合解決オプションでは、最も早いタイムスタンプ競合解決のためにE 、最新のタイムスタンプ競合解決のためにL 、ノード優先度競合解決のためにN 、手動競合解決のためにM 、またはカスタム競合処理のためにCを指定します。スタンバイ競合解決オプションでは、指定した E 、最も古いタイムスタンプによる競合解消のためにL 、最新のタイムスタンプによる競合解消のため、 Nノードの優先紛争解決のために、 Mマニュアル紛争解決、またはのためのCカスタム競合処理のため。カスタムハンドラ名オプションについては、指定 customhandlerオプションのスキーマの接頭辞を持つ関数名として(としてフォーマットされ、 schema . function_nameで与えられる) CREATE FUNCTION機能を扱うカスタム競合するためのコマンドを。カスタム競合処理関数をマスター定義ノードに追加する必要があります。 PSQLを使用してカスタム競合処理関数を追加する例については、セクション6.6.8.2を参照してください。競合解決オプションまたはスタンバイ競合解決オプションがC値を使用したカスタム競合処理に設定されている場合にのみ、カスタムハンドラー名オプションを指定する必要があります。MMRのみ: setasmdnコマンドは、マスターノードをマスター定義ノードの役割に設定します。-setasmdn pubdbid–repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。setascontrollerコマンドセットパブリケーションデータベースは、コントローラデータベースとして指定されます。パブリケーションデータベースは、シングルマスターレプリケーションシステムのマスターデータベースでも、マルチマスターレプリケーションシステムのマスターノードでもかまいません。-setascontroller pubdbid–repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。validatepubコマンドをチェックし、所与の出版物内のテーブルの定義のいずれかは、出版物が作成された以降に変更された場合。-validatepub pubname–repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。次の例では、パブリケーション dept_empが検証されます。validatepubsパブリケーションが作成されてから所定のパブリケーションデータベースの定義に従属するテーブルの定義のいずれかが変更されたかどうかをチェックするコマンド。–repsvrfile pubsvrfile-pubdbid dbidパブリケーションサーバーのログイン情報を含むファイル 。removepubコマンドは、1つまたは複数のパブリケーションを削除します。–repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。replicateddlコマンドが適用されるALTER TABLEレプリケーション・システムのすべてのデータベースで出版テーブルへの声明と同様にアップデートそのパブリケーションテーブルに関連付けられたXDB Replication Serverの挿入/更新/削除トリガーと影のテーブルを。-replicateddl pubname–repsvrfile pubsvrfile-ddlscriptfile script_fileALTER TABLEステートメントが適用されるテーブルを含むパブリケーションの名前 。パブリケーションサーバーのログイン情報を含むファイル 。table_name を含むスキーマの名前 。この値は大文字と小文字が区別されます。ALTER TABLEステートメントを含むファイルへのパス 。replicateddlコマンドを使用して実行されるaddcolumn.sqlマスターノード上のトリガとシャドウ・テーブルを更新するファイル:SMRの場合のみ: addsubdbコマンドは、サブスクリプションデータベース定義を追加します。-repsvrfile subsvrfile-dbhost host-dbport port-dbuser user-database dbname[-urloptions jdbc_url_parameters ]addsubdbコマンドは、新しいサブスクリプションデータベース定義を作成します。 addsubdbコマンドは、新しく作成されたサブスクリプションデータベース定義に割り当てられた一意のサブスクリプションデータベースIDを表示します。サブスクリプションデータベースIDは、他のxDB Replication Server CLIコマンドを実行するときに操作するサブスクリプションデータベース定義を識別するために使用されます。サブスクリプションサーバーのログイン情報を含むファイル 。データベースがOracleデータベースの場合は、 oracle 指定します。データベースがOracle互換構成モードのAdvanced Serverデータベースである場合、 enterprisedb指定します。データベースがPostgreSQLデータベースまたはPostgreSQL互換構成モードのAdvanced Serverデータベースである場合、 postgresql指定します。データベースがMicrosoft SQL Serverデータベースの場合、 sqlserver指定します。データベースサーバーが接続を待機しているポート番号 。databaseパラメータでサブスクリプションデータベースを識別するためにOracleシステムID(SID)が使用される場合は、 sid 指定します。 databaseパラメータでサブスクリプションデータベースを識別するためにOracleサービス名が使用される場合は、 servicename指定します。 注: Oracle 12cの場合、サービス名を使用します。次の例では、 Oracleデータベースのサブスクリプションデータベース定義を追加します。暗号化されたパスワードは、 dbpasswordパラメーターを使用してコマンドラインで指定されます。サブスクリプションデータベースのID 1サブスクリプションサーバーでデータベースに割り当てられます。次の例では、 Advanced Serverデータベースのサブスクリプションデータベース定義を追加します。暗号化されたパスワードは、名前のファイルから読み込まれるpwdfileでdbpassfileパラメータ。 2サブスクリプションデータベースIDは、サブスクリプションサーバーによってデータベースに割り当てられます。SMRのみ: printsubdbidsコマンドは、サブスクリプションデータベース定義のサブスクリプションデータベースIDを出力します。-printsubdbids -repsvrfile subsvrfileサブスクリプションサーバーのログイン情報を含むファイル 。SMRのみ: printsubdbidsdetailsコマンドは、各サブスクリプションデータベース定義の接続情報を出力します。-printsubdbidsdetails –repsvrfile subsvrfile注:データベースユーザーのパスワードは表示されません。サブスクリプションサーバーのログイン情報を含むファイル 。データベースサーバーが接続を待機しているポート番号 。SMRのみ: updatesubdbコマンドは、サブスクリプションデータベースIDで識別される既存のサブスクリプションデータベース定義の接続情報を変更する機能を提供します。-repsvrfile subsvrfile-subdbid dbid-dbhost host-dbport port-dbuser user-database dbname[-urloptions jdbc_url_parameters ]サブスクリプションサーバーのログイン情報を含むファイル 。データベースサーバーが接続を待機しているポート番号 。databaseパラメータでサブスクリプションデータベースを識別するためにOracleシステムID(SID)が使用される場合は、 sid 指定します。 databaseパラメータでサブスクリプションデータベースを識別するためにOracleサービス名が使用される場合は、 servicename指定します。 注: Oracle 12cの場合、サービス名を使用します。SSL接続のサポートなどのために、JDBC URLパラメーターの使用を拡張しました。 (サブスクリプションデータベースへのSSL接続の詳細については、セクション 7.11を参照してください 。) urloptionsパラメーターの指定は、このデータベースで以前に指定された既存のJDBC URLパラメーターを完全に置き換えます。 urloptionsパラメーターを省略すると、このデータベースで以前に指定された可能性のある既存のJDBC URLパラメーターが削除されます。SMRの場合のみ: removesubdbコマンドは、サブスクリプションデータベース定義を削除します。サブスクリプションサーバーのログイン情報を含むファイル 。SMRの場合のみ: createsubコマンドは、新しいサブスクリプションを作成します。-createsub subname-subsvrfile subsvrfile-subdbid dbid-pubsvrfile pubsvrfile-pubname pubnamecreatesubコマンドは、パラメータで指定したサブスクリプションデータベースのIDを持つサブスクリプションデータベースの定義に新しいサブスクリプションの従属を追加subdbid 。新しいサブスクリプションの対応するテーブルで有効にするために使用可能なテーブルフィルターのセットからフィルタールールを識別するフィルターIDのコンマ区切りリスト。 printpubfilterslistコマンドを使用して、 printpubfilterslist 使用可能なフィルタールールのフィルターIDを取得します(セクション8.3.17を参照)。 注:コンマIDとフィルターIDの間に空白があってはなりません。次の例では、サブスクリプションデータベースID 2識別されるAdvanced Serverサブスクリプションデータベースにdept_emp_sub というサブスクリプションが作成されます。サブスクリプションはdept_empという名前のパブリケーションに関連付けられていdept_emp 。SMRのみ: printsublistコマンドは、サブスクリプション名のリストを出力します。サブスクリプションサーバーのログイン情報を含むファイル 。dbid 指定されたサブスクリプションデータベース定義に従属するサブスクリプション名が出力されます。enablefilterコマンドは、シングルマスタ複製システムのサブスクリプションまたはマスター定義ノード以外のマルチマスタ複製システムのマスタノードに1つ以上のフィルタ規則を可能にします。enablefilterコマンドは、サブスクリプション又は非MDNノードにフィルタルールを適用することが望まれるときに使用されるが、フィルタルールがまだ存在していなかったか、サブスクリプション又は非MDNノード場合、これらに含まれることを怠りましたコンポーネントは最初に作成されました。-repsvrfile pubsvrfile
• テーブルフィルターは、 createpubコマンド(セクション8.3.14を参照)またはxDBレプリケーションコンソール(セクション5.2.3を参照) によって最初に作成されたときに、masterデータベースのパブリケーションで定義されました 。
• テーブルフィルタは、 addfilterコマンド(セクション8.3.20を参照)またはxDBレプリケーションコンソール(セクション7.6.4を参照) を使用して、既存のパブリケーションに追加されました 。
• テーブルフィルターは、 createpubコマンド(セクション8.3.14を参照)またはxDBレプリケーションコンソール(セクション6.2.3を参照 ) によって最初に作成されたときに、マスター定義ノードのパブリケーションで定義されました 。
• テーブルフィルタは、 addfilterコマンド(セクション8.3.20を参照)またはxDBレプリケーションコンソール(セクション7.6.4を参照) を使用して、既存のパブリケーションに追加されました 。パブリケーションサーバーのログイン情報を含むファイル 。SMRの場合のみ:フィルタールールを有効にするテーブルを含むサブスクリプションの名前。MMRのみ:フィルター規則を有効にするテーブルを含む非MDNノードのパブリケーションデータベースID。subname 指定されたSMRサブスクリプションまたはdbid指定されたMMR非MDNノードの対応するテーブルで有効にするために、使用可能なテーブルフィルターのセットからフィルター規則を識別するスペース文字で区切られた1つ以上のフィルターID printpubfilterslistコマンドを使用して、 printpubfilterslist使用可能なフィルタールールのフィルターIDを取得します(セクション8.3.17を参照)。disablefilterコマンドは、シングルマスタ複製システムのサブスクリプションまたはマスター定義ノード以外のマルチマスタ複製システムのマスタノードに1つ以上のフィルタルールを無効にします。-repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。SMRの場合のみ:フィルター規則を無効にするテーブルを含むサブスクリプションの名前。MMRのみ:フィルター規則を無効にするテーブルを含む非MDNノードのパブリケーションデータベースID。SMRの場合のみ: dosnapshotコマンドは、単一マスター複製システム内の指定されたサブスクリプションでスナップショット同期を実行します。サブスクリプションサーバーのログイン情報を含むファイル 。スナップショットからの出力を表示する true 、 このオプションを true 設定します 。スナップショットの出力を表示したくない場合は、このオプションをfalse設定します。省略した場合、デフォルトはtrueです。MMRのみ: dommrsnapshotコマンドは、マルチマスター複製システムの指定されたマスターノードでスナップショット同期を実行します。-dommrsnapshot pubname–repsvrfile pubsvrfile-pubhostdbid dbidパブリケーションサーバーのログイン情報を含むファイル 。スナップショットからの出力を表示する true 、 このオプションを true 設定します 。スナップショットの出力を表示したくない場合は、このオプションをfalse設定します。省略した場合、デフォルトはtrueです。dosynchronizeシングルマスタ複製システムのための、または全体のマルチマスタ複製システムのための指定されたサブスクリプションのコマンドを実行同期レプリケーション。注(SMRのみ): dosynchronizeコマンドを使用してスナップショットを最初に実行しなくても、 dosnapshotコマンドをサブスクリプションで使用できます。 dosynchronizeコマンドは、最初に必要なスナップショットを自動的に実行します。注(MMRのみ):マスター定義ノードからマルチマスター複製システム内の他のすべてのマスターノードへの初期スナップショット複製が実行されていることを確認してください。新しく追加されたマスターノードで初期スナップショットが行われなかった場合、その後の同期レプリケーションでは、そのマスターノードへのトランザクションの適用に失敗する可能性があります。最初のスナップショットは、マスターノードが最初に追加されたときに(セクション6.3またはセクション8.3.6を参照)、またはオンデマンドスナップショットを実行して(セクション6.5.1またはセクション8.3.41を参照) 取得できます。SMRのみ:同期レプリケーションが実行されるサブスクリプションの名前。MMRのみ:同期レプリケーションが実行されるパブリケーションの名前。SMRのみ: サブスクリプションサーバーのログイン情報を含むファイル。MMRのみ: パブリケーションサーバーのログイン情報を含むファイル。SMRの場合のみ: confscheduleコマンドは、シングルマスター複製システムで繰り返し複製を開始するスケジュールを作成します。{-realtime no_of_sec |-cronexpr " cron_expression "場合は removeパラメータが省略され、その後、 jobtypeパラメータとパラメータの一つはrealtime 、 daily 、 weekly 、 monthly 、またはcronexpr一緒に指定する必要がありますsubnameとrepsvrfileパラメータ。サブスクリプションsubname既存のスケジュールがある場合、新しいスケジュールに置き換えられます。サブスクリプションサーバーのログイン情報を含むファイル 。removeパラメーターが指定されている場合、既存のスケジュールはすべてサブスクリプションから削除されます。 removeパラメーターが指定されていない場合、サブスクリプションのスケジュールが作成されます。スケジュールされたレプリケーションをスナップショットで実行する場合は、 s 指定します。スケジュールされたレプリケーションを同期によって実行する場合は、 t指定します。関連するパブリケーションがスナップショットのみのパブリケーションである場合、 -jobtype s使用する必要があります。曜日。これは、 SUN 、 MON 、 TUE 、 WED 、 THU 、 FRI 、またはSAT いずれかの値になります 。この値は大文字と小文字が区別されないため、 SunとsunはSUNと同様に機能します。年の月。これは、 JAN 、 FEB 、 MAR 、 APR 、 MAY 、 JUN 、 JUL 、 AUG 、 SEP 、 OCT 、 NOV 、またはDECいずれかの値になります。この値は大文字と小文字を区別しないため、 JanとjanはJANと同様に機能します。MMRの場合のみ: confschedulemmrコマンドは、マルチマスター複製システムで繰り返し複製を開始するスケジュールを作成します。注:マスター定義ノードからマルチマスター複製システム内の他のすべてのマスターノードへの初期スナップショット複製が実行されていることを確認してください。新しく追加されたマスターノードが最初のスナップショットを受けなかった場合、スケジュールによって開始された以降の同期レプリケーションは、そのマスターノードへのトランザクションの適用に失敗する可能性があります。最初のスナップショットは、マスターノードが最初に追加されたときに(セクション6.3またはセクション8.3.6を参照)、またはオンデマンドスナップショットを実行して(セクション6.5.1またはセクション8.3.41を参照) 取得できます。–repsvrfile pubsvrfile{-realtime no_of_sec |-cronexpr " cron_expression "場合は removeパラメータが省略されたパラメータの一つが、その後、 realtime 、 daily 、 weekly 、 monthly 、またはcronexpr一緒に指定する必要がありますpubdbid 、 pubname 、およびrepsvrfileパラメータ。パブリケーションpubname既存のスケジュールがある場合、新しいスケジュールに置き換えられます。パブリケーションサーバーのログイン情報を含むファイル 。曜日。これは、 SUN 、 MON 、 TUE 、 WED 、 THU 、 FRI 、またはSAT いずれかの値になります 。この値は大文字と小文字が区別されないため、 SunとsunはSUNと同様に機能します。年の月。これは、 JAN 、 FEB 、 MAR 、 APR 、 MAY 、 JUN 、 JUL 、 AUG 、 SEP 、 OCT 、 NOV 、またはDECいずれかの値になります。この値は大文字と小文字を区別しないため、 JanとjanはJANと同様に機能します。次の例では 、パブリケーションデータベースIDが6マスター定義ノードに従属するパブリケーション emp_pub 同期レプリケーションを実行するスケジュールが作成されます 。レプリケーションは毎日午前8時に発生します。printscheduleコマンドは、定期的な複製スケジュールを表示します。SMRのみ:スケジュールが印刷されるサブスクリプションの名前。MMRの場合のみ:スケジュールが印刷されるパブリケーションの名前。SMRのみ: サブスクリプションサーバーのログイン情報を含むファイル。MMRのみ: パブリケーションサーバーのログイン情報を含むファイル。SMRの場合のみ: updatesubコマンドを使用すると、特定のサブスクリプションの特定のメタデータを更新できます。このメタデータにより、サブスクリプションサーバーは、サブスクリプションに関連付けられているパブリケーションを管理するパブリケーションサーバーを実行しているホストを見つけることができます。-updatesub subname-subsvrfile subsvrfile-pubsvrfile pubsvrfile-host newpubsvr_ipaddress-port newpubsvr_portupdatesubコマンドは、サブスクリプションに関連付けられている出版物の親であるパブリケーションサーバーを識別するIPアドレスとポート番号からなるサブスクリプションメタデータを更新することができます。あなたは使用する updatesubあなたはその時点で有効なIPアドレスを使用して複製システムを構築していたシナリオでコマンドを。後の時点で、 パブリケーションサーバーを実行しているホストに割り当てられたIPアドレスが変更されました。サブスクリプションsubname関連付けられたパブリケーションを管理するパブリケーションサーバーのパブリケーションサーバーログイン情報を含むファイル 。 newpubsvr_ipaddressおよびnewpubsvc_portする値は、ファイルpubsvrfileフィールドhostおよびportに設定されている値と同じでなければならないことに注意してください。サブスクリプション subname 関連付けられたパブリケーションを管理するパブリケーションサーバーの新しいIPアドレス 。この値は、ファイルpubsvrfileフィールドhostに指定されたIPアドレスと同じでなければなりません。サブスクリプション subname 関連付けられたパブリケーションを管理するパブリケーションサーバーの新しいポート番号 。この値は、ファイルpubsvrfileフィールドportに指定されたポート番号と同じでなければなりません。パブリケーションサーバーのホストIPアドレスが 192.168.2.7に変更された 192.168.2.7 、ファイルpubsvrfile.propパブリケーションサーバーのログイン情報に、次のように新しいIPアドレスが含まれていることを確認してください。SMRの場合のみ: removesubコマンドはサブスクリプションを削除します。サブスクリプションサーバーのログイン情報を含むファイル 。dept_emp_sub という名前のサブスクリプションが削除されます。confcleanupjobコマンドは、シャドウテーブル履歴が削除されるときにようスケジュールを作成します。{-minutely no_of_minutes |-hourly no_of_hours |-1 hour |-cronexpr " cron_expression "場合は disableパラメータが省略され、その後、 enableなパラメータのパラメータと1をminutely 、 hourly 、 daily 、 weekly 、またはcronexpr一緒に指定する必要がありますpubdbidとpubsvrfileパラメータ。パブリケーションサーバーのログイン情報を含むファイル 。場合 disableパラメータが指定され、その後、既存のシャドーテーブル履歴クリーンアップスケジュールは、パブリケーションデータベースの定義から削除されます。 disableパラメーターが指定されていない場合は、 disable指定enable必要があります。曜日。これは、 SUNDAY 、 MONDAY 、 TUESDAY 、 WEDNESDAY 、 THURSDAY 、 FRIDAY 、またはSATURDAY いずれかの値になります 。この値は大文字と小文字を区別しないため、 SundayとsundayはSUNDAYと同様に機能します。次の例では、パブリケーションデータベースID 1 識別されるパブリケーションデータベース定義内に作成されたシャドウテーブルで、3時間ごとにシャドウテーブル履歴クリーンアップが実行されるようにスケジュールされています 。次の例では、パブリケーションデータベースID 1 識別されるパブリケーションデータベース定義内で作成されたシャドウテーブルに対して、シャドウテーブルの履歴クリーンアップが1日1回午後6時に実行されるようにスケジュールされています 。次の例では、パブリケーションデータベースID 1 識別されるパブリケーションデータベース定義内で作成されたシャドウテーブルで、毎週水曜日の午前8時にシャドウテーブル履歴クリーンアップが実行されるようにスケジュールされています 。cleanshadowhistforpubコマンドは、指定されたパブリケーションのシャドウテーブルの履歴を削除します。-cleanshadowhistforpub pubname–repsvrfile pubsvrfileパブリケーションサーバーのログイン情報を含むファイル 。MMRのみ:シャドウテーブルの履歴を削除するマスターノードのパブリケーションデータベースID。このパラメーターは、1つ以上のコンマ区切りのパブリケーションデータベースIDを指定するマルチマスターレプリケーションシステムに必要です。 注:コンマデータベースIDとパブリケーションデータベースIDの間に空白があってはなりません。cleanrephistoryforpubコマンドは、指定されたパブリケーションのための複製履歴を削除します。レプリケーション履歴のクリーンアップに関する追加情報については、 7.5.3 項を参照してください 。パブリケーションサーバーのログイン情報を含むファイル 。cleanrephistoryコマンドは、指定されたパブリケーションサーバー内のすべての出版物の複製履歴を削除します。-cleanrephistory –repsvrfile pubsvrfileレプリケーション履歴のクリーンアップに関する追加情報については、 7.5.3 項を参照してください 。パブリケーションサーバーのログイン情報を含むファイル 。
9 データ検証比較される2つのデータベースは、 ソースデータベースとターゲットデータベースと呼ばれ ます 。ソースデータベースのタイプは、Oracle、EnterpriseDB、SQL Server、Sybase®、またはMySQL®です。ターゲットデータベースは、OracleまたはEnterpriseDBである必要があります。注:データ検証ツールは、次のデータ型の列を検証しません。これらのタイプの1つ以上の列を含むテーブルは、部分的にのみ検証されます。
•
•
•
•
•
•
•
• 注: xDB Replication ServerのシングルマスターまたはマルチマスターレプリケーションシステムのテーブルでのData Validatorの使用に関しては、Data Validatorを使用する前に、ソースとターゲットのxDB Replication Serverテーブル間のすべての同期レプリケーションが完了していることを確認してください。同期レプリケーションがまだ進行中の場合は、データ検証ツールがテーブルの内容の違いを報告する可能性があります。
9.1 インストールと構成手順1: xDB Replication Server製品をインストールすると、Data Validatorのコンポーネントもインストールされます。 xDB Replication Server製品のインストールについては、第3章を参照してください。
XDB_HOME /etc runValidation.sh (Linux) XDB_HOME /bin runValidation.bat (Windows) XDB_HOME \bin 注: XDB_HOMEは、xDB Replication Serverがインストールされているディレクトリーです。これは、xDB Replication Serverのインストール方法に応じて、Postgresホームディレクトリと同じ場合と異なる場合があります。ステップ2: Oracleデータベースをソースまたはターゲットデータベースとして使用する場合は、Oracle JDBCドライバーをダウンロードし、 JAVA_HOME /jre/lib/extディレクトリに配置します。これらのパラメーターはいずれも、Data Validatorスクリプトを呼び出すときにオプションでオーバーライドできます。データ検証ツールの起動に関する追加情報については、セクション 9.2を参照してください 。
手順4: Data Validatorログディレクトリの場所を決定します。ソース表とターゲット表の間に行の違いがある場合、 datavalidator_ yymmdd - hhmiss .diff としてフォーマットされた名前のファイルも生成されます。これには、 diff形式のエラーの出力が含まれます。 Kompareなどのグラフィカルなdiffツールを使用してこのファイルを表示し、特定の違いを強調表示します。データ XDB_HOMEは、 -ldオプションを-ldせずにデータXDB_HOME最初に起動したときに、 XDB_HOME /binディレクトリ内にlogs という名前のサブディレクトリを作成しようとします。 rootアカウントとしてData Validatorを呼び出さない場合、通常はrootアカウントのみがこの権限を持つXDB_HOME /binディレクトリにサブディレクトリlogsを作成しようとするため、実行が失敗する可能性があります。
•
•
• 使用 -ld log_directory_pathデータValidatorが指定されたディレクトリの場所にログおよび差分ファイルを作成できるようにするオプションlog_directory_path 。データlog_directory_path実行に使用するオペレーティングシステムアカウントに、 log_directory_path指定された最下位レベルのサブディレクトリがまだ存在しない場合は作成するか、完全なディレクトリパスが既に存在する場合は指定されたディレクトリ内にファイルを作成する適切な権限があることを確認してください。
9.2 データ検証の実行Data Validatorスクリプト runValidation.sh (WindowsのrunValidation.bat ) を呼び出す現在の作業ディレクトリは、スクリプトを含むbinサブディレクトリ(つまり、 XDB_HOME /bin )でなければなりません。./runValidation.sh {–ss | --source-schema} schema_name[ option ] ...runValidation {–ss | --source-schema} schema_name[ option ] ..../runValidation.sh –ss schema[-ts schema ][-ld log_directory_path ][-sdbms database_type ][-sh host ][-sp port ][-sdb dbname ][-あなたの user ][-spw password ][-tdbms database_type ][-th host ][-tp port ][-tdb dbname ][-tu user ][-tpw password ][-bs row_count ][-fs row_count ]データベース接続オプションの指定(前述の構文図にリストされている-sdbmsから-tpw )は、 datavalidator.propertiesファイル内の対応するパラメーターをオーバーライドします。 datavalidator.propertiesファイルの詳細は、 9.1項を参照してください。比較のために含まれるソーススキーマ内のテーブル。省略した場合、ソーススキーマ内のすべてのテーブルは、 -etオプションを使用した比較から除外されたテーブルを除き、ターゲットスキーマ内のテーブルと比較されます。 注:コンマとテーブル名の間に空白があってはなりません。比較から除外されるソーススキーマ内のテーブル。省略すると、 -itオプションで指定されたテーブルのみが比較のために含まれます。 -itオプションと-etオプションの両方を省略すると、すべてのソーススキーマテーブルが比較のために含まれます。 注:コンマとテーブル名の間に空白があってはなりません。場合 true指定され、同じ主キーを持つソースおよびターゲット・データベース・テーブルの両方に存在する行の差異のロギングが、異なる非プライマリ・キー値がスキップされています。デフォルトはfalseです。データ検証ログと差分ファイルを作成して保存するディレクトリパス。場合 log_directory_path存在しない場合、データValidatorは、それを作成しようとします。完全なディレクトリパスが指定されていない場合、 log_directory_pathが作成されるか、 runValidation.shスクリプトが呼び出されるXDB_HOME /binサブディレクトリに相対的であると想定されます。 (つまり、logsディレクトリはXDB_HOME /bin/ log_directory_pathです。) runValidation.shスクリプトの呼び出しに使用するオペレーティングシステムアカウントに、ディレクトリが存在しない場合はディレクトリを作成する権限、または指定した場所にファイルを作成する権限があることを確認してくださいディレクトリが既に存在する場合。省略した場合、デフォルトはXDB_HOME /bin/logsディレクトリです。-ds 、 --display-summary { true | false }データ検証ツールの概要のみを表示するには、 trueを指定し true 。これにより、ソースとターゲットのデータベース接続情報、およびソースデータベーステーブルごとの結果の詳細な内訳が省略されます。データ検証ツールのすべての結果を表示するには、 falseを指定しfalse 。データ検証ツールが呼び出されたときにコマンドラインコンソールに表示される情報の種類と量は、その実行のログファイルにも保存される情報と同じです。省略した場合、デフォルトはfalse (つまり、データ検証ツールの結果がすべて表示されます)。-bsオプションは、ソースおよびターゲット・データベース・テーブルを横切って比較のために使用されるバッチにグループに行数を指定します。たとえば、テーブルに1000行が含まれる場合、 -bs設定を100にすると、ソースデータベースとターゲットデータベース全体で比較を完了するために10回のバッチ反復が必要になります。データ検証ツールは、ソーステーブルとターゲットテーブルの両方から100行を読み取り、ソースバッファとターゲットバッファに追加します。検証スレッドは、ソースバッファとターゲットバッファから100行を読み取り、比較を実行します。次に、比較などのために次の100行を読み取って準備するために移動します。データベースから100行を-fsために必要な実際のデータベースラウンドトリップは、フェッチサイズの-fsオプションに依存することに注意してください。たとえば、 -fs設定が100の場合は1回のラウンドトリップしか必要ありませんが、 -fs設定が10の場合は10回のデータベースラウンドトリップが必要です。サイズが非常に大きいテーブルに対してデータ検証を実行すると、デフォルトのフェッチサイズ5000行を使用しているときに、データ検証ツールがヒープ領域不足エラーで終了する場合があります。 -fsオプションを使用して 、より小さいフェッチサイズを指定し、ヒープ領域不足の問題を回避します。結果セットの反復により、1回のデータベースラウンドトリップでrow_count値で表される数の行がrow_countます。次の例では、OracleソースデータベースとAdvanced Serverターゲットデータベースを使用して、Oracleのスキーマ EDBのテーブルとAdvanced Serverのpublic スキーマのテーブルを比較します。
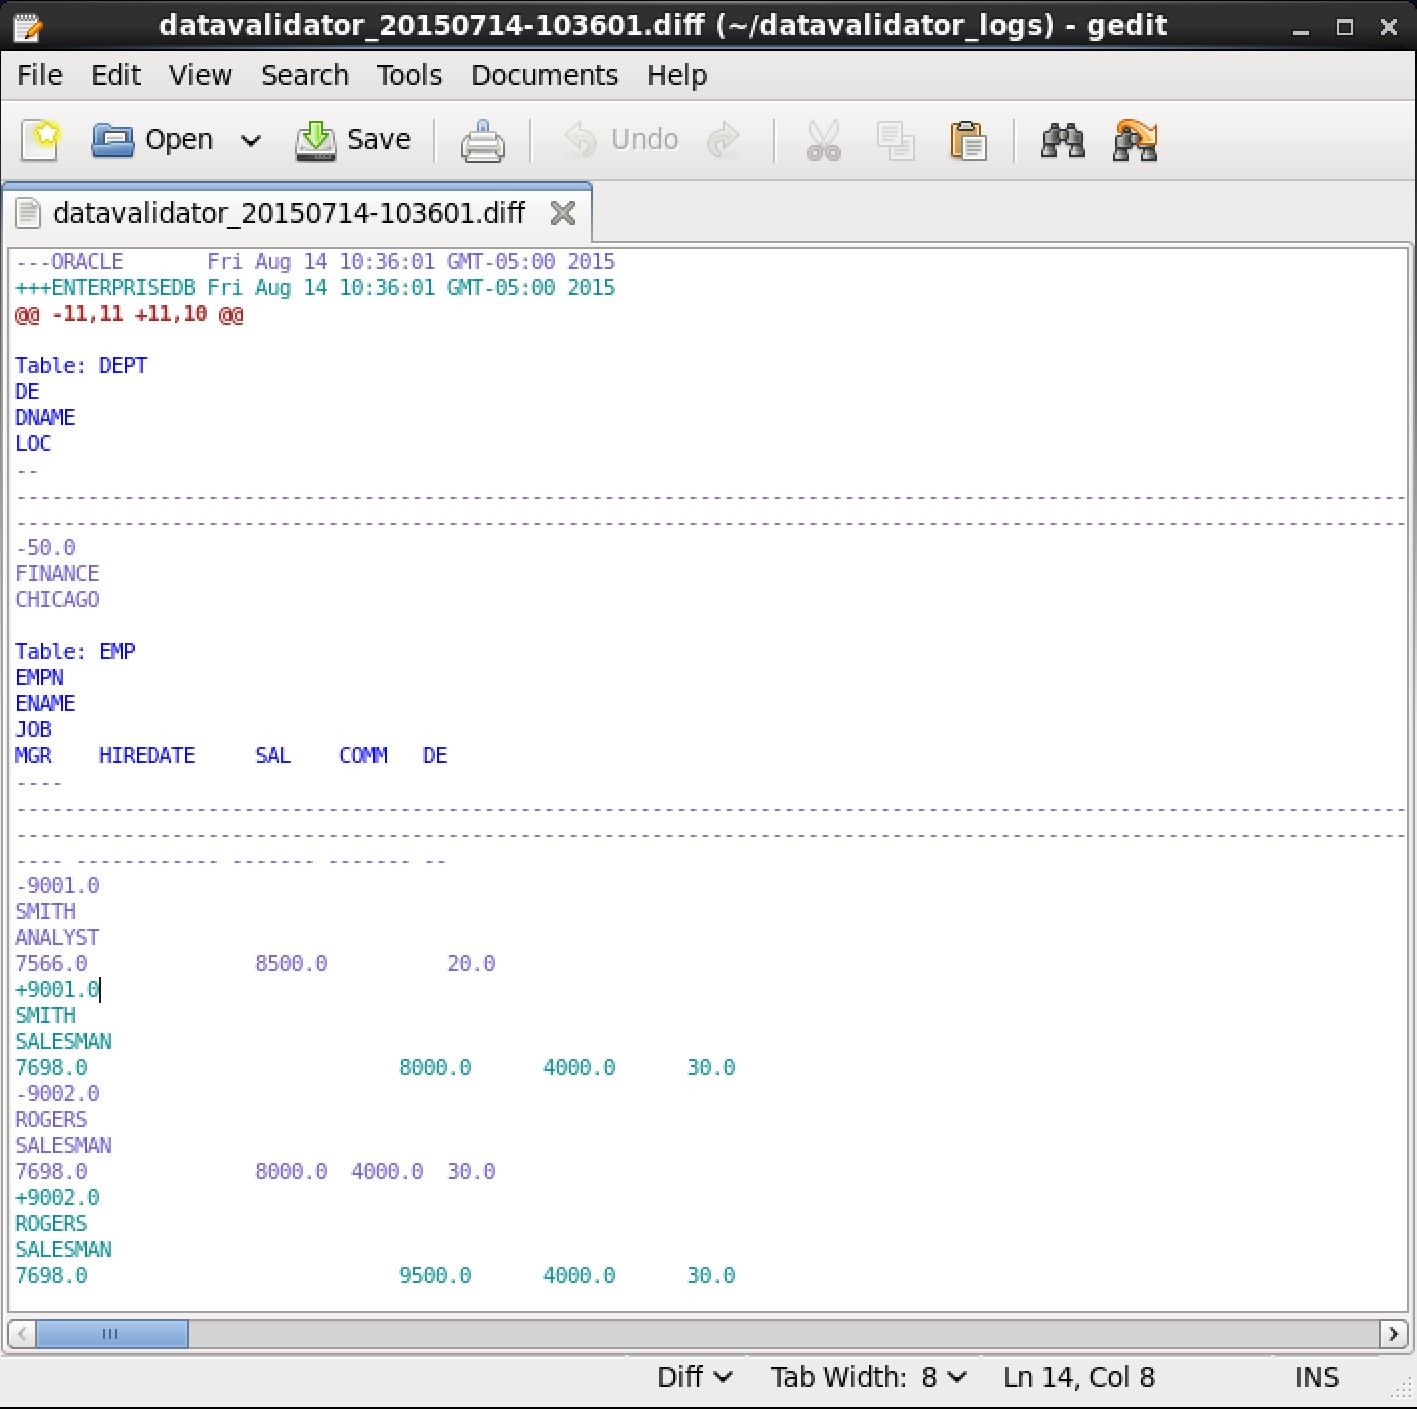
•
•
• この例では、 JOBHISTテーブルには、OracleテーブルとAdvanced Serverテーブルの両方に同じ行が含まれています。datavalidator.propertiesファイルの内容は次のように設定されます。データ /home/user/datavalidator_logs ログファイルは 、 -ldオプションで指定されたディレクトリ /home/user/datavalidator_logs 作成されます。 runValidation.shスクリプトの呼び出しに使用されるオペレーティングシステムアカウントには/home/userディレクトリへの書き込みアクセス権があるため、Data Validatorはdatavalidator_logsサブディレクトリを作成できます。
• DEPTテーブルに1つのエラーがあります(行がありません)。
• EMPテーブルに2つのエラーがあります(列の値が一致しない2つの行)
• JOBHIST表には、エラーが含まれていません。
• ORATABテーブルには、ターゲット・データベースに存在しません。
10 付録
• Oracle 10gリリース2バージョン10.2.0.1.0は明示的に認定されています。 10.2ラインの新しいマイナーバージョンもサポートされています。
• Oracle 11gリリース2バージョン11.2.0.2.0は明示的に認定されています。 11.2ラインの新しいマイナーバージョンもサポートされています。
• Oracle 12cバージョン12.1.0.2.0は明示的に認定されています。 12.1ラインの新しいマイナーバージョンもサポートされています。
• SQL Server 2008バージョン10.50.1617.0は明示的に認定されています。 10.50ラインの新しいマイナーバージョンもサポートされています。
• SQL Server 2012バージョン11.0.6020.0は明示的に認定されています。 11.0ラインの新しいマイナーバージョンもサポートされています。
• SQL Server 2014バージョン12.0.5000.0は明示的に認定されています。 12.0ラインの新しいマイナーバージョンもサポートされています。注: Advanced Serverバージョン11の場合、最初にバージョン11ベータに対して認証が実行されましたが、バージョン11 GAリリースでは問題は発生しません。Advanced Serverを使用している場合、xDB Replication Server(Oracle、SQL Server、PostgreSQL、またはAdvanced Server)で使用しているデータベース製品と 互換性構成モードに応じて、ソースデータベースサーバーとターゲットデータベースサーバーの特定の組み合わせはシングルマスター複製システムでのパブリケーションおよびそれに関連するサブスクリプションには許可されていません。
• Oracle互換構成モード。操作は、データ型、関数、データベースオブジェクトの作成などのOracle構文とセマンティクスを使用して実行されます。このモードは、アプリケーションをOracleから移行する場合、またはアプリケーションをOracle互換の方法で構築する場合に便利です。
• PostgreSQL互換の構成モード。操作は、ネイティブのPostgreSQL構文とセマンティクスを使用して実行されます。このモードは、アプリケーションをPostgreSQLから移行する場合、またはアプリケーションをPostgreSQLと互換性のある方法で構築する場合に便利です。
マルチマスター複製システムの場合、各マスターノードはすべてのマスターノードのソースとすべてのマスターノードのターゲットの両方として機能します。したがって、特定のマルチマスター複製システムまたは クラスター を構成する許可されたデータベースサーバーは、マスター定義ノードのデータベースタイプを選択するときに最初に確立されるクラスターの全体的な構成によって決定されます(セクション6.2.2のステップ3を参照) 。
• PostgreSQL互換クラスター。すべてのマスターノードは、PostgreSQL互換構成モードでインストールされたPostgreSQLデータベースサーバーまたはAdvanced Serverで構成されている必要があります。
• Advanced Server Oracle互換クラスター。すべてのマスターノードは、Oracle互換構成モードでインストールされたAdvanced Serverで構成されている必要があります。
xDB Replication Server 5.1.xを使用している場合、最初にこのバージョンをxDB Replication Server 6.0にアップグレードする必要があります。次の場所にある EDB Replication Server 6.0ユーザーズガイドの セクション10.2「xDB Replication Server 6.0へのアップグレード」を参照してください 。手順1:パブリケーションテーブルのトランザクションの保留中のバックログは、アップグレードプロセスを開始する前に複製する必要があります。ステップ2:保留中のトランザクションがすべてターゲットデータベースに複製されたら、xDB Replication Server 6.1.xパブリケーションサーバーとサブスクリプションサーバーを停止します(セクション5.2.1および5.3.1を参照)。ステップ3: xDB Replication Server 6.2をインストールします。 xDB Replication Serverのインストール手順については、第3章を参照してください。ただし、次の手順で説明する違いに注意してください。ステップ4:セクション3.1のステップ11でライセンス契約に同意すると、[コンポーネントの選択]画面が表示されますが、エントリはグレー表示されます。古いxDB Replication Serverコンポーネントは、古いxDB Replication Serverのディレクトリの場所にある新しいコンポーネントに置き換えられます。 [次へ]ボタンをクリックします。ステップ5: [既存のインストール]画面で、既存のxDB Replication Serverインストールが見つかったことを確認します。 [次へ]ボタンをクリックして、アップグレードを続行します。ステップ6: [インストールの準備完了]画面で、[次へ]ボタンをクリックします。ステップ7:表示される残りの画面は、インストールプロセスの完了を確認し、Stack BuilderまたはStackBuilder Plusを終了できるようにします。ステップ8:インストールの完了後、新しいxDB Replication Server製品のパブリケーションサーバーが実行され、xDB Replication Server 6.1が使用するコントローラーデータベースに接続されます。サブスクリプションサーバーはこの時点で実行されている場合と実行されていない場合がありますが、これはこのプロセスの予想される結果です。手順9:パブリケーションサーバーとサブスクリプションサーバーの構成ファイルのセットアップを完了します。で XDB_HOME /etcディレクトリに、XDB Replication Serverバージョン6.2の構成ファイルの新しいセットが作成されます。これらのファイルの名前はxdb_pubserver.conf.newおよびxdb_subserver.conf.newです。新しい構成ファイルには、xDB Replication Server 6.2に追加された新しい構成オプションが含まれています。xDB Replication Serverバージョン6.1.xで使用される古い構成ファイルは、 xdb_pubserver.confおよびxdb_subserver.conf まま変更されません 。で XDB_HOME /etc/sysconfigディレクトリ、確認しXDBスタートアップコンフィギュレーションファイルxdbReplicationServer-62.configあなたがXDB Replication Serverの6.2を使用したいパラメータの設定が含まれています。 xDBスタートアップコンフィギュレーションファイルの詳細については、セクション2.3.1.4を参照してください。ステップ12:必要に応じて、パブリケーションサーバーとサブスクリプションサーバーのポート番号を調整します。xDB Replication Server 6.2パブリケーションおよびサブスクリプションサーバーは 、それぞれデフォルトのポート番号 9051および9052 を使用するようにインストールされます 。 xDB Replication Server 6.1.xレプリケーションシステムが9051および9052以外のポート番号を使用した場合、セクション10.2.3で説明されているように、この不整合を修正するために変更を実行します。ポート番号をそのように調整する必要がない場合は、セクション 5.2.1および5.3.1の 説明に従って、xDBレプリケーションコンソールにパブリケーションサーバーとサブスクリプションサーバーを登録します 。既存のレプリケーションシステムは、xDBレプリケーションコンソールのレプリケーションツリーに表示されます。ステップ13:これで、 xDB Replication Server 6.2を使用して、新しいレプリケーションシステムを作成し、既存のシステムを管理する準備ができました。注: xDB Replication Server 6.2のリポジトリー構成ファイルedb.repoが/etc/yum.repos.dディレクトリーにセットアップされていることを確認して/etc/yum.repos.d 。詳細については、セクション3.3を参照してください。手順1:パブリケーションテーブルのトランザクションの保留中のバックログは、アップグレードプロセスを開始する前に複製する必要があります。ステップ2:保留中のトランザクションがすべてターゲットデータベースに複製されたら、xDB Replication Server 6.1.xパブリケーションサーバーとサブスクリプションサーバーを停止します(セクション5.2.1および5.3.1を参照)。ステップ3:次の構成ファイルのコピーを保存します。ステップ4:既存のシングルマスターレプリケーションシステムでOracleパブリケーションデータベースまたはサブスクリプションデータベースが使用されている場合、xDB Replication Server 6.2のパブリケーションサーバーおよびサブスクリプションサーバーがOracle JDBCドライバーバージョンojdbc5以降のコピーにアクセスできることを確認します。インストールされます。詳細については、セクション5.1.3.1を参照してください。注: 2つのオプションを使用できます。オプション1)Oracle JDBCドライバーをJavaランタイム環境のjre/lib/extサブディレクトリにコピーします。オプション2)Oracle JDBCドライバーをxDB Replication Serverインストールディレクトリのlib/jdbcサブディレクトリにコピーします。一方、オプション2を実行する場合、 xDB Replication Server 6.2をインストールした後に、Oracle JDBCドライバーを /usr/ppas-xdb-6.2/lib/jdbcディレクトリーにコピーする必要があります 。ステップ5:コントローラーデータベースが稼働していることを確認するのが最善です。既存のSMRおよびMMRシステムの他のパブリケーションおよびサブスクリプションデータベースは、稼働している必要はありません。ステップ6: rootアカウントでyum updateコマンドを呼び出して、次のようにxDB Replication Server 6.1.xからxDB Replication Server 6.2へのアップグレードを開始します。
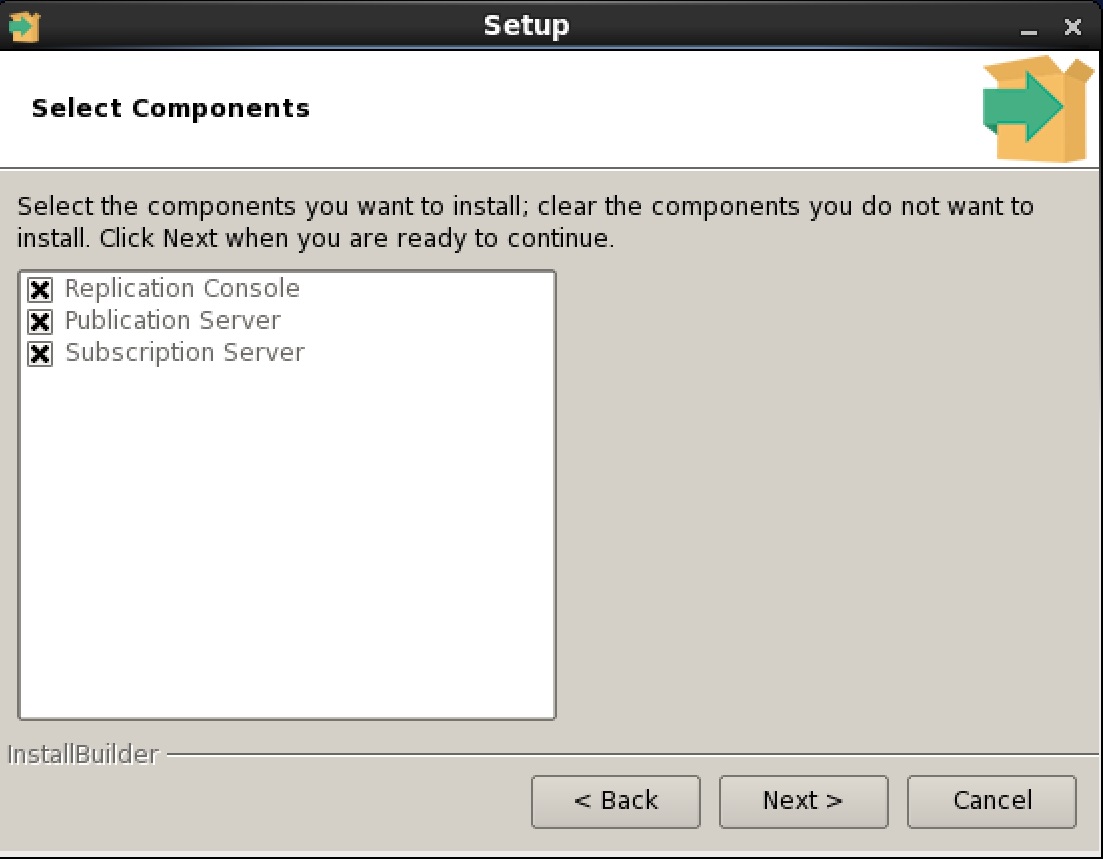
•
•
• では etcのサブディレクトリとして名前変更後のコンフィギュレーションファイルがあるかもしれませんxdb_pubserver.conf.rpmsaveとxdb_subserver.conf.rpmsave 。
•
• /etcディレクトリに、1つまたは2つのXDBレプリケーション設定が名前のファイルがあるかもしれませんedb-repl.confと、おそらくedb-repl.conf.rpmsave 。ファイルedb-repl.confは、xDB 6.1.xパブリケーションサーバーが使用するコントローラーデータベースの接続および認証情報が含まれている必要があります。ファイルedb-repl.conf.rpmsaveには、新しい管理者ユーザーパラメータadmin_userおよびadmin_passwordのみが含まれています。パブリケーションサーバーとサブスクリプションサーバーを起動する前に、コントローラーデータベースが稼働中であり、 edb-repl.confファイルにコントローラーデータベース接続と認証パラメーターが含まれていることを確認してください。ステップ7:パブリケーションサーバーとサブスクリプションサーバーの構成ファイルのセットアップを完了します。で /usr/ppas-xdb-6.2/etcディレクトリ、XDB Replication Serverバージョン6.2の構成ファイルの新しいセットが作成されます。これらのファイルの名前はxdb_pubserver.confおよびxdb_subserver.confです。新しい構成ファイルには、xDB Replication Server 6.2に追加された新しい構成オプションが含まれています。xDB Replication Serverバージョン6.1.xによって使用される古い構成ファイルは、 /usr/ppas-xdb-6.1/etcディレクトリーにあり、 xdb_pubserver.conf.rpmsaveおよびxdb_subserver.conf.rpmsave名前変更されています。注:これらのファイルが存在しない場合は、ステップ3で保存したファイルを使用してください。アクティブな構成ファイルの最終セットは、 xdb_pubserver.confおよびxdb_subserver.confという名前のディレクトリ /usr/ppas-xdb-6.2/etc 含まれている必要があります 。/ usr/ppas-xdb-6.2/etc/sysconfigディレクトリで、xDBスタートアップ構成ファイルxdbReplicationServer-62.configにxDB Replication Server 6.2で使用するパラメータ設定が含まれていることを確認します。 xDBスタートアップコンフィギュレーションファイルの詳細については、セクション2.3.1.4を参照してください。ステップ10:必要に応じて、パブリケーションサーバーとサブスクリプションサーバーのポート番号を調整します。xDB Replication Server 6.2パブリケーションおよびサブスクリプションサーバーは 、それぞれデフォルトのポート番号 9051および9052 を使用するようにインストールされます 。 xDB Replication Server 6.1.xレプリケーションシステムがパブリケーションサーバーおよびサブスクリプションサーバーに9051および9052以外のポート番号を使用した場合、セクション10.2.3で説明されているように、この不整合を修正するための変更を実行します。ポート番号をそのように調整する必要がない場合は、セクション 5.2.1および5.3.1の 説明に従って、xDBレプリケーションコンソールにパブリケーションサーバーとサブスクリプションサーバーを登録します 。既存のレプリケーションシステムは、xDBレプリケーションコンソールのレプリケーションツリーに表示されます。ステップ11:これで、 xDB Replication Server 6.2を使用して新しい複製システムを作成し、既存の複製システムを管理する準備ができました。xDB Replication Server 6.2の新しくインストールされたパブリケーションサーバーとサブスクリプションサーバーは 、それぞれデフォルトのポート番号 9051と9052 を使用するように構成されています 。セクションで説明したように、これらのポート番号は、XDBスタートアップコンフィギュレーションファイルに設定されている2.3.1.4 。xDB Replication Server 6.1.xレプリケーションシステムが 9051および9052 以外のポート番号で実行されていた場合、xDB Replication Server 6.2の設定の一部を調整して、これらの既存のレプリケーションシステムを引き続き使用する必要があります。注:ポート9052およびサブスクリプションサーバーに関する以下の変更は、シングルマスターレプリケーションシステムを実行している場合にのみ必要です。マルチマスターレプリケーションシステムのみを使用している場合、ポート9051とパブリケーションサーバーに関連する変更のみが必要です。
• xDB Replication Server 6.1.xで使用されていた古いポート番号( 9051および9052 以外 ) を引き続き使用するには 、パブリケーションおよびサブスクリプションサーバーを停止します。 xDBスタートアップ構成ファイルのPUBPORTおよびSUBPORTパラメーターの設定を9051および9052からxDB Replication Server 6.1.xが使用する古いポート番号に9052します。パブリケーションサーバーとサブスクリプションサーバーを再起動します。セクション5.2.1および5.3.1で説明されているように、パブリケーションサーバーとサブスクリプションサーバーを古いxDB Replication Server 6.1.xポート番号とadminユーザーおよびパスワードとともに登録します。
• xDB Replication Server 6.1.xレプリケーションシステムでデフォルトのポート番号 9051および9052 を使用するには 、古いポート番号をデフォルトのポート番号9051および9052置き換える必要があります。セクション5.2.1および5.3.1で説明されているように、管理ユーザーとパスワードとともにポート番号9051と9052使用して、パブリケーションサーバーとサブスクリプションサーバーを登録します。シングルマスター複製システムの場合のみ、制御スキーマに保存されているポート番号を古いポート番号から9051および9052に変更する必要があります。まず、セクション7.6.1.2で説明されている手順を実行し、次にセクション5.5.3で説明されている手順を実行します。
10.3 問題の解決10.3.1 Error Messages
解決策: Occurs when registering a publication server or subscription server. Verify the user name and password you enter matches the admin user name and password in the xDB Replication Configuration file on the host you are running the publication server or subscription server. See Section 2.3.1.3 Occurs when registering a publication server or subscription server. Verify the user name and password you enter matches the admin user name and password in the xDB Replication Configuration file on the host you are running the publication server or subscription server. See Section . 解決策: Only one publication database definition can be created for any given database. (Oracle is the exception whereby more than one publication database definition can be created for the same Oracle database if different Oracle user names are specified in each publication database definition.) The connection could not be established with the server. Verify that the server is running and accepting connections. Reason: Connection refused to host: xxxを The connection could not be established with the server. Verify that the server is running and accepting connections. Reason: Connection refused to host: . xxx . xx . xxx ; nested exception is: java.net.ConnectException: Connection refused解決策: Occurs whenever a Java RMI connection cannot be made to the publication server, the subscription server, or a database server. Can occur when registering a publication or subscription server, adding a publication database or a subscription database, or identifying the publication server for a new subscription. Verify you have entered the correct host IP address and port number of the server. Verify the server is running (see Section 10.3.4.2 Occurs whenever a Java RMI connection cannot be made to the publication server, the subscription server, or a database server. Can occur when registering a publication or subscription server, adding a publication database or a subscription database, or identifying the publication server for a new subscription. Verify you have entered the correct host IP address and port number of the server. Verify the server is running (see Section 10.3.4.2 ). If the server is running on Linux, verify that in the /etc/hosts file, the host name is mapped to the correct network IP address, which matches the IP address returned by the Linux ). If the server is running on Linux, verify that in the file, the host name is mapped to the correct network IP address, which matches the IP address returned by the Linux /sbin/ifconfig command, and also matches the IP address you entered in the Host field of the dialog box. Alternatively, instead of modifying the file, the host name is mapped to the correct network IP address, which matches the IP address returned by the Linux command, and also matches the IP address you entered in the Host field of the dialog box. Alternatively, instead of modifying the /etc/hosts file, set configuration option command, and also matches the IP address you entered in the Host field of the dialog box. Alternatively, instead of modifying the file, set configuration option java.rmi.server.hostname to the IP address of the publication or subscription server (see Section file, set configuration option to the IP address of the publication or subscription server (see Section 10.4.1.7 to the IP address of the publication or subscription server (see Section ). Do not use the loopback address 127. xを ). Do not use the loopback address . x . for this entry. x for this entry. 解決策: Occurs when attempting to save a publication database definition. The publication server cannot connect to the database server network location given in the Add Database dialog box. Verify that the correct IP address and port for the database server are given. Verify that the database server is running and is accessible from the host running the publication server. 解決策: Occurs when attempting a snapshot replication from a publication database configured with the log-based method of synchronization replication (that is, WAL based logical replication), and the additional concurrent connection for logical replication exceeds the current setting, , of the max_wal_senders Occurs when attempting a snapshot replication from a publication database configured with the log-based method of synchronization replication (that is, WAL based logical replication), and the additional concurrent connection for logical replication exceeds the current setting, n Occurs when attempting a snapshot replication from a publication database configured with the log-based method of synchronization replication (that is, WAL based logical replication), and the additional concurrent connection for logical replication exceeds the current setting, , of the max_wal_senders postgresql.conf file. Increase the value of configuration parameter in the file. Increase the value of max_wal_senders in the postgresql.conf file of the database server running the publication database. Restart the database server containing the publication database. See Section 2.2.10 file of the database server running the publication database. Restart the database server containing the publication database. See Section . 解決策: Occurs when attempting to create a subscription. If there are no publications in the specified publication server, then this error message is displayed. 解決策: The metadata database objects from a prior publication already exist in the schema under which the publication server is attempting to create new metadata database objects. Perform the operation described in Section 10.3.4.3 The metadata database objects from a prior publication already exist in the schema under which the publication server is attempting to create new metadata database objects. Perform the operation described in Section . 解決策: Make sure all publications subordinate to the publication database definition have been removed. If no publications appear under the Publication Database node in the xDB Replication Console replication tree and the error persists, there may be a problem with the control schema objects. Perform the operation described in Section 10.3.4.3 Make sure all publications subordinate to the publication database definition have been removed. If no publications appear under the Publication Database node in the xDB Replication Console replication tree and the error persists, there may be a problem with the control schema objects. Perform the operation described in Section . 解決策: The control schema objects under the Oracle publication database user schema or under the Postgres or SQL Server schemas _edb_replicator_pub , _edb_replicator_sub , or _edb_scheduler The control schema objects under the Oracle publication database user schema or under the Postgres or SQL Server schemas cannot be deleted by the publication server. The control schema objects or schemas may have already been deleted. The publication database definition cannot be removed using the xDB Replication Console. Perform the operation described in Section 10.3.4.3 cannot be deleted by the publication server. The control schema objects or schemas may have already been deleted. The publication database definition cannot be removed using the xDB Replication Console. Perform the operation described in Section . 解決策: Occurs when attempting to remove the publication database currently set as the controller database. Select another publication database to be used as the controller database. Use the Set As Controller option in the publication databases' context menu to set this database as the controller database. You can then remove the original publication database. See Section 7.7 Occurs when attempting to remove the publication database currently set as the controller database. Select another publication database to be used as the controller database. Use the Set As Controller option in the publication databases' context menu to set this database as the controller database. You can then remove the original publication database. See Section . 解決策: Occurs when attempting to set a publication database as the controller database and the database is not accessible by the publication server. Verify that the correct IP address and port has been defined in the publication database definition. Verify that the database server is running and is accessible from the host running the publication server. 解決策: Occurs when attempting to save a subscription database definition. The subscription server cannot connect to the database server network location given in the Add Database dialog box. Verify that the correct IP address and port for the database server are given. Verify that the database server is running and is accessible from the host running the subscription server. Database connection cannot be added. FATAL: no pg_hba.conf entry for host " XXX . XXX . XX . XXX ", user " USER_NAME ", database " DB_NAME ", SSL off解決策: Occurs when attempting to save a subscription database definition. The subscription server is not permitted to connect to the database at the network location given in the Add Database dialog box. Verify that the database host IP address, port number, database user name, password, and database identifier are correct. Verify there is an entry in the pg_hba.conf file permitting access to the database by the given user name originating from the IP address where the subscription server is running. Occurs when attempting to save a subscription database definition. The subscription server is not permitted to connect to the database at the network location given in the Add Database dialog box. Verify that the database host IP address, port number, database user name, password, and database identifier are correct. Verify there is an entry in the file permitting access to the database by the given user name originating from the IP address where the subscription server is running. 解決策: Occurs when attempting to add a subscription database. Verify that the xDB Replication Configuration file on the host running the subscription server contains an entry for a valid controller database. Verify that a publication database has been defined under the publication server as the controller database and its connection information is recorded in the xDB Replication Configuration file. See Section 2.3.1.3 Occurs when attempting to add a subscription database. Verify that the xDB Replication Configuration file on the host running the subscription server contains an entry for a valid controller database. Verify that a publication database has been defined under the publication server as the controller database and its connection information is recorded in the xDB Replication Configuration file. See Section . 解決策: All database servers in a multi-master replication system must be of the same type – either all PostgreSQL (or Advanced Server installed in PostgreSQL compatible configuration mode); or all Advanced Server installed in Oracle compatible configuration mode. This error message is displayed when attempting to add a master node and the database server type differs from the database server type of the master definition node. See Section 10.1.3.3 All database servers in a multi-master replication system must be of the same type – either all PostgreSQL (or Advanced Server installed in PostgreSQL compatible configuration mode); or all Advanced Server installed in Oracle compatible configuration mode. This error message is displayed when attempting to add a master node and the database server type differs from the database server type of the master definition node. See Section . 解決策: When a master node of a multi-master replication system is deleted using the xDB Replication Console or the xDB Replication Server CLI, the control schema objects that were created in the master node are also dropped. These include schemas _edb_replicator_pub , _edb_replicator_sub , and _edb_scheduler . For the log-based method of synchronization replication there are shadow tables and triggers on the publication tables as well. If any of these control schema objects fail to be dropped, this error message is displayed. See Section for directions on how to remove these control schema objects. . For the log-based method of synchronization replication there are shadow tables and triggers on the publication tables as well. If any of these control schema objects fail to be dropped, this error message is displayed. See Section 10.3.4.3 for directions on how to remove these control schema objects. . For the log-based method of synchronization replication there are shadow tables and triggers on the publication tables as well. If any of these control schema objects fail to be dropped, this error message is displayed. See Section for directions on how to remove these control schema objects. FATAL: no pg_hba.conf entry for host " XXX . XXX . XX . XXX ", user " USER_NAME ", database " DB_NAME ", SSL off解決策: Occurs when attempting to save a publication database definition. The publication server is not permitted to connect to the database at the network location given in the Add Database dialog box. Verify that the database host IP address, port number, database user name, password, and database identifier are correct. Verify there is an entry in the pg_hba.conf file permitting access to the database by the given user name originating from the IP address where the publication server is running. Occurs when attempting to save a publication database definition. The publication server is not permitted to connect to the database at the network location given in the Add Database dialog box. Verify that the database host IP address, port number, database user name, password, and database identifier are correct. Verify there is an entry in the file permitting access to the database by the given user name originating from the IP address where the publication server is running. 解決策: Occurs when attempting to define a filter rule on a column with a binary data type in a publication table. Filter rules are not permitted on such columns. See Section 2.2.12.3 Occurs when attempting to define a filter rule on a column with a binary data type in a publication table. Filter rules are not permitted on such columns. See Section . Filter with same name/clause already exist on table/view: schemaに Filter with same name/clause already exist on table/view: ます . テーブル名解決策: When adding a filter rule on a publication table, the same filter name or the same filter clause ( clause) cannot be used more than once on a given table. Modify the duplicate filter name or filter clause so it is unique for the table. When adding a filter rule on a publication table, the same filter name or the same filter clause ( WHERE clause) cannot be used more than once on a given table. Modify the duplicate filter name or filter clause so it is unique for the table. 解決策: A snapshot replication must be performed before the first synchronization replication. Perform an on demand snapshot replication. 解決策: This warning is given when is specified as the host address of a replication system component. If is strongly recommended that all replication system components are identified by their specific IP address on the network. localhost or 127.0.0.1 is specified as the host address of a replication system component. If is strongly recommended that all replication system components are identified by their specific IP address on the network. This warning is given when is specified as the host address of a replication system component. If is strongly recommended that all replication system components are identified by their specific IP address on the network. 解決策: Either the user does not have the trigger creation privilege or there is a database server problem. The database server message is displayed as part of the error. The MMR mode is currently not supported for database_type database. The MMR mode is currently not supported for database.解決策: A database server of type database_typeの A database server of type cannot be used in a multi-master replication system. Only Advanced Server or PostgreSQL database servers may be used as master nodes in a multi-master replication system. 解決策: When creating a subscription in a single-master replication system or creating a master node other than the master definition node in a multi-master replication system, only one filter may be selected for a given table. Uncheck the additional boxes in the Apply column under the Filter Rules tab if more than one box is selected. 解決策: Occurs when creating an Oracle publication or subscription database definition. Copy the Oracle JDBC driver file ojdbc x .jar to subdirectory of where the publication server or subscription server is installed on the host running the publication server or subscription server. Restart the publication server or subscription server. to subdirectory lib/jdbc of where the publication server or subscription server is installed on the host running the publication server or subscription server. Restart the publication server or subscription server. Occurs when creating an Oracle publication or subscription database definition. Copy the Oracle JDBC driver file of where the publication server or subscription server is installed on the host running the publication server or subscription server. Restart the publication server or subscription server. 解決策: Occurs when attempting to add a second master node to a multi-master replication system, but no publication has been defined under the master definition node. Create a publication under the master definition node, then add the additional master nodes. See Section 6.2.3 Occurs when attempting to add a second master node to a multi-master replication system, but no publication has been defined under the master definition node. Create a publication under the master definition node, then add the additional master nodes. See Section . 解決策: Synchronization replication failed due to the unavailability of a target database. See the publication server log file for details. See Section 10.3.2 Synchronization replication failed due to the unavailability of a target database. See the publication server log file for details. See Section . 解決策: Master nodes are still defined in a multi-master replication system in which an attempt is being made to delete the publication from the master definition node. All master nodes (other than the master definition node) must be deleted first before deleting the publication from the master definition node. Perform this deletion process with the xDB Replication Console or xDB Replication Server CLI. 解決策: Warning issued when you attempt to remove a publication with subscriptions associated with it. You can remove the publication, but the subscriptions are no longer usable and should be removed as well. 解決策: Only one publication is supported in a multi-master replication system and only one such multi-master replication system can exist for an xDB Replication Server installation. 解決策: You cannot perform synchronization replication on a snapshot-only publication. Perform snapshot replication instead. 解決策: Occurs when creating an Oracle or SQL Server publication database definition and the current controller database is not a Postgres database (that is, the controller database is an Oracle or SQL Server database). In order to create an Oracle or SQL Server publication database, create and designate a Postgres publication database as the controller database. See Section 7.7 Occurs when creating an Oracle or SQL Server publication database definition and the current controller database is not a Postgres database (that is, the controller database is an Oracle or SQL Server database). In order to create an Oracle or SQL Server publication database, create and designate a Postgres publication database as the controller database. See Section . 解決策: Table selected for a publication has a foreign key referencing a parent table that has not been chosen for the publication. This is only a warning that the parent table will not be part of the subscription. 解決策: Occurs when attempting synchronization replication and the controller database is not accessible by the publication server. Verify that the correct IP address and port has been defined in the publication database definition of the controller database. Verify that the database server is running and is accessible from the host running the publication server. Problem occurred in publish process. Reason: ERROR: permission denied for schema _edb_replicator_pub解決策: For a Postgres publication, verify that the publication database user has privilege on the publication database, or the database user is a superuser. CREATE ON DATABASE privilege on the publication database, or the database user is a superuser. 解決策: In Postgres, it is possible to create a table with no columns. A publication is not allowed to include a Postgres table with no columns since the corresponding subscription table cannot be created in Oracle. Publication cannot be created. Publication publication_name already exists on the publisher server. Please choose a different name and then proceed.解決策: Publication names must be unique within a publication server. Enter a different publication name. Publication cannot be created. Table スキーマ . table_name replica identity is set to replica_identity_settingに replica identity is set to ます . To define a Filter, the table replica identity should be set to FULL.解決策: Occurs when a table filter is attempted to be defined on a publication table used in a log-based replication system. Use the ALTER TABLE statement to change Occurs when a table filter is attempted to be defined on a publication table used in a log-based replication system. Use the REPLICA IDENTITY to FULL statement to change . See Section 2.2.12.3 . See Section . Publication cannot be created. Table table_nameに does not contain a primary key. Transactional replication is not supported for a non-pk table.解決策: All tables used for synchronization replication must have primary keys. Create a primary key on the table or add the table to a snapshot-only publication. 解決策: For a Postgres publication that is not for snapshot-only, the publication database user must be able to create triggers on the publication tables. In order to do this, the publication database user must have the privilege to execute the statement on the publication tables and the publication database user must have ALTER TABLE statement on the publication tables and the publication database user must have For a Postgres publication that is not for snapshot-only, the publication database user must be able to create triggers on the publication tables. In order to do this, the publication database user must have the privilege to execute the statement on the publication tables and the publication database user must have privileges on the schema containing the publication tables. Verify that one of the following is true: 1) All the tables in the publication are owned by the publication database user and the user has CREATE and USAGE privileges on the schema containing the publication tables. Verify that one of the following is true: 1) All the tables in the publication are owned by the publication database user and the user has statement on the publication tables and the publication database user must have privileges on the schema containing the publication tables. Verify that one of the following is true: 1) All the tables in the publication are owned by the publication database user and the user has privileges on the publication tables' schemas, or 2) the publication database user is a superuser. CREATE and USAGE privileges on the publication tables' schemas, or 2) the publication database user is a superuser. Publication cannot be removed. Reason: Publication publication_name cannot be removed. Reason: Error: cannot drop table _edb_replicator_pub.rrst_ because other objects depend on it. cannot be removed. Reason: Error: cannot drop table _edb_replicator_pub.rrst_ schema_table_nameを cannot be removed. Reason: Error: cannot drop table _edb_replicator_pub.rrst_ because other objects depend on it.解決策: PL/pgSQL custom conflict handler functions may exist in the master definition node that are dependent upon the publication's shadow tables. Drop the custom conflict handler functions before deleting the publication. Publication cannot be updated. Reason: The parent table スキーマ . table_name is selected for removal while it has one or more child tables in the publication list. Make sure that parent-child dependency holds in the publication tables.解決策: Choose the child tables for removal as well as the parent table. 解決策: A given publication cannot be used in both a multi-master replication system and a single-master replication system. 解決策: The publication does not exist for a given subscription. The subscription is no longer usable and must be removed. 解決策: Remove the subscription, remove tables from the publication, then add the subscription. The publication schema cannot be created. Reason: ERROR: Permission denied for database db_nameの The publication schema cannot be created. Reason: ERROR: Permission denied for database .解決策: Occurs when attempting to create the publication database definition and the specified publication database user does not have the privilege to create a schema in database db_nameに Occurs when attempting to create the publication database definition and the specified publication database user does not have the privilege to create a schema in database ます . Grant the CREATE privilege on the database to the publication database user 解決策: Verify that the publication server is running. See Section 10.3.4.2 Verify that the publication server is running. See Section . Verify that the database server hosting the controller database specified in the xDB Replication Configuration file is running and the publication server is connected to it. See Section 2.3.1.3 . Verify that the database server hosting the controller database specified in the xDB Replication Configuration file is running and the publication server is connected to it. See Section . 解決策: May be caused by characters in the publication data that are illegal for the character set of the subscription database. Check the snapshot replication failure log file or the database server log file. See Section 10.4.1.2 May be caused by characters in the publication data that are illegal for the character set of the subscription database. Check the snapshot replication failure log file or the database server log file. See Section . 解決策: for supported database server configurations. Use Oracle products for Oracle to Oracle replication. See Section 10.1.3 for supported database server configurations. Use Oracle products for Oracle to Oracle replication. See Section for supported database server configurations. Use Oracle products for Oracle to Oracle replication. 解像度: Occurs when attempting to add a publication database definition with the log-based method of synchronization replication, and the max_replication_slots configuration parameter in the postgresql.conf file is not set to a large enough value to accommodate the additional database. Increase the value of the max_replication_slots parameter and restart the database server. See Section file is not set to a large enough value to accommodate the additional database. Increase the value of the parameter and restart the database server. See Section 2.2.10 for additional information. parameter and restart the database server. See Section for additional information. Subscription subscription_name already exists on the subscriber server. Please choose a different name and then proceed.解決策: Subscription names must be unique within a subscription server. Enter a different subscription name. Subscription subscription_name cannot be removed. Reason: Publication does not exist on the publication server.解決策: Warning issued if the subscription you are attempting to remove does not have an associated publication. You can still remove the subscription. 解決策: You cannot remove a subscription database definition if there are subordinate subscriptions. Remove the subscriptions first. 解決策: The Subscription node you are trying to select no longer represents an existing subscription. The subscription may have been removed by a concurrent xDB Replication Console or xDB Replication Server CLI session. Click the Refresh icon in the xDB Replication Console toolbar to display the current replication tree. 解決策: Synchronization replication failed to complete for all target databases in the multi-master replication system due to the unavailability of some target database. See the publication server log file for details. See Section 10.3.2 Synchronization replication failed to complete for all target databases in the multi-master replication system due to the unavailability of some target database. See the publication server log file for details. See Section . 解決策: Oracle doesn't log changes for a large object column. Such a column cannot be referenced in the triggers that log changes to the shadow tables. Use snapshot-only replication instead. 解決策: Occurs when testing the connection of a publication or subscription database definition. The publication or subscription server cannot connect to the database server network location given in the Add Database dialog box. Verify that the correct IP address and port for the database server are given. Verify that the database server is running and is accessible from the host running the publication or subscription server. Database connection information test failed. FATAL: no pg_hba.conf entry for host " XXX . XXX . XX . XXX ", user " USER_NAME ", database " DB_NAME ", SSL off解決策: Occurs when testing the connection of a publication or subscription database definition. The publication or subscription server is not permitted to connect to the database at the network location given in the Add Database dialog box. Verify that the database host IP address, port number, database user name, password, and database identifier are correct. Verify there is an entry in the pg_hba.conf file permitting access to the database by the given user name originating from the IP address where the publication or subscription server is running. Occurs when testing the connection of a publication or subscription database definition. The publication or subscription server is not permitted to connect to the database at the network location given in the Add Database dialog box. Verify that the database host IP address, port number, database user name, password, and database identifier are correct. Verify there is an entry in the file permitting access to the database by the given user name originating from the IP address where the publication or subscription server is running. 解決策: Verify that the database server is running. For Oracle, verify that the Oracle listener program lsnrctl is running. Verify that the database server is running. For Oracle, verify that the Oracle listener program is running. 解決策: Occurs when attempting to add a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and the publication database user is not a superuser or does not have REPLICATION privilege. Grant the publication database user the appropriate privilege or specify a different database user who has the appropriate privilege for logical replication as the publication database user. See Section Occurs when attempting to add a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and the publication database user is not a superuser or does not have privilege. Grant the publication database user the appropriate privilege or specify a different database user who has the appropriate privilege for logical replication as the publication database user. See Section 2.2.10 privilege. Grant the publication database user the appropriate privilege or specify a different database user who has the appropriate privilege for logical replication as the publication database user. See Section . The target database server cannot be registered for WAL based logical replication. Reason: The database server is not configured for logical replication. Reason: FATAL: no pg_hba.conf entry for replication connection from host " XXX . XXX . XX . XXX ", user " USER_NAME ", SSL off解決策: Occurs when attempting to add a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and there is no entry in the file where the DATABASE field is set to replication for file where the DATABASE field is set to Occurs when attempting to add a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and there is no entry in the pg_hba.conf file where the DATABASE field is set to Occurs when attempting to add a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and there is no entry in the user_name . The file of the target database server must contain a replication entry for the publication database user name specified when creating the publication database definition. See Section . The pg_hba.conf file of the target database server must contain a replication entry for the publication database user name specified when creating the publication database definition. See Section 2.2.10 file of the target database server must contain a replication entry for the publication database user name specified when creating the publication database definition. See Section . 解決策: Occurs when attempting to add a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and the additional concurrent connection for logical replication exceeds the current setting, , of the max_wal_senders configuration parameter in the Occurs when attempting to add a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and the additional concurrent connection for logical replication exceeds the current setting, n Occurs when attempting to add a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and the additional concurrent connection for logical replication exceeds the current setting, configuration parameter in the postgresql.conf file. Increase the value of max_wal_senders in the postgresql.conf file of the database server running the publication database. Restart the database server containing the publication database. See Section 2.2.10 file of the database server running the publication database. Restart the database server containing the publication database. See Section . The target database server cannot be registered for WAL based logical replication. Reason: The target database server version x . x does not support WAL logical decoding.解決策: Occurs when attempting to create a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and the Postgres database server is not version 9.4 or later. Only Postgres database servers of version 9.4 or later support the log-based method of synchronization replication. See Section 2.2.10 Occurs when attempting to create a publication database definition with the log-based method of synchronization replication (that is, WAL based logical replication), and the Postgres database server is not version 9.4 or later. Only Postgres database servers of version 9.4 or later support the log-based method of synchronization replication. See Section . 解決策: The DDL statements in the text file specified for the DDL change replication feature contain syntax errors or are not supported by the DDL change replication feature. See Section 7.8 The DDL statements in the text file specified for the DDL change replication feature contain syntax errors or are not supported by the DDL change replication feature. See Section . 解決策: Occurs when attempting an operation such as performing synchronization replication or creating a schedule on a publication or subscription database that cannot be accessed by the xDB Replication Console. Verify that the publication and/or subscription servers are running. Verify that the database servers of the publication and/or subscription databases are running. 解決策: Occurs when attempting to create an MMR publication database definition and the publication server is unable to create the control schema objects in the new publication database. This typically results when creating a second publication database definition and the publication server is unable to copy by snapshot the control schema objects from the controller database to the new publication database. The publication database user of the new publication database must be a superuser. In addition, in system catalog table pg_catalog.pg_authid , column for this superuser. See Section rolcatupdate , column must be set to true for this superuser. See Section must be set to for this superuser. See Section 10.4.4 for this superuser. See Section . Unable to create Subscription subscription_name Unable to create Subscription . Reason: Connection rejected: FATAL: no pg_hba.conf entry for host " XXX . XXX . XX . XXX " user " USER_NAME ", database " DB_NAME ", SSL off解決策: Occurs when creating a subscription. The subscription server running on host xxxで Occurs when creating a subscription. The subscription server running on host . xxx . xx . xxx could not access the controller database. Verify that the file on the controller database server permits access from the subscription server host could not access the controller database. Verify that the pg_hba.conf file on the controller database server permits access from the subscription server host could not access the controller database. Verify that the file on the controller database server permits access from the subscription server host Unable to create subscription schema tables. Org.postgresql.util.PSQLException: FATAL: no pg_hba.conf entry for host " XXX . XXX . XX . XXX " user " USER_NAME ", database " DB_NAME ", SSL off解決策: Occurs when creating a subscription. The subscription server running on host xxxで Occurs when creating a subscription. The subscription server running on host . xxx . xx . xxx could not access the publication database. Verify that the file on the publication database server permits access from the subscription server host. could not access the publication database. Verify that the pg_hba.conf file on the publication database server permits access from the subscription server host. could not access the publication database. Verify that the file on the publication database server permits access from the subscription server host. 解決策: The subscription database type is not supported for the intended publication database type. See Section for a list of permitted source and target database server configurations. 10.1.3.2 The subscription database type is not supported for the intended publication database type. See Section for a list of permitted source and target database server configurations. 解決策: The subscription server was unable to create a subscription table definition in the intended target schema. Typically, the reason is that a table with the same name already exists in the target schema of the subscription database. This can occur if you create a subscription, then remove it, but fail to drop the table definitions created under the target schema, then try to create the subscription a second time. 解決策: Occurs when attempting to create an SMR publication database definition and the publication server is unable to create the control schema objects in the new publication database. This typically results when creating a second publication database definition and the publication server is unable to copy by snapshot the control schema objects from the controller database to the new publication database. The publication database user of the new publication database must be a superuser. In addition, in system catalog table pg_catalog.pg_authid , column for this superuser. See Section rolcatupdate , column must be set to true for this superuser. See Section must be set to for this superuser. See Section 10.4.4 for this superuser. See Section . Unable to perform snapshot for subscription ションsubscription_nameの Unable to perform snapshot for subscription . Reason: DB-42501: com.edb.util.PSQLException: ERROR: permission denied for relation pg_class.解決策: Occurs when attempting a snapshot replication. The database user of the database receiving the snapshot must be a superuser. In addition, in system catalog table pg_catalog.pg_authid , column for this superuser. See Section rolcatupdate , column must be set to true for this superuser. See Section must be set to for this superuser. See Section 10.4.4 for this superuser. See Section . Unable to perform snapshot for subscription ションsubscription_nameの Unable to perform snapshot for subscription . Reason: org.postgresql.util.PSQLException: FATAL: no pg_hba.conf entry for host " XXX . XXX . XX . XXX ", user " USER_NAME ", database " DB_NAME ", SSL off解決策: Occurs when attempting a snapshot replication. The publication server running on host xxxで Occurs when attempting a snapshot replication. The publication server running on host . xxx . xx . xxx could not access the subscription database. Verify that the file on the subscription database server permits access from the publication server host. could not access the subscription database. Verify that the pg_hba.conf file on the subscription database server permits access from the publication server host. could not access the subscription database. Verify that the file on the subscription database server permits access from the publication server host. Unable to synchronize. Reason: FATAL: no pg_hba.conf entry for host " XXX . XXX . XX . XXX ", user " USER_NAME ", database " DB_NAME ", SSL off理由: Occurs during an implicit synchronization following snapshot replication. The publication server running on host xxxで Occurs during an implicit synchronization following snapshot replication. The publication server running on host . xxx . xx . xxx could not access the subscription server's controller database. Verify that the file on the subscription server permits access from the publication server host using network address could not access the subscription server's controller database. Verify that the pg_hba.conf file on the subscription server permits access from the publication server host using network address xxx file on the subscription server permits access from the publication server host using network address could not access the subscription server's controller database. Verify that the file on the subscription server permits access from the publication server host using network address . xxx . xx . xxx . 解決策: The control schema objects in the publication database may have been deleted or corrupted. For an Oracle publication database the control schema objects are located in the publication database user's schema. For a Postgres or SQL Server publication database the metadata database objects are located in schemas _edb_replicator_pub , _edb_replicator_sub , and _edb_scheduler . See Section 10.3.4.3 . See Section . 解決策: An Oracle publication database user must have CONNECT , RESOURCE , and CREATE ANY TRIGGER privileges.10.3.2 Where to Look for Errors10.3.2.1 General Replication Status10.3.2.2 Snapshot Replication FailuresPOSTGRES_HOMEは、Windows postgresアカウント(Oracle互換構成モードでインストールされたAdvanced Serverのenterprisedbアカウント)のホームディレクトリです。 POSTGRES_HOMEの特定の場所は、Windowsのバージョンによって異なります。 xDB Replication Serverのバージョン番号はxで表されます。 x 。10.3.2.3 Synchronization Replication FailuresPOSTGRES_INSTALL_HOME / data / pg_logPOSTGRES_HOMEは、Windows postgresアカウント(Oracle互換構成モードでインストールされたAdvanced Serverのenterprisedbアカウント)のホームディレクトリです。 POSTGRES_HOMEの特定の場所は、Windowsのバージョンによって異なります。 xDB Replication Serverのバージョン番号はxで表され. x 。Linuxの場合のみ:パブリケーションサービスおよびサブスクリプションサービスのスタートアップログファイルedb-xdbpubserver.logおよびedb-xdbsubserver.log 、およびサービススクリプトログファイルedb-xdbpubserver_script.logおよびedb-xdbsubserver_script.logをディレクトリ/var/log/edb/xdbpubserverおよび/var/log/edb/xdbsubserverこれらのログファイルには、パブリケーションサーバーとサブスクリプションサーバーの起動に使用されるスクリプトからの出力が含まれており、通常、パブリケーションサーバーとサブスクリプションサーバーが起動されたポート番号を確認するために使用できます。注:パブリケーションサービスおよびサブスクリプションサービスの起動ログファイルは、WindowsおよびMac OS Xオペレーティングシステムでは生成されません。xDBレプリケーション構成ファイルにコントローラーデータベースのエントリがある場合、指定された接続情報を使用してこのコントローラーデータベースにアクセスできることを確認します。コントローラーデータベースパラメーターは、 host 、 port 、 type 、 user 、およびpassword 。xDBレプリケーション構成ファイルの詳細は、 2.3.1.3 項を参照してください 。10.3.2.5 Database Server ErrorsPOSTGRES_INSTALL_HOME / data / pg_log10.3.2.6 Oracle Errors10.3.3 Common Problem Checklist手順1:パブリケーションデータベースのデータベースサーバー、サブスクリプションデータベースのデータベースサーバー(シングルマスターレプリケーションシステムの場合)、およびマスターノードのデータベースサーバー(マルチマスターレプリケーションシステムの場合)がすべて実行されていることを確認します。手順2: xDBレプリケーションコンソールで情報を表示する場合、特にレプリケーションシステムの構成を変更した後、ツールバーの[更新]アイコンをクリックして、最新の情報を表示していることを確認します。手順3:パブリケーションサーバーとサブスクリプションサーバー(シングルマスターレプリケーションシステム用)が実行されていることを確認します。それらが実行されておらず、開始できない場合は、セクション10.3.4.2を参照してください。ステップ4: Oracleパブリケーションまたはサブスクリプションデータベースを使用している場合、Oracle JDBCドライバーファイルがXDB_HOME /lib/jdbcディレクトリにコピーされていることを確認します。 XDB_HOMEは、xDB Replication Serverをインストールした場所です。ステップ5:パブリケーションデータベースユーザーに必要な特権が付与されていることを確認します。Oracleパブリケーションデータベースの場合、パブリケーションデータベースユーザーに CONNECT 、 RESOURCE 、およびCREATE ANY TRIGGER特権があることを確認します 。
• msdbデータベース、データベースのユーザーがいるパブリケーションデータベースの定義で与えられたSQL Serverログインにマップされていることを確認しEXECUTEとSELECTスキーマに対する権限をdbo 。
• 前の段落で説明した同じデータベースユーザーについて、このデータベースユーザーがxDB Replication Serverメタデータデータベースオブジェクトを含むスキーマの所有者であるか、このスキーマに対する次の特権を持っていることを確認します: ALTER 、 EXECUTE 、 SELECT 、 INSERT 、 UPDATE 、およびDELETE 。
•
•
• パブリケーションテーブルを更新するデータベースユーザーについては、これらのデータベースユーザーが xDB Replication Serverメタデータデータベースオブジェクトを含むスキーマに対するEXECUTE 、 SELECT 、およびINSERT特権を持っていることを確認してください 。シングルマスターレプリケーションシステムのPostgresパブリケーションデータベースの場合、パブリケーションデータベースユーザーがスーパーユーザーであり、 pg_catalogテーブルを変更する権限を持っていることを確認し pg_catalog 。マルチマスターレプリケーションシステムのマスター定義ノードの場合、パブリケーションデータベースユーザーがスーパーユーザーであり、 pg_catalogテーブルを変更する権限を持っていることを確認し pg_catalog 。マルチマスターレプリケーションシステムのマスター定義ノード以外のマスターノードの場合、マスターノードデータベースユーザーがスーパーユーザーであり、 pg_catalogテーブルを変更する権限を持っていることを確認してください。手順6:サブスクリプションデータベースユーザーに必要な特権が付与されていることを確認します。Postgresサブスクリプションデータベースの場合、サブスクリプションデータベースユーザーがスーパーユーザーであり、 pg_catalogテーブルを変更する権限を持っていることを確認し pg_catalog 。ステップ7(Linuxのみ): /sbin/ifconfigコマンドによって返されるネットワークIPアドレスが/etc/hostsファイルのホスト名に関連付けられたIPアドレスと一致するか(セクション5.1.6.2を参照)、またはパブリケーションおよびサブスクリプションサーバー構成ファイルのjava.rmi.server.hostname構成オプションで指定されたIPアドレス(セクション10.4.1.7を参照)。10.3.4 Troubleshooting Areas10.3.4.1 Java Runtime ErrorsJavaプログラムが見つからない、Javaヒープスペースエラーなど、Javaランタイム環境に関するエラーが発生した場合は、xDBスタートアップコンフィグレーションファイル xdbReplicationServer- xx .config 設定されているパラメータを確認してください 。 xDBスタートアップコンフィギュレーションファイルの詳細については、セクション2.3.1.4を参照してください。注:サブスクリプションサーバーは、シングルマスターレプリケーションシステムにのみ適用されます。手順2:コントローラデータベースを実行しているデータベースサーバーのログファイルでエラーを確認します。手順3:パブリケーションサーバーとサブスクリプションサーバーを実行しているホスト上のxDBレプリケーション構成ファイルのユーザー名とパスワードが、パブリケーションサーバーとサブスクリプションサーバーが試行しているコントローラーデータベースを実行しているデータベースサーバーのデータベースユーザー名とパスワードと一致することを確認しますアクセスするために。ステップ4:コントローラーデータベースがPostgresデータベースの場合、そのPostgresデータベースサーバーのpg_hba.confファイルに、ユーザーがパブリケーションサーバーとサブスクリプションサーバーを実行しているホストのIPアドレスからコントローラーデータベースへのアクセスを許可するエントリがあることを確認しますxDBレプリケーション構成ファイルの名前。xDBレプリケーション構成ファイルで指定された現在のコントローラーデータベースと同じ制御スキーマ情報を共有するすべてのパブリケーションデータベースで、同じ制御スキーマ削除手順を実行する必要があります。次の例では、SMRパブリケーションデータベース edbと3つのMMRマスターノードデータベースmdnnode 、 mmrnode_a 、およびmmrnode_bはすべて、xDBレプリケーション構成ファイルで指定されたコントローラーデータベースに接続する同じパブリケーションサーバーによって管理されます。したがって、すべてのパブリケーションデータベースedb 、 mdnnode 、 mmrnode_a 、およびmmrnode_bは、同じ制御スキーマ情報が含まれている必要があります。前の例では、サブスクリプションデータベース subdbは、コントロールスキーマの削除がパブリケーションデータベースで実行された場合に削除する必要があるコントロールスキーマオブジェクトが含まれています。この削除プロセスを実行した後、セクション 5.2以降の指示に従って、シングルマスターレプリケーションシステムを再作成する必要があります。セクション6.2以降の指示に従って、マルチマスター複製システムを再作成する必要があります。このセクションでは、制御スキーマが完全でないかどうかを確認するために何を探すべきか、もしそうなら、複製システムを完全に削除するために何を削除する必要があるかについて説明します。このセクションでは、コントロールスキーマオブジェクトの内部コンテンツについては説明しません。すべてのコントロールスキーマオブジェクトが存在する場合 、コントロールスキーマテーブルのコンテンツが破損する可能性はほとんどないため、コントロールスキーマの削除に進む前に、セクション 10.3.3 のチェックリストを確認してください。ステップ1:公開サーバーを停止します。ステップ2:サブスクリプションサーバーを停止します。ステップ3:パブリケーションデータベース内に含まれるコントロールスキーマオブジェクトを探します。このセクションで使用される例では、 pubuserはパブリケーションデータベースのユーザー名です。パブリケーションは、 deptとemp 2つのテーブルで構成されています。SQL Serverのみ: SQL Serverコントロールスキーマオブジェクトのリストについては、セクション5.2.4.2を参照してください。Postgresのみ: Postgresコントロールスキーマオブジェクトのリストについては、セクション5.2.4.3を参照してください。手順4:コントロールスキーマオブジェクト(Oracleのパブリケーションデータベースユーザー名、または_edb_replicator_pub 、 _edb_replicator_sub 、 _edb_scheduler 、または_edb_replicator_pubと共にSQL Serverパブリケーションデータベースを構成するときに作成または選択したコントロールスキーマオブジェクトを含むことになっているスキーマの場合、 _edb_replicator_sub 、および_edb_scheduler for Postgres)が欠落しているか、制御スキーマの下にデータベースオブジェクトが欠落している場合、残りのすべての制御スキーマオブジェクトを削除するプロセスを完了する必要があります。ステップ5:シングルマスターレプリケーションシステムの場合、サブスクリプションデータベースには、 rrep_txset_healthという名前のテーブル形式の単一の制御スキーマオブジェクトが含まれます。サブスクリプションデータベースの各タイプのこのコントロールスキーマオブジェクトのリストについては、セクション5.3.4を参照してください。手順6:この時点で、すべてのコントロールスキーマとコントロールスキーマオブジェクトがすべてのパブリケーションデータベースとすべてのサブスクリプションデータベースにそのまま表示される場合、問題は別の場所にある可能性があります。このセクションのこれ以降の手順は続行しないでください。代わりに、セクション10.3.3のチェックリストを再確認してください。手順7:すべてのパブリケーションデータベースに対してこの手順を繰り返して、その制御スキーマと制御スキーマオブジェクトを削除します。Oracleのみ:パブリケーションユーザー名がまだ存在する場合は、SQL * Plusまたは他のOracleデータベース管理ユーティリティにログオンし、パブリケーションユーザーが所有するすべてのコントロールスキーマオブジェクトを削除します。または、カスケードオプションを使用してパブリケーションデータベースユーザーとそのデータベースオブジェクトを削除できますが、レプリケーションシステムを再構築する場合は、パブリケーションデータベースユーザーを再作成し、権限を再割り当てする必要があります。パブリケーションデータベースユーザーの作成方法については、セクション5.1.4を参照してください。次の例は、カスケードオプションの使用方法を示しています。SQL Serverのみ:手順3にリストされている制御スキーマオブジェクトのいずれかがまだ存在する場合は、SQL Serverコマンドラインプログラム、 sqlcmd 、またはSQL Server Management Studioにログオンし、これらのオブジェクトを削除します。次の例では、いくつかのコントロールスキーマオブジェクトがスキーマpubuser下に作成されたと想定しています。他の制御スキーマオブジェクトは、 _edb_replicator_pub 、 _edb_replicator_sub 、および_edb_scheduler下に作成されます。パブリケーションテーブルは、スキーマedbあるdeptとempです。_edb_replicator_pubスキーマの下のコントロールスキーマオブジェクトは、次のように削除されます。SQL Server 2008のみ:パブリケーションデータベースがSQL Server 2008の場合、次のコントロールスキーマオブジェクトを削除します。SQL Server 2012、2014のみ:パブリケーションデータベースがSQL Server 2012または2014の場合、次のコントロールスキーマオブジェクトを削除します。ドロップ _edb_replicator_pub制御スキーマを:_edb_replicator_subスキーマの下のコントロールスキーマオブジェクトとスキーマ自体は、次のように削除されます。注(SQL Server 2012、2014の場合):パブリケーションデータベースがSQL Server 2012または2014の場合、次のリストの最初のテーブルrrep_common_seqは存在しません。したがって、最初のDROP TABLE _edb_replicator_sub.rrep_common_seqコマンドを発行しないでDROP TABLE _edb_replicator_sub.rrep_common_seq 。pubuserスキーマの下の制御スキーマオブジェクトは、次のように削除されます。Postgresのみ:スキーマ_edb_replicator_pub 、 _edb_replicator_sub 、または_edb_schedulerいずれかがパブリケーションデータベースにまだ存在する場合、スキーマとそのすべてのデータベースオブジェクトを削除します。次の例は、 psqlでパブリケーションデータベースedb確立された接続を示しています。次に、 DROP SCHEMA CASCADEステートメントを使用してスキーマを削除します。手順8:サブスクリプションデータベースごとにこの手順を繰り返して、その制御スキーマと制御スキーマオブジェクトを削除します。すべてのサブスクリプションデータベースでこのテーブルを削除します。 SQL ServerおよびPostgresサブスクリプションデータベースの場合、親スキーマ _edb_replicator_subも削除します 。 Oracleサブスクリプションデータベースの場合、親スキーマはxDB Replication Serverによって生成されないため、親スキーマを保持するか削除するかを決定します。Oracleの場合のみ: RREP_TXSET_HEALTHテーブルは、サブスクリプションデータベースユーザーのスキーマに作成されます。このテーブルを削除します。ステップ9: xDBレプリケーション構成ファイルで、 user 、 password 、 host 、 port 、 database 、およびtypeパラメーターを含む行を削除しdatabase 。ステップ10:パブリケーションサーバーを起動します。ステップ11:サブスクリプションサーバーを起動します。手順12:レプリケーションツリーに次のように表示されます。ステップ13:シングルマスターレプリケーションシステムについては、セクション5.2以降で説明されているように、レプリケーションシステムを再作成する必要があります。マルチマスター複製システムについては、セクション6.2以降を参照してください。セクション 2.2.10.2で 説明したように、論理レプリケーションスロットは、同期レプリケーションのログベースの方法に使用されます。ログベースの複製システムが使用されている間、これらの複製スロットはPostgresデータベースに接続されたままです。複製システムが削除されると、これらの複製スロットも削除されます。active列が複製スロットがアクティブであるか否かを示します。アクティブなレプリケーションスロットを非アクティブにするには、最初にパブリケーションサーバーを停止します。場合は active複製スロットの列が現在表示f偽のために、あなたは、レプリケーションスロットを削除することができます。論理デコード関数の詳細については、次の場所にあるPostgreSQLコアドキュメントの セクション9.26「システム管理関数」の下のセクション9.26.6「レプリケーション関数」を参照してください 。
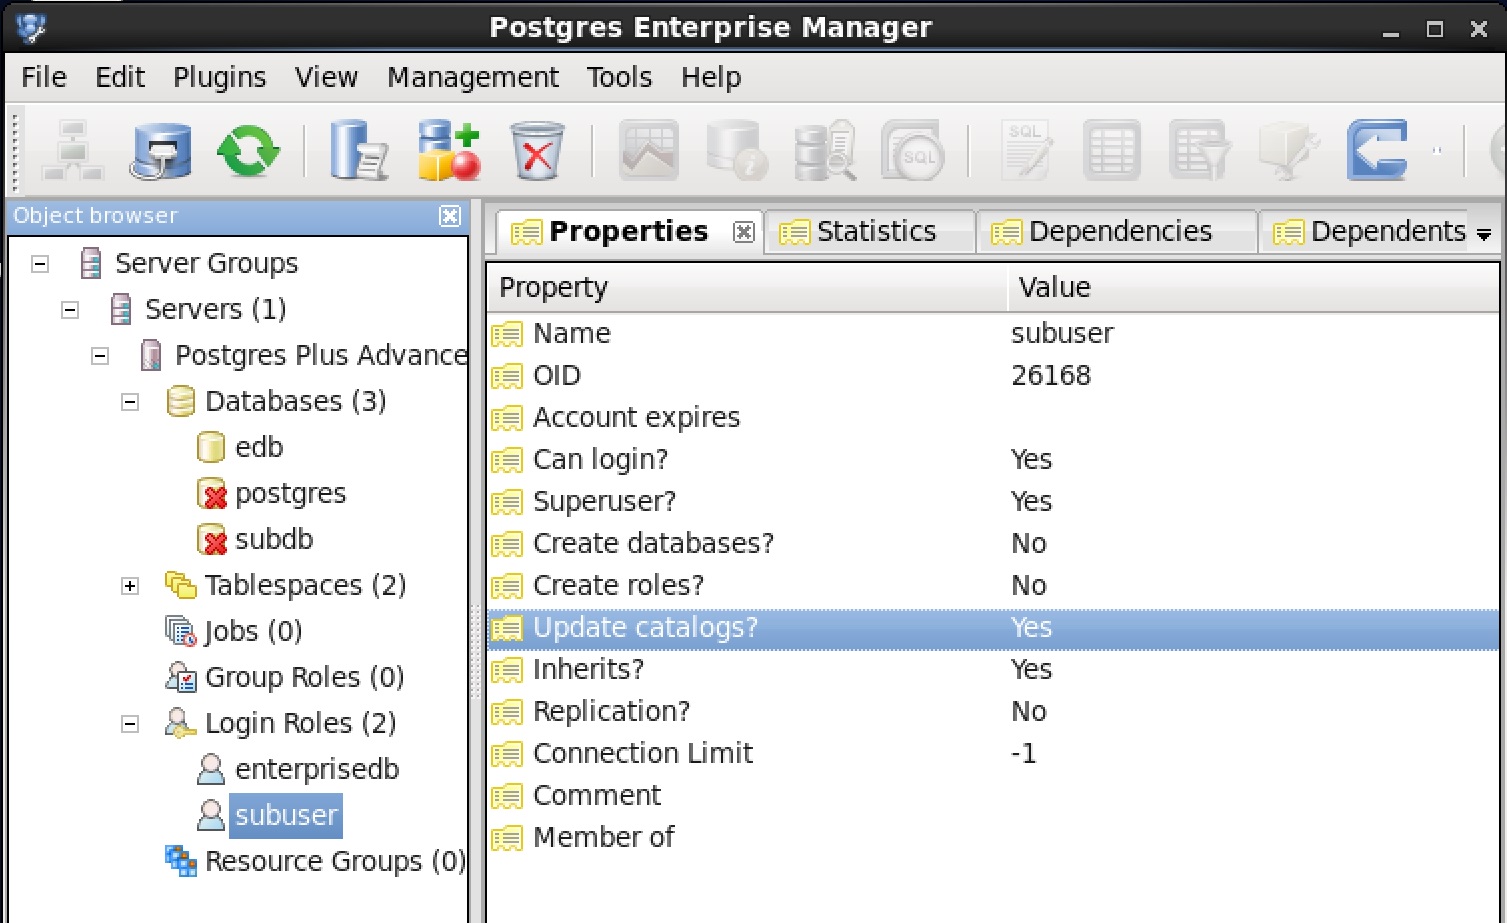
•
•
•
•
• 構成ファイルのデフォルトをオーバーライドすることで明示的に有効にされた構成オプションは、パブリケーションサーバーのログファイルとサブスクリプションサーバーのログファイルに記録されます。セクション 3.5には、これらのログファイルのディレクトリの場所が含まれています。手順1:パブリケーションおよびサブスクリプションサーバーの構成ファイルは、xDB Replication Serverのインストール中に作成され、すべての構成オプションがデフォルト設定のコメントとして既に含まれています。構成オプションの設定を変更するには、オプションからコメント記号( # )を削除し 、現在コード化されている値の代わりに目的の値を置き換えて、パブリケーションサーバーまたはサブスクリプションサーバーの構成ファイルを編集します。ステップ2:パブリケーションまたはサブスクリプションサーバーを再起動します。注:このセクションで説明するオプションは、特に指定がない限り、パブリケーションサーバーとサブスクリプションサーバーに適用されます。logging.levelオプションを設定して、パブリケーションサーバーのログファイルとサブスクリプションサーバーのログファイルに書き込まれるメッセージの重大度を制御します。デフォルト値は WARNINGです。logging.file.sizeオプションを設定して 、パブリケーションサーバーログファイルとサブスクリプションサーバーログファイルの最大ファイルサイズ(メガバイト単位)を制御します。デフォルト値は 50メガバイトです。logging.file.countオプションを設定して 、パブリケーションサーバーのログファイルとサブスクリプションサーバーのログファイルのログファイルローテーション履歴内のファイル数を制御します。n ゼロ以外の値は、作成されるログファイルの最大数を指定します。注:残りの説明では、 pubserver.logという名前のパブリケーションサーバーのログファイルを例として使用します。サブスクリプションサーバーの場合、ログファイルの名前はsubserver.logです。
•
•
• ログファイルのローテーションが有効になっている場合、最大の整数サフィックスを持つログファイルには最も古いメッセージが含まれます。履歴ローテーションですべてのファイルを生成するのに十分なメッセージがある場合、最も古いメッセージは pubserver.log. n -1ここで、 nはlogging.file.countの設定です。ログファイルpubserver.log.0は、最新のメッセージを含む現在のアクティブなログファイルです。ログファイルのローテーションが有効になり、現在のアクティブなログファイル( pubserver.log.0 )がlogging.file.sizeで指定されたサイズに達すると、次のイベントが発生します。
•
•
• 新しいアクティブなログファイルが作成されます( pubserver.log.0 )。注:このオプションは、公開サーバーにのみ適用されます。デフォルト値は 50メガバイトです。注:このオプションは、公開サーバーにのみ適用されます。n ゼロ以外の値は、作成される履歴ログファイルの最大数を指定します。
• ログファイルのローテーションが有効になっている場合、最大の整数サフィックスを持つログファイルには最も古いメッセージが含まれます。履歴ローテーションですべてのファイルを生成するのに十分なメッセージがある場合、最も古いメッセージは mtk.log. nここで、 nはmtk.logging.file.countの設定です。ログファイル mtk.logは、最新のメッセージを含む現在のアクティブなログファイルです。
•
•
•
• 新しいアクティブなログファイルが作成されます( mtk.log )。10.4.1.2 Replacing Null Characters注:このセクションで説明されているオプションは、パブリケーションサーバーにのみ適用されます。charは、ヌル文字の代わりに使用する単一の文字です。たとえば、次の組み合わせは各ヌル文字をハッシュ記号#に置き換えます。10.4.1.3 Schema Migration Options注:このセクションで説明するオプションは、サブスクリプションサーバーにのみ適用されます。デフォルトでは、パブリケーションテーブルの列 CHECK制約は、サブスクリプションの作成時にサブスクリプションテーブル定義に移行されます。サブスクリプションテーブル定義の一部としてCHECK制約が必要ない場合は、このオプションをtrue設定します。CHECK制約がパブリケーションデータベースサーバーでサポートされる組み込み関数に基づいており、この組み込み関数がサブスクリプションデータベースサーバーに存在しない場合、 このオプションを true 設定すると便利です。デフォルト値は falseです。注:このセクションで説明するオプションは、パブリケーションサーバーとサブスクリプションサーバーの両方で同じ値に設定する必要があります。注:この機能は、Advanced Serverデータベースのサブスクリプションにのみ適用されます。 PostgreSQLデータベースのサブスクリプションには適用されません。
• 範囲分割。列に定義された値の範囲により、行が格納される表領域が決まります。
• パーティションのリスト。列に定義された値のリストにより、行が格納される表領域が決まります。
• ハッシュ分割。列のアルゴリズムによりハッシュキーが生成され、行が格納されるテーブルスペースが決定されます。注: Advanced Serverを使用している場合、Oracle互換のテーブルパーティション構文を使用したテーブルパーティションは使用可能な機能です。詳細は、 『 Oracle開発者ガイドのデータベースの互換性』の表のパーティション化に関するセクションを参照してください。レプリケーションシステムにPostgresパーティションテーブルを含める方法については、セクション7.10を参照してください。このセクションで説明するimportPartitionAsTableオプションは、Oracleデータベースのテーブルパーティションにのみ適用されます。デフォルト値は falseです。とき importPartitionAsTable=false (デフォルト設定)、次の処理が発生します。注: Advanced Serverが継承したテーブルのセットとして作成されたサブスクリプションテーブルがある場合は、パブリケーションサーバー構成ファイルのenableConstBeforeDataLoadオプションもtrue設定する必要がありtrue 。セクションを参照してください。 10.4.1.6をについては、 enableConstBeforeDataLoadオプション。とき importPartitionAsTable=true 、次の処理が行われます。importPartitionAsTableオプションをtrue 設定すると、より広い範囲のOracleパーティションテーブルタイプを複製できますが、継承を使用してパーティションをシミュレートすることなく、通常のAdvanced Serverテーブルとして複製できます。注:このセクションで説明するオプションは、パブリケーションサーバーにのみ適用されます。oraJDBCCustomURL = customURL_stringドル記号( $ )が前に付いたパラメータは、Oracleパブリケーションデータベースを追加するときに指定された実際の接続値に基づいて動的に置き換えられます(セクション5.2.2を参照)。または、ドル記号が前に付いたパラメーターをURL文字列のハードコードされた値に置き換えることができます。この場合、これらのハードコードされた値は、パブリケーションデータベースを追加するときに指定された値をオーバーライドします。10.4.1.6 Snapshot Replication Options注:このセクションで説明するオプションは、特に指定がない限り、パブリケーションサーバーにのみ適用されます。スナップショットレプリケーションでJDBC COPYを使用する場合 、列値間のデータ区切り文字はエスケープされたタブ文字( \t )です。タブ区切り文字をエスケープしたくない場合は、このオプションをfalse設定します。デフォルト値は trueです。cは、データ区切り文字の単一の置換文字を示します。デフォルト値は \tです。enableConstBeforeDataLoadトリガーを含むテーブル制約は、ターゲット表にデータをロードする前に再有効化されているかどうかを制御します。デフォルトのプロセスでは、最初にテーブルがロードされ、その後制約が有効になります。デフォルト値は falseです。注:このセクションで説明するオプションは、パブリケーションサーバーとサブスクリプションサーバーに適用されます。セクション5.1.6.2で説明したように、ホスト名が非ループバックIPアドレスに関連付けられるように /etc/hostsファイルを変更する別の方法は、 java.rmi.server.hostnameオプションを使用してネットワークIPアドレスを指定することです。10.4.1.8 Using pgAgent Job Scheduling注:このセクションで説明するオプションは、パブリケーションサーバーにのみ適用されます。注: pgAgentジョブスケジューリングの使用は、Postgresがパブリケーションデータベースである場合にのみ重要です。注:パブリケーションデータベースが存在するホストにpgAgentをインストールして実行する必要があります。とき pgdbscheduleオプションがに設定されているtrue 、XDB Replication Serverのではなく、デフォルトのQuartzジョブスケジューラのpgAgentのジョブスケジューラを使用しています。
• デフォルト値は falseです。注:このセクションで説明するオプションは、パブリケーションサーバーにのみ適用されます。デフォルト値は falseです。10.4.1.10 Setting Event History Cleanup Thresholdイベント履歴のクリーンアップジョブは毎日午前12時に実行され 、 n日より古い制御スキーマ xdb_events 、 xdb_events_status 、 xdb_pub_replog 、およびxdb_pub_table_replogテーブルから完了、履歴、イベント、およびレプリケーション履歴データを削除するようにスケジュールされています 。デフォルトでは、7日より古い履歴データは削除されます。デフォルト値は 7日です。10.4.1.11 DDL Change Replication Table Locking注:このセクションで説明するオプションは、パブリケーションサーバーにのみ適用されます。DDLの変更を適用する前にテーブルに排他ロックをかけたくない場合は、 ddlChangeTableLockをfalse 設定しfalse 。このオプションは、ターゲットテーブルで予期される書き込みトランザクションがない場合にのみfalseに設定する必要があります。書き込みトランザクションが発生した場合、レプリケーションシステムによって記録されない場合があります。DDL変更レプリケーションの詳細は、 7.8 項を参照してください 。デフォルト値は trueです。注:このセクションで説明するオプションは、パブリケーションサーバーにのみ適用されます。パブリケーションサーバーの再起動後にレプリケーション履歴でゼロのトランザクションカウントレコードを維持する場合は、 persistZeroTxRepEventをtrue に設定しtrue 。そうしないと、パブリケーションサーバーが再起動されると、ゼロトランザクションカウントレコードが使用できなくなります。デフォルト値は falseです。注:このオプションは、公開サーバーにのみ適用されます。とき skipTablePrivilegesに設定されているfalseデフォルト値で、マスター定義ノードにおける出版テーブル上のデータベース・ユーザー権限は、新しく作成された非MDNノードにおける出版テーブル上の同じデータベース・ユーザーに付与されています。非MDNノードを定義するときに、パブリケーションサーバーがこれらのデータベースユーザー権限を非MDNパブリケーションテーブルおよびシャドウテーブルに付与しないようにするには、 skipTablePrivilegesをtrue に設定しtrue 。この場合、これらのテーブルへの更新アクセスを提供するデータベースユーザーに対して、非MDNノードのパブリケーションテーブルおよび対応するシャドウテーブルに対する権限を明示的に付与する必要があります。必要な特権に関する情報については、セクション5.1.4.3のステップ2を参照してください。デフォルト値は falseです。注:このオプションは、サブスクリプションサーバーにのみ適用されます。注:このオプションは、パブリケーションデータベースとサブスクリプションデータベースの両方がPostgresデータベースである場合にのみ適用されます。とき skipTablePrivilegesに設定されているtrueデフォルト値である、何のデータベースユーザーの権限は、任意のデータベース・ユーザーにこれらのサブスクリプションテーブルの上に付与されません。デフォルトでは、サブスクリプションデータベース定義の作成時に指定されたサブスクリプションデータベースユーザー(セクション5.3.2を参照)は、サブスクリプションテーブルの所有者です。ただし、サブスクリプションサーバーで、パブリケーションテーブルへのアクセス権限を既に持っている同じデータベースユーザーのサブスクリプションテーブルにデータベースユーザー権限を付与する場合は、サブスクリプションサーバー構成ファイルでskipTablePrivilegesをfalseに設定します。 (パブリケーションサーバー構成ファイルのskipTablePrivilegesの設定は、シングルマスターレプリケーションシステムのこのプロセスでは無視されます。)デフォルト値は trueです。注:このオプションは、公開サーバーにのみ適用されます。同期レプリケーションのログベースの方法を使用する場合、 walTxSetCreationIntervalオプションはトランザクションセットの作成間の時間間隔を制御します。これはトランザクションセットのサイズ(つまり、バッチサイズ)に影響します。デフォルト設定では、レプリケートされるパブリケーションテーブルへの変更が利用可能であると想定して、5,000ミリ秒(5秒)ごとにトランザクションセットが作成されます。TPMレートがより高い側にある場合、 walTxSetCreationIntervalオプションは比較的低い値に設定する必要があります。デフォルト値は 5000ミリ秒です。walStreamQueueLimitオプションは、ある時点で処理するための保留キューに保持することができるWALエントリ数の上限を規定します。キューがいっぱいになると、WALストリームレシーバーは、トランザクションエントリが処理のためにキューからポップされるため、キュー内のスペースが使用可能になるまで追加をブロックします。値0は、上限がないことを示します。設定が高すぎると、Javaヒープ領域のメモリ不足エラーが発生する可能性があることに注意してください。 Javaヒープメモリサイズの調整については、セクション 5.1.1を参照してください 。デフォルト値は 10000です。pendingTxSetThresholdオプションが達したことを保留中のトランザクションセットの数の上限しきい値限度を定義する、WALストリームから取引データの抽出を引き起こし、保留中のトランザクションが処理されるまで、その解析は保留されます。これは、データがWALストリームチャネルを介して継続的にプッシュされるが、何らかの障害または同期プロセスのスケジューリングの欠如のために処理および適用されない状況を回避するためです。これにより、Javaヒープスペースのヒープメモリエラーが発生する場合があります。 Javaヒープメモリサイズの調整については、セクション 5.1.1を参照してください 。デフォルト値は 10です。注:このオプションは、公開サーバーにのみ適用されます。jdbc.pool.validationQueryTimeout検証クエリがプールから接続を割り当てる時に実行されたときにオプションは、タイムアウトの設定を制御します。これは、接続検証クエリが失敗した場合に例外が返されるまでの秒単位の時間です。デフォルト値は 30です。xDBレプリケーション構成ファイルでパスワードを変更する必要がある場合は、最初にパスワードを暗号化する必要があります。 xDB Replication Server CLI の encryptコマンドを使用して、入力ファイルで指定されたプレーンテキスト形式からパスワードの暗号化形式を生成します。ステップ1:暗号化するパスワードを含むテキストファイルを作成します。パスワードの前後に空白を残さないでください。手順2: edb-repcli.jarファイルを使用して、最初にPATH環境変数にJava binディレクトリを含め、現在の作業ディレクトリをXDB_HOME /binして、 encryptコマンドでxDB Replication Server CLIを実行します。たとえば、 /usr/binにjava実行可能プログラムが含まれ、xDB Replication ServerがPOSTGRES_INSTALL_HOMEディレクトリにインストールされていると仮定して、次を実行します。以下に示した出力ファイル内のパスワードの暗号化された形式 encrypted :手順3:暗号化されたパスワードをコピーして、xDBレプリケーション構成ファイルに貼り付けます。10.4.3 Writing a Cron Expressioncronの式は、日付と時刻のスケジュールを表現するために使用されるテキスト文字列です。 Linux cronツールは、cron式を使用してジョブの実行をスケジュールします。 xDB Replication Serverは、複製のスケジューリングにQuartzジョブスケジューリングシステムを使用します。
Day of the month – if ダウ is given, then must be specified as is given, then dd must be specified as ? must be specified as ? Day of the week – if dd is given, then must be specified as is given, then dow must be specified as ? (3-letter day of the week abbreviations are not case sensitive)
MON,WED,FRI – Every Monday, Wednesday, and Friday MON-FRI – Every Monday through Friday 0 10 14 * * ? – Every day of every month at 2:10 PM 0 0/10 * * * ? – Every 10 minutes starting on the hour for every day of every month (eg, 8:00:00, 8:10:00, 8:20:00) When used in the day of the month ( dd ) field, means the last day of the month When used in the day of the month ( ) field, means the last day of the month When used by itself in the day of the week field ( dow ), means Saturday When used by itself in the day of the week field ( ), means Saturday 30 0 12 ? AUG L – The next Saturday in August at 30 seconds past 12:00 noon 30 0 12 ? AUG L – The next Saturday in August at 30 seconds past 12:00 noon xxx L When used in the day of the week field ( dow ) following a day of the week, means the last When used in the day of the week field ( day of the month ) following a day of the week, means the last xxx day of the month ) following a day of the week, means the last 30 0 12 ? AUG 6L – The last Friday in August at 30 seconds past 12:00 noon 30 0 12 ? AUG 6L – The last Friday in August at 30 seconds past 12:00 noon x W ) following a day of the month, x , to specify the weekday closest to ) following a day of the month, Used in the day of the month field ( dd ) following a day of the month, Used in the day of the month field ( without going over into the next or previous month. , to specify the weekday closest to xに , to specify the weekday closest to without going over into the next or previous month. 1W – The weekday closest to the 1 st of the month. If the 1 st is a Wednesday, the result is Wednesday the 1 st . If the 1 st is a Sunday, the result is Monday the 2 nd . If the 1 st is a Saturday, the result is Monday the 3 rd because the result does not go into the previous or following month. Used in the day of the week field ( dow ) to specify the Used in the day of the week field ( ) to specify the n th xxx day of the month ) to specify the
8:00:00 AM, 8:30:00 AM, 9:00:00 AM, 9:30:00 AM, 10:00:00 AM, 10:30:00 AM on the 15 th and the last day of the month of every month スナップショットレプリケーションでは、パブリケーションサーバーはEnterpriseDBのMigration Toolkitを呼び出します。これにより、テーブルの外部キー制約が無効になり、行をロードする前にターゲットテーブルを切り捨てることができます。 Postgresでは、トリガーを使用して外部キー制約が実装されるため、実際には、Migration Toolkitは各ターゲットテーブルに対してpg_catalog.pg_class 列 relhastriggersをfalse 設定することにより、ターゲットテーブルのトリガーを無効にします。
• Postgresシステムカタログ表 pg_catalog.pg_authid 、 システムカタログ表を更新しようとするスーパーユーザーを識別する行のrolcatupdate列がtrueに設定されます。この要件は、Postgresバージョン9.4以前にのみ適用されます。列rolcatupdateは、Postgres 9.5以降ではもう存在しません。ユーザーがシステムカタログテーブルを更新する権限を持っていることを確認するには、pgAdmin(Advanced ServerのPostgres Enterprise Manager Client)の[ログインロール]ノードでユーザー名を選択します。 Update Catalogsプロパティは Yes に設定する必要があります 。[ カタログの更新 ] プロパティが [ No ]に設定されている場合は、オブジェクトブラウザーでユーザー名の2番目のマウスボタンをクリックし、メニューから[プロパティ]を選択します。 [ロール特権]タブを選択し、[カタログを直接変更できる]ボックスをオンにして、[OK]ボタンをクリックします。Aは、 識別子は 、二重引用符で囲まれ、その名前( ")で作成した識別子で引用された 。二重引用符で囲まれたテキストは、アルファベット文字のデフォルトなしの場合の翻訳を与えられたとおりにオブジェクト識別子名として保存されている。引用符で囲まれた識別子は、両方のOracleで発生しますとPostgres。たとえば、 CREATE TABLE "MyTable" …は、データベースシステムのデータディクショナリにMyTableとして保存されるテーブル名を生成します。このテーブルへの参照は、名前の残りの部分に大文字のM 、大文字のT 、および小文字を使用して行う必要があります。Postgresでは、デフォルトの大文字小文字変換は小文字です。たとえば、 CREATE TABLE MyTable …は、オブジェクト識別子名CREATE TABLE MyTableになりmytable 。SQL_VARIANTその列内の個々の値は、異なるデータ型のものであってもよいように、データ・タイプは、列を定義します。たとえば、同じSQL_VARIANT列には、文字、整数、数値、および日付/時刻として明示的にキャストされた値を格納できます。ただし、 SQL_VARIANT列を含むテーブルを Postgresデータベースに複製する場合、Postgresの列の使用は、 SQL_VARIANT列のすべての値が暗黙的に変換可能な単一のデータ型に制限されます(つまり、明示的なキャストの使用)。たとえば、整数値は暗黙的にFLOATデータ型に変換できますが、浮動小数点値は暗黙的にINTEGERデータ型に変換できません。SQL_VARIANTデータ型のテーブルでレプリケーションを使用するには、次の制限が適用されます 。
• 複製されるテーブルのSQL_VARIANT列内に格納された値は、Postgresの同じデータ型に暗黙的に変換可能でなければなりません。
• 同じPostgresデータベースに複製されるSQL_VARIANT列を持つテーブルが複数ある場合 、そのようなSQL_VARIANT列にはすべて、Postgresの同じデータ型に暗黙的に変換可能な値が含まれている必要があります。Postgresサブスクリプションデータベースで、SQL Server SQL_VARIANT列に格納されている値と互換性のある基になるデータ型を使用して、 sql_variant という名前のドメインを作成します 。
10.5 サービスパックのメンテナンス