2。 |
レプリケーションサーバーをレプリケーションネットワークに参加させます。ネットワークに参加している最初のレプリケーションサーバーが、レプリケーションネットワークの リーダーサービス として機能するレプリケーションサーバーになります。レプリケーションネットワークごとにリーダーサービスは1つだけあります。 リーダーサービスとしてネットワークに参加するためのこの最初のコマンド、およびこの複製ネットワークに他の複製サーバーを追加し、このリストの以下のすべてのプロセスを実行するための後続のすべてのコマンドは、次の EPRS_HOME /client/binディレクトリから実行する必要がありますリーダーサービスを実行しているホスト。 この手順の間に、ZooKeeperが起動します。 ZooKeeperの2つのインスタンスがリーダーサービスで開始されています。単一のZooKeeperインスタンスは、ネットワークに参加している追加の複製サーバーごとに起動されます。 さらに、リーダーサービスを開始した後に、 adminという名前の adminユーザーが作成されます。その後、 adminユーザーのパスワードを設定する必要があります。 adminユーザパスワードの設定については 4.2.3項を参照してください。ネットワークへの参加についてはセクション 4.2.2を参照してください。 |
• |
特定のホスト内にセットアップするとき。手順1(レプリケーションサーバーの起動)と手順2(ネットワークへの参加)を最初に実行する必要があります。その後、ステップ3(データベースの追加)の後にステップ4(パブリケーションの作成)を続けることができます。コンシューマの場合、ステップ3(データベースの追加)が繰り返され、続いてステップ5(パブリケーションへの参加)が続きます。あるいは、ステップ3(データベースの追加)は、追加されたコンシューマデータベースでステップ4(パブリケーションの作成)およびステップ5(パブリケーションへの参加)に進む前に、複数のデータベースに対して複数回実行できます。 |
rootアカウント
として、 EPRS_HOME /server/binディレクトリーから以下を実行します。
-h 、
--host host_ip_address
-c 、
--config EPRS_HOME /server/etc
EPRS_HOME /server/etcディレクトリ
へのフルディレクトリパス 。同じホストマシン上で複数のレプリケーションサーバーを実行する場合は、
EPRS_HOME /serverディレクトリのコピーを作成し、追加のレプリケーションサーバーの
EPRS_HOME /server/etcディレクトリにある特定のプロパティファイルを変更する必要があります。変更が必要なプロパティファイルについては、 『
EDB Postgres Replication Serverリファレンスガイド』を
参照してください。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
最初の後 joinnetworkコマンドは、リーダーのサービスを確立し実行してきた、追加のレプリケーションサーバが実行することによって、ネットワークに追加された
joinnetworkユニーク指定してコマンドを
servernameレプリケーションサーバと識別するために
host_ip_address 、この追加のレプリケーションサーバが稼動しているホストの場所を指定します。
-port 8082によって与えられるようにオプションでは、レプリケーションサーバに割り当てられているデフォルトのポート番号ですngen.server.port中でパラメータapplication.propertiesファイル。同じホスト上で複数の複製サーバーを実行するためにこのポート番号が変更された場合、 -portオプションは変更されたポート番号を指定する必要があります。
とき joinnetworkリーダーサービスを確立するために使用され、
adminユーザーは、すべての権限を持つ管理者の役割、で作成されます。次に、
adminユーザーのパスワードを
-setadminpasswordコマンドで次のように設定する必要があります。
adminユーザパスワードの入力
を求めるプロンプトが表示されます。
-savepasswordオプションが含まれていない限り、
adminがコマンドを実行しているユーザーであることを示す
-user adminが指定されている場合は、後続のすべてのRepCLIコマンドにパスワードを入力する必要があります。
データベースがPostgreSQLデータベースの場合は
postgresql 、Advanced Serverデータベースの場合は
enterprisedb 指定します。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
データベースがこのパブリケーションにしか書き込めない場合は
W 指定します。これによりプロデューサのみになります。データベースがこのパブリケーションに参加している他のデータベースからの変更データも受け入れることができる場合は、
RW指定します。後者は、このデータベースを出版物の消費者と生産者の両方にします。
-nodetypeが省略された場合、デフォルトは
Wです。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
注意:それ以外の場合、レプリケートされるすべてのテーブルに主キーが必要です。パブリケーションの作成中にエラーが発生します。
データベースがこのパブリケーションからしか読み取れない場合は
R 指定してください。データベースがこのパブリケーションにしか書き込めない場合は
W指定します。これによりプロデューサのみになります。データベースがこのパブリケーションに参加している他のデータベースとの間で変更データをストリーミングおよび受信できる場合は、
RW指定します。後者は、このデータベースを出版物の消費者と生産者の両方にします。
-nodetypeが省略された場合、デフォルトは
Rです。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
通常、 joinpubコマンドは、スナップショットがすべてのターゲットデータベースに取得されストリーミングが開始される前に初期レプリケーションネットワークを作成するときに使用されることに
注意してください 。
• |
startstreamingコマンドを 再実行して startstreaming 。 |
ことに注意してください startstreamingコマンドはストリーミングがすでにレプリケーションネットワーク上で実行されている場合でも、再実行する必要があります。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH.設定によって検索されます
NGXPASSPATH.
• |
addtablesコマンド を使用するには、 create_pubパーミッションが必要です。 |
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH.設定によって検索されます
NGXPASSPATH.
• |
removetablesコマンド を使用するには、 remove_pubパーミッションが必要です。 |
注:指定されたパブリケーションのテーブルを確認するには、
listpubtableコマンドを使用して
listpubtable 。
注(MMRのみ):マルチマスターレプリケーションシステムでテーブルフィルターを使用する場合、スナップショットのテーブルコンテンツのソースを提供するマスター定義ノードには、他のマスターノードに含まれるすべてのデータのスーパーセットを含める必要があります。マルチマスターレプリケーションシステムのこれにより、スナップショットのターゲットは、他のマスターノードで有効になっているフィルタリング基準を満たすすべてのデータを確実に受け取るようになります。
注: 以下の説明では、 結果セット とは、 そのテーブルで実行され た UPDATE または DELETE ステートメントの 選択基準を満たすテーブル内の行のセットを指し ます。
ソース表
に対して INSERT文を実行した後に同期レプリケーションを実行すると、その行がフィルタリング基準を満たす場合、その行は同期のターゲット表に挿入されます。それ以外の場合、行はターゲット表への挿入から除外されます。
ソース表
に対して UPDATEステートメントが実行された後に同期レプリケーションが行われると、ソース表の
UPDATE結果セットは、同期のターゲット表に対するアクションを以下のように決定します。
場合 DELETE ステートメントは、同期複製に続いて、ソーステーブルに実行され 、以下のように 、 ソーステーブルの DELETE 結果セットは、同期の対象テーブル上のアクションを決定します。
レプリカIDENTITY FULL 設定は、ログ・ベースのレプリケーション・システムの以下のデータベースのテーブルの上に必要です。
ソース表 の REPLICA IDENTITY FULL 設定により、ソース表の特定のタイプのトランザクションで、フィルターが有効になっているターゲット表が正しく更新されます。
表ALTER スキーマを 。 table_name レプリカID FULL
レプリカIDENTITYの 設定は 、\ D + コマンドを 使用してPSQLユーティリティで表示することができ ます。
注:スナップショットを作成するには、次の権限が必要です。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
checksnapshotデータがターゲット・ノードに複製されている場合、コマンドは確認します。
今すぐ実行 checksnapshotあなたが実行した後にコマンドを
startSnapshotコマンドをデータノードをターゲットに複製されているかどうかを確認する(数秒の遅延の後に)。ステータスは完了している必要があります(データ発行およびデータインポートの場合)。
注:スナップショットステータスの取得と確認には、次の権限が必要です。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
reloadオプションを指定し
て startsnapshotコマンドを
実行する前にストリーミングを停止します。そうしないと、操作は失敗します(エラーメッセージがサーバーに記録されます)。スナップショットが完了したら、ストリーミングを明示的に再開します。
注: reloadオプションは、オフラインスナップショットには機能しません。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
以下は 、
reloadオプションを指定した
startsnapshotコマンドの
実行例です。
注意:データ移動はレプリケーションサーバの外部で行われるため、フィルタはオフラインスナップショットでは機能しません。
手順1 (
オプション):ターゲットデータベースに公開されたテーブルとスキーマが既にある場合は、この手順を省略します。すべてのパブリケーションテーブルのスキーマ定義がターゲットデータベースで適切であることを確認してください。
/ opt/edb/database_server_installation_directory/binディレクトリ
から次のコマンドを実行します 。
注:テーブルの部分的なセットがパブリケーションの一部である場合は、部分的なバックアップを取ってください(
–tablesオプションで選択されたテーブルの場合)。
この例では、次のコマンドが Advanced Server 10が実行されている
/ opt/edb/as10/binディレクトリ。ポート5432。
ステップ2(オプション):ターゲットデータベースにパブリッシュされたテーブルとスキーマが既にある場合は、このステップを省略します。すべてのパブリケーションテーブルのスキーマ定義がターゲットデータベースで適切であることを確認してください。
手順4:ターゲットノードでパブリケーションに参加する
ステップ5:スナップショットを撮ります(
offlineオプションを指定します)。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
ステップ6: checksnapshotコマンドを実行して、エクスポートされた
Snapshot Id書き留めます。
手順7:エクスポートした
Snapshot Idを使用してパブリケーションデータベース(データのみ)のバックアップを作成します。バックアップから制御スキーマ
_ngx_rep_clusterをスキップします。
Snapshot_Idを手順6でエクスポートした
Snapshot Idに置き換えた後
、 / opt/edb/ database_server_installation_directory/binディレクトリ
から次のコマンドを実行します 。
注:制御スキーマ名は構成可能です。デフォルトの制御スキーマ名は
_ngx_rep_cluster.
手順8:サブスクリプションデータベースのデータベースダンプ(データのみ)を復元します。ターゲットデータベースでダンプを復元するには、便利な方法を使用できます。ここでは、
pg_restoreユーティリティを使用してターゲットPostgreSQLデータベースのダンプを次のように復元します。
ステップ9:ターゲットデータベースのストリーミングを開始します。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
.ngxpassパスワードファイル
を含むディレクトリ 。このオプションを省略すると、
.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数
NGXPASSPATH設定によって検索されます。
• |
rootユーザーとして別の端末で、コマンド lsof -i tcp:8082を lsof -i tcp:8082してレプリケーションサーバーのプロセスIDを返し、次にコマンド kill -9 process_idを実行してレプリケーションサーバーを停止します。 lsofで与えられるコマンド、8082は、レプリケーション・サーバーが使用するポートです ngen.server.port中にパラメータ EPRS_HOME /server/etc/application.propertiesファイル。 |
• |
leavepubは、 joinpubコマンドを使用して結合したパブリケーションからデータベースを削除します。
|
• |
removepubは、 createpubコマンドで作成されたパブリケーションをレプリケーションサーバから削除します。 |
• |
removedbで追加されたレプリケーション・サーバーからデータベース削除 adddbコマンドを。 |
• |
leavenetworkは、 joinnetworkコマンドで追加されたレプリケーションネットワークからレプリケーションサーバーを削除します。 |
これらのコマンドの
詳細については、 EDB Postgres Replication Serverリファレンスガイドを
参照してください。
以下は、 MMR(2つのサーバー)を設定した
listeventsコマンドの
例です 。
注:すべてのメッセージを受信するには、
EPRS_HOME / server / etc / logback.xmlファイルの以下の行のコメントを外してください。
注意:データベースオブジェクトがプロデューサデータベースとコンシューマデータベースに作成されていることを確認してください(
4.1.1項を参照)。
コンシューマデータベース
subdb の deptテーブルに行が含まれていません。
ステップ1: Linuxの
rootユーザーアカウントとして、
EPRS_HOME /server/binディレクトリから
runServer.shスクリプトを呼び出して、リーダーサービスとして起動するホストでレプリケーションサーバーを起動し
/server/bin 。このスクリプトは、ランを指定する必要がありますされているホストのIPアドレス
--hostオプション。
ステップ2: EPRS_HOME /client/binディレクトリーに対する読み取り権限と実行権限を持つ任意のLinuxユーザー・アカウントを使用して、同じホスト上で2番目の端末を開き
/client/bin 。
EPRS_HOME /client/binディレクトリーから、
joinnetworkコマンドを使用して
runRepCLI.shスクリプトを呼び出して、複製ネットワークに参加します。
joinnetworkコマンド
を使用するときは、レプリケーションネットワークのメンバーになるレプリケーションサーバーを実行しているホストのIPアドレスと、レプリケーションサーバーのポート番号を指定します。この場合、複製サーバーはステップ1でログインしたホスト上で実行されており、ポート番号は複製サーバーのデフォルト設定の8082です。
レプリケーションサーバーが起動されたホストで
joinnetworkコマンドを
最初に使用すると、 リーダーサービスとして
-servernameオプションで指定された名前を割り当てる
サービスとして使用されます。この例では
localServiceです。
手順3: setadminpasswordコマンドを使用して、
adminというユーザ名が与えられているEDB Replication Server管理ユーザの管理者パスワードを設定する必要があります。
adminユーザーは、RepCLIコマンドを実行する権限を持ちます。
Enter admin passwordプロンプトに対して入力した応答が、
adminユーザーの
admin者パスワードになります。
これらの例の残りのRepCLIコマンドでは、管理ユーザーとしてコマンドを実行するために
-user adminが指定されています。他のユーザー名を作成し、それらがユーザーが達成できるものに特定の役割と権限を割り当てることができるRepCLIコマンドのセットがあります。この情報については
EDB Postgres Replication Serverリファレンスガイドを
参照してください。
ステップ4:パブリケーションデータベースをリーダーサービスに追加するには、
adddbコマンドを使用します。手順2で割り当てた複製サーバー名
localServiceには、
-servernameオプションを付けて指定します。
このデータベースに一意のデータベース識別子を割り当てるには
、 -dbidオプションを
使用します。このデータベース識別子は他のRepCLIコマンドで指定する必要があります。この例では、データベースID
db1が指定されています。
また、 -user adminオプションは、手順3の説明に従って指定されています。
手順5: createpubコマンドを使用してパブリケーションを作成し、変更されたデータをキャプチャして他のコンシューマデータベースにストリーミングするテーブルを指定します。
-pubnameオプションは、パブリケーションに割り当てるリケーション名を指定します。
-dbidオプションは、この出版物にあるとされているテーブルを含むデータベースを指定します。
-servernameオプションは、この出版物は、このレプリケーションサーバの一部であることを指定しlocalService 。
-tablesオプションは、パブリケーションの一部であることをしている彼らのスキーマを持つ1つ以上のテーブルを示しています。
複数のリスト schema . table_nameは、コンマの前後にスペースを入れずにコンマで区切る必要があります。
手順6:サブスクリプションデータベースをレプリケーションサーバーに追加して、コンシューマとして機能します。
adddbコマンド
のオプションについては、手順4で説明しています。
db2は、このデータベースに
-dbidオプションを使用して割り当てられたIDで
あることに注意してください 。これは、次のステップで説明する
joinpubコマンドによって参照されます。
ステップ7:サブスクリプションデータベースがパブリケーションテーブルから変更されたデータを受信できるように、パブリケーションを結合します。これを行うには、
joinpubコマンドを使用します。
-pubnameオプションでは、変更されたデータの受信元のパブリケーションを指定します。
-dbidオプションは、このデータを変更受信するサブスクリプションデータベースを識別します。
-servernameオプションは、このサブスクリプションデータベースは、ステップ6に付加したレプリケーション・サーバーを指定します。
デフォルトでは、 joinpubコマンドはデータベースがパブリケーションデータベースからの変更データの読み取りのみを許可します。
-nodetype RWオプションが
joinpubコマンドで指定されていない限り、サブスクリプションデータベーステーブルで発生した変更は他のコンシューマにストリーミングされません。
ステップ8:スナップショットを実行して、これらのサブスクリプションデータベーステーブルにパブリケーションデータベーステーブルに存在する行をロードします。
startsnapshotコマンド
の -pubnameオプションは、パブリケーション名を指定します。
-dbidオプションは、スナップショットを受信するためのターゲット消費者のデータベースを指定します。
手順9: checksnapshotコマンドを実行して(数秒後)、データがターゲットノードに複製されているかどうかを確認します。
ステップ10:すべてのパブリケーションテーブルの行の内容がパブリケーションデータベースとサブスクリプションデータベースで一貫していることを確認したら、ストリーミングを開始します。
$ ./runRepCLI.sh -startstreaming -pubname deptpub -user admin
注意:データベースオブジェクトがプロデューサデータベースとコンシューマデータベースに作成されていることを確認してください(
4.1.1項を参照)。
コンシューマデータベース
node2 の deptテーブルに行が含まれていません。
手順1: EPRS_HOME /server/binディレクトリから
runServer.shスクリプトを呼び出して、リーダーサービスとして起動するホストでレプリケーションサーバーを起動し
/server/bin 。
ステップ2:同じホスト上で2番目の端末を開きます。
EPRS_HOME /client/binディレクトリーから、
joinnetworkコマンドを使用して
runRepCLI.shスクリプトを呼び出して、複製ネットワークに参加します。
手順3: adminユーザーの
admin者パスワードを設定します。
-user adminオプションを指定して後続のRepCLIコマンドを呼び出すときにプロンプトが出されたら、このパスワードを使用してください。
ステップ4:パブリケーションデータベースをリーダーサービスに追加します。手順2で指定した複製サーバー名は、
-servernameオプションで指定されます。
このデータベースに一意のデータベース識別子を割り当てるには
、 -dbidオプションを
使用します。このデータベース識別子は他のRepCLIコマンドで指定する必要があります。
手順5:パブリケーションを作成して、変更されたデータをキャプチャしてサブスクリプションデータベースにストリーミングするテーブルを指定します。
ステップ6:サブスクライバを実行するホストマシンにログインし、そのホストにインストールされている
EPRS_HOME /server/binディレクトリから
runServer.shスクリプトを呼び出します。
手順7: -hostオプションを使用してサブスクリプションホストのホストIPアドレスを指定して
joinnetworkコマンドを実行し、サブスクリプションホストマシンのレプリケーションサーバーをレプリケーションネットワークに参加させます。
注: joinnetworkコマンドおよびすべての追加のRepCLIコマンドは、ステップ6でログインしたサブスクライバホストからではなく、必ずリーダーサービスホストマシンから実行してください。
手順8: -servernameオプションでレプリケーションサーバー名
remoteServiceを指定して、サブスクリプションデータベースをサブスクリプションホスト上のレプリケーションサーバーに追加します。後続の
joinpubコマンドで指定された複製サーバーは、データベースへの接続が行われるソースになります。
データベースに固有のデータベースIDを割り当てるには
、 -dbidオプションを
使用します。データベース識別子は他のRepCLIコマンドで指定されます。
ステップ9:サブスクリプションデータベースがパブリケーションテーブルから変更されたデータを受信できるようにパブリケーションに参加します。
-pubnameオプションを指定した
joinpubコマンドでは、変更されたデータの受信元のパブリケーションを指定します。
-dbidオプションは、このデータを変更受信するサブスクリプションデータベースを識別します。
-servernameオプションは、データベース接続が複製を受け取るために作られているから、レプリケーション・サーバーを指定します。
ステップ10:スナップショットを実行して、パブリケーションデータベーステーブルに存在する行を含むサブスクリプションデータベーステーブルをロードします。
startsnapshotコマンド
の -pubnameオプションは、パブリケーション名を指定します。
-dbidオプションは、スナップショットを受信するためのターゲット消費者のデータベースを指定します。
手順11: checksnapshotコマンドを実行して(数秒後)、データがターゲットノードに複製されているかどうかを確認します。
ステップ12:すべてのパブリケーションテーブルの行の内容がパブリケーションデータベースとサブスクリプションデータベースで一貫していることを確認したら、ストリーミングを開始します。
注意:データベースオブジェクトがプロデューサデータベースとコンシューマデータベースに作成されていることを確認してください(
4.1.1項を参照)。
手順1: EPRS_HOME /server/binディレクトリから
runServer.shスクリプトを呼び出して、リーダーサービスとして起動するホストでレプリケーションサーバーを起動し
/server/bin 。
ステップ2:同じホスト上で2番目の端末を開きます。
EPRS_HOME /client/binディレクトリーから、
joinnetworkコマンドを使用して
runRepCLI.shスクリプトを呼び出して、複製ネットワークに参加します。
手順3: adminユーザーの
admin者パスワードを設定します。
-user adminオプションを指定して後続のRepCLIコマンドを呼び出すときにプロンプトが出されたら、このパスワードを使用してください。
ステップ4:パブリケーションデータベースをリーダーサービスに追加します。手順2で指定した複製サーバー名は、
-servernameオプションで指定されます。
このデータベースに一意のデータベース識別子を割り当てるには
、 -dbidオプションを
使用します。このデータベース識別子は他のRepCLIコマンドで指定する必要があります。
使用 -nodetype RW出版物に
リード/ライトされるオプションは、で識別されたパブリケーションのテーブルを所有するデータベース、ことを指定
-dbidオプションは、ほかに、独自のテーブルに変更されたデータを受け入れ、適用することです他のコンシューマデータベースに独自の変更をストリーミングすること。
使用 -nodetype RW上のオプション
createpubコマンドだけでなく、上の
joinpubコマンドは、任意のデータベース上の出版テーブルの変更が複製され、クラスタ内の他のすべてのデータベースに適用されているMMRクラスタにつながるものです。
createpub場合、コマンド、 -nodetypeオプションが省略され、デフォルトの効果がある-nodetype W出版テーブルを所有しているデータベースは、その変更が他のデータベースの消費者にストリーミングすることができ、それは受け入れないことを意味し、 書き込み専用です、他のデータベースから自分自身のテーブルに変更を適用します。
手順6: -nodetype RWオプションを使用して2番目のパブリケーションを作成します。
ステップ7: 2番目のレプリケーションノードとして機能するホストマシンにログインし、そのホストにインストールされている
EPRS_HOME /server/binディレクトリから
runServer.shスクリプトを呼び出します。
手順8: 2番目の複製ノードホストのホストIPアドレスを
-hostオプションで指定して
joinnetworkコマンドを実行し、2番目の複製ノードホストマシン上の複製サーバーを複製ネットワークに参加させる。
注:必ずステップ7でログインした2番目の複製ノード・ホストからではなく、リーダー・サービス・ホスト・マシンから
joinnetworkコマンドを実行してください。
手順9: -servernameオプションでレプリケーションサーバー名
remoteServiceを指定して、MMRクラスターのもう一方のデータベースを2番目のレプリケーションノードホスト上のレプリケーションサーバーに
-servernameます。
データベースに固有のデータベースIDを割り当てるには
、 -dbidオプションを
使用します。データベース識別子は他のRepCLIコマンドで指定されます。
ステップ10:最初のパブリケーションに参加して、この2番目のMMRデータベースがパブリケーションテーブルから変更されたデータを受信できるようにします。
-pubnameオプションを指定した
joinpubコマンドでは、変更されたデータの受信元のパブリケーションを指定します。
-dbidオプションは、このデータを変更受信するデータベースを識別します。
-servernameオプションは、このデータベースは、手順9に付加したレプリケーション・サーバーを指定します。
デフォルトでは、 joinpubコマンドはデータベースがパブリケーションデータベースからの変更データの読み取りのみを許可します。これらのデータベーステーブルで発生する可能性のある変更は、
-nodetype RWオプションが
joinpubコマンドで指定されていない限り、他のコンシューマにストリーミングされません。
ステップ12:スナップショットを実行して、パブリケーションデータベーステーブルに存在する行を含むこれらのデータベーステーブルをロードします。
startsnapshotコマンド
の -pubnameオプションは、パブリケーション名を指定します。
-dbidオプションは、スナップショットを受信するためのターゲット・データベースを指定します。
手順13: checksnapshotコマンドを実行して(数秒後に)、データがターゲットノードに複製されているかどうかを確認します。
ステップ14: 2番目のパブリケーションでスナップショットを作成します。
ステップ15: checksnapshotコマンドを実行して(数秒後に)データがターゲットノードに複製されているかどうかを確認します。
ステップ16:すべてのパブリケーションテーブルの行の内容がデータベース間で一貫していることを確認したら、ストリーミングを開始します。
startstreamingコマンド
の -pubnameオプションは、パブリケーション名を指定します。
ステップ17: 2番目のパブリケーションでストリーミングを開始します。
注意:データベースオブジェクトがプロデューサデータベースとコンシューマデータベースに作成されていることを確認してください(
4.1.1項を参照)。
他のデータベース node2と
node3は、
deptテーブルに行を含みません。
手順1:すべてのノードでレプリケーションサーバーを起動します。
手順2:すべてのレプリケーションサーバーをレプリケーションネットワークに参加させる。
EPRS_HOME /client/binディレクトリに、起動することにより、レプリケーションネットワークに参加runRepCLI.shでスクリプトをjoinnetworkコマンド。
最初に実行した
joinnetworkコマンドは、リーダーサービスとしての使用法を確立します。
手順3:すべてのレプリケーションサーバーにデータベースを追加する
adddbコマンドの
-servernameオプションは、データベースを追加するホスト上のレプリケーションサーバーを指定します。
各データベースに固有のデータベースIDを割り当てるには
、 -dbidオプションを
使用します。データベース識別子は他のRepCLIコマンドで指定されます。
手順4: -nodetype RWオプションを使用してリーダーサービスでパブリケーションを作成し、他のプロデューサーから変更されたデータを受け入れられるようにするとともに、パブリケーションに参加している他のコンシューマーに独自の変更データをストリーミングする。
ステップ5:データベースがパブリケーションテーブルから変更されたデータを受信できるように、パブリケーションを結合します。
-pubnameオプションを指定した
joinpubコマンドでは、変更されたデータの受信元のパブリケーションを指定します。
-dbidオプションは、このデータを変更受信するデータベースを識別します。
-servernameオプションは、データベースが付加されたレプリケーション・サーバーを指定します。
デフォルトでは、 joinpubコマンドはデータベースがパブリケーションデータベースからの変更データの読み取りのみを許可します。これらのデータベーステーブルで発生する可能性のある変更は、
-nodetype RWオプションが
joinpubコマンドで指定されていない限り、他のコンシューマにストリーミングされません。
手順6:スナップショットを実行して、これらのコンシューマデータベーステーブルにパブリケーションデータベーステーブルに存在する行をロードします。
startsnapshotコマンド
の -pubnameオプションは、パブリケーション名を指定します。
-dbidオプションは、スナップショットを受信するためのターゲット・データベースを指定します。
手順7: checksnapshotコマンドを実行して(数秒後に)データがターゲットノードに複製されているかどうかを確認します。
手順8:スナップショットを実行して、これらのコンシューマデータベーステーブルにパブリケーションデータベーステーブルに存在する行をロードします。
ステップ9:すべてのパブリケーションテーブルの行の内容がパブリケーションデータベースとサブスクリプションデータベースで一貫していることを確認したら、ストリーミングを開始します。
startstreamingコマンド
の -pubnameオプションは、パブリケーション名を指定します。
schema_nameは、検証対象のテーブルを含むソースデータベース内のスキーマの名前です。
optionは、このセクションの後半のOptionsサブセクションに記載されてい
option 。
データベース接続オプション(前の構文図にリストされている
-sdbmsから
-tpw )を指定すると、
datavalidator.propertiesファイル内の対応するパラメーターがオーバーライドされます。
datavalidator.propertiesファイルについては、
7.1項を参照してください。
-ss 、 -
--source-schema schema
-ts 、
--target-schema -ts --target-schema schema
-it 、--
--include-tables table_1 [, table_2 ] ...
-et 、
--exclude-tables table_1 --exclude-tables table_1 [, table_2 ] ...
-srs 、
--skip-rowsonlyin-source { true | false }
とき true指定され、ソースデータベースのテーブルにだけ存在する行の差異のログはスキップされます。デフォルトは
falseです。
-srt 、
--skip-rowsonlyin-target { true | false }
とき true指定され、ターゲット・データベースのテーブルにだけ存在する行の差異のログはスキップされます。デフォルトは
falseです。
-srb 、
--skip-rowsin-both { true | false }
場合 true指定され、同じ主キーを持つソースおよびターゲット・データベース・テーブルの両方に存在する行の差異のロギング、しかしと異なる非主キー値がスキップされます。デフォルトは
falseです。
-ld 、 -
--logging-dir log_directory_path
Data Validatorのログファイルと差分ファイルが作成および格納される場所へのディレクトリパス。場合 log_directory_path存在しない場合、データValidatorは、それを作成しようとします。フル・ディレクトリー・パスが指定されていない場合、
log_directory_pathが作成されるか、
runValidation.shスクリプトが呼び出される
EPRS_HOME / datavalidator/ binサブディレクトリーを基準にして配置されると想定されます。 (つまり、logsディレクトリーは
EPRS_HOME / datavalidator /bin/ log_directory_pathです。)
runValidation.shスクリプトを呼び出すために使用されるオペレーティング・システム・アカウントに、ディレクトリーがまだ存在しない場合はそのディレクトリーを作成する特権、またはファイルを作成する特権があることを確認してください。指定されたディレクトリが既に存在する場合省略した場合、デフォルトは
EPRS_HOME /bin/logsディレクトリーです。
-ds 、--
--display-summary { true | false }
データ検証機能の要約のみを表示するには、
trueを
指定し true 。これにより、ソースデータベースとターゲットデータベースの接続情報、およびソースデータベーステーブル別の結果の詳細な内訳が省略されます。すべてのデータ検証ツールの結果を表示するには、
falseを指定し
false 。 Data Validatorが呼び出されたときにコマンドラインコンソールに表示される情報の種類と量は、その実行のログファイルにも格納されている情報と同じです。省略した場合、デフォルトは
false (つまり、すべてのData Validator結果が表示されます)。
-sh 、 -
--source-host host
-sp 、 -
--source-port port
-sdb 、
--source-database -sdb --source-database dbname
-su 、
--source-user -su --source-user user
-spw 、
--source-password -spw --source-password password
-th 、 -
--target-host host
-tp 、 -
--target-port port
-tdb 、
--target-database -tdb --target-database dbname
-tu 、 -
--target-user user
-tpw 、
--target-password -tpw --target-password password
-bs 、 -
--batch-size row_count
-bsオプションは、ソースおよびターゲット・データベース・テーブルを横切って比較のために使用されるバッチにグループに行数を指定します。たとえば、テーブルに1000行が含まれている場合、 -bs設定を100にすると、ソースデータベースとターゲットデータベースの比較を完了するために10回のバッチ反復が必要になります。 Data Validatorは、ソーステーブルとターゲットテーブルの両方から100行を読み取り、それらをソースバッファとターゲットバッファに追加します。検証スレッドは、ソースバッファとターゲットバッファから100行を読み取り、比較を実行します。その後、比較のために次の100行を読み取って準備します。データベースから100行を-fsために必要な実際のデータベースラウンドトリップは、フェッチサイズの-fsオプションによって異なります。たとえば、 -fsを100に設定すると1往復だけで済み、 -fsを10に設定すると10回のデータベース往復が必要になります。
-fs 、
--fetch-size row_count
スキーマ EDBのテーブルと、ソースデータベースのテーブル
DEPTおよび
EMP内容を
以下に示します。
• |
ソースの DEPTテーブルには、ターゲットのAdvanced Serverの deptテーブルには存在しない、 DEPTNO 50余分な行が1つ含まれています。 |
• |
EMPNO値が 9001と 9002 の EMP表 の行には 、ソースAdvanced Server表とターゲットAdvanced Server表の間で異なる列値があります。 |
• |
この例では、 JOBHISTテーブルには、ソースAdvanced ServerテーブルとターゲットAdvanced Serverテーブルの両方に対して同一の行が含まれています。 |
datavalidator.propertiesファイル
の内容は次のように設定されています。
Data Validatorログファイルは 、
-ldオプションで指定された
/EPRS_home/datavalidator/bin/logs 、ディレクトリ /EPRS_home/datavalidator/bin/logs / 作成されます。
runValidation.shスクリプトを呼び出すために使用されたオペレーティング・システム・アカウントは、
EPRS_homeディレクトリーへの書き込み
runValidation.shを持っているので、データ
/EPRS_home/datavalidator/bin/logsは
/EPRS_home/datavalidator/bin/logsサブディレクトリーを作成できます。
Validated tables count: 3
Tables having only unsupported datatypes count: 0
Tables having primary key limitation count: 0
• |
JOBHIST表には、エラーが含まれていません。 |
1。 |
エラー: 他のコマンドを実行する前に最初に管理者パスワードを設定してください。 |
原因: レプリケーションサーバにデータベースを追加する前に管理者パスワードが設定されていません。
対処方法: データベースをレプリケーションサーバに追加する前に管理者パスワードを設定します。
2。 |
エラー : パスワードを暗号化できません。理由無効なユーザー名またはパスワード。 |
回避策:正しいユーザー名またはパスワードを入力してください。
3。 |
エラー: エラーが発生しました:id database_Idのデータベース を追加できませんでした 。 |
原因:このエラーは次のような状況で発生する可能性があります。
回避策 :正しい暗号化パスワードを入力します。正しいIPアドレス(データベースホストのIPアドレス)を入力してください。データベースサーバが起動しているか確認してください。
encrypt コマンドを使用 してデータベースのパスワードを 暗号化 し、データベースを追加するときに同じ パスワードを使用 します。
4。 |
エラー: ID db1のデータベースを追加できませんでした。警告:接続エラー:致命的:ホスト "xxxx" 、ユーザー " xxx"、 データベース " database_Id " のpg_hba.confエントリがありません 、SSLがオフです。 |
原因:データベースホストのIPアドレスが
pg_hba.confファイルに存在しません。
回避策:データベースホストのIPアドレスを
pg_hba.confファイル
var / lib / edb /に x /としてあります。クラスタの場合、
pg_hba.confファイルは
/ var / lib / edb / as x / cluster x ます。
x EDB高度なバージョンで、
クラスター x データベースが稼働しているクラスター(例えば、cluster1またはcluster2など)。
5。 |
エラー: データベースID database_Id がネットワークに登録されていません。 |
原因:データベースが存在しないか、正しくないデータベースIDが指定されています。
回避策:正しいデータベースIDを指定するか、
create databaseコマンドを使用してデータベースを
作成します 。
6。 |
エラー: サーバー server_name はネットワークに登録されていません。 |
原因:誤ったサーバー名が指定されたか、サーバーがネットワークに存在しません。
回避策:正しいサーバー名を指定するか、
joinnetworkコマンドを使用してサーバーをネットワークに登録します。
7。 |
エラー: パブリケーション publication_name が見つかりません。
|
原因: 出版物が存在しないか、正しくない出版物名が指定されています。
回避策:正しいパブリケーション名を入力するか、パブリケーションを作成してください。
8。 |
エラー: パブリケーション publication_nameに DB ID database_Idの サブスクリプションが 見つかりません 。 |
原因:指定された
データベースIDが正しくないか、データベースが存在しません。
回避策:正しい
database_Idまたは
データベースが存在しない場合は作成します。
9。 |
Error: スナップショットを実行できません。パブリケーションデータベースID database_Id はコンシューマデータベースID database_Id と同じ です。 |
原因:パブリケーションデータベースはコンシューマデータベースと同じです。
回避策:パブリケーションデータベースとコンシューマデータベースは異なる必要があります。
10。 |
エラー: 1つ以上のサブスクリプションがパブリケーション publication_nameに 関連付けられてい ます。出版物を削除する前に、(leavepubコマンドで)購読を解除してください。 |
原因: removepub パブリケーションがネットワークを離れる前にcommandが実行されます。
回避策:パブリケーションを削除する前に
、すべてのサブスクリプションデータベースに対して leavepubコマンド
を実行して
ください 。
Error: データベースはパブリケーションサービスによってすでに登録されているので登録できません。
原因:データベースはレプリケーションクラスタに一度だけ登録できます。
回避策:データベースはすでに登録されています。
createpubコマンドを使用して、必要なテーブルを含むパブリケーションを作成できます。
Error: スレッド "main"で例外が発生しましたjavax.ws.rs.ProcessingException:java.net.ConnectException:接続が拒否されました
原因: EDB Replication Serverに接続できないときに発生します。
回避策: サーバーの正しいホストIPアドレスとポート番号を入力したことを確認してください。サーバーが稼働していることを確認してください。 pg_hba.conf ファイルで、ホスト名が正しいネットワークIPアドレスにマッピングされている ことを確認し ます。これは、Linuxの ifconfig コマンド によって返されるIPアドレスと一致します 。 パブリケーションサーバが pg_hba.conf ファイル 内のデータベースにアクセスできるかどうかを確認してください 。
エラー: 接続が拒否されました。ホスト名とポートが正しいこと、およびポストマスターがTCP / IP接続を受け入れていることを確認してください。
原因: パブリケーションデータベース定義を保存しようとしたときに発生します。パブリケーションサーバーがデータベースサーバーのネットワークの場所に接続できません。
回避策: データベースサーバーの正しいIPアドレスとポートが指定されていることを確認してください。データベースサーバが実行されていて、パブリケーションサーバを実行しているホストからアクセスできることを確認します。
エラー: データベースサーバーに接続できませんでした。理由:FATAL:要求されたスタンバイ接続数がmax_wal_sendersを超えています(現在は n )。
原因: デフォルトでログベースの同期レプリケーション(つまり、WALベースの論理レプリケーション)で構成されているパブリケーションデータベースからスナップショットレプリケーションを試行し、論理レプリケーション用の追加の同時接続が現在の設定 n を超えた 場合 に発生します。 postgresql.conf ファイル のmax_wal_senders設定パラメータ
回避策: パブリケーションデータベースを実行しているデータベース・サーバーの postgresql.conf ファイル 内 max_wal_senders の値を増やし ます。パブリケーションデータベースを含むデータベースサーバーを再起動します。
postgresql.conf ファイル のパス は / var / lib / edb / as x / cluster x です。
x EDB高度なバージョンで、
クラスター x データベースが稼働しているクラスター(例えば、cluster1またはcluster2など)。
エラー: 現在パブリケーションサーバーにパブリケーションが存在しません。サーバー上に少なくとも1つのパブリケーションを作成してから再試行してください。
原因 :指定されたパブリケーションサーバーにパブリケーションがないときにパブリケーションに参加すると、このエラーメッセージがスローされます。
回避策 : createpub コマンドで パブリケーションを作成してからパブリケーションに 参加します。
エラー: データベースを削除できません。理由:パブリケーションデータベース接続に対して1つ以上のパブリケーションが定義されているため、パブリケーションデータベース接続を削除できません。
原因: データベースに既存のパブリケーションがあります。
回避策: パブリケーションデータベースに関連するすべてのパブリケーションが削除されていることを確認してください。 出版物を取り除くために パブリケーションと removepub コマンドを 残すために leavepub コマンドを 使用します 。
エラー: データベース接続を追加できません。ホストの無いpg_hba.confのエントリ 、ユーザー"USER_NAME"、 データベース" データベース名 "、SSLオフ :FATAL "XXX のXXX XXX。。。"
原因: adddb コマンド を使用してデータベース定義を保存しようとしたときに発生します 。
回避策: データベースホストのIPアドレス、ポート番号、データベースユーザー名、パスワード、およびデータベース識別子が正しいことを確認してください。 pg_hba.conf ファイルに、EDB Replication Serverが実行されているIPアドレスから始まる指定のユーザ名でデータベースへのアクセスを許可 するエントリがあることを確認し てください。
エラー: BYTEA、BLOB、RAWなど、バイナリデータ型の列にフィルタを定義することはできません。
原因: パブリケーションテーブルのバイナリデータ型の列にフィルタルールを定義しようとしたときに発生します。そのような列では、フィルター規則は許可されません。
回避策: バイナリデータ型の列にフィルタを追加しないでください。
エラー: 同じ名前/句を持つフィルタがテーブル/ビュー: schemaに 既に存在し ます 。 table_name
原因: パブリケーション表にフィルター規則を追加するとき、同じフィルター名または同じフィルター句(WHERE句)を特定の表に複数回使用することはできません。
回避策: 重複したフィルタ名またはフィルタ句を修正して、テーブルに対して一意になるようにします。
エラー: 1つ以上のパブリケーションテーブルに対するトリガの作成に失敗しました。データベースが有効な状態にあり、ユーザーに必要な特権が付与されていることを確認してください。
原因: ユーザーにトリガー作成権限がないか、データベースサーバーに問題があります。データベースサーバメッセージはエラーの一部として表示されます。
回避策: データベースを追加するときに十分な権限を持つユーザー名を指定してください。
エラー: 発行プロセスで問題が発生しました。理由:接続が拒否されました。ホスト名とポートが正しいこと、およびポストマスターがTCP / IP接続を受け入れていることを確認してください。
解決策: 同期レプリケーションを試行し、コントローラデータベースがパブリケーションサーバーからアクセスできない場合に発生します。
回避策: コントローラデータベースのパブリケーションデータベース定義で正しいIPアドレスとポートが定義されていることを確認します。データベースサーバが実行されていて、パブリケーションサーバを実行しているホストからアクセスできることを確認します。
1。 |
エラー: パブリケーションを作成できません。パブリケーション publication_name はパブリッシャーサーバーに既に存在します。別の名前を選択してから続行してください。 |
原因: パブリケーション名はパブリケーションサーバー内で一意である必要があります。
回避策: 別のパブリケーション名を入力してください。
2。 |
エラー: パブリケーションを作成できません。テーブルスキーマ 。 table_name レプリカIDは replica_identity_settingに 設定されてい ます 。フィルタを定義するには、テーブルレプリカIDをFULLに設定する必要があります。 |
原因: ログベースのレプリケーションシステムで使用されているパブリケーションテーブルにテーブルフィルタを定義しようとしたときに発生します。
対処方法: ALTER TABLE文を使用してREPLICA IDENTITYをFULLに変更します。
3。 |
エラー: パブリケーションを作成できません。テーブル table_nameに 主キーが含まれていません。トランザクションレプリケーションは、pk以外のテーブルではサポートされていません。 |
原因: 同期レプリケーションに使用されるすべての表に主キーが必要です。
エラー: パブリケーションスキーマを作成できません。理由:エラー:データベース db_name に対する権限が拒否されました 。
原因: パブリケーションデータベース定義を作成しようとしたときに、指定されたパブリケーションデータベースユーザーにデータベース db_nameに スキーマを作成する権限がない場合に発生し ます 。
回避策: パブリケーションデータベースのユーザーにデータベースに対するCREATE権限を付与します。
エラー: ターゲットデータベースサーバーにレプリケーションスロットがありません。データベースサーバでmax_replication_slots GUCを設定してください。
原因:同期レプリケーションのログベースの方法でパブリケーションデータベース定義を追加しようとしたときに発生し、
postgresql.confファイルのmax_replication_slots構成パラメータが追加データベースを収容するのに十分な大きさの値に設定されていません。
回避策: max_replication_slotsパラメータの値を大きくしてデータベースサーバーを再起動します。
Error: main "javax.ws.rs.ProcessingException:java.net.ConnectException:接続が拒否されました(接続が拒否されました)
原因: EDB Replication Serverが実行されていません。
5。 |
/usr/edb/rs-7.0/server/etc/application.propertiesファイル 内の以下の値を確認して ください 。 |
注意: EDB Replication Serverをインストールした後に、次のディレクトリが存在することを確認してください。
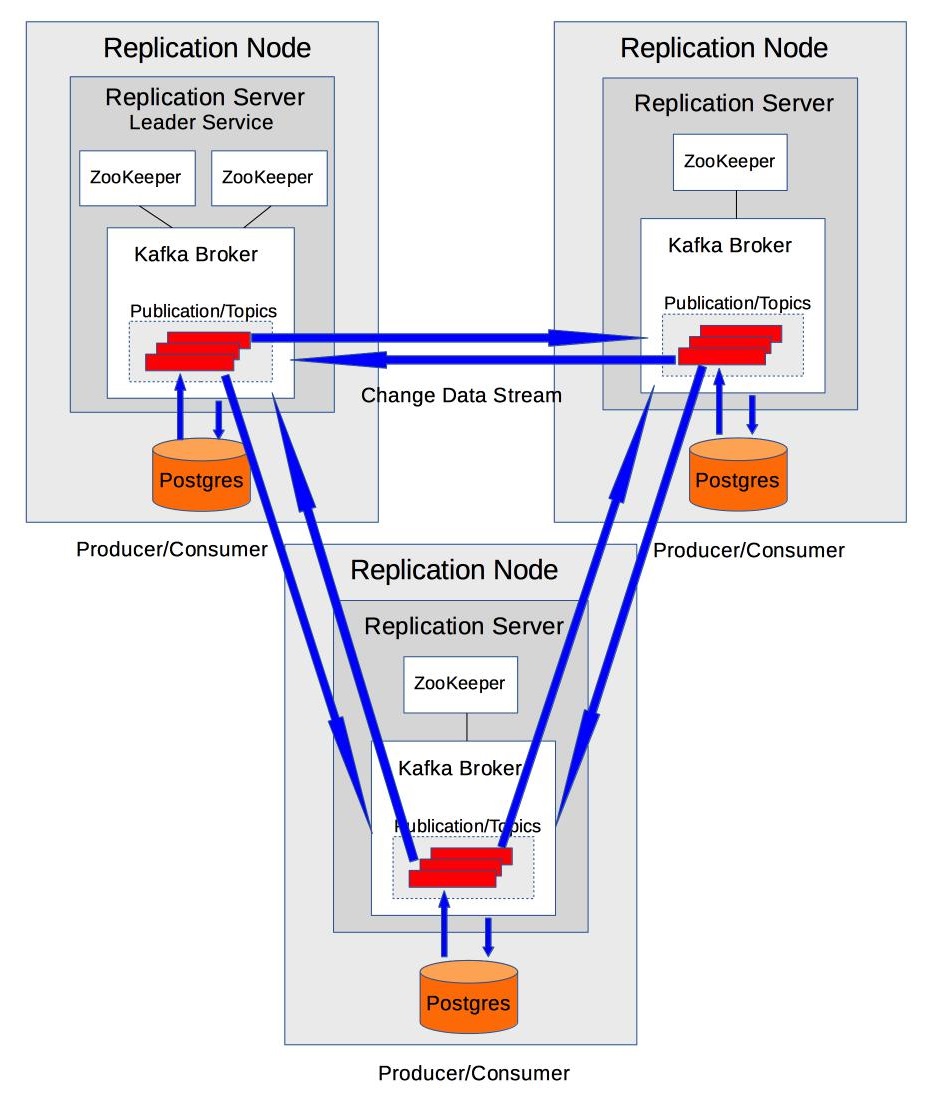
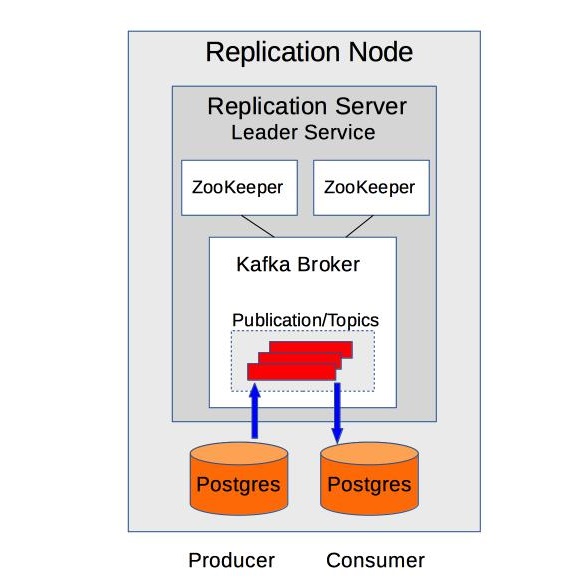 /var/lib / edb / rs / dataパブリケーションデータベース内のテーブルのグループを指定してパブリケーションを作成すると、パブリケーションデータベースから変更されたデータを保存するためにKafkaトピックログファイルが作成されます。パブリケーションテーブル内で変更されたデータが発生すると、その変更はPostgreSQLの 論理デコード を使用して収集されます 。変更されたデータはPostgreSQLの先行書き込みログセグメント(WALセグメントファイル)から抽出されます。この情報は変換され、Kafkaブローカーによって管理されるKafkaトピックに格納されます。出版物を管理するトピックが複数ある場合があります。Kafkaは パーティション と呼ばれる複数のログファイルに分割されたトピックの使用をサポートしますが 、EDB Replication Serverはトピックごとに1つのパーティションしか使用しません。/ var / lib / edb / rs / data / kafka-logs / servernameservernameは、ネットワークに参加したときに複製サーバーに割り当てられた識別子です。2.4.1.2 個別のレプリケーションノード上のSMRクラスタ
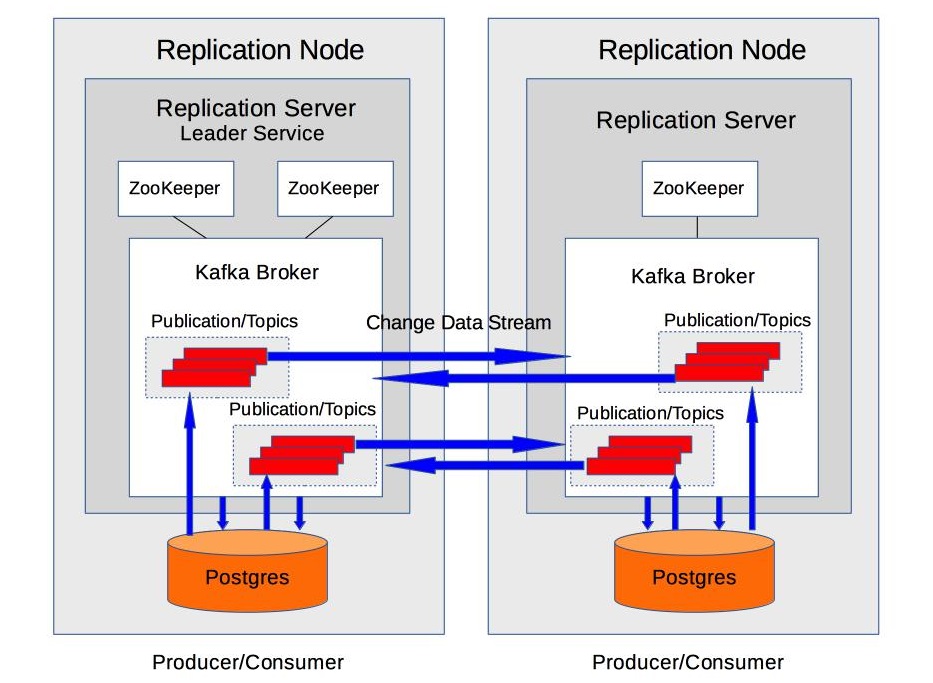
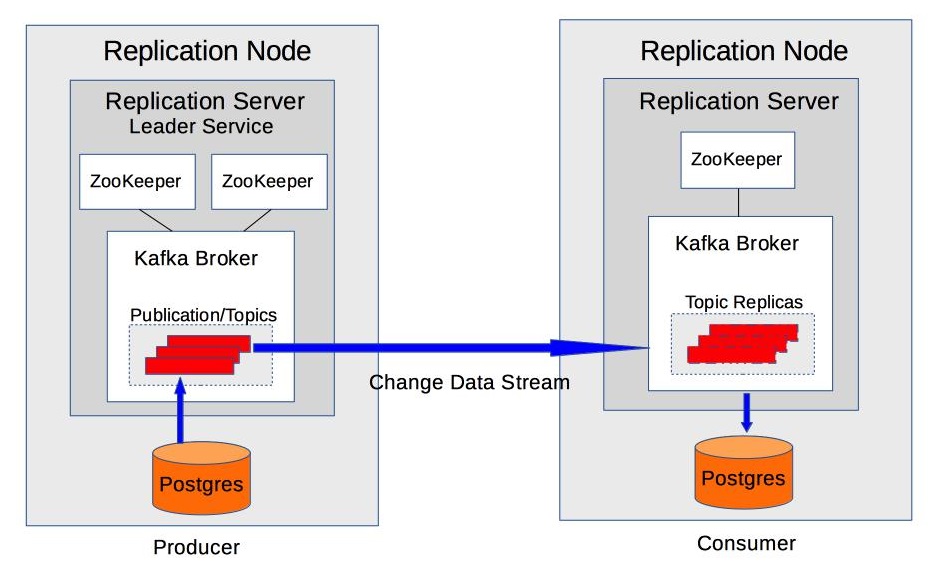 読み取り専用でパブリケーションから変更されたデータを受信するためにデータベースが参加しているサブスクリプションレプリケーションサーバー上で、Kafkaはパブリケーションを含むレプリケーションサーバーからのトピックのコピーであるトピック レプリカを 作成します。2.4.1.3 2つのパブリケーションを持つMMRクラスタ
 2.4.1.4 3つのレプリケーションノード上のMMRクラスタ