英語マニュアル
5.1.1.1 複製不足のパーティション
5.1.1.8 リーダー数
この文書は EDB Postgres Replication Serverバージョン7の 特定の側面に関する詳細情報を提供します 。 EDB Postgres Replication Server(以降EDB Replication Serverと呼びます )は、PostgreSQL®およびEDB Postgres™Advanced Serverで利用可能なレプリケーションストリーミングシステムです。後者はAdvanced Serverと呼ばれます 。
以下の説明では、 用語は、言語キーワード、ユーザー指定の値、リテラルなどである任意の単語または単語のグループを指します。用語の正確な意味は、それが使用される文脈によって異なります。
•
イタリック体のフォントは、通常は初めて定義する文章の中に新しい用語を導入します。
•
Fixed-width (mono-spaced) fontは、SQLコマンド、例で使用されている特定のテーブル名および列名、プログラミング言語のキーワードなど、文字通りに指定する必要がある用語に使用されます。例えば、 SELECT * FROM emp;
•
Italic fixed-width fontは、ユーザーが実際の使用法で値を置き換える必要がある用語に使用されます。例えば、 DELETE FROM table_name ;のようにします。
•
角括弧[]は、括弧で囲まれた用語のいずれかが置き換えられることを意味します。たとえば、 [ a | b ]は、「 a 」または「 b 」のいずれかを選択するか、または両方を選択しないことを意味します。
•
中括弧{}は、囲まれた選択肢のうち1つだけを指定する必要があることを示します。たとえば、 { a | b }はa必ず「 b 」または「 b 」のいずれかを指定する必要があることを意味します。
•
省略記号...は、前の用語が繰り返される可能性があることを示します。たとえば、 [ a | b ] ...は、シーケンス「 baaba 」があるかもしれないことを意味します。
•
この文書の情報の大部分はPostgreSQLとEDB Postgres Advanced Serverデータベースシステムの両方に当てはまります。 Advanced Server という用語は、EDB Postgres Advanced Serverを指すために使用されます。 Postgresという用語は、PostgreSQLとAdvanced Serverの両方を総称的に指すために使用されます。これら2つのデータベースシステムを区別する必要がある場合は、特定の名前(PostgreSQLまたはAdvanced Server)が使用されます。
•
PostgreSQLまたはAdvanced Server製品のインストールディレクトリパスは POSTGRES_INSTALL_HOME と呼ばれます。 PostgreSQL Linuxインストールの場合、これはデフォルトで/opt/PostgreSQL/ x .バージョン10以前の場合はx 。それ以降のバージョンでは、PostgreSQLコミュニティパッケージを使用してください。バージョン10以前の対話式インストーラーを使用して実行されたAdvanced Server Linuxインストールの場合、これはデフォルトで/opt/edb/as x . x 。 RPMパッケージを使用して実行されたAdvanced Server Linuxインストールの場合、これはデフォルトで/usr/edb/as x . x 。製品のバージョン番号はxで表され. xまたはバージョン10以降の場合はxx 。
•
runServer.sh。レプリケーションノードとして機能するホストマシン上のレプリケーションサーバーの設定と起動
•
runRepCLI.sh。プロデューサデータベースとコンシューマデータベース間のスナップショットおよびデータストリーミングを提供するレプリケーションネットワークの作成、構成、および管理
runServer.sh を使用してレプリケーションサーバーを作成する方法については、セクション2.1を参照してください。
rootアカウントとして、 EPRS_HOME /server/binディレクトリーからスクリプトを実行します。
./runServer.sh --host host_ip_address
--config EPRS_HOME / server / etc
-h 、 --host host_ip_address
-c 、 --config EPRS_HOME /server/etc
EPRS_HOME /server/etcディレクトリへのフルディレクトリパス 。同じホストマシン上で複数のレプリケーションサーバーを実行する場合は、 EPRS_HOME /serverディレクトリのコピーを作成し、追加のレプリケーションサーバーのEPRS_HOME /server/etcディレクトリにある特定のプロパティファイルを変更する必要があります。
注 : EPRS_HOMEディレクトリーの一般形式は/usr/edb/rs- x . xここでx . xはEDB Replication Serverのバージョン番号で、最初は7.0です。
例
EDB Replication Server RepCLIコマンドは 、EDB Replication ServerクライアントパッケージがインストールされているEPRS_HOME /client/binあるrunRepCLI.shスクリプトによって呼び出されます 。
一般に、RepCLIコマンドは、RepCLIコマンドの効果をレプリケーションネットワークに関連させるために、リーダーサービスとしてレプリケーションサーバーを実行しているホスト上のEPRS_HOME /client/binディレクトリから実行する必要があります。
以下に client.propertiesファイルの内容を示します。
helpコマンドは、すべてのRepCLIコマンドの構文の要約を提供します。
例
versionコマンドは、EDB Replication ServerのCLIのバージョン番号を提供します。
例
encryptコマンドは、入力ファイルで提供されたテキストを暗号化し、指定した出力ファイルに暗号化された結果を書き込みます。 encryptコマンドを使用して、データベースユーザーのパスワードを必要とするadddbコマンドで参照できる暗号化パスワードをテキストファイルに生成します。
注: encryptコマンドには、以下の許可が必要です。
-encrypt –input infile –output pwdfile –user username
infileに暗号化したいテキストだけが含まれていること、およびテキストの前または暗号化したいテキストの後に余分な文字や空行がないことを確認してください 。
例
ファイル pwdfileは、以下のものが含まれています。
joinnetworkコマンドは、レプリケーションネットワークに指定されたレプリケーション・サーバーを追加します。
-servername servername
- host
[-ngxpasspath directory ]
[-user username ]
joinnetworkリーダーサービスとして起動する最初のレプリケーションサーバ以外のReplication Server、のために呼び出さコマンドは、で与えられなければならない-userオプション。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
コマンドを実行している複製ユーザー。最初にリーダーサービスとして使用される複製サーバーを作成するときに、複製ネットワークでjoinnetworkコマンドを初めて実行するときには、このパラメーターは省略されますが 、それ以降のjoinnetwork使用にはjoinnetworkです。 usernameは、 adminまたはjoin_network権限を持つユーザーのいずれかでなければなりません。
例
次の例では、 remoteService という名前で識別される複製サーバーを複製ネットワークにremoteServiceします。
leavenetworkコマンドは、レプリケーションネットワークから指定されたレプリケーション・サーバーを削除します。
-servername servername
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
adddbコマンドは、Replication Serverにデータベースを追加します。
[-servername servername ]
-dbid dbid
-dbhost host
-dbport port
-dbuser user
{-dbpassword encrypted_pwd | -dbpassfile pwdfile }
-database dbname
[-ngxpasspath directory ]
- username
データベースがPostgreSQLデータベースの場合はpostgresql 指定します。 Advanced Serverデータベースの場合は、 enterprisedb指定します。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
次の例では、PostgreSQLデータベース node1をlocalServiceレプリケーションサーバに追加します。
removedbコマンドは、Replication Serverからデータベースを削除します。
[-servername servername ]
-dbid dbid
[-ngxpasspath directory ]
- username
使用する前に removedbコマンドを使用してデータベース内に作成されていたすべての出版物を確認してくださいcreatepubコマンドは最初の使用により除去されるremovepubコマンドを。
使用 leavepubそれはとに結合されていたすべての出版物からデータベースを切断するコマンドをjoinpubコマンド。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
次の例では、 db1 によって識別されるデータベースをレプリケーションサーバーlocalServiceから削除します 。
createpubコマンドは、新しいパブリケーションを作成します。
-servername servername
-dbid dbid
{-table schema_1 。 table_1 [、 schema_2 。 table_2 ] ... |
-alltables [ schema_1 ] [、 schema_2 ] ...}
[-ngxpasspath directory ]
- username
schema_n . table_n
-alltables [ schema_1 ][, schema_2 ]...
データベースがこのパブリケーションにしか書き込めない場合はW 指定します。これによりプロデューサのみになります。データベースがこのパブリケーションに参加している他のデータベースからの変更データも受け入れることができる場合は、 RW指定します。後者は、このデータベースを出版物の消費者と生産者の両方にします。 -nodetypeが省略された場合、デフォルトはWです。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
注意:複製する必要がある場合は、すべてのテーブルに主キーが必要です。そうしないと、パブリケーションの作成中にエラーが発生します。
例
joinpubコマンドは、出版物からのデータの受信、ならびにおそらくはその出版物に変更されたデータの投稿者となるデータベースを指定します。データベースがパブリケーションに参加した後、データベースはそのパブリケーションに参加している他のデータベースに自身の変更されたデータを受信および/またはプッシュし始めることができます。
-servername servername
-dbid dbid
-pubname pubname
[ - フィルタ filtername ]
[-ngxpasspath directory ]
- username
通常、 joinpubコマンドは、すべてのターゲットデータベースに対してスナップショットが作成されてストリーミングが開始される前に初期レプリケーションネットワークを作成するときに使用されます。
•
adddbコマンドでデータベースを追加します 。
•
joinpubコマンドでパブリケーションに参加します。
•
startstreamingコマンドを再実行して startstreaming 。
ことに注意してください startstreamingコマンドはストリーミングがすでにレプリケーションネットワーク上で実行されている場合でも、再実行する必要があります。
データベースがこのパブリケーションからしか読み取れない場合はR 指定してください。データベースがこのパブリケーションにしか書き込めない場合はW指定します。これによりプロデューサのみになります。データベースがこのパブリケーションに参加している他のデータベースとの間で変更データをストリーミングおよび受信できる場合は、 RW指定します。後者は、このデータベースを出版物の消費者と生産者の両方にします。 -nodetypeが省略された場合、デフォルトはRです。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
leavepubコマンドは、受信機または指定されたパブリケーションのデータの貢献をすることなくなったデータベースを指定します。 leavepubコマンドは、データベースをパブリケーションに結合するために使用された最初のjoinpubコマンドを取り消します。
-dbid dbid
-pubname pubname
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
removepubコマンドは、レプリケーションネットワークからの出版物を除去します。 removepubコマンドは、パブリケーションを作成するために最初に使用されたcreatepubコマンドの効果を取り消します。
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
- ユーザー名
を含むディレクトリ。 ngxpassパスワードファイル。このオプションを省略すると、.ngxpassファイルはユーザーのホームディレクトリで検索されるか、または環境変数NGXPASSPATH設定することによって検索されます。
•
addtablesコマンドを使用するには、 create_pubパーミッションが必要です。
例
- ユーザー名
を含むディレクトリ。 ngxpassパスワードファイル。このオプションを省略すると、.ngxpassファイルはユーザーのホームディレクトリで検索されるか、または環境変数NGXPASSPATH設定することによって検索されます。
•
removetablesコマンドを使用するには、 remove_pubパーミッションが必要です。 oすべてのテーブルを削除するには、カンマ区切りですべてのテーブル名を指定します。
パブリケーション pubnameにテーブルがありません。
例
addfilterコマンド行は、ターゲット消費者データベースに複製されるために満たさなければならない選択ルールを定義出版用のフィルタを作成します。ターゲットデータベースでフィルタが有効になっている場合、フィルタはスナップショットと変更されたデータストリーミングの両方に適用されます。
注意:データ移動はレプリケーションサーバの外部で行われるため、フィルタはオフラインスナップショットでは機能しません。
- filtername フィルタの filtername
-pubname pubname
- filtertable 式 filtertable
[-ngxpasspath directory ]
- username
行レベルのフィルタリングにはRを指定してください 。
WHEREキーワードのないSQL WHERE句としてフォーマットされた行選択規則 。スナップショットまたは変更されたデータストリームからtrueと評価された行は、フィルタを有効にしたターゲットデータベースに複製されます。他のすべての行は複製されません。 注: filterruleテキストを二重引用符で囲みます( " filterrule ")。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
enablefilterコマンドが適用され、ターゲット・データベースにフィルタをアクティブにします。スナップショットからのパブリケーションデータベース行と変更されたデータストリームは、ターゲットデータベースにレプリケートされるためにフィルタルールを渡す必要があります。
有効 filtername
-pubname pubname
-targetdbid target_dbid
[-ngxpasspath directory ]
- username
ターゲット・データベースが -filternameオプションを指定した joinpubコマンドを使用してパブリケーションに結合されている場合、そのフィルタはデータベース上ですでに有効になっているので、 enablefilterコマンドを使用してenablefilterにする必要はありません。 joinpubコマンドについてはセクション2.2.9を参照してください。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
updatefilterコマンドは、既存のフィルタの属性を変更します。
- filtername フィルタの filtername
-pubname pubname
- filtertable 式 filtertable
[-ngxpasspath directory ]
- username
行レベルのフィルタリングにはRを指定してください 。
WHEREキーワードのないSQL WHERE句としてフォーマットされた行選択規則 。スナップショットまたは変更されたデータストリームからtrueと評価された行は、フィルタを有効にしたターゲットデータベースに複製されます。他のすべての行は複製されません。 注: filterruleテキストを二重引用符で囲みます( " filterrule ")。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
disablefilterコマンドは、ターゲット・データベースにフィルタを無効にします。スナップショットからのパブリケーションデータベースの行および変更されたデータストリームは、ターゲットデータベースに複製されるためにフィルタ選択ルールを通過する必要がなくなりました。
無効 filtername
-pubname pubname
-targetdbid target_dbid
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
removefilterコマンドは、出版からフィルタの定義を削除します。このフィルタは、どのターゲットデータベースにも適用できなくなりました。
- filtername フィルター filtername
-pubname pubname
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
startsnapshotコマンドは、ターゲット・データベース内に掲載の表から既存の行を削除します。次に、パブリケーションデータベースからターゲットデータベースのテーブルにローをロードします。
-pubname pubname
-dbid target_dbid
[-ngxpasspath directory ]
- username
以下は、 startsnapshotコマンドの使用法に適用されます 。
新しいターゲットデータベースをパブリケーションに結合するときは、ストリーミングを開始する前に、まずstartsnapshotコマンドをターゲットデータベースに対して実行する必要があります。
ストリーミングがアクティブであるパブリケーションにデータベースに参加しようとするとこのように、ステップのシーケンスは、以下の例に示されている deptpub出版、さdeptpubで作成されたlocalService 、データベースの識別子でありdb2されたターゲット・データベースのremoteServiceに追加され、 adminがユーザーです。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
次に示すのは、 startsnapshotコマンドの実行例です。
スナップショット操作の後にクラスター構成を変更する(データベース、パブリケーション、サブスクリプション、あるいはその両方を削除する)場合は、 reloadオプションを含めてスナップショットを繰り返してください。これは、Kafkaのキュー(トピック)にソースデータベースからのデータの新しいコピーが再設定されるときに必要です。
reloadオプションを指定して startsnapshotコマンドを実行する前にストリーミングを停止します。そうしないと、操作は失敗します(エラーメッセージがサーバーに記録されます)。スナップショットが完了したら、ストリーミングを明示的に再開します。
注: 再ロードオプションは、オフラインスナップショットには機能しません。
EPRS_HOME / client / bin ディレクトリー から以下のコマンドを実行します 。
-dbid target_dbid
[-ngxpasspath ディレクトリ ]
- ユーザー名
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATHの設定によって検索されます。
例
以下は 、 reloadオプションを指定したstartsnapshotコマンドの実行例です。
スナップショットを撮る オフラインモードで、 EPRS_HOME /client/binディレクトリから次のコマンドを実行します。
-dbid target_dbid [-ngxpasspath directory ] –user username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
checksnapshotデータがターゲット・ノードに複製されている場合、コマンドは確認します。
-dbid target_dbid
[-ngxpasspath directory ]
- username
実行 checksnapshot最初の実行せずにコマンドをstartsnapshotコマンドを.ステータスは保留中になります(データの公開およびデータのインポートの場合)。
今すぐ実行 startsnapshot後にコマンドをchecksnapshotデータはノードをターゲットに複製されているかどうかを確認する(数秒の遅延の後に)コマンドを使用します。ステータスが完了している必要があります(データ発行およびデータインポートの場合)。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
以下は、 checksnapshotコマンドの実行例です。
以下は 、オフラインスナップショットに対するchecksnapshotコマンドの実行例です。
startstreamingコマンドは、出版から出版に参加しているデータベースへの変更データのストリーミングを開始します。
-startstreaming -pubname pubname [-dbid target_dbid ]
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
stopstreamingコマンドは、指定されたパブリケーションから変更されたデータのストリーミングを停止します。
-stopstreaming -pubname pubname [-dbid target_dbid ]
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
setadminpasswordコマンドは、管理者パスワードを設定します。
adminユーザパスワードの入力を求めるプロンプトが表示されます。その後、 -user adminが指定されている場合は、 adminコマンドを実行しているユーザーとして、そのパスワードを後続のすべてのRepCLIコマンドに使用する必要があります。
指定したパスワードを .ngxpassファイルに保存します。
例
createroleコマンドは、アクセス権のセットを持つロールを作成します。ユーザーに役割が割り当てられると、そのユーザーはその役割の権限を持ちます。
-createrole role_name
[ - permission [、...]]
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
createuserコマンドは、によって指定される新しいユーザ名を作成-userユーザーがRepCLIコマンドを実行したい場合、パラメータを。
-createuser newusername
[ - permission [、...]]
[-roles role [、...]]
[-ngxpasspath directory ]
- username
指定したパスワードを .ngxpassファイルに保存します。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
以下は 、ロールrepsrvrmakerから特権を持つユーザー smithを作成します 。
updateuserコマンドは、指定したユーザ名の権限や役割を更新します。
-updateuser username_privilege
[ - permission [、...]]
[-roles role [、...]]
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
以下は 、 pub_deptpubパーミッションをdeptpubして、パブリケーションdeptpubにアクセスするためのstreamer という名前のユーザのパーミッションを更新する例です 。
updatepasswordコマンドは、指定したユーザーのパスワードを更新します。
-username user_for_update
[-ngxpasspath directory ]
- username
指定したパスワードを .ngxpassファイルに保存します。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
listserverコマンドは、レプリケーションネットワークでレプリケーションサーバーに関する情報が表示されます。
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
listdbレプリケーションサーバに追加したデータベースの情報が表示されます。
[-parentservername parentservername ]
[-ngxpasspath directory ]
- username
情報を表示するデータベースの複製サーバー。これらは、 adddbコマンドを使用してこの複製サーバーに追加されたデータベースです 。このオプションを省略すると、レプリケーションネットワーク内のすべてのデータベースが表示されます。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
次の例では、 remoteService1レプリケーションサーバーに追加されたデータベースを一覧表示します。
listpubコマンドは、指定されたデータベースで作成された出版物に関する情報が表示されます。
[-parentdbid parentdbid ]
[-ngxpasspath directory ]
- username
情報を表示する createpubコマンドで作成されたパブリケーションを含むデータベースのデータベースID 。このオプションを省略すると、レプリケーションネットワークのすべての出版物が表示されます。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
listpubtableコマンドは、指定されたパブリケーション内のテーブルが一覧表示されます。
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
listconsumerコマンドは、レプリケーションネットワークでの出版によって、消費者のデータベースを示しています。
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
listconflicts検出されたリストの競合を命じます。
[-pubname pubname ]
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
replicationlagコマンドは、バイト単位のサイズ、最後の消費の時間、および消費者データベースによって最後に消費WALレコードの論理シーケンス番号(LSN)を示しています。
{-pubs pubname_1 [、 pubname_2 ] ... | -allpubs}
[-ngxpasspath directory ]
- username
複製遅延を表示する bytes数をバイト数で指定します。最後の消費時間とタイムラグを指定するtimeを指定します。両方の情報を表示するには、 allを指定します。 -lagtypeが省略されている場合、デフォルトはallです。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
注:表示される出力形式はこの資料で結果をもっと簡単に見るために修正されました。
注:このドキュメントでは結果がわかりやすくなるように、次の出力形式が大幅に変更されています。
replicationlatencyコマンドが正常に複製され、ターゲット・データベースに適用された最後のトランザクションのエンドツーエンドのデータベース・レベルの待ち時間を提供します。
-レプリケーションレイテンシ
- pubname pubname
- dbid target_dbid
[ - ngxpasspath directory ]
-ユーザーのユーザーusername
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
以下は、 replicationlatencyコマンドの実行例です 。
注: replicationlatencyコマンドには、以下の許可が必要です。
addkafkaaclコマンドでは、ACLを追加します。
zookeeper.connect = zookeeper_host : zookeeper_port
OU = organizational_unit 、O = organization 、
ST = state_or_province_name 、C = country_name
-allowhost host_1 [、 host_2 、...]
-operation operation_1 [、 operation_2 、...]
トピック topic_name
[-ngxpasspath directory ]
- username
-allowprincipalオプションは、たとえば、SSLのユーザー名を表します。
カンマ区切り値は、オプションのために許可されている -authorizerproperties 、 -allowhosts 、および-operations 。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
次の例では、Kafka ACLを追加して、一般名 127.0.0.1 表されるプリンシパルSSLユーザーがIPホスト172.16.252.3および172.16.252.5からトピックtestpub-test_db1-public.jobhist ReadおよびWrite操作Read実行できるようにします。
removekafkaaclコマンドは、ACLを削除します。
zookeeper.connect = zookeeper_host : zookeeper_port
OU = organizational_unit 、O = organization 、
ST = state_or_province_name 、C = country_name
-allowhost host_1 [、 host_2 、...]
-operation operation_1 [、 operation_2 、...]
トピック topic_name
[-ngxpasspath directory ]
- username
-allowprincipalオプションは、たとえば、SSLのユーザー名を表します。
カンマ区切り値は、オプションのために許可されている -authorizerproperties 、 -allowhosts 、および-operations 。
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
listkafkaaclコマンドはACLを示しています。
zookeeper.connect = zookeeper_host : zookeeper_port
トピック topic_name
[-ngxpasspath directory ]
- username
.ngxpassパスワードファイルを含むディレクトリ 。このオプションを省略すると、 .ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数NGXPASSPATH設定によって検索されます。
例
Kafkaでイベントの追加を有効にするには、レプリケーションサーバーを起動する前に、 EPRS_HOME/server/etc/logback.xml 内の次の行のコメントを EPRS_HOME/server/etc/logback.xmlます。
[-ngxpasspath ディレクトリ ]
を含むディレクトリ 。 ngxpass パスワードファイル。 このオプションを省略すると、.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数 NGXPASSPATH 設定によって検索されます 。
例
以下は、 MMR(2つのサーバー)を設定したlisteventsコマンドの例です 。
[-ngxpasspath ディレクトリ ]
を含むディレクトリ 。 ngxpass パスワードファイル。 このオプションを省略すると、.ngxpassファイルはユーザーのホームディレクトリ内で、または環境変数 NGXPASSPATH 設定によって検索されます 。
注:すべてのメッセージを取得するには、 EPRS_HOME/server/etc/logback.xml以下の行のコメントをEPRS_HOME/server/etc/logback.xml ファイル。
例
サポートされているフィルタリングの種類は、 行レベルのフィルタリングです。複製する行の選択は、その行の列値の内容に基づいています。フィルタリング規則は、SQLのWHERE句の形式で指定されます。
•
addfilter - パブリケーションテーブルに対するフィルタの選択規則を定義します( 2.2.12項を参照)
•
enablefilter - パブリケーションに参加したデータベースのテーブルにフィルタを適用します( 2.2.15項を参照)
•
updatefilter - 既存のフィルタの選択規則を変更する( 2.2.16項を参照 )
•
disablefilter - 以前にフィルタが有効になっていたデータベースに対するフィルタの適用を無効にします( 2.2.17項を参照 )。
•
removefilter - パブリケーションからフィルタを削除します。したがって、どのデータベースでも使用できなくなります( 2.2.18項を参照)。
•
joinpub - データベースがパブリケーションに参加するときに、パブリケーションフィルタを即座にデータベースに適用するオプションを使用できるようになりました。これにより、このデータベースに対してenablefilterコマンドを使用する必要がなくなりました( 2.2.9項を参照)。
行のフィルタリングは、両方からのスナップショットで発生 startsnapshotコマンドによって実装されたデータストリーミング変更startstreamingコマンド。
node1 、 node2 、およびnode3 の3つのデータベースのそれぞれで、 public.emp表定義を作成します。
);
パブリケーションデータベース node1のempテーブルには、最初次の行が含まれています。
他のデータベース node2とnode3は、 empテーブルに行を含みません。
データベースを localService 追加して localServiceを作成します。
では、 public.empテーブルに2つのフィルタを作成します。
出版物に2つのデータベースを結合します。 -filternameオプションはすぐにデータベース上のフィルタを有効にするために使用されます。
フィルター規則deptno=20 researchService上のデータベース node2場合、フィルター処理されたストリームは以下のようになります。
フィルタルールdeptno=30 salesService上のデータベース node3場合、フィルタ処理されたストリームは次のようになります。
•
認証システムへのアクセスを要求しているユーザーの身元の確認
•
認可認証されたユーザーに付与されている役割と特権を識別します。
•
アクセス制御。ユーザーが要求されたオブジェクトにアクセスするための役割または特権を持っているかどうかの判別
前の箇条書きで説明したユーザーは、 RepCLIコマンドを使用してEDB Replication Serverによって作成、保存、および管理されるEDB複写ユーザです。このユーザーはLinuxユーザーアカウントでもPostgresデータベースユーザーでもありません。
•
RESTセキュリティ認証、許可、およびアクセス制御を提供するためにJAX-RS 2.0 Jerseyの機能を使用して実装されています。
•
カフカセキュリティ。 Kafkaコンポーネントの設定の一部として指定されたTLS証明書ベースの認証を提供します。 TLSは暗号化通信を提供します。
セクション 4.1では、RepCLIコマンドを介して提供されるRESTセキュリティの使用方法について説明します。
セクション 4.2では 、TLS証明書に基づく認証の設定プロセスについて説明しています。
•
setadminpassword - 管理者ユーザー名adminパスワードを設定します。これは、最初に実行した後、次のRepCLIコマンドでなければなりませんjoinnetworkリーダーサービスを起動するコマンド(項参照2.2.25を )。
•
createrole - 役割に一連の許可を付与する役割ベースのアクセス制御アプローチに基づいて役割を定義します 。その後、ユーザーを1つ以上のそのようなロールに割り当てることができます。これにより、ロールに含まれる権限がユーザーに付与されます( 2.2.26項を参照)。
•
createuser - RepCLIコマンドを呼び出すときに-userパラメータで指定するユーザ名を作成します。ユーザーは、 createuserコマンドまたは後続のupdateuserコマンドによって、ユーザー名に割り当てられたロールまたは権限によって特権が付与されたRepCLIコマンドを実行できます( 2.2.27項を参照 )。
•
updateuser - ユーザ名に割り当てられているパーミッションまたはロールを更新する( 2.2.28項を参照 )
•
updatepassword - createuserコマンドで作成されたユーザー名のパスワードを更新します( 2.2.29項を参照 )
各RepCLIコマンドでは 、コマンドを呼び出すユーザーを識別するために-userオプションを指定する必要があります。デフォルトでは、ユーザーのパスワードの入力を求められます。
•
パスワードファイルは .ngxpass という名前で 、 -savepasswordオプションが指定されている場合はパスワードをプレーンテキスト形式で格納します。
•
.ngxpassファイルは、Linuxのホームディレクトリの下に作成し、更新されrootレプリケーション・サーバーを開始したユーザー。
•
.ngxpassファイルにはアクセスのみをユーザーに許可し、国民に拒否された制限されています。
•
rootユーザーではないLinuxユーザーアカウントでrunRepCLI.shスクリプトを使用して後続のRepCLIコマンドを呼び出す場合は、パスワードプロンプトを回避するために、このユーザーのホームディレクトリに.ngxpassファイルが存在する必要があります。 rootホームディレクトリからこのユーザーのホームディレクトリに.ngxpassファイルをコピーし、このユーザーだけにアクセスを許可するように.ngxpassファイルのアクセス許可を変更します。
ngx_host : ngx_port : username : password
RepCLIコマンドを呼び出すときに、オプションで-ngxpasspathオプションを使用して、 .ngxpassファイルを含むディレクトリへのフルパスを指定できます 。レプリケーションサーバーは、指定されたカスタムパスでファイルを検索します。
ファイルがカスタムパスで見つからない場合、または -ngxpasspathオプションが指定されていない場合、レプリケーションサーバーはNGXPASSPATH環境変数で指定されたディレクトリでファイルをチェックします。
場合 NGXPASSPATH環境変数が設定されていないか、ファイルがそのカスタムパスの下で発見されない場合は、パスワード・ファイルはユーザのホームディレクトリの下に検索されます。
.ngxpassファイルが見つからない場合、ユーザーはパスワードの入力を求められます。
したがって、RepCLIコマンドの実行を継続的に簡単にするために 、ユーザーの作成時に-savepasswordオプションを指定する必要があります。
次の例は、 .ngxpassファイルの作成を示しています。
createuserコマンドは、その後に実行され-savepassword新しいユーザーのためのオプションpubmanager 。
/root/.ngxpassファイルは現在、2つのユーザ名とそのパスワードが含まれています。
注: adminユーザー用の「Enter user password」プロンプトでは、応答としてテキストが表示されませんでした。 adminパスワードは.ngxpassファイルから取得されました。
新しいユーザー pubmanagerは、パスワードを.ngxpassファイルからも取得するため、パスワードを指定せずにコマンドを呼び出すようになりました。
注: pubmanagerユーザー用の「Enter user password」プロンプトの場合、応答としてテキストは表示されませんでした。 pubmanagerパスワードは、 .ngxpassファイルから取得されました。
注: runRepCLI.shスクリプトを実行しているLinuxユーザがこの例のようにrootユーザアカウントではない場合、保存されたパスワードのパスワードプロンプトを回避するために、 /root/.ngxpassファイルをLinuxユーザのホームディレクトリにコピーします。誰がrunRepCLI.shスクリプトを実行しているrunRepCLI.sh 。コピーしたファイルの所有権と許可( /home/ user /.ngxpass )が、 runRepCLI.shスクリプトの実行者であるLinuxユーザー( user表される)にのみ許可されていることを確認してください。
ユーザーによって呼び出されたすべての追加RepCLIコマンド pubmanager用のパスワードとなる同じように反応するpubmanagerから取得されます.ngxpassファイル。
setadminpassword Set administrator password with .
createrole Create a role with .
createuser Create a username with .
updateuser Update the username privileges with updateuser .
listserver List replication servers with listserver .
listpub List publications with listpub .
listpubtable List publication tables with listpubtable .
removefilter List consumers with .
List conflicts with listconflicts List conflicts with listconflicts .
List replication lag with replicationlag .
addfilter Add a filter with addfilter .
enablefilter Enable a filter with .
updatefilter Update a filter with updatefilter Update a filter with .
disablefilter Disable a filter with .
removefilter Remove a filter with .
joinnetwork Join the network with joinnetwork Join the network with .
leavenetwork Leave the network with leavenetwork Leave the network with leavenetwork .
removetables. Remove tables from a publication with removetables.
db_ dbid
Access permission to database identified by DBID . (See the following Note . (See the following )
createpub Create a publication with createpub .
leavepub Leave a publication with leavepub Leave a publication with leavepub .
removepub Remove a publication with removepub .
pub_ pubname
Access permission to the publication named PUBNAME . (See the following Note . (See the following )
startsnapshot Start a snapshot with startsnapshot .
Start streaming with startstreaming .
Stop streaming with stopstreaming .
注:データベースが追加されるかパブリケーションが作成されると、リソースタイプパーミッションが作成されます。追加されたデータベースの場合、パーミッションの名前は、DB_あるdbid dbid使用してデータベースに割り当てられたデータベース識別子であるadddbコマンド。作成されたパブリケーションの場合、パーミッションの名前はpub_pubname pubnameここで、 pubnameはcreatepubコマンドで割り当てられたパブリケーションの名前です。
addkafkaacl Add a Kafka ACL with addkafkaacl .
removekafkaacl Remove a Kafka ACL with removekafkaacl .
listkafkaacl List a Kafka ACL with listkafkaacl .
管理者ユーザー admin から始めて、さまざまなレベルの権限で追加のユーザーを作成できます。
次の例は、 create_user権限を持つusermanager の作成を示しています。これには、さまざまな権限を持つ他のユーザーを作成するための権限があります。
usermanager 、ユーザの作成に使用されpubcreatorレプリケーションネットワーク・コンポーネントを作成するための権限を持ちます。
2つのデータベース node1とnode2 それぞれで、 public.deptテーブル定義を作成します。
);
ソースデータベース node1では、 public.deptテーブルに4つの行が移入されます。
ユーザーを作成し usermanagerそれに割り当てるcreate_user 、 set_user_password 、およびupdate_user権限:
usermanagerを指定してユーザとして-userオプション、ユーザーの作成pubcreator 、データベースを追加するパブリケーションを作成し、出版に参加して、スナップショットを開始し、スナップショットを確認するための権限を持つが。
また 、ユーザーとしてusermanagerを使用して、ストリーミングを制御する権限を持つユーザーstreamerを作成します。
ユーザー pubcreator として 、初期スナップショットを実行します。
パブリケーションはstreamerではなくユーザpubcreatorによって作成されたため、ストリーミングを開始するパブリケーションdeptpubにアクセスするためのアクセス権を提供するように、 ユーザ streamer更新する必要があります。付与される許可はpub_deptpubです。ユーザーstreamerは、 update_user権限を持つusermanagerによって更新されusermanager 。
ユーザー streamerはストリーミングを開始できます。
createroleコマンドは、個々のユーザに割り当てることができる一つの特定のロールに権限のグループを割り当てるために使用することができます。
2つのデータベース node1とnode2 それぞれで、 public.deptテーブル定義を作成します。
);
ソースデータベース node1では、 public.deptテーブルに4つの行が移入されます。
パーミッションjoin_network 、 add_db 、 create_pub 、 join_pub 、 start_snapshot 、 check_snapshot 、およびstart_streaming を repsrvrmakerして、ロール repsrvrmakerを作成します 。ユーザーsmith repsrvrmakerロール特権を割り当てて、ユーザーを作成します。
ここで、新しいユーザー smithを使用して、プロデューサーデータベースを追加し、パブリケーションを作成し、コンシューマーデータベースを追加して、パブリケーションに参加することによってレプリケーションノードを完成させます。
ユーザー smith 最初のスナップショットを撮ります 。 node2データベースに、 node1最初に挿入された行が表示されます。
ストリーミングを開始して、 node1データベーステーブルに別の行を挿入します。
新しい行が node2 表示され node2 。
Kafkaは、 Transport Layer Security (TLS)/ Secure Sockets Layer (SSL)証明書を使用したサーバーとクライアントの認証をサポートしています 。 Kafkaブローカーとクライアント(プロデューサー/コンシューマー)のTLS構成は、キーストアとトラストストアの構成と共に提供する必要があります。
注意:次の例では、EDB Replication Serverクライアントとサーバは、1つの複写サーバを持つ同じ単一のホストマシン上で実行されます。したがって、単一のファイルセットのみが生成されます。レプリケーションネットワークに複数のレプリケーションサーバーを含める場合は、このプロセスを各レプリケーションサーバーのブローカーごとに繰り返す必要があります。
ステップ1:鍵ストアを生成します。鍵ストアは、サーバーとクライアントのマシンを識別するための証明書と一緒に暗号化に使用される鍵ペアです。
Javaの keytoolユーティリティを使用してキーストアを生成できます。
手順2:サーバー証明書とクライアント証明書に自己署名するための認証局(CA)を作成します。以下のすべての例で、パスワードtestpassが示されています。
ステップ3:ステップ 2で作成した認証局をサーバーおよびクライアントのトラストストアに追加して、この認証局で署名された証明書がサーバーおよびクライアントによって信頼されるようにします。同じトラストストアがサーバーとクライアントの両方のマシンに使用されます。
]
]
]
]
]
ステップ4: openssl.cnfファイルに変更をopenssl.cnfます。このファイルは、ディレクトリの場所/etc/pki/tlsます。
キーストアファイルとトラストストアファイルがディレクトリ /home/user/certにあると仮定して 、次のように、パラメータdir 、 certificate 、およびprivate_keyについて、ファイルopenssl.cnfのセクションで編集を行います。
openssl.cnfファイルの以下のセクションを編集して 、示されたパラメーターをoptional変更しoptional 。
セクション v3_reqで、示された新しいフィールドを追加し、続いてalternate_namesセクションとそのフィールドのリストを追加します。
手順5:キーストアファイルとトラストストアファイルを作成したディレクトリで、以下の変更を行います。このディレクトリは/home/user/certsと見なされ/home/user/certs 。
サーバーの最終手順:キーストアからサーバー証明書をエクスポートして署名し、再度インポートします。
ステップ6a:サーバ証明書をエクスポートします。
ステップ6b:証明書署名要求を生成します。
ステップ6c:サーバのキーストアにca-certをインポートします。
]
]
]
]
]
手順6d:署名付きサーバー証明書をサーバーキーストアにインポートします。
クライアントへの最後のステップ:キーストアからクライアント証明書をエクスポートして署名し、インポートします。
ステップ7a:クライアント証明書をエクスポートします。
ステップ7b:証明書署名要求を生成します。
ステップ7c: ca-certをクライアントキーストアにインポートします。
]
]
]
]
]
ステップ7d:署名付きクライアント証明書をクライアント鍵ストアにインポートします。
注意:次の例では、EDB Replication Serverクライアントとサーバは、1つの複写サーバを持つ同じ単一のホストマシン上で実行されます。したがって、1セットのプロパティファイルだけが変更されます。レプリケーションネットワークに複数のレプリケーションサーバーが含まれる場合は、各個別のレプリケーションサーバーのブローカーごとにプロパティファイルを変更する必要があります。
適切なディレクトリの場所を指すように他のすべての sslパラメータを変更し 、パスワードを指定します。
適切なディレクトリの場所を指すようにPathおよびPasswordパラメータを変更し 、 Passwordを指定します。
{
}
kafkastore.sslパラメータを修正して適切なディレクトリの場所を指定し、パスワードを指定します。
注意:次の例では、EDB Replication Serverクライアントとサーバは、1つの複写サーバを持つ同じ単一のホストマシン上で実行されます。したがって、1セットのプロパティファイルだけが変更されます。レプリケーションネットワークに複数のレプリケーションサーバーが含まれる場合は、各個別のレプリケーションサーバーのブローカーごとにプロパティファイルを変更する必要があります。
適切なディレクトリの場所を指すようにPathおよびPasswordパラメータを変更し 、 Passwordを指定します。
{
}
適切なディレクトリの場所を指すように他のすべての sslパラメータを変更し 、パスワードを指定します。
モニタリングとは、Kafkaブローカーやコンシューマーやプロデューサーとの間のメッセージ交換などの内部コンポーネントに基づいて、レプリケーションネットワークのパフォーマンスに関連する特定の情報を調べ、記録し、それに対応するプロセスです。
監視は 、Kafkaブローカーの運用中にさまざまな特性を測定する、 メトリック と呼ばれる一連の属性に基づいてい ます 。
JMXインタフェースを使用してMBeanを読み取るためにJolokia と呼ばれる機能を使用してメトリックが読み取られます。 Jolokiaとそのアーキテクチャに関する情報は、次のWebサイトから入手できます。
•
セクション 5.1では 、調査される測定基準の概要を説明します。
•
セクション 5.2では、監視の設定と開始の手順について説明しています。
•
ブローカメトリクス 5.1.1項を参照してください。
•
•
クライアントメトリクス 5.1.3項を参照してください。
5.1.1.1 複製不足のパーティション
これを行う1つの方法は、使用している kafka-topics.shとツールを--zookeeper 、 --describe 、および--under-replicatedオプション。使用方法については、Kafkaのマニュアルを参照してください。
ケース1:複数のアクティブコントローラ
ケース2:アクティブなコントローラがない
注:発信バイトレートには、レプリカトラフィックも含まれます。つまり、すべてのトピックが2の複製係数で構成されている場合、コンシューマクライアントがない場合は、バイトアウトレートとバイトインレートが同じになります。 1つのコンシューマクライアントにクラスタ内のすべてのメッセージを読み取らせる場合、バイトアウトレートはバイトインレートの2倍になります。何がカウントされているのかわからない場合は、これをメトリックを見るときに混乱させることがあります。
5.1.1.8 リーダー数
Yes
Yes
Yes
Yes
Yes
Yes
Yes
Bytes In Per Second Analogous to
Yes
Yes
Yes
Yes
Yes
Yes
Yes
Yes
Yes
commit-latency-avg Establish a baseline expected value for and alert on it.
Yes
手順1:監視は、レプリケーションサーバーが実行されているホストから実行することも、レプリケーションサーバーのない別のホストから実行することもできます。
後者を実現するには、 edb-rs-libsパッケージとedb-rs-monitorパッケージをインストールして監視を実行します。インストール手順については、 EDB Postgres Replication Server入門ガイドを参照してください。
ステップ2:ディレクトリーEPRS_HOME /monitor/etcにあるmonitor.propertiesファイルで、以下のパラメーターを設定します。
ngen.total.nodes = number_of_replication_servers
ngen.jolokia.host.node n = replication_server_host_ip
ngen.jolokia.port.node n = 8778
ngen.sender.email = alert_sender_email_address
ngen.sender.email.encrypted.password = encrypted_sender_passwd
ngen.recipient.email = recipient_email_address
以下のために送信者の電子メールのパスワードを暗号化し ngen.sender.email.encrypted.passwordとencryptを実行したコマンドrunMonitor.sh中にスクリプトEPRS_HOME /monitor/binディレクトリ:
./runMonitor.sh -encrypt -input unencrypted_password_file
–output encrypted_password_file
注:あなたはまたそれが電子メールを送信するためにこの監視アプリケーションによって送信者の電子メールアカウントへのアクセスを許可することを要求されるかもしれません。
以下は、 monitor.propertiesファイルの例です。
モニター・ロギング情報は 、以下に示すように、 EPRS_HOME /monitor/etc/logback.xmlファイルのpropertyエレメントで指定されたディレクトリーおよびファイルに保管されています。
このロギング情報は 、次のステップで説明するようにrunMonitor.sh -startコマンドが呼び出された端末にも表示され runMonitor.sh -start 。
ステップ3: rootユーザーアカウント、またはEPRS_HOME /monitor/binディレクトリに対する読み取り権限と実行権限を持つLinuxユーザーアカウントを使用して、監視を開始します。
cd EPRS_HOME / monitor / bin
注:次の例では、角かっこ[cenmmJolokiaMonitorThread]間のテキストは削除されているため、このドキュメントではメトリックを読みやすくしています。
ステップ4:重大な問題が発生した場合、モニタリングの出力は次のようになります。
monitor.properties以下で示すようにファイルが構成されています。

ステップ1:ディレクトリーにあるmonitor.propertiesファイルで、 EPRS_HOME /monitor/etc以下のパラメーターを設定します。
ngen.total.nodes = number_of_replication_servers
ngen.jolokia.host.node n = replication_server_host_ip
ngen.jolokia.port.node n = 8778
ngen.sender.email = alert_sender_email_address
ngen.sender.email.encrypted.password = encrypted_sender_passwd
ngen.recipient.email = recipient_email_address
ステップ2:用の送信者の電子メールのパスワードを暗号化しngen.sender.email.encrypted.passwordとencryptを実行したコマンドrunMonitor.sh中にスクリプトEPRS_HOME /monitor/binディレクトリ:
./runMonitor.sh -encrypt -input unencrypted_password_file
–output encrypted_password_file
ステップ3: Gmailアカウントにログインします。

ステップ4: Settings > Accounts > Google Account settings > security.
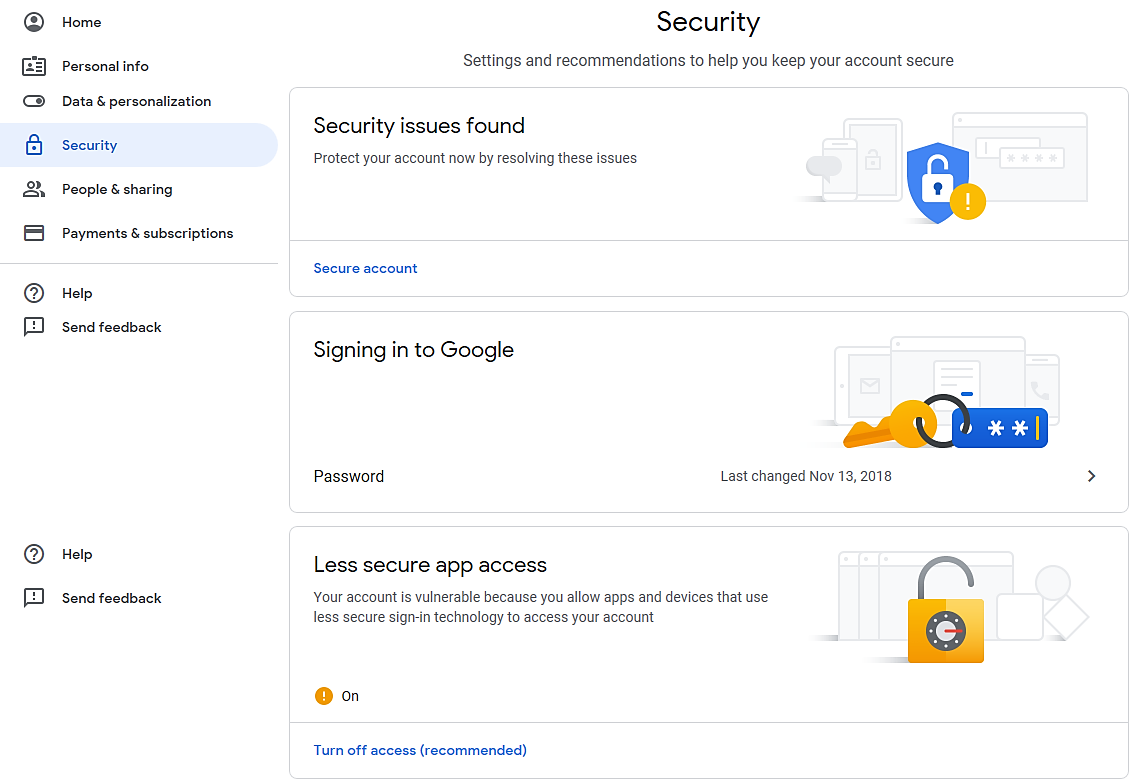
ステップ5: Less secure app access.有効にLess secure app access.
ステップ6: ./runMonitor.shコマンドを実行してEメールを送信します。
•
競合の検出、処理、および回復主キーの一意性と外部キー制約の違反(セクション6.1を参照)
•
AWSクラウドコンピューティング。レプリケーションネットワーク用のAWSインスタンス設定(セクション6.2を参照)
•
競合をログに記録し、変更されたデータのそれ以上の複製を停止します( 6.1.1.1項を参照)。
•
競合をログに記録し、競合する行のレプリケーションをスキップして、残りの変更データのレプリケーションを続行します( 6.1.1.2項を参照)。
•
競合をログに記録し、一定の時間間隔で競合する行を含むトランザクションを定期的に 再試行します( 6.1.1.3項を参照)。
停止、スキップ、または再試行アクションの使用法は、競合を含む可能性のあるデータベースがあるレプリケーションサーバーのホストにあるEPRS_HOME /server/etcディレクトリにあるapplication.propertiesファイル内の次のパラメータの設定によって決まります。追加されました:
unique.conflict.retry.period = number_of_seconds
#
競合ログ情報は、で指定されたディレクトリとファイルに格納されている propertyの要素EPRS_HOME /server/etc/logback.xml以下で示されるように、ファイル:
このロギング情報は 、レプリケーションサーバの起動に使用されるrunServer.shコマンドの出力にも表示されます。
この競合ロギング情報は 、追加されたデータベースが競合を検出したレプリケーションサーバを実行しているホストマシンの EPRS_HOME /server/etcディレクトリにのみ含まれていることに注意してください 。
競合は listconflicts RepCLIコマンドでも表示できます ( 2.2.35項を参照 )。
注: 3ノードクラスタの場合、競合が発生しているターゲットノードに対してのみレプリケーションが停止します。競合がないデータベースの場合は、レプリケーションがアクティブになります。
プロデューサデータベースとコンシューマデータベース node1とnode2には、 public.deptテーブル定義が含まれてpublic.deptます。
);
ソースデータベース node1では、 public.deptテーブルに次の行がpublic.deptます。
起動されたレプリケーションサーバーはレプリケーションネットワークに参加し、コンシューマデータベースはこの remoteServiceレプリケーションサーバーに追加され 、パブリケーションはコンシューマデータベースに参加します。
次のコンシューマデータベースへの行の挿入は、その後の一意性の競合を引き起こします。このデータベースには joinpubコマンドで-nodetype RWオプションを-nodetype RW したパブリケーションへの書き込み権限が与えられていないため 、この挿入はプロデューサデータベースにストリーミングされません。
listconflictsコマンドは、矛盾する情報が表示されます。
remoteServiceレプリケーションサーバーからのログファイルには、一意性の競合に関する次のような警告が含まれています。
プロデューサデータベースとコンシューマデータベース node1とnode2には、 public.deptテーブル定義が含まれてpublic.deptます。
);
ソースデータベース node1では、 public.deptテーブルに次の行がpublic.deptます。
起動されたレプリケーションサーバーはレプリケーションネットワークに参加し、コンシューマデータベースはこの remoteServiceレプリケーションサーバーに追加され 、パブリケーションはコンシューマデータベースに参加します。
次のコンシューマデータベースへの行の挿入は、その後の一意性の競合を引き起こします。このデータベースには joinpubコマンドで-nodetype RWオプションを-nodetype RW したパブリケーションへの書き込み権限が与えられていないため 、この挿入はプロデューサデータベースにストリーミングされません。
手動でコンシューマデータベースに挿入された元の競合する行がまだ存在するため、 50 deptnoを持つ行を除いて、これらの新しく挿入されたすべての行がコンシューマデータベースに適用されます。
listconflictsコマンドは、矛盾する情報が表示されます。
remoteServiceレプリケーションサーバーからのログファイルには、一意性の競合に関する次のような警告が含まれています。
unique.conflict.retry.period = number_of_seconds
注: 3ノードクラスタの場合、競合が発生しているターゲットノードに対してのみレプリケーションが停止します。競合がないデータベースの場合は、レプリケーションがアクティブになります。
プロデューサデータベースとコンシューマデータベース node1とnode2には、 public.deptテーブル定義が含まれてpublic.deptます。
);
ソースデータベース node1では、 public.deptテーブルに次の行がpublic.deptます。
起動されたレプリケーションサーバーはレプリケーションネットワークに参加し、コンシューマデータベースはこの remoteServiceレプリケーションサーバーに追加され 、パブリケーションはコンシューマデータベースに参加します。
次のコンシューマデータベースへの行の挿入は、その後の一意性の競合を引き起こします。このデータベースには joinpubコマンドで-nodetype RWオプションを-nodetype RW したパブリケーションへの書き込み権限が与えられていないため 、この挿入はプロデューサデータベースにストリーミングされません。
主キー値 50 行で競合が発生したため、これらの挿入はコンシューマデータベースには適用されません 。トランザクションは60秒ごとに再試行されますが、コンシューマデータベースでは発生しません。
listconflictsコマンドは、矛盾する情報が表示されます。
remoteServiceレプリケーションサーバーからのログファイルには、一意性の競合に関する次のような警告が含まれています。
このポリシーは 、データベースが格納されている可能性のあるレプリケーションサーバーのホストにあるEPRS_HOME /server/etcディレクトリにあるapplication.propertiesファイルの次のパラメータで設定されている時間間隔ごとのストリームの繰り返し再試行です。競合が追加されました:
デフォルトの number_of_seconds設定は10秒です。
プロデューサデータベースとコンシューマデータベース node1とnode2には、 deptテーブルが親で、 empテーブルが子であるpublic.deptおよびpublic.empテーブル定義が含まれていnode2 。
);
);
emp表内のすべての行について 、 deptno値には、 dept表内に対応する既存の同じdeptno主キー値を持つ行が必要です。
ソースデータベース node1では、 deptテーブルに次の行がdeptます。
node1 emp表に初期行がありません 。
コンシューマデータベース node2, 、どちらのテーブルにも行がありません。
起動されたレプリケーションサーバーはレプリケーションネットワークに参加し、コンシューマデータベースはこの remoteServiceレプリケーションサーバーに追加され 、パブリケーションはコンシューマデータベースに参加します。
コンシューマデータベースはプロデューサデータベースと同じ行になりましたが、 deptテーブルの行は削除されました。このデータベースには、 joinpubコマンドで-nodetype RWオプションを-nodetype RWしたパブリケーションへの書き込み権限が与えられていないため、この削除はプロデューサデータベースにストリーミングされません。
主キー値が30 の親 dept行が存在しないため、 外部キー違反が発生しているため、 emp行のnode2への複製は発生しません。
listconflictsコマンドは、矛盾する情報が表示されます。外部キー違反の原因となった同じSQLコマンドが繰り返し表示されることに注意してください。
しばらくして、不足している行が deptテーブルに手動で再挿入されて違反が修正され、10秒後にemp行の複製が行われます。
remoteServiceレプリケーションサーバーからのログファイルには、外部キー制約違反に関する次のような警告が含まれています。
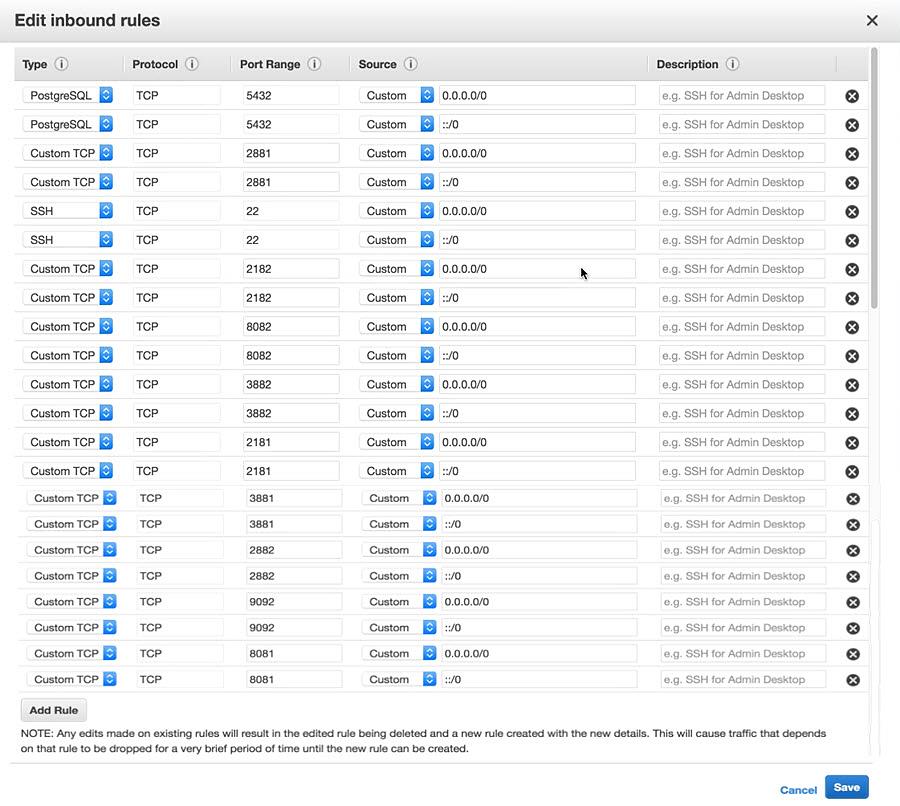
セキュリティグループは、インバウンドとアウトバウンドのトラフィックを制御するためにあなたのインスタンスの仮想ファイアウォールとして機能します。セキュリティグループごとに、インスタンスへの着信トラフィックを制御するルールを追加します。セキュリティグループについては、次のWebサイトを参照してください。
\\ vmware-host \共有フォルダ\デスクトップ2 \ Inbound_Rules_Replace_Screenshot_2.jpeg
22
n/a
n/a
n/a
n/a
-hostや-dbhost などのオプションを指定してRepCLIコマンド内でホストの場所を参照する場合は、特定の参照だけを使用できます。
比較されている2つのデータベースは、 ソースデータベースとターゲットデータベースと呼ばれ ます 。ソースデータベースはEnterpriseDBタイプにすることができます。ターゲットデータベースもEnterpriseDBタイプである必要があります。
注:データバリデータは、次のデータ型を持つ列を検証しません。これらのタイプの1つ以上の列を含む表は、部分的にのみ検証されます。
•
•
•
REF
•
•
•
•
RAW
•
注: EDB Postgres Replication Serverのデータバリデータを使用する前に、ソースとターゲットのEDB Postgres Replication Serverテーブル間のデータストリーミングが完了していることを確認してください(シングルマスターまたはマルチマスター)。ストリーミングがまだ進行中の場合は、データバリデータがテーブルの違いを表示する可能性があります。
ステップ1: EDB Postgres Replication Serverをインストールすると、Data Validator用のコンポーネントもインストールされます。
注意: EPRS_HOMEはEDB Postgres Replication Serverがインストールされているディレクトリです。 EDB Postgres Replication Serverがどのようにインストールされているかに応じて、これはPostgresホームディレクトリと同じである場合と異なる場合があります。 EPRS_HOMEディレクトリーの一般形式は/usr/edb/rs- x . xここでx . xはEDB Replication Serverのバージョン番号で、最初は7.0です。
ステップ3: EPRS_HOME /あるdatavalidator.propertiesファイルを編集します datavalidator/etcディレクトリに移動して、比較するソースデータベースとターゲットデータベースの接続情報を指定します。
以下は、 datavalidator.propertiesファイル内の datavalidator.propertiesです。
インストール後の datavalidator.propertiesファイルの初期内容は次のとおりです 。
#
#
#
#
手順4: Data Validatorのログディレクトリの場所を決定する
Data Validatorは、各実行のログディレクトリにdatavalidator_ yymmdd - hhmiss .log という形式の名前でログファイルを生成します 。
ソース表とターゲット表の間に行の相違がある場合は、 datavalidator_ yymmdd - hhmiss .diff という形式の名前のファイルも生成されます。このファイルには、 diff形式のエラーの出力が含まれています。このファイルを表示するには、 Kompareようなグラフィカルな差分ツールを使用して特定の違いを強調表示します。
Data Validatorは 、 -ldオプションを-ldせずにData Validatorを初めて起動したときに、 EPRS_HOME / datavalidator/binディレクトリ内にlogs という名前のサブディレクトリを作成しようとします。 rootアカウントとしてData Validatorを起動しないと、通常はrootアカウントのみがこの特権を持つEPRS_HOME/ datavalidator/binディレクトリにサブディレクトリlogsを作成しようとするため、実行が失敗する可能性があります。
•
rootアカウントとしてData Validatorを実行します。これは、データValidatorが作成することができますlogs内のサブディレクトリをEPRS_HOME/datavalidator/binディレクトリに移動し、ログインして、差分ファイルを作成するために、 logsサブディレクトリ。
•
Data Validatorを実行する前に、 EPRS_HOME/datavalidator/bin/logsディレクトリ構造を作成して EPRS_HOME/datavalidator/bin/logs 。 Data Validatorの実行に使用するオペレーティングシステムアカウントにディレクトリ内にファイルを作成する権限が付与されるように、ディレクトリEPRS_HOME/datavalidator/bin/logsの権限を変更します。
•
Data Validatorが指定されたディレクトリの場所log_directory_pathログファイルと差分ファイルを作成できるようにするには、 -ld log_directory_pathオプションを使用します。 Data Validatorの実行に使用するオペレーティングシステムアカウントに、 log_directory_path指定された最下位レベルのサブディレクトリが存在しない場合は作成する、またはフルディレクトリパスが既に存在する場合は指定されたディレクトリ内にファイルを作成する権限があることを確認します。
Data Validatorスクリプト runValidation.sh を呼び出す現在の作業ディレクトリは、スクリプトを含むbinサブディレクトリ(つまり、 EPRS_HOME/datavalidator/bin )である必要があります。
例
[ option ] ...
schema_nameは、検証対象のテーブルを含むソースデータベース内のスキーマの名前です。 optionは、このセクションの後半のOptionsサブセクションに記載されていoption 。
7.
--versionと--help の一般的な構文は、次のとおりです。
[-ts schema ]
[-it table_1 [、 table_2 ] ...]
[-et table_1 [、 table_2 ] ...]
[-ld log_directory_path ]
[-ds { true | false }]
[-sdbms database_type ]
[-sh host ]
[-sp port ]
[-sdb dbname ]
[-su user ]
[-spw password ]
[-tdbms database_type ]
[ - host ]
[-tp port ]
[-tdb dbname ]
[-tu user ]
[-tpw password ]
[-bs row_count ]
[-fs row_count ]
わかりやすくするために、上記の構文図では1文字形式のオプションのみを示しています。 オプションのサブセクションのリストの両方のオプションの単一文字と複数文字の形。
データベース接続オプション(前の構文図にリストされている-sdbmsから-tpw )を指定すると、 datavalidator.propertiesファイル内の対応するパラメーターがオーバーライドされます。 datavalidator.propertiesファイルについては、 7.1項を参照してください。
-ss 、 - --source-schema schema
-ts 、 --target-schema -ts --target-schema schema
-it 、-- --include-tables table_1 [, table_2 ] ...
-et 、 --exclude-tables table_1 --exclude-tables table_1 [, table_2 ] ...
比較から除外されるソーススキーマ内のテーブル。省略した場合は、 -itオプションで指定された表のみが比較対象になります。 -itと-et両方のオプションを省略すると、すべてのソーススキーマテーブルが比較のために含まれます。 注:カンマとテーブル名の間に空白があってはいけません。
-srs 、 --skip-rowsonlyin-source { true | false }
とき true指定され、ソースデータベースのテーブルにだけ存在する行の差異のログはスキップされます。デフォルトはfalseです。
-srt 、 --skip-rowsonlyin-target { true | false }
とき true指定され、ターゲット・データベースのテーブルにだけ存在する行の差異のログはスキップされます。デフォルトはfalseです。
-srb 、 --skip-rowsin-both { true | false }
場合 true指定され、同じ主キーを持つソースおよびターゲット・データベース・テーブルの両方に存在する行の差異のロギング、しかしと異なる非主キー値がスキップされます。デフォルトはfalseです。
-ld 、 - --logging-dir log_directory_path
Data Validatorのログファイルと差分ファイルが作成および格納される場所へのディレクトリパス。場合 log_directory_path存在しない場合、データValidatorは、それを作成しようとします。フル・ディレクトリー・パスが指定されていない場合、 log_directory_pathが作成されるか、 runValidation.shスクリプトが呼び出されるEPRS_HOME / datavalidator/ binサブディレクトリーを基準にして配置されると想定されます。 (つまり、logsディレクトリーはEPRS_HOME / datavalidator /bin/ log_directory_pathです。) runValidation.shスクリプトを呼び出すために使用されるオペレーティング・システム・アカウントに、ディレクトリーがまだ存在しない場合はそのディレクトリーを作成する特権、またはファイルを作成する特権があることを確認してください。指定されたディレクトリが既に存在する場合省略した場合、デフォルトはEPRS_HOME /bin/logsディレクトリーです。
-ds 、-- --display-summary { true | false }
データ検証機能の要約のみを表示するには、 trueを指定し true 。これにより、ソースデータベースとターゲットデータベースの接続情報、およびソースデータベーステーブルによる結果の詳細な内訳が省略されます。すべてのデータ検証ツールの結果を表示するには、 falseを指定しfalse 。 Data Validatorが呼び出されたときにコマンドラインコンソールに表示される情報の種類と量は、その実行のログファイルにも格納されている情報と同じです。省略した場合、デフォルトはfalse (つまり、すべてのData Validator結果が表示されます)。
-sdbms 、 --source-dbms -sdbms --source-dbms -sdbms database_type
ソースデータベースサーバのタイプ。サポートされているタイプは、 oracle 、 enterprisedb 、 sqlserver 、 sybase 、およびmysqlです。
-sh 、 - --source-host host
-sp 、 - --source-port port
ソース データベースサーバが接続をリスンしているポート番号 。
-sdb 、 --source-database -sdb --source-database dbname
-su 、 --source-user -su --source-user user
-spw 、 --source-password -spw --source-password password
-tdbms 、 --target-dbms -tdbms --target-dbms -tdbms database_type
-th 、 - --target-host host
-tp 、 - --target-port port
ターゲット データベースサーバが接続をリスンしているポート番号 。
-tdb 、 --target-database -tdb --target-database dbname
-tu 、 - --target-user user
-tpw 、 --target-password -tpw --target-password password
-bs 、 - --batch-size row_count
-bsオプションは、ソースおよびターゲット・データベース・テーブルを横切って比較のために使用されるバッチにグループに行数を指定します。たとえば、テーブルに1000行が含まれている場合、 -bs設定を100にすると、ソースデータベースとターゲットデータベースの比較を完了するために10回のバッチ反復が必要になります。 Data Validatorは、ソーステーブルとターゲットテーブルの両方から100行を読み取り、それらをソースバッファとターゲットバッファに追加します。検証スレッドは、ソースバッファとターゲットバッファから100行を読み取り、比較を実行します。その後、比較のために次の100行を読み取って準備します。データベースから100行を-fsために必要な実際のデータベースラウンドトリップは、フェッチサイズの-fsオプションによって異なります。たとえば、 -fsを100に設定すると1往復だけで済み、 -fsを10に設定すると10回のデータベース往復が必要になります。
-fs 、 --fetch-size row_count
サイズが非常に大きいテーブルに対してデータ検証を実行すると、デフォルトのフェッチサイズ5000行を使用すると、データバリデータがヒープ領域外エラーで終了することがあります。ヒープ領域不足の問題を回避するために、フェッチサイズを小さく指定するには、 -fsオプションを使用します。結果セットの反復は、1回のデータベースラウンドトリップでrow_count値で表されるのと同じ数の行をrow_countます。
例
スキーマ EDBのテーブルと、ソースデータベースのテーブルDEPTおよびEMP内容を以下に示します。
EMP
次に示すのは、Advanced Serverのedbターゲットデータベースのdeptおよびempテーブルの内容とともに、 public スキーマのテーブルの一覧です。
•
ソースの DEPTテーブルには、ターゲットのAdvanced Serverのdeptテーブルには存在しない、 DEPTNO 50余分な行が1つ含まれています。
•
EMPNO値が9001と9002 の EMP表の行には 、ソースAdvanced Server表とターゲットAdvanced Server表の間で異なる列値があります。
•
この例では、 JOBHISTテーブルには、ソースAdvanced ServerテーブルとターゲットAdvanced Serverテーブルの両方に対して同一の行が含まれています。
datavalidator.propertiesファイルの内容は次のように設定されています。
#
#
#
#
次の例では、 EDBスキーマ内のすべてのテーブルを publicスキーマと比較します。
Data Validatorログファイルは 、 -ldオプションで指定された/EPRS_home/datavalidator/bin/logs 、ディレクトリ /EPRS_home/datavalidator/bin/logs / 作成されます。 runValidation.shスクリプトを呼び出すために使用されたオペレーティング・システム・アカウントは、 EPRS_homeディレクトリーへの書き込みrunValidation.shを持っているので、データ/EPRS_home/datavalidator/bin/logsは/EPRS_home/datavalidator/bin/logsサブディレクトリーを作成できます。
7.0
All tables count: 3
Validated tables count: 3
Rows count: 38
Errors count: 3
Tables having only unsupported datatypes count: 0
Tables having primary key limitation count: 0
Total time(s): 0.678
Rows per second: 56
•
DEPTテーブルに1つエラーがあります(行がありません)。
•
EMPテーブルに2つのエラーがあります(2つの行が一致しない列値を持つ)
•
JOBHIST表には、エラーが含まれていません。

コントロールの複製元は、パブリケーションデータベースの登録プロセスの一部として自動的に作成されます。起点は _ngx_DBNAMEであるデータベース名、例えば_ngx_inventory ちなんで命名されます 。パブリケーションデータベースの登録が解除されると、コントロールの複製元は削除されます。
注意:複製起点を作成または削除に失敗した場合には、関連する上の任意の影響はありませんadddbまたはremovedb操作のみ警告メッセージが記録されます。
ステップ1: SQL端末(たとえばpsql)を開き、ユーザートランザクションを開始します。
手順2:他の(クエリ)操作を実行する前に、現在のトランザクションの複製元セッションを設定します。
手順3:ユーザー固有のクエリを実行してアプリケーションを変更します(一括変更を目的としています)。
例
Publicationの一部でもあるテーブル exclude_user_test に複数の行を追加します 。レプリケーションからスキップされる一括変更(5K)をシミュレートします。この表もEPRS7クラスター出版物の一部となります。
手順4:複製元をリセットします。

1。
エラー: 他のコマンドを実行する前に最初に管理者パスワードを設定してください。
原因: レプリケーションサーバにデータベースを追加する前に管理者パスワードが設定されていません。
対処方法: データベースをレプリケーションサーバに追加する前に管理者パスワードを設定します。
2。
エラー : パスワードを暗号化できません。理由無効なユーザー名またはパスワード。
原因:指定されたユーザー名またはパスワードが正しくありません。
回避策:正しいユーザー名またはパスワードを入力してください。
3。
エラー: エラーが発生しました:id database_Idのデータベース を追加できませんでした 。
原因:このエラーは次のような状況で発生する可能性があります。
回避策 :正しい暗号化パスワードを入力します。正しいIPアドレス(データベースホストのIPアドレス)を入力してください。データベースサーバが起動しているか確認してください。 encrypt コマンドを使用 してデータベースのパスワードを 暗号化 し、データベースを追加するときに同じ パスワードを使用 します。
4。
エラー: ID db1のデータベースを追加できませんでした。警告:接続エラー:致命的:ホスト "xxxx" 、ユーザー " xxx"、 データベース " database_Id " のpg_hba.confエントリがありません 、SSLがオフです。
原因:データベースホストのIPアドレスがpg_hba.confファイルに存在しません。
回避策:データベースホストのIPアドレスを pg_hba.confファイル var / lib / edb /に x /としてあります。クラスタの場合、 pg_hba.confファイルは/ var / lib / edb / as x / cluster x ます。
x EDB高度なバージョンで、
クラスター x データベースが稼働しているクラスター(例えば、cluster1またはcluster2など)。
_
5。
エラー: データベースID database_Id がネットワークに登録されていません。
原因:データベースが存在しないか、正しくないデータベースIDが指定されています。
回避策:正しいデータベースIDを指定するか、 create databaseコマンドを使用してデータベースを作成します 。
6。
エラー: サーバー server_name はネットワークに登録されていません。
原因:誤ったサーバー名が指定されたか、サーバーがネットワークに存在しません。
回避策:正しいサーバー名を指定するか、 joinnetworkコマンドを使用してサーバーをネットワークに登録します。
7。
エラー: パブリケーション publication_name が見つかりません。
パブリケーション publication_nameの ターゲットデータベース database_Id への スナップショットが失敗しました 。
原因: 出版物が存在しないか、正しくない出版物名が指定されています。
回避策:正しいパブリケーション名を入力するか、パブリケーションを作成してください。
8。
エラー: パブリケーション publication_nameに DB ID database_Idの サブスクリプションが 見つかりません 。
パブリケーション publication_nameの ターゲットデータベース database_Id への スナップショットが失敗しました 。
原因:指定されたデータベースIDが正しくないか、データベースが存在しません。
回避策:正しいdatabase_Idまたは データベースが存在しない場合は作成します。
9。
Error: スナップショットを実行できません。パブリケーションデータベースID database_Id はコンシューマデータベースID database_Id と同じ です。
原因:パブリケーションデータベースはコンシューマデータベースと同じです。
回避策:パブリケーションデータベースとコンシューマデータベースは異なる必要があります。
10。
エラー: 1つ以上のサブスクリプションがパブリケーション publication_nameに 関連付けられてい ます。出版物を削除する前に、(leavepubコマンドで)購読を解除してください。
原因: removepub パブリケーションがネットワークを離れる前にcommandが実行されます。
回避策:パブリケーションを削除する前に、すべてのサブスクリプションデータベースに対して leavepubコマンドを実行してください 。
Error: データベースはパブリケーションサービスによってすでに登録されているので登録できません。
原因:データベースはレプリケーションクラスタに一度だけ登録できます。
回避策:データベースはすでに登録されています。 createpubコマンドを使用して、必要なテーブルを含むパブリケーションを作成できます。
Error: スレッド "main"で例外が発生しましたjavax.ws.rs.ProcessingException:java.net.ConnectException:接続が拒否されました
原因: EDB Replication Serverに接続できないときに発生します。
回避策: サーバーの正しいホストIPアドレスとポート番号を入力したことを確認してください。サーバーが稼働していることを確認してください。 pg_hba.conf ファイルで、ホスト名が正しいネットワークIPアドレスにマッピングされている ことを確認し ます。これは、Linuxの ifconfig コマンド によって返されるIPアドレスと一致します 。 パブリケーションサーバがデータベースにアクセスできるかどうか pg_hba.conf ファイルを チェックインしてください 。
エラー: 接続が拒否されました。ホスト名とポートが正しいこと、およびポストマスターがTCP / IP接続を受け入れていることを確認してください。
原因: パブリケーションデータベース定義を保存しようとしたときに発生します。パブリケーションサーバーがデータベースサーバーのネットワークの場所に接続できません。
回避策: データベースサーバーの正しいIPアドレスとポートが指定されていることを確認してください。データベースサーバが実行されていて、パブリケーションサーバを実行しているホストからアクセスできることを確認します。
エラー: データベースサーバーに接続できませんでした。理由:FATAL:要求されたスタンバイ接続数がmax_wal_sendersを超えています(現在は n )。
原因: デフォルトでログベースの同期レプリケーション(つまり、WALベースの論理レプリケーション)で構成されているパブリケーションデータベースからスナップショットレプリケーションを試行し、論理レプリケーション用の追加の同時接続が現在の設定 n を超えた 場合 に発生します。 postgresql.conf ファイル のmax_wal_senders設定パラメータ
回避策: パブリケーションデータベースを実行しているデータベース・サーバーの postgresql.conf ファイル 内 max_wal_senders の値を増やし ます。パブリケーションデータベースを含むデータベースサーバーを再起動します。
postgresql.conf ファイル のパス は / var / lib / edb / as x / cluster x です。
x EDB高度なバージョンで、
クラスター x データベースが稼働しているクラスター(例えば、cluster1またはcluster2など)。
エラー: 現在パブリケーションサーバーにパブリケーションが存在しません。サーバー上に少なくとも1つのパブリケーションを作成してから再試行してください。
原因 :指定されたパブリケーションサーバーにパブリケーションがないときにパブリケーションに参加すると、このエラーメッセージがスローされます。
回避策 : createpub コマンドで パブリケーションを作成してからパブリケーションに 参加します。
エラー: データベースを削除できません。理由:パブリケーションデータベース接続に対して1つ以上のパブリケーションが定義されているため、パブリケーションデータベース接続を削除できません。
原因: データベースに既存のパブリケーションがあります。
回避策: パブリケーションデータベースに関連するすべてのパブリケーションが削除されていることを確認してください。 出版物を取り除くために パブリケーションと removepub コマンドを 残すために leavepub コマンドを 使用します 。
エラー: データベース接続を追加できません。ホストの無いpg_hba.confのエントリ 、ユーザー"USER_NAME"、 データベース" データベース名 "、SSLオフ :FATAL "XXX のXXX XXX。。。"
原因: adddb コマンド を使用してデータベース定義を保存しようとしたときに発生します 。
回避策: データベースホストのIPアドレス、ポート番号、データベースユーザー名、パスワード、およびデータベース識別子が正しいことを確認してください。 pg_hba.conf ファイルに、EDB Replication Serverが実行されているIPアドレスから始まる指定のユーザ名でデータベースへのアクセスを許可 するエントリがあることを確認し てください。
エラー: BYTEA、BLOB、RAWなど、バイナリデータ型の列にフィルタを定義することはできません。
原因: パブリケーションテーブルのバイナリデータ型の列にフィルタルールを定義しようとしたときに発生します。そのような列では、フィルター規則は許可されません。
回避策: バイナリデータ型の列にフィルタを追加しないでください。
エラー: 同じ名前/句を持つフィルタがテーブル/ビュー: schemaに 既に存在し ます 。 table_name
原因: パブリケーション表にフィルター規則を追加するとき、同じフィルター名または同じフィルター句(WHERE句)を特定の表に複数回使用することはできません。
回避策: 重複したフィルタ名またはフィルタ句を修正して、テーブルに対して一意になるようにします。
エラー: 1つ以上のパブリケーションテーブルに対するトリガの作成に失敗しました。データベースが有効な状態にあり、ユーザーに必要な特権が付与されていることを確認してください。
原因: ユーザーにトリガー作成権限がないか、データベースサーバーに問題があります。データベースサーバメッセージはエラーの一部として表示されます。
回避策: データベースを追加するときに十分な権限を持つユーザー名を指定してください。
エラー: 発行プロセスで問題が発生しました。理由:接続が拒否されました。ホスト名とポートが正しいこと、およびポストマスターがTCP / IP接続を受け入れていることを確認してください。
解決策: 同期レプリケーションを試行し、コントローラデータベースがパブリケーションサーバーからアクセスできない場合に発生します。
回避策: コントローラデータベースのパブリケーションデータベース定義で正しいIPアドレスとポートが定義されていることを確認します。データベースサーバが実行されていて、パブリケーションサーバを実行しているホストからアクセスできることを確認します。
以下のシナリオでは パブリケーションを作成できない というエラーが発生する可能性があります 。
1。
エラー: パブリケーションを作成できません。パブリケーション publication_name はパブリッシャーサーバーに既に存在します。別の名前を選択してから続行してください。
原因: パブリケーション名はパブリケーションサーバー内で一意である必要があります。
回避策: 別のパブリケーション名を入力してください。
2。
エラー: パブリケーションを作成できません。テーブルスキーマ 。 table_name レプリカIDは replica_identity_settingに 設定されてい ます 。フィルタを定義するには、テーブルレプリカIDをFULLに設定する必要があります。
原因: ログベースのレプリケーションシステムで使用されているパブリケーションテーブルにテーブルフィルタを定義しようとしたときに発生します。
対処方法: ALTER TABLE文を使用してREPLICA IDENTITYをFULLに変更します。
3。
エラー: パブリケーションを作成できません。テーブル table_nameに 主キーが含まれていません。トランザクションレプリケーションは、pk以外のテーブルではサポートされていません。
原因: 同期レプリケーションに使用されるすべての表に主キーが必要です。
回避策: テーブルに主キーを作成します。
エラー: パブリケーションスキーマを作成できません。理由:エラー:データベース db_name に対する権限が拒否されました 。
原因: パブリケーションデータベース定義を作成しようとしたときに、指定されたパブリケーションデータベースユーザーにデータベース db_nameに スキーマを作成する権限がない場合に発生し ます 。
回避策: パブリケーションデータベースのユーザーにデータベースに対するCREATE権限を付与します。
エラー: ターゲットデータベースサーバーにレプリケーションスロットがありません。データベースサーバでmax_replication_slots GUCを設定してください。
原因:同期レプリケーションのログベースの方法でパブリケーションデータベース定義を追加しようとしたときに発生し、 postgresql.confファイルのmax_replication_slots構成パラメータが追加データベースを収容するのに十分な大きさの値に設定されていません。
回避策: max_replication_slotsパラメータの値を大きくしてデータベースサーバーを再起動します。
Error: main "javax.ws.rs.ProcessingException:java.net.ConnectException:接続が拒否されました(接続が拒否されました)
原因: EDB Replication Serverが実行されていません。
pkill -f 'ngen'
5。
/usr/edb/rs-7.0/server/etc/application.propertiesファイル内の以下の値を確認して ください 。
注意: EDB Replication Serverをインストールした後に、次のディレクトリが存在することを確認してください。
/ var / lib / edb / as x / data / log
手順1: レプリケーションクラスタに参加し ている データベースサーバーがすべて実行されて いることを確認し ます。
手順2: EDB Replication Serverが実行されていることを確認します。
ステップ3: マルチマスターレプリケーションシステムのマスター定義ノードの場合、パブリケーションデータベースユーザーがスーパーユーザーであり、 pg_catalog テーブル を変更する権限を持っていることを確認して ください。
ステップ4: ifconfig コマンド によって返されたネットワークIPアドレスが 、application.propertiesのngen.server.hostに 設定されて いるIPアドレスと一致すること を 確認します。
ステップ5: ポートが占有されていないことを確認します 。 ポートが占有されている場合は、 application.properties および server.propertiesの ポートを変更してください 。詳細はセクション 6.2.2 を 参照し てください。
手順6: 十分な空きディスク容量があることを確認します。そうしないと、インストールおよび設定中にEDB Replication Serverで問題が発生する可能性があります。
ステップ7: ファイアウォールを設定した場合は、ファイアウォール設定で、異なるマシンで実行されているEDB Replication Serverを使用したクラスタ設定でEDB Replication Serverが使用するポートにアクセスできることを確認してください。
ステップ8: 地理的に分散したネットワークの場合は、実質的に は/ usr / EDB / RS-X.0 /サーバの/ etc にある server.properties ファイル 内 のパラメータ zookeeper.session.timeouts の値を大きくしてください 。さもなければ、ブローカーと動物園主の間で頻繁な機能停止があるでしょう。デフォルト値は6000です。
手順1: ngx-server.logファイルでエラーを確認します。
ステップ2: コントローラデータベースを実行しているデータベースサーバのログファイルでエラーを確認します。

手順1:既存のパブリケーションパーティションテーブルに新しいパーティションを追加します。
以下は、 listとしてサブパーティション化を使用した rangeパーティション化の構文です 。
例: 以下は、3つのノードクラスタnode1、node2、およびnode3を持つMMRの例です。この場合、範囲によるパーティションはサブパーティションとともにリストとして使用されます。
4。
いずれかのノードでパブリケーションを作成してから、他のノードに対してjoinpubコマンドを使用します 。
6。
events_queueテーブルがすべてのノードにわたって存在することを確認します。
7.0
手順2:パーティション表にデータを挿入または更新するパーティションテーブルの変更がターゲットデータベーステーブルにも複製されるかどうかを確認します。
ノード2:
手順3:データベースを追加した後、特定のアプリケーションデータベースの_ngx_rep_cluster コントロールスキーマの 下に次のコントロールオブジェクトが作成されていることを確認します。
手順4:データベースを削除した後、次のコントロールオブジェクトが 指定したアプリケーションデータベースの_ngx_rep_cluster コントロールスキーマ から削除されていることを確認します。