レプリカクラスター
レプリカクラスターは、独立したCloudNativePG Cluster
リソースであり、別のPostgresインスタンスからレプリカにあるという主な特徴があります、理想的には同じくCloudNativePGによって管理されます。通常、レプリカクラスターは、別のリージョンの別のKubernetesクラスターにあります。レプリカクラスターはカスケードすることもでき、以下で説明するように、ソースからのデータのレプリケーションをオブジェクトストアにのみ依存できます。
次の図は、この機能の詳細を含む アーキテクチャ から取得したもので、レプリカクラスターを使用して実装できるアーキテクチャの例を示しています。
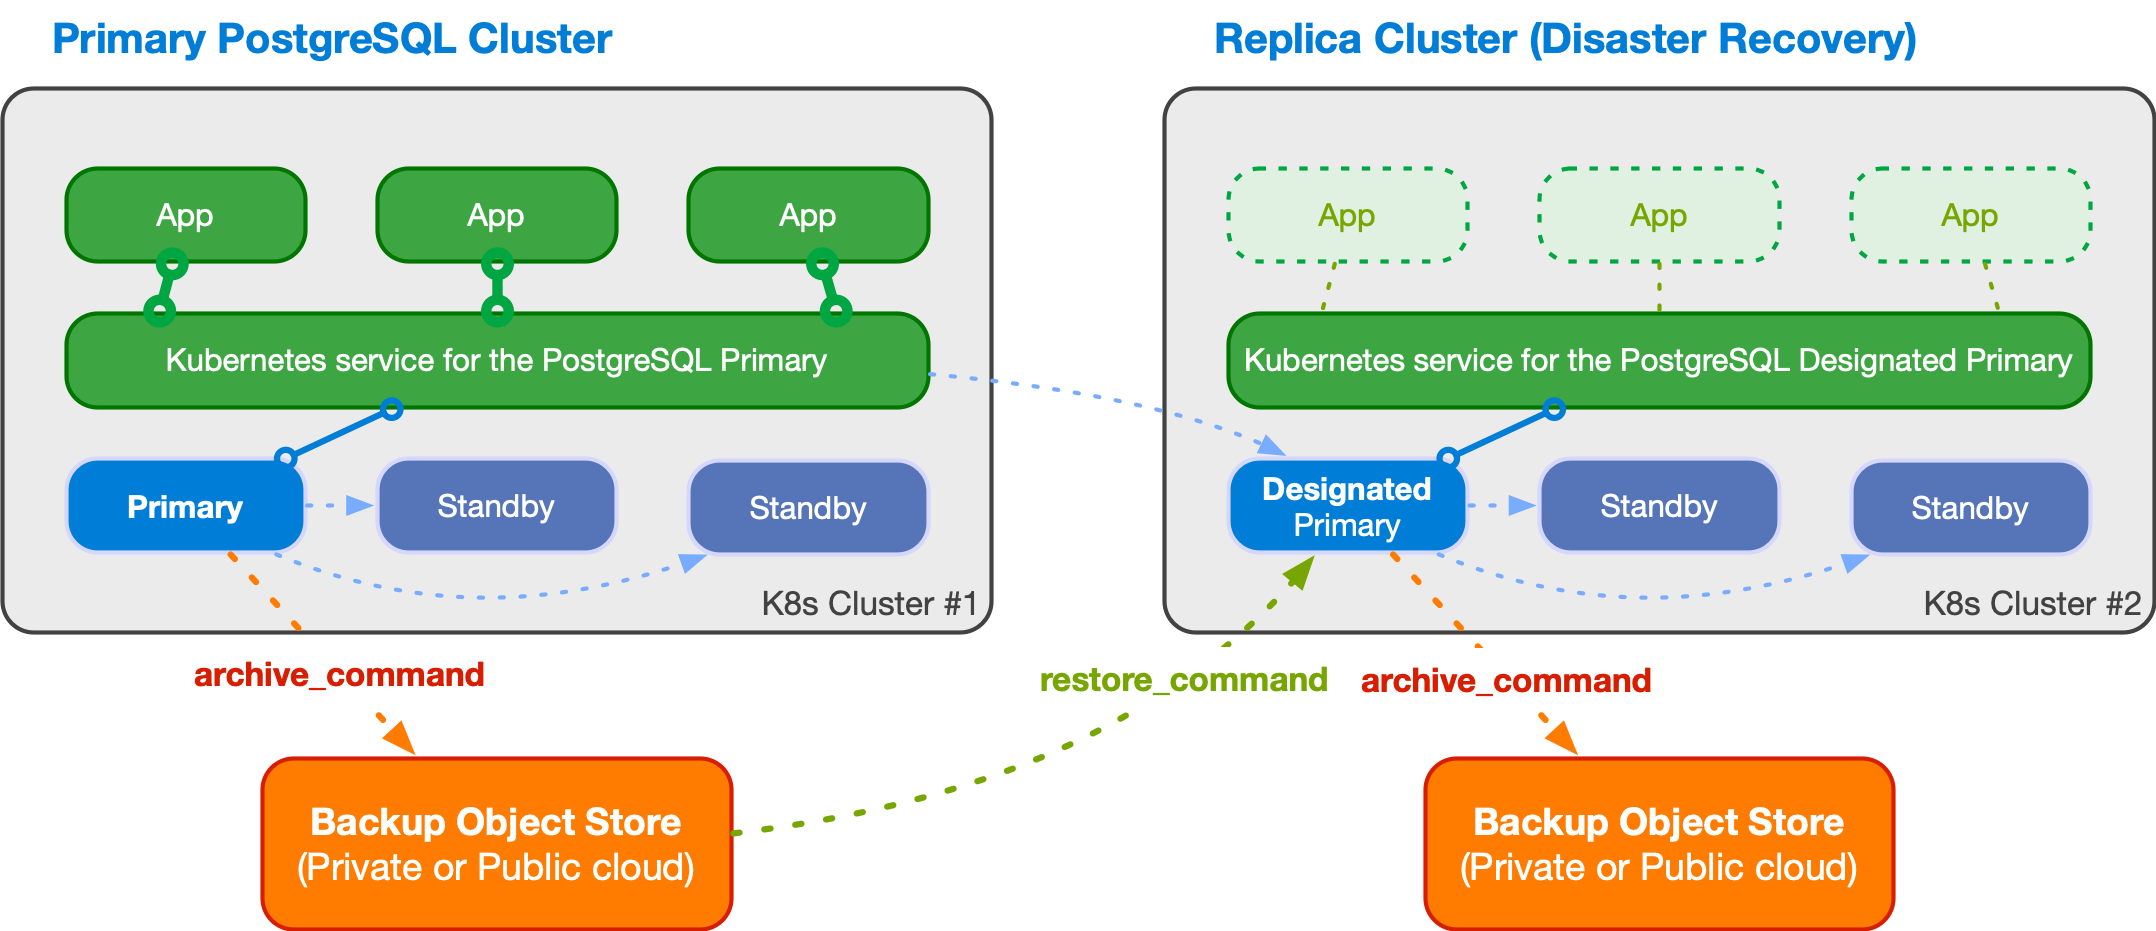
An example of multi-cluster deployment with a primary and a replica cluster
基本的な概念
CloudNativePGは、 PostgreSQLクラスターが既存のソースソースから作成され、 レプリカクラスター 機能を介して同期が維持される場合でも、 PostgreSQLレプリケーションフレームワークの基礎に依存します。ソースは、プライマリクラスターまたは別のレプリカクラスターカスケードレプリカクラスターです。
最初のステップは、レプリカクラスターをブートストラップし、使用可能な方法のいずれかを選択することです。
ストリーミングレプリケーション
pg_basebackup経由ボリュームスナップショットからのリカバリー
オブジェクトストアのBarman Cloudバックアップからのリカバリー
Bootstrap を参照してください。
pg_basebackup ストリーミングまたはrecovery
ボリュームスナップショットまたはオブジェクトストアを使用してPostgreSQLサーバーのクローンを作成する方法については、
レプリカクラスターのベースバックアップが利用できるようになったら、PostgreSQLの継続的リカバリーを介してオリジンから変更をレプリケートする方法を定義する必要があります。 2つのオプションがあります。
レプリカクラスターとソース間でストリーミングレプリケーションを使用しますこれには、2つのクラスター間のネットワーク接続が正しく設定されていることを確認するために、いくつかの管理およびセキュリティ関連の作業を行う必要があります。
WALアーカイブオブジェクトストア上を使用して、ソースからオブジェクトストアに定期的にシップされ、レプリカクラスタの
barman-cloud-wal-restoreによってプルされるWALファイルを取得します2つのいずれか
あなたがしなければならないのは、実際に外部クラスターを定義することだけです。
外部クラスターにbarmanObjectStore セクションが含まれる場合
WALアーカイブを使用できるようになり、CloudNativePGは指定されたプライマリインスタンスに
restore_commandを自動的に設定しますボリュームスナップショットを利用できない場合、
recoveryセクションを使用してオブジェクトストアからレプリカクラスターをブートストラップできます。
外部クラスターにconnectionParameters セクションが含まれる場合
pg_basebackupセクションを使用して、ストリーミングレプリケーションを介してレプリカクラスターをブートストラップできるようになりますCloudNativePGは、指定されたプライマリインスタンスで
primary_conninfoオプションを自動的に設定するため、WALレシーバープロセスが開始され、ソースクラスターに接続してデータを受信します
作成されたレプリカクラスターは、指定されたプライマリから予約されたオブジェクトストアでバックアップを実行でき、分散方法での対称アーキテクチャが有効になります。
以下を選択することにより、PostgreSQLデータベースのお気に入りの分散アーキテクチャを決定する完全な柔軟性と自由があります。
異なるデータセンターにある複数のKubernetesクラスターにまたがるプライベートクラウド
さまざまなリージョンの複数のKubernetesクラスターにまたがるパブリッククラウド
前の2つの混合ハイブリッド
さまざまなリージョンおよびさまざまなクラウドサービスプロバイダーにある複数のKubernetesクラスターにまたがるパブリッククラウド
レプリカクラスターのセットアップ
ソースクラスターからレプリカクラスターをセットアップするには、クラスターYAMLファイルを作成し、それに応じて次の部分を定義する必要があります。
レプリカクラスターに
externalClustersセクションを定義しますレプリカクラスターのブートストラップ部分を定義します。
pg_basebackupセクションを使用してストリーミングを介してブートストラップするか、recoveryセクションを使用してボリュームスナップショットまたはオブジェクトストアからブートストラップできます。レプリカクラスターに継続的リカバリ部
.spec.replicaを定義します。行う必要があるのは、オプション.spec.replica.enabledでレプリカモードを有効にし、オプション.spec.replica.sourceでexternalClusters名前を設定することだけです
pg_basebackupを使用した例
この 最初の例 は、ブートストラップと継続的リカバリーの両方でストリーミングレプリケーションを使用してレプリカクラスターを定義します。レプリカクラスターは、TLS認証を使用してソースクラスターに接続します。
samples/ サブディレクトリ。
ソースクラスターを指しているbootstrap およびreplica
セクションに注意してください。
bootstrap:
  pg_basebackup:
    source: cluster-example

replica:
  enabled: true
  source: cluster-example
externalClusters セクションでは、 connectionParameters
サブセクションのホストに対応した適切な名前空間を使用することに注意してください。レプリカクラスターが別の名前空間にある場合、
-replication および-ca
シークレットは、必要に応じてコピーしておく必要があります。
externalClusters:
- name: <MAIN-CLUSTER>
  connectionParameters:
    host: <MAIN-CLUSTER>-rw.<NAMESPACE>.svc
    user: streaming_replica
    sslmode: verify-full
    dbname: postgres
  sslKey:
    name: <MAIN-CLUSTER>-replication
    key: tls.key
  sslCert:
    name: <MAIN-CLUSTER>-replication
    key: tls.crt
  sslRootCert:
    name: <MAIN-CLUSTER>-ca
    key: ca.crt
オブジェクトストアからのバックアップを使用した例
2番目の例 は、 recovery
セクションと継続的リカバリーを使用してオブジェクトストアからブートストラップするレプリカクラスターを定義します。ストリーミングレプリケーションと特定のオブジェクトストアの両方を使用します。ストリーミングレプリケーションの場合、レプリカクラスターは基本認証を使用してソースクラスターに接続します。
samples/ サブディレクトリにあります。
ソースクラスターを指しているbootstrap およびreplica
セクションに注意してください。
bootstrap:
  recovery:
    source: cluster-example

replica:
  enabled: true
  source: cluster-example
externalClusters セクションでは、 endpointURL
およびconnectionParameters.host
で適切な名前空間を使用するように注意してください。また、必要に応じて必要なシークレットがコピーされていること、およびソースクラスターのバックアップが既に作成されていることを確認してください。
externalClusters:
- name: <MAIN-CLUSTER>
  barmanObjectStore:
    destinationPath: s3://backups/
    endpointURL: http://minio:9000
    s3Credentials:
      …
  connectionParameters:
    host: <MAIN-CLUSTER>-rw.default.svc
    user: postgres
    dbname: postgres
  password:
    name: <MAIN-CLUSTER>-superuser
    key: password
注釈
ソースクラスターとレプリカクラスター間でストリーミングレプリケーションを使用するには、2つのクラスター間のネットワーク接続があることを確認し、パスワードまたは証明書を保持する必要なシークレットがすべて事前に適切に作成されていることを確認する必要があります。
ボリュームスナップショットを使用した例
ボリュームスナップショットを使用し、ストレージクラスがスナップショットクラスター間の可用性を提供する場合、それを活用して、ソースクラスターのボリュームスナップショットを介してレプリカクラスターをブートストラップできます。
3番目の例 は、 recovery
セクションを使用してボリュームスナップショットからブートストラップするレプリカクラスターを定義します。ストリーミングレプリケーション基本認証を介して、オブジェクトストアを使用してWALファイルを取得します。
samples/ サブディレクトリにあります。
プライマリのレプリカクラスターへの降格
CloudNativePGは、プライマリクラスターをレプリカクラスターに降格する機能を提供します。このアクションは、通常、プライマリロールをあるデータセンターから別のデータセンターに移行するときに計画されます。このプロセスには、現在のプライマリクラスターたとえば
cluster-eu-southをレプリカクラスターに降格し、その後、完全に同期したときに指定されたレプリカクラスターcluster-eu-central
をプライマリに昇格させることが含まれます。新しいプライマリになるように選択されたレプリカクラスターをポイントする現在のプライマリCluster
リソースで外部クラスターを定義している場合、行う必要があるのはレプリカモードを有効にし、次のようにソースを定義することです。
replica:
  enabled: true
  source: cluster-eu-central
レプリカクラスターでの指定されたプライマリの昇格
レプリカクラスターcluster-eu-central
などをプライマリクラスターにプロモートし、指定されたプライマリを本当のプライマリにするには、オプション
.spec.replica.enabled
を介してレプリカクラスターのレプリカモードを無効にするだけです。
replica:
  enabled: false
  source: cluster-eu-south
最初にcluster-eu-south を降格し、cluster-eu-central
が同期するのを待った場合、cluster-eu-central
がプライマリとして起動すると、cluster-eu-south
クラスターはレプリカクラスターとしてシームレスに起動し、再クローンを作成する必要はありません。
事前に降格せずにレプリカモードを無効にすると、レプリカクラスターとソースクラスターは2つの別のクラスターになります。
レプリカモードが無効になっている場合、レプリカクラスター内の 指定されたプライマリ は、そのクラスターの プライマリ に昇格します。
cnpg
プラグインを使用して、以前にレプリカであったクラスターのステータスを確認して、ロールの変更を確認できます。
kubectl cnpg -n <cluster-name-space> status cluster-eu-central
注釈
レプリケーションの無効化は、**不可逆的な**操作です。レプリケーションが無効になり、指定されたプライマリがプライマリに昇格すると、レプリカクラスターとソースクラスターは決定的に2つの独立したクラスターになります。意図しない結果を回避するために、降格手順に正しく従うようにしてください。
遅延レプリカ
標準のレプリカクラスターに加えて、私たちのシステムは、PostgreSQLの recovery_min_apply_delay の利用を介して 遅延レプリカ の作成をサポートします
オプション。
遅延レプリカは、指定された時間プライマリデータベースより意図的に遅延します。この遅延は、PostgreSQLのrecovery_min_apply_delay
オプションを使用して構成できます。遅延レプリカを導入する主な目的は、プライマリデータベースでのSQLステートメントの意図しない実行の影響を緩和することです。これは、誤ったまたは欠落しているWHERE
句がUPDATE やDELETE
などの操作で使用されるシナリオで特に役立ちます。
レプリカクラスターに遅延を導入するには、 recovery_min_apply_delay
オプションを調整します。このパラメーターは、レプリカがプライマリから遅延する時間を決定します。例
# ...
postgresql:
  parameters:
    # Enforce a delay of 8 hours
    recovery_min_apply_delay = 8h
# ...
目標復旧時間と意図しないプライマリデータベース操作の潜在的な影響に基づいて、必要に応じて遅延を監視および調整します。
遅延レプリカの主な使用ケースは次のように要約できます。
人的エラーの軽減 プライマリデータベースでの意図しないSQL操作に起因するデータの破損または損失のリスクを削減します。
復旧時間の最適化 変更が他のレプリカに適用される前に問題を特定および修正できる遅延レプリカを使用することにより、意図しない変更からの迅速な復旧を促進します。
データ保護の強化 不要な変更の伝播を介入および防止する機会を提供する時間バッファを導入することにより、重要なデータを保護します。
遅延レプリカをレプリケーション戦略に統合することにより、PostgreSQL環境の復元力とデータ保護機能を強化できます。特定のニーズとデータの重要度に基づいて、遅延期間を調整します。
重要
常に目標を測定します。環境によっては、より迅速な結果を得るには、ボリュームスナップショットベースのリカバリーに依存する方が効率的である場合があります。独自の要件とインフラストラクチャに最適なアプローチを評価および選択します。