Postgresデータベースのインポート
このセクションでは、新しいCloudNativePGクラスター内に1つ以上の既存のPostgreSQLデータベースをインポートする方法について説明します。
インポート操作は、PostgreSQLのオンライン論理バックアップの概念に基づいており、オリジンホストへのネットワーク接続を介してpg_dump
、およびpg_restore
に依存します。ネイティブのマルチバージョン同時実行制御MVCCとスナップショットのおかげで、PostgreSQLでは、書き込みアクティビティを停止せずに、ネットワークを介して同時実行の方法で、一貫したバックアップを取得できます。
論理バックアップは、PostgreSQLバージョンのメジャーアップグレードを実行するための最も一般的な柔軟で信頼性の高い技術でもあります。
その結果、このセクションの手順は両方の場合に適しています。
Kubernetesの外部でも、既存のPostgreSQLインスタンスから1つ以上のデータベースをインポート
PostgreSQLバージョンから同じまたは新しいバージョンにデータベースをインポートし、PostgreSQLの_メジャーアップグレード_を有効にしますバージョン11.xからバージョン15.xなど
警告
PostgreSQLのメジャーアップグレードを実行するときは、アプリケーションが新しいバージョンと互換性があり、データベース拡張機能を含むオブジェクトのアップグレードパスが実行可能であることを確認する責任があります。
どちらの場合も、操作は元のデータベースの一貫した スナップショット で実行されます。
重要
このため、バックアップの開始後にソースデータベースに行われた変更は宛先クラスタにないため、 Cluster リソースの最終インポートの前にソースの書き込み操作を停止することをお勧めします。したがって、この機能が参照される理由「オフラインインポート」または「オフラインメジャーアップグレード」として。
その仕組み
概念的には、インポートには、
空のクラスターをブートストラップする `initdb <空のクラスターをブートストラップする initdb>` を使用して新しいクラスター_destination cluster_を作成し、
initdb.import
サブセクションを完了して、既存のPostgresクラスター_source
cluster_からオブジェクトをインポートする必要があります。
PostgreSQLの推奨に従って、_destination
cluster_のPostgreSQLメジャーバージョンが_source
cluster_のメジャーバージョン以上であることをお勧めします。
CloudNativePGは、ソースクラスターから宛先クラスターにオブジェクトをインポートする2つの主な方法を提供します。
マイクロサービスアプローチ 宛先クラスターは、CloudNativePGプロジェクトで推奨されているように、指定されたアプリケーションユーザーが所有する単一のアプリケーションデータベースをホストするように設計されています
モノリスアプローチ 宛先クラスターは、ソースクラスターからインポートされた複数のデータベースとさまざまなユーザーをホストするように設計されています。
最初のインポート方法はmicroservice
タイプを介して使用でき、後者はmonolith タイプで使用できます。
警告
宛先クラスターが、スーパーユーザーまたは`pg_dump` で論理バックアップを取るための十分な特権を持つユーザーでソースクラスターにアクセスできることを確認するのはあなたの責任です。 PostgreSQL documentation on "SQL Dump" を参照してください。
詳細については、
microservice タイプ
マイクロサービスアプローチでは、ソースクラスターから宛先クラスターにインポートする単一のデータベースを指定できます。操作は4つのステップで実行されます。
新しいクラスターの
initdbブートストラップpg_dump -Fdを使用した選択したデータベースinitdb.import.databases内のエクスポートinitdb.ownerユーザーが所有するinitdb.databaseアプリケーションデータベースへのpg_restore --no-acl --no-ownerを使用したデータベースのインポートデータベースダンプファイルのクリーンアップ
postImportApplicationSQLパラメーターを介してアプリケーションデータベースでのユーザー定義のSQLクエリーのオプションの実行インポートされたデータベースでの
ANALYZE VERBOSEの実行
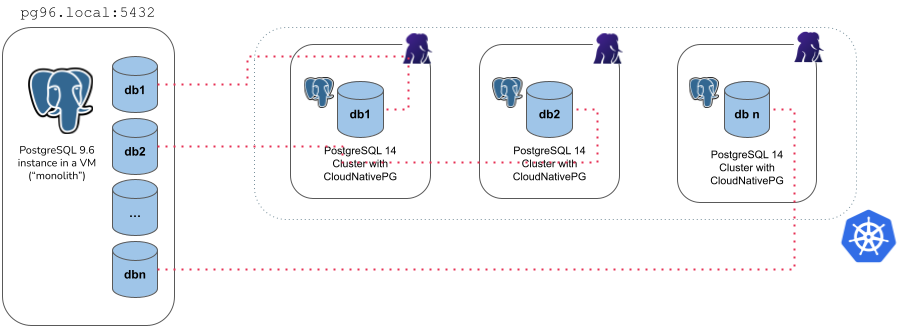
Example of microservice import type
たとえば、以下のYAMLは、 postgres
に接続することにより、cluster-pg96
クラスターサポートされていないPostgreSQL 9.6からangus
データベースをインポートするcluster-microservice
と呼ばれる新しい3インスタンスのPostgreSQLクラスターオペレーターがリリースされた時点での利用可能な最新のメジャーバージョンを作成しますcluster-pg96-superuser
シークレットに保存されたパスワードを介して、 postgres
ユーザーを使用してデータベースにアクセスします。
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: cluster-microservice
spec:
  instances: 3

  bootstrap:
    initdb:
      import:
        type: microservice
        databases:
          - angus
        source:
          externalCluster: cluster-pg96
        #postImportApplicationSQL:
        #- |
        #  INSERT YOUR SQL QUERIES HERE
  storage:
    size: 1Gi
  externalClusters:
    - name: cluster-pg96
      connectionParameters:
        # Use the correct IP or host name for the source database
        host: pg96.local
        user: postgres
        dbname: postgres
      password:
        name: cluster-pg96-superuser
        key: password
警告
上記の例では、コミュニティ、したがってCloudNativePGでサポートされていないバージョンのPostgreSQLを実行しているソースデータベースを意図的に使用しています。ソースインスタンスからのデータのエクスポートは、宛先クラスターの`pg_dump` のバージョンを使用して実行されます。これは、サポートされているものであり、ソースのものと同等以上である必要があります。私たちの経験に基づいて、データをエクスポートするこの方法はPostgresの古いバージョンのサポートされていないバージョンでも動作するため、古いデータをKubernetes内のより良いシステムに移動する機会が得られます。これが、このセクションの例で9.6を使用した主な理由です。この領域で問題が発生した場合は、ご連絡をお待ちしております。
microservice
タイプを使用するときは、いくつか注意する必要があります。
インポートするデータを含む既存のPostgreSQLインスタンスをポイントする
externalClusterが必要です。詳細については、 :ref:``externalClusters` セクション <externalClusters セクション>` を参照してください。オペレーション中にKubernetesクラスターと
externalClusterの間でトラフィックを許可する必要があるソースデータベースへの接続は、
pg_dumpを実行し、ロール情報を読み取る必要がある指定されたユーザーで付与される必要があります_superuser_はOKです現在、
pg_dump -Fd結果はPGDATAボリュームのdumpsフォルダー内に一時的に保存されます。そのため、割り当てられたノードにダンプ結果、復元されたデータとインデックスを一時的に含むための十分な利用可能な領域が必要です。インポート操作が完了すると、このフォルダーはオペレーターによって自動的に削除されます。initdb.import.databases配列内で指定できるデータベースは1つだけですロールはインポートされません - そのため、
initdb.import.roles内で指定できません
monolith タイプ
モノリスアプローチでは、ソースクラスターから宛先クラスターにインポートするロールとデータベースのセットを指定できます。操作は次の手順で実行されます。
新しいクラスターの
initdbブートストラップ選択したロールのエクスポートとインポート
pg_dump -Fdを使用して、選択したデータベースinitdb.import.databases内を一度に1つずつエクスポート選択した各データベースを作成し、
pg_restoreを使用してデータをインポートしますインポートされた各データベースで
ANALYZEを実行しますデータベースダンプファイルのクリーンアップ
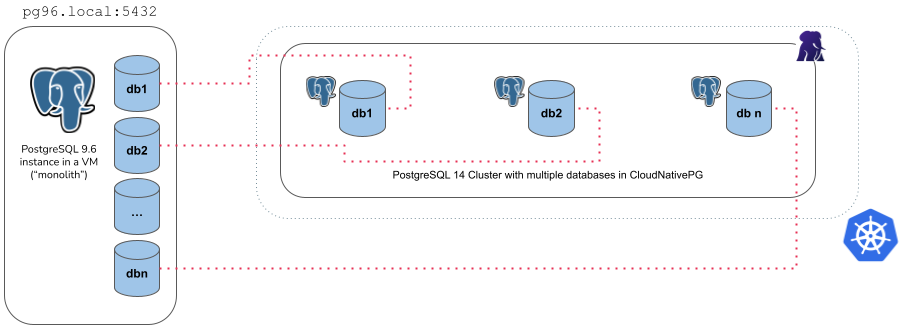
Example of monolith import type
たとえば、以下のYAMLは、 cluster-monolith
と呼ばれる新しい3インスタンスのPostgreSQLクラスターオペレーターがリリースされた時点での利用可能な最新のメジャーバージョンを作成します。
postgres ユーザーを使用してpostgres
データベースに接続し、cluster-pg96-superuser
シークレットに保存されているパスワードを介してpostgres
データベースに接続します。
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: cluster-monolith
spec:
  instances: 3
  bootstrap:
    initdb:
      import:
        type: monolith
        databases:
          - accounting
          - banking
          - resort
        roles:
          - accountant
          - bank_user
        source:
          externalCluster: cluster-pg96
  storage:
    size: 1Gi
  externalClusters:
    - name: cluster-pg96
      connectionParameters:
        # Use the correct IP or host name for the source database
        host: pg96.local
        user: postgres
        dbname: postgres
        sslmode: require
      password:
        name: cluster-pg96-superuser
        key: password
monolith タイプを使用するときは、いくつか注意する必要があります。
インポートするデータを含む既存のPostgreSQLインスタンスをポイントする
externalClusterが必要です。詳細については、 :ref:``externalClusters` セクション <externalClusters セクション>` を参照してください。オペレーション中にKubernetesクラスターと
externalClusterの間でトラフィックを許可する必要があるソースデータベースへの接続は、
pg_dumpを実行し、ロール情報を取得する必要がある指定されたユーザーで付与される必要があります_superuser_はOKです現在、
pg_dump -Fd結果はPGDATAボリュームのdumpsフォルダー内に一時的に保存されます。そのため、割り当てられたノードにダンプ結果、復元されたデータとインデックスを一時的に含むための十分な利用可能な領域が必要です。インポート操作が完了すると、このフォルダーはオペレーターによって自動的に削除されます。initdb.import.databases配列で指定される少なくとも1つのデータベースインポートされたデータベースに必要なロールは、
initdb.import.roles内で指定する必要があります。以下の制限があります。次のロールが存在する場合、インポートされません。
postgres、streaming_replica、cnp_pooler_pgbouncerSUPERUSERオプションは、インポートされたロールから削除されますワイルドカード
"*"は、databasesおよび/またはroles配列の唯一の要素として使用して、その種類のすべてのオブジェクトをインポートできます。データベースを照合する場合、ワイルドカードはpostgresデータベース、テンプレートデータベース、および接続を許可しないデータベースを無視しますクローンプロシージャが完了した後、すべてのデータベースに対して
ANALYZE VERBOSEが実行されます。postImportApplicationSQLフィールドはサポートされていません
インポートの最適化
データベースの論理インポート中に、CloudNativePGは、以下を強制することにより、速度とデータの耐久性を優先するためにPostgreSQLの構成を最適化します。
archive_mode〜offfsync〜offfull_page_writes〜offmax_wal_senders〜0wal_level〜minimal
インポートジョブを完了する前に、CloudNativePGは予想される構成を復元し、initdb --sync-only
を実行してデータがディスクに永続的に書き込まれるようにします。
重要
WALアーカイブ要求された場合、およびデータベースのインポートプロセスが完了した後にWALレベルが受け入れられます。同様に、レプリカはブートストラップフェーズの後に、実際のクラスターリソースが開始されるときにクローン作成されます。
インポートフェーズ中に実行できる最適化は他にもあります。このトピックはCloudNativePGの範囲を超えていますが、
Cluster 構成でshared_buffers 、max_wal_size
、checkpoint_timeout などのPostgres
GUCを直接調整することにより、チェックポイント領域への不要な書き込みを削減することをお勧めします。
pg_dump およびpg_restore の動作のカスタマイズ
pgDumpExtraOptions およびpgRestoreExtraOptions
パラメーターを使用して追加オプションを指定することにより、pg_dump
およびpg_restore
の動作をカスタマイズできます。たとえば、次の例に示すように、パラレルジョブを有効にしてデータのインポート/エクスポートプロセスを高速化できます。
#  <snip>

bootstrap:
  initdb:
    import:
      type: microservice
      databases:
        - app
      source:
        externalCluster: cluster-example
      pgDumpExtraOptions:
        - "--jobs=2"
      pgRestoreExtraOptions:
        - "--jobs=2"

#  <snip>
警告
pgDumpExtraOptions および`pgRestoreExtraOptions` フィールドは、自己の責任で注意して使用してください。これらのオプションはオペレーターによって検証または検証されておらず、一部の構成は意図された機能または動作と競合する場合があります。運用に適用する前に、安全で制御された環境で完全にテストしてください。
オンラインインポートとアップグレード
論理レプリケーションは、次のアプローチを使用して、ネットワーク経由でアクセス可能なPostgreSQLデータベースをインポートする強力な方法を提供します。
スキーマのみのオプションを使用したブートストラップのインポート レプリケーションを開始する前に、ターゲットデータベースのスキーマを初期化します。
``Subscription`` リソース 連続レプリケーションを設定してデータ変更を同期します。
この手法は、最小限のダウンタイムでメジャーPostgreSQLのアップグレードを実行するために活用できるため、シームレスな移行とシステムのアップグレードに最適です。
制限やベストプラクティスを含む詳細については、ドキュメントの ロジカルレプリケーションのパブリケーション セクションを参照してください。