Operator Capability Levels
このセクションでは、 Operator SDK definition of Capability Levels フレームワークを使用して分類されたCloudNativePGによって実装される機能の概要を説明します。
Operator Capability Levels
重要
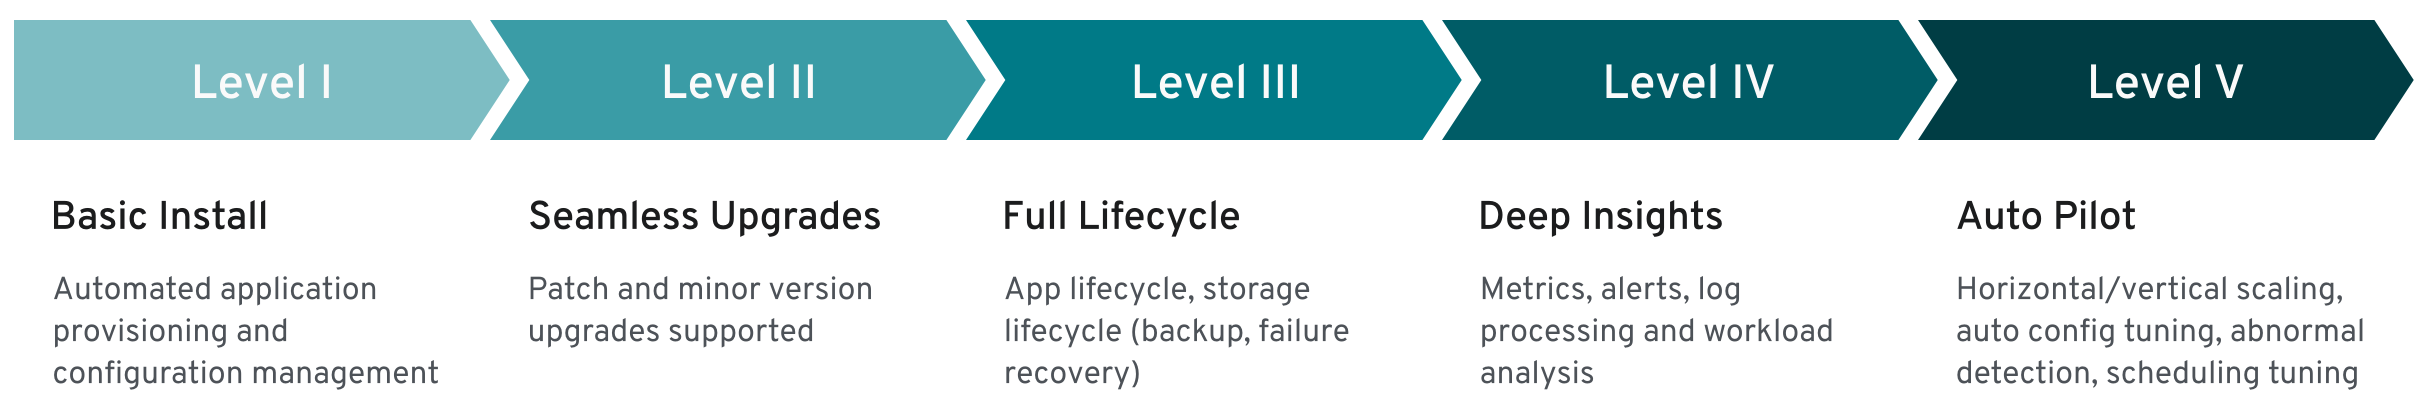
Operator Capability Levels model に基づいて、CloudNativePGオペレーターから**「レベルV-自動パイロット」**機能セットが期待できます。
各機能レベルは、演算子が提供する管理機能の特定のセットに関連付けられています。
1.基本インストール2。シームレスなアップグレード3。フルライフサイクル4。深い洞察5。オートパイロット
注釈
このフレームワークは、演算子の将来の作業と実装のガイドと考えています。
レベル1-基本インストール
機能レベル1には、オペレーターの インストール および 構成 が含まれます。このカテゴリには、操作性やPostgreSQLクラスター構成との対話方法の改善など、使いやすさとユーザエクスペリエンスの向上が含まれます。
重要
このレベルの**情報セキュリティ**パートを考慮します。
宣言的な設定によるオペレーターの展開
演算子は、4つのメジャー CustomResourceDefinition オブジェクト、
Cluster 、 Pooler 、 Backup 、および ScheduledBackup
を定義するKubernetesマニフェストを使用して宣言的にインストールされます。
宣言的設定によるPostgreSQLクラスターの展開
PostgreSQLクラスター(オペランド)は、完全に宣言的な方法で Cluster
カスタムリソースを使用して定義されます。
PostgreSQLのバージョンは、CRで定義されているオペランドコンテナイメージによって決定され、要求されたレジストリから自動的に取得されます。オペランドをデプロイするとき、演算子は次のリソースも自動的に作成します:
Pod 、 Service 、 Secret 、 ConfigMap 、
PersistentVolumeClaim 、 PodDisruptionBudget 、
ServiceAccount 、 RoleBinding 、 Role 。
CRDを介したオペランドイメージのオーバーライド
演算子は、PostgreSQLが内部にあるオペランドコンテナイメージをサポートするように設計されています。デフォルトでは、演算子は、
PostgreSQLがサポートし、
イメージで公開されている最新の安定(stable)メジャーバージョンの最新の利用可能なマイナーバージョンを使用します。
/ CRで imageName
attributeを設定して直接スタンバイアーキテクチャ。演算子は、コンテナイメージの不変性をより細かく制御するためのタグに加えて、プライベートコンテナレジストリにアクセスするための
imagePullSecrets もサポートしています。
ラベルと注釈
演算子は、KubernetesインフラストラクチャでのCloudNativePG展開の組織を改善する目的で、クラスターのメタデータで定義されたラベルと注釈の継承をサポートするように構成できます。
自己完結型のインスタンスマネージャ
PatroniやStolonなどの外部ツールに依存してKubernetesクラスターポッド内のPostgreSQLインスタンスを調整する代わりに、オペレーターは各ポッド内で、
/controller/manager
という名前のファイルで演算子実行可能ファイルを注入します。このアプリケーションは、基盤となるPostgreSQLインスタンスを制御し、
PostgreSQLクラスタートポロジに基づいてポッドのステータスをインスタンス自体と調整するために使用されます。インスタンスマネージャは、プローブ用に
kubelet によって呼び出されるWebサーバーも起動します。 kubelet
によって呼び出されたUnixシグナルは、インスタンスマネージャによってフィルター処理され、必要に応じて
postgres
プロセスに転送され、外部イベントに対する高速で制御された反応が行われます。インスタンスマネージャはGoで記述されており、外部依存関係はありません。
ストレージ構成
ストレージは、データベースワークロードの重要なコンポーネントです。ストレージに関して、Kubernetesのネイティブ機能とリソースを活用することで、オペレーターは、基盤となるKubernetes環境が提供できるものに基づいて、ワークロード要件に適したストレージを選択するのに十分な柔軟性を提供します。これは、パブリッククラウド環境で特定のストレージクラスを選択すること、または生成されたPVCをCRのストレージパラメータのPVCテンプレートを介して微調整することを意味しデータベース。
レプリカ構成
演算子は、 instances
という単一のパラメータを使用して、クラスター内のレプリカを自動的に検出します。
1
に設定すると、クラスターはレプリカなしの単一のプライマリPostgreSQLインスタンスで構成されます。
1
よりも高い場合、演算子は、自動フェイルオーバーによる高可用性やスイッチオーバー操作によるローリング更新など、
instances -1 レプリカを管理します。
データベース設定
演算子は、単一のデータベースでPostgreSQLクラスターを管理するように設計されています。演算子は、読み書き、読み取り、ユーザ専用のワークロード用に自動的にプロビジョニングおよび管理される3つのデフォルトPostgresを通じて、データベースへのアクセスを透過的に管理し演算子。同じ名前。必要に応じて、データベース名前とユーザ名前の両方を指定できます。クラスターの実行に構成は必要ありませんが、CRの
postgresql セクションでPostgreSQL実行時構成とPostgreSQL
Host-BasedAuthenticationルールの両方をカスタマイズできます。
ポッドセキュリティポリシー
InfoSec要件の場合、演算子はどのコンテナーに対しても特権モードを必要とせず、読み取り専用ルートファイルシステムを適用して、演算子とオペランドポッドの両方に対してコンテナーの不変性を保証します。また、必要なセキュリティコンテキストを明示的に設定します。
アフィニティ
クラスターの affinity
セクションでは、ポッドおよび永続的なボリュームなどの関連リソースをaKubernetesクラスターのノード全体でスケジュールする方法を微調整できます。特に、演算子は以下をサポートします。
ポッドアフィニティとアンチアフィニティ
ノードセレクター
汚染と許容
コマンドラインインタフェース
CloudNativePGには独自のコマンドラインインタフェースはありません。PostgreSQLクラスタ管理エクスペリエンスを強化および簡素化するために、
cnpg
と呼ばれるプラグインを提供することにより、Kubernetesの最適なコマンドラインインタフェース
kubectl に依存しています。
クラスターの現在のステータス
演算子は、CRの状況セクションをクラスターの監視状況で継続的に更新します。
PostgreSQLクラスター全体のステータスは、各ポッドで実行されているインスタンスマネージャによって継続的に監視されます:インスタンスマネージャーは、制御されたPostgreSQLインスタンスに必要な変更を適用して、クラスターの必要なステータスに収束するマネージャがあります(例、クラスターステータスがポッド
-1 であると報告した場合プライマリ、ポッド -1
は自分自身をプロモートニーズがあり、他のポッドはポッド -1
をフォローする必要があります。 kubectl の cnpg
プラグインは、同じステータスを使用して詳細を提供します。
オペレーターの認証権限
演算子は、自分自身の証明権限を自動的に作成しますAPIサーバーと演算子自分自身の間の安全な通信を保証に、Webhookサーバーが使用するリーフ証明書を作成し、演算子証明権限と署名します。
クラスターの証明権限
演算子は、すべてのPostgreSQLclusterに対して証明権限を自動的に作成します。これは、パスワードの代わりにストリーミングレプリケーションスタンバイサーバを含むクライアントの認証用にTLS証明権限を発行および更新するために使用されます。
cert-managerとの統合も含まれます。証明書は、 kubectl の cnpg
プラグインで発行できます。
TLS接続
演算子は、TLS / SSL接続を透過的かつネイティブにサポートして、クラスターの証明権限を使用してセキュリティを強化するためのクライアント/サーバー通信を暗号化します。カスタムサーバ証明書のサポートは、シークレットを介して利用できます。
ストリーミングレプリケーションの証明書認証
演算子は、パスワード(およびそのための秘密)に頼るのではなく、TLSクライアント証明書認証に依存して、スタンバイサーバからのストリーミングレプリケーション接続を承認します。
継続的な構成管理
演算子を使用すると、 PostgreSQL設定の Cluster
リソースYAMLセクションに変更を適用し、設定オプションに応じてすべてのインスタンスが適切にリロードまたは再起動されるようにすることができます。現在の制限:
ALTER SYSTEM による変更は検出されません。強制されません。
PostgreSQLの基本的なLDAP認証
演算子は、 PostgreSQL documentation: LDAP authentication で説明されているように、* シンプル bind または 検索+ bind *モードを使用して、PostgreSQLクライアントのLDAP認証を構成できます。
複数のインストール方法
演算子は、 kubectlapply
を介してKubernetesマニフェストからインストールでき、パブリックおよびプライベートクラウド環境での従来のKubernetesインストールで使用できます。さらに、演算子のヘルムチャートも利用できます。
設定より規約
演算子は、構成パラダイムに関する規則をサポートし、標準のデフォルト値を決定すると同時に、それらをオーバーライドしてカスタマイズすることもできます。いくつかのYAMLコード行で
Cluster CRDを使用して、
PostgreSQLクラスターのデプロイメントを指定できます。
レベル2-シームレスなアップグレード
機能レベル2とは、 演算子と実際のワークロード (この場合はPostgreSQLサーバー)の更新を有効にすることです。これには、 PostgreSQLマイナーリリース更新 (通常はセキュリティおよびバグ修正)および メジャーオンラインアップグレード が含まれます。
演算子のアップグレード
新しい展開として演算子をシームレスにアップグレードできます。演算子の変更は、オペランドの変更を必要としません-instancemanagerのインジェクションのおかげです。演算子は、古いバージョンのオペランドを管理できます。
CloudNativePGは、演算子のアップグレード後に インスタンスマネージャのインプレース更新 もサポートします。インプレース更新では、クラスターのローリング更新(およびその後のスイッチオーバー)は不要です。
管理対象ワークロードのアップグレード
オペランドは、CR、特に imageName
パラメータの変更の一環として、宣言的な構成アプローチを使用してアップグレードできます。オペレーターは、
PostgreSQLのメジャーアップグレードを防止し、メジャーバージョン内のマイナーPostgreSQLリリースの両方の方向に進むことを可能にします(更新とロールバックを有効にします)。
スタンバイサーバが存在する場合、演算子は既存のポッドをドロップし、基になるストレージを再利用する新しい要求されたオペランドイメージで新しいポッドを作成することにより、レプリカからローリング更新を実行します。
primaryUpdateStrategy
の値に応じて、演算子はスイッチオーバーを続行します以前のプライマリ(
unsupervised )を更新するか、 kubectl の cnpg
プラグインを介してユーザがスイッチオーバープロシージャ( supervised
)を手動で発行するのを待機します。実際のデータベースワークロードに基づきます。
アップグレード中にクラスターの可用性ステータスを表示する
いつでも、例、 Setting up primary 、 Creating a new replica 、
Cluster in healthy state 、 Switchover in progress 、
Failing over 、 Upgrading cluster
など、クラスターの高可用性ステータスを伝えます。
レベル3-完全なライフサイクル
機能レベル3では、演算子が ビジネス継続性 および スケーラビリティ の側面を管理する必要があります。 災害リカバリ は、データベースのバックアップとリカバリの両方が正しく機能することを必要とするビジネス継続性コンポーネントです。出発点としての目標はRPO <5分を達成することですが、長期的な目標はRPO = 0バックアップソリューションを実装することです。 高可用性 は、 PostgreSQLのネイティブ物理レプリケーションとホットスタンバイレプリカを介して、演算子がフェールオーバーおよびスイッチオーバー操作を実行できるようにするビジネス継続性のもう1つの重要コンポーネントです。この領域には、次の機能強化が含まれます。
同期レプリケーションなどのPostgreSQL物理的レプリケーションの制御、 (カスケード)レプリケーションクラスターなど。
コネクションプーリング、を介してパフォーマンスと制御を改善します pgBouncerによるコネクションプーリングレイヤー。
PostgreSQLバックアップ
演算子は、物理ベースバックアップと連続WALアーカイビングに基づくPostgreSQLのネイティブ連続バックアップテクノロジーを使用して、アプリケーションレベルのバックアップを提供するように設計されています。具体的には、演算子は現在、オブジェクトストア(AWS S3およびS3互換、Azure Blob Storage、Google Cloud Storage、MinIOなどのゲートウェイ)のバックアップのみをサポートしています。
WALアーカイビングとベースバックアップは、S3プロトコルの宛先URL(例、AWS
S3バケット内の特定のフォルダーを指す)を指定することにより、クラスターレベルで宣言的にクラスター定義で
backup
パラメータを介して定義され、オプションで汎用エンドポイントURL。連続バックアップの前提条件であるWALアーカイビングでは、ユーザからのさらなるアクションは不要です。演算子は、
archive_command を自動的かつ透過的に設定し、
barman-cloud-wal-archive
に依存してWALfilesを定義されたエンドポイントに送信します。ユーザーは、圧縮アルゴリズム、およびアーカイブ内のWALファイルを同時にアップロードする並列ジョブの数を決定できます。それに加えて、
Instance Manager は、最初のWALファイルセットの出荷を開始する前に
barman-cloud-check-wal-archive
コマンドを実行することにより、アーカイブ先の正確性を自動的にチェックします。
ベースバックアップは、オンデマンド( Backup
customリソース定義を使用)またはスケジュール(cronのような構文を使用して
ScheduledBackup
customerリソース定義を使用)の2つの方法で定義できます。これらは両方とも、ジョブのon
barman-cloud-backup (applicationcontainer
イメージのパートとして配布されます)を使用して、WALファイルとともに同じエンドポイントでバックアップをリレーします。
barman-cloud-wal-restore と barman-cloud-backup は両方とも、 GNU
GPL 3の条件の下でアプリケーションコンテナーイメージに配布されます。
バックアップからの完全な復元
演算子を使用すると、 barman-cloud-backup
を使用して取得された既存のアクセス可能なバックアップから開始して、新しいクラスターを(設定とともに)ブートストラップできます。ブートストラッププロセスが完了すると、演算子はリカバリモードでインスタンスを開始し、指定されたアーカイブから利用可能プライマリすべてのスタンバイファイルを再生し、リカバリを終了してプライマリとして開始します。アーカイブから取得するWAL。
バックアップからのポイントインタイムリカバリ(PITR)
演算子を使用すると、 タイムスタンプ、alabel、またはトランザクションIDで定義された特定の時点に既存のバックアップを回復することにより、新しいPostgreSQLクラスターを作成できます。この機能は、完全なrestoreoneの上に構築され、 PostgreSQL for PITR で利用可能なすべてのオプションをサポートします。
同期レプリケーションによるゼロデータ損失クラスター
クォーラムベースの同期レプリケーションサポートにより、ローカルの高可用性CloudNativePGclusterでゼロデータ損失(RPO
=
0)を達成します。演算子は、いつでも利用可能な予想される同期的スタンバイレプリカの最小数と最大数を制御する2つの構成オプションを提供します。演算子は、クォーラムの次の式(
q
)を使用して、クラスター内の使用可能なPostgreSQLインスタンスの数に基づいて、それに応じて反応します。
1 <= minSyncReplicas <= q <= maxSyncReplicas <= readyReplicas
レプリカクラスター
PostgreSQLネイティブストリーミングとカスケーディングレプリケーションの利点を活用して、
PostgreSQLクラスターのクロスKubernetesクラスタートポロジを定義します。
replica
オプションを使用して、独立したクラスターをセットアップし、同じメジャーバージョンの別のPostgreSQLソースからのデータを継続的に複製できソース。
TLSを介した直接ストリーミング接続が2つのエンドポイントから許可されている限り、ソースはKubernetesの外部でも、物理的環境または仮想環境で実行できます。レプリカクラスターは、リカバリオブジェクトストア(BarmanCloudフォーマットのバックアップ)から作成できます。
pg_basebackup を介したストリーミング経由。レプリカクラスターは、
ストリーミングでのPostgreSQLデータベースのビジネス継続性を劇的に改善し、マルチプルのファイルセンターにまたがり、ハイブリッドおよびマルチクラウドのセットアップを可能にします(現在、Kubernetesを待機している間に、データセンター間のマニュアル切り替えが必要です)フェデレーション機能)。
活性と準備のプローブ
演算子は、PostgresContainersの活性プローブと準備プローブを定義します。これらのプローブは、kubeletによって呼び出されます。これらはそれぞれ、インスタンスマネージャによって直接管理されるウェブサーバの
/healthz および /readyz
エンドポイントにマッピングされます。livenessプローブは、 pg_isready
実行可能ファイルに基づいており、ポッドは終了コード0(サーバーは正常に接続を受け入れています)および1(サーバーは拒否しています)接続、例スタートアップ中)。準備状況プローブは、シンプルクエリー(
;
)を発行して、サーバーが接続を受け入れる準備ができていることを確認します。
ローリング展開
演算子はローリング展開をサポートしてダウンタイムを最小限に抑え、PostgreSQLクラスターが公開されている場合、サービスは初期化または更新中に読み取り専用トラフィックを利用可能なポッドにのみ負荷分散します。
レプリカのスケールアップとスケールダウン
演算子を使用すると、PostgreSQLクラスター内のインスタンスの数を増減できます。新しいレプリカはプライマリサーバーから自動的に起動され、クラスターのHAインフラストラクチャに参加します。CRDは、ユーザが
kubectl scale
コマンドを使用できるようにする「スケール」サブリソースを宣言します。
KubernetesノードのメンテナンスウィンドウとPodDisruptionBudget
演算子は、 PodDisruptionBudget
リソースを作成して、同時中断の数を1つのプライマリインスタンスに制限します。この構成により、メンテナンスオペレーションでクラスター内のすべてのポッドが削除されなくなり、指定された数のインスタンスを作成できます。ノードのドレインオペレーション中にPodDisruptionBudgetが適用され、クラスターサービスの中断を防ぎます。
この戦略は、ストレージがすべてのワーカーノード間で共有されるKubernetesクラスターには正しいものですが、ローカルストレージを使用するクラスターやプライベートクラウドにインストールされたクラスターには最適なソリューションではない場合があります。演算子を使用すると、メンテナンスウィンドウを指定し、基になるノードの排除に対する反応を設定できます。メンテナンスウィンドウセクションの
ReusePVC
オプションを使用して、使用する戦略を指定できます。削除されたインスタンスに別のPVCに新しいストレージを割り当てるか、基になるノードが再び使用可能になるまで待機します。
フェンシング
フェンシングは、 PostgreSQLクラスターの1つ、複数、またはすべてのインスタンスが誤動作してPostgreSQLように見える場合に、それらのインスタンスのデータを保護するサーバプロセスです。これにより、フェンスが解除されるまで、ポッドのデータはPostgreSQLによって変更されず、ファイルシステムをデバッグおよびトラブルシューティングの目的で調査できるようになります。
ポッドでの永続ボリュームストレージの再利用
演算子がユーザによって削除されたポッドを作成するニーズがある場合、またはKubernetesメンテナンスオペレーションによって削除されたポッドを作成する必要がある場合、可能であれば、
PersistentVolumeClaim
を再利用し、プライマリからデータを再クローンする必要を回避します。
CPUとメモリのリクエストと制限
演算子により、管理者は、マニフェストの resources
セクションを使用して、クラスターのポッドによるリソース使用を制御および管理できます。特定の
requests と limits の値は、CPUとRAMの両方に設定できます。
PgBouncerを使用した接続プーリング
CloudNativePGは、 PostgreSQLの最も一般的なオープンソース接続プーラーの1つである PgBouncerIntegrationStatus を使用したコネクションプーリングのネイティブサポートを提供します。アーキテクチャのビューから、PgBouncerコネクションプーラの一般的な実装は、インスタンスへのクエリーフローを最適化し、基になるPostgreSQLリソースの使用をより効率的にするデータベースにアクセスするための新しいレイヤーを導入しますPostgreSQLサービスに直接接続する代わりに、アプリケーションこれでPgBouncerサービスに接続し、既存の接続の再利用をスタートできます。
レベル4-深い洞察
機能レベル4は、 監視可能性 :特に、モニタリング、アラート、トレンド、ログ処理です。これには、Prometheus、Grafana、Fluent Bitなどの外部ツールの使用、およびJSONフォーマットでエラーログを直接出力するためのPostgreSQLエンジンの拡張が含まれる場合があります。
CloudNativePGは、柔軟なモニタリングとロギングのための業界標準およびコミュニティで受け入れられているツールと簡単に統合するために必要なすべてを提供するように設計されています。
設定可能なクエリを備えたPrometheusエクスポーター
インスタンスマネージャはプラガブルフレームワークを提供し、 metrics
ポート(9187)でリスニングする独自のWebサーバーを介して、
モニタリングモニタリングおよびアラートツールのメトリックをエクスポートするエンドポイントを公開します。演算子は、
オープンソースと互換性のある構文プロジェクトは、コンテキストに統合および適応できるPostgreSQLの基本的なモニタリングクエリのセットを提供します。いくつかの基本的な指標とダッシュボードの例を提供します。
JSONフォーマットのPostgreSQLエラーメッセージの標準出力ロギング
すべてのログメッセージは、標準のPostgreSQLエラーメッセージチャネルの
postgres
など、タイムスタンプ、ログレベル、ログエントリーのタイプの最初のレベル定義とともに、
JSONフォーマットで標準出力に配信されます。その結果、CloudNativePGによって管理されるすべてのPodはソースデータ型としてJSONをサポートするダウンストリームログ処理スタックと簡単かつ直接統合できます。
リアルタイムのクエリーモニタリング
CloudNativePGは透過的かつネイティブに以下をサポートします。
必須の :ref:``pg_stat_statements` を有効にする<pg_stat_statements を有効にする>` 、 すべてのSQLの計画および実行統計の追跡を可能にします PostgreSQLサーバーによって実行されるステートメント。
:ref:``auto_explain` を有効にする<auto_explain を有効にする>` 、
遅いステートメントの実行計画をロギングする手段を提供します
EXPLAINを手動で実行することなく、自動的に(追跡に役立ちます 最適化されていないクエリ)。
監査
CloudNativePGを使用すると、データベースおよびセキュリティの管理者、監査者、オペレーターはPGAudit(forPostgreSQL)を使用してデータベースアクティビティを追跡および分析できます。このようなアクティビティはJSONログに直接フロー、Fluentdなどの一般的なログブローカーを使用して適切なダウンストリームターゲットに適切にルーティングできます。
Kubernetesイベント
リソースの作成、ノードの削除、アップグレード処理など、Kubernetes
APIが期待するメジャーイベントを記録します。イベントは、
kubectl describe および kubectl get events
コマンドを使用して表示できます。
レベル5-オートパイロット
機能レベル5は、観測可能性レイヤーから出現した異常と洞察の発見を通じて、 自動スケーリング 、 修復 、 チューニング に焦点を当てています。
自己修復のための自動フェイルオーバー
プライマリで障害が検出された場合、演算子は、最も整合したレプリカを新しいターゲットプライマリとして設定することにより、クラスターのステータスを変更します。結果として、各アライブポッドのインスタンスマネージャは、新しいプライマリになるか、それに従うことにより、クラスターの要求されたステータスに合わせて必要な手順を開始し自分自身。前のプライマリが復旧した場合、同じメカニズムはアプリケーションからのアクセスを防ぎ、サーバーで
pg_rewind
を実行し、スタンバイとして再起動することにより、asplit-brain。
スタンバイの自動作成
スタンバイをホスティングしているポッドが取り外された場合、演算子はスタンバイサーバを再作成するプロシージャを開始します。