Operator capability levels
これらの機能はCloudNativePGによって実装され、 Operator SDK definition of Capability Levels を使用して分類されました
フレームワーク。
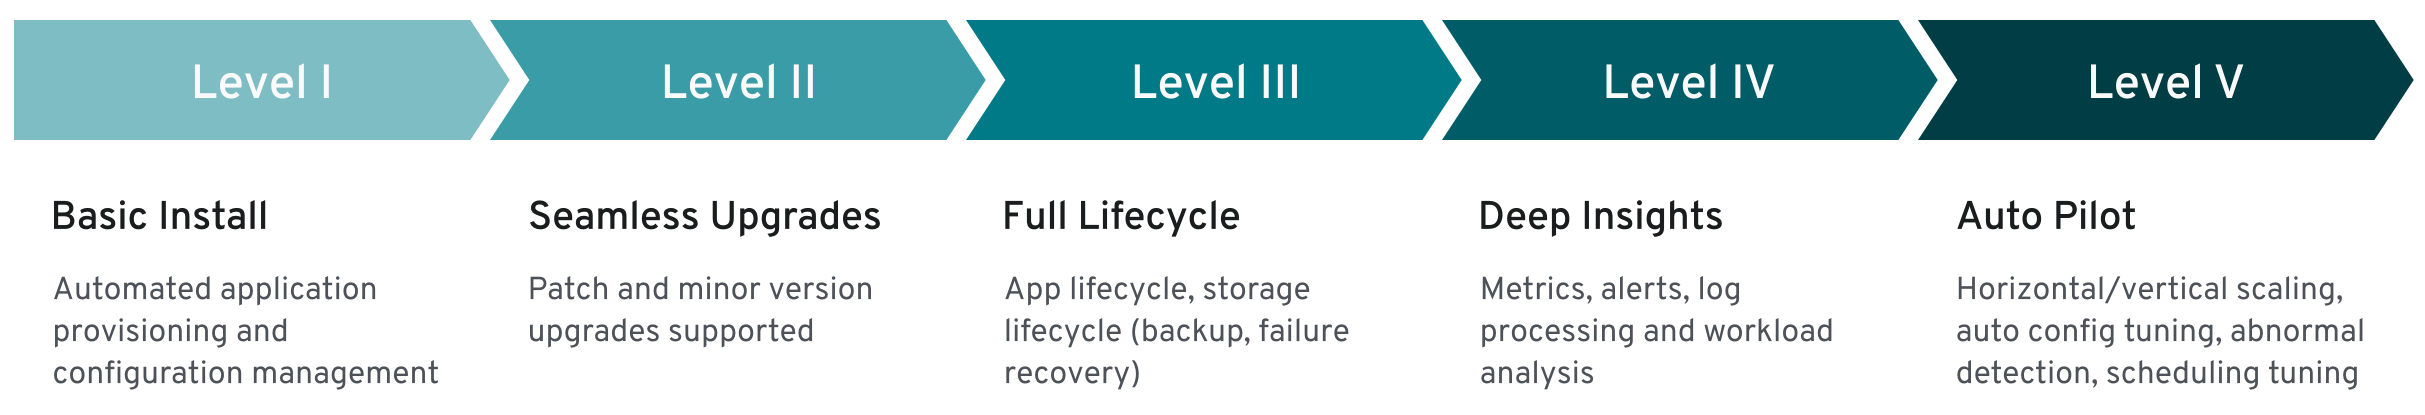
Operator Capability Levels
注釈
Operator Capability Levels model に基づいて、CloudNativePGオペレーターからの「レベルV - 自動パイロット」機能セットを期待できます。
各機能レベルは、オペレーターが提供する特定の管理機能のセットに関連付けられています。
基本的なインストール
シームレスなアップグレード
完全なライフサイクル
深い洞察
オートパイロット
注釈
私たちは、このフレームワークを、オペレーターでの将来の作業と実装のガイドと考えます。
レベル1 基本インストール
機能レベル1には、オペレーターのインストールと構成が含まれます。このカテゴリには、オペレーターやPostgreSQLクラスター構成との対話方法の改善など、使いやすさとユーザーエクスペリエンスの強化が含まれています。
注釈
情報セキュリティはこのレベルの一部であると考えられます。
宣言的構成を介したOperatorの展開
オペレーターは、PostgreSQLライフサイクルの管理に必要なコアCustomResourceDefinition
オブジェクトを定義するKubernetesマニフェストを使用して、宣言的な方法でインストールされます。これらには次のものが含まれます。
構成とトポロジ
Cluster、Pooler、ImageCatalog、およびClusterImageCatalog。IDとスキーマ
DatabaseRoleおよびDatabase。事業継続性
Backup、ScheduledBackup、Publication、およびSubscription。ランタイムオーケストレーション
FailoverQuorum自動フェイルオーバー中にコンセンサスのためにオペレーターが使用します。
宣言的構成を介したPostgreSQLクラスターの展開
Cluster
カスタムリソースを使用して、完全な宣言的方法でPostgreSQLクラスターオペランドを定義します。
PostgreSQLバージョンは、CRで定義されたオペランドコンテナイメージによって決定されます。これは、要求されたレジストリから自動的に取得されます。
オペレーターは、標準のKubernetesリソースPod 、Service
、Secret 、ConfigMap 、PersistentVolumeClaim
、PodDisruptionBudget 、ServiceAccount 、RoleBinding
、およびRole
を作成および管理することにより展開を調整し、Database
やedb_などのユーザー定義のCNPGリソースを調整してデータベース1環境1目的の状態と一致します。
オプションで、 Cluster とPooler
リソースの両方に既存のサービスアカウントを提供できます。この共有ServiceAccountサポートにより、クラウドネイティブのIDプロバイダーとのシームレスな統合が可能になり、クラスターごとではなくインフラストラクチャレベルでIAMロールと権限を管理できます。
CRDを介したオペランドイメージのオーバーライド
オペレーターは、PostgreSQLを含むオペランドコンテナイメージをサポートしています。
ghcr.io
では、最新のコミュニティでサポートされているメジャーバージョンの最新の安定したマイナーバージョンがデフォルトですが、
Cluster リソースで.spec.imageName
属性を設定することにより、これをオーバーライドできます。このダイレクト方法は、プライベートレジストリのimagePullSecrets
をサポートし、タグとSHA256ダイジェストの両方を使用してコンテナの不変性を保証します。
または、 image catalogs を活用して、PostgreSQLメジャーバージョンを参照するだけで、イメージをより効果的に管理できます。このアプローチは、イメージサプライチェーンの管理を一元化するため、実稼働環境に優れています。
コアのPostgreSQLエンジンを超えて、イメージカタログでオペランドイメージとともに extension volumes を定義できるようになりました。これにより、データベースとその関連モジュールが常に互換性があり、バージョンが調整され、インフラストラクチャ全体で単一の凝集ユニットとして扱われることが保証されます。同じカタログメカニズムが PgBouncerIntegrationStatus も管理します
プーラーイメージ、イメージカタログを、オペレーターが管理するPostgreSQLスタック全体にわたる統合されたサプライチェーンプリミティブにします。
ラベルとアノテーション
クラスターのメタデータで定義されたラベルとアノテーションの継承をサポートするようにオペレーターを構成できます。目標は、KubernetesインフラストラクチャでのCloudNativePG展開の構成を改善することです。
自己完結型インスタンスマネージャー
PatroniやStolonなどのKubernetesクラスターポッド内のPostgreSQLインスタンスを調整する外部ツールに依存する代わりに、オペレーターは各ポッド内の/controller/manager
という名前のファイルにオペレーター実行可能ファイルを注入します。アプリケーションは、基になるPostgreSQLインスタンスを制御し、PostgreSQLクラスタートポロジに基づいてインスタンスとポッドステータスを調整するために使用されます。インスタンスマネージャーは、プローブのkubelet
によって呼び出されるWebサーバーも起動します。 kubelet
によって呼び出されるUnixシグナルは、インスタンスマネージャーによってフィルタリングされます。必要に応じて、それらはpostgres
プロセスに転送され、外部イベントに対する高速で制御された反応が行われます。インスタンスマネージャーはGoで書かれており、外部依存関係はありません。
ストレージ構成
ストレージは、データベースワークロードの重要なコンポーネントです。オペレーターは、ストレージに関するKubernetesのネイティブ機能とリソースを利用して、基になるKubernetes環境が提供できるものに基づいて、ワークロード要件に適切なストレージを選択するための十分な柔軟性を提供します。これは、パブリッククラウド環境で特定のストレージクラスを選択するか、CRのstorage
パラメーターのPVCテンプレートを介して生成されたPVCを微調整することを意味します。
パフォーマンスの向上とより詳細な制御のために、クラスターのログ先行書き込みWAL、pg_wal
としても知られるを別のボリューム、できれば別のストレージでホストすることを選択することもできます。ドキュメントの Benchmarking セクションでは、運用前にストレージとデータベースの両方をベンチマークする方法の詳細な手順を提供します。
cnpg
プラグインに依存して、最適なパフォーマンスと信頼性を保証します。
レプリカ構成
オペレーターは、instances
と呼ばれる単一のパラメーターを介してクラスター内のレプリカを検出します。
1
に設定されている場合、クラスターは、レプリカのない単一のプライマリPostgreSQLインスタンスで構成されます。
1
より高い場合、オペレーターは自動フェイルオーバーを介した高可用性HA、スイッチオーバー操作を介したローリング更新を含むinstances -1
レプリカを管理します。
CloudNativePGは、高可用性クラスター内のすべてのレプリカのレプリケーションスロットを管理します。また、プライマリでユーザー定義の物理レプリケーションスロットをサポートし、論理デコードフェイルオーバーを有効にします。PostgreSQL
17以降ではネイティブにsync_replication_slots
を使用し、以前のバージョンの場合はpg_failover_slots
拡張機能を介して。
サービス構成
デフォルトでは、CloudNativePGは3つのKubernetes ManagedServices を作成します
アプリケーションがネットワークを介してクラスターにアクセスする場合
読み取り/書き込み操作のプライマリを指すもの。
読み取り専用クエリーのレプリカを指すもの。
読み取り操作のインスタンスを指す汎用的なもの。
構成を介して読み取り専用および読み取りサービスを無効にできます。さらに、サービステンプレート機能を活用して、ロードバランサーを含むカスタムサービスリソースを作成し、Kubernetes外部のPostgreSQLにアクセスできます。これは、DBaaSの目的で特に役立ちます。
ポッドセレクターを介した動的なネットワークアクセス制御
CloudNativePGは、 podSelectorRefs
の宣言定義をサポートして、pg_hba.conf
ルールを動的に管理します。ラベルセレクターを使用してクライアントポッドを識別することにより、オペレーターは自動的にエフェメラルIPアドレスを解決し、それに応じてPostgreSQLホストベースの認証ルールを更新します。これにより、同じ名前空間内の許可されたワークロードのみがデータベースに接続できるようになり、手動のIP管理または静的CIDRレンジが必要なくなります。
データベース構成
オペレーターは、単一のデータベースでPostgreSQLクラスターをブートストラップするように設計されています。オペレーターは、読み取り書き込み、読み取り、および読み取り専用のワークロード用にプロビジョニングおよび管理される3つのKubernetesサービスを介して、クラスターへのネットワークアクセスを透過的に管理します。構成より規約のアプローチを使用して、オペレーターはapp
と呼ばれるデータベースを作成します。デフォルトでは、同じ名前の通常のPostgresユーザーが所有します。必要に応じて、ブートストラップの一部としてデータベース名とユーザー名の両方を指定できます。
Database
CRDを使用して、 declarative database management を介して追加のデータベースを作成または管理できます。拡張機能、スキーマ、外部データラッパーFDW、および外部サーバーもサポートしています。
クラスターを実行するための構成は必要ありませんが、 CRのpostgresql
セクションでPostgreSQLランタイム構成とPostgreSQLホストベースの認証ルールの両方をカスタマイズできます。
Postgresのロール、ユーザー、およびグループの構成
CloudNativePGは comprehensive management of PostgreSQL roles, users, and groups をサポート
2つの宣言的メソッドを介して
DatabaseRoleCRD推奨 きめ細かいライフサイクル管理のためのスタンドアロンリソース。これには、Kubernetesリソースが削除されたときにデータベースロールをドロップするかどうかを定義するdatabaseRoleReclaimPolicyretainまたはdeleteをサポートが含まれています。managedスタンザ より単純な要件の場合、Clusterリソースの.spec.managed.rolesセクション内でロールをインラインで定義できます。
どちらの方法も、ロール属性たとえば login 、superuser
、connectionLimit などの自動調整と、Kubernetes
Secretを介した安全なバージョン化されたパスワード管理を提供します。パスワードはPostgreSQLに送信される前にオペレーター側でSCRAM-SHA-256エンコードされるため、クリアテキスト値がサーバーログまたは拡張機能に到達することはありません。
DatabaseRole
は、オペレーターが自動的に生成および更新するTLSクライアント証明書をさらに要求でき、パスワードなしのcert
認証を有効にします。
Postgres拡張機能の構成
CloudNativePGは、各ポッドに読み取り専用の extension volumes としてマウントすることにより、PostgreSQL拡張機能を管理するための宣言サポートを提供します。バージョン1.29以降、推奨されるアプローチは
ImageCatalogSpec を活用することです。これにより、オペレーターはPostgreSQLバージョンに基づいてイメージ参照とディレクトリパスを自動的に解決できます。イメージボリュームには、extension_control_path
パラメーターPostgreSQL 18以降とImageVolume 機能Kubernetes
1.35以降、またはフィーチャーゲート付き1.33以降が必要です。これらの要件が満たされない場合、拡張子をオペランドイメージに直接含める必要があります。システムで利用可能になると、
アプリケーションデータベースの構成
CREATE EXTENSION SQLライフサイクルを自動化します。
ポッドのセキュリティ標準
InfoSec要件の場合、オペレーターはコンテナに特権モードを必要としません。読み取り専用のルートファイルシステムを適用して、オペレーターとオペランドの両方のポッドのコンテナの不変性を保証します。また、必要なセキュリティコンテキストも明示的に設定します。
アフィニティ
クラスターのaffinity
セクションでは、ポッドと永続ボリュームなどの関連リソースをKubernetesクラスターのノード全体でスケジュールする方法を微調整できます。特に、オペレーターは以下をサポートしています。
ポッドのアフィニティとアンチアフィニティ
ノードセレクター
テイントと許容範囲
トポロジスプレッドコンストレイン
クラスターのtopologySpreadConstraints
セクションにより、トポロジ全体でポッドのスケジューリングの追加制御が有効になり、アフィニティとアンチアフィニティが提供できる内容が強化されます。
コマンドラインインターフェイス
CloudNativePGには、独自のコマンドラインインターフェイスがありません。
cnpg
と呼ばれるプラグインを提供することにより、Kubernetesに最適なコマンドラインインターフェイスkubectlに依存しています。このプラグインは、PostgreSQLクラスター管理エクスペリエンスを強化および簡素化します。
クラスターの現在のステータス
オペレーターは、クラスターの観察されたステータスでCRのステータスセクションを継続的に更新します。
PostgreSQLクラスター全体のステータスは、各ポッドで実行されているインスタンスマネージャーによって継続的に監視されます。インスタンスマネージャーは、制御されるPostgreSQLインスタンスに必要な変更を適用して、クラスターの必要なステータスに収束します。たとえば、クラスターステータスがポッド
-1 がプライマリであることをレポートする場合、ポッド -1
は自分自身を昇格させる必要がありますが、他のポッドはポッド -1
に従う必要があります。
オペレーターの認証局
オペレーターは、自分自身の認証局を作成します。 Webhookサーバーが使用するリーフ証明書を作成し、オペレーター認証局で署名します。この証明書は、Kubernetes APIサーバーとオペレーター間の安全な通信を保証します。
クラスターの認証局
オペレーターは、すべてのPostgreSQLクラスターの証明機関を作成します。この認証局は、ストリーミングレプリケーションスタンバイサーバーパスワードの代わりにを含むクライアントの認証のためのTLS証明書を発行および更新するために使用されます。クライアント証明書のカスタム認証局のサポートは、シークレットを介して利用できます。これには、cert-managerとの統合も含まれます。証明書は、kubectlのcnpg
プラグインを使用して発行できます。
TLS接続
オペレーターは、TLS / SSL接続を透過的にサポートし、クラスターの認証局を使用してクライアント/サーバー通信を暗号化し、セキュリティを向上させます。カスタムサーバー証明書のサポートは、シークレットを介して利用できます。これには、cert-managerとの統合も含まれます。
ストリーミングレプリケーションの証明書認証
スタンバイサーバーからのストリーミングレプリケーション接続を承認するために、オペレーターはTLSクライアント証明書認証に依存します。この方法は、パスワードおよびシークレットに依存する代わりに使用されます。
継続的な構成管理
オペレーターを使用すると、PostgreSQL構成のCluster
リソースYAMLセクションに変更を適用できます。構成オプションによっては、すべてのインスタンスが適切にリロードまたは再起動されていることも確認します。
注釈
ALTER SYSTEM による変更は検出されません。つまり、クラスター状態が適用されません。
既存のPostgreSQLデータベースのインポート
オペレーターは、オフライン移行を使用して、既存のPostgresデータベースをKubernetesの新しいCloudNativePGクラスターにインポートする宣言的方法を提供します。同じ機能は、PostgreSQLデータベースのオフラインメジャーアップグレードもカバーしています。オフラインとは、データベースがインポートされるまで、アプリケーションがソースで書き込み操作を停止する必要があることを意味します。この機能は、
initdb
ブートストラップ方法を拡張して、別のPostgreSQLデータベースで使用可能なデータの論理スナップショットを使用して、新しいPostgreSQLクラスターを作成します。このデータは、スーパーユーザー接続を介してネットワークを介してアクセスできます。インポートは、サポートされているPostgresのバージョンからです。これは、操作の一部であるすべてのデータベース、および要求に応じてロールの新しいクラスタープライマリから実行されるpg_dump
およびpg_restore に依存しています。
PostGISクラスター
CloudNativePGは、 PostGISクラスター
地理データベースのオープンソース拡張機能。この拡張機能は、PostgreSQLの最も人気のある拡張機能の1つです。
PostgreSQLの基本的なLDAP認証
オペレーターを使用すると、 LDAP authentication section of the PostgreSQL documentation で説明しているように、 _simplebind_または_search+bind_モードを使用して、PostgreSQLクライアントのLDAP認証を構成できます。
複数のインストール方法
オペレーターは、kubectl apply
を介してKubernetesマニフェストを介してインストールでき、パブリックおよびプライベートクラウド環境での従来のKubernetesインストールで使用できます。
CloudNativePGは、OperatorHub.ioからのHelmチャートまたはOLMバンドルを介したインストールもサポートしています。
構成より規約
オペレーターは、規約より構成パラダイムをサポートし、標準のデフォルト値を決定しながら、オーバーライドおよびカスタマイズができます。数行のYAMLコードでCluster
CRDを使用して、PostgreSQLクラスターのデプロイメントを指定できます。
レベル2 シームレスなアップグレード
機能レベル2は、オペレーターと実際のワークロード、この場合PostgreSQLサーバーの更新を有効にすることに関するものです。これには、PostgreSQLのマイナーリリース更新通常はセキュリティとバグ修正が含まれ、メジャーオンラインアップグレードが含まれます。
オペレーターのアップグレード
オペレーターのアップグレードはシームレスで、新しい展開として実行できます。コントローラをアップグレードした後、展開されたすべてのPostgreSQLクラスターのローリング更新が開始されます。すべてのクラスターを同時に更新するか、時間の経過とともにアップグレードを分散することを選択できます。
インスタンスマネージャーのインジェクションのおかげで、オペレーターのアップグレードにオペランドの変更が必要ないため、オペレーターは古いバージョンを管理できます。
さらに、CloudNativePGは インスタンスマネージャーのインプレース更新 をサポート
オペレーターのアップグレード後。インプレース更新では、ローリング更新またはその後のクラスターのスイッチオーバーは必要ありません。
管理対象ワークロードのアップグレード
オペランドは、 Cluster
リソースを更新することにより、宣言的アプローチを介してアップグレードされます。具体的には
.spec.imageName パラメーターを介して、または
イメージカタログを使用する のバージョン参照を更新します。このプロセスは、通常、セキュリティパッチまたは新しいPostgreSQLマイナーバージョンによってトリガーされます。スタンバイサーバーを使用するクラスターでは、オペレーターはレプリカから開始してローリング更新を実行します。既存のポッドを削除し、基になるストレージを再利用しながら、更新されたイメージを使用して新しいポッドに置き換えます。
primaryUpdateStrategy
によっては、オペレーターは元のプライマリunsupervised
を更新する前にスイッチオーバーを自動的に実行するか、cnpg
プラグインsupervised
を介してユーザーが開始する手動スイッチオーバーを待機できます。この戦略により、組織は、スイッチオーバーに必要なワークロードに応じて数秒から分の範囲の短いダウンタイムと、ビジネス要件のバランスを保つことができます。
PostgreSQLのオフラインインプレースメジャーアップグレード
CloudNativePGは、より高いPostgreSQLメジャーバージョンを使用した新しいオペランドコンテナイメージが適用される場合、宣言的オフラインインプレースメジャーアップグレードをサポートします。このアップグレードは、
.spec.imageName
を直接更新することにより、またはイメージカタログ内の新しいメジャーバージョンを選択することによりトリガーできます。イメージカタログの使用は、関連する extension volumes が新しいPostgreSQLメジャーバージョンと互換性のあるバージョンに同時に更新されるため、特に有益です。
プロセス中に、オペレーターはすべてのクラスターポッドをシャットダウンしてデータの一貫性を維持し、ジョブを開始してアップグレード条件を検証し、pg_upgrade
を実行します。このジョブは、レプリカを再作成する前に、PGDATA
、WALファイル、およびテーブルスペースに必要な新しいディレクトリを作成します。この構造化されたワークフローは、メジャーバージョン移行の信頼できるパスを提供し、ユーザーが障害後にイメージを元に戻したときの自動ロールバッククリーンアップをサポートします。イメージボリューム拡張機能を使用するクラスターもサポートされています。ソースバージョンとターゲットバージョンの拡張イメージは、アップグレードジョブ中にサイドバイサイドでマウントされるため、古いサーバーはライブラリを保持し、失敗したアップグレードはきれいに元に戻ります。
アップグレード中にクラスターの可用性ステータスを表示する
任意の時点で、クラスターの高可用性ステータスたとえば、
Setting up primary 、Creating a new replica
、Cluster in healthy state 、Switchover in progress
、Failing over 、Upgrading cluster
、およびUpgrading Postgres major version などを伝えます。
レベル3完全なライフサイクル
機能レベル3では、オペレーターはビジネスの継続性とスケーラビリティの側面を管理する必要があります。
_ディザスターリカバリー_は、データベースのバックアップとリカバリーの両方が正常に動作することを必要とするビジネス継続コンポーネントです。出発点として、目標は RPO < 5分を達成することですが、長期的な目標はRPO=0のバックアップソリューションを実装することです。 _高可用性_は、ビジネス継続性のもう1つの重要なコンポーネントです。 PostgreSQLネイティブ物理レプリケーションとホットスタンバイレプリカを介して、オペレーターはフェールオーバーとスイッチオーバー操作を実行できます。この領域には、次の機能の強化が含まれます。
同期レプリケーション、カスケードレプリケーションクラスターなどのPostgreSQL物理レプリケーションの制御
接続プーリング、pgBouncerを使用した接続プーリングレイヤーを介してパフォーマンスと制御を向上させます
PostgreSQL WALアーカイブ
オペレーターは、オブジェクトストアAWS S3およびS3互換、Azure Blob Storage、Google Cloud Storage、およびMinIOのようなゲートウェイへのWALファイルのPostgreSQL継続的アーカイブをサポートしています。
WALアーカイブは、クラスター定義のbackup
パラメーターを介して、クラスターレベルで宣言的に定義されます。これは、S3プロトコルの宛先URLたとえば、AWS
S3バケットの特定のフォルダーをポイントするなど、オプションで汎用エンドポイントURLを指定することにより実行されます。
継続的バックアップの前提条件であるWALアーカイブには、それ以上のユーザーアクションは必要ありません。オペレーターは、barman-cloud-wal-archive
に依存してWALファイルを定義されたエンドポイントに出荷するようにarchive_command
を透過的に設定します。圧縮アルゴリズムと、アーカイブ内のWALファイルを同時にアップロードする並列ジョブの数を決定できます。さらに、
Instance Manager は、WALファイルの最初のセットの出荷を開始する前に
barman-cloud-check-wal-archive
コマンドを実行して、アーカイブの宛先の正しさをチェックします。
PostgreSQLのバックアップ
CloudNativePGは、 PostgreSQLのネイティブ物理バックアップメカニズム、つまりベースバックアップと継続的WALアーカイブを使用してアプリケーションレベルのバックアップを管理するためのプラガブルインターフェイスCNPG-Iを提供します。このデザインにより、一貫性とパフォーマンスを保証しながら、柔軟性と拡張性が可能になります。
CloudNativePGコミュニティは、 Barman Cloud Plugin を公式にサポートしています。これにより、オブジェクトストアへの継続的な物理バックアップと、完全なポイントインタイムリカバリPITR機能が可能になります。
CNPG-Iプラグインに加えて、CloudNativePGは、基になるストレージクラスとCSIドライバーでサポートされている場合、Kubernetesボリュームスナップショットを使用したバックアップもネイティブにサポートします。
ベースバックアップは2つの方法で開始できます。
オンデマンド、
Backupカスタムリソースを使用ScheduledBackupカスタムリソースを使用し、cronのようなスケジュール形式でスケジュール
ボリュームスナップショットはKubernetes APIを活用し、速度とストレージ効率の点で非常に大規模なデータベースVLDBに特に効果的です。
ボリュームスナップショットとCNPG-Iベースのバックアップは両方とも以下をサポートしています。
ホットバックアップ PostgreSQLの実行中に取得され、中断を最小限に抑えます。
コールドバックアップ 必要に応じて、PostgreSQLを一時的に停止して、完全に一貫したスナップショットを保証することにより実行されます。
スタンバイからのバックアップ
オペレーターは、データベースの RPO に影響を与えることなく、スタンバイへのベースバックアップのオフロードをサポートします。これにより、標準のデータベース操作のためにプライマリにリソース、特にI/Oを保存できます。
バックアップからの完全な復元
オペレーターを使用すると、ボリュームスナップショット、オブジェクトストア、またはプラグインを介して、既存のアクセス可能なバックアップから新しいクラスターとその設定をブートストラップできます。
ブートストラッププロセスが完了すると、オペレーターはリカバリモードでインスタンスを起動します。指定されたアーカイブから使用可能なすべてのWALファイルを再生し、リカバリを終了してプライマリとして起動します。次に、オペレーターは、要求された数のスタンバイインスタンスをプライマリからクローン作成します。 CloudNativePGは、アーカイブからの並列WAL取得をサポートしています。
バックアップからのポイント インタイム リカバリーPITR
オペレーターを使用すると、既存のバックアップをタイムスタンプ、ラベル、またはトランザクションIDで定義された特定の時点にリカバリーすることにより、新しいPostgreSQLクラスターを作成できます。この機能は、完全なリストアのものの上に構築され、 PostgreSQL for PITR で使用可能なすべてのオプションをサポートしています。
同期レプリケーションを介したゼロデータ損失クラスター
CloudNativePGは、同期レプリケーションとオプションの Failover Quorum クォーラムベースのフェールオーバー を組み合わせることにより、_zero-data-loss
RPO=0_高可用性クラスターを有効にします。任意の時点で使用する必要がある同期スタンバイレプリカの数を定義でき、データが安全な場合にのみフェールオーバーを続行できますレプリケートされました。クォーラムベースと優先度ベースの両方の同期レプリケーションがサポートされており、オペレーターは、耐久性とパフォーマンスの要件に一致するようにsynchronous_standby_names
設定を構成する際に完全な柔軟性を提供します。
レプリカクラスター
ネイティブストリーミングとカスケードレプリケーションの力を利用して、PostgreSQLクラスター用の堅牢なクロスKubernetesクラスタートポロジを確立します。
replica
オプションを使用すると、同じメジャーバージョンの別のPostgreSQLソースからデータを一貫してレプリケートするように自律クラスターを構成できます。
WALファイルを取得するためのWALアーカイブ、または2つのエンドポイント間のTLSを介した直接ストリーミング接続にアクセスできる場合、このソースはどこにでもあります。
特に、ソースのPostgreSQLインスタンスは、物理的設定か仮想設定かにかかわらず、Kubernetes環境の外部に存在できます。
レプリカクラスターは、ボリュームスナップショット、リカバリオブジェクトストアBarman
Cloudバックアップ形式を使用、pg_basebackup
を使用したストリーミングなどのさまざまな方法を介してインスタンス化できます。
WALファイルシッピングとWALストリーミングの両方がサポートされています。レプリカクラスターの展開により、Kubernetes内のPostgreSQLデータベースのビジネス継続体制が大幅に向上し、マルチプルのデータセンターに拡張され、ハイブリッドおよびマルチクラウドのセットアップが促進されます。
Kubernetesフェデレーションネイティブ機能を想定していますが、データセンター間の手動スイッチオーバーは引き続き必要です。
さらに、柔軟性は、プライマリクラスターから意図的に遅延して作成される遅延レプリカクラスターにまで及びます。この意図的な遅延は、誤ったDELETE
またはUPDATE
SQL操作などの意図しないエラーが発生した場合の復旧時間目標 バックアップ頻度とRTO
を最小限に抑えることを目的としています。
分散データベーストポロジ
レプリカクラスターを活用して 分散データベーストポロジ を定義する
さまざまなKubernetesクラスターにまたがるPostgreSQLに対応し、ハイブリッドおよびマルチクラウドの展開を促進します。 CloudNativePGを使用すると、次のような強力な機能を獲得できます。
宣言的プライマリ制御 どのPostgreSQLクラスターがプライマリとして機能するかを簡単に指定します。
シームレスなプライマリスイッチオーバー 現在のプライマリを簡単に降格し、通常は別のリージョンにある別のPostgreSQLクラスターを昇格させます。以前のプライマリを再クローンする必要はありません。
このセットアップは、2つ以上のリージョンにまたがって効率的に動作でき、レプリケーションをオブジェクトストアに完全に依存でき、最大5分のRPO目標リカバリポイントを保証します。この高度な機能はCloudNativePGが独自に提供し、多様な環境にわたって堅牢なデータの完全性と継続性を保証します。
テーブルスペースのサポート
CloudNativePGは、個々の永続ボリュームの宣言的定義を容易にすることにより、PostgreSQLテーブルスペースの堅牢なサポートをシームレスに統合します。この革新的な機能により、さまざまなストレージデバイスにI/O操作を効率的に分散できます。 CloudNativePGは、テーブルスペースの透過的なオーケストレーションを通じて、PostgreSQLデータベースのパフォーマンスとスケーラビリティを強化し、クラウドネイティブ環境で大規模なデータストレージを管理するための合理化され最適化されたエクスペリエンスを保証します。一時テーブルスペースのサポートも含まれています。
カスタマイズ可能なスタートアップ、ライブネス、および準備状況プローブ
CloudNativePGは、Kubernetes
kubeletによって管理されるPostgreSQLコンテナのスタートアップ、ライブネス、および準備状況プローブを構成します。これらのプローブは、インスタンスマネージャーのWebサーバーによって公開される/startupz
、/healthz 、および/readyz
エンドポイントと対話して、ポッドの状態と準備状況をモニタします。
すべてのプローブはデフォルト設定で構成されますが、特定のニーズを満たすように完全にカスタマイズでき、環境やワークロードに合わせて微調整が可能です。
詳細な構成オプションと高度な使用方法については、 Postgres Instance Manager ドキュメントを参照してください。
ローリング展開
オペレーターは、ローリング展開をサポートして、ダウンタイムを最小限に抑えます。 PostgreSQLクラスターが一般に公開されている場合、サービスは、初期化または更新中に使用可能なポッドにのみ読み取り専用トラフィックをロードバランシングします。
レプリカのスケールアップとスケールダウン
演算子を使用すると、PostgreSQLクラスター内のインスタンスの数をスケールアップおよびダウンできます。新しいレプリカはプライマリサーバーから起動され、クラスターのHAインフラストラクチャに参加します。
CRDは、 kubectl scale
コマンドを使用できるようにする「scale」サブリソースを宣言します。また、scaleサブリソースは、管理対象インスタンスポッドのラベルセレクターを公開し、オートスケーラーがそれらを検出できるようにします。
Vertical Pod Autoscaler integration を参照してください
推奨される使用方法、および Horizontal Pod Autoscaler integration
HPAに適用される注意事項については、
KubernetesノードのメンテナンスウィンドウとPodDisruptionBudget
オペレーターはPodDisruptionBudget
リソースを作成して、同時中断数を1つのプライマリインスタンスに制限します。この構成により、メンテナンス操作でクラスター内のすべてのポッドが削除されるのを防ぎ、指定された数のインスタンスを作成できます。
PodDisruptionBudgetは、ノードドレイン操作中に適用され、クラスターサービスの中断を防ぎます。
この戦略は、ストレージがすべてのワーカーノードで共有されるKubernetesクラスターには正しいですが、ローカルストレージを使用するクラスター、またはプライベートクラウドにインストールされたクラスターには、最適なソリューションではない可能性があります。オペレーターを使用すると、メンテナンスウィンドウを指定し、基になるノードのエビクションへの反応を構成できます。メンテナンスウィンドウセクションのReusePVC
オプションを使用すると、使用するストラテジーを指定できます。削除されたインスタンスの別のPVCに新しいストレージを割り当てるか、基になるノードが再び利用できるようになるのを待ちます。
フェンシング
フェンシングは、PostgreSQLクラスターの1つ以上、またはすべてのインスタンスに障害があると思われる場合に、データを保護するプロセスです。インスタンスがフェンスされると、PostgreSQLサーバープロセスは保証的にシャットダウンされますが、ポッドは実行されたままです。これにより、フェンスが解除されるまで、ポッド上のデータはPostgreSQLによって変更されず、デバッグとトラブルシューティングの目的でファイルシステムを調査できます。
ハイバネーション
CloudNativePGは hibernation of a running PostgreSQL cluster をサポート
cnpg.io/hibernation
アノテーションを介して宣言的な方法で。ハイバネーションでは、データベースPVCを維持したままデータベースポッドを削除することにより、CPUパワーを節約できます。この機能は、0インスタンスへのスケーリングをシミュレートします。
ポッドの永続ボリュームストレージの再利用
ユーザーによって削除されたポッド、またはKubernetesメンテナンスオペレーションによって削除されたポッドをオペレーターが作成する必要がある場合、PersistentVolumeClaim
可能な場合は再利用します。この機能により、プライマリからデータを再度クローン作成する必要がなくなります。
CPUとメモリの要求と制限
オペレーターを使用すると、管理者は、マニフェストのresources
セクションでクラスターのポッドによるリソースの使用を制御および管理できます。特に、CPUとRAMの両方にrequests
およびlimits 値を設定できます。 Cluster
は、scaleサブリソースを介してラベルセレクターを公開するため、
垂直ポッドオートスケーラーVPAとの統合 のターゲットとして使用することもできます。
推奨専用モードで、これらの値のサイズの提案を取得します。
PgBouncerを使用した接続プーリング
CloudNativePGは、
PostgreSQLで最も人気のあるオープンソース接続プーラーの1つである
PgBouncerIntegrationStatus
を使用した接続プーリングのネイティブサポートを提供します。アーキテクチャの観点から、PgBouncer接続プーラーのネイティブ実装は、データベースにアクセスするための新しいレイヤーを導入します。これにより、インスタンスへのクエリフローが最適化され、基になるPostgreSQLリソースの使用がより効率的になります。
PostgreSQLサービスに直接接続する代わりに、アプリケーションはPgBouncerサービスに接続し、既存の接続の再利用を開始できるようになりました。
PgBouncerイメージは、ImageCatalog またはClusterImageCatalog
spec.pgbouncer.imageCatalogRef
を介して一元管理でき、オプションでPooler
メトリックエンドポイントをTLSで提供できます。
論理レプリケーション
CloudNativePGは、 Publication およびSubscription
カスタムリソース定義を使用して、宣言的方法でPostgreSQLの論理レプリケーションをサポートします。
論理レプリケーションは、次の場合に特に役立ちます。
オンラインデータの移行 最小限のダウンタイムで外部のPostgreSQLインスタンスまたはパブリックDBaaSソリューションからデータを移動します。
PostgreSQLのメジャーアップグレード メジャーバージョン間のほぼゼロのダウンタイムのアップグレードを促進します。
選択的なデータ分散 レポートまたはローカライズされたワークロードのために、さまざまなクラスターにわたって特定のテーブルまたはデータセットを複製します。
レベル4 深い洞察
機能レベル4は、_observability_モニタリング、アラート、トレンド、ログ処理に関するものです。これには、Prometheus、Grafana、Fluent Bitなどの外部ツール、およびJSON形式で直接エラーログを出力するためのPostgreSQLエンジンの拡張機能の使用が含まれる場合があります。
CloudNativePGは、柔軟なモニタリングとロギングのための業界標準のコミュニティで認められたツールと簡単に統合するために必要なすべてを提供するように設計されました。
構成可能なクエリを備えたPrometheusエクスポータ
インスタンスマネージャーは、プラグ可能なフレームワークを提供します。
metrics
ポート9187でリッスンする独自のWebサーバーを介して、 Prometheus モニタリングおよびアラートツールのメトリックをエクスポートするエンドポイントを公開します。オペレーターは、
postgres_exporter と互換性のある構文を使用して、ConfigMap
またはSecret
オブジェクトとして定義されたカスタムモニタリングクエリーをサポートします。
CloudNativePGは、コンテキストに統合して適応できるPostgreSQLの基本的なモニタリングクエリセットを提供します。
Grafanaダッシュボード
CloudNativePGには、PostgreSQLクラスターのすべての重要な側面を監視し、カスタマイズするためのベースとして使用できるGrafanaダッシュボードが付属しています。
JSON形式のPostgreSQLエラーメッセージの標準出力ログ
すべてのログメッセージはJSON形式で標準出力に配信されます。最初のレベルは、タイムスタンプ、ログレベル、および正規のPostgreSQLエラーメッセージチャネルのpostgres
などのログエントリのタイプの定義です。その結果、CloudNativePGによって管理されるすべてのポッドは、ソースデータ型としてJSONをサポートするダウンストリームログ処理スタックと簡単かつ直接統合できます。
リアルタイムクエリモニタリング
CloudNativePGは以下を透過的かつネイティブにサポートします。
必須の pg_stat_statements 、 PostgreSQLサーバーによって実行されるすべてのSQLステートメントの計画と実行統計の追跡を有効にします
auto_explain 、
EXPLAINを手動で実行することなく、遅いステートメントの実行プランを自動的にログに記録する手段を提供します最適化されていないクエリーを追跡するのに役立ちます
監査
CloudNativePGを使用すると、データベースとセキュリティの管理者、監査人、およびオペレーターは、PostgreSQLのPGAuditを使用してデータベースアクティビティを追跡および分析できます。このようなアクティビティはJSONログで直接フローし、Fluentdのような一般的なログブローカーを使用して正しいダウンストリームターゲットに適切にルーティングできます。
Kubernetesイベント
リソースの作成、ノードの削除、アップグレードなど、Kubernetes
APIで想定されているメジャーイベントを記録します。 kubectl describe
、kubectl get events コマンドを使用してイベントを表示できます。
レベル5 自動操縦
機能レベル5は、オブザーバビリティレイヤーから現れた異常と洞察の発見を介した自動スケーリング、修復、および調整に焦点を当てています。
自己修復のための自動フェイルオーバー
プライマリで障害が検出された場合、オペレーターは、最も調整されたレプリカを新しいターゲットプライマリとして設定することにより、クラスターのステータスを変更します。その結果、各生きているポッドのインスタンスマネージャーは、必要なプロシージャを開始して、クラスターの要求されたステータスに自分自身を調整します。これは、新しいプライマリになるか、フォローすることにより実行されます。元のプライマリが復旧した場合、同じメカニズムにより、アプリケーションがそれに到達しないようにし、サーバーでpg_rewind
を実行し、スタンバイとして再起動することにより、スプリットブレインを回避します。オペレーターはさらに、ミューテックスとして機能するクラスターごとのKubernetes
Lease
を介してプライマリプロモーションを調整し、任意の時点で最大1つのインスタンスがプロモートするように保証します。インスタンスはプライマリとして機能する前にリースを保持し、クリーンシャットダウンでリリースする必要があるため、レプリカ完全なTTLを待たずに昇格できます。同期フェイルオーバークォーラムが有効になっている場合、オペレーターの「オートパイロット」ロジックはさらに洗練されたものになります。レプリカのクォーラムがトランザクション状態を検証できない場合、プロモーションをアクティブにブロックします。これにより、プライマリとその同期スタンバイの両方に影響を与えるネットワークパーティションなど、複雑な障害シナリオ中の偶発的なデータの損失が防止されます。
スタンバイの自動再作成
スタンバイをホスティングするポッドが削除された場合、オペレーターはスタンバイサーバーを再作成する手順を開始します。