Architecture
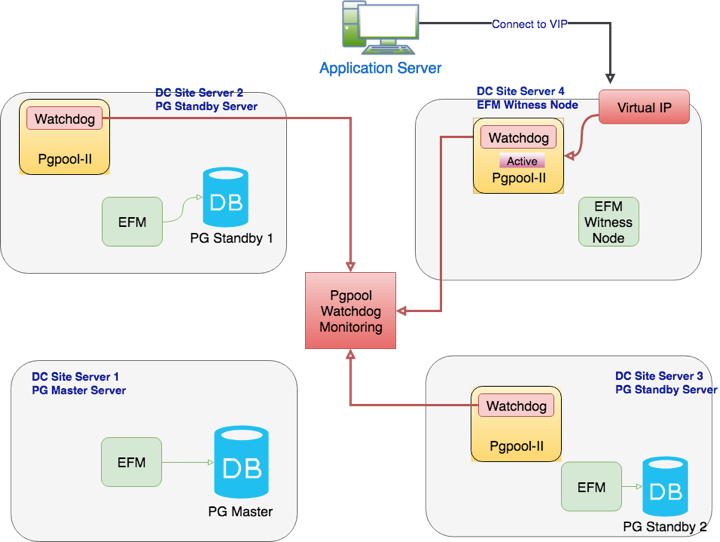
典型的なEFMおよびPgPool構成
サンプルのアーキテクチャー図には、次の表で説明する4つのノードが示されています。
シナリオ |
コンポーネント |
|---|---|
|
マスタサーバー、PostgresStreamingReplicationでAdvancedServerおよびFailoverManagerを実行しています。アプリケーション/クライアントは、書き込み操作(つまり、INSERT、UPDATE、DELETE)を実行するために、サーバー4のPgpoolポート(または、使用する場合は仮想IP)を介して接続します。 |
|
フェールオーバーマネージャーを実行するスタンバイノード(Pgpool-IIはオプション)。これは、ストリーミングレプリケーションのスタンバイノードです。アプリケーション/クライアントは、サーバー4のPgpoolポートを介して(または使用されている場合は仮想IPを介して)このデータベースに接続し、読み取り操作(つまりSELECT)を実行します。必要に応じて、ウォッチドッグを実行した状態でオプションのスタンバイPgpoolインスタンスをセットアップできます。 |
|
Pgpool-IIおよびFailoverManagerを実行しているオプションの監視ノード。このサーバーは、アクティブなデータベースではなく、フェールオーバーマネージャーとPgpoolでセットアップされます。すべてのアプリケーション/クライアントは、このサーバーのIPアドレスまたはこのサーバーを指す仮想IPを介して、このサーバーを介して他のデータベースに接続します。少なくとも3つの他のEFMノードが存在する場合、監視ノードは必要ありません。このサンプルアーキテクチャの監視ノードは、デモ用に提供されています。 |
このアーキテクチャ:
マスターノードに障害が発生した場合に2つのスタンバイを提供することにより、最大限の可用性を実現します。
負荷分散のための複数のスタンバイで読み取りスケーラビリティを向上させることにより、混合および読み取り集約型のワークロードで最大のパフォーマンスを実現します。
マスターでPgpoolを実行せずに負荷分散を実行することにより、マスターノードの負荷を軽減します。
watchdogを使用してPgpoolを高可用性モードで構成することにより、Pgpoolの単一障害点を回避します。最も負荷の少ないノード(監視ノード)でPgpoolマスター/アクティブインスタンスを実行して、パフォーマンスを向上させながら、フェールオーバーマネージャーとリソースを共有します(TCOを削減します)。
1つ以上のスタンバイが同期レプリケーションで構成されている場合、ユーザーは障害イベントでほぼゼロのデータ損失を達成できます。
このアーキテクチャでは、次の動作が期待できます。
シナリオ |
HAへの影響 |
読み取りスケーラビリティへの影響 |
|---|---|---|
スイッチオーバー/スイッチバック: これは、一部のOS/DBレベルのアクティビティ、およびダウンタイム中に使用可能なスタンバイのいずれかをマスターとしてプロモートする場合に計画されるダウンタイムです。 |
**HAへの影響なし**(ロール変更中の数秒の妨害を除く)。EFM/PgPoolクラスター内のノードの数はそのままです。スイッチオーバーは、EFMによって(EFMコマンドを介して)行われます。使用可能なスタンバイの1つが、ダウンタイム中に新しいマスターとして昇格されます。古いマスターは、手動設定なしでEFMによって新しいスタンバイとして再構成され、HAセットアップのノードの総数を維持します。 |
**読み取りスケーラビリティへの影響なし**(ロール変更中の数秒の妨害を除く)。スイッチオーバー後、クラスター内のスタンバイの総数は同じままであるため、負荷分散/読み取りスケーラビリティへの影響はありません。EFMによる切り替えが完了すると、変更後のPgPoolを更新するためにポストプロモーションスクリプトが呼び出されます。したがって、PgPoolはすべてのクラスターノードの役割を変更します。 |
フェールオーバー: これは計画外のダウンタイムであり、マスターデータベースにアプリケーションからアクセスできなくなります(プライマリDBがダウンします)。 |
HAへの影響はありません。ただし、このようなインシデント(フェールオーバー)は、EFM/PgPoolクラスターに1つのスタンバイのみを残します。常に最大可用性(1マスター、2スタンバイ)を維持するには、古い/ダウンしたマスターを新しいスタンバイとして再構築し(pg_basebackupまたはpg_rewindを使用)、EFMクラスターに接続する必要があります(または新しいマシンをスタンバイ)。DBAによる手動の介入が必要です。フェールオーバーはEFMによって自動的に実行されます。 |
読み取りのスケーラビリティが影響を受けます。フェールオーバー後、古い/ダウンしたマスターが新しいスタンバイとして再構築され、EFMクラスターに接続されるまで、読み取りスケーラビリティ/ロードバランシングに使用できるスタンバイは1つだけです。ノードの総数(この場合は3つのノード)が復元されると、EFM接続スクリプトはノードをPgpoolクラスターに接続します。完了後、両方のスタンバイがロードバランシングに使用可能になります。 |
