Supported failover and failure scenarios
フェールオーバーマネージャーは、フェールオーバーを引き起こす可能性のある障害についてクラスターを監視します。
フェールオーバーマネージャーは、非常に限定された限定的なフェールオーバーシナリオをサポートします。フェールオーバーが発生する可能性があります。
プライマリデータベースがクラッシュまたはシャットダウンした場合。
プライマリデータベースをホストしているノードがクラッシュまたは到達不能になった場合。
フェールオーバーマネージャーは、これらの条件の正確性を検証しようとするあらゆる試みを行います。プライマリデータベースまたはノードに障害が発生したことをエージェントが確認できない場合、フェールオーバーマネージャーはクラスターでフェールオーバーアクションを実行しません。
フェールオーバーマネージャーは、フェールオーバーマネージャーでフェールオーバー条件を監視および検出したいが、スタンバイへの自動フェールオーバーを実行しない場合に、 noauto-failover モードもサポートします。このモードでは、フェールオーバー条件が満たされたときに通知が管理者に送信されます。自動フェイルオーバーを無効にするには、クラスタープロパティファイルを変更し、
auto.failover パラメーターを
falseに設定します。
フェールオーバーマネージャーは、管理者の介入を必要とするが、スタンバイデータベースをプライマリに昇格することに値しない状況について、管理者に警告します。
プライマリデータベースがダウンしています
プライマリデータベースノードで実行されているエージェントがプライマリデータベースの障害を検出すると、Failover Managerは障害を確認するプロセスを開始します。
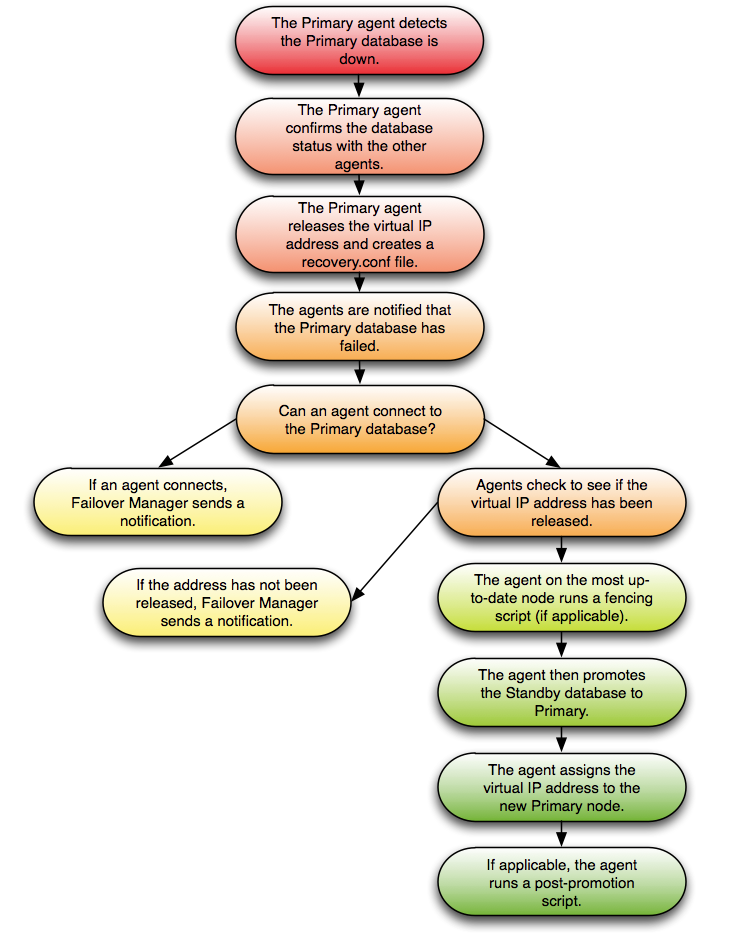
Confirming the failure of the primary database.
プライマリノードのエージェントが、プライマリデータベースに障害が発生したことを検出すると、すべてのエージェントがプライマリデータベースに直接接続しようとします。エージェントがデータベースに接続できる場合、フェールオーバーマネージャーはプライマリノードの状態に関する通知を送信します。接続できるエージェントがない場合、プライマリエージェントはデータベース障害を宣言し、VIPを解放します(該当する場合)。
エージェントが仮想IPアドレスまたはデータベースサーバーに到達できない場合、フェールオーバーマネージャーはフェールオーバープロセスを開始します。最新のノードのスタンバイエージェントは、フェンシングスクリプト(該当する場合)を実行し、スタンバイデータベースをプライマリデータベースに昇格させ、仮想IPアドレスをスタンバイノードに割り当てます。
auto.reconfigure がfalse
に設定されていない限り、追加のスタンバイノードは新しいプライマリから複製するように構成されます。該当する場合、エージェントはプロモーション後スクリプトを実行します。
ノードをクラスターに戻す
クラスター全体を再起動せずにこのシナリオから回復するには:
1.元のプライマリノードでデータベースをスタンバイデータベースとして再起動します。
2.元のプライマリノードでefm resume コマンドを呼び出します。
ノードをプライマリの役割に戻します
ノードをスタンバイとしてクラスターに戻した後、ノードを簡単にプライマリのロールに戻すことができます。
1.クラスターに複数のスタンバイノードがある場合、 efm set-priority
コマンドを使用して、ノードのフェイルオーバー優先度を1に設定します。
efm promote -switchover コマンドを呼び出して、ノードをプライマリノードの元のロールに昇格させます。
注釈
フェールオーバーマネージャーは、障害が発生したプライマリデータベースを再構築してスタンバイにしません。再構築する前に、プライマリに障害が発生した理由を特定し、新しいプライマリですべてのデータを利用できることを確認することが重要です。サーバーをスタンバイとして復元する準備ができたら、古いデータディレクトリを削除して、サーバーを復元できます。詳細については、 Setting up a standby server のPostgreSQLドキュメントを参照してください。場合によっては、 pg_rewind を使用してサーバーを復元することもできます。
スタンバイデータベースがダウンしています
スタンバイエージェントがデータベースの障害を検出すると、エージェントは他のエージェントに通知します。他のエージェントはデータベースの状態を確認します。
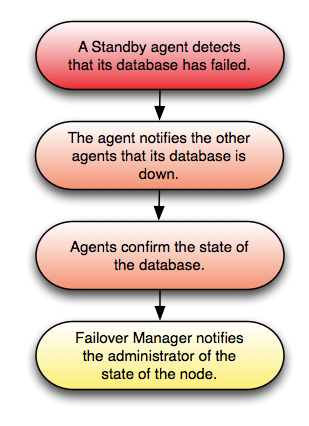
Confirming the failure of a standby database.
スタンバイデータベースを正常な状態に戻した後、 efm resume
コマンドを呼び出して、スタンバイをクラスターに戻します。
プライマリエージェントが終了するか、ノードに障害が発生しました
フェールオーバーマネージャーのプライマリエージェントがクラッシュするか、ノードに障害が発生すると、スタンバイエージェントが障害を検出し、必要に応じてフェールオーバーを開始します。
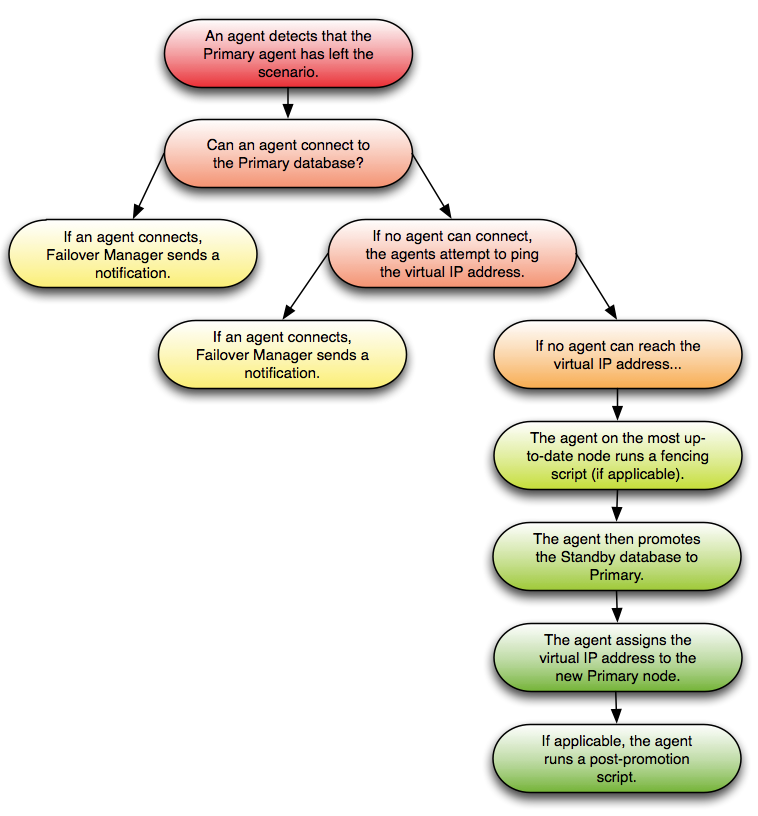
Confirming the failure of the primary agent.
プライマリエージェントが去ったことをエージェントが検出した場合、すべてのエージェントはプライマリデータベースに直接接続しようとします。データベースに接続できるエージェントがある場合、エージェントはプライマリエージェントの障害に関する通知を送信します。接続できるエージェントがない場合、エージェントは仮想IPアドレス(該当する場合)にpingを試行して、解放されたかどうかを判断します。
エージェントが仮想IPアドレスまたはデータベースサーバーに到達できない場合、フェールオーバーマネージャーはフェールオーバープロセスを開始します。最新のノードのスタンバイエージェントは、フェンシングスクリプト(該当する場合)を実行し、スタンバイデータベースをプライマリデータベースに昇格させ、仮想IPアドレスをスタンバイノードに割り当てます。該当する場合、エージェントはプロモーション後スクリプトを実行します。
auto.reconfigure がfalse
に設定されていない限り、追加のスタンバイノードは新しいプライマリから複製するように構成されます。
プライマリがネットワークから分離されたためにこのシナリオが発生した場合、プライマリエージェントは分離を検出し、仮想IPアドレスを解放して、
recovery.conf
ファイルを作成します。フェールオーバーマネージャーは、クラスターの残りのノードで同じ手順を実行します。
クラスター全体を再起動せずにこのシナリオから回復するには:
1.元のプライマリノードを再起動します。
2.元のプライマリデータベースをスタンバイノードとして起動します。
3.元のプライマリノードでサービスを開始します。
- プライマリフェールオーバーマネージャープロセスが失敗した場合、エージェントが再起動されるまでフェールオーバー保護はありません。このケースを回避するには、systemdを介してプライマリノードを設定し、プライマリエージェントの終了時にフェイルオーバーを発生させることができます。詳細については、
Configuring for Eager Failover を参照してください。
スタンバイエージェントが終了するか、ノードに障害が発生します
スタンバイエージェントが終了するか、スタンバイノードに障害が発生すると、他のエージェントは、クラスターに接続されなくなったことを検出します。
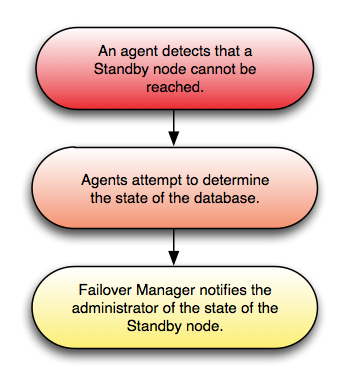
Failure of standby agent.
障害が検出されると、エージェントはノードにあるデータベースへの接続を試みます。エージェントが問題があることを確認すると、フェールオーバーマネージャーは適切な通知を管理者に送信します。
プライマリが1つだけ、スタンバイが1つだけ残っている場合、プライマリノードに障害が発生した場合のフェールオーバー保護はありません。プライマリデータベースに障害が発生した場合、プライマリエージェントとスタンバイエージェントは、データベースに障害が発生したことに同意し、フェールオーバーを続行できます。
専用の証人エージェントが終了/ノードに障害が発生する
このシナリオでは、専用の監視(データベースをホストしていないノード)に障害が発生した場合に実行されるアクションについて詳しく説明します。
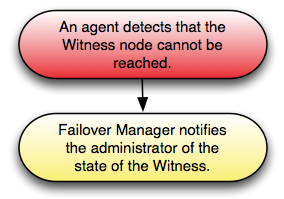
Confirming the failure of a dedicated witness.
監視ノードに到達できないことをエージェントが検出すると、フェールオーバーマネージャーは監視の状態を管理者に通知します。
注釈
監視が失敗し、クラスターに2つのノードしかない場合、フェールオーバー保護はありません。スタンバイノードは、プライマリに障害が発生したか切断されたかを知ることができません。 2ノードクラスターでは、プライマリデータベースに障害が発生してもノードがまだ接続されている場合、フェールオーバーは引き続き発生します。スタンバイはプライマリデータベースの状態を確認できます。
ノードはクラスターから分離されます
このシナリオでは、1つ以上のノード(クラスターのマイノリティ)がクラスターの大部分から分離された場合に実行されるアクションについて詳しく説明します。

If members of the cluster become isolated.
1つ以上のノード(ただし、クラスターの半分未満)がクラスターの残りの部分から分離されると、残りのクラスターは、ノードに障害が発生したかのように動作します。エージェントは、プライマリノードが隔離されたノードの中にあるかどうかを識別しようとします。そうである場合、プライマリはクラスターから自分自身をフェンスオフし、クラスターマジョリティ内のスタンバイノードがそれを置き換えるように昇格されます。
auto.reconfigure がfalse
に設定されていない限り、他のスタンバイノードは新しいプライマリから複製するように構成されます。
フェールオーバーマネージャーは管理者に通知し、分離されたノードは可能な場合はクラスターに再参加します。ノードがクラスターに再参加すると、フェールオーバーの優先順位が変更される場合があります。