Known issues#
これらは、ハイブリッドマネージャーHMイノベーションリリースで特定された現在既知の問題と制限です。回避策は、これらの問題の影響を軽減するのに役立つ場合があります。これらの問題は積極的に追跡され、将来のリリースで解決される予定です。
マルチDC#
アップグレード後のマルチDC構成の損失#
!!!ヒント
HMバージョン2025.12以降で解決されました。
回避策 HMアップグレードまたはコンポーネントを元に戻した後、マルチDCセットアップスクリプトを再度実行して、必要な構成を再適用します。
マルチDCセットアップの場所ドロップダウンリストが空です#
!!!ヒント
HMバージョン2025.12以降で解決されました。
回避策
この高度な回避策には、APIから返されるイメージセット情報の量を制限するクラスター管理者権限が必要です。これには、upm-image-library
およびupm-beacon
ConfigMapのイメージ検出タグルールの変更と、それに続く関連ポッドの再起動が含まれます。
回避策の詳細
回避策は、画像ライブラリとEDB Postgres AIエージェントコンポーネントが使用する正規表現タグルールを変更して、インデックス付けされる画像タグの数を一時的に制限します。これにより、API応答サイズが削減され、ロケーションをロードできるようになります。
upm-image-libraryConfigMapを見つけます。
kubectl get configmaps -n upm-image-library | grep upm-image-library
# Example Output: upm-image-library-ttkt29fmf7 1 5d3h
ConfigMapを編集し、各イメージ検出ルール
edb-postgres-advanced、edb-postgres-extended、postgresqlの下のtagsルールを変更します。既存の正規表現を制限的な正規表現に置き換えます。
# Snippet of the YAML you will edit in the ConfigMap
"imageDiscovery": {
  "rules": {
    "(^|.*/)edb-postgres-advanced$": {
      "readme": "EDB postgres advanced server",
      "tags": [
        "^(?P<major>\d+)\.(?P<minor>\d+)-2509(?P<day>\d{2})(?P<hour>\d{2})(?P<minute>\d{2})    (?:-(?P<pgdFlavor>pgdx|pgds))?(?:-(?P<suffix>full))?$"
      ]
    },
    # ... repeat for edb-postgres-extended and postgresql ...
  }
}
注釈
マルチDCセットアップを実行している場合、プライマリHMクラスターでこの手順を実行します。
イメージライブラリーポッドを再起動します。
kubectl rollout restart deployment upm-image-library -n upm-image-library
upm-beaconConfigMapを取得して、 EDB Postgres AIエージェント構成を変更します。
kubectl get configmaps -n upm-beacon beacon-agent-k8s-config
ConfigMap
beacon-agent-k8s-configを編集し、各postgres_repositoriesエントリーedb-postgres-advanced、edb-postgres-extended、postgresqlの下のtag_regexルールを変更します。
# Snippet of the YAML you will edit in the ConfigMap
postgres_repositories:
  - name: edb-postgres-advanced
    description: EDB postgres advanced server
    tag_regex: "^(?P<major>\d+)\.(?P<minor>\d+)-2509(?P<day>\d{2})(?P<hour>\d{2})(?    P<minute>\d{2})(?:-(?P<pgdFlavor>pgdx|pgds))?(?:-(?P<suffix>full))?$"
  # ... repeat for edb-postgres-extended and postgresql ...
EDB Postgres AIエージェントポッドを再起動します。
kubectl rollout restart deployment -n upm-beacon upm-beacon-agent-k8s
これらの手順を完了すると、画像データのサイズが削減されるため、ロケーションAPI呼び出しが成功し、場所がHMコンソールに正しく表示されます。
プロジェクト分離のための専用オブジェクトストレージ#
!!!ヒント
HMバージョン2025.12以降で解決されました。
回避策 新しいプロジェクト用に専用のオブジェクトストレージを作成し、プロジェクトの分離を有効にします。
回避策の詳細 プロジェクトリソースを分離する必要がある場合は、プロジェクトごとに プロジェクト分離のための専用オブジェクトストレージ を構成できます。
コアプラットフォームとリソース#
OpenShiftユーザーのクロスストリームアップグレードの問題#
!!!tip HMバージョン1.4.0以降で解決されました。
回避策 この問題に使用可能な回避策はありません。これを解決するために、現在HMアプリケーションバージョンからOperatorバージョンを切り離しているところです。
upm-beacon-agent 複雑な環境ではメモリ制限が不十分です#
!!!tip HMバージョン1.3.1以降で解決されました。
回避策
Kubernetes展開に手動でパッチを適用して、upm-beacon-agent
ポッドのメモリリソース制限を増やします。
バージョン2026.2へのアップグレード後にIdP構成が失敗する#
説明: 場合によっては、バージョン2026.1から2026.2にアップグレードすると、IDプロバイダーIdP構成がHMコンソールに Expiring Soon ステータスを表示する場合があります。これは、移行プロセス中の競合状態が原因で発生します。この問題はすべての環境で発生するわけではありませんが、トリガーされると、ユーザーはIdPプロバイダーを介して正常に認証できません。
回避策 この状態を解決し、構成を正しく復元できるようにするには、クラスター管理者が内部アプリケーションデータベースを手動で更新する必要があります。
HMコンソールでIdP統合を再セットアップする前に**、内部app-db
データベースで次のSQLステートメントを実行します。
UPDATE upm_api_admin.idp SET deleted_at = NOW() WHERE deleted_at IS NULL;
Langflowシークレットが欠落しているため、accm-server の起動に失敗する#
!!!ヒント
HMバージョン2026.3以降で解決されました。
回避策 AI機能がインストールされていない環境でaccm-server
を起動できるようにするには、 upm-beaco-ff-base
名前空間にプレースホルダーシークレットを手動で作成する必要があります。
次のkubectlコマンドを使用して、空のシークレットを作成できます。
kubectl create secret generic langflow-secret -n upm-beaco-ff-base --from-literal=LANGFLOW_NOT_INSTALLED=true
シークレットが存在すると、accm-server
ポッドはボリュームをマウントし、 Running
状態に移行できるようになります。
イメージをプルするためのハイブリッドマネージャーアプリではkapp-controller サポートなし#
説明: kapp-controller
は、イメージをプルするためのマネージドID/IAMロールをサポートしていません。
回避策
クラウドネイティブのマネージドIDは現在サポートされていないため、ユーザーはレジストリ認証にSecretRef
Kubernetesシークレットを使用してPackageRepository
を手動で構成する必要があります。
スパイアが破損すると、ビーコンサーバーがクラッシュループに入る#
!!!tip HMバージョン2026.5以降で解決されました。
説明 upm-beacon-server
は、spireコンポーネントが壊れているか、使用できない場合にクラッシュループに入ります。
spireは、セカンダリロケーションをサポートするように構成されたすべてのHM展開に必要であるため、壊れたspireコンポーネントはPostgresクラスターの展開を妨げます。
回避策 kubectl
アクセスを持つ管理者として、ビーコンサーバーの構成マップを編集して、spire統合を無効にします。実行します
kubectl edit cm -n upm-beacon beacon-server-config
次に、次の2つのspiffe関連の構成項目を設定します。
general:
  spiffe:
    enabled: false
  spiffeid_controller:
    disabled: true
セカンダリロケーションを接続する前に、これらの設定を元に戻します。
SELinuxが有効になっているRKE2でSPIREエージェントが起動に失敗する#
説明
RHELまたは強制モードのSELinuxを使用する他のLinuxディストリビューションで実行されているRKE2クラスターでは、SPIREエージェントポッドがcreate UDS listener: listen unix /tmp/spire-agent/public/spire-agent.sock: bind: permission denied
エラーでCrashLoopBackOff
状態になります。これは、SELinuxがコンテナプロセスがHostPath
ボリューム/run/spire/agent-sockets
にUnixドメインソケットを作成することをブロックするために発生します。
SELinuxのない環境UbuntuベースのRKE2クラスターなどは、影響を受けません。
回避策
すべてのRKE2クラスターノードでSELinuxを無効にします。このためには、
/etc/selinux/config でSELINUX=disabled
を設定し、ノードをリブートします。リブート後、getenforce
がDisabled と表示されていることを確認します。
SPIREエージェントポッドは自動的に復旧しますが、ポッドが既にCrashLoopBackOff
状態にある場合、バックオフタイマーのため数分かかる場合があります。
重複するオペランドイメージが同じタグとSHAを共有する場合、イメージライブラリの検出に失敗します#
!!!tip HMバージョン2026.4以降で解決されました。
説明 2セットのEDB公式PostgreSQLオペランドイメージが同じタグとSHAダイジェストが異なるリポジトリ名でアップロードされている場合、イメージライブラリ検出プロセスは失敗し、クラスタープロビジョニングに使用できるイメージはありません。
回避策 重複したオペランドイメージの1セットを削除します。画像ライブラリは、残りのセットを正常に検出します。
データベースクラスターエンジン#
max_connections がデフォルト以外の場合、3ノードPGDクラスターの作成に失敗する#
説明
初期クラスタープロビジョニング中に構成パラメーターmax_connections
がデフォルト以外の値に設定されている場合、3データノードPGDクラスターの作成は失敗します。
回避策 デフォルトのmax_connections 値を使用してPGD
3データノードクラスターを作成します。クラスターが正常にプロビジョニングされた後、値を更新します。
AHA監視ノードのリソースがオーバープロビジョニングされています#
説明 監視ノードを使用する高度な高可用性AHAクラスターの場合、監視ノードは大規模なデータノードのCPU、メモリ、およびディスク構成を誤って継承し、不必要なリソースのオーバープロビジョニングが発生します。
回避策 pgdgroup YAML構成を手動で更新して、監視ノードに必要な最小限のリソースを指定および構成します。
HAクラスターは、ストリーミングレプリケーション証明書の認証にverify-full の代わりにverify-ca を使用します#
説明:
レプリカクラスターは、ストリーミングレプリケーション認証に、推奨される最も安全なverify-full
の代わりに、それほど厳密ではないverify-ca
設定を使用します。基になるCloudNativePGCNPクラスターが、特定の環境GKEロードバランサーなどでverify-full
に必要なIPサブジェクト代替名IP
SANをサポートしていないため、これは現在必要です。
回避策 なし。修正は、IP SANをサポートする基になるCNPコンポーネントに依存しています。
2番目のノードが遅すぎるため、大規模なHAクラスターに参加できません#
!!!ヒント
HMバージョン2025.12以降で解決されました。
回避策 単一のノードにデータをロードして、HAにスケーリングするベストプラクティスを回避します。代わりに、最初からHAクラスターにデータを直接ロードします。大規模なクラスターをHA構成に復元するための回避策はありません。
2つのデータグループと1つの監視グループを含むEDB Postgres分散PGDクラスターが正常ではありません#
!!!tip HMバージョン1.4.0以降で解決されました。
AKSデプロイメントは、リージョンごとにプライベートアクセスを備えた1つのPGDデータグループに制限されています#
!!!tip HMバージョン2026.5以降で解決されました。
説明 Azureは、標準ロードバランサー
PrivateLinkServicesPerLoadBalancerLimitReached
ごとに8つのプライベートリンクサービスのハード制限を適用します。プライベートアクセスを持つ各PGDデータグループは5つのロードバランサーサービスノードごとに1つとグループサービスとプロキシサービスを必要とするため、AKSベースのHM展開は、リージョンごとにプライベートアクセスを持つ1つのPGDデータグループのみをホストできます。読み取り専用接続を有効にすると、データグループごとに1つの追加ロードバランサーサービスが追加され、使用可能なクォータがさらに削減されます。
プライベートアクセスを備えた完全な2データグループと監視クラスターは、標準のロードバランサー制限の8で12のプライベートリンクサービススロットを消費します。これにより、単一の場所のAKSでのマルチノードPGDブートストラップが妨げられます。
回避策 データグループを複数の場所に展開して、ロードバランサーのクォータを分散します。たとえば、1つのデータグループと監視を1つの場所に展開し、2番目のデータグループを別の場所に展開します。単一のHMインスタンス内の同じAKSリージョンにプライベートアクセスを使用して複数のPGDデータグループを作成しないでください。
RKEで明示的に選択されていない場合、ネットワークアクセスタイプはデフォルトのPrivate になります#
!!!tip HMバージョン2026.5以降で解決されました。
説明 RKE環境では、2つの関連するネットワークアクセスタイプの問題が存在します。
場所で パブリック と プライベート の両方のアクセスが有効になっている場合、ネットワークアクセスタイプフィールドにはデフォルト選択があります。オプションを明示的に選択しない場合、バックエンドはデフォルトの
Privateになります。場所で ノードポート が有効になっている場合、バックエンドはクラスターのノードポートを正しく構成しますが、HMコンソールには代わりに
Privateとしてアクセスタイプが表示されます。
回避策 RKEでクラスターを作成するときは、目的のネットワークアクセスタイプを常に明示的に選択します。将来のリリースに向けて修正が追跡されています。
ブートストラップJob 作成が中断されると、CNPGオペレーターが無限リコンサイルループに入る#
説明 PVCの作成後、ブートストラップJob
が作成される前に、オプティミスティックロックの競合などにより、クラスターリコンシリエーションが中断された場合、後続のリコンサイルは無限ループに入ります。オペレーターは、PVCがReady
ステータスに到達するのを待機しますが、これはJob
なしでは発生せず、ループが無期限に継続します。
回避策 影響を受けるPVCを削除して、オペレーターがそれを再作成し、ループを中断できるようにします。この問題は、新しく作成されたPVCにのみ影響を与えるため、PVにはまだデータが含まれず、削除しても安全です。
kubectl delete pvc <pvc-name> -n <cluster-namespace>
バックアップ リカバリー#
リージョンをまたがってボリュームスナップショットリカバリーを使用する場合、レプリカクラスターの作成が失敗する#
!!!ヒント
HMバージョン2025.12以降で解決されました。
回避策 最初にプライマリクラスターからBarmanバックアップを手動でトリガーします。次に、そのBarmanバックアップをボリュームスナップショットの代わりに使用して、クロスリージョンレプリカクラスターをプロビジョニングします。
ボリュームスナップショットの復元は同じリージョンに制限されています#
説明 HMは、内部バックアップメカニズムを使用してレプリカクラスターのクロスリージョンデータの同期を自動的に処理しますが、ボリュームスナップショットからのクラスターの手動復元は、クロスリージョン操作をサポートしていません。ボリュームスナップショットを使用してクラスターを別のリージョンの場所に復元しようとすると、スナップショットは地理的にソースリージョンに制限されているため、操作は失敗します。
回避策 別のリージョンの場所にデータを復元するには、ボリュームスナップショットの代わりにBarmanバックアップを使用します。 Barmanバックアップは、リージョンを超えてアクセスできます。
デフォルトの並列構成が原因でWALアーカイブが遅い#
説明 wal.maxParallel
のデフォルト設定は制限が多すぎるため、大量のデータのロード中にWALアーカイブが遅くなります。これにより、アーカイブの準備ができたWALファイルのバックログが発生し、ディスクがいっぱいの状態が発生する可能性があります。このパラメーターは、HMコンソールではまだ設定できません。
回避策
特定のバックアップオブジェクトストアのobjectstores.barmancloud.cnpg.io
Kubernetesリソースを手動で編集し、wal.maxParallel
値を20などに増やして、アーカイブを高速化します。
transporter-db WALギャップのため、ディザスターリカバリーDRプロセスが失敗する場合がある#
!!!tip HMバージョン1.4.0以降で解決されました。
回避策 復元を成功させるには、すぐに少なくとも1つのアーカイブされたWALファイルがある古いバックアップを選択して復元します。これにより、必要なトランザクションログをリカバリプロセスで利用できるようになります。
クラスターの完全なリカバリーはpg_ctl: server does not shut down エラーで失敗します#
説明 競合状態では、HMによって作成および管理されるHAアーキテクチャを備えたクラスターへの復元に失敗する場合があります。完全復旧ポッドのエラーログには、次のようなエントリが含まれます。
pg_ctl: server does not shut down
pg_ctl: waiting for server to shut down............................................................... failed
controller: Error while deactivating instance err=error stopping PostgreSQL instance: exit status 1
回避策 最初にシングルノードクラスターに復元します。復元が完了したら、クラスターをHAアーキテクチャに拡張します。
Agent Factoryとモデル管理#
プロファイルキャッシュを使用したnim-nvidia-nvclip モデルの展開の失敗#
説明
展開プロセス中にプロファイルキャッシュが使用される場合、エージェントファクトリーでnim-nvidia-nvclip
モデルの作成が失敗します。
回避策 管理者は、必要なモデルプロファイルをNVIDIAレジストリからローカルマシンに手動でダウンロードする必要があります。次に、プロファイルファイルをHMのオブジェクトストレージパスに直接アップロードする必要があります。次に、特定の環境変数を使用してKubernetes InferenceService YAMLにパッチを適用して、失敗したネットワークダウンロードを試行する代わりに事前キャッシュされたファイルを使用するように強制することにより、モデルを展開します。
回避策の詳細
NGC APIキーを使用して、NVIDIA Container Registry nvcr.ioにログインします。
docker login nvcr.io -u $oauthtoken -p $NGC_API_KEY
Dockerイメージをローカルマシンにプルします。
docker pull nvcr.io/nim/nvidia/nvclip:latest
ダウンロードしたプロファイル用のローカルディレクトリを準備します。
mkdir -p ./model-cache
chmod -R a+w ./model-cache
ターゲットGPUのプロファイルを選択します。
例、A100 GPUプロファイル
9367a7048d21c405768203724f863e116d9aeb71d4847fca004930b9b9584bb6
コンテナを実行してプロファイルをダウンロードします。コンテナはCPU専用モード
NIM\_CPU\_ONLY=1で実行され、ダウンロードマシンでのGPU固有の初期化問題を防ぎます。
export NIM_MANIFEST_PROFILE=9367a7048d21c405768203724f863e116d9aeb71d4847fca004930b9b9584bb6
export NIM_CPU_ONLY=1

docker run -v ./model-cache:/opt/nim/.cache -u $(id -u) -e NGC_API_KEY -e NIM_CPU_ONLY -e NIM_MANIFEST_PROFILE --rm nvcr.io/nim/nvidia/nvclip:latest
このコンテナは終了しません。ログにHealth method called
という行が表示されたら、実行を手動で停止する必要があります Ctrl+C
。これは、プロファイルのダウンロードが完了したことを確認します。
ローカルマシンからHM展開が使用するオブジェクトストレージバケットにプロファイルをアップロードします。
gcloud storage cp -r ./model-cache gs://uat-gke-edb-object-storage/model-cache/nim-nvidia-nvclip
!!!note
gs://
パスを調整して、展開の構成済みオブジェクトストレージの場所と一致します。
HMコンソールを使用してモデル
nim-nvidia-nvclipを作成し、 Model Profiles Path フィールドを以前の場所たとえば/model-cache/nim-nvidia-nvclipなどとして指定します。展開は、最初は失敗するか、スタックします。HM KubernetesクラスターからInferenceService YAMLをエクスポートします。
必要な環境変数
NIM_IGNORE_MODEL_DOWNLOAD_FAILを、エクスポートしたYAMLのspec.predictor.modelブロックのenvセクションに追加します。このフラグは、ローカルで利用可能なキャッシュアップロードしたファイルを使用し、ネットワークダウンロードの失敗を無視するようにNIMコンテナに指示します。
# --- Snippet of the modified InferenceService YAML ---
spec:
  predictor:
    minReplicas: 1
    model:
      modelFormat:
        name: nim-nvidia-nvclip
      name: ""
      env:
      - name: NIM_IGNORE_MODEL_DOWNLOAD_FAIL  # <-- ADD THIS LINE
        value: "1"                         # <-- ADD THIS LINE
      resources:
        # ... resource requests/limits ...
      runtime: nim-nvidia-nvclip
      storageUri: gs://uat-gke-edb-object-storage/model-cache/nim-nvidia-nvclip
# ---------------------------------------------------
kubectlを使用して変更したYAMLを適用して、事前ダウンロードされたプロファイルを使用するように展開を強制します。
kubectl apply -f <modified-inference-service-file.yaml> -n <model-cluster-namespace>
オブジェクトストレージを使用して手動で提供したモデルプロファイルを使用して、ポッドが正常に起動します。
モデルプロファイルのオブジェクトストレージパスが空の場合、AIモデルクラスターの展開が停止する#
!!!ヒント
HMバージョン2025.11以降で解決されました。
回避策 モデルクラスター展開を開始する前に、 Model Profiles Path フィールドで指定されたオブジェクトストレージパスに、正しい有効なプロファイルが含まれていることを確認します。
イノベーションリリースのアップグレード後にモデル構成設定がリセットされる#
!!!tip HMはグリップテープの代わりにLangflowを使用するようになったため、この問題は適用されません。
説明 HMを2025.11 から2025.12
イノベーションリリースにアップグレードした後、既存のモデル構成設定が意図せずに空にリセットされます。これにより、
model_not_found
エラーが発生し、AIサービスへのアクセスが防止され、ナレッジベースKBがHMコンソールに表示されないなどの問題が発生します。
回避策 HMコンソールで、必要なモデル構成を手動で再入力または設定して、機能を復元します。
ナレッジベースの資格情報を編集するとエラーページが表示される#
!!!tip HMはグリップテープの代わりにLangflowを使用するようになったため、この問題は適用されません。
説明: HMコンソールのパイプラインから作成されたナレッジベースKBを編集するときに、ユーザー名フィールドをスキップして、すぐにパスワードフィールドに移動すると、クライアントサイドのJavaScriptエラーnullのプロパティを読み取ることができません、 Unexpected Application Error! ページが発生します。
回避策 エラーページが表示されないようにするには、 Edit KB を選択した直後、パスワードを入力する前に Username フィールドを入力します。
PGD監視ノードにaidb_usersロールが欠落しているため、AI機能が防止されている#
説明: aidb_users
ロールエージェントファクトリー機能に必要およびその関連拡張機能は、クラスターの初期化中にPGDクラスターの監視ノードに正常に複製されません。この問題は、単一の監視ノード監視グループではなくを使用するPGDクラスターに固有であり、必要なロールが不足しているためにエージェントファクトリーでエラーが発生します。
回避策 必要なロールを手動でインストールし、エージェントファクトリーが機能できるようにするには、 PGD監視ノードで次のSQLコマンドを直接実行します。
begin;
set local bdr.ddl_replication = off;
SET LOCAL bdr.commit_scope = local;
create user aidb_users;
commit;
GenAI Builderの構造とツールの実行失敗#
!!!ヒント
HMバージョン2025.12以降で解決されました。
[Errno -2] (Name or service not known)
回避策 GenAI Builderで構造を作成するときに、 Create Structure パネルで次の環境変数を設定します。
``GT_CLOUD_BASE_URL`` 完全なプロジェクトパスに設定する必要があります
https://<PORTAL URL>/apps/genai-builder/projects/<PROJECT ID>``REQUESTS_CA_BUNDLE`` 次の証明書パスに設定する必要があります。
/etc/ssl/certs/hcp.crt
変数のスクリーンショット
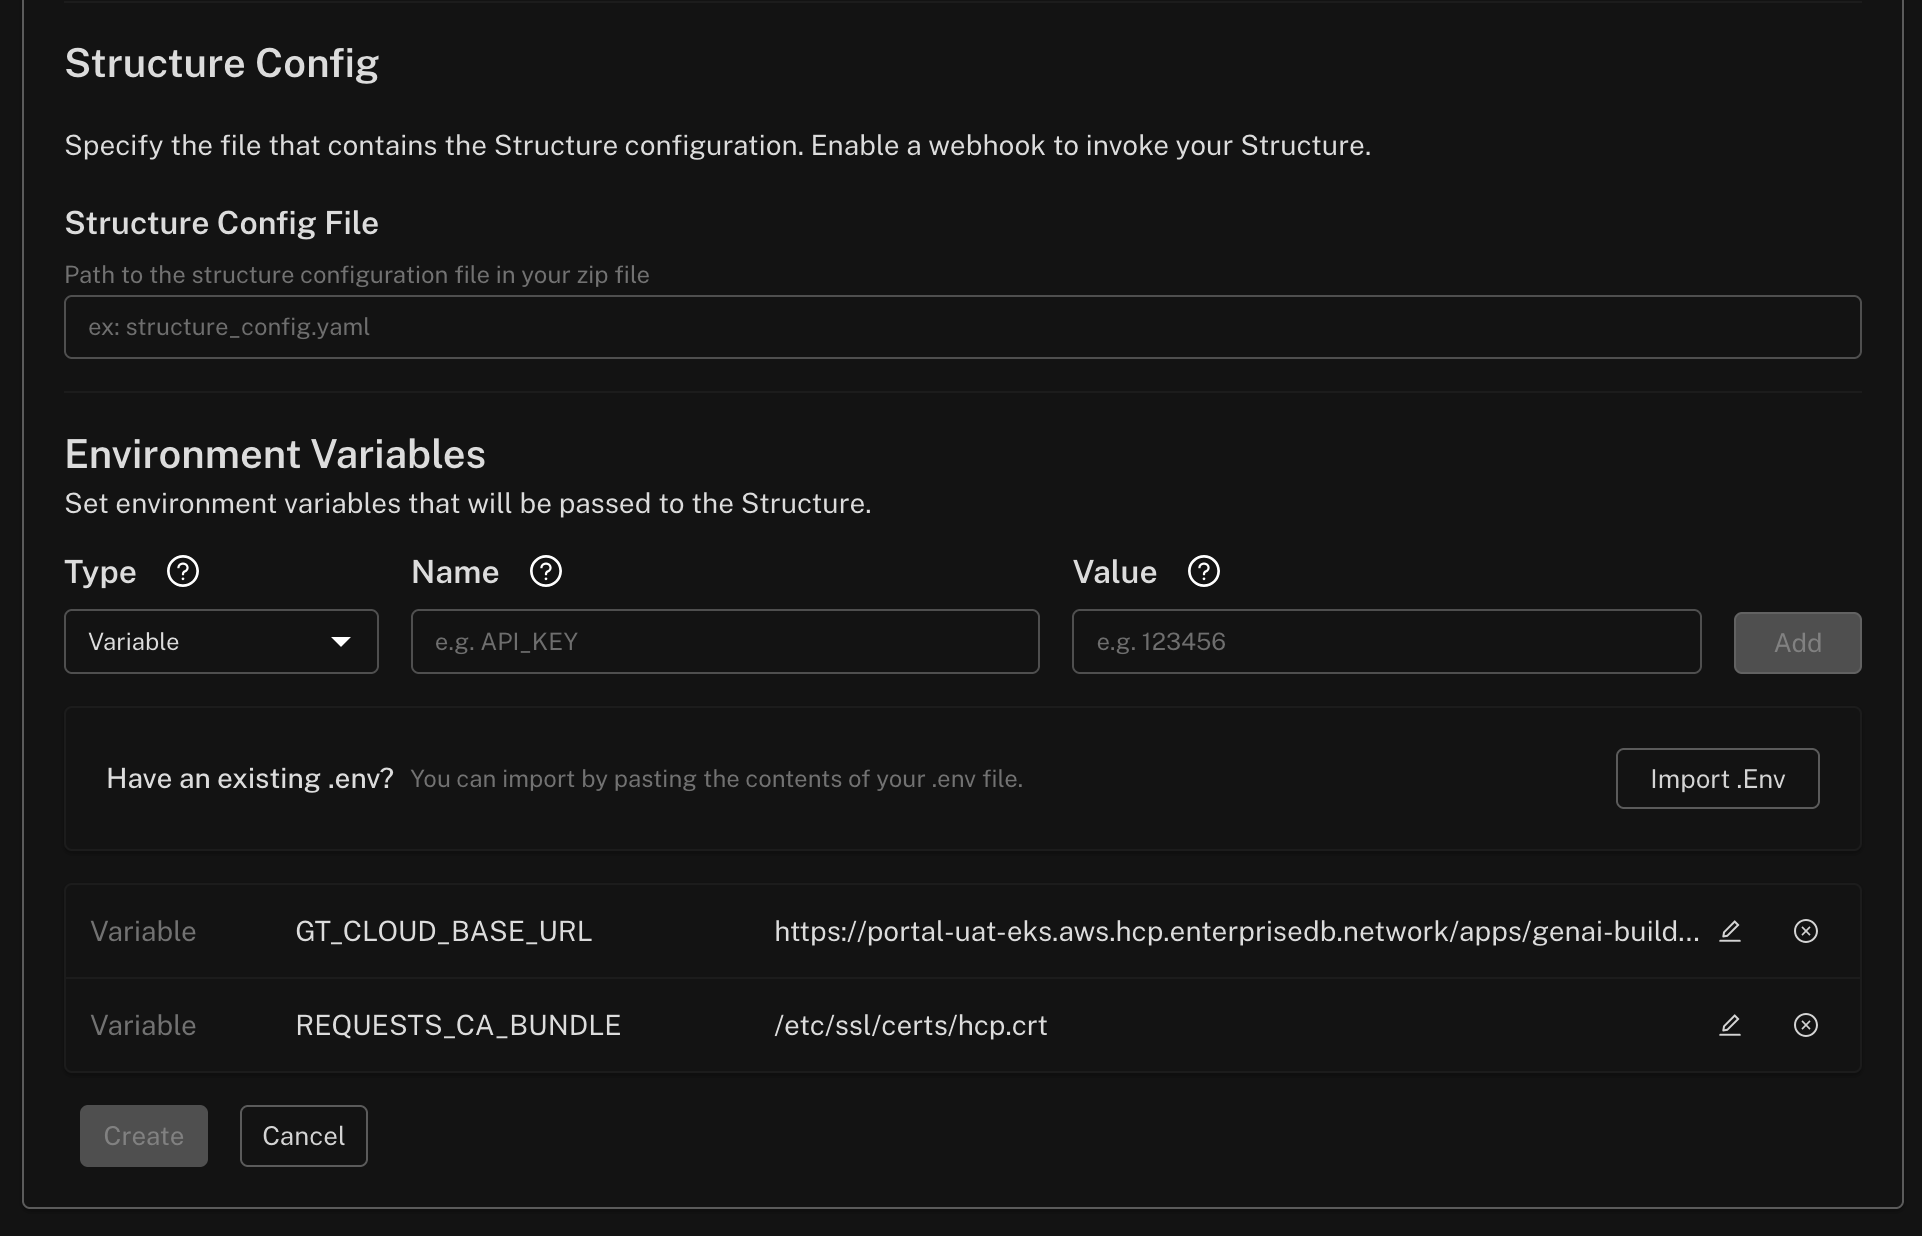
Screenshot of environment variables to be set in the UI#
パイプラインデザイナーが作成したナレッジベースはGenAI Builderに表示されません#
説明 HM
2025.12では、パイプラインデザイナーPDで作成されたナレッジベースKBはvisual_pipeline_user
ロールに割り当てられます。これは、厳密な分離を適用するために行われ、HMユーザーがデフォルトでSQL作成のKBにアクセスできないようにします。その逆も可能です。ただし、この分離により、GenAI
BuilderはすぐにこれらのKBを照会できません。
回避策 PDで作成したKBを特定のPostgreSQLユーザーアカウントと明示的に共有して、GenAI Builderでクエリ可能にします。
回避策の詳細
サンプルシナリオ
Aliceはalice@acme.org
としてHMに接続し、データベースユーザーalice
としてPostgreSQLに接続します。彼女はPD KBをalice
データベースユーザーと共有して、GenAI
Builderエージェントが彼女の資格情報を使用してそれらを照会できるようにする必要があります。
前提条件 ユーザーの存在を確認する
ターゲットPostgreSQLユーザーこの例ではalice
が存在し、aidb_users ロールが割り当てられていることを確認します。
ユーザーが存在しない場合は、次を実行しますAIDBのインストールにEDBドキュメントに従っていることを前提としています。
CREATE USER alice WITH PASSWORD  ****  **** ;
GRANT CONNECT ON DATABASE <some_db> TO alice;
GRANT CREATE ON SCHEMA <some_schema> TO alice;
GRANT aidb_users TO alice;
ロールアクセスの付与 回避策
ユーザーがPDで作成したナレッジベースを表示および照会できるようにするには、visual_pipeline_user
ロールのメンバーシップを付与します。
GRANT visual_pipeline_user TO alice;
設定
設定したalice
資格情報のユーザー名とパスワードを使用するようにGenAI
Builderエージェント構成を更新します。
外部推論サービスパラメーターを編集すると、名前変更エラーが返されます#
!!!ヒント
HMバージョン2026.3以降で解決されました。
回避策 外部推論サービスのパラメーターを更新するには、既存のサービスを削除し、目的の構成で新しいサービスを作成する必要があります。この問題は、特に外部モデルサービスに影響を与えますが、内部推論サービスには影響しません。
無効な外部モデル名の検証メッセージがありません#
!!!ヒント
HMバージョン2026.3以降で解決されました。
両方の名前が有効であるためには、次のことを行う必要があります。
小文字の英数字、ハイフン
-、またはドット.のみで構成されます。英数字で開始および終了します。
回避策 登録時に指定されたすべての名前が文字要件を厳密に従っていることを確認します。外部サービスの登録後にページがハングしたように見える場合は、サービス名とモデル名に大文字またはサポートされていない特殊文字が含まれていないことを確認します。
AIDB v6.1を使用するPGDクラスターでパイプラインの作成が失敗する#
!!!tip AIDB 7.3.2に同梱されているHMバージョン1.4.0以降で解決されています。
説明 HMバージョン2026.3では、 EDB Postgres DistributedPGDおよびAIDB
v6.1でエージェントファクトリーを使用する場合、レプリケートテーブルでのパイプラインの作成が失敗する場合があります。次のエラーが発生する場合があります。ERROR: replicated relation <table_name> cannot have triggers that are owned by roles other than the relation owner (SQLSTATE 42501)
。
これは、
PGDでは、トリガーとその関連トリガーハンドラーファンクションの両方が、テーブル通常はvisual_pipeline_user
を所有する同じロールが所有していることを必要とするために発生します。バージョン2026.3では、これらの機能はデフォルトで別の所有者に割り当てられる場合があります。
回避策
この所有権の競合を解決するには、スーパーユーザーがAIDBトリガーハンドラーファンクションの所有権をvisual_pipeline_user
ロールに手動で譲渡する必要があります。
影響を受けるデータベースで次のSQLコマンドを実行します。
ALTER FUNCTION aidb.pipeline_background_trigger_handler OWNER TO visual_pipeline_user;
ALTER FUNCTION aidb.pipeline_live_trigger_handler OWNER TO visual_pipeline_user;
外部クラウドホストOCRモデルは、HMコンソールを介して登録に失敗します#
説明: aidb.sync_hcp_models
ファンクションは、同期中にすべてのモデルURLに/v1/infer
サフィックスを自動的に追加します。このサフィックスはローカルコンテナ化されたNIMモデルに必要ですが、NVIDIAのPaddleOCR
.../cv/baidu/paddleocr
のようなURLパスを使用するなどの外部クラウドホストモデルの接続を切断します。その結果、外部OCRモデルは、HMコンソールを介して正常に構成または使用できません。
回避策 HMコンソール登録フローをバイパスし、aidb.create_model
ファンクションを介してSQLを使用してデータベースにモデルを直接登録し、正しいURLを明示的に提供します。
オプション1—リモートNVIDIAモデルのビルトインのデフォルトURLを使用します。
SELECT aidb.create_model(
    my_ocr_model,
    nim_paddle_ocr,
    credentials => jsonb_build_object(api_key, current_setting(aidb.nvidia_nim_api_key, true)),
    replace_credentials => true
);
オプション2-カスタムの完全なURLを明示的に設定します。
SELECT aidb.create_model(
    my_ocr_model,
    nim_paddle_ocr,
    config => {"url":"https://ai.api.nvidia.com/v1/cv/baidu/paddleocr"}::JSONB,
    credentials => jsonb_build_object(api_key, current_setting(aidb.nvidia_nim_api_key, true)),
    replace_credentials => true
);
アナリティクスと階層テーブル#
階層化パーティションテーブルの更新がPGAAエラーで失敗する#
!!!ヒント
HMバージョン2026.2以降で解決されました。
PostgreSQL 17で一定の結果関係を使用してJOINクエリーを実行すると、PGAAはサーバークラッシュSIGSEGVを発生させます#
!!!tip HMバージョン1.4.0以降で解決されました。
説明: Postgres Analytics Accelerator
PGAA拡張機能がロードされているときに、一方が定数結果リレーションたとえばSELECT aaa FROM v_dual LEFT JOIN bbb
またはSELECT aaa FROM (SELECT 1) d LEFT JOIN bbb であるJOIN
クエリーを実行すると、SIGSEGVクラッシュが発生します。この問題は、PostgreSQL
17のタイプの混乱が原因であり、3つの異なるパスサブタイプが同じT_Result
パスタイプを共有します。
回避策 PGAAで結合と集計プッシュダウンを無効にします。
ALTER DATABASE <your_database> SET pgaa.enable_join_pushdown    = off;
ALTER DATABASE <your_database> SET pgaa.enable_groupby_pushdown = off;
Advanced 高可用性または分散高可用性PGDクラスターを使用している場合、設定をすべてのノードにレプリケートします。
SELECT bdr.run_on_all_nodes($$
ALTER DATABASE <your_database> SET pgaa.enable_join_pushdown    = off;
ALTER DATABASE <your_database> SET pgaa.enable_groupby_pushdown = off;
$$);
HMコンソールと可観測性#
Advanced High Availabilityおよび分散高可用性PGDクラスターのフォールスポジティブバックアップアラート#
!!!ヒント
HMバージョン2026.2以降で解決されました。
回避策 HMコンソールでの不必要な通知を回避するには、次のいずれかの方法を使用して、高度な高可用性および分散高可用性PGDクラスターのこれらの特定のアラートをサイレントにできます。
HMコンソール プロジェクトで、 Settings > Alerts に移動し、
pem_time_since_last_backup_available_secondsおよびpem_backup_longer_than_expectedを沈黙させます。アラートマネージャー 高度な高可用性および分散高可用性PGD環境をターゲットとするこれらの2つのアラートのサイレントルールを作成します。
2つの異なるイベントを表示するときにイベントマーカーが重なる#
!!!ヒント
HMバージョン2026.3以降で解決されました。
回避策 イベントマーカーフィルターを使用して特定のイベントを表示し、イベントマーカーの重なりを回避します。
エステートページにアクセスするときのHTTP 431 “Request Header Fields Too Large”エラー#
!!!ヒント
HMバージョン2026.3以降で解決されました。
回避策 このエラーの影響を受けるユーザーの場合、組織所有者は次のいずれかのアクションを実行して要求ヘッダーのサイズを削減する必要があります。
プロジェクトアクセスの取り消し アクティブに必要とされなくなったプロジェクトへの影響を受けるユーザーのアクセスを削除します。
未使用のプロジェクトの削除 使用されなくなったプロジェクトを削除して、ユーザーのプロファイルに関連付けられている合計数を減らします。
タスクおよびクラスターのライフサイクルイベントの通知が見つからない#
!!!tip HMバージョン2026.4以降で解決されました。ただし、回避策は2026.3へのアップグレードに引き続き適用されます。
説明:
バージョン2026.3にアップグレードした後、ユーザーはクラスターライフサイクルイベントと自動化タスクトリガーされたスケーリングやメンテナンスなどのアプリ内通知とWebhook通知の受信を停止する場合があります。この問題は、以前のバージョンの孤立したテーブルが新しいスキーマと競合し、アクティビティプロセッサの初期化を妨げた、データベースの移行005_activity_processor_setting.sql
の失敗が原因で発生します。新規インストールは影響を受けません。
回避策 HM管理者は、不足している設定テーブルを手動で作成し、内部アプリケーションデータベースのタイムスタンプを初期化する必要があります。
upm-beaco-ff-base 名前空間にあるapp-db
ポッド内で次のコマンドを実行します。
CREATE TABLE upm_notification_system.activity_processor_settings (
    last_processed_at TIMESTAMPTZ NOT NULL
);

INSERT INTO upm_notification_system.activity_processor_settings (last_processed_at)
VALUES (NOW());
WALストレージパーセントメトリックは、監視ページに誤った値を表示します#
!!!tip HMバージョン2026.4以降で解決されました。
回避策 n/a
GUC設定は再起動するまで適用されない#
!!!tip HMバージョン1.4.0以降で解決されました。
説明 shared_preload_libraries
など、HMコンソールで構成されたGUC設定はすぐには適用されません。設定は、少なくとも1回の再起動が実行されるまで、以前の状態のままです。
回避策 HMコンソールでGUC変更を適用した後、再起動をトリガーして、新しい設定を有効にします。
アラートしきい値の更新が断続的に有効にされない#
!!!tip HMバージョン2026.5以降で解決されました。
説明 HMコンソールで新しいアラートしきい値を保存した後—たとえば、メモリ使用量アラートしきい値を90%から85%に減らした後-変更は断続的に適用されず、しきい値は以前の値に戻ります。
回避策 アラート設定で、 Notify After フィールドが0より大きい値に設定されていることを確認します。現在0に設定されている場合、ゼロ以外の値に更新して保存します。
アセットライブラリーアプリには、プロジェクト所有者またはプロジェクト編集者のロールが必要です#
説明: すべてのアセットライブラリーアプリで、ユーザーがアクセス、展開、または管理するには、少なくとも プロジェクトエディター ロールが必要です。 プロジェクト閲覧者 など、より低い権限ロールを持つユーザーは、アセットライブラリーアプリにアクセスできません。このロール要件は、すべてのアセットライブラリーアプリに適用され、現在アプリごとに構成できません。
回避策 アセットライブラリーアプリにアクセスまたは管理する必要があるユーザーに、関連するプロジェクトの少なくとも プロジェクトエディター ロールが割り当てられていることを確認します。ロールの割り当ては、プロジェクト設定でプロジェクト所有者または組織の所有者が管理できます。
アセットライブラリーアプリは表示名ではなくパッケージ名で並べ替えられました#
!!!tip HMバージョン2026.5以降で解決されました。
説明 アセットライブラリー では、アプリは表示名ではなく内部パッケージ名で並べ替えられます。これにより、アルファベット順にブラウズしたときにアプリが予期しない位置に表示されます。たとえば、Apache AirflowとApache Supersetが予想通りに一緒に表示されない場合があります。
回避策 なし。これが将来のリリースで解決されるまで、完全なアプリリストを手動で参照してアプリを見つけます。
EPASクラスターをデータベースバックエンドとして使用する場合、メタベースの展開に失敗する#
説明 選択したデータベースクラスターがEDB Postgres Advanced
Serverインスタンスの場合、 アセットライブラリー
からのメタベースの展開は失敗します。
Metabaseは、Liquibase移行エラーERROR: syntax error at or near "$"
を含むCrashLoopBackOff 状態になります。これは、LiquibaseがEDB
Postgres Advanced
ServerをコミュニティPostgreSQLとは異なるデータベースタイプとして識別するために発生します。その結果、
dbms="postgresql" ${TEXT.TYPE} や${TIMESTAMP_TYPE}
などにスコープされたプロパティ定義はスキップされますが、依存する変更セットは未解決のプレースホルダーで実行され、
SQL構文エラーが発生します。
回避策 EDB Postgres Advanced Serverの代わりにコミュニティPostgreSQLクラスターをメタベースのデータベースバックエンドとして使用します。 EDB Postgres Advanced Serverクラスターは、展開後も分析用のデータソースとしてメタベースに接続できます。
アセットライブラリーアプリpgAdmin4およびApache SupersetはRHOSへの展開に失敗する#
!!!tip この問題は、HMバージョン1.4以降のApache Supersetで解決されました。 pgAdmin4では、この問題が引き続き発生しています。
説明: Red Hat OpenShift RHOS環境では、pgAdmin4およびApache
Supersetアセットライブラリーアプリケーションの展開が、OpenShift Security
Context
ConstraintSCC違反のため失敗します。これらのアプリのアップストリームイメージは、OpenShiftの制限されたSCCポリシーによって適用される許可UID範囲の外にある特定のユーザーIDたとえば、pgAdmin4の5050
とApache Supersetのinitコンテナの0
として実行されます。これは、上流のイメージの互換性の問題です。
回避策 この問題が上流で解決されるまで、RHOS環境にpgAdmin4またはApache Supersetを展開しないでください。
AirflowまたはSupersetの暗号キーを編集すると、アプリが障害状態になる#
!!!tip HMバージョン2026.5以降で解決されました。
説明
初期展開後にアセットライブラリーUIを介してAirflowのfernetKey
またはapiSecretKey 、またはSupersetのsecretKey
を編集すると、アプリが障害状態になります。これらのキーは、接続、変数、セッション、CSRFトークンの暗号化を含む暗号化操作に使用され、基になるHelmチャートはキーのローテーションをサポートしていません。最初の作成後にこれらの値を変更すると、新しいキーと元のキーで暗号化されたデータの間で不一致が発生し、アプリケーションが中断されます。
回避策 最初のアプリの作成後は、 fernetKey 、apiSecretKey
Airflow、またはsecretKey
Supersetを変更しないでください。キーの変更が原因でアプリが障害状態になった場合は、元のキー値で再展開して機能を復元します。
スーパーセットの展開はDuplicateTable エラーで失敗します#
説明: アセットライブラリーからスーパーセットの展開は、
DuplicateTable エラー
psycopg2.errors.DuplicateTable: relation "idx_user_id" already exists
で失敗する場合があります。これは、選択したバックエンドデータベースに、以前のスーパーセット展開からのテーブルが既に含まれている場合に発生します。
回避策 スーパーセットを展開するときに、新しい空のデータベースを使用します。
アセットライブラリー起動アプリは、カスタムポータルポートに関係なく、常にポート443を使用します#
!!!tip HMバージョン2026.5以降で解決されました。
説明 HMが443以外のカスタムportal_port 値で構成されている場合、
Estate
のアプリまたはフローURLは、構成されたポートの代わりにポート443を使用します。これにより、HMポータルが標準のHTTPSポートで公開されていない環境では、起動されたアプリまたはフローが到達不能になります。
回避策
ポート443を、アクセスするアプリまたはフローURLで構成済みのportal_port
に手動で置き換えます。
アセットライブラリーアプリのCPUおよびメモリメトリックには、失敗および完了したポッド状態が含まれます#
!!!tip HMバージョン1.4.0以降で解決されました。
説明:
アセットライブラリーアプリに表示されるCPUとメモリ使用量メトリックには、ジョブによって生成されたポッドなど、Failed
またはCompleted
状態のポッドが含まれます。これらのメトリックは、アプリの起動フェーズ中にのみ使用できるため、メトリックが安定するまで、表示される数値はアプリの現在のリソース使用量を正確に反映していない場合があります。
回避策 アプリの起動後、メトリックが安定して正しい状態を反映するまで30分間待ちます。
サービスアカウントが見つからないため、アプリまたはフローの削除が停止する#
!!!tip HMバージョン2026.5以降で解決されました。
説明
アプリまたはフローを削除すると、削除がエラーDelete failed: Preparing kapp: Getting service account: serviceaccounts "beacon-app-installer" not found
でスタックする場合があります。これは、 PackageInstall
リソースのファイナライザーが、存在しないサービスアカウントを使用しようとしているため、アプリの名前空間を削除できないために発生します。
回避策 スタックした名前空間を特定し、 PackageInstall
およびそれに関連するApp
リソースからファイナライザーを手動で削除します。
Terminatingでスタックしている名前空間を見つけます。
kubectl get ns --field-selector status.phase=Terminating
アプリ名前空間は、アプリケーションIDたとえば app-abc123xyz
と一致します。
PackageInstall名前を特定します。
kubectl get packageinstall -n <app-namespace>
名前は<app-namespace>-pkginstall 形式に従います。
PackageInstallおよび関連するAppからファイナライザーを削除しますApp名前はPackageInstall名前と一致します。
kubectl patch packageinstall <name> -n <app-namespace> --type=json -p=[{"op": "remove", "path": "/metadata/finalizers"}]
kubectl patch app <name> -n <app-namespace> --type=json -p=[{"op": "remove", "path": "/metadata/finalizers"}]
名前空間の削除が完了したことを確認します。
kubectl get ns <app-namespace>
ストレージクラスが異なる場合、RHOSでアセットライブラリーアプリが保留状態になることがある#
説明
クラスターのデフォルトのストレージクラスがspec.globalParameters.storage_class
値と異なるRed Hat OpenShiftRHOS環境たとえば、デフォルトはlvms-vm
コントロールプレーンノードによってバッキングされていますが、構成されたストレージクラスはlvms-bm
(ワーカーノードによってバッキングされた) —
pgAdmin4などの永続ボリュームを必要とするアセットライブラリーアプリは、無期限にPending
状態でスタックする場合があります。これは、アプリのPVCがクラスターのデフォルトのストレージクラスを継承するため、アプリポッドをスケジュールできるノードで使用可能な容量がない可能性があるために発生します。
回避策
アプリの展開がスタックする環境では、アプリ名前空間で保留中のPVCを削除し、
storageClassName をhcp.spec.globalParameters.storage_class
の値に設定して再作成します。または、クラスターのデフォルトのStorageClassをhcp.spec.globalParameters.storage_class
と一致するように変更して、すべての新しいPVCが自動的に正しいストレージを使用するようにします。
クラスターとアップグレード#
不変のfluent-bit-k8s-events StatefulSetが原因でバージョン2026.4へのアップグレードが失敗する#
説明 HM
2026.4にアップグレードする場合、アップグレードプロセスはupm-fluent-bit
のFailed to install component
エラーで失敗する場合があります。これは、アップグレードがfluent-bit-k8s-events
StatefulSet仕様の不変フィールドを変更しようとするため、Kubernetes
APIサーバーが拒否するために発生します。エラーメッセージはStatefulSet.apps "fluent-bit-k8s-events" is invalid: spec: Forbidden: updates to statefulset spec for fields other than 'replicas', 'ordinals', 'template', 'updateStrategy', 'persistentVolumeClaimRetentionPolicy' and 'minReadySeconds' are forbidden
です。
回避策 2026.4にアップグレードする前に、edb-observability
名前空間のfluent-bit-k8s-events
StatefulSetを手動で削除します。オペレーターは、アップグレード中に正しい構成で再作成します。
kubectl delete statefulset fluent-bit-k8s-events -n edb-observability
監視グループを使用した高度な高可用性および分散高可用性PGDクラスターのメジャーバージョンのアップグレードが失敗する#
!!!ヒント
HMバージョン2026.2以降で解決されました。
回避策 この特定のクラスター構成に対してインプレースメジャーバージョンのアップグレードを実行しないでください。代わりに、ターゲットメジャーバージョンを使用して新しい高度な高可用性または分散高可用性PGDクラスターをプロビジョニングし、データ移行サービスDMSを使用して古いクラスターから新しいクラスターにスキーマとデータを移行します。
ロギング名前空間の終了が原因でバージョン2026.3 へのアップグレードが失敗する#
!!!tip HMバージョン2026.4以降で解決されました。ただし、回避策は2026.3へのアップグレードに引き続き適用されます。
回避策オプション1推奨
バージョン2026.3へのアップグレードを開始する前に、次のコマンドを実行して、クリーンアッププロセス中に名前空間を孤立させます。
kubectl annotate namespace logging kapp.k14s.io/delete-strategy=orphan --overwrite=true
回避策オプション2ffのアップグレードは既にスタックしています
アップグレードが既に開始され、logging 名前空間がTerminating
状態でスタックしている場合、次のコマンドを実行してファイナライザーを手動で削除し、アップグレードのブロックを解除します。
kubectl patch fluentbit/fluent-bit -n logging --type=merge -p {"metadata":{"finalizers":[]}}
Agent Factory#
ナレッジベースデータは、PGDクラスターの非プライマリノードにレプリケートされません#
!!!tip HMバージョン1.4.0以降で解決されました。
説明: PGDクラスターでAIDB
7.3.0でエージェントファクトリーを使用する場合、ナレッジベースデータ
aidb.knowledge_bases_v6 ビューで可視
プライマリノードにのみ存在し、他のノードに自動的にレプリケートされません。これは、AIDB
7で導入されたaidb.knowledge_base_registry
およびaidb.knowledge_base_pipeline
テーブルがPGDセットアップスクリプトに含まれていないために発生します。
回避策 ナレッジベースを作成する前に、PGDクラスターで次のSQLコマンドを手動で実行します。
SELECT bdr.alter_sequence_set_kind(aidb.knowledge_base_registry_id_seq::regclass, galloc, 1);
SELECT bdr.replication_set_add_table(aidb.knowledge_base_registry);
SELECT bdr.replication_set_add_table(aidb.knowledge_base_pipeline);
hypopg 拡張機能が欠落しているため、インデックス分析アクションが失敗します#
説明: 必要なhypopg
拡張機能が標準のHMデータベースイメージにないため、Agent
Factoryアクションanalyze_workload_indexes
およびanalyze_query_indexes
は現在使用できません。これらのアクションを実行しようとすると、拡張機能がインストールされていないことを示すエラーが発生します。
回避策 現在、管理対象クラスターにこの拡張機能をインストールする手動の回避策はありません。拡張機能が将来のイメージ更新に含まれるまで、これらの2つの特定のアクションは使用しないでください。
削除されたクラスターはAIコンポーネントに表示されたままです#
!!!ヒント
HMバージョン2026.2以降で解決されました。
回避策 AIコンポーネントでクラスターを選択する前に、HMコンソールまたはクラスターAPIを介してそのステータスを確認します。現在「正常」または「 Active 」状態にあるクラスターのみを選択してください。
必須MCPツールパラメーターの検証の欠落#
説明 MCPツール内のいくつかのアクションでは、構成中にフィールドを空のままにすることができます。これにより、検証警告ではなく実行エラーが発生します。これらのパラメーターが入力されない場合、ワークフローはビルドに失敗するか、「Unsupported object type」エラーを返す場合があります。
影響を受けるアクションとパラメーター
list_objectsおよびget_object_detailsObject Typeフィールドは空であってはなりません。explain_queryAnalyzeおよびhypothetical_indexesフィールドには、特定のデータ型を入力する必要があります。
回避策 フローを実行する前に、次のパラメーターが手動で入力されていることを確認します。
list_objectsオブジェクトタイプtable、view、sequence、function、stored procedure、またはextensionと入力します。get_object_detailsオブジェクトタイプtable、view、sequence、またはextensionと入力します。explain_query分析TrueまたはFalseと入力します。explain_queryhypothetical_indexesツールモードを使用して、有効なリストを提供します。
一部のEDBコンポーネントツールは、互換性のないAPI要求フォーマットのため機能しない#
説明 EDBコンポーネント内の一部のツールは、互換性のないAPI要求フォーマットのため、現在機能していません。デフォルトでは、コンポーネントは公開するツールが多すぎるため、API制限を超え、エラーをトリガーする可能性があります。
回避策 ツールモードを有効にし、特定のフィルタを適用して、コンポーネントによって公開されるツールの数を制限します。
高度な高可用性と分散高可用性PGD監視グループがデータベース選択リストに表示される#
!!!ヒント
HMバージョン2026.2以降で解決されました。
回避策 これらのコンポーネントを構成するときは、監視グループとしてラベル付けされたエントリを手動で無視します。データグループのみを選択して、有効な接続と正常なデータの取得を保証します。
テキスト検索は非表示フィールドに一致する場合があります#
説明 HMコンソールの検索機能、たとえば アクティビティログ セクションを使用すると、システムはすべての基になるデータフィールドの全文検索を実行します。その結果、検索結果には、表示されている アクティビティ名 またはその他の表示属性が検索用語と一致しないように見えるリソースまたはアクティビティログエントリが含まれる場合があります。
回避策 これは、基になる検索デザインの結果であるため、現在この動作の回避策はありません。ユーザーは、検索結果には、プライマリログビューに表示されない内部アクションの詳細が含まれることに注意してください。
Langflow MCPサーバーコンポーネントはHMフローホスティングでサポートされていません#
説明 Langflow
MCPモデルコンテキストプロトコルサーバーコンポーネントを含むフローは、ハイブリッドマネージャーフローホスティングAPIを介して実行すると、次のエラーで失敗します。Error building Component my_mcp: Error updating tool list: Langflow MCP server functionality is not available. This feature requires the full Langflow installation.
HM Flow Hostingランタイム lfx-runtime
は、軽量環境です。完全なLangflowインストールが含まれます。
MCPサーバーコンポーネントを使用するフローは、正常に展開されたように見えますポッドは正常であると報告しますが、REST
APIを介して呼び出されると、実行時に失敗します。
回避策 HM Flow Hosting APIを介した展開を目的としたフローにLangflow MCPサーバーコンポーネントを含めないでください。 AirmanまたはHM MCPサーバーを実行する必要がある場合は、代わりにEDB AirmanまたはEDB Platformコンポーネントを使用します。これらのコンポーネントは、lfx-runtime環境と互換性があります。他のMCPサーバー機能の場合、代わりに完全なLangflowインタラクティブ環境を使用します。
EDB Knowledge BaseコンポーネントをLangflowにドラッグすると403エラーを返します#
!!!tip HMバージョン2026.5以降で解決されました。
説明
EDBナレッジベースコンポーネントをLangflowにドラッグすると、左下隅にエラーAPI call to .../projects/None/clusters returned 403
が表示されます。これは、コンポーネントのロード時にAPI呼び出しにプロジェクトIDが欠落しているために発生します。
回避策 コンポーネントで Hybrid Manager Project ドロップダウンを選択し、 リストの更新 を選択して使用可能なプロジェクトをロードします。プロジェクトIDが入力されると、エラーはクリアされます。
データベースユーザーのグローバル変数を使用する場合、EDB Knowledge Baseコンポーネントは接続に失敗します#
!!!tip HMバージョン2026.5以降で解決されました。
説明 データベースユーザーフィールドのグローバル変数を使用してLangflowのEDB Knowledge Baseコンポーネントを構成すると、接続試行が失敗します。初期接続セットアップ中に、このフィールドのグローバル変数値は正しく解決されません。
回避策 グローバル変数ではなく生のテキスト値としてデータベースのユーザー名を入力します。
空のナレッジベースに対してテストクエリーを実行すると、500エラーが返されます#
!!!tip HMバージョン1.4.0以降で解決されました。
説明 基になる埋め込みテーブルが空のナレッジベースに対して
ナレッジベース
リストビューからテストクエリーを実行すると、たとえば、
KBパイプラインがまだProcessing 状態にあるときに、APIはHTTP
500エラーERROR: Query returned no data. Hint: The "<pipeline_name>" table is likely empty
。 APIは代わりに空の結果セットを返す必要があります。
回避策
テストクエリを実行する前に、ナレッジベースパイプラインの処理が終了するまで待機します。データのインデックスが作成され、エンベディングテーブルにデータが設定されると、パイプラインステータスはProcessing
からアクティブ状態に変更されます。
フローホスティングの展開はFlowValidationError で断続的に失敗します#
!!!ヒント
HMバージョン2026.5以降で解決されました。
説明 Langflow UIを介してフローを作成する場合、コンポーネントのシークレットまたは資格情報フィールドはグローバル変数を使用する必要があります。パスワードを直接貼り付けると、HMフローホスティングを介してフローを展開するときにエラーが発生します。これは、Langflow v0.19からのすべてのコンポーネントのデフォルト動作です。
回避策 資格情報をグローバル変数に保存し、フロー構成で参照します。
EDB Model Serverコンポーネントは、EDB Airman MCPコンポーネントと使用するとエージェント障害が発生します#
!!!tip HMバージョン1.4.0以降で解決されました。
説明 EDB Airman MCPコンポーネントとともにEDB Model
Serverコンポーネントを使用するLangflowでエージェントフローをビルドすると、エージェントがmessages with role 'tool' must be a response to a preceding message with 'tool_calls'
のようなエラーで失敗する場合があります。この問題は断続的であり、他のモデルプロバイダーコンポーネントを使用する場合には発生しません。
回避策 EDB Model Serverコンポーネントの代わりにOpenAIコンポーネントまたは汎用モデルコンポーネントを使用します。これらの代替モデルプロバイダーを使用するフローは、この問題の影響を受けません。
upm-ai-model-server-beaco メモリ制限の不足によるOOMKills#
!!!tip HMバージョン2026.5以降で解決されました。
説明: upm-ai-model-server-beaco
ポッドは、重要なAIワークロードがある環境でのOOMKillが原因でクラッシュループに入る場合があります。このコンポーネントのデフォルトのメモリ割り当ては不十分であり、現在標準のHelm値またはHybridControlPlane
CRを介して構成できません。
回避策
Kubernetes展開に手動でパッチを適用して、upm-ai-model-server-beaco
ポッドのメモリリソース制限をデフォルトの256MBから512MBに増やし、ポッドをモニタして安定性を確認します。
更新されたLangflowフローの変更は、再公開後HMにすぐに反映されません#
説明: 以前にパブリッシュされたLangflowフローをHM Langflowエディターで編集し、アセットライブラリーに再公開すると、更新されたバージョンはHMにすぐに表示されません。変更が伝播されて表示されるまでに、最大5分の遅延が発生します。
回避策 フローを再公開した後、約5分待って、変更がHMに反映されていることを確認します。
マイグレーション#
HM移行ポータル、データ移行ワークフロー、およびスキーマ取り込みワークフローに関連する既知の問題は、 Migrating databases with Hybrid Manager ドキュメントの専用ページで維持されています。完全なリストについては、 Known issues, limitations, and notes を参照してください。