HAマルチデータセンター
複数のデータセンターにデプロイされたPostgreSQLクラスターの高可用性は、同期または非同期( replication_modes )のレプリケーションに基づいています。
どちらの場合も、次の概念を明確にすることが重要です。
Postgresは、先頭のキーを所有し、先頭のキーを更新できる場合にのみ、プライマリリーダーまたはスタンバイリーダーとして実行できます。
etcd、ZooKeeper、またはConsulノードの奇数の数(3または5)を実行する必要があります。
同期レプリケーション
ゾーンドロップを自動的に許容できるマルチDCクラスターを構築するには、少なくとも3つが必要です。
アーキテクチャ図は次のようになります。
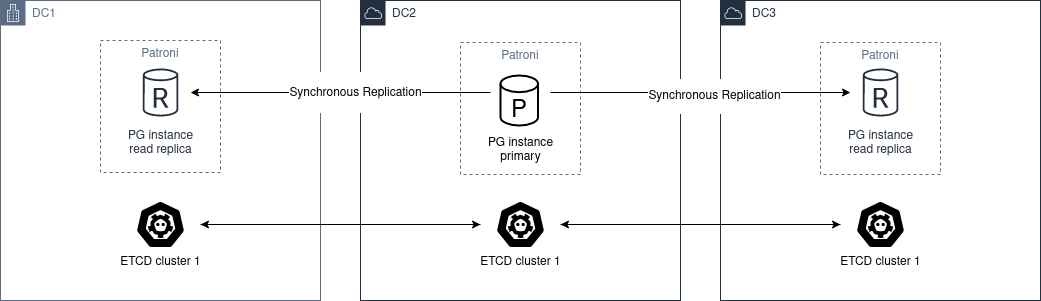
etcd、ZooKeeper、またはConsulのクラスターを別のDC経由でデプロイする必要があります。各ゾーンに1つずつ、少なくとも3つのノードが必要です。
postgresに関しては、異なるDCに少なくとも2つのノードをデプロイする必要があります。次に、グローバル synchronous_mode: true に synchronous_mode: true を設定する必要があります。
これにより同期レプリケーションが有効になり、プライマリノードはいずれかのノードを同期として選択します。
非同期レプリケーション
データセンターが2つしかない場合は、2つの独立したetcdクラスターを用意し、2番目のデータセンターでPatroni standby cluster を実行する方がよいでしょう。最初のサイトがダウンしている場合は、 standby_cluster を手動で昇格できます。
アーキテクチャ図は次のようになります。
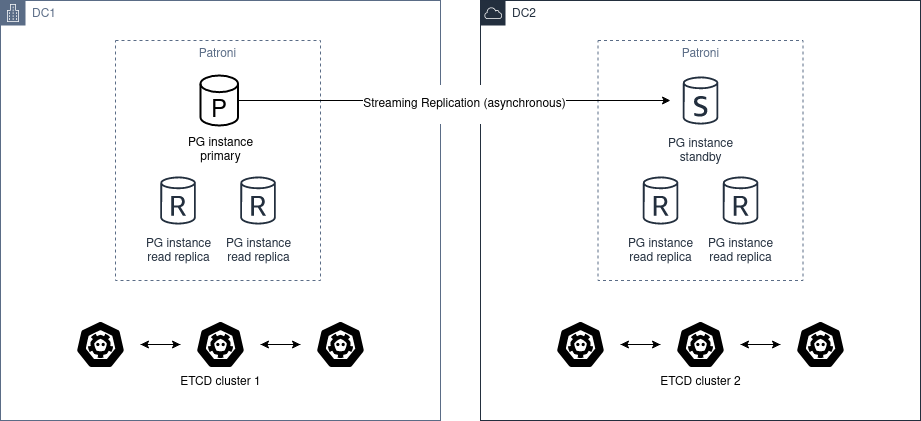
DC2はDC1の状態を決して把握できないため、自動昇格は不可能です。
このシナリオでは pg_ctl promote を使用しないでください。 pg_ctl promote から standby_cluster セクションを削除して、正常なクラスタを「手動で昇格」する必要があります。
警告
ソースクラスターがまだ稼働中で、スタンバイクラスターを昇格すると、スプリットブレインが作成されます。
「初期」状態に戻したい場合、それを解決する方法は2つしかありません。
standby_clusterセクションを追加し直すと、pg_rewindがトリガーされますが、pg_rewindが失敗する可能性があります。
スタンバイクラスターを最初から再構築します。
スタンバイクラスタを昇格させる前に、ソースクラスタが停止していることを手動で確認する必要があります(STONITH)。DC1が回復したら、クラスターをスタンバイクラスターに変換する必要があります。
これを行う前に、データベースを手動で調べて、DC1とDC2の間のネットワークが動作を停止した時点からDC1のクラスターを手動で停止した時点までの間に発生したすべての変更を抽出できます。
抽出したら、これらの変更をDC2のクラスターに手動で適用することもできます。