HAマルチデータセンター
複数のデータセンターに展開されたPostgreSQLクラスターの高可用性は、レプリケーションに基づいています。これは同期または非同期です replication modes を参照してください。
どちらの場合も、次の概念を明確にすることが重要です。
Postgresは、先頭キーを所有し、先頭キーを更新できる場合にのみ、プライマリまたはスタンバイリーダーとして実行できます。
奇数のetcd、ZooKeeperまたはConsulノード3または5を実行する必要があります。
同期レプリケーション
ゾーンドロップを自動的に許容できるマルチDCクラスターを作成するには、少なくとも3つが必要です。
アーキテクチャ図は次のとおりです。
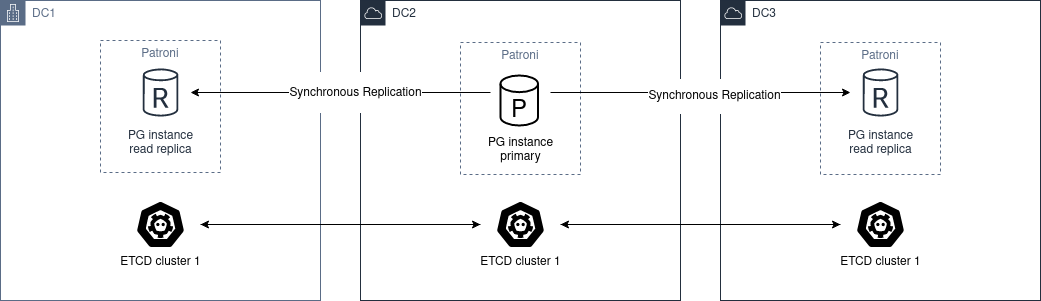
別のDCを介してetcd、ZooKeeper、またはConsulのクラスターを展開する必要があります。各ゾーンに1つずつ、少なくとも3つのノードを使用します。
postgresに関しては、少なくとも2つのノードを別のDCに展開する必要があります。次に、グローバル synchronous_mode: true で synchronous_mode: true を設定する必要があります。
これにより、同期レプリケーションが有効になり、プライマリノードはいずれかのノードを同期として選択します。
非同期レプリケーション
データセンターが2つだけの場合、2つの独立したetcdクラスターを使用し、2番目のデータセンターでPatroni standby cluster を実行することをお勧めします。最初のサイトがダウンしている場合は、 standby_cluster を手動でプロモートせることができます。
アーキテクチャ図は次のとおりです。
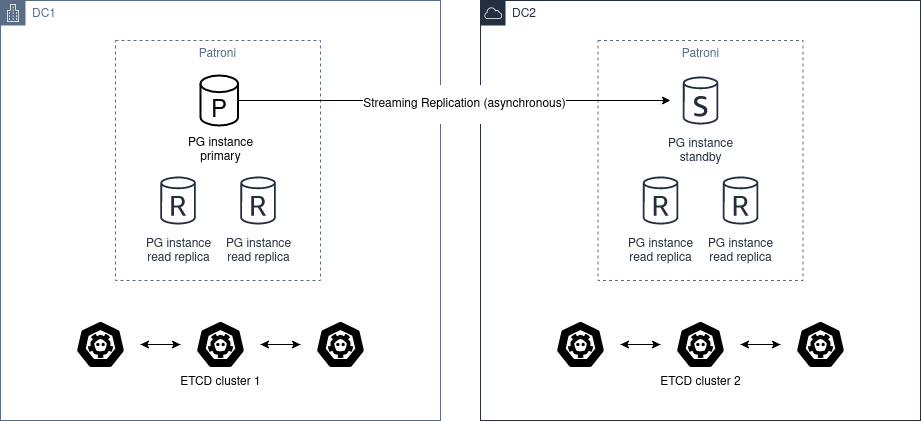
DC2はDC1の状態を理解できないため、自動プロモーションは不可能です。
このシナリオでは pg_ctl promote を使用しないでください。 pg_ctl promote から standby_cluster セクションを削除して、正常なクラスターを/"手動でプロモート"する必要があります。
警告
ソースクラスターがまだ稼働している場合、スタンバイクラスターを昇格させると、スプリットブレインが作成されます。
/"initial/"状態に戻したい場合、それを解決する方法は2つしかありません。
standby_clusterセクションを追加して戻すと、
pg_rewindがトリガーされます。ただし、pg_rewindが正常に機能するには、クラスターをdata page checksumsinitdbの--data-checksumsオプションで初期化するか、wal_log_hintsをonに設定する必要がありますが、他の要因によりpg_rewindが失敗する可能性がまだあります。スタンバイクラスターを最初から再構築します。
スタンバイクラスターを昇格する前に、ソースクラスターがダウンしていることを手動で確認する必要がありますSTONITH。 DC1が復旧したら、クラスターをスタンバイクラスターに変換する必要があります。
その前に、データベースを手動で調べて、DC1とDC2間のネットワークが動作を停止した時間からDC1のクラスターを手動で停止した時間までに発生したすべての変更を抽出できます。
抽出したら、これらの変更をDC2のクラスターに手動で適用することもできます。