Scaling with WarehousePG#
Postgres Analytics AcceleratorPGAAは、レイクハウス機能でWarehousePG 7を拡張し、別個のインフラストラクチャやデータの移動をせずにオブジェクトストレージ内のデータに対する分散分析クエリーを可能にします。 WarehousePGのPGAAには、WarehousePG 7.4以降が必要です。
機能#
WarehousePGから直接オブジェクトストレージを照会します。 ストレージの場所としてS3、Google Cloud StorageGCS、またはAzureパスを登録し、それを指すPGAAテーブルを作成し、次の使用でParquet、Delta Lake、またはIcebergファイルを照会します。 ETLやデータインポートを必要としない標準SQL 。 ストレージの場所を使用したオブジェクトストレージの照会 を参照してください。
Icebergカタログに接続する テーブル検出、スキーマとパーティションのメタデータ、および基になるオブジェクトストレージへの認証のために、外部のIceberg RESTカタログにPGAAを接続します。 EDB Postgres分散PGDがデータをオブジェクトストレージにレプリケートすると、WarehousePGは共有カタログに接続し、MPPスケールでそのデータを読み取ることができ、両方のプラットフォームでOLTPと分析ワークロードを組み合わせて使用できます。 Icebergカタログに接続する を参照してください。
Sparkでの加速 大規模なワークロードの場合、または既にSparkクラスターを運用している場合、SeafowlではなくSpark Connectを介してクエリーをルーティングします。クラスターにGPU対応ノードが含まれる場合、SparkでRAPIDSアクセラレーションを利用でき、コンピューティング集約的なクエリのスループットがさらに向上します。 Accelerating with Spark を参照してください。
バックアップと復元 gpbackupを使用して、PGAAテーブル定義とストレージバインディングをキャプチャします。復元後、テーブルはすぐに正しいオブジェクトストレージパスを参照し、手動の再構成は必要ありません。 Backing up and restoring PGAA tables on WarehousePG を参照してください。
監視と保守 テーブルの状態を監視し、PGAAテーブルで圧縮やバキュームなどのメンテナンス操作を実行します。 WarehousePGでは、メンテナンスワーカーはコーディネーターでのみ実行されます。 Monitoring and maintaining analytical tables を参照してください。
現在の制限については、 Known issues を参照してください。
WarehousePGでPGAAを使用する場合#
次の場合にPGAAを選択します。
オープンテーブルフォーマットIceberg、Delta Lakeを照会する必要があります。
PGDなどの他のパイプラインと共有するIceberg RESTカタログにアタッチし、カタログ管理の認証を活用して、複製せずにMPPスケールでデータを照会したい。
より高速な分析クエリーが必要です。 PGAAのベクトル化エンジンは、行ごとではなく列方向のバッチでデータを処理します。
Spark Connectを介してクエリーをルーティングするか、GPUアクセラレーション実行のためにRAPIDSを使用したい。
考慮すべき現在の制限事項
PGAAは、標準のPostgreSQLプランナーのみをサポートし、Orcaはサポートしていません。
PGAAテーブルは読み取り専用です。
アーキテクチャの概要#
WarehousePGのPGAAは、オプションのIcebergカタログとSpark統合を使用して、ベクトル化クエリエンジンを介してクラスターのコーディネーターとセグメントホストをオブジェクトストレージに接続します。
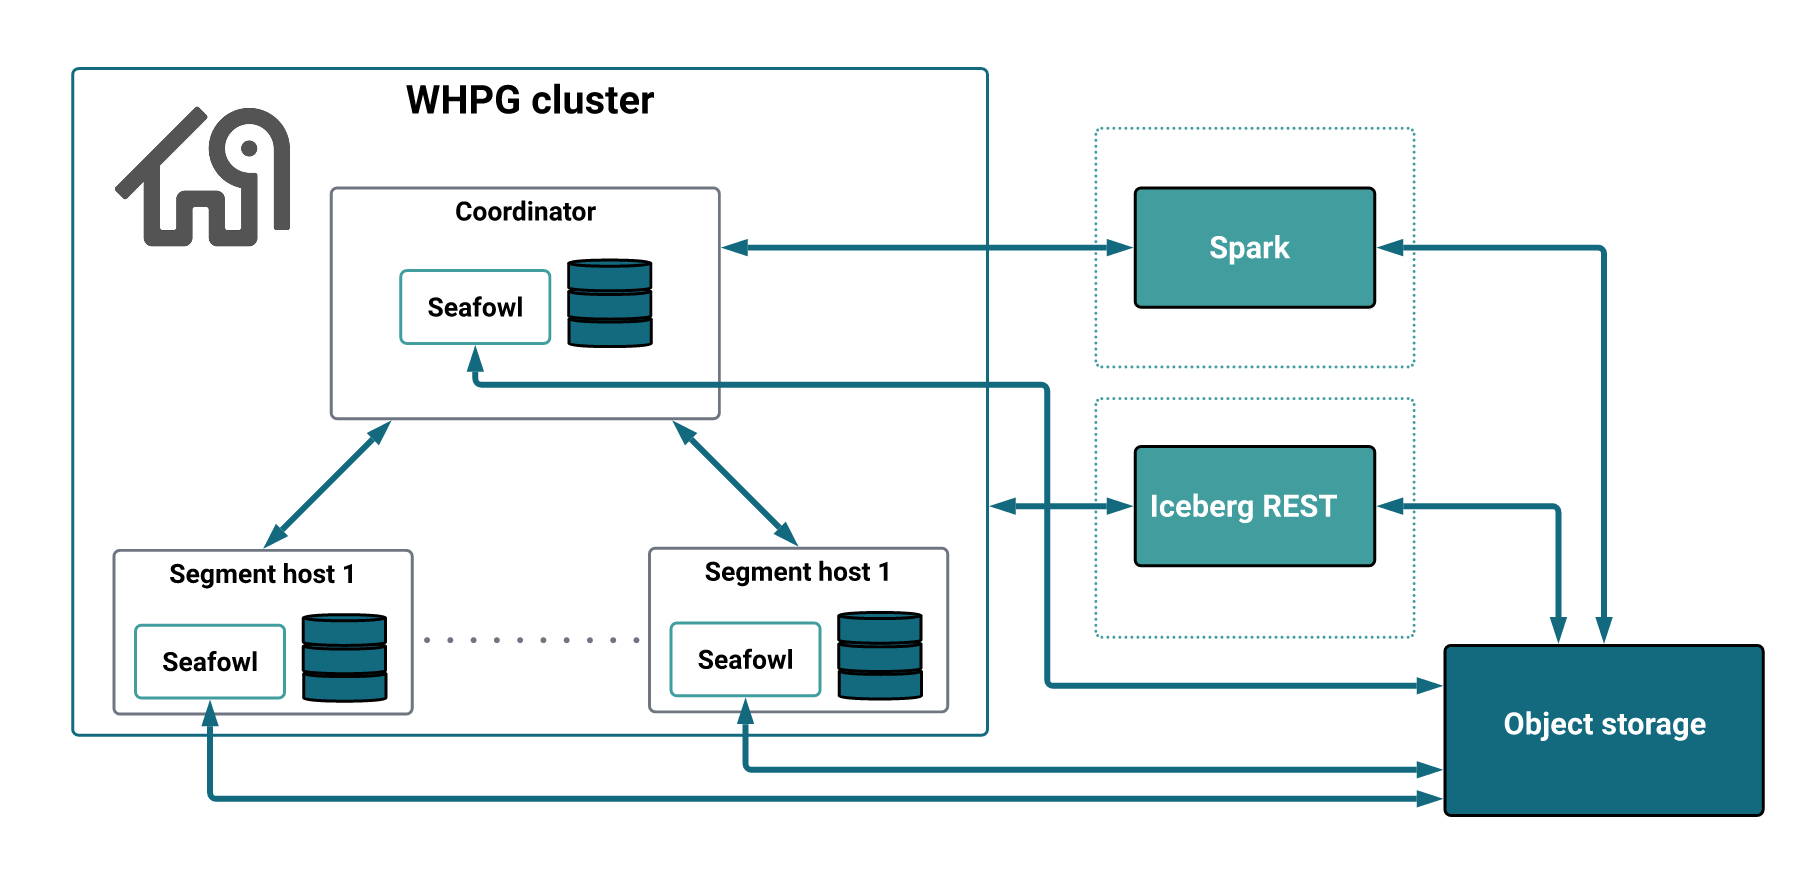
PGAA on WarehousePG architecture diagram#
コアコンポーネント#
WarehousePG WHPG
コーディネーターホストと複数のセグメントホストで構成されるPostgresベースの超並列処理MPPデータベース。コーディネーターはクエリのプランニングとディスパッチを処理し、セグメントはクエリを並列実行します。
PGAA拡張機能
WarehousePGクエリプランナーと統合して、分析エンジンにオフロードできるクエリを特定します。デフォルトのベクトル化実行エンジンとしてSeafowlをバンドルし、分析テーブルのメタデータを管理し、Postgresプロセスとクエリ実行プログラム間の通信を調整します。
PGFS拡張機能
オブジェクトストレージ接続のストレージレイヤーを提供するPGAAの依存関係。資格情報管理を処理し、S3、GCS、およびAzureへのアクセスを抽象化します。
シー鳥
PGAAにバンドルされたベクトル化クエリエンジン。
WarehousePGインストールでは、SeafowlはWHPGコーディネーターと各セグメントホストでsystemd
サービスとして実行され、コーディネーターのみと分散クエリーの実行の両方を有効にします。
Iceberg RESTカタログオプショナル
テーブルスキーマ、パーティション、およびスナップショットを追跡する外部メタデータレジストリ。 PGAAは、登録されたカタログを介して、基になるオブジェクトストレージへのテーブル検出と認証を有効にします。
Sparkクラスターオプション
代替実行エンジンとして使用される外部Apache Sparkクラスター。 Spark Connectを介して構成された場合、WHPGコーディネーターはSeafowlではなくSparkにクエリーを転送します。
オブジェクトストレージ
分析データのソース。 PGAAは、S3、GCS、およびAzureをサポートし、WarehousePGへのデータインポートはせずに、クエリ時にParquet、Delta Lake、およびIcebergファイルの直接照会をサポートしています。
WarehousePGでのPGAAの仕組み#
PGAAは、分析テーブルが定義およびオブジェクトストレージにバインドされるストレージレイヤーと、プランナーとベクトル化クエリエンジンが連携してクラスター全体にクエリを分散および実行するクエリ実行レイヤーの2つのレベルでWarehousePGと統合します。
分析テーブルの作成#
PGAAは、カスタムテーブルアクセス方法 pgaa を提供し、
WarehousePGにデータをインポートせずに、標準のSQLを介してオブジェクトストレージにあるテーブルを定義および照会できます。
PGAAカタログテーブルはDISTRIBUTED REPLICATED
ポリシーを使用し、すべてのノードでメタデータを利用できるようにします。
PGAAテーブルは読み取り専用で、書き込み操作をサポートしていません。データは、オブジェクトストレージに既に存在する必要があります、たとえば、PGDまたは別のパイプラインによって書き込まれます。
クエリーの実行#
データが特定のセグメントホストに固定されるネイティブのWarehousePGテーブルとは異なり、PGAAデータはオブジェクトストレージに存在し、任意のノードからアクセスできるため、PGAAに各クエリーに対して最も効率的な実行戦略を選択する自由度を与えます。
注釈
PGAAは、標準のPostgreSQLプランナーのみをサポートし、Orcaオプティマイザーはサポートしません。
PGAAは、2つのエンジンのいずれかを介してクエリーを実行します。PGAAにバンドルされたデフォルトのベクトル化エンジンであるSeafowl、またはSparkクラスターをポイントするようにSpark Connectを構成する場合のSpark。
Sparkがアクティブなエンジンである場合、コーディネーターは、セグメントホストを関与させずに、Spark Connectを介してクエリーをSparkクラスターに転送します。 Sparkは、Seafowlスキャンモードとは無関係に、独自の計画と配布を処理します。
Seafowlがアクティブなエンジンの場合、PGAAはクエリの性質に応じて2つのスキャンモードのいずれかを選択します。
DirectScan PGAAは、セグメントホストを関与させずに、コーディネーター上のSeafowlにクエリを完全にオフロードします。
CompatScan クエリーに、ネイティブWarehousePGヒープテーブルとの結合など、Seafowlが処理できない操作が含まれる場合に使用されます。 PGAAは、テーブルごとに、2つの候補実行プランをWarehousePGプランナーに提案し、プランナーは安価な方を選択します。
Strewn locus MPP スキャンはすべてのセグメントホストに分散され、それぞれがデータの一部を並列して読み取ります.
一般的な軌跡 テーブル全体をコーディネーターとすべてのセグメントで処理できます。 aggregation pushdown を有効にすると、コーディネーターは結果を返す前に集計を処理します。これにより、クライアントに返されるデータをさらに削減できます。
両方の戦略を組み合わせると、異なるサイズのPGAAテーブル間の結合に特に役立ちます。たとえば、小さなテーブルを大きなテーブルに対して結合する場合、プランナーは小さなテーブルの一般軌跡を使用し、すべてのセグメントで完全にスキャンしてローカルハッシュマップにロードできますが、大きなテーブルにStrown軌跡を使用します。各セグメントは、その部分のみを読み取ります。結合は、ホスト間でデータをシャッフルせずに、各セグメントでローカルに実行されます。
Engine |
Scan mode |
Execution |
|---|---|---|
Seafowl |
DirectScan |
Coordinator only. |
Seafowl |
CompatScan |
Coordinator and every segment scan the full table (General locus), or each segment reads a portion of the data in parallel (Strewn locus), based on cost. |
Spark |
SparkDirectScan |
Spark cluster via coordinator only. |
Seafowlスキャンモードの詳細な説明については、 スキャンタイプを理解する を参照してください。