
Implementing tiered tables#
階層テーブルは、 Postgres Distributed PGD AutoPartitionとPostgres Analytics Accelerator PGAAを組み合わせて、自動化されたデータライフサイクルを作成することにより、ユニファイドストレージアーキテクチャを提供します。標準ヒープテーブルが階層構造に変換されると、システムは手動介入なしでトランザクションストレージから分析ストレージへのデータの移行を管理し、ストレージコストを最適化するゼロタッチデータライフサイクル管理を提供します。
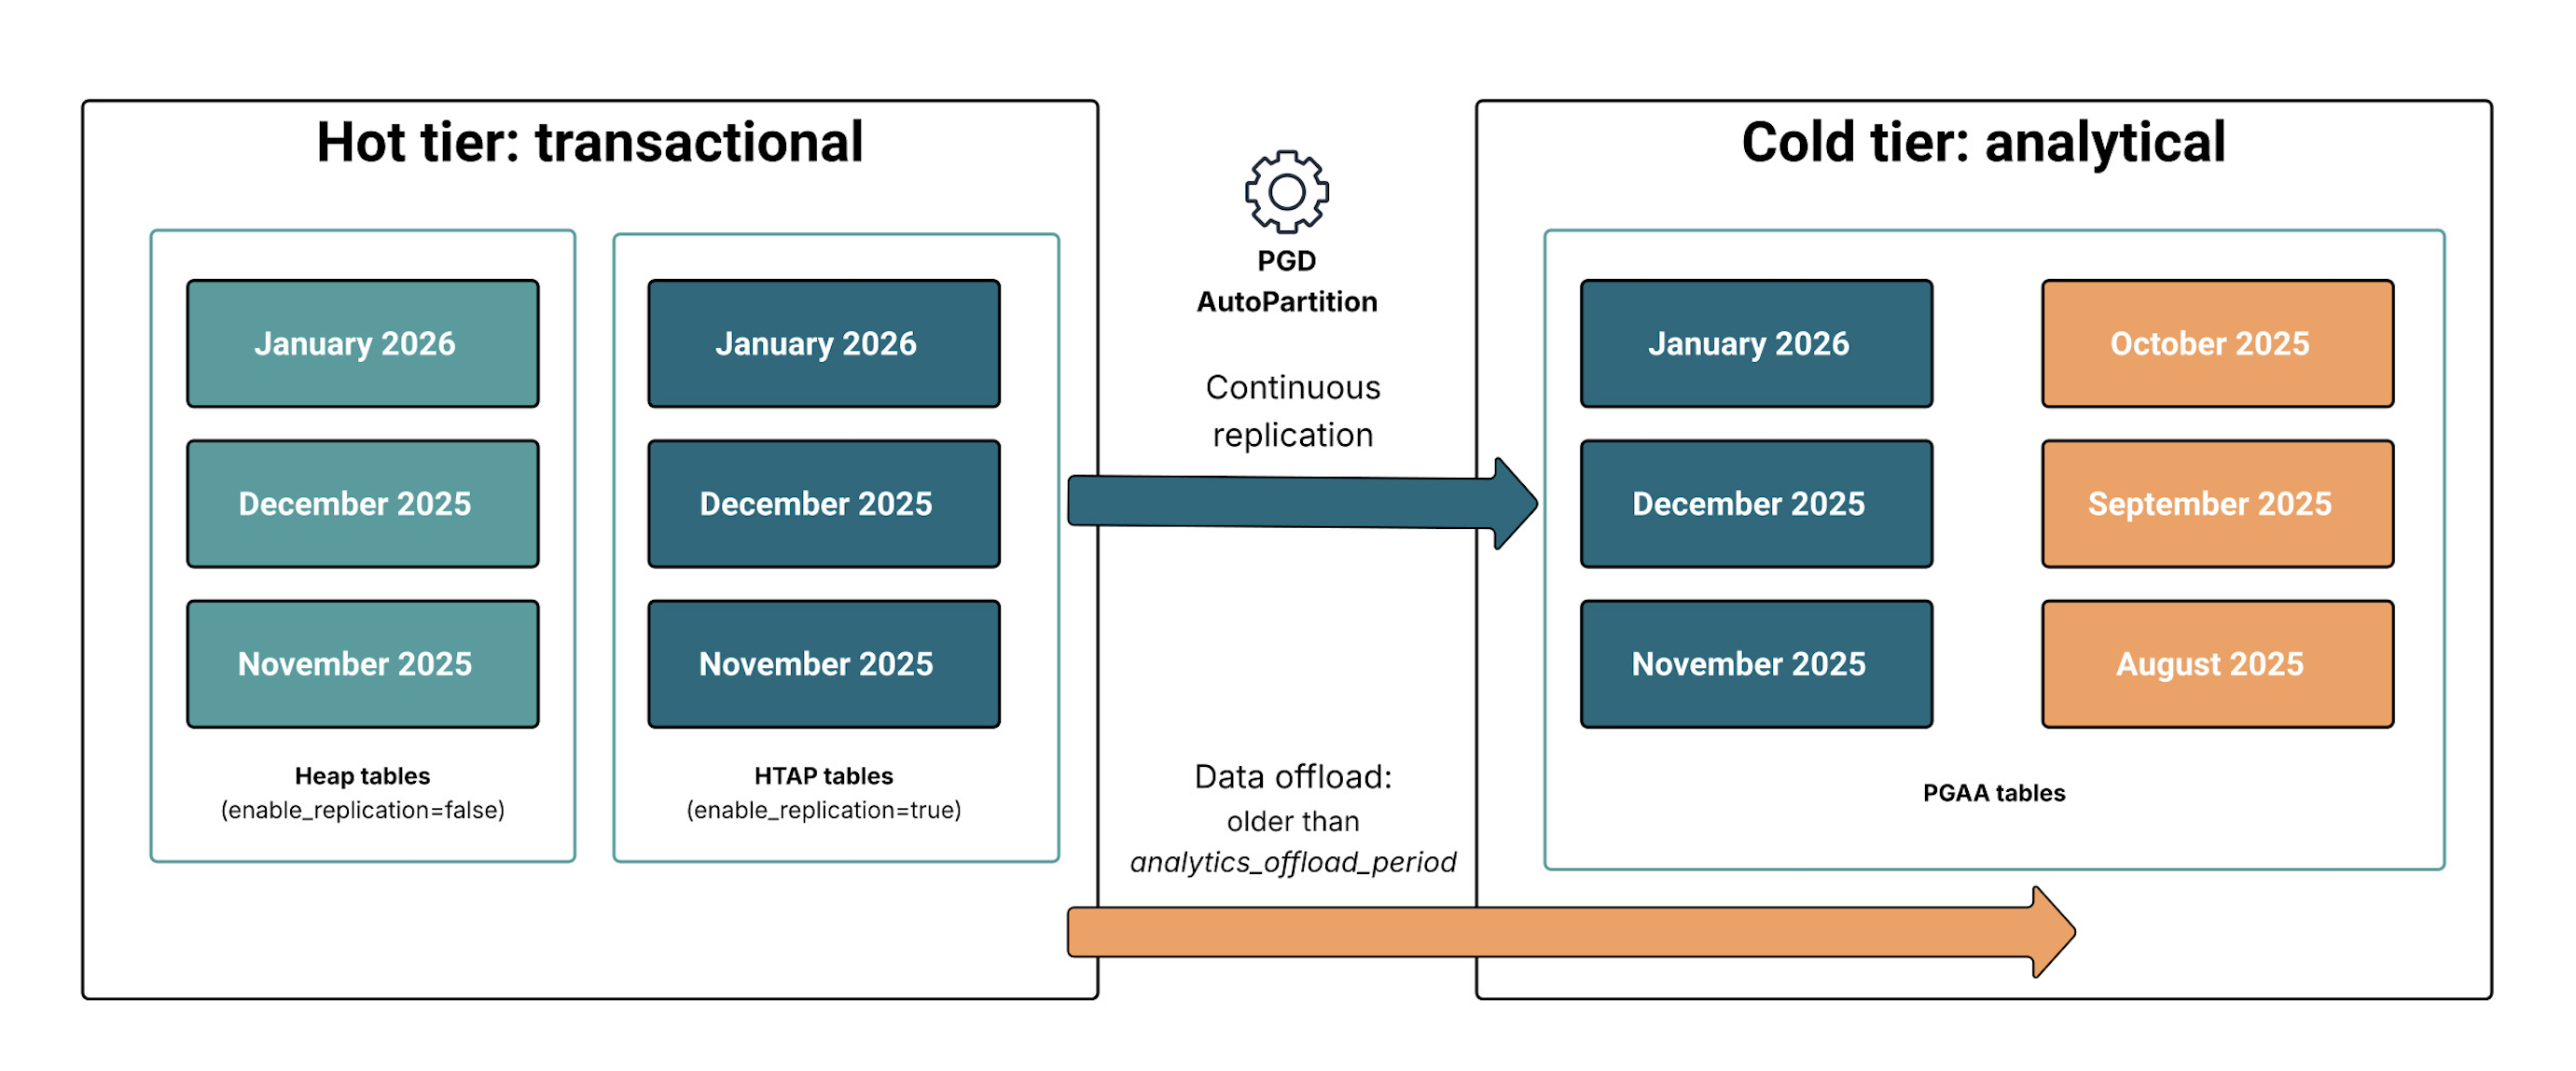
tiered_tables#
このアーキテクチャでは、クエリはホットとコールドの両方のデータ層にシームレスにまたがり、物理的な場所に関係なくデータセット全体への単一アクセスポイントを提供します。最近のデータは、高性能のトランザクション処理のためにローカルヒープパーティションに残りますが、古いコールドパーティションは、定義された経過期間のしきい値を超えると、オブジェクトストレージに透過的にオフロードされます。
pgaa.convert_to_tiered_table()
を呼び出すことにより、標準ヒープテーブルはハイブリッドパーティション構造に変換されます。
ホット層 最近のデータは、ローカルヒープパーティション、またはレプリケーションが有効になっている場合はハイブリッド分析およびトランザクション処理HTAPテーブルに残ります。 HTAPの場合、PGAAはIceberg Merge-on-ReadMoRを使用して、軽量の「削除ファイル」として更新と削除をキャプチャします。これにより、大規模なデータブロックの書き換えのオーバーヘッドなしで、クラウド層の同期が維持されます。
コールド層 パーティションが
analytics_offload_periodで定義された経過時間しきい値を超えると、データレイクのPGAAテーブルに自動的に変換されます。ローカルストレージは再利用されますが、データは同じテーブルインターフェイスを介して透過的に照会可能なままです。
プロセスの概要#
ヒープテーブルを階層テーブルに変換するには、次の手順を実行します。
Getting started 保存場所またはカタログサービスのいずれかを選択します。
pgaa.convert_to_tiered_table()ファンクションを使用して ヒープテーブルの階層テーブルへの変換 。階層化テーブルのモニタリング 自動オフロード。
ストレージニーズの進化に応じた 階層化テーブルの変更と無効化 設定。
ヒープテーブルの階層テーブルへの変換#
pgaa.convert_to_tiered_table()
ファンクションは、自動オフロードプロセスを開始します。
enable_replication がtrue
の場合、継続的レプリケーションのためにアクティブなパーティションをHTAPテーブルに変換します。例
CALL pgaa.convert_to_tiered_table(
    relation := my-transactional-table::regclass,
    range_partition_column := date,
    partition_increment := 1 month,
    analytics_offload_period := 1 year,
    initial_lower_bound := 2010-01-01,
    retention_period := 5 years,
    enable_replication := true,
    minimum_advance_partitions := 2,
    maximum_advance_partitions := 5,
    drop_after_retention_period := true,
    purge_analytics_target := true
);
そこで
relation階層化テーブルに変換するヒープテーブルの名前。range_partition_columnレンジパーティション化に使用される列。DATEまたはTIMESTAMPであり、主キーに含まれる必要があります。partition_increment各パーティションのサイズを定義する時間間隔。analytics_offload_periodパーティションがローカルストレージからデータレイクのコールド層に移動される経過期間のしきい値。initial_lower_bound最初のパーティションの下限の開始値。retention_periodデータがコールド層からパージされる期間。enable_replicationtrueの場合、アクティブなパーティションのオブジェクトストレージへのリアルタイムレプリケーションをHTAPテーブルとして有効にします。falseの場合、ホットパーティションはヒープテーブルとして残ります。minimum_advance_partitions維持する将来のパーティションの最小数。maximum_advance_partitions維持する将来のパーティションの最大数。drop_after_retention_period保持期間の有効期限が切れた後、パーティションをローカルにドロップするかどうか。purge_analytics_targettrueの場合、オブジェクトストアディレクトリまたはカタログエントリに既存のテーブルが削除されます。falseに設定されており、既存のテーブルが検出された場合、コマンドはエラーで失敗します PGD 6.3以降でサポートされています。
注釈
レンジパーティションに使用される列は、主キーである必要があります。
シーケンスまたは外部キー制約を含むテーブルは、階層テーブルではサポートされていません。階層テーブルに変換する前に、シーケンスまたはコンストレインを削除する必要があります。
階層化テーブルは、すべてのパーティションのUNION
を実行する統合ビューを作成し、データライフサイクル全体で単一のクエリインターフェイスを提供します。
bdr.prefer_analytics_engine
パラメーターを有効にして、階層テーブル全体のクエリーをSeafowlエンジンにルーティングできます。
SET bdr.prefer_analytics_engine = TRUE;
enable_replication がtrue
の場合、この設定はパーティションテーブル全体のDirectScanを有効にし、Seafowlは単一のパスでオフロードされたコールドデータとレプリケートされたホットデータの両方に対してクエリを実行できます。
注釈
ストレージ場所ベースのレプリケーションを使用する場合、パーティション分割テーブルのユニオンビューはSeafowlエンジンでのみサポートされ、Sparkを介してアクセスできません。カタログサービスを使用する場合、SeafowlとSparkの両方を介してユニオンビューにアクセスできます。
階層化テーブルのモニタリング#
pgaa.list_tiered_tables()
ファンクションは、現在自動化されたライフサイクル管理が行われているすべてのテーブルの高レベルの概要を提供します。その出力は、どのヒープテーブルが階層化テーブルに正常に変換されたか、どのパーティション化ロジックが適用されているか、およびローカルストレージとオブジェクトストレージ間の現在のバランス階層化および非階層化データサイズを特定するのに役立ちます。
SELECT * FROM pgaa.list_tiered_tables();
bdr.analytics_table
ビューを照会して、Postgresスキーマと基になる分析エンジン間の低レベルのマッピングを表示します。このテーブルは、ローカルノードグループとリモート分析ターゲットの関係を追跡します。
SELECT * FROM bdr.analytics_table;
次のクエリを使用して、ホットパーティションとコールドパーティションを区別します。
SELECT
    relname AS partition_name,
    amname AS access_method
FROM pg_class c
JOIN pg_am am ON c.relam = am.oid
WHERE relname LIKE my-transactional-table%
  AND c.relkind = r
ORDER BY relname;
階層化テーブルの変更と無効化#
PGDとPGAAコマンドを組み合わせて使用して、ライフサイクルポリシーを変更したり、標準のパーティションテーブルに戻すことができます。
ライフサイクル設定の調整
bdr.autopartition() ファンクションを実行する既存の階層テーブルのパーティション化とオフロードロジックを更新できます。
これは、オフロードしきい値を短縮または拡張する必要がある場合に特に役立ちます。たとえば、
analytics_offload_period
を1か月から3か月に変更するには、次のコマンドを実行します。
SELECT bdr.replicate_ddl_command($$
  SELECT bdr.autopartition(
    relation := public.my-transactional-table,
    partition_increment := 1 month,
    partition_initial_lowerbound := 2020-01-01,
    analytics_offload_period := 3 months
  )
$$);
詳細は、 AutoPartition in PGD を参照してください。
警告
これらの設定の変更は、新しいパーティションにのみ影響し、既存のデータは再編成されません。パーティションサイズを増やしても、システムは現在の小さなパーティションをマージしません。現在のセットが使い果たされると、より大きなパーティションの作成が開始されます。新しいオフロードタイミングはすべてのパーティションに適用されますが、以前の設定で作成された物理構造は変更されません。 !!!
レプリケーションステータスの変更
enable_replication
の現在の設定を変更する場合は、パーティションのレプリケーションステータスを管理する必要があります。
親テーブルに対してpgaa.enable_analytics_replication()
またはpgaa.disable_analytics_replication()
ファンクションを使用して、階層全体の一貫性を保証します。
CALL pgaa.enable_analytics_replication(my-transactional-table::regclass);
親テーブルに対してALTER TABLE
を使用すると、将来のパーティションのenable_replication
の値のみが設定されます。既存の子パーティションは遡って更新されません。既存のすべてのパーティションでALTER TABLE
コマンドを手動で実行して、データ全体の一貫性を保証する必要があります。
階層テーブルの無効化
標準のパーティションヒープテーブルに戻すには
enable_replicationがアクティブであった場合、親テーブルのレプリケーションを停止します。
CALL pgaa.disable_analytics_replication(my-transactional-table::regclass);
コールドパーティションを復元します。コールドパーティションごとに、次を実行します。
pgaa.restore_from_analytics(partition_name);
またはALTER TABLE partition_name SET ACCESS METHOD heap;
を使用します。
親テーブルから階層テーブルフラグを削除します。
ALTER TABLE my-transactional-table SET (pgaa.tiered_table = false);
AutoPartitionを停止しますオプショナル。テーブルが新しいパーティションを完全に作成しないようにするには、次のコマンドを実行します。
bdr.drop_autopartition(my-transactional-table);
テーブルが
SELECT * FROM pgaa.list_tiered_tables()を使用して階層テーブルとしてリストされていないことを確認します。すべてのパーティションがアクセス方法として
heapをリストしていることを確認します。
SELECT
    c.relname AS partition_name,
    a.amname AS access_method
FROM pg_class c
JOIN pg_am a ON c.relam = a.oid
WHERE c.relname LIKE my-transactional-table%
  AND c.relkind = r;