Exploring failover handling with PGD
高可用性クラスターでは、フェールオーバー機能はクラスターの全体的な復元力にとって重要です。リードデータノードが何らかの理由で動作を停止した場合、アプリケーションはほとんど、またはまったく中断せずにデータベースの操作を継続できる必要があります。 PGDの場合、これは、アプリケーションを新しいリードデータノードに転送することを意味し、自動的に引き継ぎます。これがPGDプロキシが役立つ場所です。クラスターと連携し、トラフィックをリードデータノードに自動的に転送します。
この演習では、データベースに定期的にデータを送信するアプリケーションを作成します。次に、PGD CLIで変更を要求することにより、最初にリードデータノードをソフトに切り替えます。次に、データベースインスタンスを強制的にシャットダウンし、PGDがそれをどのように処理するかを確認します。
クイックスタート構成
この探索では、 quick start for Docker 、 quick start for AWS 、または quick start for Linux hosts を使用してPGDクラスターを作成したことを前提としています。
各クイックスタートの最後には、4つのノードと次のロールを持つクラスターが作成されます。
Host name |
Host role |
|---|---|
kaboom |
PGD data node and pgd-proxy co-host |
kaftan |
PGD data node and pgd-proxy co-host |
kaolin |
PGD data node and pgd-proxy co-host |
kapok |
Barman backup node |
この演習では、これらのホスト名を使用します。
xpanesのインストール
xpanes
を使用します。これは、簡単に切り替えることができる複数のターミナルセッションをすばやく作成できるユーティリティです。デフォルトではインストールされないため、インストールする必要があります。この演習では、
tpaexec
を実行してクイックスタートクラスターを構成したシステムからxpanesを起動します。
システムでUbuntuを実行している場合は、次を実行します。
sudo apt install software-properties-common
sudo add-apt-repository ppa:greymd/tmux-xpanes
sudo apt update
sudo apt install tmux-xpanes
これらは the xpanes repository からのインストール手順です。 Ubuntuを使用していない場合、リポジトリには他のシステムのインストール手順も含まれています。
4つのサーバーへの接続
xpanesがインストールされたら、次を実行して、4つすべてのサーバーとのSSHセッションを作成できます。
cd democluster
xpanes -d -c "ssh -F ssh_config {}" "kaboom" "kaolin" "kaftan" "kapok"
これらのコマンドを実行すると、4つのペインが表示されます。 4つのペインはkaboom、kaolin、kaftan、およびkapokに接続され、それぞれにrootユーザーとしてログインします。演習の後半でサービスを簡単に停止および開始できるように、この特権が必要です。
Control-b を押してから q を押して、各ペインの数値を簡単に表示します。
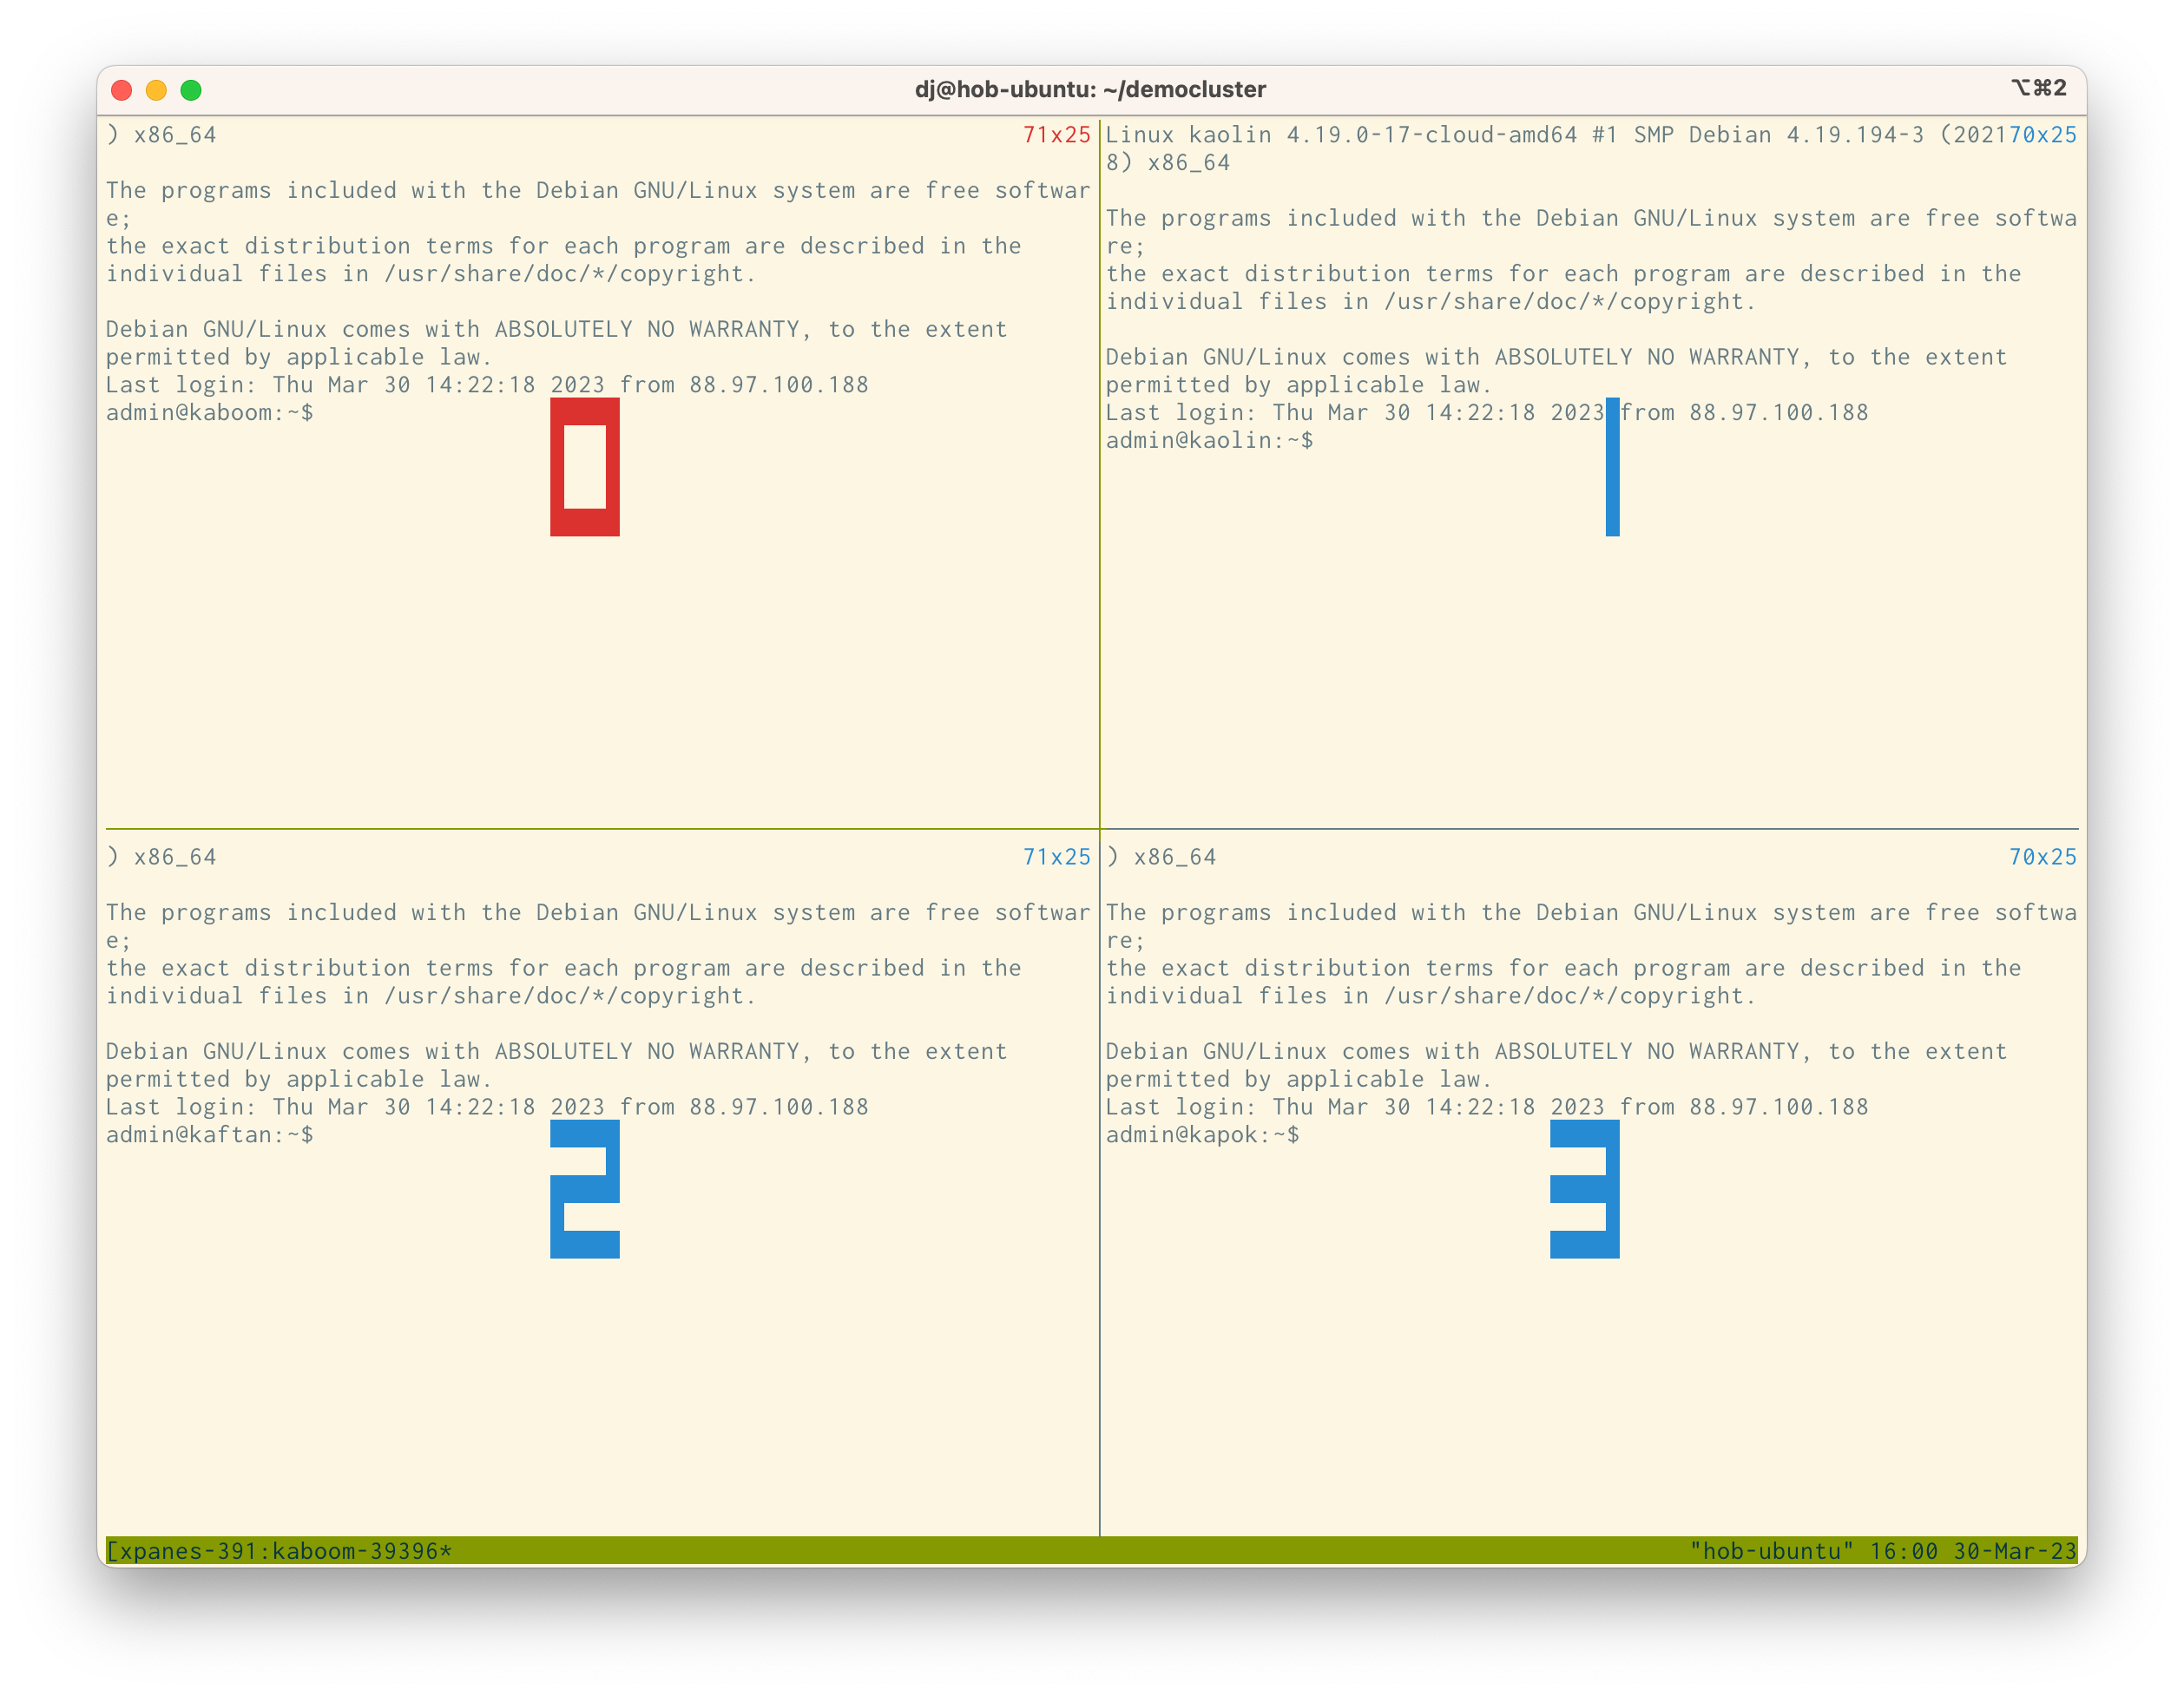
4 SSH Sessions showing numbers
ペイン間でフォーカスを切り替えるには、 Control-b とカーソルキーを使用してペイン間を移動できます。または、 Control-b を使用し、その後に q とフォーカスするペインの番号を入力します。両方の方法を示します。
Control-b↓を使用します。Control-b→ または Control-bq3 して、フォーカスをkapokホストである右下のペインに移動します。このサーバーは、バックアップの実行を担当します。これは、デモアプリケーションの操作のベースとして使用します。 Barmanの資格情報を使用して、データベースサーバーとプロキシに接続できます。
sudo -iu barman
psql -h kaboom -p 6432 bdrdb
このコードはkaboomホスト上のプロキシに接続します。ホストはクラスターの一部としてPostgresインスタンスも実行します。
次のステップでは、アプリケーションが書き込むテーブルを作成します。
drop table if exists ping cascade;
CREATE TABLE ping (id SERIAL PRIMARY KEY, node TEXT, timestamp TEXT) ;
このコードは、最初にping テーブルを削除します。次に、
id主キーと、ノードとタイムスタンプ用の2つのテキストフィールドを使用して、
ping
テーブルを再作成します。これでテーブルの準備ができました。確認するには、
Control-b←を使用します。Control-b↑ または Control-bq0
して左上のペインに移動し、kaboomサーバーに接続します。このペインで、enterprisedbユーザーになり、データベースに簡単に接続できます。
sudo -iu enterprisedb
次を実行して、ローカルデータベースに接続できます。
psql bdrdb
このコマンドは、kaboom上のローカルデータベースインスタンスに直接接続します。
\dt を使用して、使用可能なテーブルを表示します。
bdrdb=# \dt
       List of relations
 Schema | Name | Type  | Owner
- -------+------+-------+--------
 public | ping | table | barman
(1 row)
\d ping
を実行すると、pingを作成するDDLがkaboomサーバー上にあることが示されます。
edb_notranlate_7このテーブルが複製されていることを確認したい場合は、クラスター内の別のノードに接続して見ることができます。
psqlの\c コマンドを使用すると、別のサーバーに接続できます。
Kaftanノードに接続するには、次を実行します。
\c - - kaftan
次のようなログインメッセージが表示されます。
psql.bin (15.2.0 (Debian 15.2.0-2.buster), server 15.2.0 (Debian 15.2.0-2.buster)) SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off)
You are now connected to database "bdrdb" as user "enterprisedb" on host "kaftan" (address "10.33.25.233") at port "5444".
bdrdb=#
\dt および\d ping
を実行すると、kaftanノードで同じ結果が表示されます。
kaboomノードに再接続するには、次を実行します。
\c - - kaboom
モニターのセットアップ
次に、pingテーブルのアクティビティを監視します。次のSQLを入力して、最新の10件のエントリを表示します。
select * from ping order by timestamp desc limit 10;
このコマンドを複数回実行するには、シェルで\watch
コマンドを使用します。これにより、定期的に最後のクエリが実行されます。毎秒更新するには、次のように入力します。
\watch 1
これまでのところ、見るものは何もありません。すぐにアクティビティを追加します。
pingの作成
Control-b↓を使用して、Barmanホストカポックに戻ります。Control-b→ または Control-bq3 。
このセッションはまだpsqlセッションにログインしています。次にシェルスクリプトを実行するため、 psqlを終了する必要があります。 Control-d を押します。
シェルプロンプトに次のように表示されます。
barman@kapok:~$
admin@kapok またはroot@kapok と書かれている場合は、
sudo -iu barman を実行してBarmanユーザーに戻ります。
作成するアプリケーションはシンプルです。書き込むノードとpingのタイムスタンプを取得します。次に、できるだけ早く、新しいpingをpingテーブルに書き込みます。
シェルで、次のように入力します。
while true; do psql -h kaftan,kaolin,kaboom -p 6432 bdrdb -c "INSERT INTO ping(node, timestamp) select node_name, current_timestamp from bdr.local_node_summary;"; done
より読みやすい形式で、つまり:
while true;
    do psql -h kaftan,kaolin,kaboom -p 6432 bdrdb -c \
        "INSERT INTO ping(node, timestamp) select node_name, current_timestamp from bdr.local_node_summary;"
    done
定数ループでは、
psqlコマンドを呼び出し、ホストとして3つのプロキシのいずれかに接続するように指示し、プロキシポートを提供し、
bdrdbデータベースを選択します。また、2つの値をpingテーブルに挿入するコマンドを渡します。値の1つは、実際に接続しているノードの名前を含むbdr.local_node_summary
から取得されます。もう1つの値は現在の時刻です。
ループが実行されると、新しいエントリがテーブルに表示されます。モニターをセットアップする左上のペインにそれらが表示されます。
これで、フェールオーバーのテストを開始できます。
書き込みリーダーの表示
プロセスのこの部分では、左下隅にあるホストkaftanに切り替えます。 Control-b← または Control-bq2 を使用して、フォーカスを切り替えます。
pgd
を実行するための適切な特権を取得するには、PGDコマンドラインインターフェイスで次を実行します。
sudo -iu enterprisedb
クラスターの状態を表示するには、次を実行します。
pgd show-groups
次のような出力が表示されます。
Group        Group ID   Type   Parent Group Location Raft Routing Write Leader
- ----        --------   ----   ------------ -------- ---- ------- ------------
democluster  1935823863 global                       true false
dc1_subgroup 1302278103 data   democluster  dc1      true true    kaboom
グローバルグループdemocluster
には、すべてのサブグループが含まれます。 dc1_subgroup
は、使用しているデータクラスターです。そのグループ名の値は、このクラスターを構成したときにクイックスタートで指定された場所から派生します。各ロケーションは独自のサブグループを取得するため、他のロケーションまたはクラスターとは無関係に管理できます。
表の右側にスキップすると、グループの現在の書き込みリーダー(すべてのプロキシが更新を送信するサーバー)がkaboomであることがわかります。
switchover
コマンドをクラスターグループに送信して、リーダーを変更します。次のコマンドを実行します。
edb_notranlate_33 ノード名は、dc1_subgroupグループ内の別のデータノードのホスト名です。
2つの応答のいずれかが表示されます。 show-groups
コマンドを実行したとき、書き込みリーダーとしてkaolinが表示された場合、次のように表示されます。
Error: "kaolin" is already a write leader
これは、カオリンがすでに書き込みリーダーに選出されたことを意味するため、切り替えても効果はありません。この演習では、ノード名をkaboomまたはkaftanに置き換えて、別のホストへのスイッチオーバーを再試行します。
現在の書き込みリーダーではないホストを選択すると、他の応答が表示されます。
switchover is complete
左上のペインを見ると、スクリプトからの挿入が切り替えられ、切り替えたばかりのノードに書き込まれていることがわかります。
!!!Info ID番号を観察する 生成されているID番号は、値の完全に異なる範囲からのものであることに注意してください。これは、システムがIDを生成するシーケンスを透過的にグローバルシーケンスにしたためです。グローバルシーケンスとそれらが
bdr.シーケンス でどのように機能するかについてもっと読む。
ノードを失う
リーダーを切り替えることができることは、計画的なメンテナンスに役立ちます。クラスターに構成を変更するように指示します。予期せぬ変化が起こったら?ここで、そのシナリオを作成します。
左下のペインで、リーダーをカオリンに設定します。
pgd switchover --group-name dc1_subgroup --node-name kaolin
次に、 Control-b↑を使用して、フォーカスを右上のペインに変更します。Control-b→ または Control-bq1 、これはカオリンホストでのセッションです。
次を実行して、Postgresサーバーをオフにします。
sudo systemctl stop postgres.service
左上のペインには、クラスターサブグループが新しいリーダーを選択すると、監視対象テーブルがカオリンから別のノードに切り替わるのが表示されます。更新がキャンセルされると、右下ペインのスクリプトにエラーが表示される場合があります。ただし、新しいリーダーが選出されるとすぐに、そのリーダーへのトラフィックのルーティングが開始されます。
ノードの状態を表示する
Control-b↓を使用して左下のペインに切り替えますControl-b← または Control-bq2 、実行:
pgd show-nodes
次のようなものが表示されます。
Node   Node ID    Group        Type Current State Target State Status      Seq ID
- ---   -------    -----        ---- ------------- ------------ ------      ------
kaboom 2710197610 dc1_subgroup data ACTIVE        ACTIVE       Up          3
kaftan 3490219809 dc1_subgroup data ACTIVE        ACTIVE       Up          2
kaolin 2111777360 dc1_subgroup data ACTIVE        ACTIVE       Unreachable 1
カオリンノードがダウンしており、更新は別の書き込みリーダーに送られます。
監視ラグ
カオリンがダウンしている間、PGDの中心にある論理レプリケーションは、カオリンがクラスターとどの程度同期していないかを追跡しています。それを自分で確認するには、次を実行します。
psql bdrdb -c "select * from bdr.node_replication_rates;"
このコマンドは、サーバー間の現在のレプリケーション速度を表示します。
 peer_node_id | target_name | sent_lsn  | replay_lsn |   replay_lag    | replay_lag_bytes | replay_lag_size | apply_rate | catchup_interval
- -------------+-------------+-----------+------------+-----------------+------------------+-----------------+------------+------------------
   2710197610 | kaboom      | 0/769F650 | 0/769F650  | 00:00:00        |                0 | 0 bytes         |       1861 | 00:00:00
              | kaolin      | 0/7656648 | 0/7656648  | 00:03:07.252266 |           299016 | 292 kB          |            |
(2 rows)
この出力を見ると、カオリンには3分のリプレイラグと、今戻ってきた場合に追いつくための約292KBのデータがあることがわかります。カオリンがダウンしている時間が長いほど、リプレイラグが大きくなります。モニタリングコマンドを再実行すると、数値が上昇していることがわかります。
 peer_node_id | target_name | sent_lsn  | replay_lsn |   replay_lag    | replay_lag_bytes | replay_lag_size | apply_rate | catchup_interval
- -------------+-------------+-----------+------------+-----------------+------------------+-----------------+------------+------------------
   2710197610 | kaboom      | 0/76B1D28 | 0/76B1D28  | 00:00:00        |                0 | 0 bytes         |       1743 | 00:00:00
              | kaolin      | 0/7656648 | 0/7656648  | 00:03:53.045704 |           374496 | 366 kB          |            |
(2 rows)
さらに46秒が経過し、ラグは74KB拡大しました。次に、ノードを元に戻し、システムがどのように回復するかを確認します。
ノードの再起動
カオリンでPostgresサービスを戻すことができます。 Control-b↑を使用して、右上のペインに戻ります。Control-b→ または Control-bq1 、実行:
sudo systemctl start postgres.service
変化は見られません。データベースサービスは復旧して実行されていますが、クラスターは選挙を行っていないため、リーダーはそのままです。 Control-b↓を使用して左下のペインに切り替えますControl-b← または Control-bq2 、実行:
pgd show-nodes
次の内容が表示されます。
Node   Node ID    Group        Type Current State Target State Status Seq ID
- ---   -------    -----        ---- ------------- ------------ ------ ------
kaboom 2710197610 dc1_subgroup data ACTIVE        ACTIVE       Up     3
kaftan 3490219809 dc1_subgroup data ACTIVE        ACTIVE       Up     2
kaolin 2111777360 dc1_subgroup data ACTIVE        ACTIVE       Up     1
カオリンがクラスターに戻るとすぐに、クラスターとの同期が開始されます。それは、そのリプレイデータに追いつくことによってそれを行います。実行:
psql bdrdb -c "select * from bdr.node_replication_rates;"
出力は次のようになります。
 peer_node_id | target_name | sent_lsn  | replay_lsn | replay_lag | replay_lag_bytes | replay_lag_size | apply_rate | catchup_interval
- -------------+-------------+-----------+------------+------------+------------------+-----------------+------------+------------------
   2710197610 | kaboom      | 0/8092938 | 0/8092938  | 00:00:00   |                0 | 0 bytes         |       2321 | 00:00:00
   2111777360 | kaolin      | 0/8092938 | 0/8092938  | 00:00:00   |                0 | 0 bytes         |     337426 | 00:00:00
(2 rows)
ご覧のとおり、カオリンは完全に自動的に追いついたので、リプレイラグはなくなりました。
カオリンが完全にサービスを再開すると、すべてをそのままにすることができます。ライトリーダーであるサーバーを変更する必要はありません。フェイルオーバーメカニズムは、必要に応じて別のサーバーを書き込みリーダーに引き上げる準備ができています。
必要に応じて、次を実行してカオリンリーダーを再度作成できます。
pgd switchover --group-name dc1_subgroup --node-name kaolin
このコマンドは、リードを書き込むカオリンを返します。プロキシが書き込みリーダーを追跡するため、アプリケーションの更新が続きます。
プロキシフェイルオーバー
プロキシはフェールオーバーすることもできます。これを体験するには、フォーカスがまだ左下のペインにあることを確認して、次を実行します。
pgd show-proxies
次の内容が表示されます。
Proxy  Group        Listen Addresses Listen Port
- ----  -----        ---------------- -----------
kaboom dc1_subgroup [0.0.0.0]        6432
kaftan dc1_subgroup [0.0.0.0]        6432
kaolin dc1_subgroup [0.0.0.0]        6432
exit
と入力してenterprisedbユーザーを終了し、管理/ルートシェルに戻ります。次を実行して、このノードのプロキシサービスを停止できます。
sudo systemctl stop pgd-proxy.service
スクリプトが別のプロキシに切り替えると、右下のウィンドウに簡単なエラーが表示されます。ただし、書き込みリーダーは変更されないため、プロキシのスイッチは、モニタークエリが実行されている左上のペインに表示されません。
次を実行して、Kaftanのプロキシサービスを元に戻します。
sudo systemctl start pgd-proxy.service
!!!Tip Tmuxの終了
Tmuxと関連するすべてのセッションをすばやく終了できます。セッションが強制終了された後も実行を継続するため、最初に実行中のプロセスを終了します。
Control-B を押してから、 :kill-session
と入力します。このアプローチは、 Control-D またはexit
を使用して各ペインのセッションを1つずつ終了するよりも簡単です。
この例では、3つのデータノードと1つのバックアップノードのクイックスタート構成を使用します。 2つのデータノードと1つの監視ノードを持つようにクラスターを構成できます。これは、ノードの障害に対する回復性が低くなります。または、5つのデータノードを構成できます。これは、ノードの障害に対する回復力がはるかに高くなります。この構成では、アプリケーションでフェールオーバーがどのように機能するかを調べることができます。複数の場所を持つクラスターの場合、同じ基本ルールが適用されます。サーバーをダウンすると、プロキシが指す新しい書き込みリーダーが選択されます。
さらに読む
PGD CLIの使用 の管理機能の詳細を読む。