
Replication sets#
レプリケーションセットは、PGDノードがサブスクライブできるテーブルのグループです。レプリケーションセットを使用して、各ノードが他のノードの正確なコピーである通常の対称マルチマスターよりも複雑なレプリケーショントポロジを作成できます。
すべてのPGDグループは、グループと同じ名前のレプリケーションセットを作成します。このレプリケーションセットは、すべてのユーザーテーブルとDDLレプリケーションに使用されるデフォルトのレプリケーションセットです。すべてのノードがそれにサブスクライブされます。つまり、デフォルトでは、すべてのユーザーテーブルがすべてのノード間でレプリケートされます。
レプリケーションセットを使用する#
を使用して、挿入、更新、削除、または切り捨てアクションを含めるかどうかを指定して、レプリケーションセットを作成できます。 1つのオプションでは既存のテーブルをセットに追加でき、2番目のオプションでは作成時にテーブルを追加するかどうかを定義します。
テーブルを手動で定義して、レプリケーションセットに追加または削除することもできます。
レプリケーションセットに含まれるテーブルは、ノードがクラスターに参加したときおよびその後に維持されます。
ノードが参加したら、レプリケーションセットからテーブルを削除できますが、再同期操作を使用して新しいテーブルを追加する必要があります。
- デフォルトでは、新しく定義されたレプリケーションセットはDDLまたはPGD管理ファンクション呼び出しをレプリケートしません。
複製するコマンドを定義します。
- PGDは、すべてのノードでレプリケーションセット定義を作成します。次に、
bdr.alter_node_replication_sets を使用して各レプリケーションセットをパブリッシュまたはサブスクライブするように各ノードを定義できます。
ファンクションを使用して、これらの定義を後で変更したり、レプリケーションセットを削除したりできます。
注釈
選択的レプリケーションにデフォルトのレプリケーションセットを使用しないでください。クラスター内のPGDノードにあるデフォルトのレプリケーションセットは、 DDLレプリケーションおよび管理ファンクション呼び出しにもデフォルトで使用されるため、ドロップまたは変更しないでください。
パーティション分割テーブルの動作#
PGDは、パーティション化テーブルを透過的にサポートします。つまり、パーティション化されたテーブルをレプリケーションセットに追加できます。
パーティションに関係する変更は、ダウンストリームにレプリケートされます。
注釈
パーティションがパーティションテーブルを介してレプリケートされる場合、パーティションで直接実行されるステートメントは、親テーブルで実行されたときと同じようにレプリケートされます。例外は`TRUNCATE` コマンドであり、これは常に影響を受けるテーブルまたはパーティションのリストを使用して複製します。
個々のパーティションをレプリケーションセットに追加できます。この場合、それらは通常のテーブルと同様に、つまり、ダウンストリームのパーティションと同じ名前のテーブルにレプリケートされます。パーティショニング定義がプロバイダーとサブスクライバーの両方で同じである場合、パーティショニングロジックを実行する必要がないため、この動作にはいくつかのパフォーマンスの利点があります。
注釈
ルートパーティションテーブルがレプリケーションセットの一部である場合、個々のパーティションのメンバーシップは無視されます。そのルートテーブルのメンバーシップのみが考慮されます。
外部キーを使用した動作#
外部キー制約は、参照テーブルの各行が参照先テーブルの行と一致することを保証します。したがって、参照テーブルがレプリケーションセットのメンバーである場合、参照されるテーブルも同じレプリケーションセットのメンバーである必要があります。
PGDの現在のバージョンは、この条件を自動的にチェックまたは適用しません。レプリケーションセットにテーブルを追加するとき、データベース管理者は、外部キーによって参照されるすべてのテーブルも追加されていることを確認する必要があります。
次のクエリを使用して、この要件を満たさないすべての外部キーとレプリケーションセットをリストできます。参照テーブルはレプリケーションセットのメンバーですが、参照されるテーブルはレプリケーションセットのメンバーではありません。
SELECT t1.relname,
       t1.nspname,
       fk.conname,
       t1.set_name
  FROM bdr.tables AS t1
  JOIN pg_catalog.pg_constraint AS fk
    ON fk.conrelid = t1.relid
   AND fk.contype = f
 WHERE NOT EXISTS (
  SELECT *
    FROM bdr.tables AS t2
   WHERE t2.relid = fk.confrelid
     AND t2.set_name = t1.set_name
);
このクエリの出力は次のようになります。
 relname | nspname |  conname  | set_name
- --------+---------+-----------+----------
 t2      | public  | t2_x_fkey | s2
(1 row)
この出力は、テーブルt2 がレプリケーションセットs2
のメンバーであるが、外部キーt2_x_fkey
によって参照されるテーブルがそうでないことを意味します。
TRUNCATE CASCADE
コマンドは、コマンドをレプリケートする前にレプリケーションセットのメンバーシップを考慮します。例
TRUNCATE table1 CASCADE;
これは、レプリケーションセットのみの一部であるすべてのテーブルでカスケードなしのTRUNCATE
になります。
TRUNCATE table1, referencing_table1, referencing_table2 ...
レプリケーションセットのメンバーシップ#
1つ以上のレプリケーションセットにテーブルを追加または削除できます。そうすると、これらのテーブルの変更DMLのレプリケーションにのみ影響します。スキーマ変更DDLは、 DDLレプリケーションセットフィルターによって処理されます
DDL replication filtering を参照してください。
レプリケーションは、ノードレプリケーションセット構成を使用してレプリケーションセットのテーブルメンバーシップを使用して、どのノードにレプリケートするアクションを決定します。決定は、すべてのメンバーシップとレプリケーションセットオプションの和集合を使用して行われます。テーブルが、 INSERTアクションのみをレプリケートするレプリケーションセットAと、 UPDATEアクションのみをレプリケートするレプリケーションセットBのメンバーであるとします。ターゲットノードがレプリケーションセットAおよびBの両方にサブスクライブされている場合、 INSERTおよびUPDATEアクションは両方ともレプリケートされます。
bdr.replication_set_add_table および bdr.replication_set_remove_table を使用してメンバーシップを制御できます。
レプリケーションセットのリスト#
次のクエリーを使用して、既存のレプリケーションセットをリストできます。
SELECT set_name
FROM bdr.replication_sets;
このクエリを使用して、特定のレプリケーションセット内のすべてのテーブルをリストできます。
  SELECT nspname, relname
  FROM bdr.tables
  WHERE set_name = myrepset;

:ref:`外部キーを使用した動作 <外部キーを使用した動作>` は、参照されるテーブルが参照テーブルと同じレプリケーションセットに含まれていないすべての外部キーをリストするクエリーを示しています。
次のSQLを使用して、現在のノードが発行およびサブスクライブするレプリケーションセットを表示します。
SELECT node_id,
       node_name,
       pub_repsets,
       sub_repsets
  FROM bdr.local_node_summary;
このコードは、次のような出力を生成します。
  node_id   | node_name |    pub_repsets     |   sub_repsets
- -----------+-----------+----------------------------------------
 1834550102 | s01db01   | {bdrglobal,bdrs01} | {bdrglobal,bdrs01}
(1 row)
クラスター内のすべてのノードに対して同じクエリーを実行するには、次のクエリーを使用できます。このアプローチでは、すべてのノードに関連付けられたレプリケーションセットを同時に取得します。
WITH node_repsets AS (
  SELECT jsonb_array_elements(
    bdr.run_on_all_nodes($$
        SELECT
          node_id,
          node_name,
          pub_repsets,
          sub_repsets
        FROM bdr.local_node_summary;
    $$)::jsonb
  ) AS j
)
SELECT j->response->command_tuples->0->>node_id AS node_id,
       j->response->command_tuples->0->>node_name AS node_name,
       j->response->command_tuples->0->>pub_repsets AS pub_repsets,
       j->response->command_tuples->0->>sub_repsets AS sub_repsets
FROM node_repsets;
これは、例を示します。
  node_id   | node_name |    pub_repsets     |    sub_repsets
- -----------+-----------+----------------------------------------
 933864801  | s02db01   | {bdrglobal,bdrs02} | {bdrglobal,bdrs02}
 1834550102 | s01db01   | {bdrglobal,bdrs01} | {bdrglobal,bdrs01}
 3898940082 | s01db02   | {bdrglobal,bdrs01} | {bdrglobal,bdrs01}
 1102086297 | s02db02   | {bdrglobal,bdrs02} | {bdrglobal,bdrs02}
(4 rows)
DDLレプリケーションフィルタリング#
デフォルトでは、サポートされているすべてのDDLのレプリケーションは、デフォルトのPGDグループレプリケーションセットを介して発生します。このレプリケーションは、PGDグループと同じ名前のDDLフィルターを使用して実現されます。このフィルタは、 PGDグループの作成時に、デフォルトのPGDグループレプリケーションセットに追加されます。
これは、既存のすべてのレプリケーションセットのDDLレプリケーションフィルターを変更することにより調整できます。これらのフィルターは、レプリケーションセットのテーブルメンバーシップとは独立しています。データ変更と同様に、各DDLステートメントは、複数のレプリケーションセットの複数のフィルターと一致する場合でも、1回だけレプリケートされます。
次のクエリーを使用して既存のDDLフィルターをリストできます。これは、フィルターごとに、コマンドタグとロール名に適用された正規表現を示します。
  SELECT * FROM bdr.ddl_replication;

:ref:`bdr.replication_set_add_ddl_filter <bdr.replication_set_add_ddl_filter>` および :ref:`bdr.replication_set_remove_ddl_filter <bdr.replication_set_remove_ddl_filter>` を使用して、
DDLフィルターを操作できます。これらはDDL であると考えられるため、
DDLレプリケーションとグローバルロックの対象になります。
選択的レプリケーションの例#
この例では、テーブルを特定のノードのグループに選択的にレプリケートするようにEDB Postgres分散を構成します。
クラスター構成#
この例では、6つのデータノードのクラスターが2つの場所にdata-a1
〜data-a3 およびdata-b1 〜data-b3 あり、 region_a
およびregion_b グループのメンバーであることによって表されます。
また、お勧めしますが、 region-c のwitness
という名前の監視ノードもありますが、この例ではそれについて言及する必要はありません。クラスター自分自身の名前はsere
になります。
この構成は次のようになります。
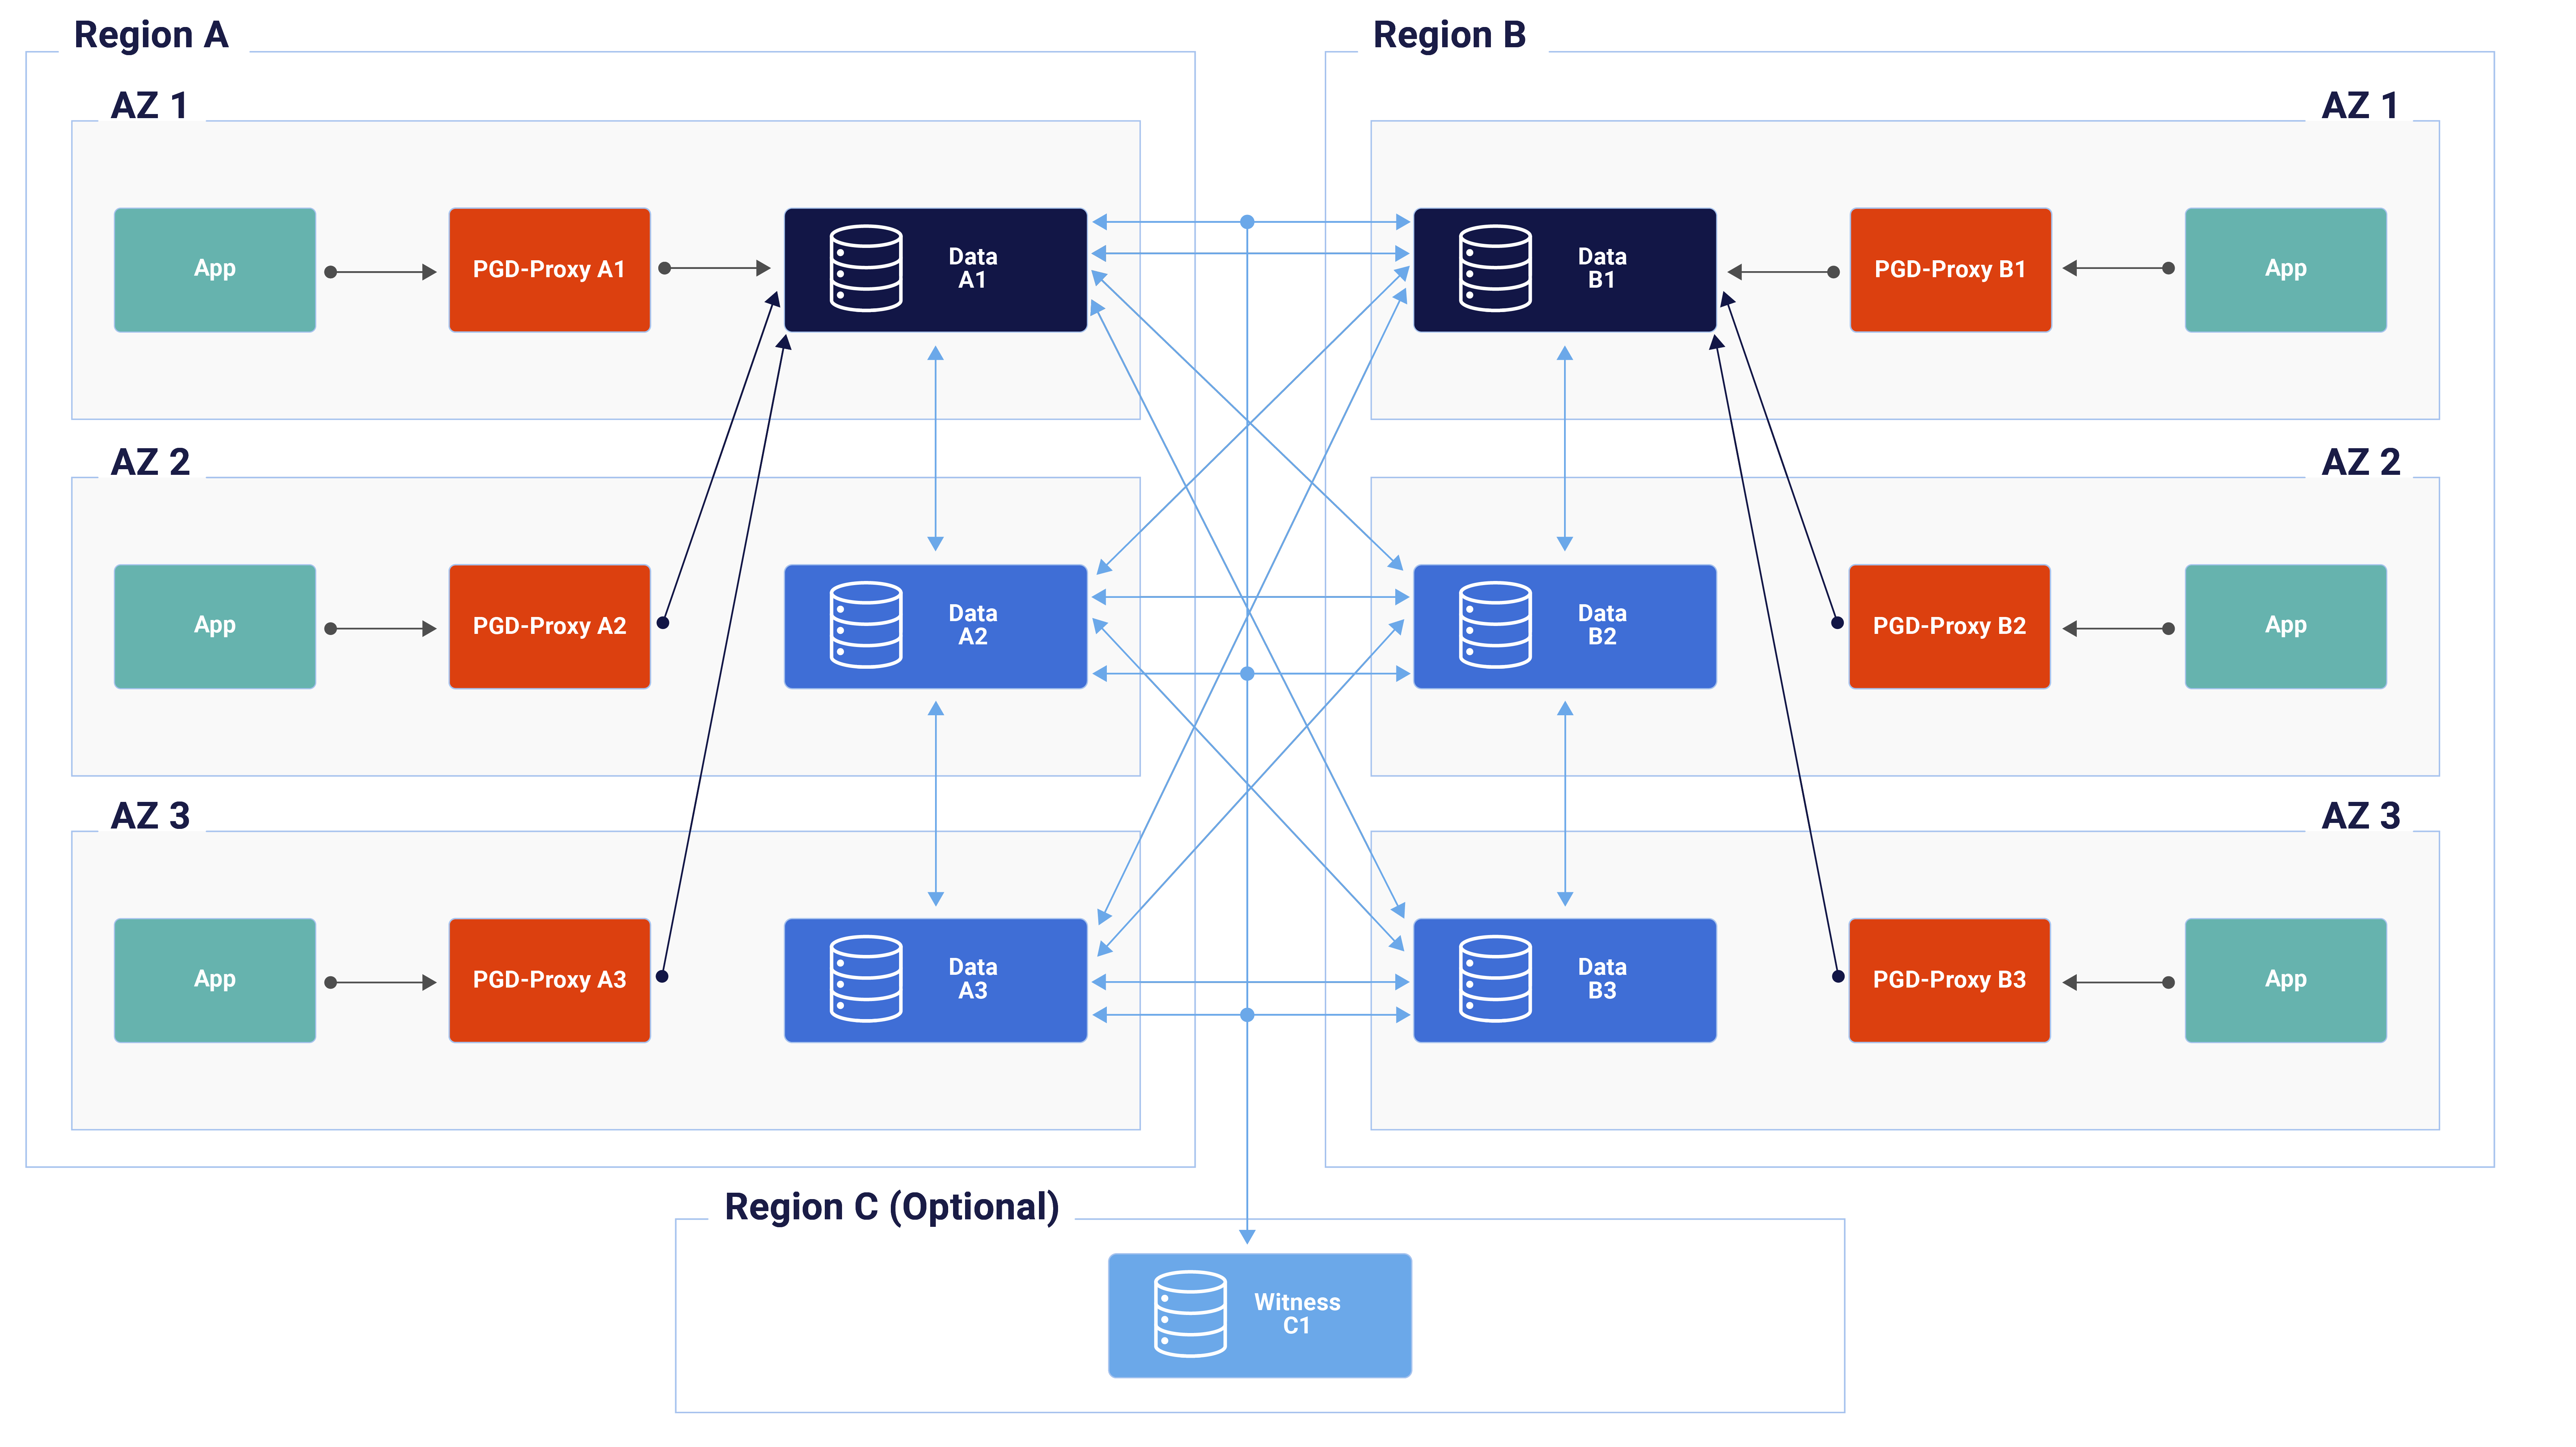
Multi-Region 3 Nodes Configuration#
- これは、
Choosing your architecture セクションで説明した標準のAlways-Onマルチリージョン構成です。
アプリケーション要件#
この例では、音楽作品の公演に出席した人々の意見を記録するアプリケーションを使用します。出席者用のテーブル、作品用のテーブル、そしてどの出席者がどの作品を見た、どこで、いつ、どのように作品を採点したかを記録する意見テーブルがあります。データ規制のため、この例では、意見データは、意見が記録されたリージョンにのみ存在する必要があることを前提としています。
テーブルの作成#
最初の手順は、適切なテーブルを作成することです。
CREATE TABLE attendee (
   id bigserial PRIMARY KEY,
   email text NOT NULL
);

CREATE TABLE work (
    id int PRIMARY KEY,
    title text NOT NULL,
    author text NOT NULL
);

CREATE TABLE opinion (
    id bigserial PRIMARY KEY,
    work_id int NOT NULL REFERENCES work(id),
    attendee_id bigint NOT NULL REFERENCES attendee(id),
    country text NOT NULL,
    day date NOT NULL,
    score int NOT NULL
);
グループとレプリケーションセットの表示#
デフォルトでは、 EDB Postgres分散は、各テーブル全体を各すべてのノードにレプリケートするように構成されます。これは、レプリケーションセットを介して管理されます。
初期構成のデフォルトのレプリケーションセットを表示するには、次のコマンドを実行します。
SELECT node_group_name, default_repset, parent_group_name
FROM bdr.node_group_summary;
 node_group_name | default_repset | parent_group_name
- ----------------+----------------+-------------------
 sere            | sere           |
 region_a        | region_a       | sere
 region_b        | region_b       | sere
 region_c        | region_c       | sere
出力には、sere
という名前のデフォルトのレプリケーションセットを含むトップレベルグループsere
があることがわかります。
3つのサブグループには、それぞれ、サブグループと同じ名前のレプリケーションセットがあります。
region_a グループには、region_a
デフォルトレプリケーションセットがあります。
デフォルトでは、既存のすべてのテーブルと新しいテーブルは、トップレベルグループのレプリケーションセットのメンバーになります。
レプリケーションセットへのテーブルの追加#
このプロセスの次のステップは、リージョンを表すグループに属するレプリケーションセットにテーブルを追加することです。前述のように、新しいテーブルはすべてsere
レプリケーションセットに自動的に追加されます。次を実行してそれを確認できます。
SELECT relname, set_name FROM bdr.tables ORDER BY relname, set_name;
 relname  | set_name
- ---------+----------
 attendee | sere
 opinion  | sere
 work     | sere
(3 rows)
opinion テーブルをregion_a
内でのみレプリケートし、別にregion_b
内でのみレプリケートする必要があります。そのためには、各リージョンのレプリカセットにテーブルを追加します。
SELECT bdr.replication_set_add_table(opinion, region_a);
SELECT bdr.replication_set_add_table(opinion, region_b);
ただし、 opinion はまだsere
レプリケーションセットのメンバーであるため、これで完了ではありません。テーブルが複数のレプリケーションセットのメンバーである場合、各テーブル内でレプリケートされます。ただし、各行は各ターゲットノードで1回のみレプリケートされるため、これはパフォーマンスに影響を与えません。
opinion
をすべてのノードでレプリケートしたくないため、トップレベルグループのレプリケーションセットから削除する必要があります。
SELECT bdr.replication_set_remove_table(opinion, sere);
これらの変更を確認できるようになりました。
SELECT relname, set_name FROM bdr.tables ORDER BY relname, set_name;
 relname  | set_name
- ---------+-------------------
 attendee | sere
 opinion  | region_a
 opinion  | region_b
 work     | sere
(4 rows)
これにより、目的の選択的レプリケーションが提供されます。次のステップは、それをテストすることです。
選択的レプリケーションのテスト#
いくつかのテストデータ、2つの作品、1つの出席者を作成してみましょう。 data-a1に直接接続して、この次のコードを実行します。
INSERT INTO work VALUES (1, Aida, Verdi);
INSERT INTO work VALUES (2, Lohengrin, Wagner);
INSERT INTO attendee (email) VALUES (gv@example.com);
これらのテーブルにデータが入ったので、外部キー制約に違反せずにopinion
テーブルに挿入できます。
INSERT INTO opinion (work_id, attendee_id, country, day, score)
SELECT work.id, attendee.id, Italy, 1871-11-19, 3
  FROM work, attendee
 WHERE work.title = Lohengrin
   AND attendee.email = gv@example.com;
挿入したら、同じノードでデータベースの内容を検証できます。
SELECT a.email
, o.country
, o.day
, w.title
, w.author
, o.score
FROM opinion o
JOIN work w ON w.id = o.work_id
JOIN attendee a ON a.id = o.attendee_id;
    email       | country |    day     |   title   | author | score
- ---------------+---------+------------+-----------+--------+-------
 gv@example.com | Italy   | 1871-11-19 | Lohengrin | Wagner |     3
(1 row)
ここで、ノードdata-a2 およびdata-a3
に接続し、同じクエリーを実行すると、同じ結果が得られます。データはregion_a
で複製されています。 data-b1 、data-b2 またはdata-b3
に接続する場合、クエリーは行を返しません。これは、 attendee
およびwork
テーブルにデータが入力されていますが、選択できるopinion
行がないためです。これは、 region_a でのopinion
のレプリケーションがそのリージョンでのみ発生するためです。
data-b1 に接続し、次のようにそこに意見を挿入すると
INSERT INTO attendee (email) VALUES (fb@example.com);

INSERT INTO opinion (work_id, attendee_id, country, day, score)
SELECT work.id, attendee.id, Germany, 1850-08-27, 9
  FROM work, attendee
 WHERE work.title = Lohengrin
   AND attendee.email = fb@example.com;
この意見はregion_b でのみ複製されます。 data-b1
、data-b2 、およびdata-b3 では、次を実行できます。
SELECT a.email
, o.country
, o.day
, w.title
, w.author
, o.score
FROM opinion o
JOIN work w ON w.id = o.work_id
JOIN attendee a ON a.id = o.attendee_id;
    email       | country |    day     |   title   | author | score
- ---------------+---------+------------+-----------+--------+-------
 fb@example.com | Germany | 1850-08-27 | Lohengrin | Wagner |     9
(1 row)
各region_b データノードで同じ結果が表示されます。 region_a
ノードでクエリーを実行すると、この特定のエントリは表示されません。
最後に、 attendee
テーブルはすべてのノードで同様に共有されることに注意してください。任意のノードで、クエリを実行します。
SELECT * FROM attendee;
         id         |    email
- -------------------+----------------
 904252679641903104 | gv@example.com
 904261037006536704 | fb@example.com
(2 rows)