
Architecture overview#
EDB Postgres Distributed PGDは、 PostgreSQLの機能を拡張し、マルチプルのノードにわたる高可用性とフォールトトレラントのデータベース展開を可能にする分散データベースソリューションです。 PGDは、高度な競合管理、データ損失保護、最大ファイブナインの高可用性、およびネイティブ論理レプリケーションより最大5倍高速のスループットを備えたデータ分散を提供します。
PGDは、マルチマスター基盤双方向レプリケーションBDR上に構築されており、Connection Managerを介してパフォーマンスと可用性が最適化されます。マルチマスター機能をより適切に利用するカスタム展開が必要な場合、接続マネージャーを使用せずにPGDを実行できます。接続マネージャーなしで実行されている場合、書き込みはノード間で分散されて相互に複製され、一貫性の維持には競合の解決が必要です。アーキテクチャのニーズによっては、これがより効率的な場合があります。ただし、接続マネージャーは、書き込みリーダーを使用して、競合と競合の低下を保証します。 Raft は、システムがどのノードがRaft選挙リーダーであり、どのノードが書き込みリーダーであるかを決定するなど、重要な決定を下すのを助けるために実装されています。
高レベルアーキテクチャ#
最高レベルでは、 PGDは2つの主要コンポーネントで構成されています。双方向レプリケーションBDRと接続マネージャー。 BDRは、異なるBDR対応Postgresインスタンス/ノード間のマルチマスターレプリケーションメッシュを有効にするPostgres拡張機能です。 接続マネージャーを介して接続する は、書き込みリーダーに要求を送信します。ノード間の競合のリスクの低下、より強い一貫性を保証します。
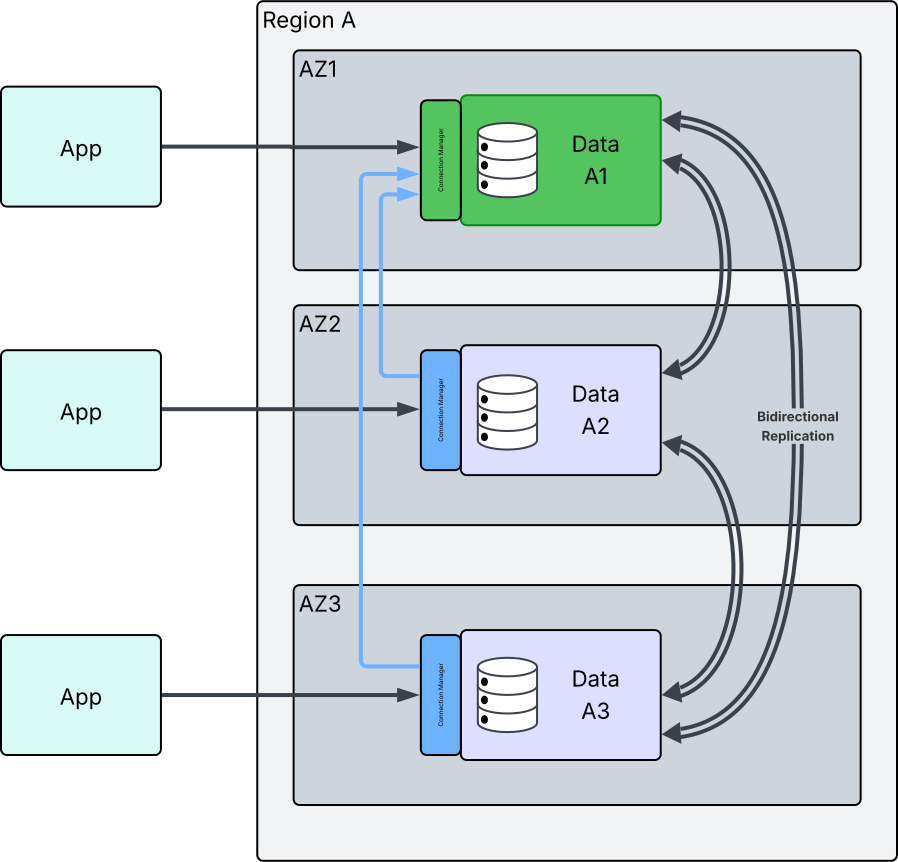
Diagram showing 3 application nodes and 3 PGD nodes. Traffic is being directed from each of the PGD nodes by the connection manatger to the write leader node.
変更は、すべてのノード間で行ごとに直接レプリケートされます。 PGDの Logical replication はデフォルトで非同期であるため、最終的な一貫性のみが保証されます通常数秒以内。 ただし、 commit scope オプションは、 CAMO 、 group および synchronous コミットを介して即時一貫性と耐久性を保証します。
Raftアルゴリズムは、リーダーRaftリーダーと書き込みリーダーの両方を選択し、クラスターに追加または削除するノードを決定するためのメカニズムを提供します。これにより、一般に、ノードに障害が発生した場合でも、分散システムの一貫性とフォールトトレラントが保証されます。
アーキテクチャ要素#
PGDは、分散データベースソリューションを提供するために連携するいくつかの主要なアーキテクチャ要素で構成されています。
PGDノード これらは、データを保存および管理する個々のPostgresインスタンスです。これらは、PGDクラスターの基本的なビルディングブロックです。 - グループ デフォルトでは、すべてのノードは独自のRaftリーダーを持つ トップレベルグループでのコミットスコープの作成 のメンバーでもありますが、書き込みリーダーはありません。 PGDノードはさらに Groups and subgroups に編成でき、管理性と高可用性が向上します。各グループには複数のノードを含めることができ、グループ内の冗長性とフェールオーバーが可能です。グループは、同じグループ内および異なるグループ間のノード間の組織的なレプリケーションとデータの一貫性を促進します。各グループには、独自の書き込みリーダーがあります。
レプリケーションメカニズム PGDのレプリケーションメカニズムには、ノード全体で効率的なレプリケーションのためのBDRが含まれ、マルチマスターレプリケーションを有効にします。 BDRはデフォルトで非同期レプリケーションをサポートしますが、 耐久性オプショングループコミット/ CAMO や 同期コミット などのさまざまな同期レベルに構成して、データの耐久性を強化できます。
モニタリングツール PGDでのパフォーマンス、状態、および使用状況をモニタするには、いくつかの便利なコマンドを提供する built-in command-line interface CLIを使用できます。例えば - pgd nodes list コマンドは、クラスター内のすべてのノードの概要を提供します。それらの状態とステータスを含みます。 - pgd cluster show --health コマンドは、クラスターの状態を確認し、ノードのアクセス可能性、レプリケーションスロットの状態、およびその他の重要なメトリックを報告します。 - pgd events show コマンドは、バックグラウンドワーカーエラーやノードメンバーシップの変更などの重要なイベントをリストするため、クラスター内の操作ステータスと問題を追跡するのに役立ちます。
さらに、 BDR拡張機能を使用すると、 bdr.monitor_group_versions ロールを使用してSQLを使用してクラスターをモニタリングできます。
ノードタイプ#
PGDのすべてのノードは事実上データノードです。これらは、クラスター内の目的が異なるだけです。
**Data nodes ** データの保存と管理、読み取りおよび書き込み操作を処理し、レプリケーションに参加します。
次に、データノードのように構築されますが、特定の目的を持つ3種類のノードがあります。これらは次のとおりです。
**Subscriber-only nodes ** 読み取り専用の目的でデータノードからの変更をサブスクライブします。レポートまたは分析で使用されます。
**Witness nodes ** データを保存せずにコンセンサスプロセスに参加し、クォーラムの達成と高可用性の維持に役立ちます。
**Logical standby nodes ** 必要に応じてデータノードに昇格できるスタンバイノードとして機能し、高可用性とディザスターリカバリーを保証します。
ノードのロール#
グループ内のデータノードは、特定の機能を有効にするために特定のロールを引き受けることもできます。 これらのロールは一時的なもので、必要に応じてグループ内の他の対応可能なノードに転送できます。これらのロールには次のものが含まれます。
Raft leader グループのノード間のコンセンサスを調停および管理します。
**Write leader ** アプリケーションが接続マネージャーを介して接続するときにすべての書き込み操作を受け取ります。
アーキテクチャの柔軟性#
PGDは、さまざまなパフォーマンス、可用性、コンプライアンスのニーズを満たすようにアーキテクチャを展開、維持、およびスケーリングする方法に関する柔軟なオプションを提供します。
PGDは、 Postgresのアップグレードとその他のシステムまたはアプリケーションレベルの変更の両方のブルー/グリーン展開を含むローリングメンテナンスをサポートしています。このアプローチにより、マイナーまたはメジャーバージョンのアップグレード、スキーマの変更、バキューム操作などの日常的なタスク中にデータベースが利用可能なままになります。システムは、アクティブなデータベースバージョンをシームレスに切り替え、ゼロダウンタイムを実現します。
PGDは、自動フェイルオーバーを提供して、高可用性を保証します。クラスター内のノードが使用できなくなると、別のノードがその責任を引き継ぎ、ダウンタイムを最小限に抑えます。また、PGDには自己修復機能が含まれており、障害が発生または切断されたノードはクラスターに再接続し、問題が解決されると通常のオペレーションを再開します。
PGDでは選択的レプリケーションが可能であるため、ユーザーはデータのサブセットのみを特定のノードにレプリケートできます。この機能を使用して、ノード間の不要なデータトラフィックを削減することによりパフォーマンスを最適化したり、地理的データ制限などの規制要件を満たすことができます。たとえば、ヘルスケアアプリケーションは、地域のデータプライバシー法に準拠するために、特定のリージョン内の患者データのみを複製する場合があります。
コミットスコープを使用すると、PGDは構成可能な耐久性も提供します。したがって、耐久性をデフォルトの非同期動作から向上させ、さまざまな構成可能なコミットスコープを使用して調整できます。
**Synchronous Commit ** 基になるオペレーションでのPostgreSQLのsynchronous_commitオプションとよく似ています。 COMMIT時に少なくとも1つの他のノードに書き込む必要がありますが、すべてのノードを必要とするように調整できます。
**CAMO ** Commit At Most Onceの一意のIDで各トランザクションを追跡し、ノードのペアを使用してトランザクションの結果を確認することにより動作し、アプリケーションがトランザクションを再試行するかどうかを認識します。
**Group Commit ** 実験的なコミットスコープ。その目標は、COMMIT時にトランザクションを正常に確認するために複数のPGDノードを必要とすることにより、一時的な停止の単一ノードに障害が発生した場合のデータ損失から保護することです。
**Lag Control ** レプリケーションが設定された制限の外で実行されている場合別のノードにレプリケートされるのに時間がかかりすぎる場合、最初にトランザクションを受け取ったノードに遅延が注入され、他のノードが追いつくまで速度が低下します。