1 はじめに
2 要件の概要
3.1 JDBCドライバタイプ
3.2 JDBCインタフェース
3.3 JDBCクラスとインタフェース
4.1 JDBCコネクタのインストール
4.1.1 RPMパッケージを使用したコネクタのインストール
4.1.2 SLES 12ホストへのコネクタのインストール
5.2 データベースへの接続
5.2.1 追加の接続プロパティ
5.2.2 同期副データベースサーバの優先
5.5 リソースを解放する
5.6 エラー処理
6.1.1 executeUpdate()の構文例
8.1.1 ステートメントオブジェクトのバッチサイズの変更
8.3 ストアドプロシージャを実行する
8.3.1 ストアドプロシージャの呼び出し
8.3.1.1 単純なストアドプロシージャの実行
8.3.1.2 INパラメータを使用したストアドプロシージャの実行
8.3.1.3 OUTパラメータを使用したストアドプロシージャの実行
8.3.1.4 IN OUTパラメータを使用したストアドプロシージャの実行
8.6.1 オブジェクト型の使用
8.6.2 コレクションの利用
1 はじめに
以下の説明において、 用語は、言語キーワード、ユーザ指定の値、リテラルなどであり得る任意の単語または単語のグループを指す。用語の正確な意味は、それが使用される文脈に依存する。
2 要件の概要
3.1 JDBCドライバタイプ
3.2 JDBCインタフェース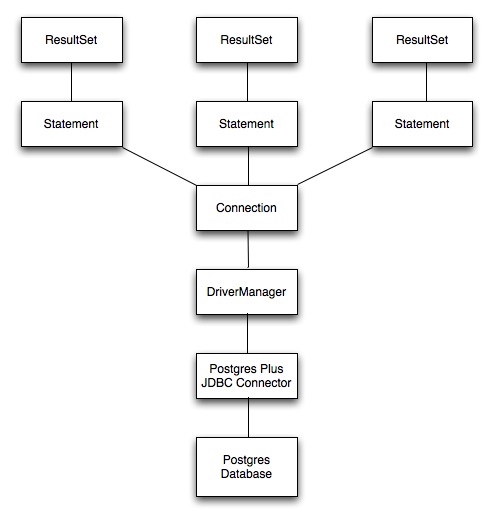
3.3 JDBCクラスとインタフェース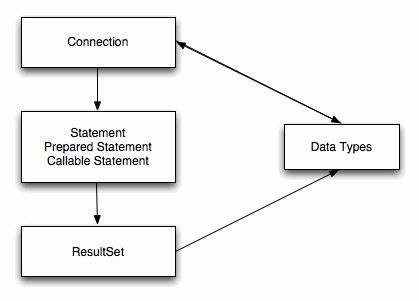
図2.3は、一般的なJDBCアプリケーションにおけるDriverManagerクラスの役割を示しています。 DriverManagerは、Javaアプリケーションとバックエンドデータベース間のブリッジとして機能し、ターゲットデータベースに使用するJDBCドライバを決定します。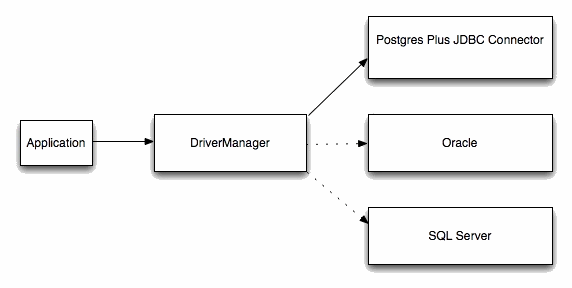
4.1 JDBCコネクタのインストール
4.1.1 RPMパッケージを使用したコネクタのインストールリポジトリ設定ファイルをダウンロードした後、スーパーユーザー特権を引き受け 、次のコマンドを使用してリポジトリ設定ファイルを作成します。インストーラによって、 edb という名前のリポジトリ設定ファイルが作成されます 。 repo ;ファイルは/etc/yum.repos.dます。このファイルには、各EnterpriseDBリポジトリのエントリが含まれています。コネクタをインストールするには、 enterprisedb - toolsリポジトリのエントリを有効にする必要があります。
4.1.2 SLES 12ホストへのコネクタのインストール入力を求められたら User NameとPassword 、EnterpriseDBのリポジトリ用の接続の資格情報を提供しています。認証情報が必要な場合は、EnterpriseDBに連絡してください。
DebianまたはUbuntuホストにDEBパッケージをインストールするには、EnterpriseDBリポジトリへのアクセスを許可する認証情報が必要です。リポジトリの認証情報を要求するには、以下のEnterpriseDB Advanced Downloadsページにアクセスしてください。次の手順では、EnterpriseDB aptリポジトリを使用してDEBパッケージをインストールする方法について説明します。コマンドを使用するときは、 usernameとpasswordをEnterpriseDBが提供する資格情報に置き換えてください。このセクションでは、インストールウィザードを使用してWindowsシステムにコネクタをインストールする方法について説明します。 (インストーラをダウンロードし、インストーラのアイコンを右クリックして 、コンテキストメニューから[ Administrator As Run ]を選択します。)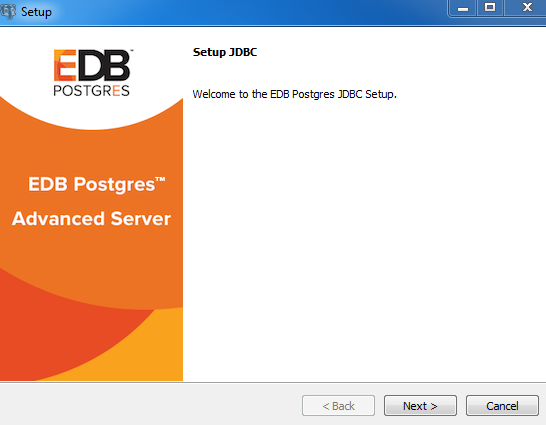 Nextをクリックして続けます。
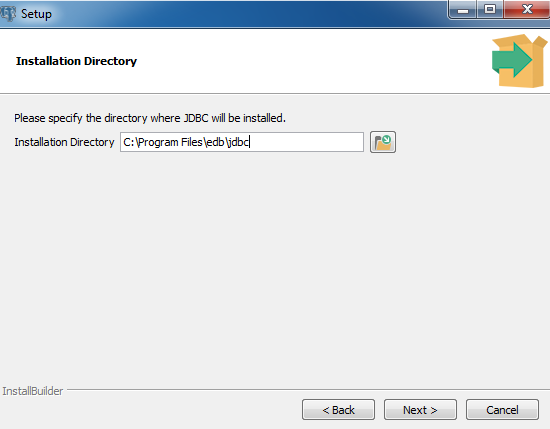
 StackBuilder Plusを使用して、既存のAdvanced Serverインストールでコネクタを追加または更新することもできます。 StackBuilder Plusを開くには、Windows Appsメニューから、またはLinux ApplicationsメニューからStackBuilder Plusを選択します(図3.5を参照)。
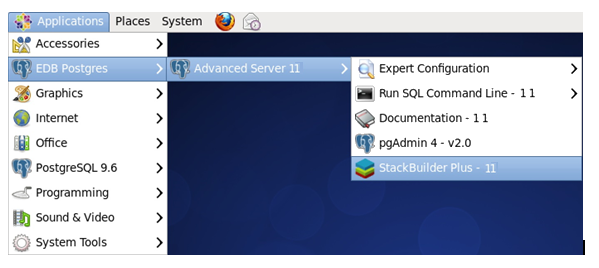 StackBuilder Plusが開いたら、画面上の指示に従います。ツリーコントロールの[ Database Driversノードから[ EnterpriseDB JDBC Connector ]オプションを選択し JDBC Connector (図3.6を参照)。
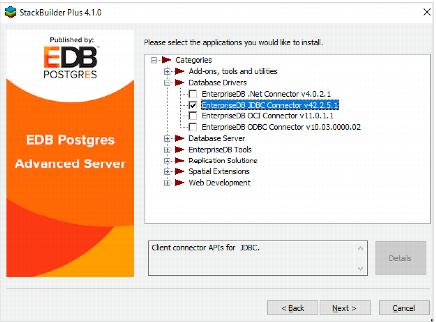
JavaとAdvanced Server JDBC Connectorが配置されていれば、JavaアプリケーションはAdvanced Serverデータベースにアクセスできます。 リスト1.1は、クエリを実行して結果セットを印刷するアプリケーションを作成します。
Advanced Server JDBCドライバはJavaで書かれており、コンパイル済みJAR(Java Archive)ファイルの形式で配布されています。 Class 使用してください 。ドライバをロードするためのforName ()メソッド。 forName ()メソッドは、実行時にJavaクラスを動的にロードします。アプリケーションがforName ()メソッドを呼び出すと、JVM(Java Virtual Machine)は要求されたクラスを実装するコンパイル済みフォーム(バイトコード)を見つけようとします。Advanced Server JDBCドライバの名前は com.edb.Driver:ドライバのバイトコードをロードした後、ドライバは現在のシステムにインストールされているすべてのJDBCドライバの管理を担当する別のJDBCクラス( DriverManager )に自分自身を登録します。JVMが名前付きドライバを見つけることができない場合、 ClassNotFound例外(プログラムの終わり近くでcatchブロックでインターセプトされる)をスローし ClassNotFound 。 DriverManagerは、複数のJDBCドライバオブジェクトを処理するように設計されています。 JDBCを介して複数のデータベースシステムに接続するJavaアプリケーションを書くことができます。次のセクションでは、特定のドライバを選択する方法について説明します。
5.2 データベースへの接続すべてのJDBC接続は DriverManager から始まります 。 DriverManagerクラスは、データベースへの接続を作成する責任を負うgetConnection()という静的メソッドを提供します。 getConnection()メソッドを呼び出すときには、 DriverManagerがデータベースへの接続に使用するJDBCドライバを決定する必要があります。その決定は、 getConnection().渡すURL(Uniform Resource Locator)に基づいていますgetConnection().jdbc:edb:< database >
5.2.1 追加の接続プロパティ標準の接続パラメータに加えて、Advanced Server JDBCドライバは、EnterpriseDB固有の動作を制御する接続プロパティをサポートしています。これらのプロパティは接続URLで指定するか、 DriverManager.getConnection().渡されるPropertiesオブジェクトパラメータとして指定できます DriverManager.getConnection().リスト1.2は、 Propertiesオブジェクトを使って追加の接続プロパティを指定する方法を示しています。注:デフォルトでは、 SSL = trueと接続URLパラメーターsslfactory = org.postgresql.ssl.NonValidatingFactoryの設定は、接続を暗号化しますが、SSL証明書を検証しません。証明書の検証を強制するには、 カスタムSSLSocketFactoryを使用する必要があります。カスタムSSLSocketFactoryの 作成方法の詳細については 、以下を参照してください。
5.2.2 同期副データベースサーバの優先Advanced Server JDBC Connectorは 、 表5–2に示すように、 targetServerType接続プロパティのオプション preferSyncSecondaryをサポートしています 。注:の使用targetServerType値slave 、 preferSlave 、及びpreferSyncSlave値としてすべての機能の同一の対応するセットを提供するsecondary 、 preferSecondary 、及びpreferSyncSecondaryが「スレーブ」の値が推奨されています。 「二次」値を使用することをお勧めします。preferSyncSecondaryオプションは、フェイルオーバー接続用の同期、スタンバイサーバの優先を提供し、従って非同期サーバを無視します。jdbc:edb:// master : port , secondary_1 : port_1 , secondary_2 : port_2 ,.../
database ?targetServerType=preferSyncSecondarymasterデータベースサーバに割り当てられたIPアドレスまたは名前の後にポート番号を続けたもの。 masterが名前の場合は、Javaプログラムを実行しているホストの/etc/hostsファイルにIPアドレスを指定して指定する必要があります。 注:マスターデータベースサーバは、リスト内の任意の場所に指定できます。セカンダリデータベースサーバの前に置く必要はありません。スタンバイセカンダリデータベースサーバに割り当てられているIPアドレスまたは名前の後にポート番号を続けたもの。 secondary_nが名前の場合は、Javaプログラムを実行しているホスト上の/etc/hostsファイルにIPアドレスを指定して指定する必要があります。
Advanced Server JDBC Connectorドライバをロードしてサーバに接続した後、サンプルアプリケーションのコードはJDBC Statementオブジェクトを構築し 、SQLクエリを実行して結果を表示します。Statementオブジェクトは、SQL文をデータベースに送信します。 Statementオブジェクトには3種類あります。それぞれが特定のタイプのSQLステートメントを送信するように特殊化されています。
JDBCコネクタ(Advanced Serverバージョン9.6以降)は、 CallableStatement オブジェクトを インスタンス化するときの名前付きパラメータの使用をサポートしてい ます。この構文はJDBCがサポートする構文の拡張であり、JDBC標準には準拠していません。CallableStatementオブジェクトを使用して、パラメータ値をストアドプロシージャに渡すことができます。 CallableStatement オブジェクトを使用して、 IN 、 OUT 、およびINOUTパラメータに値を割り当てることができます。CallableStatement クラス を使用するときは、 序数表記または名前表記を使用して実際の引数の値を指定できます。 ステートメント内の 各 IN または INOUT パラメーター・マーカーに 値を設定する必要があり ます。序数表記を使用して CallableStatement オブジェクトに 値を渡す場合 は、パラメータ型に対応する設定メソッドを使用する必要があります。たとえば、 STRING 値 を渡すとき は、 setString セッターメソッドを 使用し ます。ステートメント内の各パラメーター・マーカー( ? )は序数値を表します。序数パラメータを使用するときは、仮引数が手続き定義内で指定されている順序で実際のパラメータ値を文に渡す必要があります。CallableStatement オブジェクトの 引数値を指定するときに名前付きパラメーター表記を使用することもでき ます。名前付きパラメーター表記を使用すると、許容可能なデフォルト値を持つパラメーターを省略して、手順で必要なパラメーターのみに値を指定できます。名前付きパラメータを任意の順序で指定することもできます。名前表記法を使用する場合、各パラメータ名に対応している必要があり COLUMN _ NAME の呼び出しによって返さ DatabaseMetaData 。 getProcedureColumns メソッドステートメント呼び出しに名前付きパラメーターを含める場合は、=>トークンを使用してください。
ResultSetオブジェクトは、SQL文によって返されるデータのためのプライマリストレージメカニズムです。各ResultSetオブジェクトには、データとメタデータの両方( ResultSetMetaDataオブジェクトの形式)が含まれています。 ResultSetMetaDataは、SQLコマンドによって返される結果に関する有用な情報(列名、列数、行数、列の長さなど)が含まれています。格納された行データにアクセスするため ResultSetオブジェクトを、アプリケーションは、1つのまたは複数のゲッターメソッドを呼び出します。 ゲッターメソッドは、現在の行の特定の列の値を取得します。さまざまなゲッターメソッドがあります。各メソッドは特定の型の値を返します。たとえば、 getString ()メソッドはSTRING型を返します。 getDate ()メソッドはDate返し、 getInt ()メソッドはINT型を返します。アプリケーションは、getterメソッドを呼び出すと、JDBCは、要求された型に値を変換しようとします。各 ResultSetは、現在の行を指す内部ポインタを保持しています。 executeQuery ()メソッドがResultSet返すと、ポインタは最初の行の前に配置されます。アプリケーションは、ポインタを移動する前にgetterメソッドを呼び出す場合、getterメソッドは失敗します。次の(または最初の)行に進むには、 ResultSetのnext()メソッドを呼び出します。 ResultSet 。 next()はブールメソッドです。 ResultSet別の行がある場合はTRUE返し、最後の行を過ぎて移動した場合はFALSE返します。ポインタを最初の行に移動した後、サンプルアプリケーションは getString () getterメソッドを使用して最初の列の値を取得し、その値を出力します。 ListEmployeesはループ内でrs.next()とrs.getString()を呼び出すので、結果セット内の各行を処理します。 ListEmployeesは、 rsなるとループを終了します。 next ()は最後の行を越えてポインタを移動し、 FALSEを返しFALSE 。ResultSetインタフェースを使用するときは、
5.5 リソースを解放するすべてのJDBCオブジェクトはいくつかのリソースを消費します。 ResultSetオブジェクトは、例えば、クエリによって返されるすべての行のコピーを含んでいてもよいです。 Statementオブジェクトには、最後に実行したコマンドのテキストなどを含めることができます。通常、アプリケーションがリソースを必要としなくなったときに、それらのリソースを解放することをお勧めします。サンプルアプリケーションは、各オブジェクトのclose()メソッドを呼び出すことによって、 Result 、 Statement 、およびConnectionオブジェクトによって消費されたリソースを解放します。
5.6 エラー処理外部リソース(データベースサーバーなど)に接続すると、エラーが発生します。あなたのコードはこれらのエラーを処理する方法を含むべきです。 JDBCとAdvanced Server JDBC Connectorはどちらもさまざまな種類のエラー処理を提供します。 ListEmployees (1.1リスト)クラスが使用してエラーを処理する方法を示しますtry/catchブロックを。JDBCオブジェクトがエラー( SQLException 型またはSQLExceptionから派生した型のオブジェクト)をスローすると、 SQLExceptionオブジェクトは3つの異なるエラー情報を公開します。
前の例では、 ListEmployeesはStatementを使用してSELECT文を実行しました。 executeQuery()メソッドexecuteQuery()は、クエリステートメントを実行するように設計されているため、クエリによって返されたデータを含むResultSetが返されます。 Statementクラスは、他の種類のコマンド( UPDATE 、 INSERT 、 DELETEなど)を実行するために使用する必要がある2番目のメソッドを提供します。行のコレクションを返すのではなく、 executeUpdate()メソッドは、実行するSQLコマンドの影響を受ける行数を返します。executeUpdate()メソッドのシグネチャは次のとおりです。
注:次の例は完全なアプリケーションではなく、メソッドにすぎません。このドキュメントの残りの部分にあるサンプルには、 Connection設定と切断に必要なコードは含まれていません。例を試すには、サンプルコードを呼び出すクラスを用意する必要があります。updateEmployee()メソッドは、呼び出し元から単一の引数、Advanced Serverのデータベースに接続する必要があり、Connectionオブジェクトを期待します:次に、 updateEmployee()はユーザーに従業員の名前と番号の入力を求めます。executeUpdate()メソッドは、SQL文によって影響を受けた行の数を返す( INSERT典型的には、1つの行に影響を与えるが、 UPDATEまたはDELETEステートメントがより影響を与えることができます)。 executeUpdate()がエラーをスローせずに戻った場合は、 Systemへの呼び出し。 out 。 printlnは、影響を受けた行数を示すメッセージをユーザーに表示します。
6.1.1 executeUpdate()の構文例stmt.executeUpdate("DROP TABLE tablename ");fieldname2 VARCHAR2(30))");
次の例(リスト1.4)は、少し手間をかけてプログラムにグラフィカルユーザーインタフェースを追加することができます。次の例(リスト1.4)は、 JTable (スプレッドシートのようなグラフィカルオブジェクト)を作成して、そのJTable問い合わせJTable 。注:次のサンプルアプリケーションは方法であり、完全なアプリケーションではありません。このメソッドを呼び出すには、適切なmain()関数とラッパークラスを提供します。showEmployees()メソッドを作成する前に、いくつかのJDK提供クラスの定義をインポートする必要があります。showEmployees()メソッドは期待Connectionオブジェクトは、呼び出し元によって提供されます。 ConnectionオブジェクトはAdvanced Serverに接続されている必要があります。ご executeQuery() とおり、 executeQuery()はResultSetオブジェクトを返します。 ResultSetオブジェクトには、結果セットの形状 (つまり、結果セット内の行数と列数、各列のデータ型、各列の名前など)を記述するメタデータが含まれています。 getMetaData()メソッドを呼び出して、 ResultSetからメタデータを抽出できます。次に、 showEmployees()は列ヘッダーを保持するためのVector (1次元配列)を作成してから、 ResultMetaDataオブジェクトの各ヘッダーをベクトルにResultMetaDataます。列ヘッダーを配置した状態で、 showEmployees()はResultSetから各行を抽出し、それを新しいrows ( rowsという名前)にコピーします。 rowsベクトルは実際にはベクトルのベクトルです。rowsベクトルの各エントリには、そのrowsのデータ値を含むベクトルが含まれています。この組み合わせは、 JTableを構築するために必要となる二次元配列を形成しJTable 。 rowsベクトルを作成した後、プログラムは( rs.next()呼び出して) ResultSet内の各行を読み取ります。各行の各列に対して、 ゲッターメソッドは、その行/列の値を抽出し、値を追加rowValuesベクター。最後に、 showEmployee()は各rowValuesベクトルをrowValuesベクトルに追加しrows 。この時点で、ベクトル( labels )は列ヘッダーを含み、2番目の2次元ベクトル( rows )はテーブルのデータを含みます。これで、ベクトルとJTableを保持するJFrameからJTableを作成できます。showEmployees()メソッドは、 catchユーザに適切なメッセージを発生し、表示することができる任意のエラーをインターセプトするブロック。showEmployees()メソッドを呼び出した結果を図6.1に示します。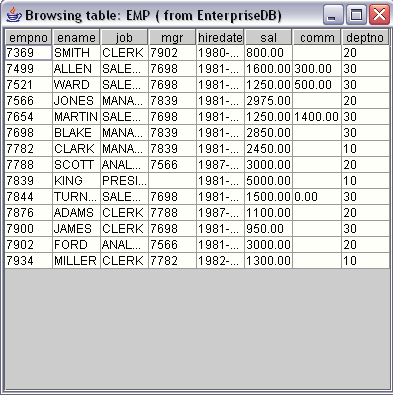 図6.1 - showEmployeesウィンドウ
前の例では、結果セットを JTable 表示するグラフィカルユーザーインタフェースを作成しました 。それでは、ギアを切り替えて、Advanced Server JDBC Connectorのより高度な機能のいくつかを紹介します。
Advanced Server JDBCドライバは、SQLクエリの結果を ResultSetオブジェクトとして取得します。クエリが多数の行を返す場合、バッチResultSetを使用すると以下のようになります。ResultSetオブジェクトのフェッチサイズを小さくすると、ドライバはネットワーク全体(サーバーからクライアントへ)でResultSet全体をコピーしません。代わりに、ドライバは一度に少数の行を要求します。クライアントアプリケーションが結果セット内を移動すると、ドライバはサーバーから次の行のバッチをフェッチします。
8.1.1 ステートメントオブジェクトのバッチサイズの変更ResultSetオブジェクトのバッチサイズを制限すると、データの取得が高速化され、クライアントサイドアプリケーションに必要なリソースが削減されます。リスト1.5は、5行に制限されたバッチサイズでStatementオブジェクトを作成します。呼び出し conn 。 setAutoCommit(false)すると、最初の行を取得する機会がある前に、サーバーはResultSet閉じません。 Connection準備したら、 Statementオブジェクトを構築できます。ResultSetにはテーブル内のすべての行が含まれていますが、それらはサーバーから一度に5行だけフェッチされることを忘れないでください 。クライアントの観点から見ると、 バッチ結果セットと未バッチ結果セットの唯一の違いは、 バッチ結果が短時間で最初の行を返すということです。
多くのアプリケーションは同じSQLステートメントを何度も繰り返し実行し、各繰り返しの間にステートメント内の1つ以上のデータ値を変更します。 Statementオブジェクトを使用してSQL文を繰り返し実行する場合、サーバは毎回文を解析、計画、および最適化する必要があります。 JDBCは、そのようなシナリオで必要な作業量を減らすために、 Statementの派生物であるPreparedStatementを提供しています。SQLステートメントでデータ値をハードコーディングする代わりに、反復ごとに変わる値を表すプレースホルダーを挿入します。リスト1.6は、2つのプレースホルダー(それぞれ疑問符で表されています)を含むINSERTステートメントを示しています。パラメータ化されたSQL文を使用すると、 AddEmployee()メソッドはConnectionオブジェクトにその文を準備してPreparedStatementオブジェクトを返すように依頼できます。この時点で、 PreparedStatementはINSERTステートメントを解析し計画していますが、テーブルに追加する値がわかりません。実行する前にPreparedStatement 、あなたはセッターメトdを呼び出すことにより、各プレースホルダの値を指定する必要があります。 setObject()は2つの引数をsetObject()ます。AddEmployee()メソッドは、従業員IDと名前をユーザに促し、呼び出しsetObject()ユーザによって供給された値を使用して:SQLステートメントが予想どおりに実行されると、 AddEmployee()は実行を確認するメッセージを表示します。サーバーで例外が発生した場合、エラー処理コードはエラーメッセージを表示します。
8.3 ストアドプロシージャを実行するストアドプロシージャは、EnterpriseDBのSPLで記述され、データベースに格納されているモジュールです。ストアドプロシージャは、プロシージャにデータを提供するための入力パラメータと、プロシージャからデータを返すための出力パラメータを定義できます。ストアドプロシージャはサーバー内で 実行され、データベースアクセスコマンド(SQL)、制御ステートメント、およびデータベースから取得したデータを操作するデータ構造で構成されています。8.3.1 ストアドプロシージャの呼び出しCallableStatementクラスは、ストアドプロシージャを呼び出すためのJavaプログラムのための方法を提供します。 CallableStatementオブジェクトは、入力( INパラメーター)、出力( OUTパラメーター)、またはその両方( IN OUTパラメーター)に使用される可変数のパラメーターを持つことができます。各疑問符は、パラメータのプレースホルダとして機能します。ストアドプロシージャは、プレースホルダが IN 、 OUT 、またはIN OUTパラメータを表し 、Javaコードが一致する必要があるかどうかを決定します。 IN (またはIN OUT )パラメータに値を指定する方法と、 OUT (またはIN OUT )パラメータに返された値をすぐに取得する方法について説明します。8.3.1.1 単純なストアドプロシージャの実行リスト1.7-aは、各従業員の給与を10%増やすストアドプロシージャを示しています。 increaseSalary 、発信者からの引数を期待していないし、任意の情報を返しません。1.7-Bをリスト起動する方法を示し increaseSalary手順を:Javaアプリケーションからストアドプロシージャを呼び出すには、 CallableStatementオブジェクトを使用します。 CallableStatementクラスは同様に、Statementクラスから派生しているStatementクラス、あなたが取得するCallableStatement尋ねることによってオブジェクトをConnectionあなたのための1つを作成するためにオブジェクトを。 ConnectionからCallableStatementを作成するには、 prepareCall()メソッドを使用します。名前が示すとおり、 prepareCall()メソッドは文を準備しますが、実行しません。次の例でわかるように、アプリケーションは通常prepareCall()の呼び出しとexecute()呼び出しの間にパラメーター値をバインドします。サーバー上でストアドプロシージャを呼び出すには、 execute()メソッドを呼び出します。このストアドプロシージャ( increaseSalary )はINパラメータを必要とせず、( OUTパラメータを使用して)呼び出し元に情報を返さなかったので、プロシージャを呼び出すことは単にCallableStatementオブジェクトを作成してからそのオブジェクトのexecute()メソッドを呼び出すことです。8.3.1.2 INパラメータを使用したストアドプロシージャの実行次の例のコードは、最初に empInsert というストアドプロシージャを作成して呼び出します 。 empInsertは、従業員情報を含むINパラメータ( empno 、 ename 、 job 、 sal 、 comm 、 deptno 、およびmgrです。 empInsert 、 empInsertはその情報をempテーブルに挿入します。setObject()メソッドは、値を結合しINまたはIN OUTプレースホルダ。 setObject()呼び出すたびに、パラメータ番号とそのパラメータにバインドする値が指定されます。8.3.1.3 OUTパラメータを使用したストアドプロシージャの実行次の例では、 deptSelect というSPLストアドプロシージャを作成して呼び出します 。このプロシージャでは、1つのINパラメータ(部門番号)が必要で、部門番号に対応する2つのOUTパラメータ(部門名と場所)が返されます。リスト1.9-aのコードはdeptSelectプロシージャを作成します。setObject()メソッドは、値を結合しINまたはIN OUTプレースホルダ。 setObject()を呼び出すときは、プレースホルダを(その序数で)識別し、そのプレースホルダの代わりに置き換える値を指定する必要があります。CallableStatementオブジェクトを実行する前に、 各 OUTパラメータのJDBCタイプを登録する必要があります。 JDBCタイプのregisterOutParameter()はregisterOutParameter()メソッドで行われます。この例では、 GetDeptInfo() 2つのOUTパラメータを登録し、(ストアドプロシージャの実行後に) OUTパラメータに返された値を取得します。両方のOUTパラメータはVARCHAR値として定義されているため、 GetDeptInfo()はgetString()メソッドを使用してOUTパラメータを取得します。8.3.1.4 IN OUTパラメータを使用したストアドプロシージャの実行次の例のコードは、 1つのINパラメータ( p_deptno )、2つのIN OUTパラメータ( p_empnoとp_ename )、および3つのOUTパラメータ( p_job 、 p_hiredate 、 p_sal )で定義された empQuery という名前のストアドプロシージャを作成して呼び出します 。 empQuery 、 empQueryは2つのIN OUTパラメータと3つのOUTパラメータで従業員に関する情報を返します。setInt()メソッドは、結合型特異セッターメソッドであるIntegerに値をIN又はIN OUTプレースホルダ。 setInt()呼び出すと、パラメータ番号が指定され、そのプレースホルダの代わりに代入する値が提供されます。setString()メソッドは、結合Stringに値IN又はIN OUTプレースホルダ。INパラメータを使用してプロシージャを呼び出す前に 、設定メソッドを使用してそのパラメータに値を割り当てる必要があります。 OUTパラメータを使用してプロシージャを呼び出す前に、そのパラメータの型を登録します。その後、getterメソッドを呼び出して返された値を取得できます。 IN OUTパラメータを定義するプロシージャを呼び出すときは、3つすべてのアクションを実行する必要があります。
A REF CURSORは、 OPEN文によって返されたクエリ結果セットへのポインタを含むカーソル変数です。静的カーソルとは異なり、 REF CURSORは特定の問合せに結び付けられていません。同じREF CURSOR変数を何回でも開くことがCURSORます。 異なるクエリを含むOPEN文。毎回、そのクエリに対して新しい結果セットが作成され、カーソル変数を介して利用可能になります。 REF CURSORは、あるプロシージャから別のプロシージャに結果セットを渡すこともCURSOR 。Advanced Serverは、 強い 型指定と弱い 型指定 の両方の REF の宣言をサポートしています。 CURSORs 。強く型付けされたカーソルは、予期される結果セットの形状 (各列の型)を宣言しなければなりません。厳密に型指定されたカーソルは、宣言された列を返すクエリでしか使用できません。異なる形状の結果セットを返すクエリでカーソルを開くと、サーバーは例外をスローします。一方、型の弱いカーソルは、任意の形状の結果セットを扱うことができます。リスト1.11-aに示すストアドプロシージャ( getEmpNames )は、サーバー上に2つのREF CURSORsを作成します。最初のREF CURSORにはemp表に委託された従業員のリストが含まれ、2番目のREF CURSORにはemp表に給与がempれた従業員のリストが含まれています。RefCursorSample()メソッドを呼び出す(1.11-Bリスト参照) getEmpName()ストアド・プロシージャと名前は、2つのそれぞれに返さ表示REF CURSOR変数:CallableStatement各準備REF CURSOR ( commissionedおよびsalaried )各カーソルは、ストアドプロシージャのIN OUTパラメータgetEmpNames():として返されますgetEmpNames():stmt.execute()を呼び出すと 、次の文が実行されます。getObject()メソッドは、最初のパラメータから値を取得しに結果をキャストResultSet 。次に、 RefCursorSampleはカーソルを繰り返し処理して、各委託従業員の名前を出力します。
BYTEAデータ・タイプはバイトのシーケンス内のバイナリ文字列を格納します。デジタル画像やサウンドファイルは、バイナリデータとして保存されることがよくあります。 Advanced Serverは、 BYTEAデータ型を介してバイナリデータを格納および取得できます。次のJavaサンプルは、 BYTEAデータをAdvanced Serverデータベースに格納してから、そのデータを取得する方法を示しています。この例では少しセットアップが必要です。リスト1.12-a、1.12-b、および1.12-cは、Javaの例のサーバーサイド環境を作成します。リスト1.12-aは BYTEAデータを格納するテーブル( emp_detail )を作成します 。 emp_detail 最初の列は従業員のID番号( INT型)を格納し、テーブルの主キーとして機能します。 2列目には、従業員の写真がBYTEA形式でBYTEAます。リスト1.13は ADD_PICプロシージャ(リスト1.12-b参照)を呼び出して写真をクライアントファイルシステムからサーバー上のemp_detailテーブルにコピーするJavaメソッドを示しています。InsertPic()は、従業員番号と画像ファイルの名前の入力をユーザーに求めます。要求されたファイルが存在しない場合、 InsertPic()はエラーメッセージを表示して終了します。次に、 InsertPic()はADD_PICプロシージャを呼び出すCallableStatementオブジェクト( stmt )をADD_PICます。最初のプレースホルダ( ? )は、 ADD_PIC ( p_empno )によって予期される最初のパラメータを表します。 2番目のプレースホルダーは2番目のパラメーターを表します( p_photo )。これらのプレースホルダーに実際の値を提供するために、 InsertPic()は2つの設定メソッドを呼び出します。最初のパラメータは型であるためINTEGER 、 InsertPic()呼び出しsetInt()のための値を提供する方法p_empno 。 2番目のパラメータはBYTEA型であるため、 InsertPic()はバイナリセッターメソッドを使用します。この場合、メソッドはsetBinaryStream():すべてうまく InsertPic() ば、 InsertPic()は画像がテーブルに追加されたことを確認するメッセージを表示します。エラーが発生した場合、 catchブロックはユーザーにメッセージを表示します。GetPic()は、ユーザーに従業員ID番号の入力を求めることから始めます。次に、 GetPic()は、1つのINパラメータと1つのOUTパラメータを使用してCallableStatementを準備します。最初のパラメータはデータベースから取得した写真を含むOUTパラメータです。写真はBYTEAデータなので、 GetPic()はパラメータをType.BINARYとして登録します。 2番目のパラメータは従業員番号( INT )を保持するINパラメータです。したがって、 GetPic()はsetInt()メソッドを使用して2番目のパラメータの値を提供します。FileOutputStreamオブジェクトは、宛先ファイル名に写真が含まれているバイナリデータを書き込みます。最後に、 GetPic()はファイルが新しい場所に保存されたことを確認するメッセージを表示します。
SQLの CREATE TYPEコマンドを使用して、Advanced Serverデータベースに格納されているユーザー定義のオブジェクト型を作成します。 CREATE TYPEコマンドは、一般に配列とも呼ばれるコレクションを作成するためにも使用され、これもAdvanced Serverデータベースに格納されます。ネストした表型のコレクションを使用して作成されCREATE TYPE AS TABLE OFコマンドを使用します。 CREATE TYPE VARRAYコマンドを使用してVARRAY型コレクションを作成します。
8.6.1 オブジェクト型の使用Advanced Serverデータベースにオブジェクト型を作成します。オブジェクト型 addr_object_typeは、住所の属性を定義します。オブジェクト型 emp_obj_typは、従業員の属性を定義します。前述のように、これらの属性の1つはオブジェクト型ADDR_OBJECT_TYPEです。オブジェクト型本体には、従業員情報を表示するメソッドが含まれています。CallableStatementオブジェクトは、に基づいて作成されdisplay_emp()のメソッドemp_obj_typオブジェクトタイプ:setObject()メソッドは、オブジェクトのインスタンスのバインドempにIN OUTプレースホルダを。
8.6.2 コレクションの利用関数から従業員IDを連結 NUMBER_ARRAY INから対応する行の従業員の名前のパラメータCHAR_ARRAY INパラメータ。結果として得られる連結エントリは、 CHAR_ARRAY OUTパラメータに返されます。CallableStatementオブジェクトを起動するために用意されconcatEmpIdName()関数:setObject()メソッドは、コレクションに結合empIdArrayとempNameArrayへINプレースホルダを:getArray()は、関数によって返されたコレクションを取得します。連結された従業員IDと名前からなる最初の2行が表示されます。
Advanced Server JDBC Connectorは非同期通知処理機能を提供します。 通知は、SPL(またはPL / pgSQLの)プログラムを実行するサーバによって生成されたメッセージであるRAISE NOTICEステートメント。各通知はサーバーからクライアントアプリケーションに送信されます。 JDBCクライアントで通知を傍受するには、 アプリケーションはNoticeListenerオブジェクト(またはより一般的にはNoticeListenerから派生したオブジェクト)を作成する必要があります。SPL(またはPL / pgSQL)プログラムの実行の結果として通知がクライアントに送信されることを理解することは重要です。通知を生成するには、ストアドプロシージャ、関数、またはトリガを呼び出すSQLステートメントを実行する必要があります。SQLステートメントの実行時に通知がクライアントに配信されます。通知はあらゆる種類のステートメントオブジェクトで機能します。 CallableStatementオブジェクト、 PreparedStatementオブジェクト、または単純なStatementオブジェクト。 JDBCプログラムは、 NoticeListenerをStatementオブジェクトに関連付けることによって通知をNoticeListenerします。場合Statementオブジェクトが通知を発生させたSQL文を実行し、JDBCを呼び出すnoticeReceived()関連で方法NoticeListener 。リスト1.18-aは、 empテーブルをループ処理して各従業員に10%の昇給を行うSPLプロシージャを示しています 。各従業員が処理されると、 adjustSalaryはRAISE NOTICEステートメントを実行します(この場合、通知に含まれるメッセージはクライアントアプリケーションに進行状況を報告します)。リスト1.18-bは、各通知を傍受するNoticeListenerを作成する方法を示しています。NoticeExample()メソッドは簡単です。呼び出し元からの単一の引数、 Connectionオブジェクトが必要です。NoticeExample()は、例1.10-aに示すadjustSalary手続きの呼び出しを準備することから始めます。ごcon.prepareCall() 、 con.prepareCall()はCallableStatementオブジェクトを返します。 CallableStatement実行する前に、 NoticeListenerインタフェースを実装するオブジェクトを作成し、そのオブジェクトをCallableStatement関連付けられているNoticeListenersのリストに追加する必要があります。一旦 NoticeListenerが所定の位置にある、NoticeExample方法は、(サーバー上adjustSalaryプロシージャを呼び出す) のCallableStatementを実行し、ユーザにメッセージを表示します。たび adjustSalary手順を実行RAISE NOTICE文は、サーバは(メッセージのテキストを送信し"Salary increased for ..."に) Statementクライアントアプリケーションで(または誘導体)のオブジェクトを。 JDBCは、呼び出しnoticeReceived()の呼び出し前に、方法(おそらく何回も) stmt.execute()完了します。
Advanced Server JDBC Connectorは、アプリケーションでJDBC Connectorを使用した場合の問題解決に役立つロギングの使用をサポートしています。 JDBC Connectorは、 JDK 1.4以降はJavaの一部であったjava.util.logging のロギングAPIを使用します 。 java.util.loggingについては、次のWebサイトで入手可能なThe PostgreSQL JDBC Driverを参照してください。注意:以前のバージョンのAdvanced Server JDBCコネクタでは、ロギングを有効にするためのカスタムメカニズムが使用されていましたが、コミュニティバージョン42.1.4.1以降のバージョンではjava.util.loggingを使用するようになりました。古いメカニズムはもう利用できません。
次の表は、Advanced ServerとJDBCコネクタでサポートされているJDBCデータ型の一覧です。 setObject()メソッドを使用してAdvanced Serverの型(中央の列に表示)にバインドしている場合は、左の列に表示されている型のJDBC値を指定します。データを取得すると、 getObject()メソッドは右端の列にリストされているオブジェクトタイプを返します。