アーキテクチャ
このセクションでは、KubernetesにPostgreSQLをデプロイするときに考慮する必要があるアーキテクチャの主な側面について説明します。
重要
セルフマネージドのKubernetes環境にPostgreSQLをデプロイする場合は、必ず Kubernetesアーキテクチャ をお読みください
クラウドネイティブの世界への旅の計画を開始するときは、以下をご覧ください。
状態の同期
PostgreSQLはデータベース管理システムであるため、Kubernetesで ステートフルなワークロード として扱う必要があります。ステートレスアプリケーションは主にトラフィックリダイレクトを使用して高可用性(HA)とディザスターリカバリー(DR)を達成しますが、データベースの場合、次のいずれかを採用することにより、状態を複数の場所に、好ましくは連続的かつ瞬時に複製する必要があります。 2つの戦略:
** ストレージレベルのレプリケーション*、通常は永続ボリューム
** アプリケーションレベルのレプリケーション*、この特定のケースではPostgreSQL
CloudNativePGは、単純な理由で、アプリケーションレベルのレプリケーションに依存しています。PostgreSQLデータベース管理システムには、堅牢で信頼性の高いビルトイン 物理レプリケーション 機能が搭載されています。 10年以上にわたり、世界中の何百万人ものユーザーが本番環境で使用しています。
PostgreSQLは、ネットワークを介した非同期と同期の両方のストリーミングレプリケーションと、非同期ファイルベースのログシッピング(通常、フォールバックオプションとして、たとえば、WALファイルをオブジェクトストアに保存するために使用されます)をサポートします。レプリカは通常 スタンバイサーバー と呼ばれ、 ホットスタンバイ 機能のおかげで、読み取り専用ワークロードにも使用できます。
重要
PostgreSQLを使用したストレージレベルのレプリケーションはお勧めしません。ただし、CloudNativePGではその戦略を採用できます。詳細については、KubeCon NA 2022でのChris MilstedとGabriele Bartoliniによる Data On Kubernetes, Deploying And Running PostgreSQL And Patterns For Databases In a Kubernetes Cluster と題された講演を参照してください。
このトピックが詳細に説明された場所。
Kubernetesアーキテクチャ
Kubernetesはネイティブに、冗長で低レイテンシーのプライベートネットワーク接続を介して互いに接続された、離れた物理的な場所(データセンター、障害ゾーン、またはより頻繁に アベイラビリティーゾーン とも呼ばれます)にまたがる可能性を提供します。
- 分散システムであるため、単一ゾーンの障害に対するコントロールプレーンの回復力を高めるために、Kubernetesクラスターの推奨される可用性ゾーンの最小数は3です。詳細は
Running in multiple zones を参照ください。これは、
各データセンターがいつでもアクティブ であり、ワークロードを同時に実行できることを意味します。
注釈
パブリッククラウドプロバイダーのマネージドKubernetesサービスのほとんどは、すでに各リージョンに3つ以上のアベイラビリティーゾーンを提供しています。
マルチアベイラビリティーゾーンKubernetesクラスター
3つ以上のゾーンを持つマルチアベイラビリティーゾーンKubernetesアーキテクチャは、PostgreSQLの使用をお勧めします。このシナリオは、クラウドプロバイダーによって管理されるKubernetesサービスの典型です。
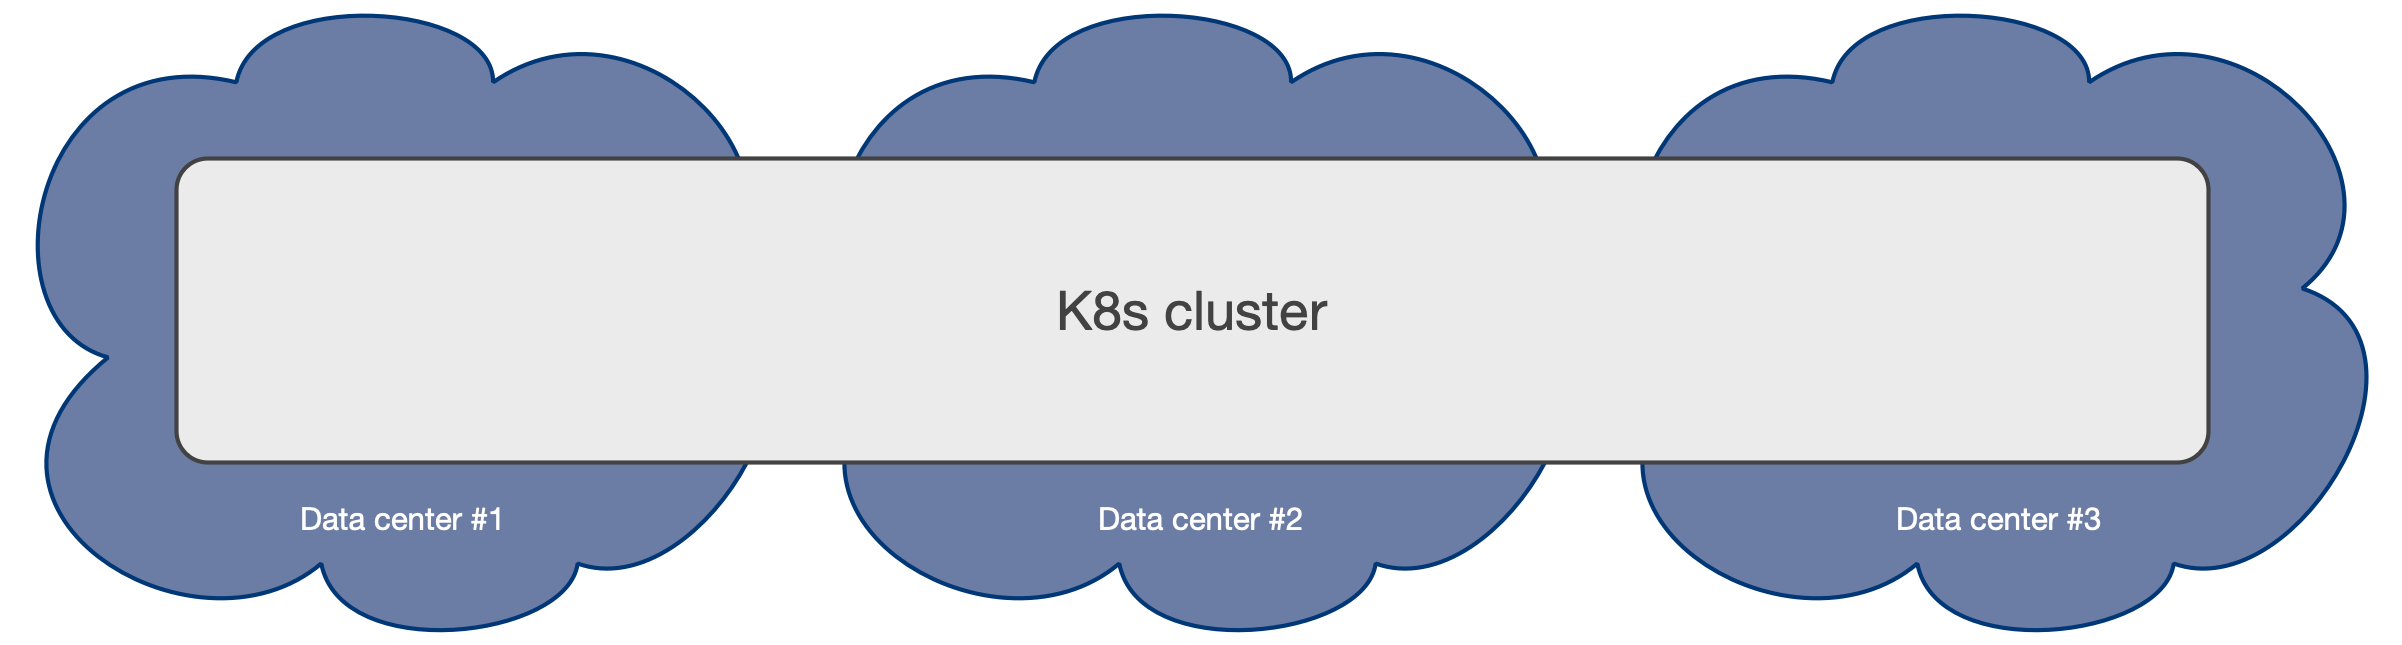
Kubernetes cluster spanning over 3 independent data centers
このようなアーキテクチャにより、CloudNativePGオペレーターは、すべてのアベイラビリティーゾーンをアクティブとして扱うことにより、単一のKubernetesクラスター内のゾーン全体でCluster
リソースのライフサイクル全体を制御できます。これには、他のオペレーションの中でも、宣言的な方法で スケジューリング ワークロード(ベースアフィニティルール、容認、ノードセレクターについて)、自動フェイルオーバー、自己修復、および更新。すべてが、単一のKubernetesクラスター内のゾーン間でシームレスに機能します。
PostgreSQLアーキテクチャ を参照してください
ストレージ、ワーカーノード、およびアベイラビリティーゾーンレベルでのシェアードナッシングデプロイメントを介して、同じKubernetesクラスター内でPostgreSQLクラスターを設計する方法の詳細については、以下のセクション。
さらに、追加の マルチアベイラビリティーゾーンKubernetesクラスター を利用して、それらを使用して「パッシブ」PostgreSQLレプリカクラスターをホストできます。この場合のフェイルオーバーとプロモーションは手動で行う必要がありますが、これは主にDR、読み取り専用オペレーション、またはクロスリージョンの可用性のために使用する必要があります。
単一のアベイラビリティーゾーンKubernetesクラスター
Kubernetesクラスターに1つだけのアベイラビリティーゾーンがある場合、CloudNativePGは引き続きPostgreSQLデータベースのHAとDRの結果を向上させるための多くの機能を提供し、単一障害点(SPoF)を可能な限りゾーンのレベルにプッシュします-つまり、CloudNativePGクラスターに障害が発生する前に、ゾーンが停止している必要があります。
このシナリオは、1つのデータセンターのみを使用できるセルフマネージドのオンプレミスKubernetesクラスターの一般的なシナリオです。
シングルアベイラビリティーゾーン Kubernetesは、残念ながら、低レイテンシー接続の届く範囲内(通常は同じ大都市圏)で 2つのデータセンター しか利用できない唯一の実行可能なオプションです。2つのゾーンしかないため、ユーザーはマルチ-アベイラビリティーゾーンKubernetesクラスター(3ゾーンの最小数に達していないため)し、アクティブ/パッシブ構成で2つの異なるKubernetesクラスターを作成するように強制します。2番目のクラスターは主にディザスターリカバリーに使用されます。
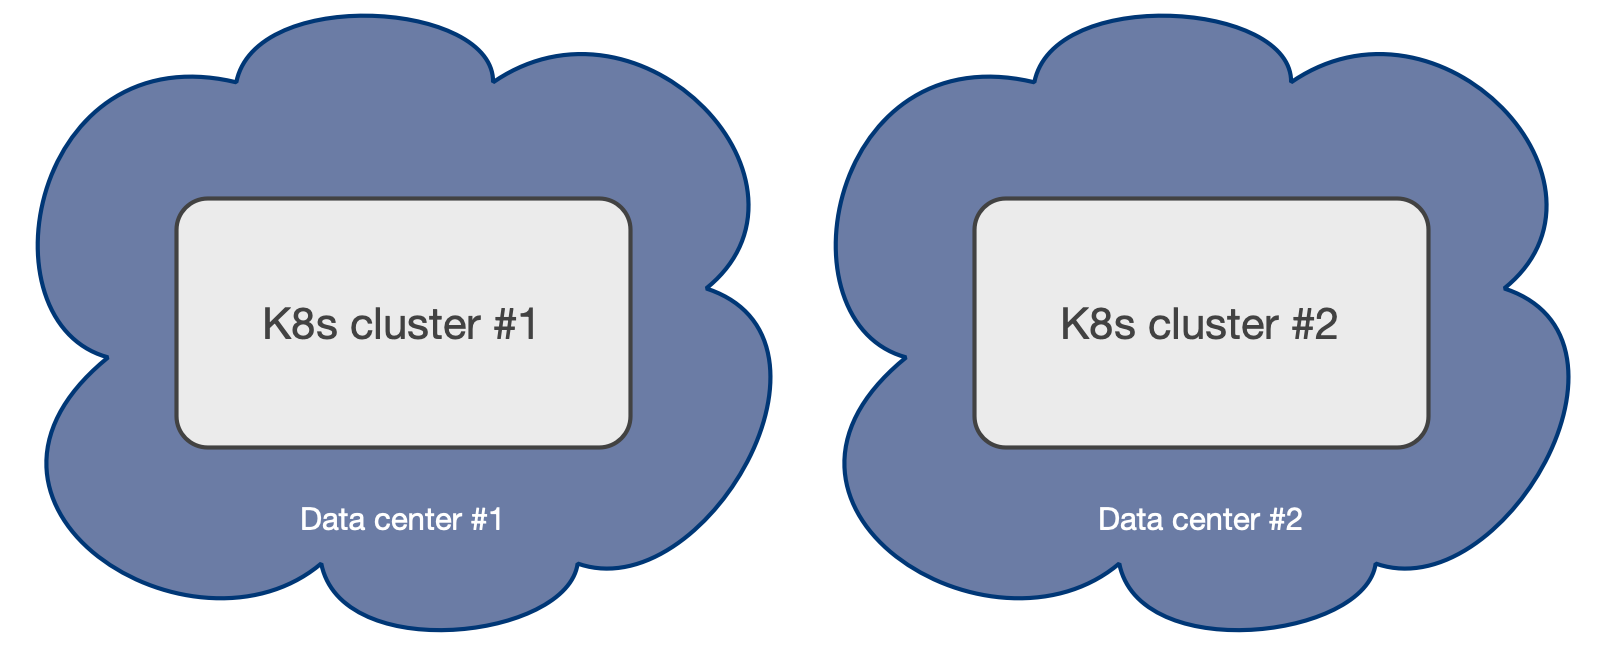
Example of a Kubernetes architecture with only 2 data centers
ヒント
Kubernetesジャーニーの初期段階にいる場合は、このドキュメントをインフラストラクチャチームと共有してください。 2つのデータセンターのセットアップは、従来のベアメタルまたはVMベースのインフラストラクチャからKubernetesへの「リフトアンドシフト」移行の結果である可能性があり、3つ以上のゾーンのシナリオでKubernetesが提供する利点は知られていない可能性があります、またはインフラストラクチャアーキテクチャが設計されたときに対処されました。最終的に、他の2つに接続された3番目の物理的な場所は、組織が検討する有効なオプションを表す場合があります。
PostgreSQLアーキテクチャ を参照してください
ストレージおよびワーカーノードレベルでのみシェアードナッシングデプロイメントを介して、単一のアベイラビリティーゾーンKubernetesクラスター内でPostgreSQLクラスターを設計する方法の詳細については、以下のセクション。 HAの場合、このようなシナリオでは、PostgreSQLインスタンスを異なるワーカーノードに配置し、同じストレージを共有しないことがさらに重要になります。
DRの場合、追加の マルチアベイラビリティーゾーンKubernetesクラスター を使用して「パッシブ」PostgreSQLレプリカクラスターをホストすることにより、SPoFをシングルゾーンより上にプッシュできます。このシナリオの他のKubernetesワークロードと同様に、プライマリとしてのKubernetesクラスターのプロモーションは手動で行う必要があります。以下で説明するように、オペレーターは単一のKubernetesクラスター内でのみ作業できるため、現時点ではCloudNativePGを使用したPostgreSQLでKubernetesクラスター間の自動フェールオーバーを利用できません。
PostgreSQLアーキテクチャ
CloudNativePGは、次の仕様で、非同期および同期ストリーミングレプリケーションに基づいたクラスターをサポートして、同じKubernetesクラスター内の複数のホットスタンバイレプリカを管理します。
1つのプライマリ、オプションでHA用の複数のホットスタンバイレプリカ
アプリケーションで利用可能なサービス: -rw
:アプリケーションはクラスターのプライマリインスタンスにのみ接続
``-ro``:アプリケーションは読み取り専用ワークロードのホットスタンバイレプリカにのみ接続
-r
:アプリケーションは読み取り専用ワークロードのインスタンスのいずれかに接続
PostgreSQLクラスターの復元力を高めるために推奨されるシェアードナッシングアーキテクチャ: PostgreSQLインスタンスは異なるKubernetesワーカーノードに存在し、ネットワークのみを共有する必要があります-結果として、インスタンスはストレージを共有せず、できればノードに接続されたローカルボリュームを使用するで実行 * PostgreSQLインスタンスは、同じKubernetesクラスター/リージョン内の異なるアベイラビリティーゾーンに存在する必要があります
次の図は、3つの異なるアベイラビリティーゾーンにまたがり、それぞれがPostgreSQLデータ用の専用ローカルストレージを備えた別々のノードで実行されているPostgreSQLクラスターに推奨されるシェアードナッシングアーキテクチャの単純なビューを提供します。
クラスターのトポロジが変更された場合、CloudNativePGは上記のサービスを自動的に更新します。たとえば、フェイルオーバーの場合、昇格したプライマリを指すように-rw
サービスを自動的に更新し、アプリケーションからのトラフィックがシームレスにリダイレクトされるようにします。
読み書きワークロード
次の図に示すように、アプリケーションは、Kubernetesオペレーターによって 現在のプライマリ として選択されたPostgreSQLインスタンスに接続することを決定できます。
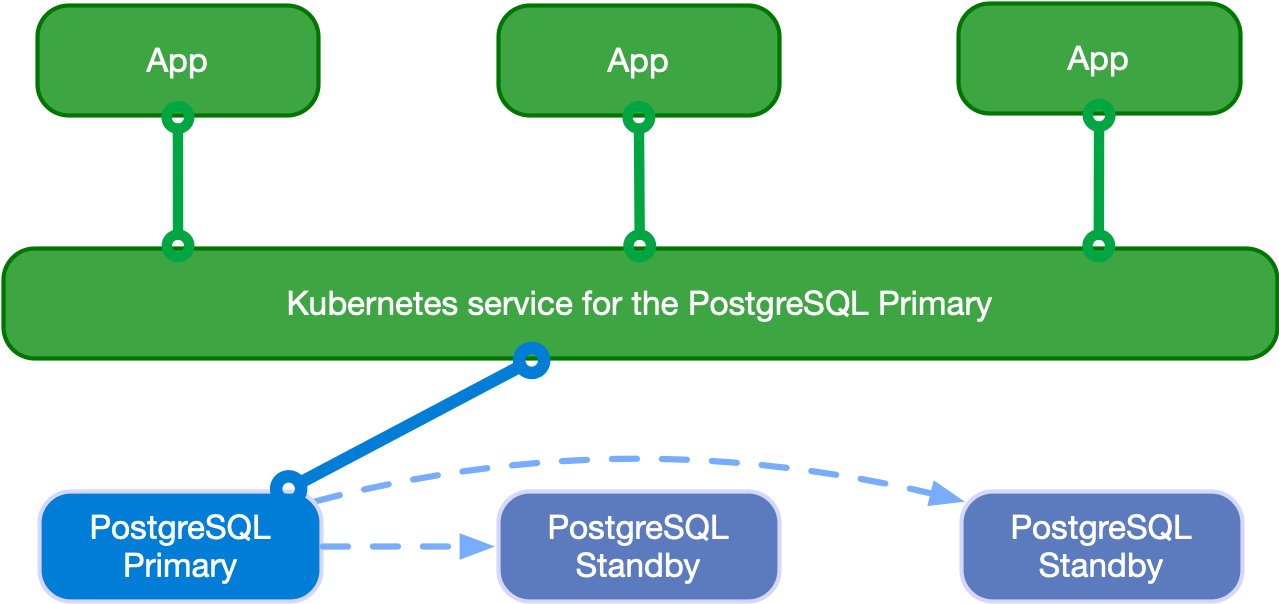
Applications writing to the single primary
アプリケーションは-rw サフィックスサービスを使用できます。
プライマリが一時的または永続的に利用できない場合、高可用性のためにCloudNativePGはフェイルオーバーをトリガーし、
-rw サービスをクラスターの別のインスタンスにポイントします。
読み取り専用ワークロード
重要
アプリケーションは、 Hot Standby
これらのワークロードを処理する際のPostgreSQLの動作を提示し、精通しています。
アプリケーションは、オペレーターが利用可能にした-ro
サービスを介して、ホットスタンバイレプリカにアクセスできます。このサービスにより、アプリケーションはプライマリノードから読み取り専用クエリをオフロードできます。
次の図は、アーキテクチャを示しています。
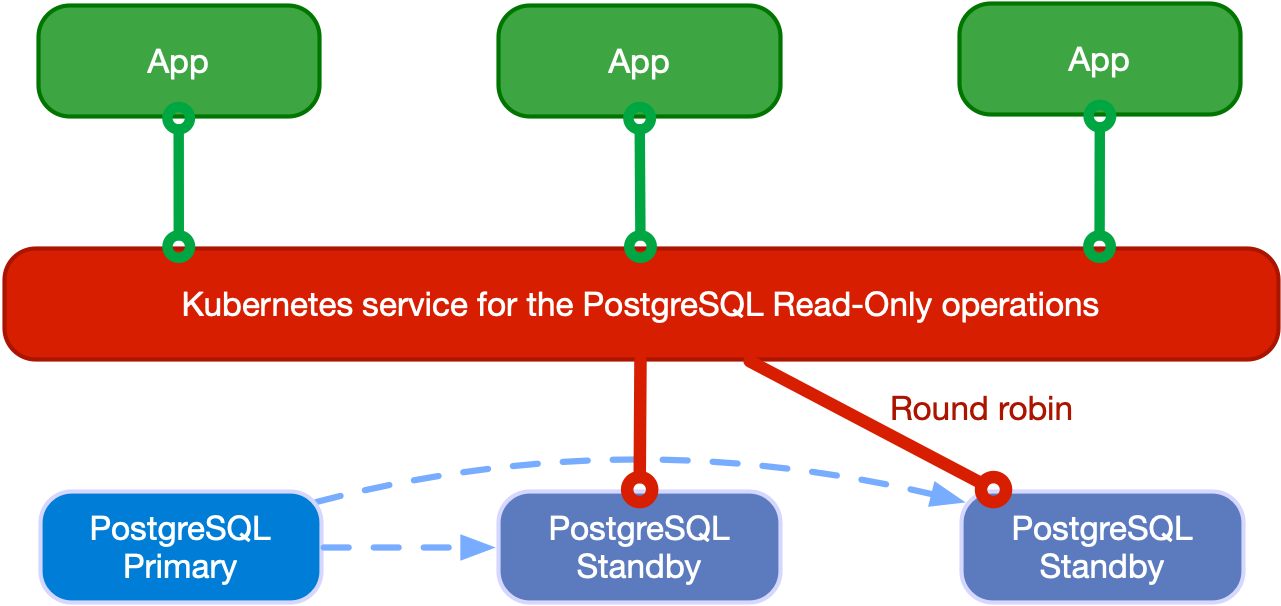
Applications reading from hot standby replicas in round robin
アプリケーションは、 -r
サービスを介して任意のPostgreSQLインスタンスにアクセスすることもできます。
Kubernetesクラスター間のデプロイメント
注釈
CloudNativePGは、このセクションで説明する**レプリカクラスター**と呼ばれる機能を介して、複数のKubernetesクラスターにわたるPostgreSQLのデプロイをサポートしています。
分散PostgreSQLクラスターでは、常にプライマリとして機能する1つのPostgreSQLインスタンスのみが存在できます。これは、アプリケーションがいつでも単一のKubernetesクラスター内にのみ書き込むことができることを意味します。
ただし、事業継続性の目標には、次のことが基本です。
PostgreSQLバックアップデータを複数の場所、リージョンに保存し、場合によっては異なるプロバイダーを使用することにより、グローバルな 目標復旧時点 (RPO)を削減します(ディザスターリカバリー)
プライマリKubernetesクラスターを超えてPostgreSQLレプリケーションを活用することにより、グローバルな 目標復旧時間 (RTO)を削減(高可用性)
上記の懸念に対処するために、CloudNativePGは PostgreSQLレプリカクラスター の概念を導入しています。レプリカクラスターは、プライベート、パブリック、ハイブリッド、マルチクラウドのコンテキストでマルチクラスターデプロイを有効にするCloudNativePGの方法です。
レプリカクラスターは別のCluster リソースです。
1.定義された外部ソースクラスターからのbootstrap
オプションとしてpg_basebackup または完全なrecovery を持つ
replica.enabledオプションをtrueに設定するreplica.sourceで識別される定義された外部クラスターからの複製、通常はKubernetesクラスターの外部にあります
4.リカバリオブジェクトストアから受信したWAL情報の再生(PostgreSQLのrestore_command
パラメーターを使用)、またはストリーミングレプリケーション(PostgreSQLのprimary_conninfo
パラメーターを使用)、または2つのいずれか( barmanObjectStore
とconnectionParameters
の両方が外部クラスターで定義されている場合)
PostgreSQLのホットスタンバイでサポートされている、読み取り接続のみを受け入れる
参考
別のPostgreSQLクラスター( externalClusters セクションで定義)からのクローン作成の詳細については、 BootstrapConfiguration を参照してください。
次の図は、2つの異なるKubernetesクラスターにまたがるPostgreSQLクラスターを示しています。プライマリクラスターは最初のKubernetesクラスターにあり、レプリカクラスターは2番目にあります。 2番目のKubernetesクラスターは、会社のディザスターリカバリークラスターとして機能し、災害が発生して最初のKubernetesクラスターが利用できなくなった場合にアクティブ化する準備ができています。
レプリカクラスターは、プライマリクラスターと同じアーキテクチャを持つことができます。プライマリインスタンスの代わりに、レプリカクラスターには 指定されたプライマリ インスタンスがあります。これは、ストリーミングレプリケーション(対称アーキテクチャ)で任意の数のカスケードスタンバイサーバーを持つスタンバイサーバーです。
指定されたプライマリはいつでも昇格でき、レプリカクラスターを書き込み接続を受け入れることができるプライマリクラスターにします。
警告
CloudNativePGは、現時点ではクラスター間のスイッチオーバーまたはフェイルオーバーを実行しません。このような操作は、手動で実行するか、マルチクラスター/フェデレーテッドクラスター対応機関に委任する必要があります。各PostgreSQLクラスターは、互いに独立しています。
上記の例で指定されたプライマリは、WALストリーミング(primary_conninfo
)を介して供給され、restore_command
およびbarman-cloud-wal-restore
を介したファイルベースのWALシッピングのフォールバックオプションがあります。
CloudNativePGでは、複数のレプリカクラスターを定義できます。より少ない数のレプリカでレプリカクラスターを定義し、クラスターがプライマリに昇格したときにこの数を増やすこともできます。