ベンチマーク
CNPG kubectlプラグインは、CloudNativePGを使用してKubernetesでPostgreSQLデプロイメントをベンチマークする簡単な方法を提供します。
ベンチマークは2つの側面に焦点を当てています。
重要
pgbench および`fio` は、ステージングまたは本番前環境で実行する必要があります。データベースや、同じ共有環境で実行される他のワークロード/アプリケーションに壊滅的な結果をもたらす可能性があるため、これらのプラグインを実稼働環境で使用しないでください。
pgbench
kubectl CNPGプラグインコマンド pgbench
は、既存のPostgresクラスターに対してユーザー定義のpgbench
ジョブを実行します。
--dry-run
フラグを介して、後で変更/実行するためにジョブのマニフェストを生成できます。
pgbench を使用した一般的なコマンド構造は次のとおりです。
kubectl cnpg pgbench \
  -n <namespace> <cluster-name> \
  --job-name <pgbench-job> \
  --db-name <db-name> \
  -- <pgbench options>
重要
pgbench を参照してください
ジョブで使用する特定のオプションについては。
この例では、pgbench
OLTPのような目的で、1000のスケール係数を使用してcluster-example
という名前のCluster 内のapp
データベースを初期化するpgbench-init というジョブを作成します。
kubectl cnpg pgbench \
  --job-name pgbench-init \
  cluster-example \
  -- --initialize --scale 1000
注釈
これにより、100000000レコードのデータベースが生成され、ディスク上に約13GBの領域が必要になります。
ジョブの進行状況は次のコマンドで確認できます。
shell kubectl logs jobs/pgbench-run
次の例では、単一の接続を使用して、以前に初期化されたデータベースに対してpgbench
を30秒間実行するpgbench-run というジョブを作成します。
kubectl cnpg pgbench \
  --job-name pgbench-run \
  cluster-example \
  -- --time 30 --client 1 --jobs 1
次の例では、 --db-name フラグとpgbench
名前空間を使用して、既存のデータベースに対してpgbench
を実行します。
kubectl cnpg pgbench \
  --db-name pgbench \
  --job-name pgbench-job \
  cluster-example \
  -- --time 30 --client 1 --jobs 1
特定のワーカーノードでpgbench ジョブを実行する場合は、
--node-selector オプションを使用できます。 workload=pgbench
ラベルを持つノードで以前の初期化ジョブを実行すると仮定すると、次を実行できます。
kubectl cnpg pgbench \
  --db-name pgbench \
  --job-name pgbench-init \
  --node-selector workload=pgbench \
  cluster-example \
  -- --initialize --scale 1000
ジョブのステータスは、次を実行して取得できます。
kubectl get job/pgbench-job -n <namespace>

NAME       COMPLETIONS   DURATION   AGE
job-name   1/1           15s        41s
ジョブが完了したら、次を実行して結果を収集できます。
kubectl logs job/pgbench-job -n <namespace>
fio
kubectl CNPGプラグインコマンド fio
は、デフォルト値と読み取り操作でfioジョブを実行します。 --dry-run
フラグを使用して、後で変更/実行するためにジョブのマニフェストを生成できます。
注釈
kubectlプラグインコマンド fio は、 ConfigMapを使用して、事前定義されたfioジョブ値でデプロイメントを作成します。カスタムジョブ値を提供する場合は、 --dry-run フラグを使用してマニフェストを生成し、生成されたConfigMapでカスタムジョブ値を提供することをお勧めします。
デフォルトの使用例:
kubectl cnpg fio <fio-name>
```カスタム値の例:

```shell
kubectl cnpg fio <fio-name> \
  -n <namespace>  \
  --storageClass <name> \
  --pvcSize <size>
fio 名前空間のstandard およびpvcSize: 2Gi
という名前のStorageClass に対してfio
コマンドを実行する方法の例:
kubectl cnpg fio fio-job \
  -n fio  \
  --storageClass standard \
  --pvcSize 2Gi
展開ステータスは、次を実行して取得できます。
kubectl get deployment/fio-job -n fio

NAME          READY   UP-TO-DATE   AVAILABLE   AGE
fio-job        1/1     1            1           14s
kubectlプラグインコマンド fio を実行した後。
それはします:
1.PVCを作成する
1.fioジョブの構成を表すConfigMapを作成します
1.単一のPodで構成されるfioデプロイメントを作成します。PVCでfioを実行し、ベンチマークの完了後にグラフを作成し、生成されたファイルのWebサーバーでの提供を開始します。そのために fio-tools <https://github.com/wallnerryan/fio-tools>`__ 画像を使用します。
デプロイメントによって作成されたPodは、結果の提供を開始すると準備が整います。デプロイで作成されたポッドのポートを転送できます
kubectl port-forward -n <namespace> deployment/<fio-name> 8000
ブラウザを使用してhttp://localhost:8000/
に接続し、データを取得します。
デフォルトの8kブロックサイズは、PostgreSQLワークロードをエミュレートするために選択されています。使用可能なIOPSの量を制限するディスクは、このパラメーターを変更すると、非常に異なるスループット値を示す場合があります。
以下は、専用のKubernetesノードにマウントされたローカルディスクへのシーケンシャル書き込みの例図です(1時間のベンチマーク)。
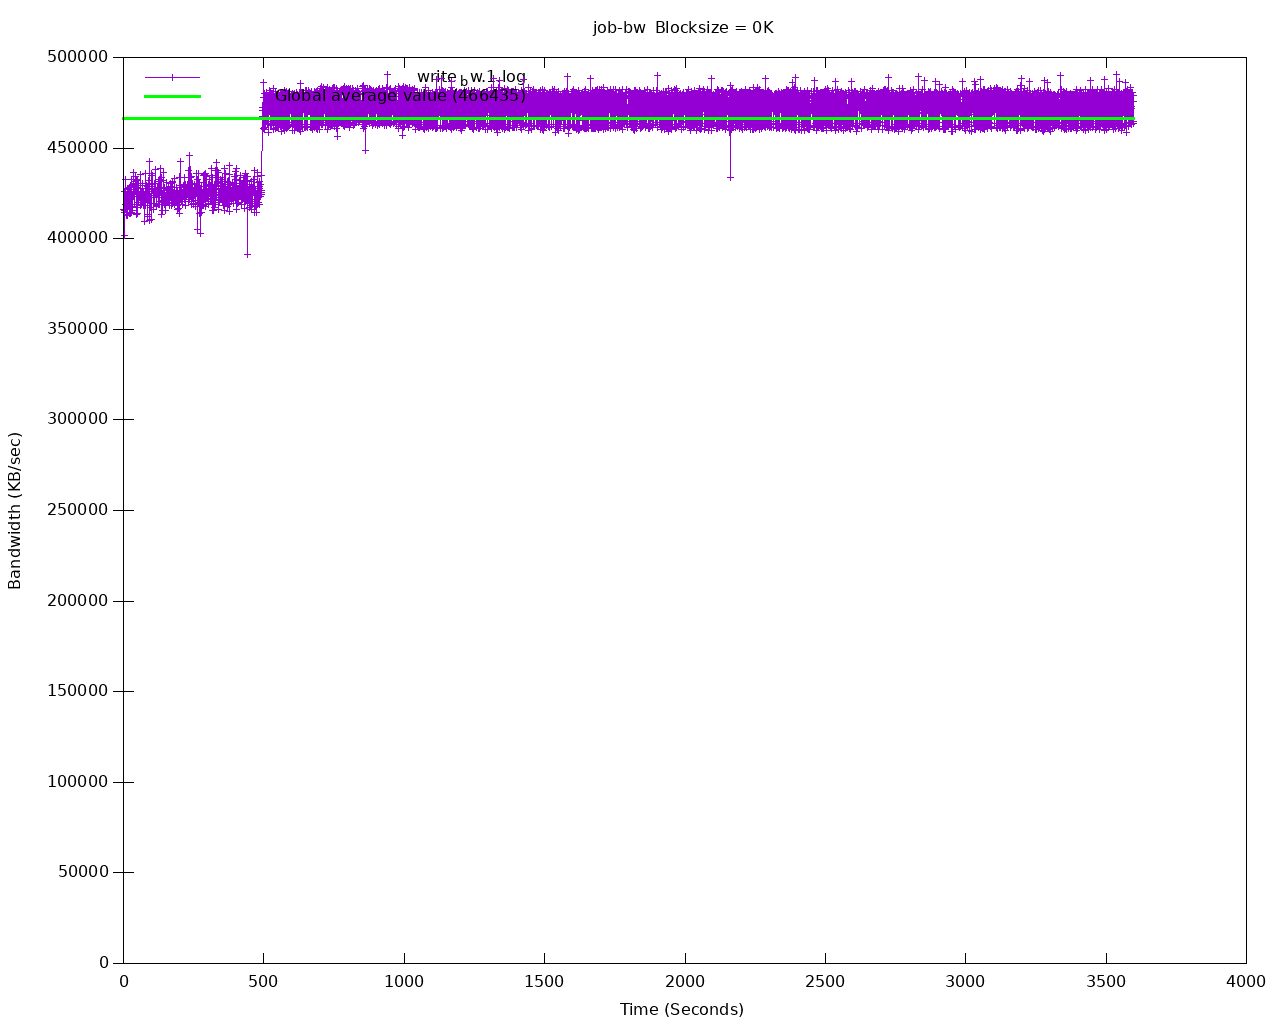
Sequential writes bandwidth
すべてのテストが完了したら、次の方法でfioのデプロイとリソースを削除できます。
shell kubectl cnpg fio <fio-job-name> --dry-run | kubectl delete -f -
fioデプロイメントの作成に使用したものと同じ名前を使用し、必要に応じて名前空間を追加してください。