建築
このセクションでは、PostgreSQL を Kubernetes にデプロイする際に考慮する必要がある主なアーキテクチャの側面について説明します。
重要
自己管理型の Kubernetes 環境に PostgreSQL をデプロイする場合は、必ず Kubernetes アーキテクチャ をお読みください。
クラウド ネイティブの世界への旅を計画し始めるときは、以下をご覧ください。
状態の同期
PostgreSQL はデータベース管理システムであるため、Kubernetes では ステートフルワークロード として扱う必要があります。ステートレス アプリケーションは主にトラフィック リダイレクトを使用して高可用性 (HA) と災害復旧 (DR) を実現しますが、データベースの場合、次のいずれかを採用することにより、できれば継続的かつ瞬時に状態を複数の場所にレプリケートする必要があります。 2 つの戦略:
ストレージ レベルのレプリケーション、通常は永続的なボリューム
アプリケーションレベルのレプリケーション、この特定のケースでは PostgreSQL
CloudNativePG がアプリケーション レベルのレプリケーションに依存している理由は単純です。PostgreSQL データベース管理システムには、 WriteAheadLog(WAL)出荷 に基づく堅牢で信頼性の高い組み込みの 物理レプリケーション 機能が付属しています。 10 年以上にわたり、世界中の何百万人ものユーザーが本番環境で使用しています。
PostgreSQL は、ネットワークを介した非同期と同期の両方のストリーミングレプリケーションと、非同期のファイルベースのログ シッピング (通常は、WAL ファイルをオブジェクト ストアに格納するためのフォールバック オプションとして使用されます) をサポートしています。レプリカは通常、スタンバイ サーバーと呼ばれ、ホット スタンバイ機能のおかげで、読み取り専用のワークロードにも使用できます。
重要
PostgreSQL を使用したストレージ レベルのレプリケーションはお勧めしません。ただし、CloudNativePG ではその戦略を採用できます。詳細については、KubeCon NA 2022 での Chris Milsted と Gabriele Bartolini による講演 Data On Kubernetes, Deploying And Running PostgreSQL And Patterns For Databases In a Kubernetes Cluster を参照してください。
このトピックについて詳しく説明されている場所。
Kubernetes アーキテクチャ
Kubernetes は、個別の物理的な場所 (データ センター、障害ゾーン、またはより頻繁には 可用性ゾーン とも呼ばれる) にまたがる可能性をネイティブに提供し、冗長で低遅延のプライベート ネットワーク接続を介して相互に接続します。
分散システムであるため、単一ゾーンの障害に対するコントロール プレーンの回復力を高めるために、Kubernetes クラスターの推奨される可用性ゾーンの最小数は 3 です。詳細は
Running in multiple zones を参照してください。これは、
各データセンターが常にアクティブで 、ワークロードを同時に実行できることを意味します。
注釈
パブリック クラウド プロバイダーのマネージド Kubernetes サービスのほとんどは、各リージョンに 3 つ以上のアベイラビリティ ゾーンをすでに提供しています。
マルチアベイラビリティ ゾーンの Kubernetes クラスタ
3 つ以上のゾーンを持つマルチアベイラビリティ ゾーン Kubernetes アーキテクチャは、PostgreSQL の使用に推奨されるものです。このシナリオは、クラウド プロバイダーによって管理される Kubernetes サービスの典型です。
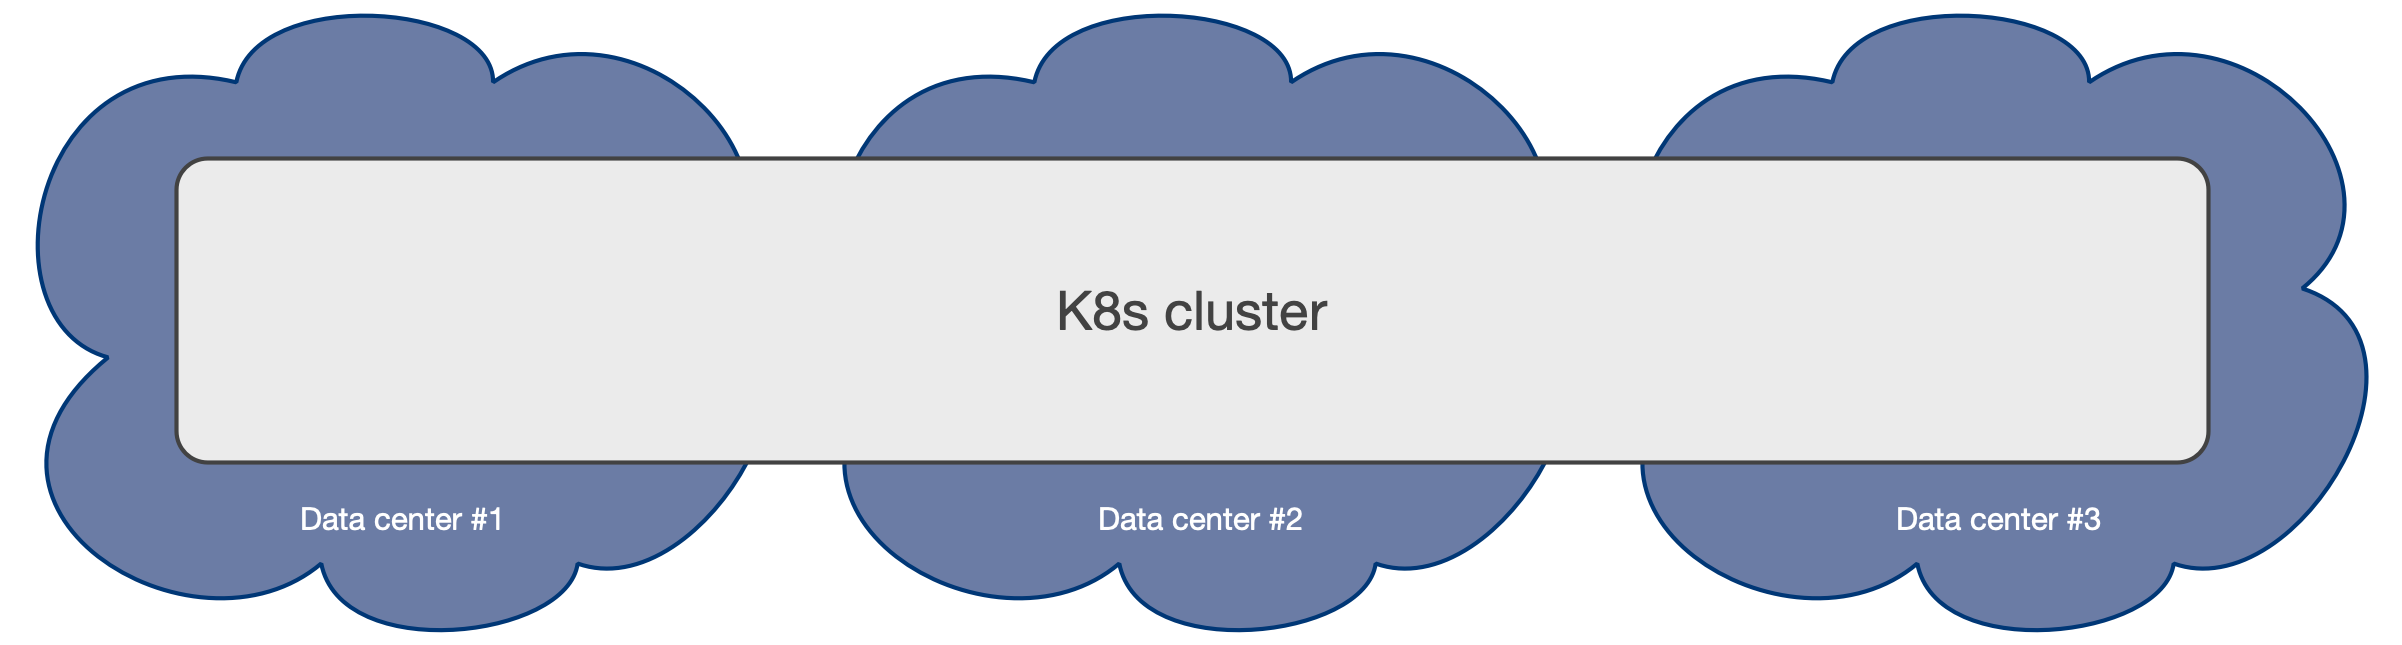
Kubernetes cluster spanning over 3 independent data centers
このようなアーキテクチャにより、CloudNativePG
オペレーターは、すべてのアベイラビリティ
ゾーンをアクティブとして扱うことにより、単一の Kubernetes
クラスター内のゾーン全体で Cluster
リソースの完全なライフサイクルを制御できます。アフィニティ
ルール、容認、およびノード
セレクターで)、自動フェイルオーバー、自己修復、および更新を行います。すべてが単一の
Kubernetes クラスター内のゾーン間でシームレスに機能します。
PostgreSQL のアーキテクチャ を参照してください。
ストレージ、ワーカーノード、およびアベイラビリティ ゾーン レベルでシェアード ナッシング デプロイを使用して、同じ Kubernetes クラスター内で PostgreSQL クラスターを設計する方法の詳細については、以下のセクションを参照してください。
さらに、追加の マルチアベイラビリティ ゾーンの Kubernetes クラスタ を利用して、「パッシブ」PostgreSQL レプリカ クラスターをホストすることができます。これは主に、DR、読み取り専用操作、またはリージョン間の可用性のために使用する必要がありますが、この場合のフェイルオーバーとプロモーションは手動で行う必要があります。
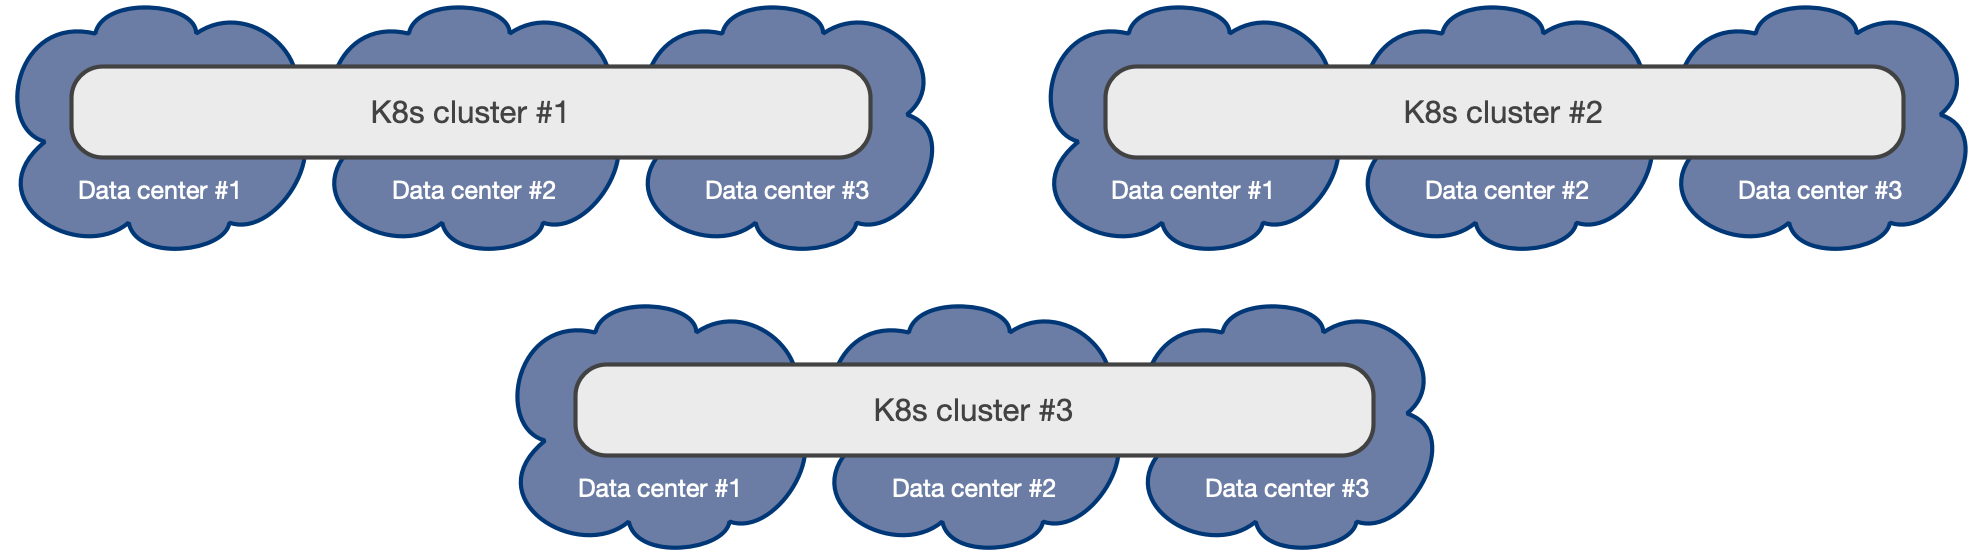
Example of a multiple Kubernetes cluster architecture distributed over 3 regions each with 3 independent data centers
単一の可用性ゾーンの Kubernetes クラスター
Kubernetes クラスターにアベイラビリティ ゾーンが 1 つしかない場合でも、CloudNativePG は PostgreSQL データベースの HA と DR の結果を改善する多くの機能を提供し、単一障害点 (SPoF) を可能な限りゾーンのレベルに押し上げます -つまり、CloudNativePG クラスターに障害が発生する前に、ゾーンを停止する必要があります。
このシナリオは、1 つのデータ センターしか使用できない自己管理型オンプレミス Kubernetes クラスターの典型です。
シングル アベイラビリティ ゾーン Kubernetes は、残念ながら、低遅延接続 (通常は同じ大都市圏) の範囲内で 2つのデータセンター しか利用できない場合に実行可能な唯一のオプションです。 -可用性ゾーン Kubernetes クラスター (3 つのゾーンの最小数に達していないため) をアクティブ/パッシブ構成で 2 つの異なる Kubernetes クラスターを作成するように強制し、2 番目のクラスターは主に災害復旧に使用されます。
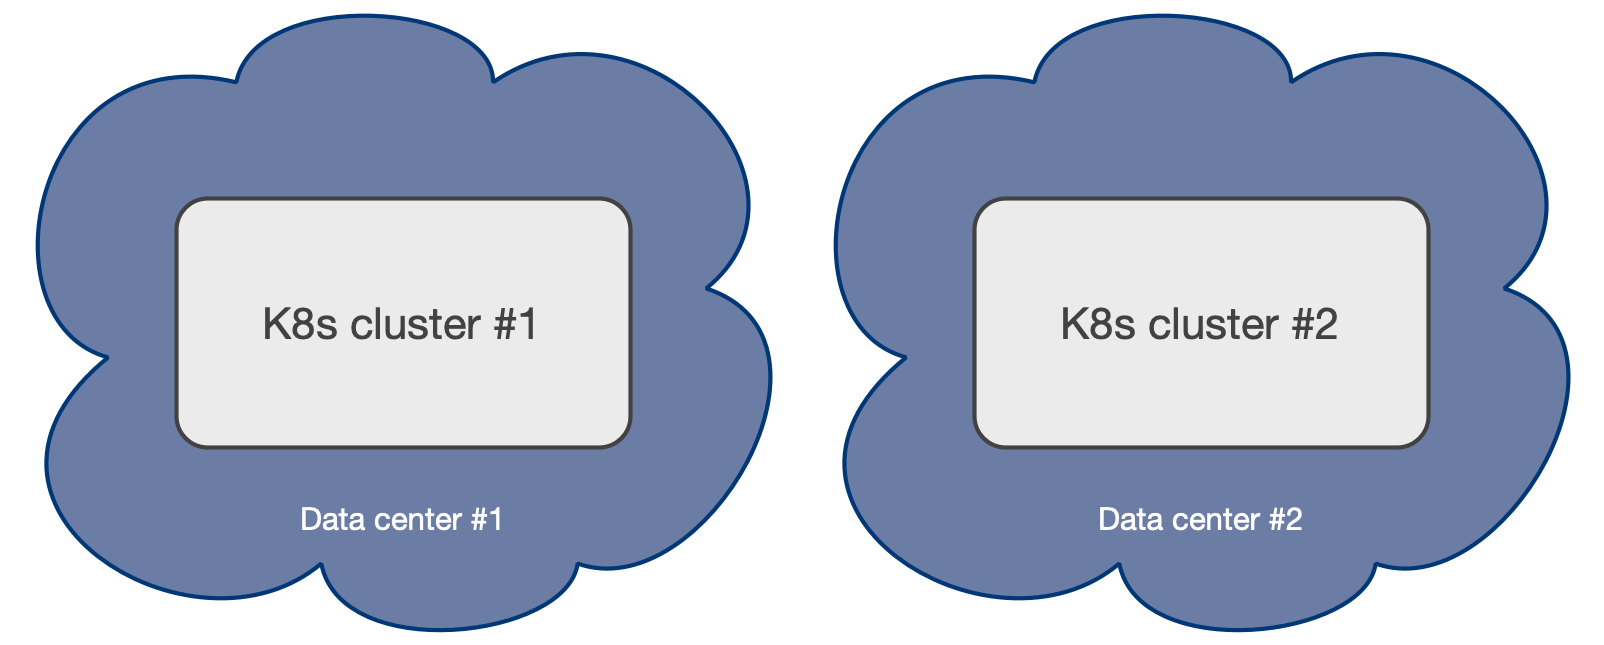
Example of a Kubernetes architecture with only 2 data centers
ヒント
Kubernetes ジャーニーの初期段階にある場合は、このドキュメントをインフラストラクチャ チームと共有してください。 2 つのデータ センターのセットアップは、従来のベアメタルまたは VM ベースのインフラストラクチャから Kubernetes への「リフト アンド シフト」移行の結果にすぎない可能性があり、3 つ以上のゾーンのシナリオで Kubernetes が提供する利点は知られていない可能性があります。 、またはインフラストラクチャ アーキテクチャの設計時に対処されました。最終的に、他の 2 つの場所に接続された 3 番目の物理的な場所は、組織にとって検討すべき有効なオプションになる可能性があります。これは、日々の複雑さをアプリケーション レベルから物理インフラストラクチャ レベルに移行することで、インフラストラクチャの全体的なコストを削減するためです。
PostgreSQL のアーキテクチャ を参照してください。
ストレージ レベルとワーカーノード レベルのみでシェアード ナッシング デプロイを使用して、単一の可用性ゾーンの Kubernetes クラスター内で PostgreSQL クラスターを設計する方法の詳細については、以下のセクションを参照してください。 HA の場合、このようなシナリオでは、PostgreSQL インスタンスが異なるワーカーノードに配置され、同じストレージを共有しないことがさらに重要になります。
DR の場合、追加の マルチアベイラビリティ ゾーンの Kubernetes クラスタ を使用して「パッシブ」PostgreSQL レプリカ クラスターをホストすることにより、単一ゾーンの上に SPoF をプッシュできます。このシナリオの他の Kubernetes ワークロードと同様に、プライマリとしての Kubernetes クラスターの昇格は手動で行う必要があります。以下で説明するように、オペレーターは単一の Kubernetes クラスター内でしか動作できないため、現時点では、CloudNativePG を使用した PostgreSQL で使用できる Kubernetes クラスター間の自動フェイルオーバーはありません。
PostgreSQL のアーキテクチャ
CloudNativePG は、非同期および同期ストリーミングレプリケーションに基づくクラスターをサポートし、同じ Kubernetes クラスター内で複数のホット スタンバイ レプリカを管理します。仕様は次のとおりです。
1 つのプライマリ、オプションで HA 用の複数のホット スタンバイ レプリカ
アプリケーションで利用可能なサービス: *
-rw: アプリケーションはクラスターのプライマリ インスタンスにのみ接続します *-ro: アプリケーションは読み取り専用ワークロードのホット スタンバイ レプリカにのみ接続します *-r: アプリケーションは読み取り専用ワークロードのいずれかのインスタンスに接続しますPostgreSQL クラスターの回復力を高めるために推奨されるシェアード ナッシング アーキテクチャ: * PostgreSQL インスタンスは異なる Kubernetesワーカーノードに存在し、ネットワークのみを共有する必要があります。 * PostgreSQL インスタンスは、同じ Kubernetes クラスタ / リージョン内の異なるアベイラビリティ ゾーンに存在する必要があります
以下の図は、3 つの異なるアベイラビリティー ゾーンにまたがる PostgreSQL クラスターの推奨されるシェアード ナッシング アーキテクチャを単純化して示したもので、それぞれが PostgreSQL データ専用のローカル ストレージを備えた個別のノードで実行されます。
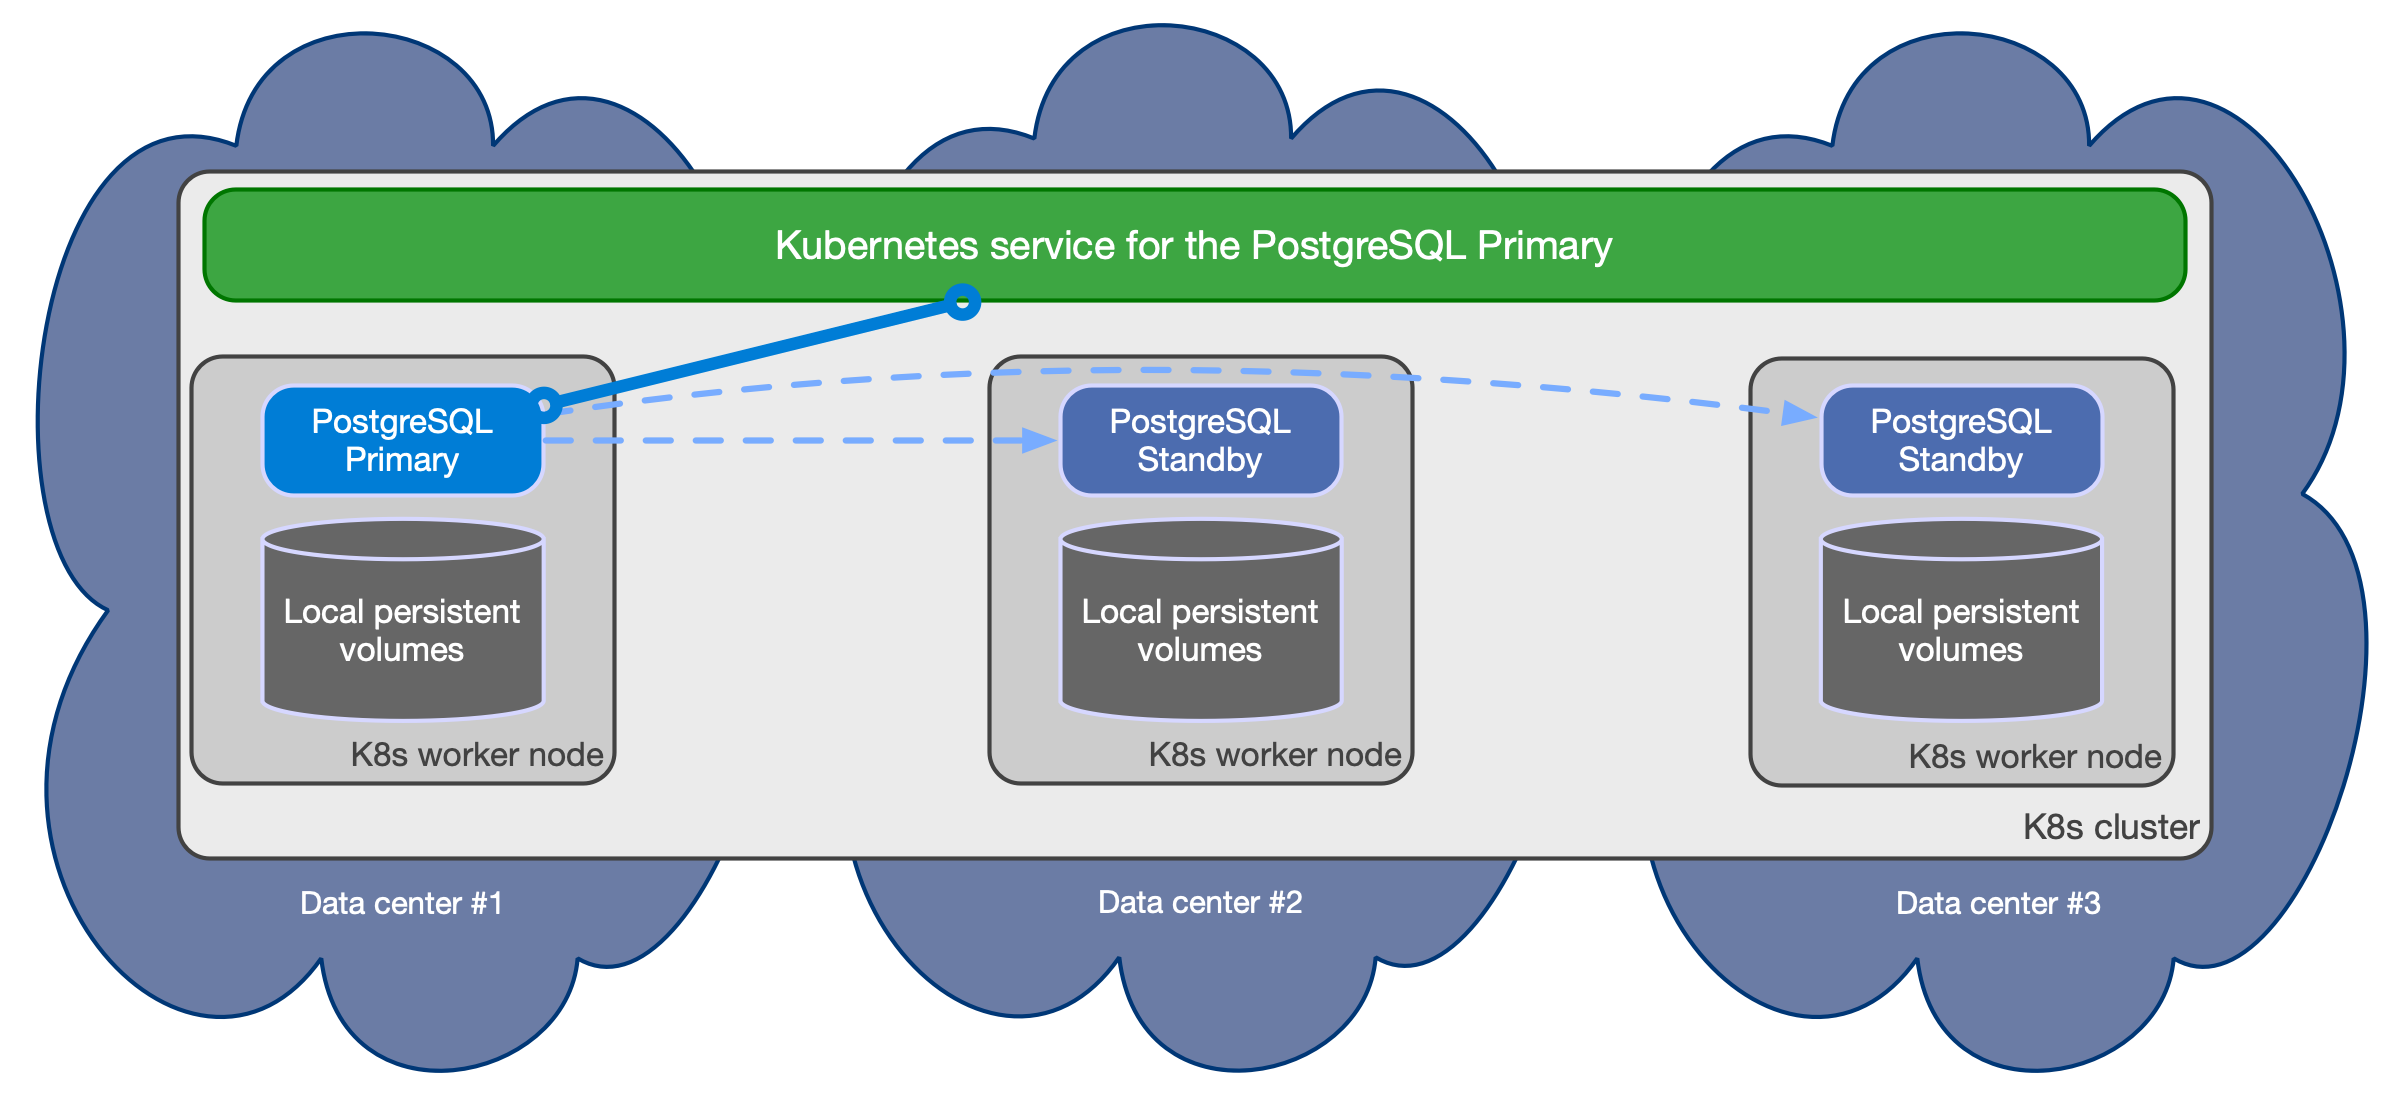
Bird-eye view of the recommended shared nothing architecture for PostgreSQL in Kubernetes
クラスタのトポロジが変更された場合、CloudNativePG
は上記のサービスを自動的に更新します。たとえば、フェイルオーバーの場合、-rw
サービスを自動的に更新して、昇格したプライマリを指すようにし、アプリケーションからのトラフィックがシームレスにリダイレクトされるようにします。
読み書きワークロード
次の図に示すように、アプリケーションは、Kubernetes オペレーターによって「現在のプライマリ」として選択された PostgreSQL インスタンスに接続することを決定できます。
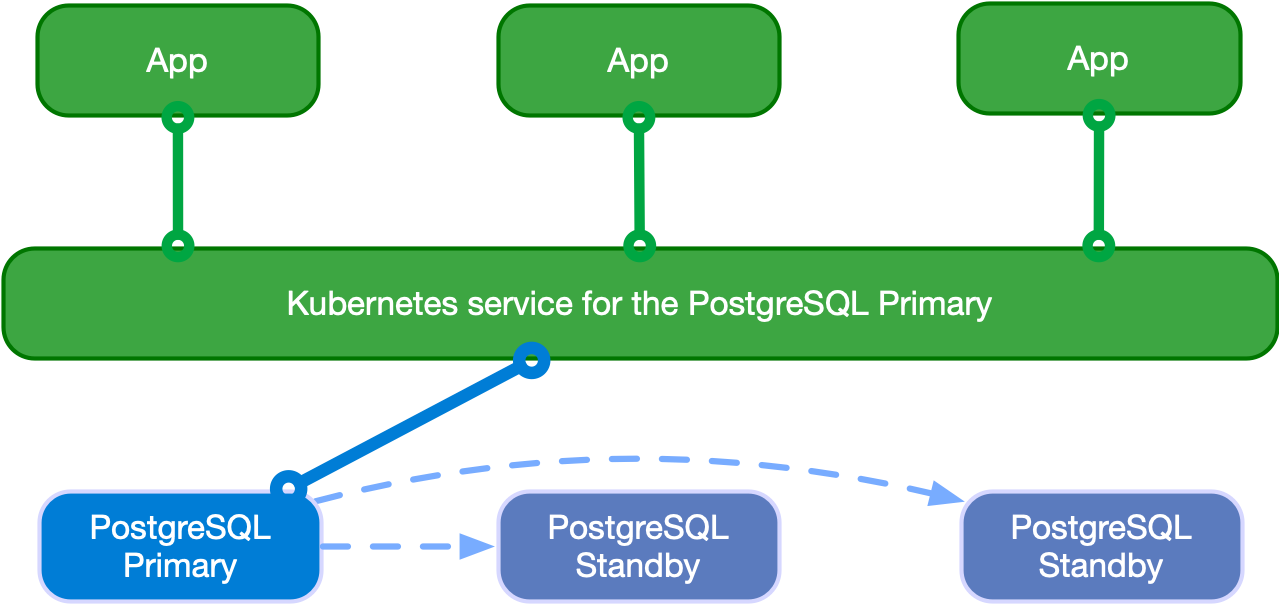
Applications writing to the single primary
アプリケーションは -rw サフィックス サービスを使用できます。
プライマリが一時的または永続的に利用できない場合、高可用性の目的で
CloudNativePG はフェイルオーバーをトリガーし、-rw
サービスをクラスターの別のインスタンスにポイントします。
読み取り専用ワークロード
重要
アプリケーションは、 Hot Standby の制限を認識している必要があります。
これらのワークロードを処理する際の PostgreSQL の動作方法を紹介し、熟知しています。
アプリケーションは、オペレーターが提供する -ro
サービスを介してホット スタンバイ
レプリカにアクセスできます。このサービスにより、アプリケーションはプライマリ
ノードから読み取り専用クエリをオフロードできます。
次の図は、アーキテクチャを示しています。
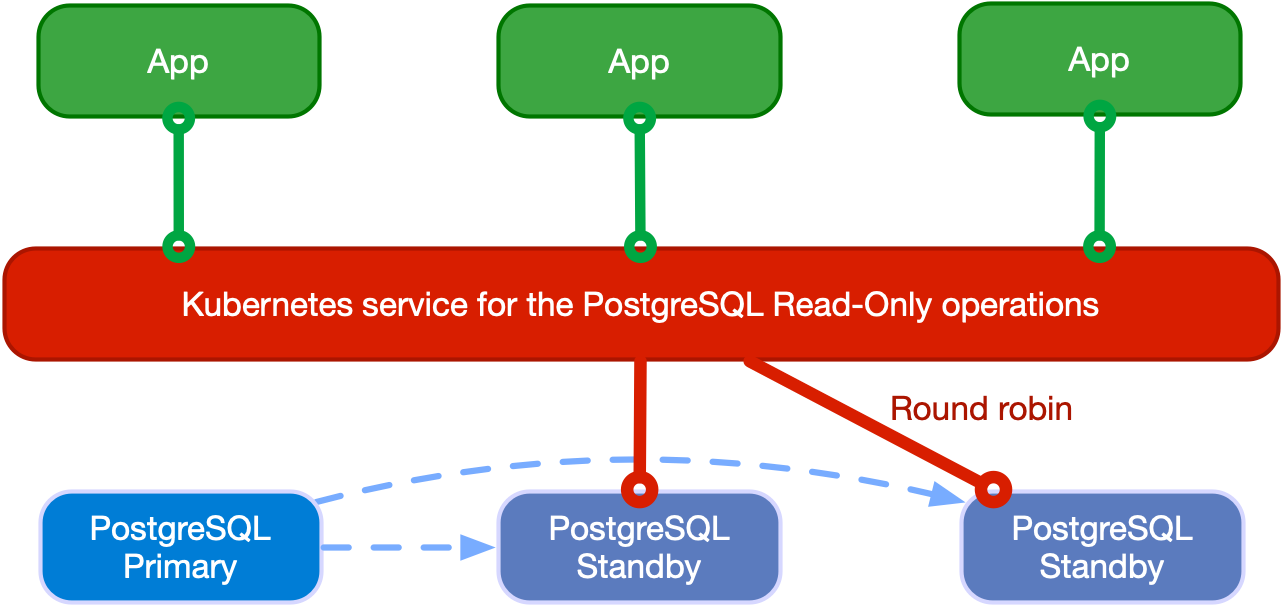
Applications reading from hot standby replicas in round robin
アプリケーションは、-r サービスを介して任意の PostgreSQL
インスタンスにアクセスすることもできます。
Kubernetes クラスター全体へのデプロイ
分散 PostgreSQL クラスタでは、常にプライマリとして機能する 1 つの PostgreSQL インスタンスしか存在できません。これは、アプリケーションがいつでも 1 つの Kubernetes クラスター内でしか書き込みできないことを意味します。
ただし、ビジネス継続性の目的では、次のことが基本となります。
PostgreSQL バックアップ データを複数の場所、リージョンに保存し、場合によっては異なるプロバイダーを使用することで、グローバル 目標復旧時点 (RPO) を削減します (ディザスター リカバリー)
プライマリ Kubernetes クラスターを超えた PostgreSQL レプリケーションを利用することで、グローバル 目標復旧時間 (RTO) を短縮します (高可用性)
上記の問題に対処するために、CloudNativePG は PostgreSQL レプリカ クラスター の概念を導入しています。レプリカ クラスターは、プライベート、パブリック、ハイブリッド、およびマルチクラウドのコンテキストでマルチクラスター展開を可能にする CloudNativePG の方法です。
レプリカ クラスターは別の Cluster リソースです。
定義された外部ソース クラスタからの
bootstrapオプションとしてpg_basebackupまたは完全なrecoveryを持つreplica.enabledオプションをtrueに設定するreplica.sourceで識別される定義済みの外部クラスター (通常は Kubernetes クラスターの外部にある) から複製するリカバリ オブジェクト ストアから受信した WAL 情報の再生 (PostgreSQL の
restore_commandパラメータを使用)、ストリーミングレプリケーション経由 (PostgreSQL のprimary_conninfoパラメータを使用)、または 2 つのいずれか (barmanObjectStoreとconnectionParametersの両方が外部クラスタで定義されている場合)PostgreSQL のホット スタンバイでサポートされているように、読み取り接続のみを受け入れる
参考
PostgreSQL クラスターを別のクラスターから複製する方法の詳細については、 ブートストラップ を参照してください (externalClusters セクションで定義)。
以下の図は、2 つの異なる Kubernetes クラスターにまたがる PostgreSQL クラスターを示しています。プライマリ クラスターは最初の Kubernetes クラスターにあり、レプリカ クラスターは 2 番目の Kubernetes クラスターにあります。 2 番目の Kubernetes クラスターは、会社のディザスター リカバリー クラスターとして機能し、災害が発生して最初のクラスターが使用できなくなった場合にアクティブ化する準備ができています。
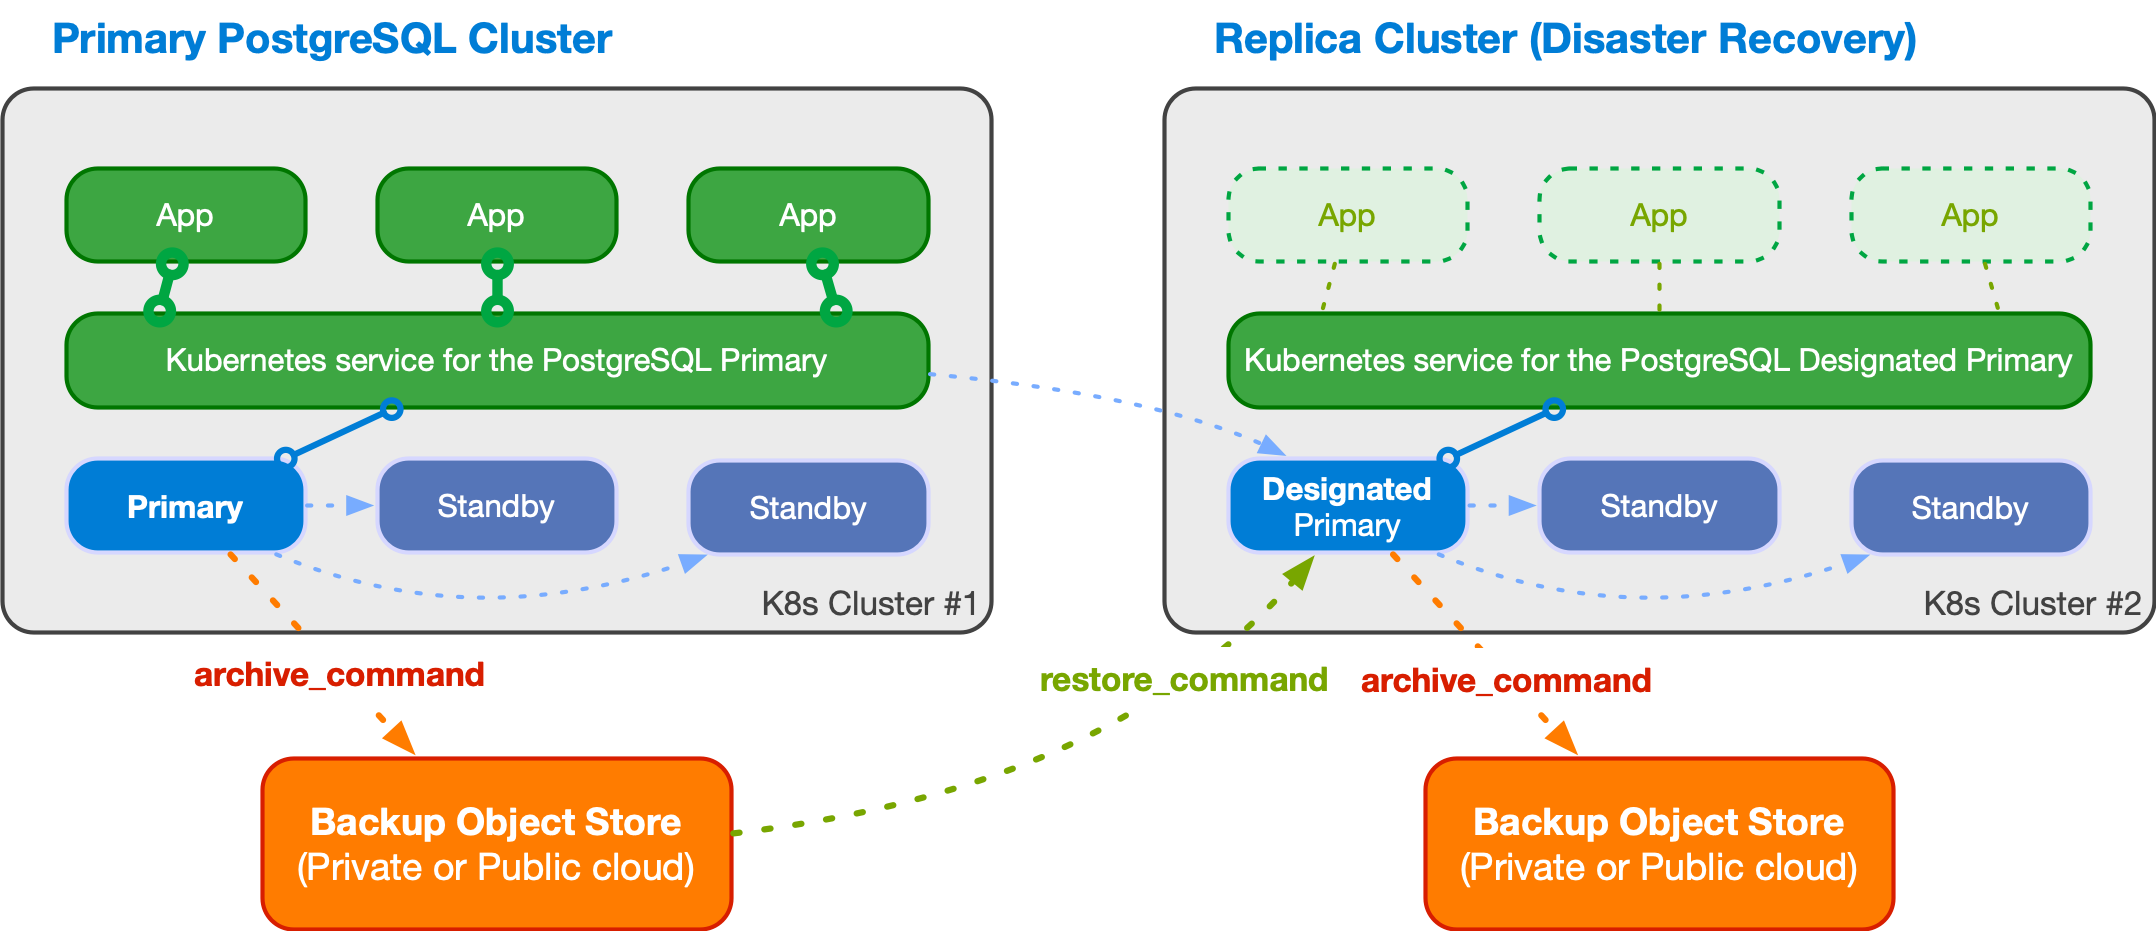
An example of multi-cluster deployment with a primary and a replica cluster
レプリカ クラスタは、プライマリ クラスタと同じアーキテクチャを持つことができます。プライマリ インスタンスの代わりに、レプリカ クラスターには 指定されたプライマリ インスタンスがあります。これは、ストリーミングレプリケーション(対称アーキテクチャ) で任意の数のカスケード スタンバイ サーバーを持つスタンバイ サーバーです。
指定されたプライマリはいつでも昇格でき、レプリカ クラスタは書き込み接続を受け入れることができるプライマリ クラスタになります。
警告
CloudNativePG は現在、クラスタ間の切り替えやフェイルオーバーを実行していません。このような操作は、手動で実行するか、マルチクラスター/フェデレーション クラスター対応機関に委任する必要があります。各 PostgreSQL クラスターは、他から独立しています。
上記の例で指定されたプライマリは、restore_command および
barman-cloud-wal-restore を介してファイルベースの WAL
出荷のフォールバック オプションを使用して、WAL ストリーミング
(primary_conninfo ) を介して供給されます。
CloudNativePG では、複数のレプリカ クラスターを定義できます。レプリカの数を減らしてレプリカ クラスターを定義し、クラスターがプライマリに昇格したときにこの数を増やすこともできます。
