オペレーターの能力レベル
このセクションでは、 Operator SDK definition of Capability Levels を使用して分類された、CloudNativePG によって実装された機能の概要を提供します。
フレームワーク。
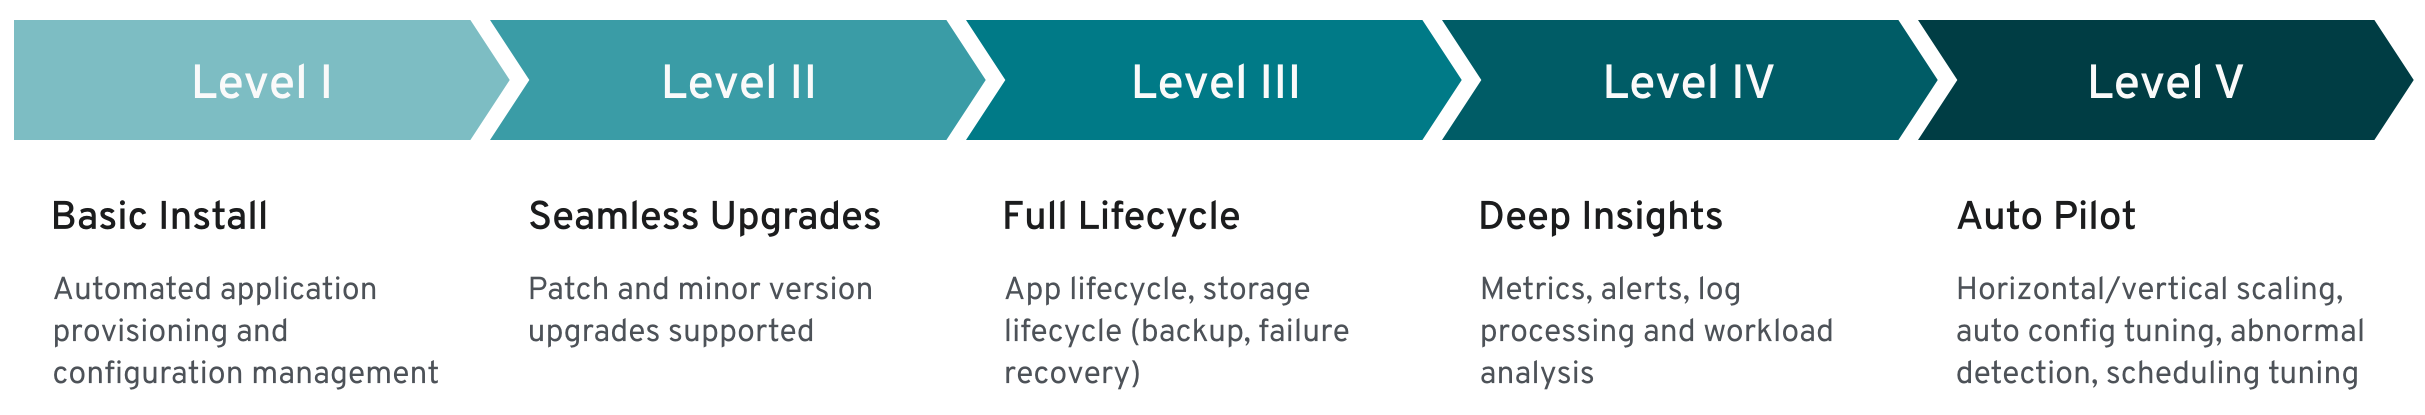
Operator Capability Levels
重要
Operator Capability Levels model に基づいて、CloudNativePG Operator から "Level V - Auto Pilot" 一連の機能を期待できます。
各機能レベルは、オペレーターが提供する特定の一連の管理機能に関連付けられています。
基本インストール
2.シームレスなアップグレード
完全なライフサイクル
深い洞察
5.オートパイロット
注釈
このフレームワークは、オペレーターの将来の作業と実装のガイドと見なされます。
レベル 1 - 基本インストール
能力レベル 1 には、オペレーターの インストール と 構成 が含まれます。このカテゴリには、オペレーターとの対話方法の改善や PostgreSQL クラスター構成など、使いやすさとユーザー エクスペリエンスの強化が含まれます。
重要
**情報セキュリティ**はこのレベルの一部と考えています。
宣言型構成によるオペレーターのデプロイ
オペレーターは、4 つの主要な CustomResourceDefinition オブジェクト
(Cluster 、Pooler 、Backup 、および ScheduledBackup
) を定義する Kubernetes
マニフェストを使用して、宣言的な方法でインストールされます。
宣言型構成による PostgreSQL クラスターの展開
PostgreSQL クラスター (オペランド) は、完全に宣言的な方法で Cluster
カスタム リソースを使用して定義されます。 PostgreSQL のバージョンは、CR
で定義されたオペランド コンテナー
イメージによって決定されます。これは、要求されたレジストリから自動的にフェッチされます。オペランドをデプロイするとき、オペレーターは次のリソースも自動的に作成します:
Pod 、Service 、Secret 、ConfigMap
、PersistentVolumeClaim 、PodDisruptionBudget
、ServiceAccount 、RoleBinding 、Role 。
CRD によるオペランド イメージのオーバーライド
オペレーターは、PostgreSQL を内部に持つオペランド コンテナー
イメージをサポートするように設計されています。デフォルトでは、オペレーターは、PostgreSQL
コミュニティーによってサポートされ、ghcr.io
で公開されている最新の安定したメジャー
バージョンの最新の利用可能なマイナー バージョンを使用します。 CR で
imageName 属性を設定することにより、プライマリ/スタンバイ
アーキテクチャを直接サポートする PostgreSQL
の互換性のあるイメージを使用できます。オペレーターは、プライベート
コンテナー レジストリにアクセスするための imagePullSecrets
もサポートしています。また、コンテナー
イメージの不変性をより細かく制御するためのタグに加えて、ダイジェストもサポートしています。
ラベルと注釈
Operator は、クラスターのメタデータで定義されているラベルとアノテーションの継承をサポートするように構成できます。これは、Kubernetes インフラストラクチャーでの CloudNativePG デプロイメントの組織を改善することを目的としています。
自己完結型のインスタンス マネージャー
Patroni や Stolon などの外部ツールに依存して Kubernetes クラスター
ポッド内の PostgreSQL
インスタンスを調整する代わりに、オペレーターは各ポッド内の
/controller/manager
という名前のファイルにオペレーター実行可能ファイルを挿入します。アプリケーションは、基盤となる
PostgreSQL インスタンスを制御し、PostgreSQL クラスター
トポロジに基づいてインスタンス自体とポッドの状態を調整するために使用されます。インスタンス
マネージャーは、プローブ用に kubelet によって呼び出される Web
サーバーも開始します。 kubelet によって呼び出された Unix
シグナルは、インスタンス
マネージャーによってフィルター処理され、必要に応じて postgres
プロセスに転送され、外部イベントに対する迅速かつ制御された反応が行われます。インスタンス
マネージャーは Go で記述されており、外部依存関係はありません。
ストレージ構成
ストレージは、データベース
ワークロードの重要なコンポーネントです。ストレージに関して Kubernetes
ネイティブの機能とリソースを利用するオペレーターは、基盤となる
Kubernetes
環境が提供できるものに基づいて、ワークロード要件に適したストレージを選択するのに十分な柔軟性を提供します。これは、パブリック
クラウド環境で特定のストレージ クラスを選択するか、CR の storage
パラメーターの PVC テンプレートを使用して生成された PVC
を微調整することを意味します。パフォーマンスを向上させ、より細かく制御するために、クラスターの先行書き込みログ
(WAL、pg_wal とも呼ばれる) を別のボリューム
(できれば別のストレージ) でホストすることもできます。 cnp-bench
オープン ソース
プロジェクトを使用して、運用前にストレージとデータベースの両方をベンチマークできます。
レプリカ構成
オペレーターは、instances
という単一のパラメーターを使用して、クラスター内のレプリカを自動的に検出します。
1 に設定すると、クラスターはレプリカのない単一のプライマリ
PostgreSQL インスタンスで構成されます。 1
より高い場合、オペレーターは、自動フェイルオーバーによる高可用性 (HA)
と切り替え操作によるローリング更新を含む、instances -1
レプリカを管理します。 CloudNativePG は、以前に提案された Failover slots
と呼ばれる PostgreSQL 用のパッチに触発された実装を使用して、HA
クラスター内のすべてのレプリカのレプリケーション
スロットを自動的に管理します。
データベース構成
このオペレーターは、単一のデータベースで PostgreSQL
クラスターを管理するように設計されています。オペレーターは、読み取り/書き込み、読み取り、および読み取り専用のワークロード用に自動的にプロビジョニングおよび管理される
3 つの Kubernetes
サービスを通じて、データベースへのアクセスを透過的に管理します。構成よりも規則的なアプローチを使用して、オペレーターは
app
という名前のデータベースを作成します。これはデフォルトで、同じ名前の通常の
Postgres
ユーザーによって所有されます。必要に応じて、データベース名とユーザー名の両方を指定できます。クラスターを実行するために構成は必要ありませんが、CR
の postgresql セクションで PostgreSQL ランタイム構成と PostgreSQL
ホストベース認証ルールの両方をカスタマイズできます。
ポッド セキュリティ ポリシー
InfoSec 要件の場合、オペレーターはコンテナーに対して特権モードを必要とせず、読み取り専用のルート ファイルシステムを適用して、オペレーターとオペランド ポッドの両方のコンテナーの不変性を保証します。また、必要なセキュリティ コンテキストを明示的に設定します。
親和性
クラスターの affinity セクションを使用すると、Kubernetes
クラスターのノード全体で、ポッドおよび永続ボリュームなどの関連リソースをスケジュールする方法を微調整できます。特に、オペレーターは以下をサポートします。
ポッドの親和性と非親和性
ノードセレクター
汚染と寛容
コマンドラインインターフェース
CloudNativePG には、独自のコマンド ライン インターフェイスはありません。
PostgreSQL クラスター管理エクスペリエンスを強化および簡素化する cnpg
というプラグインを提供することで、Kubernetes に最適なコマンド ライン
インターフェースである kubectl に依存するだけです。
クラスタの現在のステータス
オペレーターは、クラスターの観察された状況で CR
の状況セクションを継続的に更新します。 PostgreSQL
クラスター全体のステータスは、各ポッドで実行されているインスタンス
マネージャーによって継続的に監視されます。インスタンス
マネージャーは、制御された PostgreSQL
インスタンスに必要な変更を適用して、クラスターの必要なステータスに収束する責任があります
(たとえば、クラスター ステータスがレポートする場合)。ポッド -1
がプライマリであり、ポッド -1
はそれ自体を昇格させる必要があり、他のポッドはポッド -1
に従う必要があります)。詳細を提供するために、kubectl の cnpg
プラグインによって同じステータスが使用されます。
事業者の認証局
オペレーターは、自身の認証局を自動的に作成します。 Kubernetes API サーバーとオペレーター自体の間の安全な通信を確保するために、webhook サーバーで使用されるリーフ証明書を作成し、オペレーター認証局で署名します。
クラスターの認証局
オペレーターは、すべての PostgreSQL
クラスターに対して認証局を自動的に作成します。これは、(パスワードの代わりに)ストリーミングレプリケーションスタンバイ
サーバーを含む、クライアントの認証用の TLS
証明書を発行および更新するために使用されます。クライアント証明書のカスタム証明機関のサポートは、シークレットを通じて利用できます。これには、cert-manager
との統合も含まれます。証明書は、kubectl の cnpg
プラグインで発行できます。
TLS 接続
このオペレーターは、TLS/SSL 接続を透過的かつネイティブにサポートし、クライアント/サーバー通信を暗号化して、クラスターの認証機関を使用してセキュリティを強化します。カスタム サーバー証明書のサポートは、シークレットを通じて利用できます。これには、cert-manager との統合も含まれます。
ストリーミングレプリケーションの証明書認証
オペレーターは、パスワード (したがってシークレット) に依存する代わりに、TLS クライアント証明書認証に依存して、スタンバイ サーバーからのストリーミングレプリケーション接続を承認します。
継続的な構成管理
オペレーターを使用すると、PostgreSQL 構成の Cluster リソース YAML
セクションに変更を適用でき、構成オプションに応じて、すべてのインスタンスが適切に再ロードまたは再起動されるようになります。
現在の制限: ALTER SYSTEM
の変更は検出されません。つまり、クラスターの状態は適用されません。
既存の PostgreSQL データベースのインポート
バージョン 1.16 以降、オペレーターはオフライン移行を使用して、既存の
Postgres データベースを Kubernetes の新しい CloudNativePG Cluster
にインポートする宣言的な方法を提供します。同じ機能は、PostgreSQL
データベースのオフライン メジャー
アップグレードにも対応しています。オフラインとは、データベースがインポートされるまで、アプリケーションがソースで書き込み操作を停止する必要があることを意味します。この機能は、initdb
ブートストラップ メソッドを拡張して、別の PostgreSQL
データベースで使用可能なデータの論理スナップショットを使用して新しい
PostgreSQL
クラスターを作成します。これは、スーパーユーザー接続を介してネットワーク経由でアクセスできます。インポートは、サポートされているすべてのバージョンの
Postgres から行われ、pg_dump および pg_restore
に依存して、操作のすべてのデータベース部分、および要求された場合はロールに対して、新しいクラスター
プライマリから実行されます。
PostGIS クラスタ
CloudNativePG は、 PostGIS を使用したクラスターのインストールをサポートしています
PostgreSQL の最も一般的な拡張機能の 1 つである、地理データベース用のオープン ソース拡張機能。
PostgreSQL の基本的な LDAP 認証
オペレーターを使用すると、 PostgreSQL documentation: LDAP authentication で説明されているように、simple bind または search+bind モードを使用して、PostgreSQL クライアントの LDAP 認証を構成できます。
複数のインストール方法
このオペレーターは、kubectl apply を介して Kubernetes
マニフェストを介してインストールでき、パブリックおよびプライベート
クラウド環境の従来の Kubernetes
インストールで使用できます。さらに、オペレーター用の Helm
チャートも利用できます。
設定より規約
オペレーターは、構成パラダイムよりも規則をサポートし、標準のデフォルト値を決定しながら、それらをオーバーライドしてカスタマイズできるようにします。いくつかの
YAML コード行で Cluster CRD を使用して、PostgreSQL
クラスターのデプロイを指定できます。
レベル 2 - シームレスなアップグレード
機能レベル 2 は、 オペレーターと実際のワークロードの更新 (この場合は PostgreSQL サーバー) を有効にすることです。これには、 PostgreSQLのマイナーリリース更新 (通常はセキュリティとバグ修正) と 主要なオンラインアップグレード が含まれます。
オペレーターのアップグレード
新しい展開としてオペレーターをシームレスにアップグレードできます。演算子を変更しても、オペランドを変更する必要はありません - インスタンス マネージャーのインジェクションのおかげです。オペレーターは、古いバージョンのオペランドを管理できます。
CloudNativePG は インスタンスマネージャーのインプレース更新 もサポートしています
オペレーターのアップグレード後: インプレース更新では、クラスターのローリング更新 (およびその後の切り替え) は必要ありません。
管理対象ワークロードのアップグレード
オペランドは、CR、特に imageName
パラメーターの変更の一環として、宣言的な構成アプローチを使用してアップグレードできます。オペレーターは、PostgreSQL
のメジャー アップグレードを防ぎながら、メジャー バージョン内のマイナー
PostgreSQL リリースに関して両方向に進むことを可能にします
(更新とロールバックを有効にします)。
スタンバイ
サーバーが存在する場合、オペレーターは、既存のポッドを削除し、基になるストレージを再利用する新しい要求されたオペランド
イメージを使用して新しいポッドを作成することにより、レプリカから開始するローリング更新を実行します。
primaryUpdateStrategy の値に応じて、オペレーターは以前のプライマリ
(unsupervised ) を更新する前に切り替えを続行するか、ユーザーが
kubectl の cnpg プラグインを介して切り替え手順 (supervised )
を手動で発行するのを待ちます。どの設定を使用するかは、実際のデータベース
ワークロードに基づいて、操作によってアプリケーションのダウンタイムが数秒から数分発生する可能性があるため、ビジネス要件によって異なります。
アップグレード中にクラスターの可用性ステータスを表示する
いつでも、Setting up primary 、Creating a new replica
、Cluster in healthy state 、Switchover in progress
、Failing over 、Upgrading cluster
など、クラスターの高可用性ステータスを伝えます。
レベル 3 - フル ライフサイクル
能力レベル 3 では、事業者は ビジネス継続性 と スケーラビリティ の側面を管理する必要があります。 ディザスタリカバリ は、データベースのバックアップとリカバリの両方が正しく機能することを必要とするビジネス継続性のコンポーネントです。開始点としての目標は RPO を 5 分未満にすることですが、長期的な目標は RPO=0 のバックアップ ソリューションを実装することです。 高可用性 は、ビジネス継続性のもう 1 つの重要な要素であり、PostgreSQL ネイティブの物理レプリケーションとホット スタンバイ レプリカにより、オペレーターはフェイルオーバーとスイッチオーバー操作を実行できます。この領域には、次の機能強化が含まれています。
同期レプリケーション、(カスケード) レプリケーション クラスターなどの PostgreSQL 物理レプリケーションの制御。
接続プーリング。pgBouncer を使用した接続プーリング レイヤーを介してパフォーマンスと制御を向上させます。
PostgreSQL ホット バックアップ
このオペレーターは、物理ベースのバックアップと継続的な WAL アーカイブに基づく PostgreSQL のネイティブの継続的なホット バックアップ テクノロジを使用して、アプリケーション レベルのバックアップを提供するように設計されています。具体的には、オペレーターは現在、オブジェクト ストア (AWS S3 および S3 互換、Azure Blob Storage、Google Cloud Storage、および MinIO などのゲートウェイ) のバックアップのみをサポートしています。
WAL アーカイブとベース バックアップは、S3 プロトコルの宛先 URL
(たとえば、AWS S3 バケット内の特定のフォルダーを指すように)
を指定することによって、クラスター定義の backup
パラメーターを使用して、宣言的にクラスター
レベルで定義されます。汎用エンドポイント
URL。継続的なバックアップの前提条件である WAL
アーカイブは、ユーザーによる追加のアクションを必要としません。オペレーターは、定義されたエンドポイントに
WAL ファイルを送信するために barman-cloud-wal-archive
に依存するように archive_command
を自動的かつ透過的に設定します。ユーザーは、圧縮アルゴリズムと、アーカイブ内の
WAL
ファイルを同時にアップロードする並列ジョブの数を決定できます。それに加えて、Instance Manager
は、WAL ファイルの最初のセットの出荷を開始する前に
barman-cloud-check-wal-archive
コマンドを実行することにより、アーカイブ先の正確性を自動的にチェックします。
基本バックアップは、オンデマンド (Backup カスタム
リソース定義による) またはスケジュール (ScheduledBackup
顧客リソース定義による、cron のような構文を使用) の 2
つの方法で定義できます。どちらも、ジョブ (アプリケーション コンテナー
イメージの一部として配布される) を barman-cloud-backup
に依存して、WAL
ファイルと一緒に同じエンドポイントでバックアップをリレーします。
barman-cloud-wal-restore と barman-cloud-backup の両方が、GNU
GPL 3 条件の下でアプリケーション コンテナー イメージで配布されます。
スタンバイからのバックアップ
オペレーターは、データベースの RPO に影響を与えることなく、スタンバイへのベース バックアップのオフロードをサポートします。これにより、標準的なデータベース操作のために、プライマリのリソース、特に I/O を保持できます。
バックアップからの完全復元
オペレーターを使用すると、barman-cloud-backup
を使用して作成された既存のアクセス可能なバックアップから開始して、新しいクラスターを
(その設定と共に) ブートストラップできます。ブートストラップ
プロセスが完了すると、オペレータはインスタンスをリカバリ
モードで開始し、指定されたアーカイブから利用可能なすべての WAL
ファイルを再生し、リカバリを終了してプライマリとして開始します。その後、オペレーターは要求された数のスタンバイ
インスタンスをプライマリから複製します。 CloudNativePG
は、アーカイブからの並列 WAL フェッチをサポートしています。
バックアップからのポイントインタイム リカバリ (PITR)
Operator を使用すると、タイムスタンプ、ラベル、またはトランザクション ID で定義された特定の時点まで既存のバックアップを復元することで、新しい PostgreSQL クラスターを作成できます。この機能は完全復元機能の上に構築され、
PostgreSQL for PITR で利用可能なすべてのオプションをサポートします。
同期レプリケーションによるデータ損失ゼロのクラスター
クォーラム ベースの同期レプリケーション
サポートにより、ローカルの高可用性 CloudNativePG クラスターで ゼロ
データ損失 (RPO=0)
を達成します。オペレーターは、いつでも使用できると予想される同期スタンバイ
レプリカの最小数と最大数を制御する 2
つの構成オプションを提供します。オペレーターは、クォーラム (q )
の次の式を通じて、クラスター内の使用可能で準備ができている PostgreSQL
インスタンスの数に基づいて、それに応じて反応します。
1 <= minSyncReplicas <= q <= maxSyncReplicas <= readyReplicas
レプリカ クラスタ
PostgreSQL ネイティブ ストリーミングとカスケード
レプリケーションを利用して、PostgreSQL クラスターのクロス Kubernetes
クラスター トポロジを定義します。 replica
オプションを使用すると、独立したクラスターをセットアップして、同じメジャー
バージョンの別の PostgreSQL
ソースから継続的にデータをレプリケートできます。このようなソースは、2
つのエンドポイントから TLS
を介した直接ストリーミング接続が許可されている限り、どこにでも配置できます。さらに、ソースは、物理環境または仮想環境で実行されている
Kubernetes の外部であってもかまいません。レプリカ クラスタは、リカバリ
オブジェクト ストア ( Barman Cloud 形式のバックアップ) から、または
pg_basebackup を介したストリーミングを介して作成できます。 WAL
ファイル シッピングと WAL ストリーミングの両方が許可されます。レプリカ
クラスターは、複数のデータセンターにまたがり、ハイブリッドおよびマルチクラウドのセットアップに対応できるようにすることで、Kubernetes
内の PostgreSQL データベースのビジネス継続性を劇的に改善します
(現在、Kubernetes フェデレーションのネイティブ機能を待つ間、データ
センター間の手動スイッチオーバーが必要です)。
liveness と readiness プローブ
オペレーターは、kubelet によって呼び出される Postgres コンテナーの
liveness および readiness プローブを定義します。これらは、インスタンス
マネージャーによって直接管理される Web サーバーの /healthz および
/readyz エンドポイントにそれぞれマップされます。 liveness プローブは
pg_isready 実行可能ファイルに基づいており、ポッドは終了コード 0
(サーバーが正常に接続を受け入れている) および 1
(サーバーが起動中などに接続を拒否している) で正常であると見なされます。
readiness プローブは、単純なクエリ (; )
を発行して、サーバーが接続を受け入れる準備ができていることを確認します。
ローリング展開
オペレーターは、ダウンタイムを最小限に抑えるためにローリング デプロイをサポートします。PostgreSQL クラスターが公開されている場合、サービスは、初期化または更新中に、読み取り専用トラフィックを使用可能なポッドにのみ負荷分散します。
レプリカのスケールアップとスケールダウン
オペレーターを使用すると、PostgreSQL
クラスター内のインスタンス数をスケールアップおよびスケールダウンできます。新しいレプリカはプライマリ
サーバーから自動的に起動され、クラスターの HA
インフラストラクチャに参加します。 CRD は、ユーザーが kubectl scale
コマンドを使用できるようにする「スケール」サブリソースを宣言します。
Kubernetes ノードのメンテナンス期間と PodDisruptionBudget
オペレーターは PodDisruptionBudget
リソースを作成して、同時中断の数を 1 つのプライマリ
インスタンスに制限します。この構成により、メンテナンス操作によってクラスター内のすべてのポッドが削除されるのを防ぎ、指定された数のインスタンスを作成できるようになります。
PodDisruptionBudget は、ノードのドレイン操作中に適用され、クラスター
サービスの中断を防ぎます。
この戦略は、ストレージがすべてのワーカーノード間で共有される Kubernetes
クラスターには適していますが、ローカル
ストレージを使用するクラスターや、プライベート
クラウドにインストールされたクラスターには最適なソリューションではない可能性があります。オペレーターを使用すると、メンテナンス
ウィンドウを指定し、基になるノードの削除に対する対応を構成できます。メンテナンス
ウィンドウ セクションの ReusePVC
オプションを使用すると、使用する戦略を指定できます。削除されたインスタンスに別の
PVC
に新しいストレージを割り当てるか、基になるノードが再び利用可能になるまで待ちます。
フェンシング
フェンシングは、PostgreSQL クラスターの 1 つ、複数、またはすべてのインスタンスのデータが誤動作しているように見える場合に、そのデータを保護するプロセスです。インスタンスがフェンシングされると、ポッドが実行され続けている間、PostgreSQL サーバー プロセスがシャットダウンされることが保証されます。これにより、フェンスが解除されるまで、Pod 上のデータが PostgreSQL によって変更されず、デバッグやトラブルシューティングの目的でファイル システムを調査できることが保証されます。
ハイバネーション
CloudNativePG は hibernation of a running PostgreSQL cluster をサポートします
cnpg
プラグイン経由。ハイバネーションは、高可用性クラスター内のすべての
Postgres インスタンスをシャットダウンし、PGDATA と WAL
を含むプライマリの PVC
の静的コピーを保持します。プラグインを使用すると、プライマリを再開してからすべてのレプリカを再作成することで、ハイバネーション
フェーズを終了できます (レプリカが存在する場合)。
Pod での永続ボリューム ストレージの再利用
オペレーターが、ユーザーによって削除された、または Kubernetes
メンテナンス操作によって削除されたポッドを作成する必要がある場合、利用可能な場合は
PersistentVolumeClaim
を再利用し、プライマリからデータを再クローンする必要を回避します。
CPU とメモリの要求と制限
オペレーターは、管理者がマニフェストの resources
セクションを通じて、クラスターのポッドによるリソースの使用を制御および管理できるようにします。特に、requests
と limits の値は、CPU と RAM の両方に設定できます。
PgBouncer による接続プーリング
CloudNativePG は、PostgreSQL の最も一般的なオープン ソース接続プーラーの 1 つである PgBouncer 設定オプション を使用した接続プーリングのネイティブ サポートを提供します。アーキテクチャの観点から、PgBouncer 接続プーラーのネイティブ実装は、データベースにアクセスするための新しいレイヤーを導入します。これにより、インスタンスへのクエリ フローが最適化され、基盤となる PostgreSQL リソースの使用がより効率的になります。アプリケーションは、PostgreSQL サービスに直接接続する代わりに、PgBouncer サービスに接続して既存の接続を再利用できるようになりました。
レベル 4 - 深い洞察
機能レベル 4 は、 可観測性 に関するものです。具体的には、監視、アラート、傾向分析、ログ処理です。これには、Prometheus、Grafana、Fluent Bit などの外部ツールの使用や、JSON 形式でエラー ログを直接出力するための PostgreSQL エンジンの拡張機能が含まれる場合があります。
CloudNativePG は、柔軟な監視とロギングのために、業界標準およびコミュニティで受け入れられているツールと簡単に統合するために必要なすべてを提供するように設計されています。
構成可能なクエリを備えた Prometheus エクスポーター
インスタンス
マネージャーはプラグ可能なフレームワークを提供し、metrics ポート
(9187) でリッスンする独自の Web サーバーを介して、 パート 4 - Prometheus と Grafana を使用してクラスターを監視する
監視およびアラート
ツールのメトリックをエクスポートするエンドポイントを公開します。オペレーターは、
postgres_exporter と互換性のある構文を使用して、
ConfigMap
および/または Secret
オブジェクトとして定義されたカスタム監視クエリをサポートします。
CloudNativePG は、PostgreSQL
用の一連の基本的な監視クエリを提供します。これらは、統合してコンテキストに適応させることができます。
JSON 形式の PostgreSQL エラー メッセージの標準出力ロギング
すべてのログ メッセージは、標準的な PostgreSQL エラー メッセージ
チャネルの postgres など、タイムスタンプの最初のレベルの定義、ログ
レベル、およびログ エントリのタイプとともに、JSON
形式で標準出力に配信されます。その結果、CloudNativePG
によって管理されるすべての Pod は、JSON をソース データ
タイプとしてサポートする任意のダウンストリーム
ログ処理スタックと簡単かつ直接統合できます。
リアルタイムのクエリ監視
CloudNativePG は透過的かつネイティブに以下をサポートします。
監査
CloudNativePG を使用すると、データベースとセキュリティの管理者、監査者、およびオペレーターは、PGAudit (PostgreSQL 用) を使用してデータベース アクティビティを追跡および分析できます。このようなアクティビティは JSON ログに直接流れ、Fluentd などの一般的なログ ブローカーを使用して適切なダウンストリーム ターゲットに適切にルーティングできます。
Kubernetes イベント
リソースの作成、ノードの削除、アップグレードなど、Kubernetes API
が期待する主要なイベントを記録します。イベントは、kubectl describe
および kubectl get events コマンドで表示できます。
レベル 5 - 自動操縦
機能レベル 5 は、 自動スケーリング 、 修復 、 チューニング に重点を置いています。これは、オブザーバビリティ レイヤーから明らかになった異常と洞察の発見を通じて行われます。
自己修復のための自動フェイルオーバー
プライマリで障害が検出された場合、オペレーターは、最も整合性のとれたレプリカを新しいターゲット
プライマリとして設定することで、クラスターのステータスを変更します。その結果、稼働中の各ポッドのインスタンス
マネージャーは、新しいプライマリになるか、それに従うことにより、必要な手順を開始して、クラスターの要求されたステータスに合わせます。以前のプライマリが復旧した場合、同じメカニズムでアプリケーションがプライマリに到達するのを防ぎ、サーバーで
pg_rewind を実行してスタンバイとして再起動することで、スプリット
ブレインを回避します。
スタンバイの自動再作成
スタンバイをホストしているポッドが削除された場合、オペレーターはスタンバイ サーバーを再作成する手順を開始します。
