アーキテクチャ
高可用性とスケーラビリティの目標のために、PostgreSQLデータベース管理システムは、管理者に WriteAheadLog(WAL)シッピング に基づいた組み込みの 物理レプリケーション 機能を提供します。
PostgreSQLは、ネットワークを介した非同期と同期の両方のストリーミングレプリケーションと、非同期ファイルベースのログシッピング(通常、WALファイルをオブジェクトストアに保存するためのフォールバックオプションとして使用されます)をサポートしています。レプリカは通常スタンバイサーバーと呼ばれ、ホットスタンバイ機能のおかげで読み取り専用のワークロードにも使用できます。
CloudNativePGは、次の仕様で、同じKubernetesクラスター内で複数のホットスタンバイレプリカを管理するための非同期および同期ストリーミングレプリケーションに基づくクラスターをサポートしています。
1つのプライマリ、オプションで高可用性のための複数のホットスタンバイレプリカ
アプリケーションで利用可能なサービス: *
-rw:アプリケーションはクラスターの唯一のプライマリインスタンスに接続 *-ro:アプリケーションは読み取り専用ワークロードの唯一のホットスタンバイレプリカに接続 *-r:アプリケーションは読み取り専用のいずれかのインスタンスに接続ワークロードPostgreSQLクラスターの復元力を高めるために推奨されるシェアードナッシングアーキテクチャ: * PostgreSQLインスタンスは異なるKubernetesワーカーノードに存在し、ネットワークのみを共有する必要があります * PostgreSQLインスタンスは同じリージョン内の異なるアベイラビリティーゾーンに存在できる同じ地域に住んでいる
読み書きワークロード
次の図に示すように、アプリケーションは、Kubernetesオペレーターによって現在のプライマリとして選択されたPostgreSQLインスタンスに接続することを決定できます。
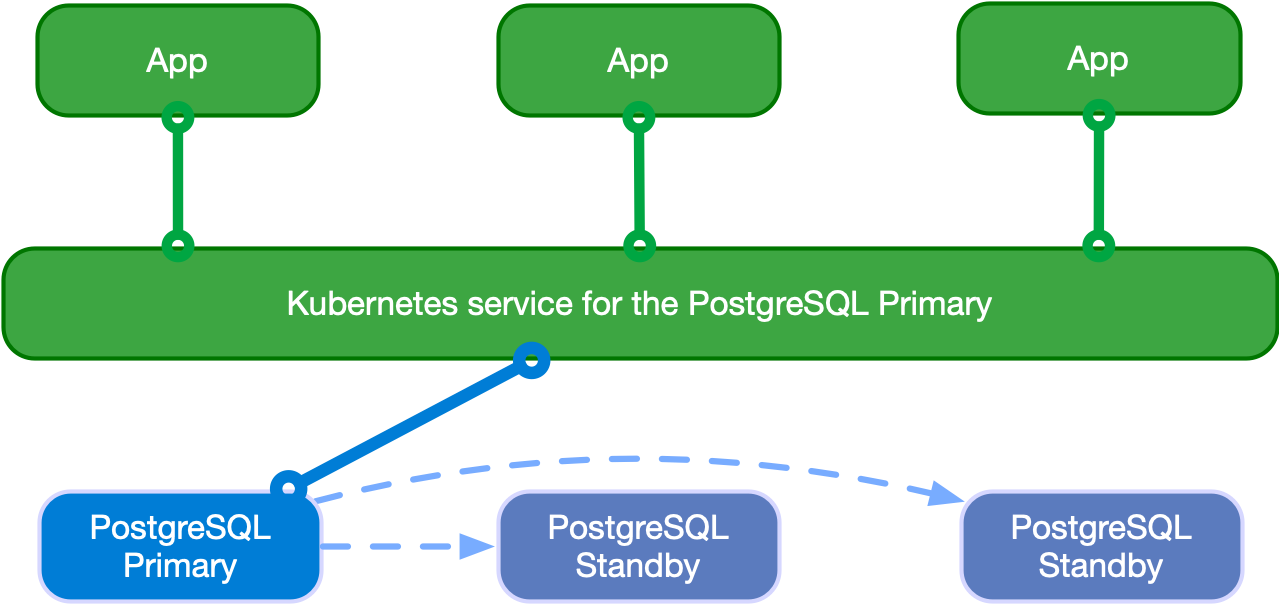
Applications writing to the single primary
アプリケーションは-rw サフィックスサービスを使用できます。
プライマリが一時的または永続的に使用できない場合、Kubernetesは高可用性のために
-rw サービスをクラスターの別のインスタンスに移動します。
読み取り専用ワークロード
重要
アプリケーションは、 Hot Standby が提示する制限を認識し、これらのワークロードを処理する際のPostgreSQLの動作に精通する必要があります。
アプリケーションは、オペレーターが使用可能にした-ro
サービスを介してホットスタンバイレプリカにアクセスできます。このサービスにより、アプリケーションはプライマリノードから読み取り専用クエリをオフロードできます。
次の図は、アーキテクチャを示しています。
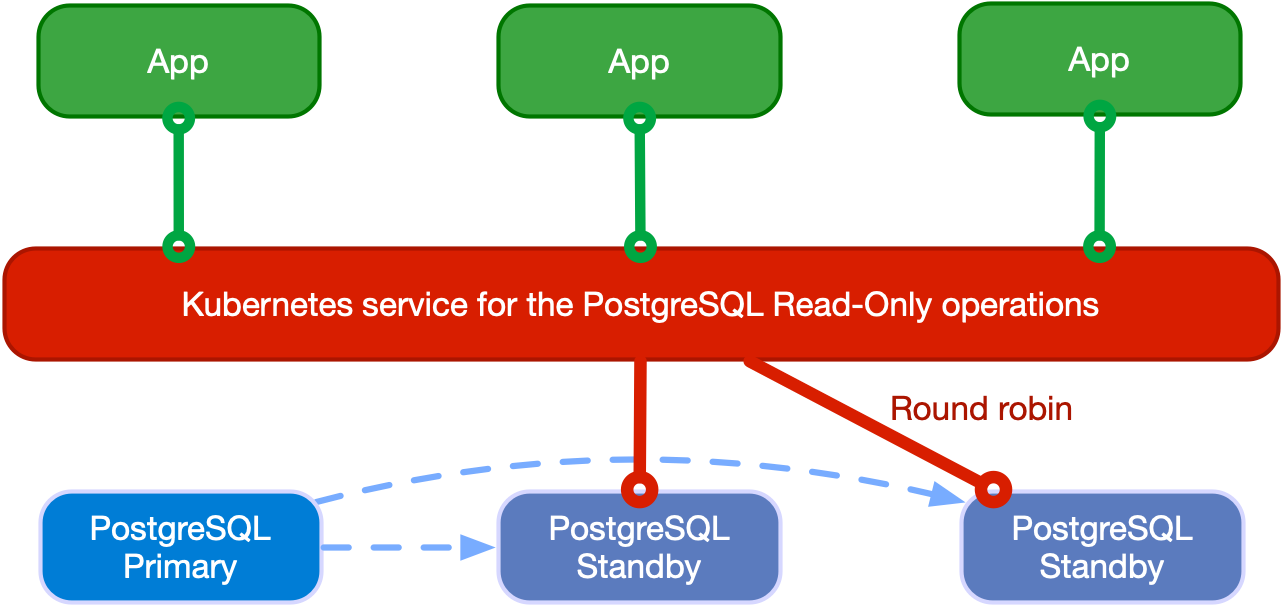
Applications reading from hot standby replicas in round robin
アプリケーションは、 -r
サービスを介して任意のPostgreSQLインスタンスにアクセスすることもできます。
マルチクラスター展開
分散PostgreSQLクラスターでは、常にプライマリとして機能する1つのPostgreSQLインスタンスのみが存在します。これは、アプリケーションがいつでも単一のKubernetesクラスター内にのみ書き込むことができることを意味します。
Tip
すべてのインスタンスが書き込みを受け入れるPostgreSQLアーキテクチャに興味がある場合は、 EDB Distributed Postgres by EDB をご覧ください。 Kubernetesの場合、EDB Distributed Postgresには独自のOperatorがあり、2022年後半に予定されています。
ただし、ビジネス継続性目標には、次のことが基本です。
PostgreSQLバックアップデータを複数の場所、リージョンに保存し、場合によっては異なるプロバイダーを使用することにより、グローバルな 目標復旧時点 (RPO)を削減します( ディザスターリカバリー )
プライマリKubernetesクラスターを超えてPostgreSQLレプリケーションを利用することにより、グローバルな 目標復旧時間 (RTO)を削減します( 高可用性 )
上記の懸念に対処するために、CloudNativePGではPostgreSQLレプリカクラスターの概念を導入しています。レプリカクラスターは、プライベート、パブリック、ハイブリッド、マルチクラウドのコンテキストでマルチクラスターデプロイを有効にするCloudNativePGの方法です。
レプリカクラスターは別の Cluster リソースです。
1.定義された外部ソースクラスターからのbootstrap
オプションとしてpg_basebackup または完全なrecovery を持つ
replica.enabledオプションをtrueに設定する
3.通常Kubernetesクラスターの外部にある、replica.source
で識別される定義された外部クラスターからの複製
4.復旧オブジェクトストアから受信したWAL情報の再生(PostgreSQLのrestore_command
パラメーターを使用)、またはストリーミングレプリケーション(PostgreSQLのprimary_conninfo
パラメーターを使用)、または2つのいずれか( barmanObjectStore
とconnectionParameters
の両方が外部クラスターで定義されている場合)
PostgreSQLのホットスタンバイでサポートされている、読み取り接続のみを受け入れる
参考
別のPostgreSQLクラスター( externalClusters セクションで定義)からのクローン作成の詳細については、 Bootstrap構成 を参照してください。
次の図は、2 つの異なる Kubernetes クラスターにまたがる PostgreSQL クラスターを示しています。プライマリクラスターは最初の Kubernetes クラスターにあり、レプリカクラスターは 2 番目にあります。 2番目のKubernetesクラスターは、会社のディザスターリカバリークラスターとして機能し、災害が発生して最初のクラスターが使用できなくなった場合にアクティブ化できます。
レプリカクラスターは、プライマリクラスターと同じアーキテクチャを持つことができます。プライマリインスタンスの代わりに、レプリカクラスターには 指定されたプライマリ インスタンスがあります。これは、ストリーミングレプリケーション(対称アーキテクチャ)で任意の数のカスケードスタンバイサーバーを持つスタンバイサーバーです。
指定されたプライマリはいつでも昇格できるため、レプリカクラスターを書き込み接続を受け入れられるプライマリクラスターにします。
警告
CloudNativePGは、現時点ではクラスター間のスイッチオーバーまたはフェイルオーバーを実行しません。このような操作は、手動で実行するか、マルチクラスター/フェデレーションクラスター対応の当局に委任する必要があります。各 PostgreSQL クラスターは互いに独立しています。
上記の例で指定されたプライマリは、 restore_command
およびbarman-cloud-wal-restore
を介したファイルベースのWALシッピングのフォールバックオプションを使用して、WALストリーミング(primary_conninfo
)を介して供給されます。
CloudNativePGでは、複数のレプリカクラスターを定義できます。より少ない数のレプリカでレプリカクラスターを定義し、クラスターがプライマリに昇格したときにこの数を増やすこともできます。