Postgresデータベースのインポート
このセクションでは、新しい CloudNativePG クラスター内に 1 つ以上の既存の PostgreSQL データベースをインポートする方法について説明します。
インポート操作は、PostgreSQLのオンライン論理バックアップの概念に基づいており、元のホストへのネットワーク接続を介したpg_dump
、およびpg_restore
に依存しています。ネイティブのマルチバージョン同時実行制御(MVCC)とスナップショットのおかげで、PostgreSQLでは、書き込みアクティビティを停止することなく、ネットワークを介して一貫したバックアップを同時に取得できます。
論理バックアップは、PostgreSQLバージョンのメジャーアップグレードを実行するための最も一般的で柔軟で信頼できる手法です。
その結果、このセクションの手順は次の両方に適しています。
Kubernetesの外部でも、既存のPostgreSQLインスタンスから1つ以上のデータベースをインポートする
任意のPostgreSQLバージョンから同じまたは新しいバージョンにデータベースをインポートし、PostgreSQLのメジャーアップグレードを有効にします(バージョン10.xからバージョン14.xなど)
警告
PostgreSQLのメジャーアップグレードを実行する場合、アプリケーションが新しいバージョンと互換性があること、およびデータベースに含まれるオブジェクト(拡張機能を含む)のアップグレードパスが実行可能であることを確認する責任があります。
どちらの場合も、操作は元のデータベースの一貫した スナップショット で実行されます。
重要
このため、バックアップの開始後にソースデータベースに加えられた変更は宛先クラスターにないため、 Cluster リソースでの最終インポートの前にソースでの書き込み操作を停止することをお勧めします。 「オフラインインポート」または「オフラインメジャーアップグレード」として。
仕組み
概念的には、インポートでは BootstrapInitDB
を使用して新しいクラスター(宛先クラスター)を作成し、
initdb.import
サブセクションを完了して既存のPostgresクラスター(ソースクラスター)からオブジェクトをインポートする必要があります。
PostgreSQLの推奨事項に従って、宛先クラスターのPostgreSQLメジャーバージョンはソースクラスターのメジャーバージョン以上にすることをお勧めします。
CloudNativePGは、ソースクラスターから宛先クラスターにオブジェクトをインポートするための2つの主な方法を提供します。
マイクロサービスアプローチ :宛先クラスターは、CloudNativePGプロジェクトの推奨に従って、指定されたアプリケーションユーザーが所有する単一のアプリケーションデータベースをホストするように設計されています
モノリスアプローチ :宛先クラスターは、ソースクラスターからインポートされた複数のデータベースと異なるユーザーをホストするように設計されています
最初のインポート方法はmicroservice
タイプを介して使用でき、後者はmonolith
タイプを介して使用できます。
警告
あなたの責任で、スーパーユーザーまたは`pg_dump` で論理バックアップを作成するための十分な権限を持つユーザーでソースクラスターにアクセスできます。詳細は PostgreSQL documentation on "SQL Dump" を参照してください。
microservice タイプ
マイクロサービスのアプローチでは、ソースクラスターから宛先クラスターにインポートする単一のデータベースを指定できます。操作は4つのステップで実行されます。
新しいクラスターの
initdbブートストラップpg_dump -Fcを使用した選択したデータベース(initdb.import.databases内)のエクスポートinitdb.ownerユーザーが所有するinitdb.database(アプリケーションデータベース)へのpg_restore --no-acl --no-ownerを使用したデータベースのインポートデータベースダンプファイルのクリーンアップ
postImportApplicationSQLパラメーターを介したアプリケーションデータベースでのユーザー定義SQLクエリのオプションの実行インポートされたデータベースでの
ANALYZE VERBOSEの実行
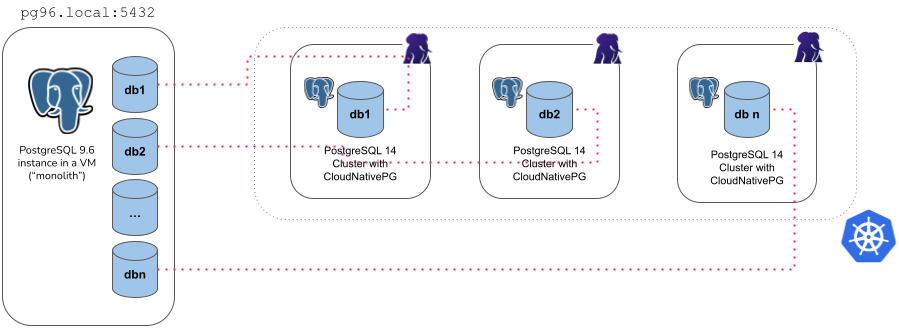
Example of microservice import type
たとえば、以下のYAMLは、 postgres
に接続することにより、cluster-pg96
クラスター(サポートされていないPostgreSQL 9.6を使用)からangus
データベースをインポートするcluster-microservice
という新しい3インスタンスのPostgreSQLクラスターを作成します。
cluster-pg96-superuser
シークレットに保存されているパスワードを介して、 postgres
ユーザーを使用するデータベース。
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: cluster-microservice
spec:
  instances: 3

  bootstrap:
    initdb:
      import:
        type: microservice
        databases:
          - angus
        source:
          externalCluster: cluster-pg96
        #postImportApplicationSQL:
        #- |
        #  INSERT YOUR SQL QUERIES HERE
  storage:
    size: 1Gi
  externalClusters:
    - name: cluster-pg96
      connectionParameters:
        # Use the correct IP or host name for the source database
        host: pg96.local
        user: postgres
        dbname: postgres
      password:
        name: cluster-pg96-superuser
        key: password
警告
上記の例では、コミュニティ、したがってCloudNativePGでサポートされなくなったPostgreSQLのバージョンを実行しているソースデータベースを意図的に使用しています。ソースインスタンスからのデータエクスポートは、宛先クラスターの`pg_dump` のバージョンを使用して実行されます。これは、サポートされているバージョンである必要があります。私たちの経験によれば、データをエクスポートするこの方法はPostgresの古いバージョンやサポートされていないバージョンでも機能し、レガシーデータをKubernetes内のより良いシステムに移動する機会を提供します。これが、このセクションの例で9.6を使用した主な理由です。この分野で問題が発生した場合は、ご連絡をお待ちしております。
microservice
タイプを使用する際には、注意する必要があることがいくつかあります。
インポートするデータを含む既存のPostgreSQLインスタンスを指す
externalClusterが必要です(詳細については、 :ref:``externalClusters` セクション<externalClusters セクション>` を参照してください)操作中にKubernetesクラスターと
externalCluster間のトラフィックを許可する必要がありますpg_dumpを実行し、ロール情報を読み取る必要がある指定されたユーザーでソースデータベースへの接続を許可する必要があります(スーパーユーザーは問題ありません)現在、
pg_dump -Fcの結果はPGDATAボリュームのdumpsフォルダー内に一時的に保存されているため、割り当てられたノードのダンプ結果、復元されたデータとインデックスを一時的に含めるための十分な領域があるはずです。インポート操作が完了すると、このフォルダーはオペレーターによって自動的に削除されます。initdb.import.databases配列内に指定できるデータベースは1つだけですロールはインポートされないため、
initdb.import.roles内で指定できません
monolith タイプ
モノリスアプローチでは、ソースクラスターから宛先クラスターにインポートするロールとデータベースのセットを指定できます。操作は次の手順で実行されます。
新しいクラスターの
initdbブートストラップ選択したロールのエクスポートとインポート
pg_dump -Fcを使用して、選択したデータベース(initdb.import.databases内)を一度に1つずつエクスポート選択した各データベースを作成し、
pg_restoreを使用してデータをインポートしますインポートされた各データベースで
ANALYZEを実行しますデータベースダンプファイルのクリーンアップ
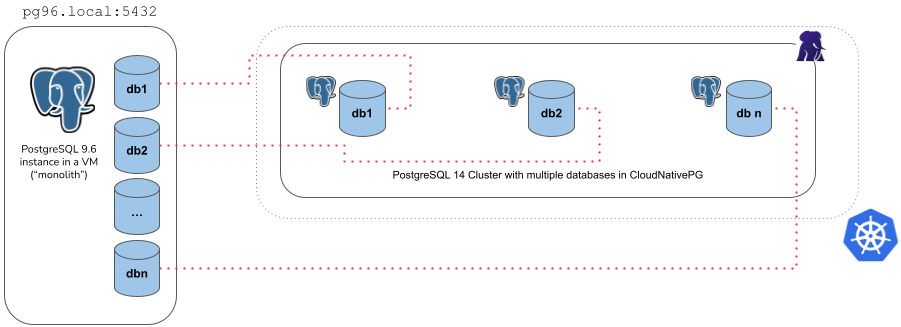
Example of monolith import type
たとえば、以下のYAMLは、 accountant とbank_user
のロール、およびcluster-pg96 からaccounting 、banking
、resort データベースをインポートするcluster-microservice
という新しい3インスタンスのPostgreSQLクラスター(オペレーターがリリースされた時点で利用可能な最新のメジャーバージョン)を作成します。クラスター(サポートされていないPostgreSQL
9.6を使用)、 postgres ユーザーを使用して、
cluster-pg96-superuser
シークレットに保存されているパスワードを使用してpostgres
データベースに接続します。
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: cluster-monolith
spec:
  instances: 3
  bootstrap:
    initdb:
      import:
        type: monolith
        databases:
          - accounting
          - banking
          - resort
        roles:
          - accountant
          - bank_user
        source:
          externalCluster: cluster-pg96
  storage:
    size: 1Gi
  externalClusters:
    - name: cluster-pg96
      connectionParameters:
        # Use the correct IP or host name for the source database
        host: pg96.local
        user: postgres
        dbname: postgres
        sslmode: require
      password:
        name: cluster-pg96-superuser
        key: password
monolith
タイプを使用する際には、注意する必要があることがいくつかあります。
インポートするデータを含む既存のPostgreSQLインスタンスを指す
externalClusterが必要です(詳細については、 :ref:``externalClusters` セクション<externalClusters セクション>` を参照してください)操作中にKubernetesクラスターと
externalCluster間のトラフィックを許可する必要がありますSSLなしでPostgreSQLインスタンスに接続する必要がある場合は、
connectionParametersセクションでsslmode: disableを指定する必要がありますpg_dumpを実行してロール情報を取得する必要がある指定されたユーザーでソースデータベースへの接続を許可する必要があります(スーパーユーザーは問題ありません)現在、
pg_dump -Fcの結果はPGDATAボリュームのdumpsフォルダー内に一時的に保存されているため、割り当てられたノードのダンプ結果、復元されたデータとインデックスを一時的に含めるための十分な領域があるはずです。インポート操作が完了すると、このフォルダーはオペレーターによって自動的に削除されます。initdb.import.databases配列で指定される少なくとも1つのデータベースインポートされたデータベースに必要なロールは、以下の制限付きで
initdb.import.roles内で指定する必要があります。-次のロールがある場合、インポートされません:postgres、streaming_replica、cnp_pooler_pgbouncerワイルドカード
"*"は、その種類のすべてのオブジェクトをインポートするdatabasesおよび/またはroles配列の唯一の要素として使用できます。データベースを一致させる場合、ワイルドカードはpostgresデータベース、テンプレートデータベース、および接続を許可していないデータベースを無視しますclone手順が完了した後、すべてのデータベースに対して
ANALYZE VERBOSEが実行されます。postImportApplicationSQLフィールドはサポートされていません