</ div>
プライマリデータベースがダウンしています
プライマリデータベースノードで実行されているエージェントがプライマリデータベースの障害を検出すると、Failover Managerは障害を確認するプロセスを開始します。
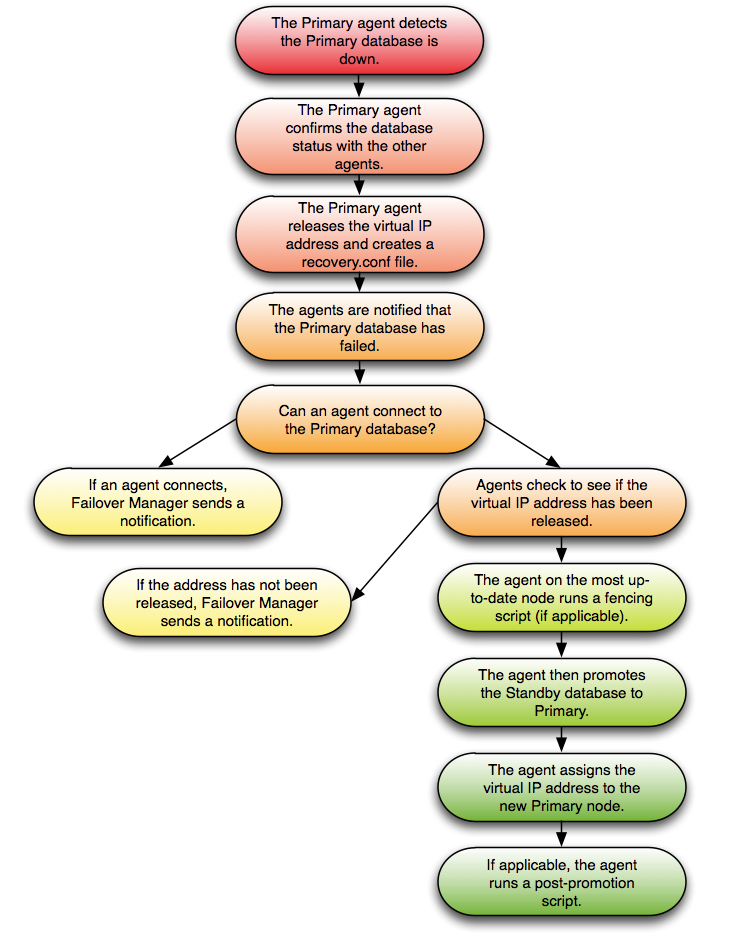
Confirming the failure of the primary database.
プライマリノードのエージェントがプライマリプライマリに直接接続しようとしデータベース。エージェントがデータベースに接続できる場合、フェールオーバーマネージャーはプライマリノードの状態に関する通知を送信します。接続できるエージェントがない場合、プライマリエージェントはデータベース障害を宣言し、VIPを解放します(該当する場合)。
エージェントが仮想IPアドレスまたはデータベースサーバに到達できない場合、フェールオーバーマネージャーはフェイルオーバープロセスを開始します。最新ノードのスタンバイエージェントは、フェンシングスクリプト(該当する場合)を実行し、スタンバイデータベースをプライマリデータベースに昇格させ、仮想IPアドレスをスタンバイノードに割り当てます。追加のスタンバイノードは、auto.reconfigureがfalseに設定されていない限り、新しいプライマリから複製するように構成されます。該当する場合、エージェントはポストプロモーションスクリプトを実行します。
ノードをクラスターに戻す
クラスター全体を再起動せずにこのシナリオから回復するには:
1.オリジナルのプライマリノードのデータベースをスタンバイデータベースとして再起動します。オリジナルのプライマリノードでefm resumeコマンドを呼び出します。
ノードをプライマリのロールに戻す
ノードをスタンバイとしてクラスターに戻した後、簡単にノードをプライマリのロールに結果ことができます。
1.クラスターに複数のスタンバイノードがある場合、efm set-priorityコマンドを使用して、ノードのフェイルオーバー優先度を1.2に設定します。
efm promote
-switchoverコマンドを呼び出して、ノードをプライマリノードのオリジナルのロールにプロモートさせます。
!!! Note * Failover Managerは、障害が発生したプライマリデータベースを再構築してスタンバイになりません。再構築する前に、プライマリが失敗した理由を特定し、すべてのデータが新しいプライマリで利用可能であることを保証ことが重要です。サーバーをスタンバイとして復元する準備ができたら、古いデータディレクトリを削除して、サーバーを復元できます。詳細については、 PostgreSQLの文書を参照してください。場合によっては、を使用してサーバーを復元することもできます。
</ div>
スタンバイデータベースがダウンしています
スタンバイエージェントがデータベースの障害を検出した場合、エージェントは他のエージェントに通知します。他のエージェントは、データベースの状態を確認します。
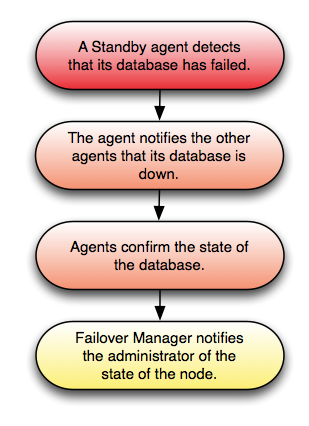
Confirming the failure of a standby database.
スタンバイデータベースを正常な状態に戻した後、efm resumeコマンドを呼び出して、スタンバイをクラスターに結果ます。
</ div>
プライマリエージェントが終了するか、ノードに障害が発生する
フェールオーバーマネージャーのプライマリエージェントがクラッシュするか、ノードに障害が発生すると、スタンバイエージェントが障害を検出し、必要に応じてフェイルオーバーを開始します。
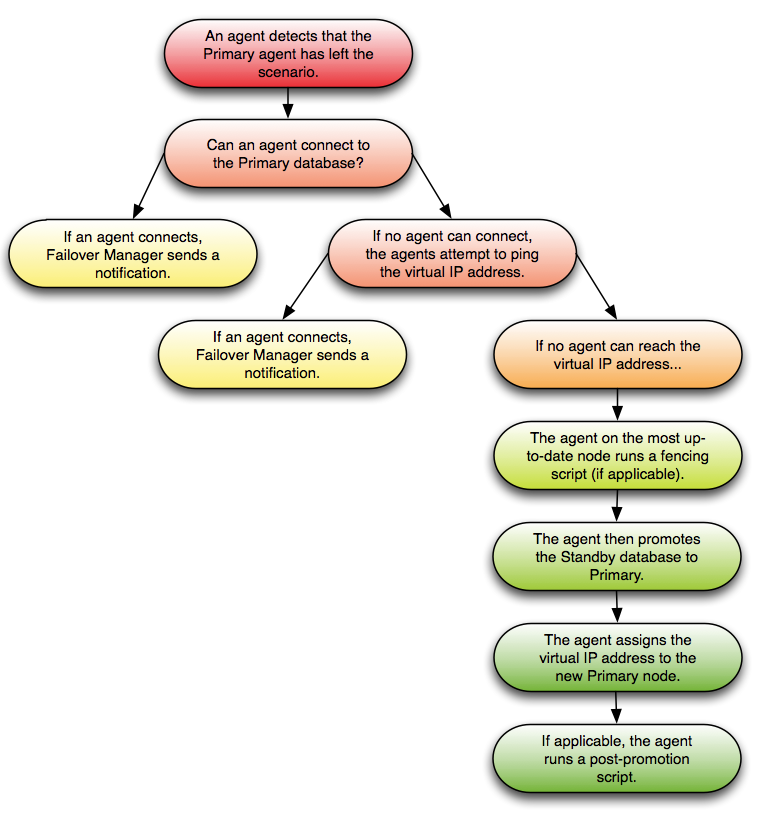
Confirming the failure of the primary agent.
プライマリエージェントが去ったことをエージェントが検出すると、すべてのエージェントがプライマリデータベースに直接接続しようとします。エージェントがデータベースに接続できる場合、エージェントはプライマリエージェントの障害に関する通知を送信します。接続できるエージェントがない場合、エージェントは仮想IPアドレス(該当する場合)に対してピングを試行し、解放されたかどうかを判断します。
エージェントが仮想IPアドレスまたはデータベースサーバに到達できない場合、フェールオーバーマネージャーはフェイルオーバープロセスを開始します。最新ノードのスタンバイエージェントは、フェンシングスクリプト(該当する場合)を実行し、スタンバイデータベースをプライマリデータベースに昇格させ、仮想IPアドレスをスタンバイノードに割り当てます。該当する場合、エージェントはポストプロモーションスクリプトを実行します。追加のスタンバイノードは、auto.reconfigureがfalseに設定されていない限り、新しいプライマリから複製するように構成されます。
プライマリがネットワークから分離されたためにこのシナリオが発生した場合、プライマリエージェントは分離を検出し、仮想IPアドレスを解放し、recovery.confファイルを作成します。フェールオーバーマネージャーは、クラスターの残りのノードで同じ手順を実行します。
クラスター全体を再起動せずにこのシナリオから回復するには:
1.オリジナルのプライマリノードを再起動します。オリジナルのプライマリデータベースをスタンバイノードとして起動します。オリジナルのプライマリノードでサービスを開始します。
!!! Note: * エージェントを停止しても、エージェントに障害が発生したことをクラスターにシグナルしません。
プライマリフェールオーバーマネージャープロセスが失敗した場合、エージェントが再起動されるまでフェイルオーバー保護はありません。この場合を回避するには、systemdを介してプライマリノードをセットアップし、プライマリエージェントが終了したときにフェイルオーバーを発生させることができます。詳細については、Configuring for Eager Failoverを参照してください。
</ div>
スタンバイエージェントが終了するか、ノードに障害が発生する
スタンバイエージェントが終了するか、スタンバイノードに障害が発生すると、他のエージェントは、クラスタに接続されなくなったことを検出します。
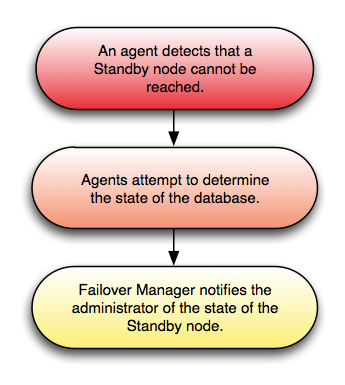
Failure of standby agent.
障害が検出されると、エージェントはノード上にあるデータベースへの接続を試みます。エージェントが問題があることを確認すると、フェールオーバーマネージャーは適切な通知を管理者に送信します。
1つのプライマリと1つのスタンバイのみが残っている場合、プライマリノードに障害が発生した場合のフェイルオーバー保護はありません。プライマリデータベースに障害が発生した場合、プライマリエージェントとスタンバイエージェントは、データベースに障害が発生したことに同意し、フェイルオーバーを続行できます。
</ div>
専用の監視エージェントが終了/ノードが失敗する
このシナリオでは、専用ミラーリング監視(データベースをホスティングていないノード)が失敗した場合に実行されるアクションを詳しく説明します。
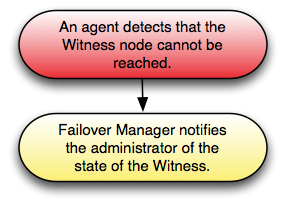
Confirming the failure of a dedicated witness.
監視ノードに到達できないことをエージェントが検出すると、フェールオーバーマネージャーは管理者に監視の状態を通知します。
!!! Note * ミラーリング監視が失敗し、クラスターに2つのノードしかない場合、フェイルオーバー保護はありません。スタンバイノードは、プライマリが失敗したか切断されたかを知ることができません。 2ノードクラスタでは、プライマリデータベースに障害が発生しても、ノードが接続されたままの場合、フェイルオーバーが発生します。スタンバイは、プライマリデータベースの状態を確認できます。
</ div>
ノードはクラスターから分離されます
このシナリオでは、1つ以上のノード(クラスターの少数)がクラスターの大部分から分離された場合に実行されるアクションについて詳しく説明します。
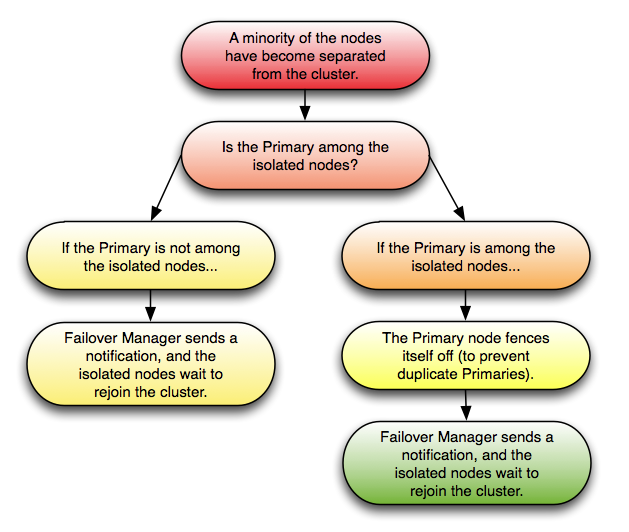
If members of the cluster become isolated.
1つ以上のノード(ただし、クラスターの半分より小さい)がクラスターの残りの部分から分離されると、残りのクラスターは、ノードに障害が発生したかのように動作します。エージェントは、プライマリノードが隔離されたノードに含まれているかどうかを識別しようとします。そうである場合、プライマリフェンス自分自身がクラスタから隔離され、クラスタの過半数内からスタンバイノードが昇格して、それを置き換えます。
auto.reconfigureがfalseに設定されていない限り、他のスタンバイノードは新しいプライマリから複製するように構成されます。
フェールオーバーマネージャーは管理者に通知し、分離されたノードは可能なときにクラスターに再参加します。ノードがクラスターに再参加すると、フェイルオーバーの優先順位が変更される場合があります。
前のトピックへ
次のトピックへ
目次
- Release Notes
- Choosing a deployment architecture
- Prerequisites
- Installing Failover Manager
- Upgrading an existing cluster
- Configuring streaming replication
- Configuring Failover Manager
- Configuring SSL authentication on a Failover Manager cluster
- Using Failover Manager
- Using the efm utility
- Monitoring a Failover Manager cluster
- Controlling the Failover Manager service
- Controlling logging
- Notifications
- Supported failover and failure scenarios
- Troubleshooting
- Creating a Failover Manager cluster