HARP functionality overview
HARPは、 BDRクラスターの高可用性に対する新しいアプローチです。コンセンサス駆動のクォーラムを活用して、半排他的な方法で正しい接続エンドポイントを決定し、アプリケーションからの意図しないマルチノード書き込みを防ぎます。
クォーラムの重要性
HARPの主な目的は、管理するPostgresクラスターにフルクォーラムを適用することです。クォーラムとは、決定を行うために特定の最小限の出席者を義務付ける投票機関に適用される用語です。より簡単に:多数決ルール。
同点以外の結果に終わるには、奇数のノードが完全なクラスターメンバーシップを構成する必要があります。ただし、クォーラムはこの制限を厳密に要求しません。単純過半数で十分です。これは、Nノードのクラスターでは、クォーラムが意味のある投票を保持するために少なくともN/2+1ノードが必要であることを意味します。
これらすべてにより、クラスターが「担当」するノードに関して常に合意することが保証されます。複数のノードで構成されるEDB Postgres分散クラスターの場合、これはプライマリ書き込みターゲットであるノードを決定します。 HARPはこのノードをリードマスターとして指定します。
書き込みターゲットの削減
クォーラムの概念を無視するか、それを十分に適用しないと、「正しい」書き込みターゲットがあいまいまたは不明な「スプリットブレイン」シナリオが発生する可能性があります。標準のPostgresクラスターでは、1つのノードのみが書き込み可能で、残りのノードにレプリケーショントラフィックを送信することが重要です。
BDRなどのマルチマスター対応のアプローチでも、クラスター全体で同一のデータを取得するために必要な競合管理の量を削減すると役立ちます。物理的な場所またはリージョンごとに複数のBDRノードで構成されるクラスターでは、これは通常、単一のBDRノードが「リーダー」として機能し、残りのノードが「シャドウ」であることを意味します。これらのシャドウノードは引き続き書き込み可能ですが、どうしても必要な場合を除き、書き込みはお勧めしません。
クォーラムを活用することで、すべてのノードがクラスター全体またはローカルBDRリージョンを表す正確なPostgresノードに同意できます。定義上、クォーラムの残りの部分との接続を失ったノード、またはクォーラムによって無効にされたノードはクラスターリーダーになることはできません。
この制限により、書き込みが意図せずに2つのPostgresノードに到達するスプリットブレイン状況が防止されます。 VPN、プロキシ、ロードバランサー、DNSなどのテクノロジーとは異なり、構成ミスやネットワークパーティションによってクォーラムから派生したコンセンサスを回避することはできません。コンセンサスレイヤーに接続して、 HARPによって維持されるクォーラムの状態を判断できる限り、有効なターゲットは1つだけです。
基本的なアーキテクチャ
HARPのデザインは、基本的にマネージャーとプロキシの2つの部分で構成されています。次の図は、これらが単一のPostgresインスタンスとどのように相互作用するかを説明しています。
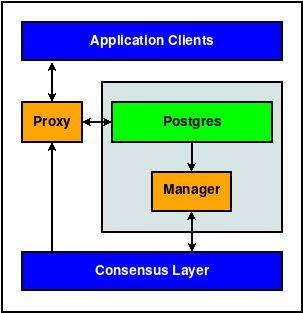
HARP Unit
コンセンサスレイヤーは、Harp Managerが割り当てられたPostgresノードについて学習した情報を維持する外部エンティティであり、 HARPプロキシはこの情報を有効なPostgresノードターゲットに変換します。プロキシはコンセンサスレイヤーからノードターゲットを取得するため、このようなインスタンスが複数存在する可能性があります。
コンセンサスレイヤーとしてBDRを使用している間、各サーバーノードは代わりにこのバリアントに似ています。
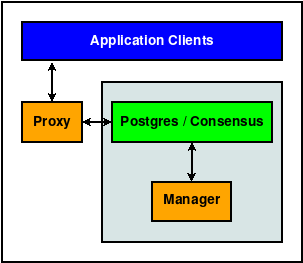
HARP Unit w/BDR Consensus
いずれの場合も、各ユニットは次の要素で構成されます。
PostgresまたはEDBインスタンス
Postgresインスタンスのさまざまな属性を追跡するためのコンセンサスレイヤーリソース
Postgresノードの状態をコンセンサスレイヤーに伝えるHARP Managerプロセス
*コンセンサスレイヤーから派生した、適切なリードマスターノードにトラフィックを転送するHARPプロキシサービス
すべてのアプリケーションスタックがプロキシコンポーネント専用の追加ノードリソースにアクセスできるわけではないため、アプリケーションサーバーと組み合わせてスタックを簡素化できます。
これは、リードマスター/シャドウマスター構成で編成された単一のデータセンターで2つのBDRノードを使用する一般的なデザインです。
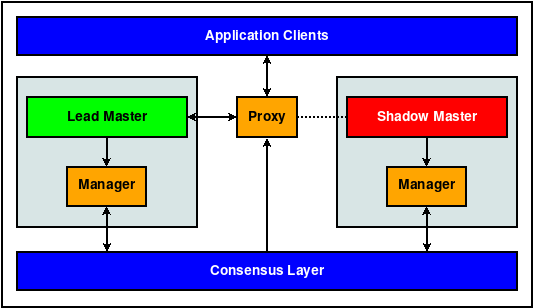
HARP Cluster
BDRをHARPコンセンサスレイヤーとして使用する場合、クォーラムマジョリティを保証には、少なくとも3つの完全修飾BDRノードが存在する必要があります。 (図には、 BDRノード間の接続は示されていません。)
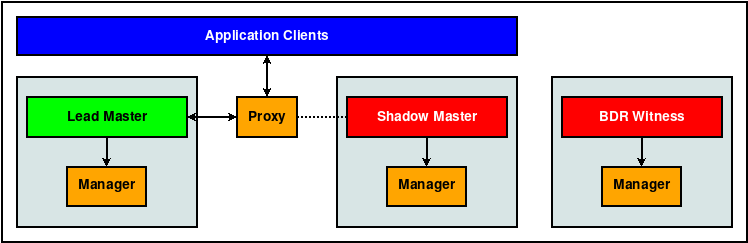
HARP Cluster w/BDR Consensus
仕組み
EDB Postgres分散クラスターを管理する場合、 HARPは定義された場所ごとに最大1つのリーダーノードを維持します。これはリードマスターと呼ばれます。この位置を取得できる他のBDRノードは、リーダーロールを取得するまでシャドウマスター状態です。
アプリケーションは、プロキシサービスを介してのみ現在のリーダーに連絡できます。コンセンサスレイヤーはリーダーの状態を伝える前にクォーラム契約を必要とするため、プロキシサービスはトラフィックをそのノードに転送します。
高レベルでは、このメカニズムはマルチプルのノードとの同時のアプリケーションの相互作用を防ぎます。
リーダーの決定
例として、単一のデータセンターに存在する可能性がある、ローカルに細分化されたBDR Always-Onグループでのリードマスターのロールを検討します。 PostgresまたはManagerリソースが起動され、構成可能な更新間隔の後、次が発生する必要があります。
Managerは、割り当てられたPostgresリソースのステータスを確認します。 - Postgresが実行されていない場合は、構成可能なタイムアウト後に再試行します。 - Postgresが実行されている場合は続行します。
Managerは、コンセンサスレイヤーのリーダーリースのステータスを確認します。 -リースが要求されていない場合は、リースを取得し、このマネージャーに割り当てられたPostgresインスタンスのIDを割り当てます。このリース期間は構成可能ですが、設定が低すぎると、予期しないリーダーシップの移行が発生する可能性があります。 - リースが既に当社によって要求されている場合は、リースのTTLを更新します。 - それ以外の場合は何もしません。
もっと多くのことが起こりますが、この単純化されたバージョンは何が起こっているのかを説明しています。リーダーリースは1つのノードでのみ保持でき、他の場所で保持されている場合、 HARPマネージャーはあきらめて後で再試行します。
注釈
選択されたコンセンサスレイヤーに応じて、リーダーリースのステータスを確認するために繰り返しループするのではなく、 HARPは通知をサブスクライブします。この場合、リースの状態が変化するたびに、ポーリングではなくすぐに応答できます。現在、この機能はetcdコンセンサスレイヤーに制限されています。
これは、 HARP自分自身が選挙を行ったり、コンセンサスレイヤーに委任されたりするクォーラムを管理しないことを意味します。コンセンサスレイヤーのクォーラムはリースを取得する行為を確認する必要があるため、要求が成功した場合、そのノードはその場所のクラスターをリードします。
接続ルーティング
リードマスターのロールが確立されると、接続はHARPプロキシに反映されるのと同様の決定論的な結果で処理されます。 HARPプロキシが特定のバックエンドリソースの接続ターゲットを決定する必要がある場合を考えます。
HARPプロキシは、設定された場所にある現在のリードマスターのコンセンサスレイヤーを照会します。
2.これが設定されていないか移行中の場合: - Postgresへの新しいクライアント接続は禁止されていますが、クライアントは蓄積され、リードマスターが表示されるまで一時停止状態になります。 -既存のクライアント接続は現在のトランザクションを完了することが許可され、新しい接続と同様の保留状態に戻ります。
3.クライアント接続はリードマスターに転送されます。
この場合に示される相互作用は、 HARP ManagerまたはPostgresとの相互作用を必要としません。コンセンサスレイヤーは、プロキシの観点からのすべての真実のソースです。
コロケーション
ワークユニットの配置は、組織が次の原則に従う必要があります。
managerユニットとPostgresユニットが同一ノードに存在すること。
2.コンセンサスレイヤーの内容は、すべての運用作業単位の規範的な役割を指示します。
この取り決めは、クラスタークォーラムの責任をコンセンサスレイヤーに委任しますが、 HARPは重要なロールの割り当てとキー/値のストレージにそれを活用します。コンセンサスレイヤーが動作不能または到達不能の場合、ストレージも取得も成功しないため、不正なPostgresノードが接続を受け入れることを防ぎます。
その結果、コンセンサスレイヤーは一般に、安全性を最大限に高めるためにHARPまたはHARP管理対象ノードの外部に存在します。リファレンス図はこの分離を示していますが、必須ではありません。
注釈
クラスター状態を操作および管理するために、 BDRにはRaftコンセンサスモデルの独自の実装が含まれています。この同じレイヤーを利用して、外部依存関係への依存を減らし、サーバーリソースを保持するようにHARPを構成できます。ただし、このアプローチの特定の欠点については、 コンセンサスレイヤー で説明されています。
推奨されるアーキテクチャと使用
HARPは、主に2つ以上のデータセンターにあり、少なくとも5つのBDRノードで構成されるBDR Always-Onアーキテクチャを表すように設計されました。この構成では、ロジカルスタンバイノードはカウントされません。
次の図は、現在および標準の表現を示しています。
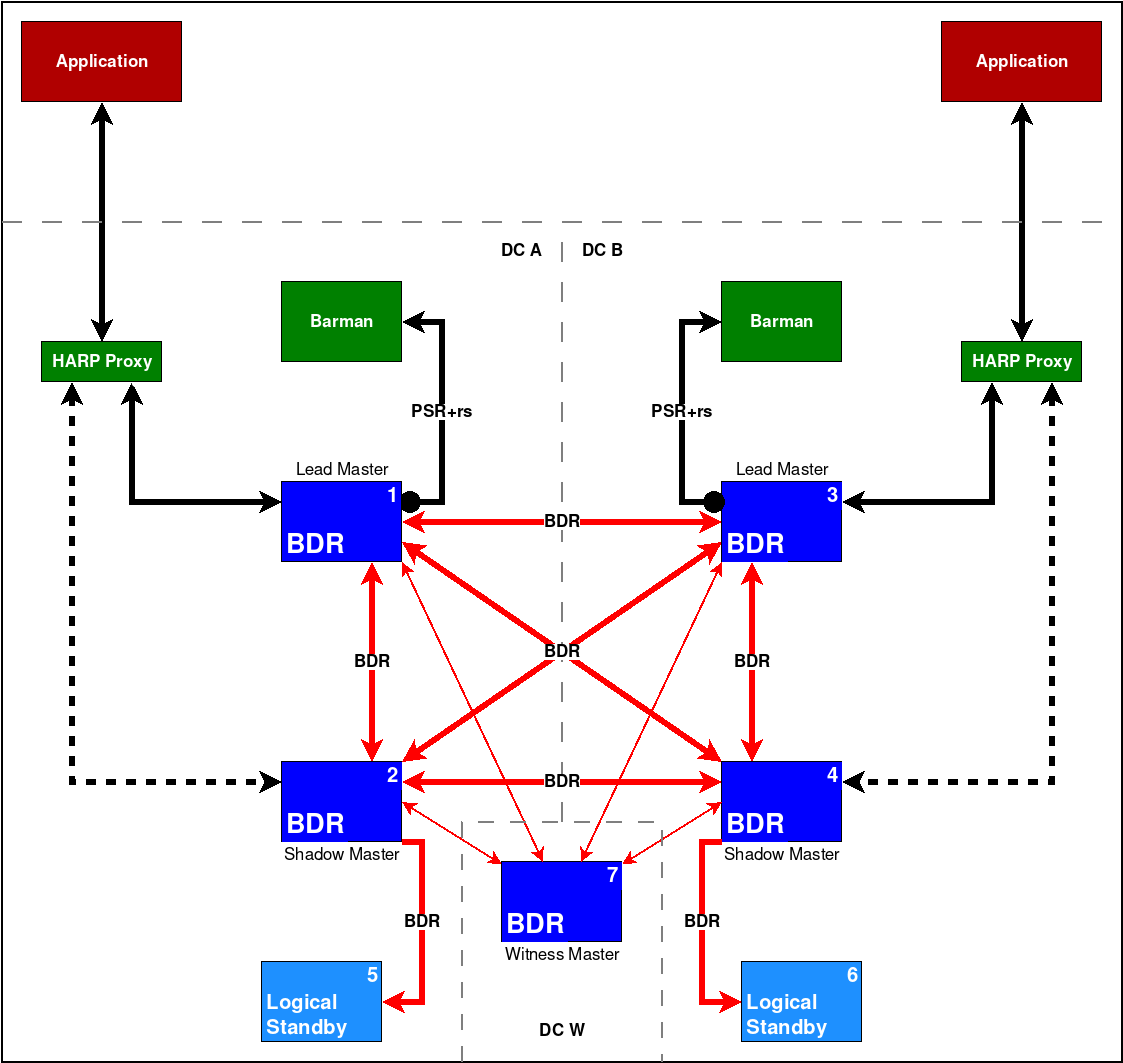
BDR Always-On Reference Architecture
この図では、 HARP ManagerはBDRノード1〜4に存在します。クラスターの初期状態は、 BDRノード1がDC Aのリードマスターであり、 BDRノード3がDC Bのリードマスターです。
この構成により、DC AのHARPプロキシリソースがBDRノード1に接続され、DC BのHARPプロキシリソースがBDRノード3に接続されます。
注釈
この図はDCごとに1つのHARPプロキシのみを示していますが、これは例にすぎず、単一障害点とは見なされません。 HARPプロキシノードはいくつでも存在でき、それらはすべてアプリケーショントラフィックを同じノードに転送します。
ロケーション構成
複数のBDRノードがロケーションでリードマスターロックを取得できるようにするには、
config.yml 構成ファイルでロケーションを定義する必要があります。
図に示されているBDR Always-Onリファレンスアーキテクチャを再現するには、
BDRノード1および2のconfig.yml 構成に次の行を含めます。
location: dca
BDRノード3および4の場合、次を追加します。
location: dcb
これは、これらのそれぞれのデータセンターで指定されたHARPプロキシノードにも適用されます。
BDR 3.7との互換性
BDR 3.7以降では、 BDRノードにロケーションを割り当てることにより、より直接的なロケーション定義を提供します。これを行うには、 BDRノードに接続しているときに次のSQL APIファンクションを呼び出します。したがって、 BDRノード1および2の場合、次のようにします。
SELECT bdr.set_node_location(dca);
BDRノード3および4の場合:
SELECT bdr.set_node_location(dcb);