Concepts - EDB Postgres Lakehouse#
EDB Postgres Lakehouseは、 EDB Postgres® AIプラットフォーム上の運用データに対してRapid Analyticsを実行するためのソリューションです。
主要な概念#
レイクハウスノード は、 管理対象ストレージの場所 の レイクハウステーブル を照会します。
Lakehouse Sync は、ソースデータベースの トランザクションテーブル から Lakehouseテーブル を作成できます。
それがどのように収まるかは次のとおりです。
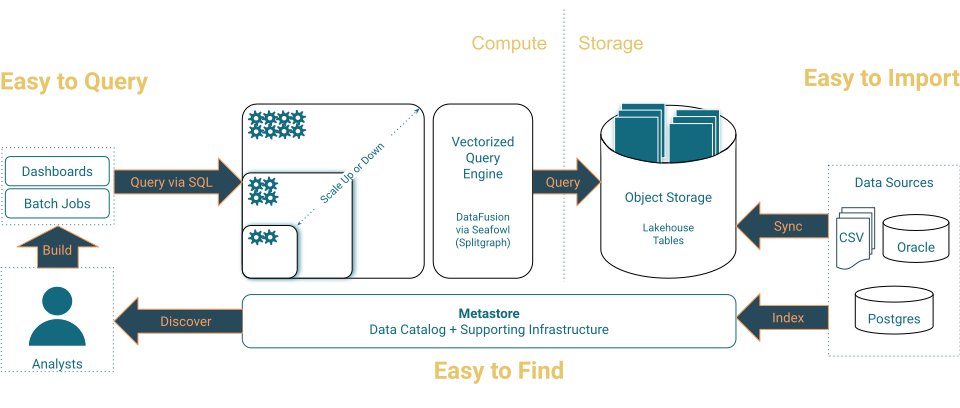
Level 50 basic architecture#
Lakehouseノード#
Postgres LakehouseノードはPostgresで、Lakehouseテーブルを照会するように最適化されたベクトル化クエリエンジンを備えていますが、完全な互換性を得るためにPostgresにフォールバックします。
Lakehouseノードはステートレスで一時的なものです。ワークロード要件に基づいて、それらをスケールアップまたはダウンします。
Lakehouseテーブル#
Lakehouseテーブルは、分析用に最適化され、アナリティクスエコシステムの残りの部分と相互運用可能な、圧縮性の高い列型ストレージ形式を使用して保存されます。現在、Postgres Lakehouseノードは、デルタプロトコルを使用して保存されたテーブル「デルタテーブル」を読み取ることができ、Lakehouse Syncはそれらを書き込むことができます。
管理対象ストレージの場所#
管理対象ストレージ場所 は、オブジェクトストレージでLakehouseテーブルを編成できる場所で、Postgres Lakehouseがそれらを照会できるようにします。
管理対象ストレージの場所は、ファイルレイアウトを制御し、お客様に代わってレイクハウステーブルを書き込むオブジェクトストレージ内の場所です。技術的には、これらをバケットに保存するのは実装の詳細です。これは実際には、独自のバケットを持ってくる「外部ストレージロケーション」もサポートする今後の「ストレージロケーション」機能のサブセットです。
Lakehouse Sync#
Lakehouse Syncは、 EDB Postgres AIプラットフォームの一部として提供されるデータ移行サービスです。トランザクションデータベースから宛先のストレージ場所にあるレイクハウステーブルにテーブルを「同期」できます。現在、 EDB Postgres AI Cloud Service旧BigAnimalとして知られているソースデータベースをサポートしています。将来的には、より多くのソースデータベースOracleなどと展開場所オンプレミスデータベースをサポートする予定です。 Debezium を使用してビルドされています。
用語#
レイクハウス#
「 Lakehouse architecture 」は、データエンジニアリングの実践であり、「Data Lake」と「Data Ware_house_」を組み合わせたもので、両方の利点を提供します。アーキテクチャの中心的な教義は、データがオブジェクトストレージに保存されるということです。一般的にParquetのような列指向形式で、さまざまなクエリエンジンが特定のクエリに最適なコンピューティングリソースを使用して、独自の特殊な目的にそれを処理できます。
ベクトル化されたクエリエンジン#
ベクトル化されたクエリエンジンは、列指向データでクエリを実行するように最適化されたクエリエンジンです。ほとんどの分析エンジンは、ベクトル化されたクエリ実行を使用します。 Postgres Lakehouseは Apache DataFusion を使用します。
デルタテーブル#
私たちは、特定の形式へのオーバーコミットを避けるために「レイクハウステーブル」という用語を使用していますたとえば、最終的にIcebergまたはHudiをサポートする可能性があるため。しかし、技術的には、 Delta Tables を使用しています。デルタテーブルは、「Delta Lake」仕様とオープンプロトコルに従って、ParquetファイルとJSONメタデータの明確に定義されたコンテナーです。 Delta Lakeは、Linux Foundationプロジェクトです。
その仕組み#
Postgres Lakehouseは、多くのテクノロジーを使用して構築されています。
PostgreSQL
Seafowl 、Splitgraphから取得した分析データベース
Apache DataFusion 、Seafowlが使用するクエリエンジン
Delta Lake および具体的には delta-rs デルタテーブルのストレージおよび取得レイヤーを実装するため
レベル100#
Postgres Lakehouseについて理解する最も重要な点は、ストレージをコンピューティングから分離することです。これにより、それらを独立してスケーリングできます。これは、クエリが予測不能でスパイキーになる可能性がある分析ワークロードに最適です。接続されたハードドライブにデータを保持するためだけに、マシンをほとんどアイドル状態にしておいたくないでしょう。代わりに、データをオブジェクトストレージおよび高圧縮可能な形式で保持し、必要に応じて照会に必要なコンピューティングのみをプロビジョニングできます。
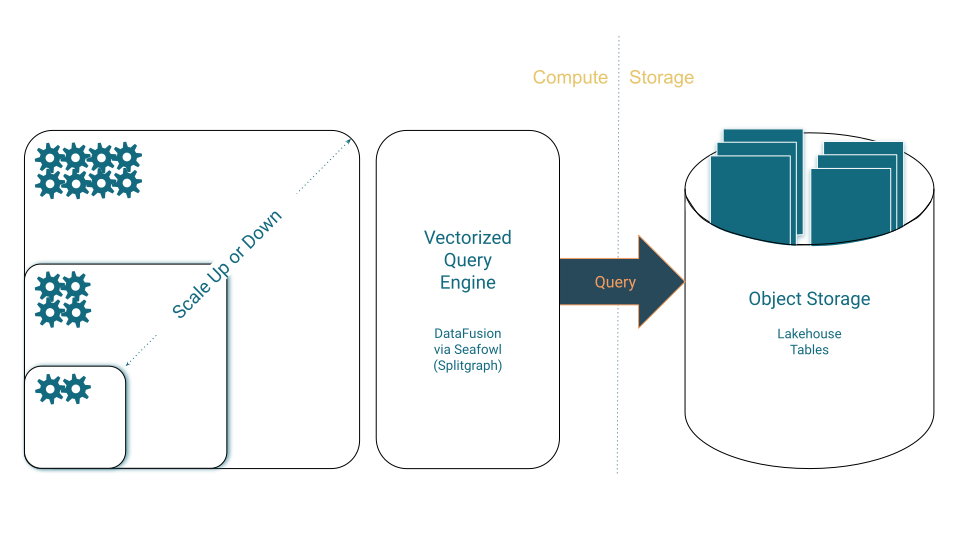
Level 100 Architecture#
コンピューティング側では、ベクトル化されたクエリエンジンはレイクハウステーブルを照会するように最適化されていますが、完全な互換性を得るためにPostgresにフォールバックします。
ストレージ側では、レイクハウステーブルは、アナリティクス用に最適化された圧縮性の高い列型ストレージ形式を使用して保存されます。
レベル200#
次に、これらのサービスがどのように連携するかを示すもう少し包括的な図を示します。
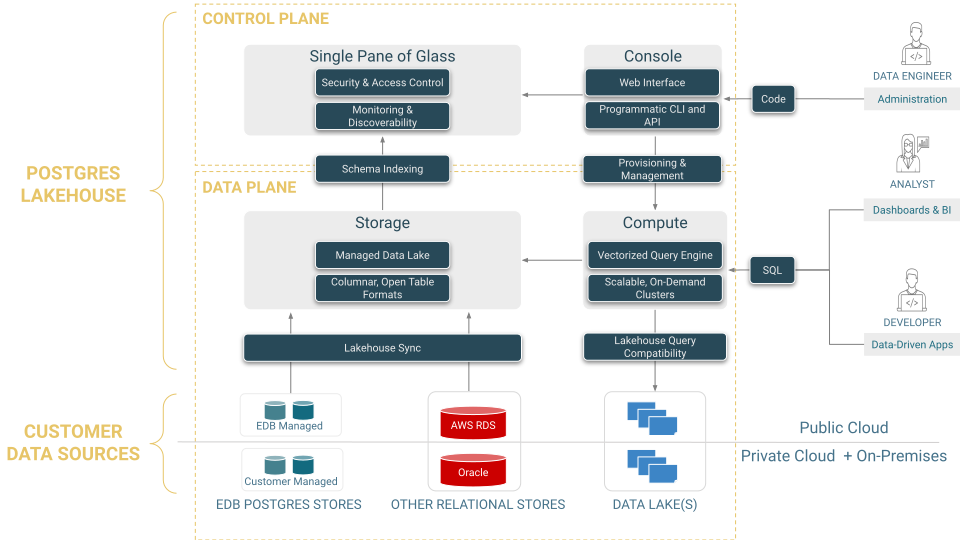
Level 200 Architecture#
レベル300#
これは、「ボックスの内容」のより詳細な拡大ビューです。
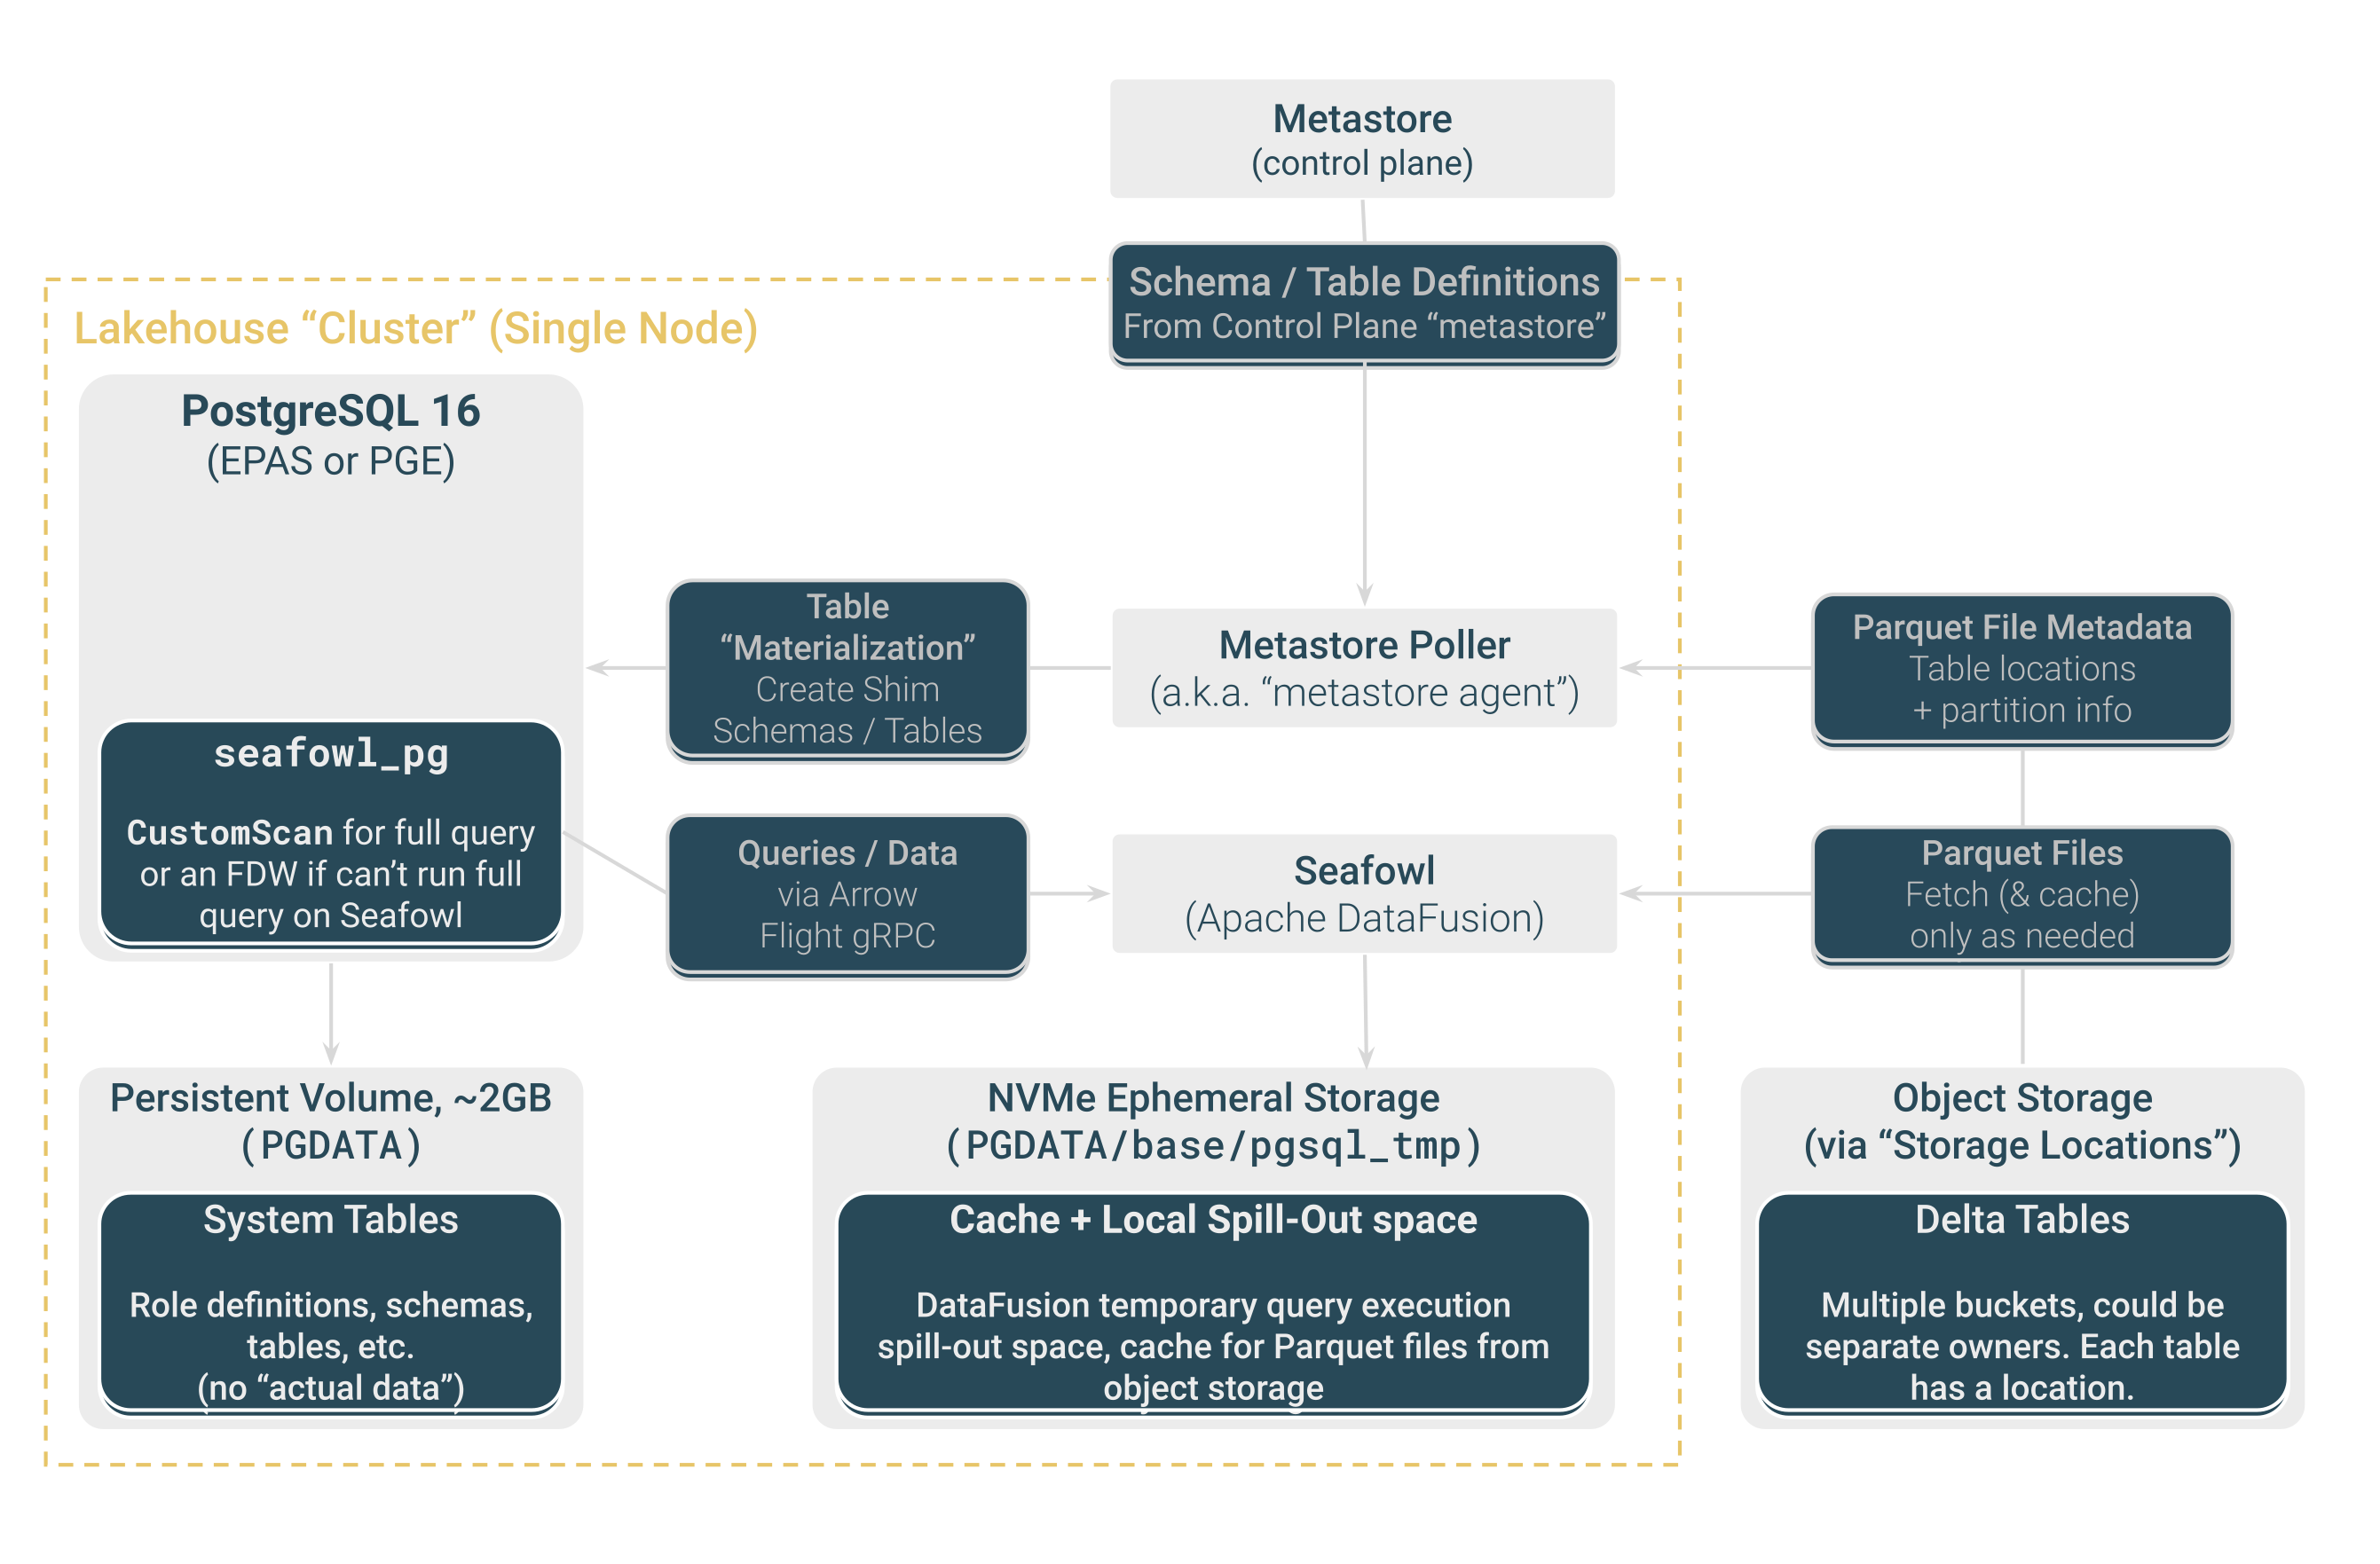
Level 300 Architecture#