Quick Start - EDB Postgres Lakehouse#
このガイドでは、次のことを行います。
Lakehouseノードを作成する
優先するPostgresクライアントを使用してノードに接続します
オブジェクトストレージ内のサンプルデータTPC-H、TPC-DS、Clickbench、または1BRCを照会します
詳細および高度なユースケースについては、 PGAA functions reference を参照してください。
はじめに#
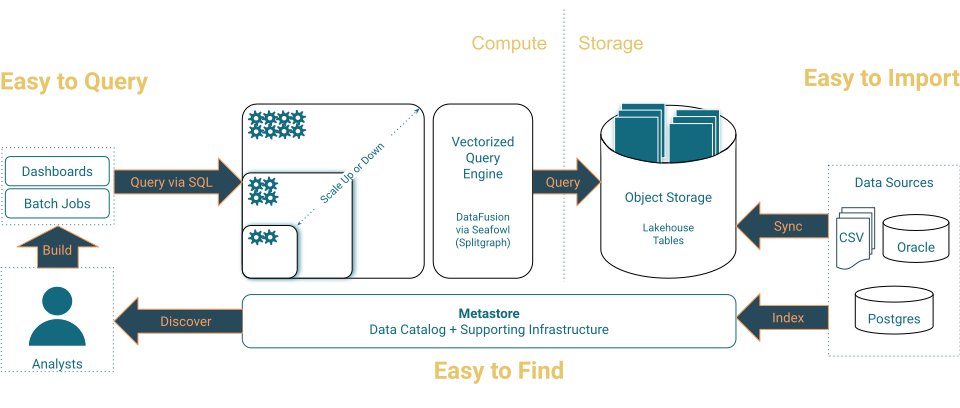
Postgres Lakehouseは、新しいタイプのPostgres「クラスター」実際には単なる1つのノードであり、 EDB Postgres® AI Cloud Services旧「BigAnimal」としてプロビジョニングできます。これには、オブジェクトストレージ内の列状の「レイクハウステーブル」を高速クエリーするためのベクトル化クエリエンジンApache DataFusion ベース Delta Lake protocol を使用します。
知っておくべきこと#
詳細については、 Concepts - EDB Postgres Lakehouse および PGAA functions reference を参照してください。ただし、これはその要点をカバーするはずです。
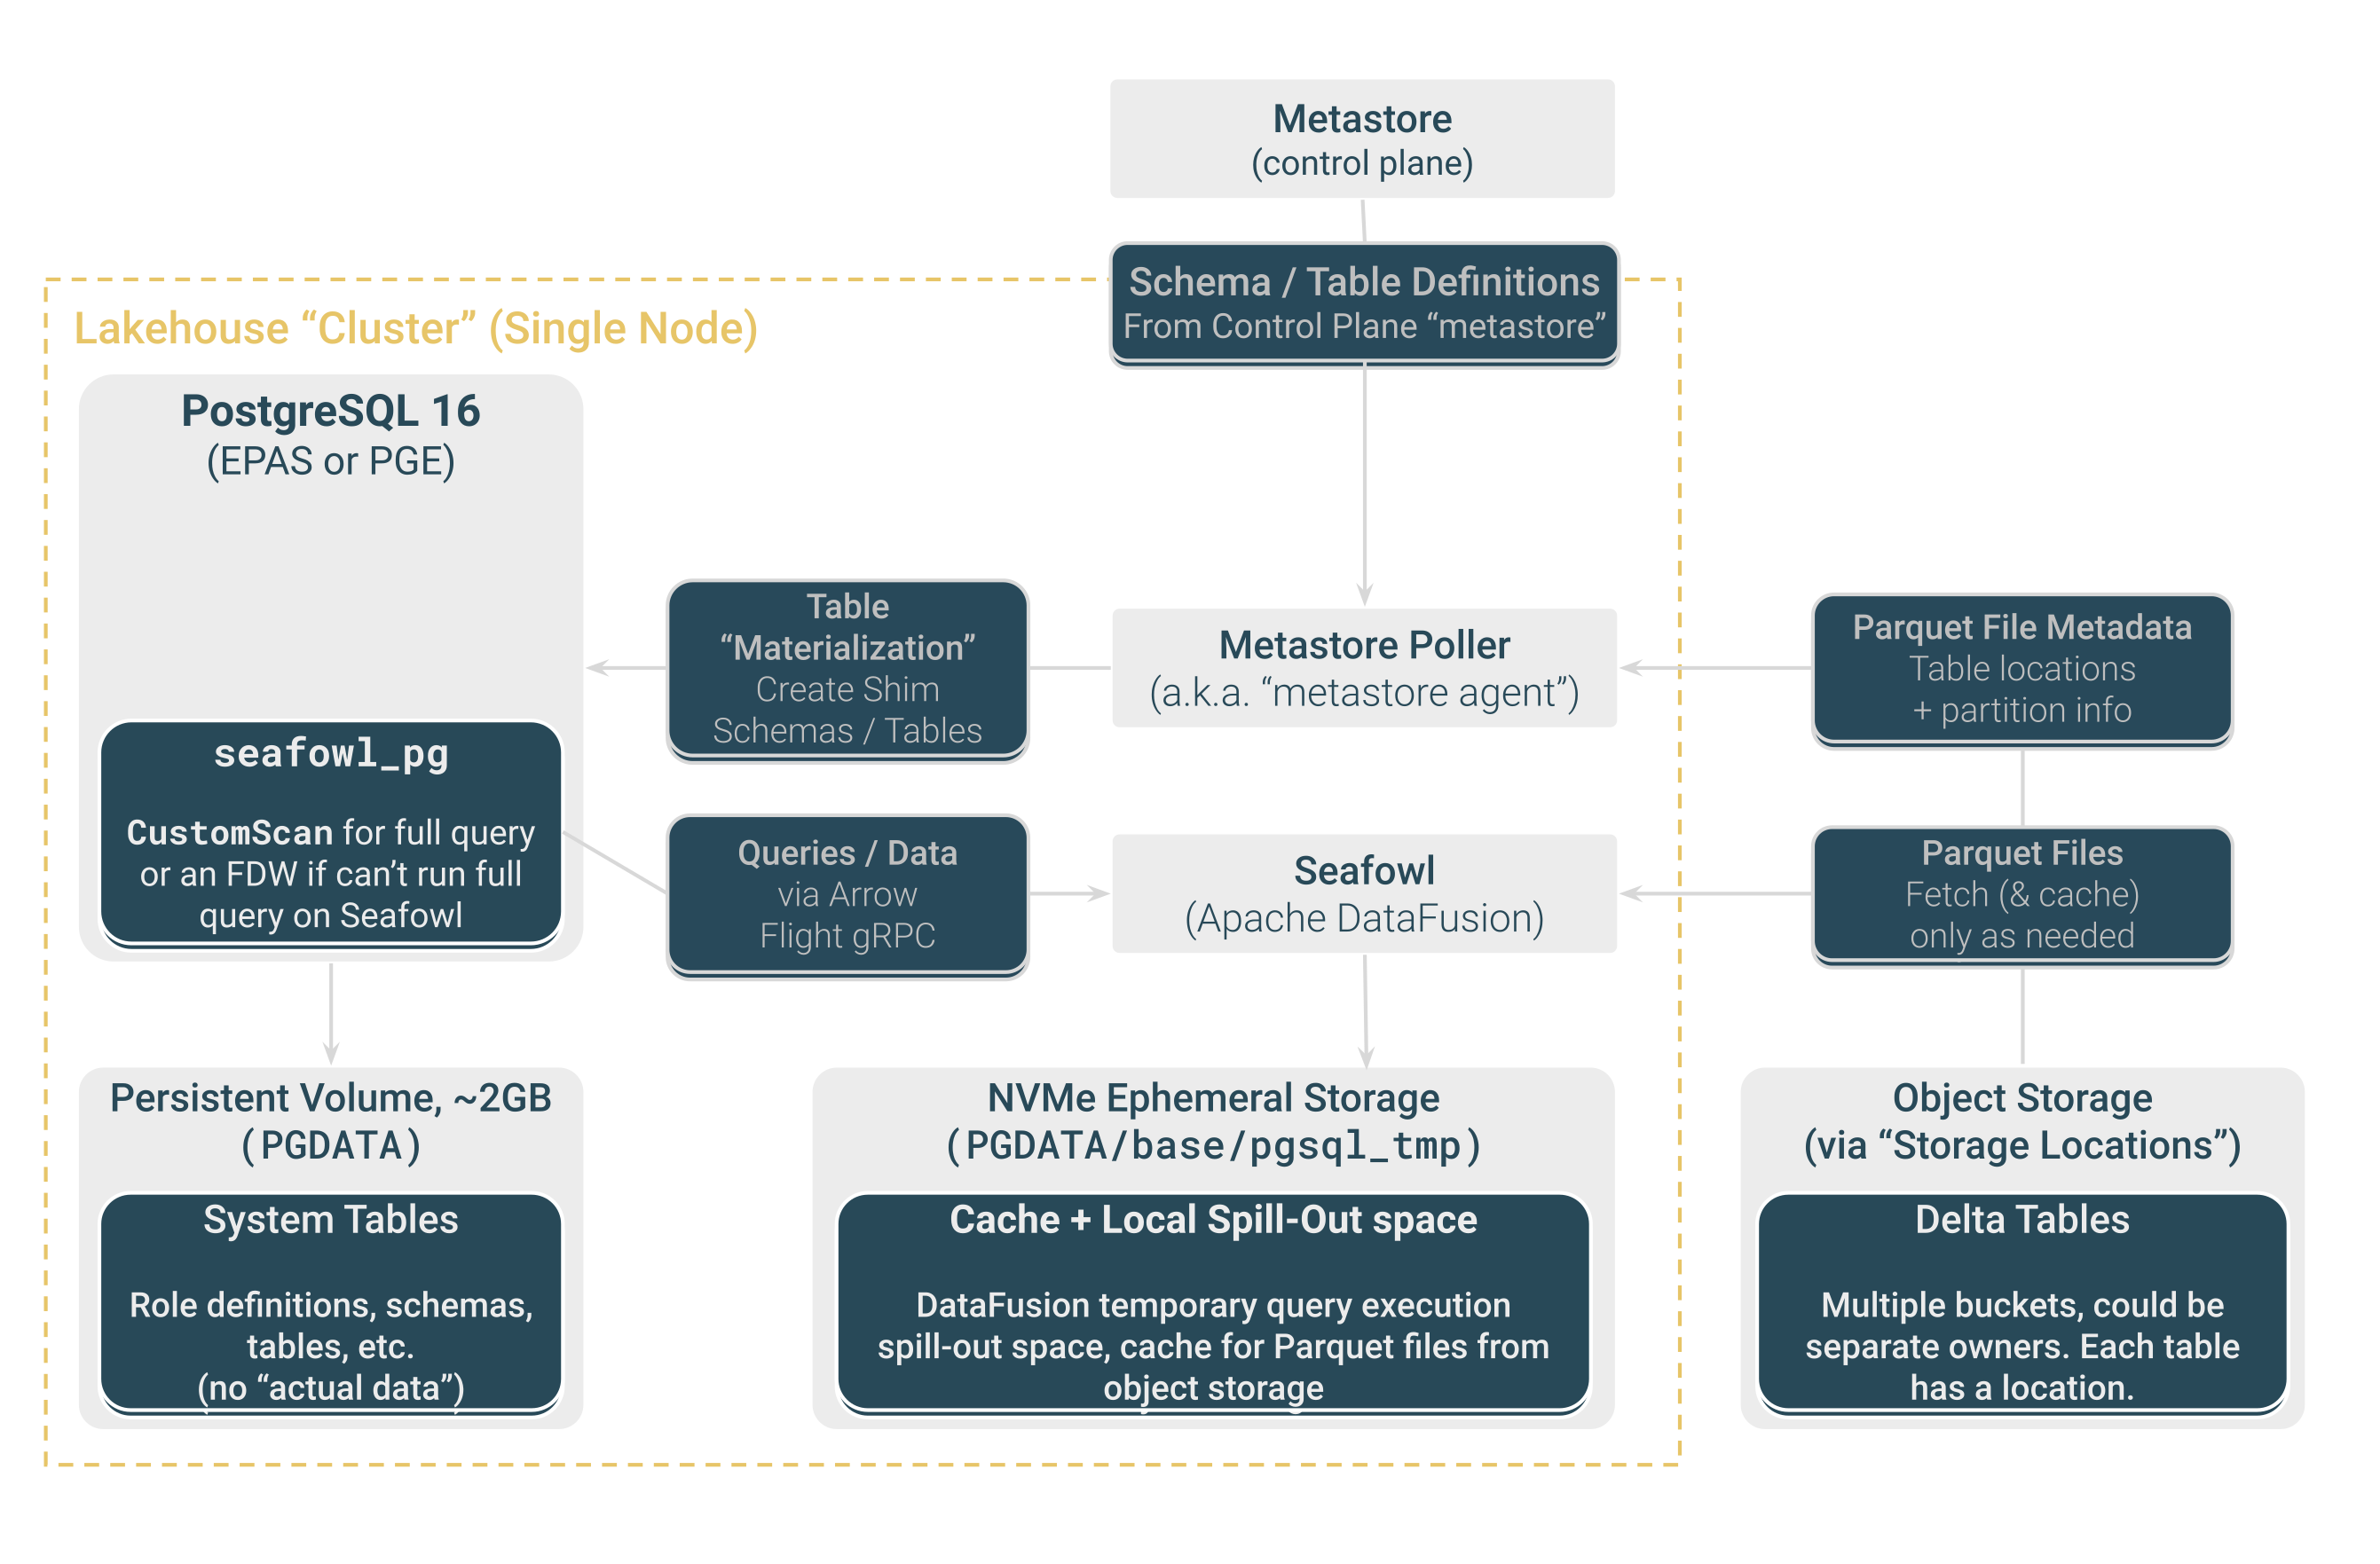
Postgres Lakehouseノードは一時的ですが、ローカルキャッシュとスピルアウト領域用のNVMeハードドライブを備えています。現在、AWSのEDBホストリージョンへの展開をサポートしています。
Postgres Lakehouseノードは、オブジェクトストレージ内のベンチマークデータセットを照会するように事前構成されています。
Postgres Lakehouseは、通常「読み取り専用」ですが、それ以外の場合は、すべての有効なPostgresクエリーをサポートします。
システムテーブルは書き込み可能なため、ユーザーとロールを作成できます。これらのテーブルは、接続されたブロックストレージに保存されるため、インスタンスを再起動するまで持続し、バックアップ/復元操作の一部として保存されます。それ以外の場合、Lakehouseテーブルは最終的にオブジェクトストレージに保存されるため、バックアップの一部になりません。
基本アーキテクチャ#
Lakehouseノードのボックスの内容は次のとおりです。
Level 300 Architecture#
はじめに#
EDB Postgres AIアカウントが必要です。ログインしてプロジェクトを作成したら、クラスターを作成できます。
Lakehouseノードを作成する#
プロジェクトページの「Create New」ドロップダウンの下に「Lakehouse Analytics」オプションが表示されます。
Level 50 basic architecture#
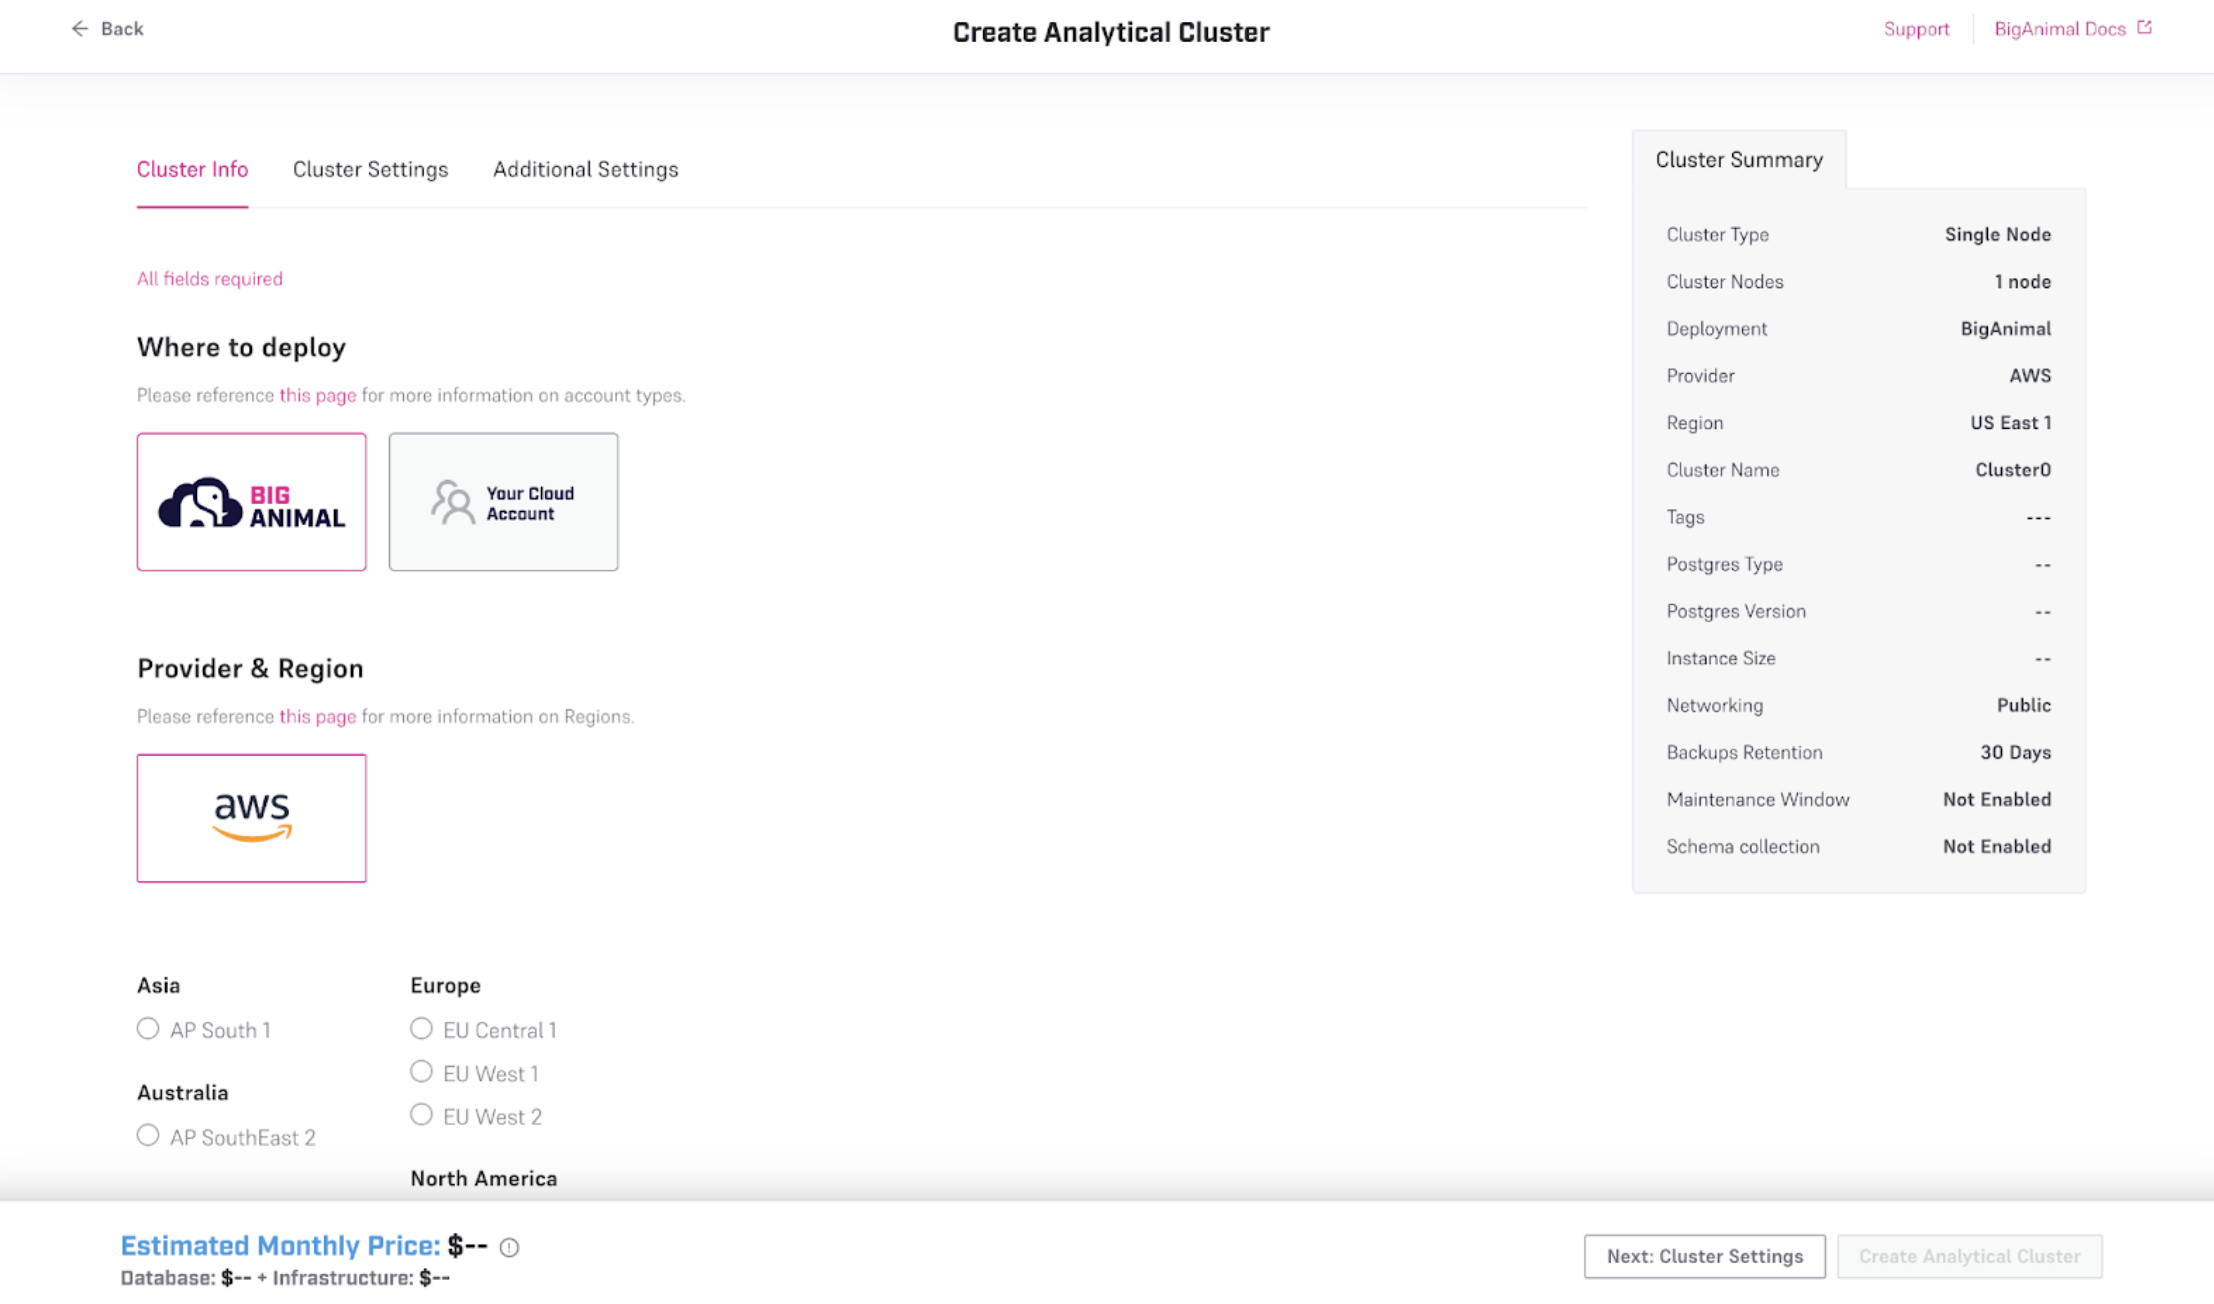
[Lakehouse Analytics]ボタンを選択すると、次のような構成ウィザードが起動します。
Create Lakehouse Node Wizard Step 1#
クラスターのプロビジョニングには10〜15分かかる場合があります。
いくつかの注意事項
独自のパスワードを提供する必要があります。安全なパスワードを作成し、パスワードマネージャーに保存します。私たちの側では保存しません。
BigAnimal Hostedリージョンでは、AWSのみがサポートされています。
EDB Postgres Advanced ServerまたはEDB Postgres ExtendedPGEを選択できます。価格計算ツールは、通常のEPASまたはPGEシングルノードクラスターの場合と同様に、ライセンスコストと同じ式を使用します。
NVMeドライブを備えたインスタンスのみがサポートされています。これはM6IDファミリーです。 NVMeドライブは、クエリの処理中にスピルアウト領域に使用されます。 NVMeドライブ上のすべてのデータは、クラスターがシャットダウンすると失われます。システムテーブルユーザー、ロールなどの永続データは、接続されたブロックストレージデバイスに保存され、再起動またはバックアップ/復元サイクル後も存続します。
Postgres 16のみがサポートされています。
サポートされているインスタンスサイズに関する注意事項については、 Reference - Supported AWS instances を参照してください。
Lakehouseノードの動作#
ノードに接続します#
EDB Postgres AI Cloud Service旧BigAnimalから他のクラスターに接続するのと同じ方法で、Postgresクライアントを使用してLakehouseノードに接続できます。クラスターの詳細ページに移動し、接続文字列をコピーします。
たとえば、 .pgpass blobを~/.pgpass
にコピーします。$YOUR_PASSWORD
を、クラスター起動時に指定したパスワードに置き換えてください。次に、接続文字列をコピーし、psql
またはpgcli への引数として使用できます。
通常、Postgresクライアントでデータベースに接続できる必要があります。私たちはすべてのイントロスペクションクエリーが機能することを期待しています。そうでないクエリーが見つかった場合、それはバグです。
コンストレインを理解する#
すべてのクラスターはEPASまたはPGEを使用します。したがって、接続したときにインストール内のこれらのフレーバーからボイラープレートテーブルが表示されることが予想されます。
クエリ可能データベンチマークデータセットのようなは、デルタテーブルとしてオブジェクトストレージに保存されます。すべてのクラスターは、1〜1000のスケールファクターでTPC-H、TPC-DS、クリックベンチ内のベンチマークデータを含むストレージバケットをポイントするようにプリロードされています。
現時点ではAWSのみがサポートされています。 Bring Your Own Account BYOAはサポートされていません。
EDB Postgres AIアカウントでアクティブ化されている任意のリージョンにクラスターを展開できます。各リージョンには、ベンチマークデータのコピーを含むバケットがあるため、クラスターを起動すると、それに最も近い場所のベンチマークデータを使用します。
クラスターは一時的なものです。システムテーブルのデータを除き、データはハードドライブに保存されません。ロール、ユーザー、および付与。クラスターを再起動するか、クラスターをバックアップして復元すると、これらのシステムテーブルが復元されます。ただし、オブジェクトストレージのデータは変更されないままです。
クラスターは、オブジェクトストレージ内のデータの読み取り専用クエリーをサポートしますが、ユーザーなどを作成するためのシステムテーブルへの書き込みクエリーをサポートします。オブジェクトストレージに直接書き込むことはできません。新しいテーブルを作成することはできません。
独自のデータをオブジェクトストレージにロードする場合は、 Reference - Bring your own data を参照してください。
ベンチマークデータセットを検査する#
ベンチマークデータセットを検査します。すべてのクラスターには、すぐに使用できるベンチマークデータがあります。
pgcliを使用している場合、\dn
を実行して、使用可能なテーブルを表示できます。
使用可能なベンチマークデータセットは次のとおりです。
TPC-H、スケールファクター1、10、100、および1000
TPC-DS、スケールファクター1、10、100、および1000
クリックベンチ、1億行
10億行チャレンジ
ベンチマークデータセットの詳細については、 Reference - Available Benchmarking datasets](./reference/datasets)を参照してください。
ベンチマークデータセットを照会する#
いくつかの基本的なクエリーを実行してみることができます。
edb_admin> select count(*) from clickbench.hits;
+----------+
| count    |
|----------|
| 99997497 |
+----------+
SELECT 1
Time: 0.945s

edb_admin> select count(*) from brc_1b.measurements;
+------------+
| count      |
|------------|
| 1000000000 |
+------------+
SELECT 1
Time: 0.651s
注 search_path は使用しないでください。 PGAA functions reference を読む
その他の注意事項と構文/クエリの互換性に関する情報のページ。