
Introduction to EDB Postgres® Analytics Accelerator#
Analytics Accelerator PGAA を使用して、 EDB Postgresに構築された分析機能を探索します。このアクセラレータは、コア概念を理解し、 EDB Postgres® Lakehouseなどの主要テクノロジーを探索し、EDB Hybrid ManagerHMを使用して分析を実装する方法を学習するのに役立ちます。
私たちは、最新のデータアーキテクチャとオープンスタンダードをPostgresの信頼性と柔軟性と統合して、貴重な洞察を導き出すのを支援します。
分析アクセラレーターのナビゲート#
アクセラレータは、コンテンツを4つのエリアに編成します。
概念的な基礎 分析原則とEDBのアプローチについての理解を深めます。
EDBコア分析テクノロジー 分析サービスを強化するEDBソリューションとテクノロジーについて学びます。
実践的なガイダンスとソリューション ユースケース、ペルソナベースのガイド、ハウツー記事、チュートリアルを見つけます。
製品固有の実装 これらの分析機能がどのように表面化し、EDB Hybrid ManagerなどのEDB製品で管理される方法に関するドキュメントにアクセスします。
概念的な基礎#
最新のデータ分析とEDBのアプローチの背後にある原則と戦略を理解します。
データアーキテクチャデータウェアハウス、データレイク、レイクハウスと基盤テクノロジーカラムナストレージ、ベクトル化エンジンなどについて学びます。
Postgres®分析に対するEDBのビジョンと、EDBがコアテクノロジーを活用する方法を探ります。
EDB分析機能、デザインの選択、および以下のセクションにわたる高度なトピックの詳細な説明を確認します。
EDBコア分析テクノロジー#
EDBの分析テクノロジーと、それらがPostgres®を拡張する方法について学びます。
オブジェクトストレージの分析を有効にするためのEDB Postgres® Lakehouseソリューションとそのコンポーネントを確認します。
EDBソリューションがApache Icebergを使用して大規模な分析データセットを管理する方法を理解します。
EDB Postgres® がデルタテーブルと相互作用して、信頼性の高いデータレイクを有効にする方法を学びます。
EDB Postgres DistributedPGDおよびLakehouse機能を使用してストレージ階層全体でデータを管理し、コストとパフォーマンスを最適化します。
Use Anywhereマニュアル/リファレンス#
レイクハウスの概要 EDB Postgres Lakehouse Architecture
オープンフォーマット Apache Iceberg Integration With Analytics Accelerator 、 Delta Lake Integration with Analytics Accelerator
保存場所 機能と構成については、 PGAA functions reference を参照してください
参照 PGAA functions reference 、 PGAA functions reference 、 Direct scan 、 Inspect the benchmark datasets
PGDでの使用マニュアル/リファレンス#
ハイブリッドマネージャーでの使用マニュアル/リファレンス#
準備中 Getting setup for Lakehouse analytics
プロビジョニング Create A Lakehouse Cluster
カタログ Configure Analytics Storage and Data Tiering with PGAA and PGD
How-Tos :ランブックに合わせた#
これらのガイドは、ランブックフローとコード例を反映しています。
— コアハウツー
どこから始めるべきか#
Analytics Generic Concepts および EDB Postgres Lakehouse Architecture から始めて、コアアイデアを理解します。
外部データを実験する場合は、No Catalogのハウツーを使用してください。
PGD /階層テーブルまたはカタログと統合する場合、PGDおよびカタログのハウツーに従ってください。
Postgres Lakehouseは、多くのテクノロジーを使用して構築されています。
PostgreSQL
Seafowl 、分析データベース
Apache DataFusion 、Seafowlが使用するクエリエンジン
Delta Lake および具体的には delta-rs デルタテーブルのストレージおよび取得レイヤーを実装するため
レベル100#
Postgres Lakehouseについて理解する最も重要な点は、ストレージをコンピューティングから分離することです。このデザインでは、それらを独立してスケーリングできます。これは、クエリが予測不能でスパイキーになる可能性がある分析ワークロードに最適です。接続されているハードドライブにデータを保持するためだけに、マシンをほとんどアイドル状態に保つことはしたくないでしょう。代わりに、データをオブジェクトストレージおよび高圧縮可能な形式で保持し、必要に応じて照会に必要なコンピューティングのみをプロビジョニングできます。
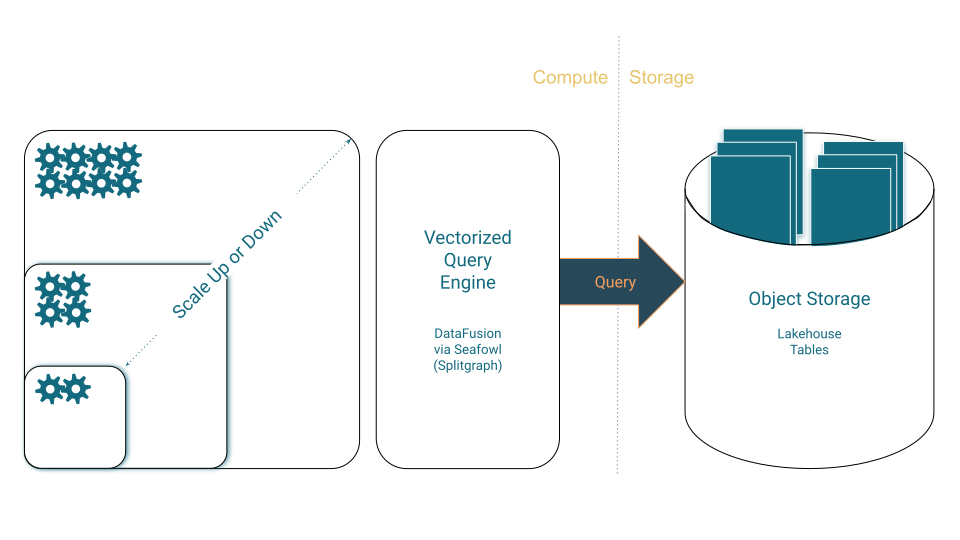
Level 100 Architecture#
コンピューティング側では、ベクトル化されたクエリエンジンはLakehouseテーブルを照会するように最適化されていますが、完全な互換性ためにPostgresにフォールバックします。
ストレージ側では、Lakehouseテーブルは、分析用に最適化された圧縮性の高い列型ストレージ形式を使用して保存されます。
レベル200#
次に、これらのサービスがどのように連携するかを示すもう少し包括的な図を示します。
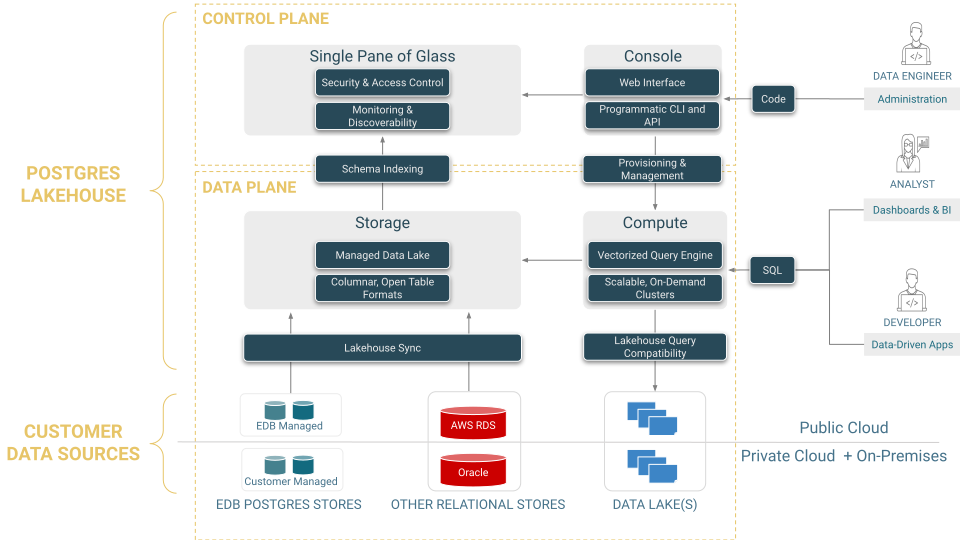
Level 200 Architecture#
レベル300#
これは、「ボックスの内容」のより詳細な拡大ビューです。
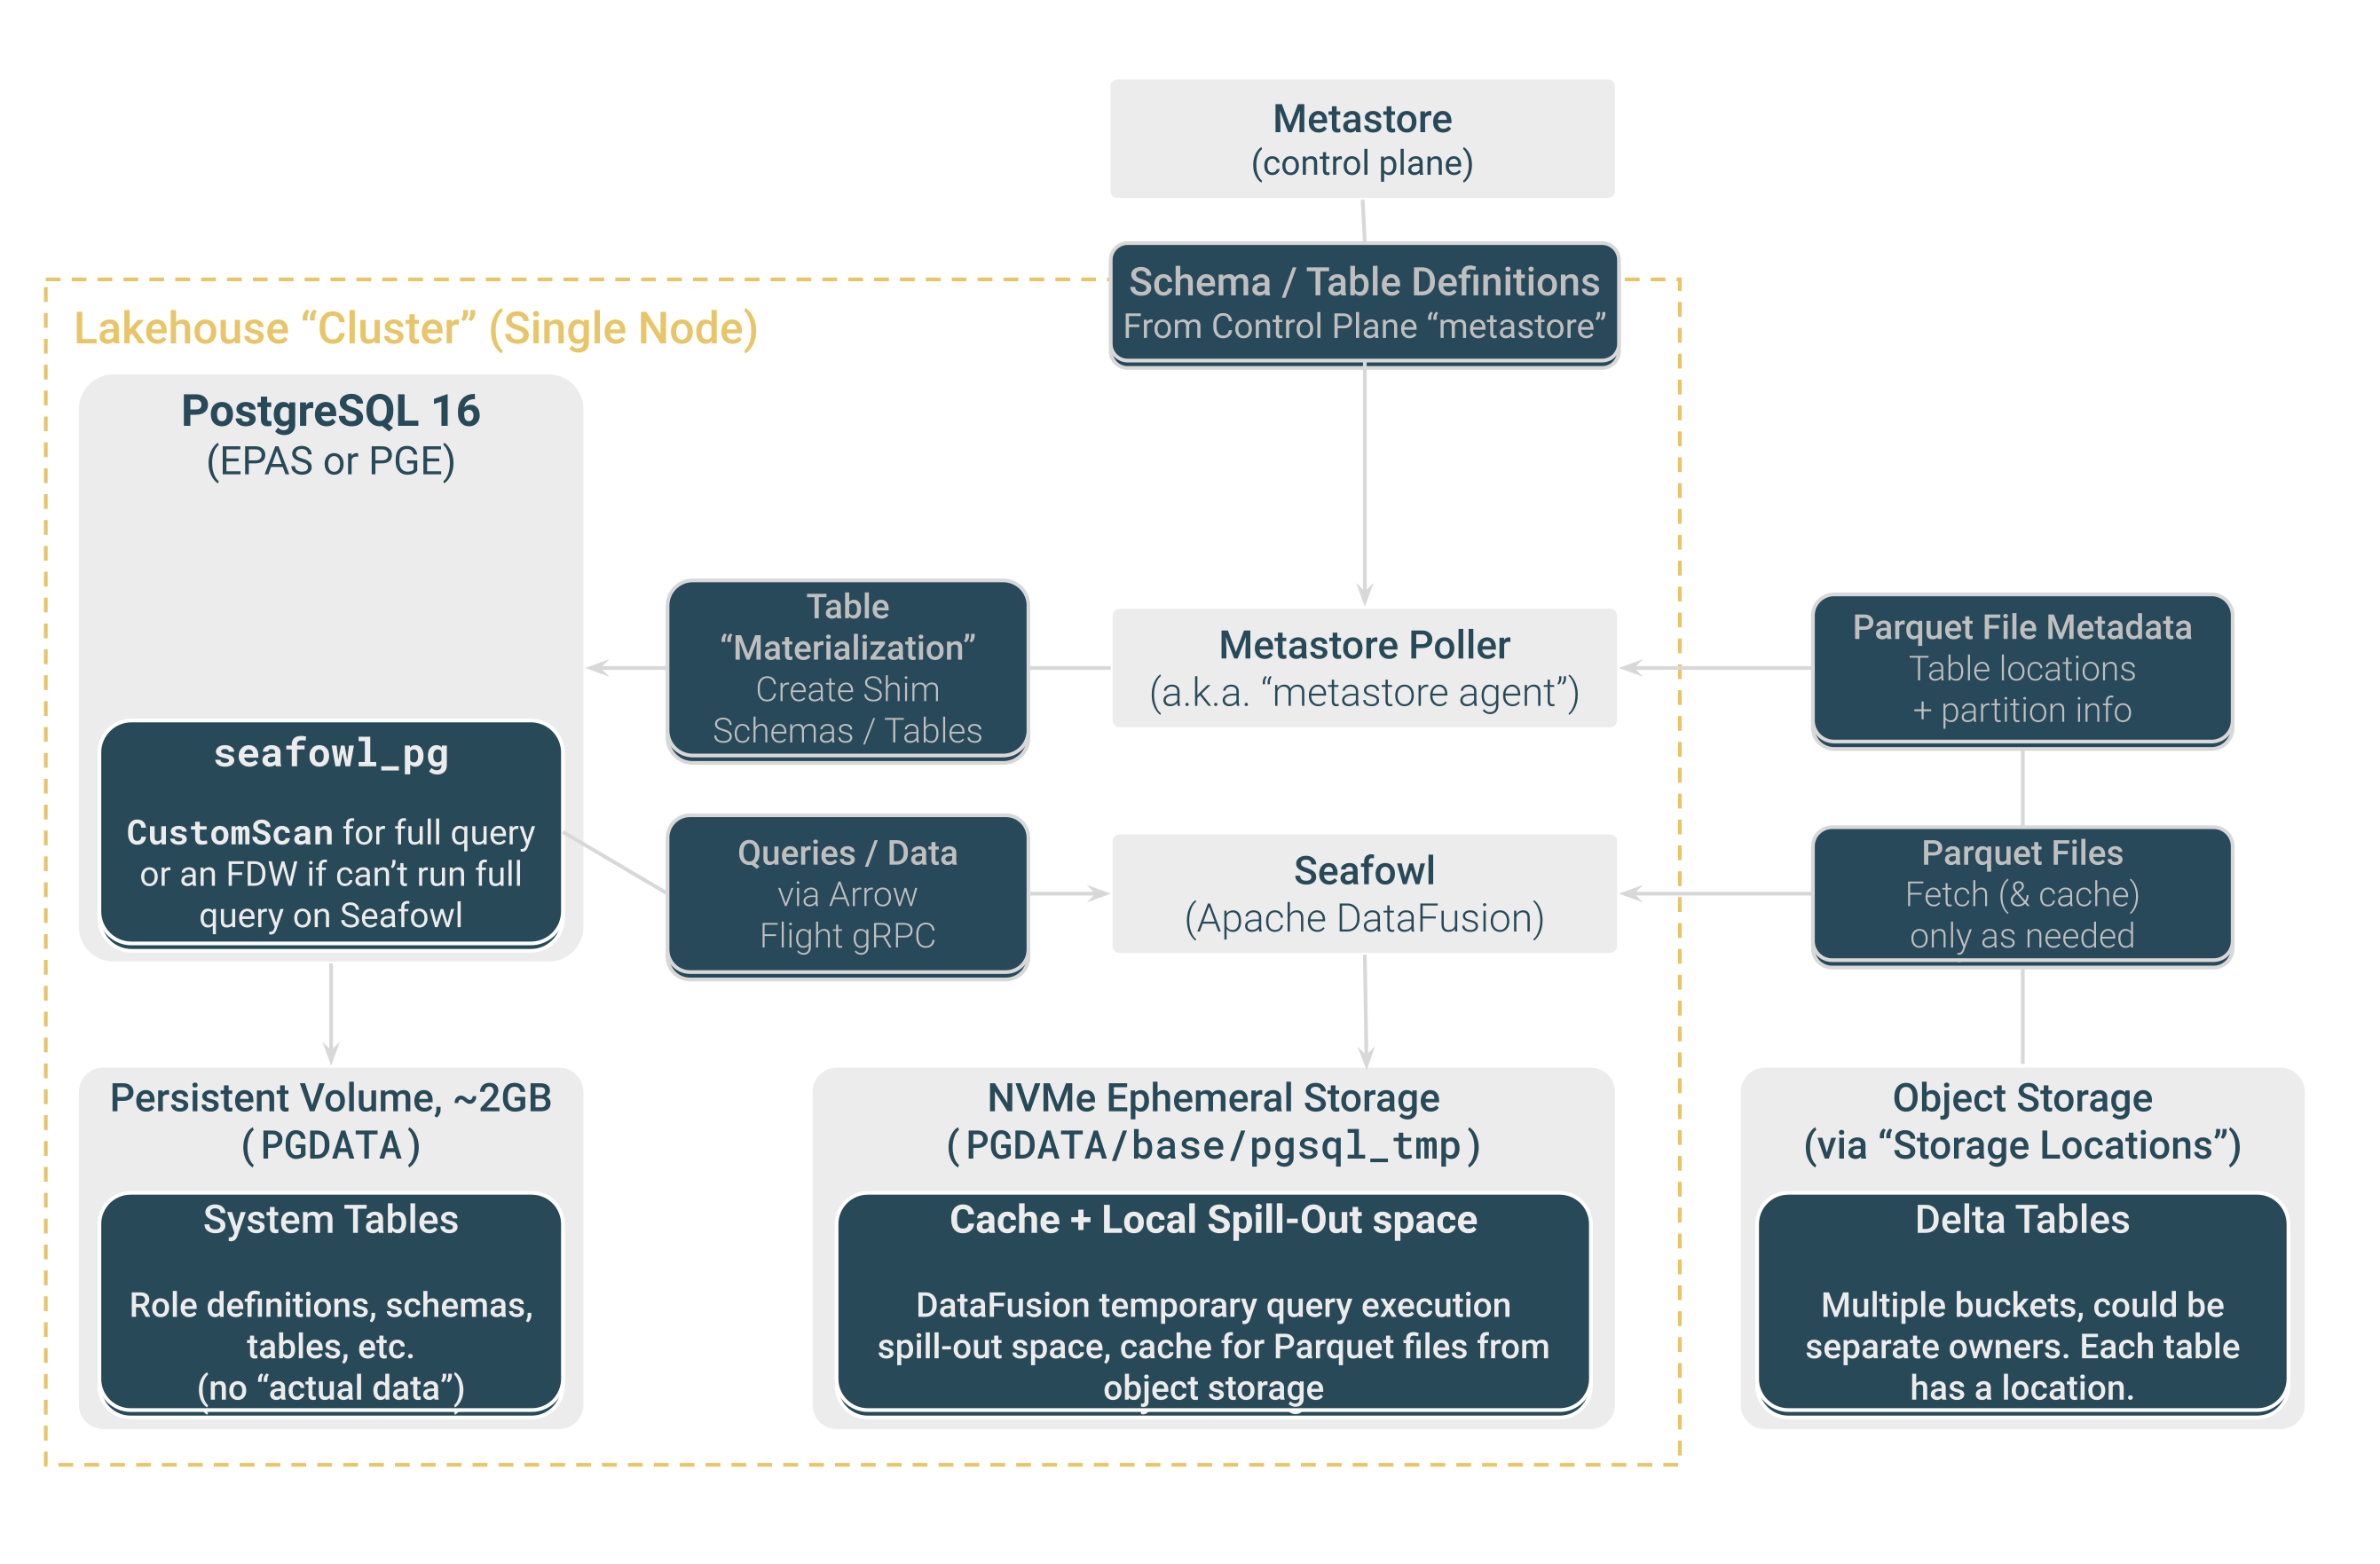
Level 300 Architecture#